この記事は、2014年10月のnginx.confでBelly CardのKevin Reedy氏が行ったプレゼンテーションを基に再構成したものです。数年前の内容ですが、現在でも非常に有用です。プレゼンテーションの録画はYouTubeでご覧いただけます。
目次
0:00 はじめに 概要 免責事項1:16 Bellyとは Bellyの技術スタック1:44 バージョン0:暗黒時代2:04 バージョン1:新たなる希望2:35 バージョン2:ホームページとAPIの分離 本日のバズワード:サービス指向アーキテクチャ! SOAの有効化 ELBからNGINXへの移行 アップストリームと仮想サーバーの設定 結果4:43 Chefによる設定 レシピ ファイル テンプレート クックブック6:49 例:NGINX向けChef インストール、設定、チューニング APIトラフィックのルーティング9:46 実環境でのChefの例10:08 バージョン2:アプリのデプロイ10:40 バージョン3:すべてをSOA化 そしてHeartbleedが発生 すべてをSSL化12:25 バージョン4:Docker メリット コンテナのデプロイ15:45 デプロイ戦略17:43 サービスディスカバリの選択肢18:33 Consulのアーキテクチャ19:30 Consulの機能22:07 Consul Template Consul Templateを起動するコマンド Consul Templateを使用したNGINXの設定 Consul Templateによる構成管理24:35 Chefを使用したConsulのデプロイ25:44 実践的なヒント Chefの部分検索 DNS 古い設定の回避30:35 質疑応答36:31 連絡先
0:00 はじめに
皆さん、おはようございます。Kevin Reedyと申します。シカゴに拠点を置くBelly Cardという会社に勤務しています。従業員は約100人で、そのうちエンジニアは20人です。本日は、絶えず変化する動的なインフラストラクチャにおいて、当社がどのようにロードバランシングを行っているかについてお話しします。
0:21 概要
まず、「暗黒時代」と呼んでいるバージョン0から始めて、インフラストラクチャスタックがどのように変遷してきたかをご説明します。次に、Chefを使用してNGINXを構成する方法を取り上げます。その後、従来の方法から、Consulというサービスディスカバリプラットフォームのデータを使用してNGINXを構成する方法へ、どのように移行したかをお話しします。時間が許せば、特に構成管理に関連するNGINX構成の実践的なヒントもご紹介します。
0:49 免責事項
ここではChefとConsulについてお話ししますが、あらかじめお断りしておくと、この講演の内容はこれらに固有のものではありません。Chef、Puppet、Ansible、Salt、CFEngineをはじめ、どれも優れた製品ですので、いずれかを利用することをお勧めします。私たちはChefを気に入っていますし、ほかにも多くの方が同じように感じていることでしょう。
サービスディスカバリについても同様です。Consul、etcd、ZooKeeperはいずれも優れた製品ですので、用途に合ったものをお使いください。
1:16 Bellyとは?
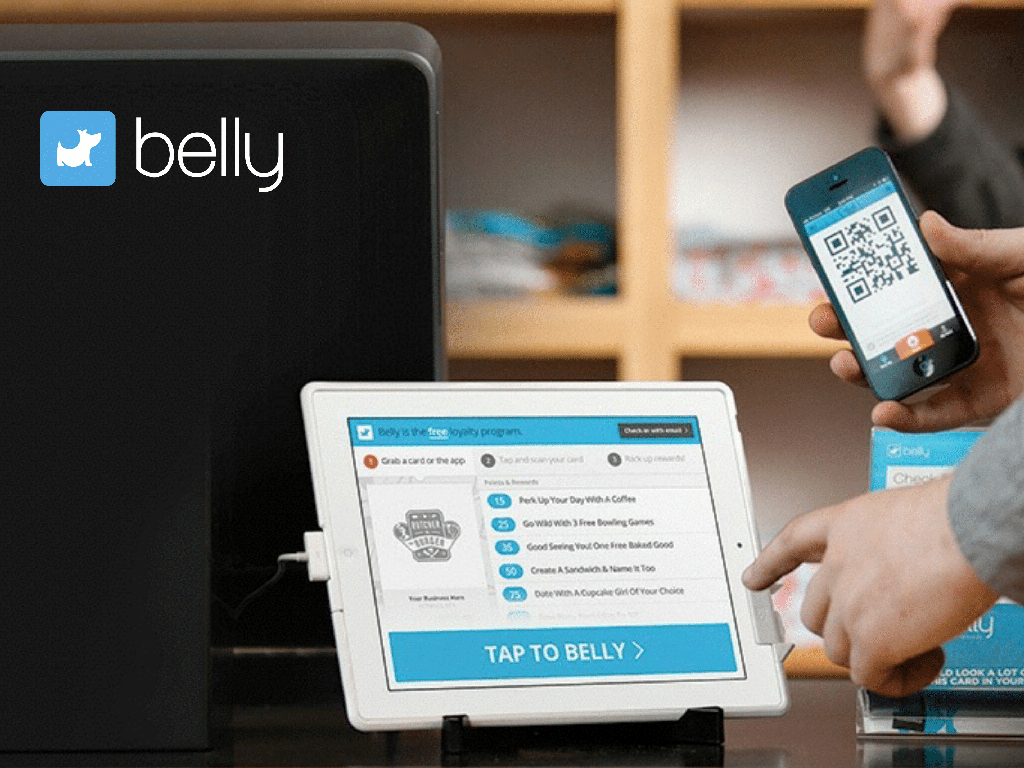
Bellyとは何でしょうか。簡単に言えば、コーヒーショップでドリンクを10杯購入すると1杯無料になる紙のスタンプカードをデジタル化したものです。店舗にiPadを設置し、お客さまがスマートフォンまたはQRコード付きのカードを使ってスキャンすると、ポイントを記録して特典を提供します。さらに、その仕組みを基盤としたマーケティングツールも構築しています。
1:36 Bellyの技術スタック
ただし、ここでは企業としてのbellyについてお話しするわけではありません。ご興味があれば、当社のウェブサイトをご覧ください。ここでは、当社のインフラストラクチャスタックについてお話しします。
1:44 バージョン0:暗黒時代
まずはバージョン0です。開発者が3人で、私が入社する前のBellyは、モノリシックなRuby on Railsアプリケーションでした。つまり、すべてのAPI呼び出しとWebサイトの各部分が、単一のRailsアプリに送られていました。バックエンドにはMySQL、MongoDB、Memcachedを使用し、導入先として最適なHerokuにデプロイしていました。
2:04 バージョン1:新たなる希望
そこで、バージョン1「新たなる希望」です。Herokuではもはやニーズを満たせないと判断し、Capistranoというツールを使ったデプロイを始めました。これはRubyで書かれた、いわば「シェルスクリプトより優れた」ツールで、さまざまなもののデプロイに役立ちます。
Amazon Web Services EC2上で約6台のサーバーを運用していました。基本的には固定台数でしたが、大きなイベントがあると分かっている場合は増やし、必要に応じて元に戻していました。その前段にはAWS Elastic Load Balancerを配置していました。
2:35 バージョン2:ホームページとAPIを分離
その後、ホームページをAPIの他の部分から分離するプロジェクトが立ち上がりました。ホームページの開発を迅速化し、別の開発者が担当できるようにすることが目的でした。
2:47 今日のバズワード:サービス指向アーキテクチャ!
当時、大きな注目を集めていたバズワードは、現在もなお注目されているサービス指向アーキテクチャです。
2:50 SOAの実装
そこで、スタックのバージョン2では、サービス指向アーキテクチャを実現することにしました。最初の計画は、ホームページとAPIを分離することでした。これは非常にシンプルで、用意するのは「www.bellycard.com」と「api.bellycard.com」だけです。
しかし、実際には非常に複雑で、決して単純ではありませんでした。一部のモバイルアプリケーションでは、使用先として「www.bellycard.com/api」と「/api‑assets」が静的に記述されていたためです。また、メールプロバイダーと、すでに送信済みのメールに含まれるすべてのクリックリンクでは、「メール開封」に「/eo」、「メールクリック」に「/ec」が使用されていました。Facebookアプリは「/facebook/callback」を使用するよう設定されていました。
3:28 NGINXがELBを置き換える
そのため、AWS Elastic Load Balancerでは、このトラフィックを複数のアプリケーションに振り分けるために必要な柔軟性を確保できなくなりました。そこで役立ったのがNGINXです。具体的には、複数のアップストリームとリライトルールを設定し、各アプリケーションにトラフィックをルーティングできました。
3:44 アップストリームと仮想サーバーの設定
この非常に基本的な例では、API用に6台のサーバーを含むupstreamブロックと、ホームページ用に2台のサーバーを含むブロックを定義します。
さらに、仮想サーバーを定義する2つの「server」ブロックがあります。一方では、api.bellycard.comへのリクエストを受け付け、そのトラフィックをすべてAPIサーバーにルーティングします。もう一方では、www.bellycard.comへのリクエストを受け付け、適切にルーティングします。
4:02 結果
これは非常にうまく機能し、開発者は迅速に作業を進められました。フロントエンド担当者は1つのプロジェクトに取り組み、APIに妨げられることもありませんでした。そこで、3つ目のサービスをデプロイしました。確か、AppleのPassbookと連携するためのものだったと思います。続いて4つ目として、Facebook関連の機能をすべて別のサービスに移しました。5つ目は、Webサイト上のユーザーイベントを処理するためのものでした。
その後、誰かがこれをNode.jsで書くのは素晴らしいアイデアだと考えたため、2つの言語で書かれた5つの異なるサービスを抱えることになりました。どのサービスも構成管理がほとんどないまま個別にデプロイされ、NGINXも手作業で編集していました。多くの方が最初は同じように始めるのではないでしょうか。
4:43 Chefによる構成管理
このプロセスをより効率的に拡張する方法が必要だったため、Chefを活用しました。
Chefは構成管理スイートです。Rubyで記述されており、実際の構成管理もRubyで記述できるため、開発者に最適です。learnchef.comは、Chefについて学ぶための優れたリソースです。私が45分で説明できるよりも、はるかに多くのことをChefについて学べます。
ただし、共通認識を持てるよう、基本事項をいくつか説明します。
5:17 レシピ
Chefの最初の構成要素は「レシピ」です。Chefでは、ツールを「ナイフ」、手順を「レシピ」、それらをまとめたものを「クックブック」と呼ぶなど、気の利いた名前が数多く使われています。こうした比喩は楽しく理解しやすい一方で、Googleで情報を検索するのが非常に難しくなります。
そこで、思いつく限り最も基本的なレシピを紹介します。パッケージ「nginx」をインストールし、サービス「nginx」を起動して有効化します。
5:56 ファイル
ファイルリソースを使用することもできます。たとえば、ファイル「Hello World!」に次の内容を書き込みます:/usr/share/NGINX/html/index.html。
6:08 テンプレート
これをテンプレートシステムに組み込むこともできます。ここでは、gとwという2つの変数に、それぞれHelloとKevinを設定しています。これらの変数を、ERB形式(Rubyのテンプレートスクリプト)のテンプレートファイルに渡すことができます。
そのため、内容を手作業で書き出す代わりに、読み上げる内容と挨拶する相手を指定するテンプレートを作成できます。
6:19 クックブック
最後の主要な構成要素は、レシピ、ファイル、テンプレートをまとめたクックブックです。さらに、より複雑なリソースであるリソース、プロバイダー、ライブラリも含まれます。オープンソースをはじめとする多数のクックブックが、https://supermarket.getchef.comで公開されています。NGINX、MySQL、Java、apt、yum向けのものに加え、ssh_known_hostsファイルを管理するものまであります。構成管理で実現しようとしていることに必要な主要な構成要素は、ほぼすべて既存のクックブックで見つけられます。
6:49 例:NGINX向けChef
Chefを使用した簡単なNGINXの例を見ていきます。NGINXをインストールし、いくつかの変数を変更して設定します。Chefを使用してアプリケーションの実行場所を検出し、アプリケーションにトラフィックをルーティングするようNGINXを設定します。
7:14 インストール、設定、チューニング
この例では、まずいくつかのノード属性を設定します。各ノードでは、JSONドキュメントを追加することで属性値を設定できます。ここでは、これらの属性の設定を参照するサードパーティ製のNGINX cookbookを使用します。設定するのは、worker_connectionsの値、worker_rlimit_nofileディレクティブ、NGINXで使用するeventタイプ、さらにclient_max_body_sizeです。
その後、NGINX cookbookから2つのrecipeを組み込みます。1つ目は「nginx::repo」で、使用しているオペレーティングシステムに応じて、aptまたはyumのrepositoryをセットアップします。次に、[nginx recipe]でNGINXをインストールします。NGINXはソースからインストールすることもできますが、packageを使用する方が短時間で済みます。
次に、Chefの検索機能を活用します。Chefは、マシン上のエージェントとして実行することも、基本的にスクリプトのように処理を実行するsoloモードで動作させることもできます。マシン上でエージェントを実行している場合は、Chefサーバーに対してノードやその他の属性を照会できます。
ここでは、レシピ「belly‑api」が適用されているすべてのノードの一覧をChefから取得します。次に、「/sites‑enabled/api」というサイトファイルをテンプレートから生成します。ソースは、次に示すテンプレート[「api.erb」というファイル]です。渡す変数は、直前に検索したノードです。
ここで最後に新しく登場するのは、notifiesステートメントです。これは、nginxサービスを再読み込みするためのもので、このテンプレートが変更されるたびにサービスを再読み込みするよう指定しています。
8:54 APIトラフィックのルーティング
このテンプレートファイルは非常にシンプルです。apiという名前のアップストリームがあり、ERBでは変数として渡すすべてのサーバーを反復処理し、各サーバーをIPアドレスとポート8080で指定します。さらに、サーバー名を含むコメントも追加します。オペレーターがこのサービスの状況を確認する際に役立つコメントです。
さらに、serverブロックを定義し、api.bellycard.comでリクエストを待ち受けます。すべてのトラフィックはapiアップストリームに転送します。
9:46 実環境でのChefの例
実際の例もご紹介します。文字が小さくて読みにくいかもしれませんが、Chefレシピがどれほど複雑になり得るかは、何となくお分かりいただけると思います。これは、現在一部の本番サーバーで実際に使用しているテンプレートとレシピです。
10:08 バージョン2:アプリのデプロイ
では、話を私たちのスタックに戻しましょう。先ほど、約5つのアプリケーションをデプロイし、順調に稼働しているとお話ししました。これらのアプリケーションにトラフィックをルーティングする方法が整ったことで、開発者はすぐにこれを活用し始めました。現在では、Chefを使用して約40のRubyアプリケーションをサーバーにデプロイしています。トラフィックはNGINXによって完全に動的にルーティングされます。
開発者が行う必要があるのは、1つのレシピを編集して新しいサービス名を追加することだけです。すべてのトラフィックはNGINXによってルーティングされ、Chefで動的に構成されます。
10:40 バージョン3:すべてをSOA化
また、静的ファイルのみで構成されたフロントエンドJavaScriptアプリケーションが約10個あり、S3にデプロイし、その前段にCDNである[Amazon] CloudFrontを配置していました。index.htmlはS3バケットから配信し、その他のアセットはCloudFront経由で配信していました。さらに、単発の用途として開発者がHerokuに直接デプロイしたものの、いつの間にか本番環境で使われるようになり、そのことがほとんど周知されていなかったアプリも5個ほどありました。
11:10 そしてHeartbleedが発生
[Heroku上の5つのアプリ]は、4月のある晴れた日にHeartbleedバグが公表されるまで、当社のインフラストラクチャから完全に切り離されていました。多くの人が対応に追われました。HeartbleedはOpenSSLのバグで、第三者に秘密鍵を抽出される可能性がありました。
Chefを使用していたため、パッチが提供されるとすぐに、すべてのマシンでOpenSSLインフラストラクチャをアップグレードできました。インフラストラクチャ全体へのデプロイは、約20分で完了したと思います。一方、AWS(したがってHeroku)では、Elastic Load Balancerへのパッチ適用に約24時間かかりました。
これをきっかけに、すべての負荷分散とSSL終端処理を、S3とHerokuのどちらにデプロイされているかにかかわらず、NGINXに移行しました。これにより若干のパフォーマンス低下は生じますが、少なくとも4月のあの日、私たちにとっては移行する価値がありました。
11:57 すべてをSSL化
こうして、スタックのバージョン3では、「すべてをSOA化」から「すべてをSSL化」へと移行しました。bellycard.comとそのサブドメインへのトラフィックは、すべてロードバランサーを経由します。一方、アセットはパフォーマンスを考慮し、現在も別のドメインのCloudFrontから配信しています。SSLのオーバーヘッドは避けたいですし、東海岸にある単一のデータセンターのみで運用しているためです。
12:25 バージョン4:Docker
バージョン4 – 今年、誰もが話題にしているバズワードはDockerです。Dockerがまだバージョン0.5だった頃から、F5の開発者はその活用に大きな期待を寄せていました。
12:38 メリット
[Dockerを使用する]理由はシンプルです。
アプリケーションのデプロイが大幅に簡素化されます。レシピを記述する必要はありません。アセットをどのようにコンパイルするかを気にする必要もありません。自分のアプリをRubyで記述し、ほかの人がPythonで記述していても問題ありません。
基本的には、開発と運用の責任を分離します。開発者は、コードや使用するライブラリ、さらにはインストールするLinuxパッケージに集中できます。一方、運用担当者は、デプロイ先、ログの収集方法、監視方法といった運用上の課題に集中できます。こうした課題を解決して運用体制を整えれば、どの言語で記述されたアプリケーションでも動作します。
さらに、開発者が各自のノートPC上で依存サービスを簡単に立ち上げられるという利点もあります。先ほど述べたように、現在では約55種類のアプリケーションがあり、その多くがDockerコンテナで稼働しています。
メールキャンペーンを配信する新しいサービスを開発しているとします。このサービスはメールサービスに依存しています。そのため、通常は開発マシンにコードをダウンロードし、bundle installを実行してバックグラウンドで起動します。すると、「ああ、でも実際には、これも別のサービスであるユーザーサービスに依存している」と気づきます。
そのサービスも、さらに別のサービスに依存しています。つまり、新しいメールキャンペーンサービスは、実際には約5つのサービスに加え、MySQL、Elasticsearch、Redisなどにも依存しています。
Dockerを使用すれば、本番環境で使用しているものと同じChefレシピからこれらのコンテナを構築し、開発者が非常に短時間でダウンロードできるコンテナを提供できます。
これにより、デプロイと開発が迅速化されます。
14:23 コンテナのデプロイ
そこで、バージョン4では、Chefを使用したアプリケーションのデプロイから、コンテナへのデプロイに移行しました。これを実現するソリューションは数多くあり、今後さらに増えていくでしょう。
1つ目はCoreOSとFleetです。CoreOSは、etcdというサービスディスカバリエンジンを搭載した、必要最小限のLinuxオペレーティングシステムです。Fleetでは、「コンテナを5つ実行し、この別のサービスと同じマシン上では実行しない」といった設定を定義できます。
ほかにも、Git Pushインターフェースを備え、Herokuに似たDeisがあります。ApacheのMesosやGoogleのKubernetesもあり、Flynnも最近登場したツールの1つです。私たちがこの取り組みを始めた当時、これらのツールのほとんどはまだ利用できる段階になかったため、実際には独自のツールを開発しました。
私たちが独自に開発したツールはJockeyと呼ばれ、非常に明確な方針に基づくデプロイプロセスに適しているため、極めてうまく機能しています。Dockerの優れた点は、コンテナ化のための共通API群を実質的に提供していることです。LinuxのLXCコンテナだけを使用する場合に必要となる多くの考慮事項を気にせずに済みます。
オープンソース化を予定していますが、先ほど述べたように、デプロイ方法には私たち独自の方針が強く反映されているため、私たちに適した方法が皆さんにも適しているとは限りません。
15:45 デプロイ戦略
また、Dockerへの移行に伴い、デプロイ戦略も多少変わりました。以前は、アプリケーションの新しいバージョンをその場で更新することで、ダウンタイムなしのデプロイを行っていました。たとえば、そのユーザー向けFAXサービスを4台のマシンで稼働させていた場合、Chefを使用して新しいバージョンを取得し、[古いバージョン]に上書きインストールしてから、Webサーバーにシグナルを送信して再読み込みさせていました。Unicornは、この処理に適した優れたRubyエンジンです。
ただし、コンテナはイミュータブルです。実行中のコンテナがある状態で新しいビルドを作成する場合は、新しいコンテナを作成する必要があります。実行中のコンテナに接続して追加のコマンドを実行し、Gitのような感覚で保存することもできます。しかし、Dockerを最大限に活用するには、コンテナを完全にイミュータブルにする必要があります。
つまり、インプレースでデプロイできなくなったため、新しいデプロイ戦略を考える必要がありました。選択肢はいくつかありますが、なかでも興味深いのがブルーグリーンデプロイです。たとえば、4台のマシンでアプリケーションを実行している場合、別の4台のマシンでアプリケーションを起動し、ロードバランサーの接続先を新しいマシンに切り替えます。想定どおりに動作していることを確認したら、ブルー環境を破棄し、グリーン環境を新たなブルー環境にします。Amazonは、AWSでこの作業を行うための優れたツールを提供しています。
「カナリア」デプロイという方法もあります。新しいマシンを1台デプロイして監視し、メトリクスチェックとヘルスチェックに合格した場合は、デプロイを続行できます。
ここでコンテナが異なるのは、実際に既存のコンテナを破棄して新しいコンテナを起動する点です。そのため、インフラストラクチャ内で稼働する各アプリケーションの場所を追跡する何らかのシステムが必要になります。
実際、Chefはこれを実現するための非常に優れた手段になりつつあります。現在、Chef Metalというクックブックの統合が進められており、Chefインフラストラクチャ内の他のリソースと同様にコンテナを扱えるようになります。
17:43 サービスディスカバリの選択肢
サービスディスカバリもあります。ZooKeeperは、Hadoop全体で広く使用されている非常に人気の高いツールです。[Airbnb]には、SmartStackという優れた製品があり、デプロイを実行してZooKeeperで追跡できます。
先ほど触れたetcdは、基本的にはRESTインターフェースを備えた分散型キーバリューストアです。Javaクライアントライブラリとしての性格が強いZooKeeperと比べ、どのアプリケーションからでもetcdと通信できる点が優れています。先ほど紹介したオープンソースのPlatform-as-a-Serviceの多く(Deis、Flynn、さらにはGoogleのKubernetesなど)でetcdが使用されています。CoreOSを使用している場合、etcdはあらかじめ組み込まれており、すぐに利用できます。
RESTベースの別のツールも登場しています。その名は「Consul」です。VagrantやPackerをはじめ、数多くの優れたツールを開発しているHashiCorpがリリースしています。実際に、私たちはConsulを採用することにしました。
18:33 Consulアーキテクチャ
これは、Consulのごく基本的な構成を示す図です。複数のデータセンターがあり、それぞれに3台のサーバーが配置されています。データセンター1にはクライアントもあります。注目すべき点は、サーバーエージェントの中からプライマリエージェントが選出され、各クライアントがすべてのサーバーだけでなく、ほかのすべてのクライアントも認識していることです。クライアントはゴシッププロトコルを使用して、ほかのすべてのエージェントと通信します。
昔のAT&TのCMを思い出します。2人の友人に伝えると、その2人がそれぞれ別の2人に伝え、さらにその人たちが別の2人に伝えるというように、メッセージがノードのネットワーク全体に広がっていくというものです。[編集者注:惜しいですが、これはFaberge OrganicsシャンプーのCMでした。]一方、etcdやZooKeeperでは、基本的にサーバーエージェントのみが存在し、クライアントはそれらに接続します。
Consul方式では、Dockerをデプロイする場所やロードバランサーを稼働させる場所を含め、ほぼすべてのサーバーでConsulクライアントを実行します。そのため、localhostのポート8500でいつでもそのAPIにアクセスできます。
19:30 Consulの機能
etcdと同様に、[Consul]は分散型のキーバリューストアです。キーを設定、取得でき、線形化可能性が維持されるため、常に一貫性を確保できます。注意すべき点はいくつかありますが、問題が生じる箇所について非常に優れたドキュメントが用意されています。ただし、etcdとは異なり、サービスディスカバリを第一級の機能として扱っています。
単なるキーと値のペアだけでなく、APIなどのサービスも登録できます。サービスを登録する際は、そのサービスが実行されているノードをConsulに指定します。つまり、コンテナをデプロイするときには、このホスト上のサービスAPIも登録するようConsulに指示します。
さらに、Consulには分散型ヘルスチェック機能があるため、サービスディスカバリプラットフォーム内でNagios形式のヘルスチェックを定義できます。Consulにクエリを実行すると、APIサービスが稼働しているすべての場所の一覧を取得できます。「すべて」「正常なもののみ」「異常なもののみ」のいずれかを示すフラグを指定できます。
また、複数のデータセンターにも対応しています。先ほど、Consulクライアントをすべての場所で実行する必要があると説明しました。起動時には、データセンターを指定するパラメーターを渡します。Data Center EastとData Center Westがある場合でも、データセンターを意識することなく、ローカルのConsulクライアントにアドレスなどを問い合わせることができます。
実際には、データセンターをステージング環境と本番環境の境界として使用しています。ステージング環境のアプリケーションでは、「MySQL.services.consulの場所を問い合わせる」という設定が考えられます。実際にステージングノードと本番ノードのどちらで実行されていても、データセンターや複数環境を意識することなく、正しい値を取得できます。
もう1つの優れた点は、etcdと同様に、HTTPインターフェースでロングポーリングを利用できることです。クエリを実行して、このサービスを稼働しているすべてのサーバーの一覧を取得できるだけでなく、接続を60秒間維持し、変更があればすぐに通知を受け取れます。ポーリング時間は最大10分まで設定できます。これにより、インフラストラクチャに変更があった場合、即座に通知を受け取ることができます。
先ほども触れたように、各所にクライアントを配置することで、エージェントをスケールアウトできる仕組みを構築できます。常にlocalhostと通信できる点が大きな利点です。
しかし、ここで大きな疑問が生じます。このデータを分散型サービスディスカバリプラットフォームに格納した今、そのデータを基にNGINXをどのように設定すればよいのでしょうか。
22:07 Consul Template
幸い、Consul Templateというツールがあります。実は昨日リリースされたばかりで、今日のスライドはここから先を変更することになりました。以前は「Consul HAProxy」と呼ばれていましたが、実際にはHAProxy専用ではなかったため、ひどい名前でした。
Consul Templateは、サービスの変更やそのサービスのヘルスチェック、さらにはキーバリューストアの変更を監視するテンプレートを作成するための、非常にシンプルなインターフェースを提供します。これにより、NGINXワーカー[の数]などの設定をキーバリューストアに保存し、その値が変更されたときに設定ファイルを再生成できます。
ここでの主な機能は、テンプレートからファイルを生成することです。これは、以前Chefで行っていたこととよく似ています。大きな違いは、RubyのERBではなく、Golangのテンプレート言語を使用する点です。ファイルを変更した際には、必要に応じてコマンドを実行できます。たとえば、service nginx reloadです。
22:59 Consul Templateを起動するコマンド
以下は、コマンドラインでConsul Templateを実行する例です。実際のConsulホストを指定します。この例では、consul‑prod.example.comです。実際の本番環境では、すべての場所でConsulを実行し、localhostに接続することを推奨します。
次に、Golangテンプレートであるテンプレートファイルを指定します。この例では、/etc/consul‑templates/apiを指定します。続いて、実際の出力先ファイルを指定します。この例では、/etc/NGINX/sites‑enabled/apiです。最後に、呼び出すコマンドを指定します:service nginx reload。
23:32 Consul Templateを使用したNGINXの設定
Consulテンプレートは以前お見せしたスライドとよく似ていますが、ERBではなくGolangを使用しています。ここでは2つのアップストリームを定義します。1つは「api」、もう1つは「homepage」です。サービスAPIにはrange文を使用し、サービスが実際に稼働している場所のIPアドレスとポートを取得するための組み込み変数があります。
23:54 Consul Templateによる構成管理
Consul Templateをこのように使用する利点は、サービス変更への収束が速いことです。Dockerでデプロイする以前は、マシンに応じてChefを約5分または10分ごとに実行していました。当時はインプレースでデプロイしていたため、その頻度で十分でした。
現在、より高度なデプロイシステムを構築しているため、こうした変更の通知を数分ではなく数秒以内に受け取る必要があります。実際にはミリ秒単位で通知され、平均すると約200ミリ秒です。
ただし、テンプレートの生成には、引き続き構成管理が必要です。Chefを単にConsulに置き換えることはできません。ConsulやConsul Templateなどをどのようにデプロイするかについても、検討する必要があります。
24:35 Chefを使用したConsulのデプロイ
実際には、Chefテンプレートを使用してConsulテンプレートをデプロイしているため、少し複雑に見えるかもしれません。まずChefレシピでConsulホストにクエリを実行し、すべてのサービスのリストを取得します。次に、templateステートメントとsourceステートメントを使用してConsulテンプレートを生成し、SSL証明書とキーの場所を渡して、consul‑templateを再読み込みします。[編集者注:Reedy氏は当初、 consul‑haproxyと述べていました。これはスライドの最初の notifies ステートメントに記載されています。その後、同氏は発言を訂正し、このスライドはConsul Templateのリリース前に作成されたものだと説明しました。]
Consul Template用の設定ファイルも書き出し、Consulホスト、ソース、宛先、リロードコマンドを[指定する変数として]渡します。これが、ChefとConsulを連携させてNGINXの設定を即時に更新する仕組みの中核です。
25:44 プロのヒント
次に、Chef、Consul、NGINXの設定全般に関するプロ向けのヒントをご紹介します。
25:52 Chef Partial Search
最初のヒントです。サービスの実行場所を特定するためにChef searchを使用している場合は、Chef partial searchの利用を検討してください。Chef searchには、すべての属性を含むノード全体のコピーが作成されるという問題があります。ノードの属性に多くの情報を保存していると、Chef serverとの通信時にそれらをネットワーク経由で取得し、さらにメモリにも保存する必要があります。
Chef searchで数百台、数千台ものサーバーが返される場合、実際のレシピを実行するためのメモリが不足しかねないことは容易に想像できます。partial searchを使用すると、必要なキーだけを返すことができます。
たとえば、最初は次のようになっていました。
nodes = search(:node, 'recipe:belly-api')この検索では、すべてのオブジェクトに関するあらゆる情報が返されます。これには、ディスク容量、RAM、CPUに関する情報のほか、独自のノード属性を書き込んだすべてのアプリケーションに関する情報が含まれます。
代わりに、部分検索を使用できます。まず、search_keysという新しいハッシュを作成し、必要なキーのリスト(この場合は名前とIPアドレスのみ)を指定します。次に、よく似たpartial_searchというAPIを呼び出し、追加の[keys]パラメーターを渡します。
26:53 DNS
S3とHerokuの前段にロードバランサーを配置した際に直面した2つ目の問題は、NGINXがDNSを使用してupstreamブロック内のホスト名を解決するのは、設定の再読み込み時に限られることです。つまり、アップストリームサーバーをs3.amazonaws.comまたはanything.herokuapp.comに設定していて、そのIPアドレスが変更された場合、ロードバランサーは次回の再読み込みまで新しいIPアドレスを認識できません。
この問題を回避するため、実際のDNS名前解決はChefで行い、その結果が変わったときにNGINXの再読み込みを実行するようにしました。すると、別の問題が発生しました。[DNS応答内のアドレスの順序]は常に同じとは限らないため、応答をテンプレートに書き込む前に必ず並べ替えてください。
27:36 古い設定の回避
多数のサービスをデプロイし始めると、もう1つの課題として、古い設定が残らないようにする必要があります。[編集者注:Reedy氏は聴衆からの質問に答えるため、プレゼンテーションを一時中断します。]Apache、NGINX、その他のUNIX系システムでは、conf.dフォルダーを用意し、そこからすべての設定を読み込むのが一般的な設定パターンです。そのため、サービスA、B、Cをデプロイする場合は、service-a.conf、service-b.conf、service-c.confを作成します。
その後、サービスBをDに置き換えることにすると、サービスBはもう存在しないにもかかわらず、NGINXの設定フォルダーには4つの設定ファイルが残ります。BとDのホスト名が似ているため、両者の間で競合が発生する可能性があります。
これまで、これ[古い設定の削除]を行う方法として、2つの方法を検討してきました。テンプレートでは、:delete関数を追加できますが、すぐに扱いにくくなりました。実質的には、古いサービスのリストを用意し、該当するサービスが存在する場合は常に削除を試みていました。この方法では、十分にスケールできませんでした。
もう1つの方法は、すべてのサイト設定を1つのファイルに出力することです。これは多くの場合、「冪等性を上位に移す」と表現されます。つまり、複数のソースから読み込むNGINX設定を使用する代わりに、すべてをnginx.confにまとめます。
確かに、実際にサーバーへログインして作業する際には、少し扱いにくくなります。しかし、本番環境で設定ファイルを直接トラブルシューティングする必要がない段階に近づいていることを願っています。Chefレシピ内でもまだ少し扱いにくい場合、私たちは1つの「nginx.conf」から複数のサイト設定を読み込むようにしています。たとえば、あるサイト設定ファイルには約30のサービスを記載し、Heroku用に1つ、すべてのS3用に1つ、といった具合に分けています。
そのため、すべてのサイト設定を1つ、または少数のファイルにレンダリングすれば、後処理を気にする必要はありません。Chefから見てサービスがなくなった場合、Chefはそのサービスの設定を実際のファイルにレンダリングしなくなるだけです。
30:35 質疑応答
Q: これまでのところ、Consulの導入効果はいかがですか?
A: Consulは非常に気に入っています。etcdのようなものと比べて特に優れていると感じるのは、Consulを基盤とするサービスが継続的に構築されている点です。サービスディスカバリを気にする必要もありません。実際、レガシーアプリケーションがあり、たとえばConsulを使用してMySQLサーバーをデプロイする場合、ConsulはDNSインターフェースも提供します。
アプリケーション側でConsulを認識する必要はなく、「mysqldb.services.consulから取得できるアドレスは何か」と問い合わせるだけです。この場合、ConsulがDNSサーバーになります。TLD[トップレベルドメイン]の末尾が.consulの場合にクエリがConsulへルーティングされるよう、DNSインフラストラクチャを設定します。
当社の環境では、非常にうまくスケールアウトできています。本番環境では、サーバーエージェント用に約3ノード、クライアントを約60台稼働させていますが、これまで問題は発生していません。機能が継続的に追加される一方で、後方互換性も維持されているため、アップグレードも常にスムーズです。
質問: NGINX Plusを使用していますか?
A: 使用していません。Consulを使い始めた際、まさにこの用途で検討しました。テンプレートシステムが不要であれば、HTTPロングポーリングをリッスンし、代わりにNGINX APIと通信するスクリプトを用意するだけで済むため、非常に便利です。ただし、NGINXが再起動した場合に備えて、やはりテンプレートシステムも必要になるでしょう。これにより、アップストリーム設定をその場で再読み込みできます。
また、NGINX LuaからConsulに直接クエリを実行する取り組みも行われています。しかし、まだ優れた実装は見たことがありません。実装は次の2つのいずれかに分かれる傾向があるためです。1つ目は、HTTPリクエストのたびにConsulにクエリを実行する方式で、処理が遅くなります。2つ目は、設定の実行時に読み込む方式で、DNSと同じ問題が生じます。そのため、現時点ではテンプレートを使用する方法が最適ですが、将来的にNGINX Luaで実現する方法が登場しても不思議ではありません。
質問: Chefから移行する可能性はありますか?
A: Consulには、これらのテンプレートを管理するための優れた仕組みが組み込まれていません。また、すでにChefを使用してNGINXをデプロイしています。ロギング、トレーシング、一部のOAuthなど、NGINXで行っているさまざまな処理に関するレシピは、現時点で数百行、場合によっては数千行に及びます。インフラストラクチャでChefの使用をやめて別のものに置き換えることは考えていませんが、ConsulはChefを補完し、迅速に通知を受け取るための優れた手段です。
Q: Chefによるオーバーヘッドはどの程度ですか?
A: 当社のマシンの大半は単一のタスクを実行しているため、Chefによる実際のオーバーヘッドはかなり小さくなっています。アイドル時のRAM使用量もわずかです。通常はタイマーで待機し、必要に応じて子プロセスを生成できます。収束速度を重視しない場合は、cronで実行しているケースもあります。負荷の高いレシピではCPU使用率が少し上昇しますが、サーバーをもう1台デプロイすれば対処できる程度です。
Q: CloudFormationをどの程度利用したことがありますか?
A: CloudFormationはまだ使用していません。導入を検討していますが、変更点の1つとして、Auto Scalingグループをこれまで以上に活用するようになりました。インスタンスが起動すると、そのChef実行リストを含むユーザーデータが設定される仕組みです。
新しいマシンは、そのイメージに基づくキーをあらかじめ持った状態でクラスター内に起動します。そのため、Chefサーバーと通信して自身を登録し、必要なクックブックを取得できます。CloudFormationと併用する他のAWSツールの多くは使用していないため、これでCloudFormationに関する要件の大部分を満たせます。
Q: サーバーが破棄された場合、どのように対処しますか?
A: Auto Scalingグループ内のサーバーがなくなった場合、Amazon SNS[Simple Notification Service]を使用して通知を受け取ることができます。F5では、その通知を受信してChefサーバーをクリーンアップする非常にシンプルなサービスを用意しています。
Q: AWSのOpsWorksを使用したことはありますか?
A: いいえ。最初からホステッドChefを使用しており、非常にうまく機能しています。確かではありませんが、OpsWorksはChef Soloに近く、プロビジョニング専用で使用するものだと認識しています。現在もほぼすべてのマシンでChef Agentを実行しており、同じChefレシピを使用して開発用のDockerコンテナを生成しています。
36:31 連絡先情報
関連するブログ記事

チュートリアル:NGINXを使用してアプリケーション向けにOpenTelemetryを構成する
OpenTelemetryを使用してNGINXサーバーの状態と健全性をより明確に把握することで、問題のトラブルシューティングを行い、Webアプリケーションのパフォーマンスを向上できます。
AkitaのNGINX Plus認定モジュールでAPIエンドポイントの問題を特定・修正
Akita SoftwareのAPIオブザーバビリティ向け新しいNGINX Plus Certified Moduleを活用して、APIエンドポイントの問題をより迅速に特定し、修正できます。
JavaプロジェクトをスキャフォールディングしてKubernetesネイティブアプリを構築する方法
Red HatのシニアプリンシパルデベロッパーアドボケイトであるDaniel Oh氏が、Javaプロジェクトをゼロから構築するためのひな形を作成し、Kubernetesネイティブアプリケーションとしてビルドする方法を解説します。
F5 NGINXaaS for Azureのご紹介:Microsoft Azureでネイティブに利用できるSaaS型ロードバランシング
NGINXaaS for Azureは、NGINX PlusをAzureネイティブのSaaSとして利用できるサービスです。NGINXの設定を容易にリフト&シフトできるため、クラウド導入とモダンアプリの展開を加速できます。

SELinuxでNGINXおよびNGINX Plusを使用する
Red Hat Enterprise Linux(RHEL)および関連ディストリビューションでSecurity-Enhanced Linux(SELinux)を有効にすると、デフォルト設定によりNGINXとNGINX Plusの一部の操作が制限されます。この記事では、すべての機能を利用できるようにSELinuxの設定を変更する方法について説明します。
NGINX PlusによるAWS Auto Scalingグループの負荷分散
新しいnginx-asg-sync統合ソフトウェアにより、NGINX PlusはAWS Auto Scalingグループの負荷を直接分散できるため、クラウドでの負荷分散がさらに柔軟になります