生成AI(GenAI)に関する話題は、至るところで聞かれます。では、実際に普及しているのは何でしょうか。生成AIはどのように世界をより良くしているのでしょうか。ビジネス価値はどこにあるのでしょうか。こうした問いは、GenAIを業務(AIOps)に導入するかどうか、また導入するならいつにするかを検討している組織が直面する課題を考えるうえでも重要です。ここでは、過去1年間にわたる生成AIの実験と、F5での日々の調査を通じて幅広く把握した業界動向を踏まえ、GenAIが運用データの活用方法に及ぼす影響を理解しようとする組織に役立つ5つのポイントをご紹介します。これにより、既存の予算、業務慣行、組織文化に合わせて、GenAIテクノロジーの導入時期をより適切に設定できるようになります。
1. GenAIモデルは半構造化データと非構造化データを好む
運用データは、半構造化データ(オブジェクト)と非構造化データセットが混在しています。大規模言語モデル(LLM)は、このような多様なデータ形式に柔軟かつ効果的に対応できます。そのため、LLMは運用データセットの分析に最適なテクノロジーです。組織は、GenAI対応ソリューションの有効性、使いやすさ、コストを検証するために、さまざまな実験や評価を社内で実施できます。LLM推論を使用して、誤検知を抑えながら注目すべきデータパターンを検出することで、運用データフローを利用するチームの目標に、機械処理の速度と規模を適合させることができます。
2. 組織がモデルを構築する必要はない
特定のタスクに対して、どのモデルでどの手法が使用されているかを把握することに注力すれば、組織が独自のモデルを構築する必要はありません。たとえば、固有表現認識(NER)は自然言語処理(NLP)の一分野であり、半構造化データ内の主要な要素を特定するうえで有効な手法であることが実証されつつあります。NERの例としては、「曜日」のようなカテゴリや、「1より大きく5より小さい整数」のような記述で構成されるリストが挙げられます。その結果、推論時には、GenAIに対応していないルールベースのパターンマッチング手法よりも高い精度が得られます。NERのような手法に関する研究と実践が進展するにつれ、運用チームはモデルの構築ではなく、実績のある手法の活用に注力できるようになります。
NERの例:
固有表現:曜日
リスト:日曜日、月曜日、火曜日、水曜日、木曜日、金曜日、土曜日
図1. 固有表現認識は、ルールベースのパターンマッチングよりも推論時の精度が高くなります。
3. データグラビティは現実のもの
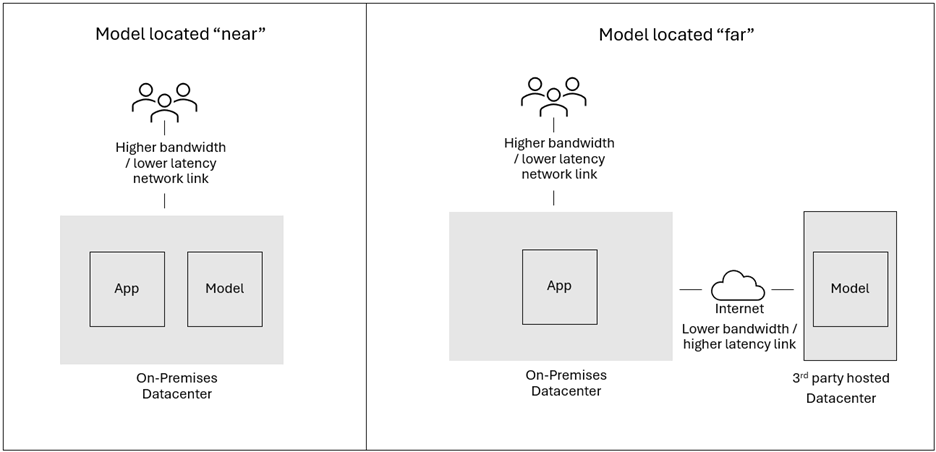
データグラビティは、データが生成される場所の近くにコンピューティングリソースを配置するか、すでにコンピューティングリソースが展開されている場所の近くにデータを移動するかという判断に影響を与える根本的な力です。データ量が増えるほど引力が強まり、そのデータの近くに配置されるコンピューティング能力も増加します。トレーニング(モデルの作成とチューニング)では、データを集約し、コンピューティングリソースの近くに移動します。推論(モデルの使用)では、プロンプトが発行される場所の近くにモデルを移動します。
サードパーティがホストするインスタンスのAPIを呼び出すのではなく、モデルのコピーを社内に取り込んで利用する場合は、モデルをプロンプトの発行元や、プロンプトの一部としてベクトル化される追加のプライベートデータセットに近づけることが合理的です。一方、インターネット経由でAPIを公開するサードパーティがモデルをホストしている場合、モデルも推論処理も移動しません。このような場合は、データセンターのコロケーション相互接続を利用するか、可能であればホスティング拠点をモデルプロバイダーの拠点に合わせることで、推論処理とプライベートデータのベクトルを「ネットワーク上で近接した」場所に移動できます。
データとコンピューティングを近づける要因と、両者を引き離す要因を把握することで、コストとパフォーマンスの適切なバランスを見極めるための、十分な情報に基づく選択が可能になります。
4. データサイロを放置せず、対処する
GenAIによる処理では、運用データの分析を簡素化し、迅速化するために、データサイロを解消することがこれまで以上に重要です。しかし、当面はデータサイロがなくならず、むしろ増加する可能性もあります。
重要なのは、データサイロにどう対処し、どのテクノロジーを選択するかです。複数の場所に保存されたデータへアクセスする方法としては、データをコピーして移動するか、データを移動せずにフェデレーテッドクエリを使用する論理データレイヤーを実装するかの選択肢があります。どちらを選ぶ場合でも、既存のストリーミングデータソースを把握し、時間やデータ鮮度の制約を踏まえて運用ユースケースを評価することで、ストリーミングエンジン、クエリエンジン、データ形式、カタログなど、データテクノロジースタックに必要な要素を選定しやすくなります。テクノロジーを選択できることで、データチームはパフォーマンスとコストのバランスを取りながら、最も効果的で使いやすいテクノロジーを選べます。理想的には、組織のデータ活用は時間とともに成熟しつつ、各成熟段階で最適な手法を柔軟に選択できる状態を維持します。
5. 自動化は味方です。恐れる必要はありません
ソリューションに自動化を取り入れると、データプライバシーとSecOpsの専門家が持つ暗黙知を、機械で実行可能かつ反復可能なAIOps対応の実務へと転換することで、拡張性を高められます。これにより初めて、データ、セキュリティ、プライバシーの各チームは、インテリジェンスの付加に注力できるようになります。インテリジェンスは、データの保存場所、作成されるコピー、共有先を追跡しながら、特定のデータを誰が、どのくらいの期間、どのような目的で使用できるかをより詳細に定義することで、ポリシーの有効性を高めます。その結果、戦略策定、新しいテクノロジーの評価、データアクセスポリシーの改善や例外の承認に向けた事業部門とのコミュニケーションに充てる時間を確保できます。
スピード、拡張性、自動化は、成熟したAIOpsプラクティスの特徴であり、成果の向上、意思決定の迅速化、人的資本の最適化につながります。GenAIは、これまでテクノロジーでは開けなかった扉を開きつつあります。上記の5つの学びは、IT運用、セキュリティ運用、プライバシー運用の各チームがAIOpsにGenAIを導入する際に検討すべき道しるべとなります。AIモデル、運用データに近接したコンピューティング、データ、自動化は、新たなAIOpsプラットフォームを構成する重要な要素です。この充実した学習環境の中で、組織は現在および次世代に向けたテクノロジー運用の文化とプラクティスを構築できます。
生成AIがデータに与える影響について詳しくは、F5の最新レポート「Digital Enterprise Maturity Index」をご覧ください。
著者について

関連するブログ記事

SOAS 2025:足並みの乱れが凡庸さを招く
AI導入における方針の不一致は、非効率を招きます。セキュリティ、自動化、導入の各戦略を整合させ、AIの可能性を最大限に引き出す方法をご紹介します。

WebAssemblyが重要な理由
WebAssembly(Wasm)は、あらゆるプラットフォームで高性能なアプリケーションを実現する、ポータブルで高速かつセキュアなバイナリ命令セットです。

インフラストラクチャは依然として格好の攻撃経路
クラウドコンピューティングでは、APIやドラッグ&ドロップ式の設定ツールを活用し、ネットワークやインフラストラクチャを敬遠する人がそれらを直接扱わずに済むようにすることで、インフラストラクチャへの対応を不要にすることが長年追求されてきました。しかし、インフラストラクチャを無視することも、攻撃の主要な標的であるという事実を見過ごすこともできません。
堅牢なデータアーキテクチャがもたらす戦略的メリット
適切に構築されたデータアーキテクチャがもたらす効果は、業務プロセスの改善にとどまりません。戦略的な業務効率の向上、より深いビジネスインサイトの獲得、隣接するビジネス機会への展開にもつながり、これらすべてをより俊敏に実行できるようになります。
デジタルワークフローにおける不正検知には、データだけでは不十分
2019年には、業界全体でクレジットカード詐欺の試みが約25万件確認されました。これは約2分に1件の割合です。今日、不正を検知するには、デジタルワークフロー上のできるだけ多くのポイントから収集したデータを相互に関連付け、手作業によるデータ処理をはるかに上回る速度で分析する能力が求められます。