
Créer un cloud d’entreprise avec F5 et IBM
Introduction
Selon certaines estimations, le cloud d’entreprise, également appelé cloud privé, est adopté plus rapidement que le cloud public. Le cabinet de conseil aux entreprises Accenture estime que le taux d’adoption du cloud privé par les entreprises atteindra 77 % d’ici fin 2011.1 Cette évolution rapide vers la création d’une infrastructure agile sur site s’explique en grande partie par la nécessité, pour les services informatiques des grandes comme des petites entreprises, de conserver en interne le contrôle et la gestion de l’infrastructure et des données.
Une fois la décision prise d’adopter une infrastructure cloud, le choix entre un cloud interne/privé et un cloud externe/public repose sur une analyse des coûts, des risques et de la valeur. Un cloud public offre généralement une approche flexible et les économies les plus importantes ; il comporte toutefois des risques liés à la sécurité, aux accords de niveau de service (SLA), à la disponibilité et à la gestion. Le service informatique peut bénéficier d’une capacité d’évolution presque illimitée pour un faible coût initial, mais il renonce à une partie de son contrôle. Passer d’un centre de données traditionnel sur site ou hébergé à un cloud public externe revient, en substance, à confier l’intégralité de son centre de données à un tiers.
Avec un cloud d’entreprise, le service informatique bénéficie du niveau de contrôle dont il a besoin et évite les risques associés à un cloud public. Toutefois, un cloud privé est plus coûteux à déployer, exige du personnel des connaissances et une expertise supplémentaires, et accroît la complexité du centre de données sur site. L’infrastructure de cloud d’entreprise peut être dimensionnée selon les besoins et offre un provisionnement dynamique ainsi qu’une grande agilité, mais cette évolutivité et ce contrôle s’accompagnent souvent d’un coût initial plus élevé.
Ensemble, F5 Networks® et IBM ont conçu une architecture de référence pour le cloud d’entreprise qui permet de surmonter bon nombre des difficultés liées à la complexité. Elle transpose sur site de nombreux composants d’architecture et de mise à l’échelle d’un cloud public afin de réduire considérablement le coût de création d’un système interne constitué de solutions disparates. En prédéfinissant les composants requis et en décrivant la manière dont ils interagissent, F5 et IBM ont créé une infrastructure de cloud d’entreprise complète, dynamique et agile.
Flux de travail
L’élément le plus important d’un système de provisionnement à la demande est sa capacité à prendre des décisions et à agir en fonction des événements. Un événement survenant quelque part dans le système génère une alerte ou un message qui est pris en charge par un composant (soit parce qu’il est abonné au bus de messages, soit parce qu’il a été directement sollicité par un appel d’API), lequel agit ensuite en conséquence. Le workflow désigne le processus et l’ordre selon lesquels les composants réagissent aux messages du système.
Dans un cloud d’entreprise, le workflow se décompose généralement en composants de provisionnement qui demandent ou libèrent des ressources, ainsi qu’en étapes nécessaires à la gestion de leur allocation. Lorsqu’une machine virtuelle (VM) a besoin de ressources processeur supplémentaires, un workflow est lancé afin de déterminer d’où proviendront ces ressources, de démarrer une nouvelle VM, d’attribuer une adresse IP, etc.
Architecture des workflows
L’architecture cloud d’entreprise de F5 et IBM repose sur deux principes fondamentaux :
- Un bus de messages centralisé est utilisé pour acheminer les messages de notification d’événements, et tous les composants devant réagir à ces événements sont connectés à ce bus.
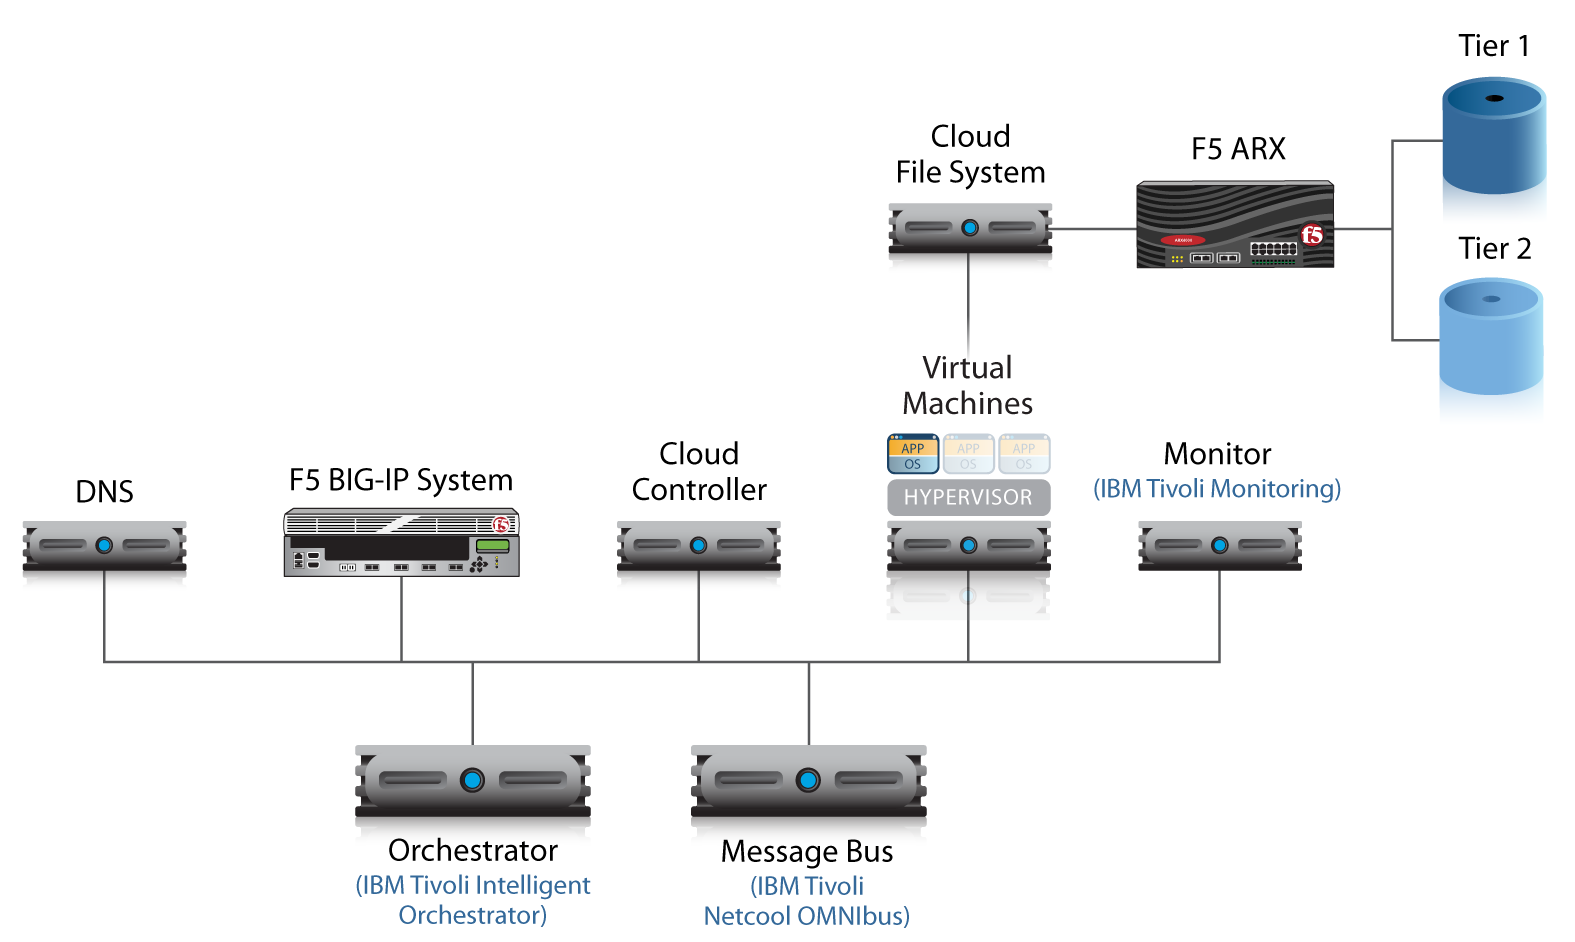
Au-delà de ces deux principes, l’architecture de référence de F5 et IBM est extrêmement flexible, ce qui lui permet de s’adapter à n’importe quelle architecture de centre de données ou de cloud existante. Par exemple, si un moteur d’orchestration est déjà utilisé pour gérer le déploiement des machines virtuelles, cette architecture de référence peut être adaptée afin de permettre l’utilisation du moteur existant. Une idée reçue concernant la création d’un cloud d’entreprise veut que l’ensemble de l’infrastructure doive être remplacé ; la solution de F5 et IBM a été conçue pour s’intégrer aux composants existants à chaque étape possible.
Composants du workflow
Que certains composants existent déjà ou soient nouveaux, le workflow de cloud d’entreprise se compose de composants spécifiques qui exécutent des tâches précises. L’ensemble du système cloud est constitué de ces composants individuels, qui fonctionnent de concert pour fournir l’infrastructure cloud complète. Cette infrastructure est alimentée et contrôlée par des workflows de composants, c’est-à-dire des tâches coordonnées qui gèrent un événement cloud.
Bus de messages
Le bus de messages est le système qui transmet des messages fondés sur des événements et des alertes à chaque composant concerné. Lorsqu’un événement déclenche un message, celui-ci est envoyé via le bus de messages à un composant particulier, qui dispose de règles définissant la manière de le traiter. Le bus de messages est également chargé de normaliser les messages selon les règles propres à certains composants.
L’architecture cloud de référence de F5 et IBM utilise la solution IBM Tivoli Netcool OMNIbus comme bus de messages central. Toutefois, n’importe quel bus de messages d’entreprise peut être utilisé pour transmettre les notifications d’événements dans l’ensemble du système.
Orchestrateur
L’orchestrateur peut être considéré comme le cerveau du cloud d’entreprise : il s’agit du composant chargé de prendre la plupart des décisions globales de provisionnement en fonction des messages reçus via le bus. L’orchestrateur déclenche les principaux événements et workflows de l’architecture cloud, comme le lancement du workflow « provisionner une nouvelle machine virtuelle ». Il est également chargé de récupérer les données nécessaires à chaque workflow et de les transmettre aux composants concernés. Par exemple, il fournit les informations relatives à l’adresse IP requises pour provisionner une nouvelle machine virtuelle.
Dans l’architecture de référence, l’orchestrateur est créé à l’aide d’une série de scripts interprétés qui traitent les messages provenant du bus et déclenchent des événements de workflow. Tout type d’orchestrateur peut être utilisé, notamment IBM Tivoli Intelligent Orchestrator, HP Operations Orchestration ou VMware vCenter Orchestrator.
Contrôleur cloud
Le contrôleur cloud est le système frontal chargé de recueillir et d’agréger les données préliminaires nécessaires au lancement d’un processus de provisionnement. Initialement, ces informations sont fournies par un administrateur dans le cadre du processus de création et sont propres à chaque type de workflow utilisé pour le provisionnement. Par exemple, le contrôleur cloud recueille des informations telles que l’emplacement de la machine virtuelle, la catégorie d’application (serveur web, serveur de base de données, serveur de messagerie, etc.) et les besoins minimaux en ressources.
Lors d’une opération de provisionnement automatisé, une fois ces données préliminaires stockées dans le système, l’orchestrateur demande et extrait les informations existantes afin d’initialiser le workflow de provisionnement. Eucalyptus Cloud Controller, VMware vCloud Director et Amazon EC2 sont des exemples de contrôleurs cloud. Pour anticiper la croissance future et l’extension à d’autres plateformes cloud, il est recommandé de choisir un contrôleur cloud capable de s’intégrer à un ensemble standard d’API cloud ou de communiquer avec celui-ci. Le contrôleur cloud peut ainsi s’étendre à un fournisseur de cloud public ou hybride sans qu’il soit nécessaire de repenser l’architecture de la plateforme cloud de l’entreprise.
Contrôleur de cluster/hyperviseur
Le contrôleur de cluster est le composant du cloud d’entreprise chargé de gérer la machine virtuelle en cours de provisionnement, ainsi que le stockage et les métadonnées nécessaires à son exécution. En tant qu’environnement d’exécution de la machine virtuelle, le contrôleur de cluster comprend l’hyperviseur de la plateforme virtuelle et peut également inclure un environnement plus vaste de gestion des hyperviseurs. Par exemple, le contrôleur de cluster peut être un hyperviseur minimaliste, tel que VMware ESXi, ou un ensemble plus vaste de systèmes d’hyperviseurs distribués, tel que VMware vSphere ou VMware vCloud.
Surveillance
La surveillance de l’intégrité et de l’état constitue un élément essentiel de tout déploiement d’applications d’entreprise. Elle fournit également aux systèmes de provisionnement des informations actualisées sur l’état des ressources, par exemple lorsqu’une machine virtuelle est opérationnelle et répond aux connexions sur le réseau. La surveillance continue du système peut générer des alertes en temps réel qui alimentent ensuite de nouveaux workflows et influencent les décisions de provisionnement. Tout composant capable de surveiller l’état des applications et du réseau peut être utilisé dans le cadre d’un déploiement de cloud d’entreprise. Toutefois, le logiciel IBM Tivoli Monitoring est utilisé dans l’architecture de référence de F5 et IBM.
DNS
Le système de noms de domaine (DNS) joue un rôle essentiel dans l’architecture de référence de cloud d’entreprise de F5 et IBM. Il assure le stockage non seulement des informations relatives aux adresses IP et aux noms de domaine pour IPv4 et IPv6, mais aussi des métadonnées système, telles que les informations recueillies par le contrôleur cloud et les données d’identification uniques des machines. Pour cette architecture de référence, le DNS a été choisi comme emplacement de stockage des métadonnées, car il s’agit d’un système normalisé déjà présent dans la plupart des réseaux, accessible à tous les composants du cloud et permettant d’éviter l’ajout d’un stockage supplémentaire de type base de données à l’infrastructure. Toute solution DNS gérée par le service informatique et permettant d’ajouter des zones et des fichiers de zone supplémentaires peut être utilisée.
Stockage
Pour l’architecture de référence F5 et IBM, le contrôleur de cluster exécute la machine virtuelle à partir du stockage local. Toutefois, lorsqu’elle n’est pas en cours d’exécution, le disque virtuel de la machine virtuelle réside sur un stockage virtualisé. Lors d’un événement de provisionnement de workflow, le contrôleur de cluster demande le disque virtuel au périphérique de stockage virtuel via le protocole Network File System (NFS).
Contrôleur de mise à disposition d’applications
Le dernier composant du cloud d’entreprise est le contrôleur de mise à disposition d’applications (également appelé équilibreur de charge), qui, dans l’architecture de référence de F5 et IBM, correspond à F5® BIG-IP® Local Traffic Manager™ (LTM). BIG-IP LTM gère les connexions, les services et la distribution des données applicatives provenant de la machine virtuelle. En définitive, BIG-IP LTM est le dernier élément du système à intervenir lors d’un événement de provisionnement de workflow.
Procédures pas à pas : provisionnement manuel et automatisé
L’objectif de l’architecture de référence de cloud d’entreprise de F5 et IBM est de fournir une plateforme concrète, fondée sur les ressources, permettant de déployer dynamiquement des applications. Une fois tous les composants en place, ils fonctionnent de concert, par le biais de différents workflows, afin de provisionner de nouveaux services applicatifs selon les besoins. Il existe deux façons de provisionner les systèmes présents dans le cloud d’entreprise : le provisionnement manuel et le provisionnement automatisé.
Provisionnement manuel
En règle générale, le premier workflow dans le cloud d’entreprise est lancé à partir d’un processus manuel, sur la base des informations fournies par l’administrateur système ou le demandeur de l’application. Cela ne signifie pas que le workflow est manuel ; seule la saisie initiale des informations dans le système l’est. Une fois les données recueillies auprès de l’administrateur, le système déclenche des événements de workflow automatisés prédéfinis pour le provisionnement de l’application.
Étape 1 : saisie des données dans le contrôleur cloud
À l’aide de l’interface graphique du contrôleur cloud, l’administrateur (ou le demandeur de l’application, selon la personne chargée de lancer une nouvelle opération de provisionnement) saisit les informations nécessaires pour créer une nouvelle machine virtuelle et mettre une application en ligne. Il s’agit généralement de données d’infrastructure de haut niveau, telles que :
- Type d’application : liste prédéfinie des types d’applications disponibles, tels que Microsoft SharePoint, un serveur web, un serveur de messagerie, une base de données Oracle, etc.
- Informations réseau : adresse IP du cluster, URL frontale, indication précisant si cette application sera accessible au public ou réservée à un usage interne, etc.
- Informations de provisionnement : toute information supplémentaire requise par le système de provisionnement, telle que l’emplacement réseau (souvent une référence géographique associée à un centre de données physique, par exemple « Europe – Centre de données de Copenhague »), ainsi que toute restriction concernant le nombre minimal et maximal d’instances autorisées pour un type d’application donné.
Ces informations sont utilisées comme métadonnées pour le provisionnement automatisé dans l’ensemble du cloud d’entreprise.
Étape 2 : lancer le workflow de provisionnement ; distribuer les métadonnées
Une fois que l’administrateur a envoyé les données requises, l’étape suivante consiste, pour le contrôleur cloud, à regrouper ces informations avec un identifiant d’instance unique créé dynamiquement et utilisé dans l’ensemble du système pour identifier cette instance lors du provisionnement, tel que « vm12345 », puis à les transmettre à l’orchestrateur via le bus de messages.
Toutes les informations fournies lors de la première étape sont normalisées par le bus de messages avant d’être transmises à l’orchestrateur.
Parallèlement, le contrôleur cloud transmet à l’hyperviseur, via une API, les mêmes métadonnées et le même identifiant d’instance unique, et lui demande de déployer l’image d’application requise. Cet événement amène l’hyperviseur à demander l’image disque de machine virtuelle correspondante au stockage cloud. Le dispositif de stockage récupère l’image disque appropriée via NFS et commence à la copier vers le stockage local.
Étape 3 : l’orchestrateur distribue les métadonnées
Une fois que l’orchestrateur a reçu du bus de messages les informations normalisées sur l’événement ainsi que les métadonnées, il lance deux workflows distincts qui transmettent simultanément les métadonnées au(x) système(s) de supervision et au DNS. Le ou les systèmes de supervision utilisent ces informations pour configurer un calendrier de supervision automatisée de l’application et commencent à la superviser après avoir été informés qu’elle est opérationnelle. Au cours de cette étape, l’orchestrateur définit également des seuils pour les événements du système de supervision — par exemple, en demandant à l’outil de supervision d’envoyer une notification d’événement lorsque le taux d’utilisation du processeur de cette instance virtuelle dépasse 75 %.
L’orchestrateur transmet également les métadonnées de l’instance virtuelle au DNS, où elles sont stockées afin d’être utilisées dans l’ensemble du cloud d’entreprise. Il lui incombe de soumettre les métadonnées dans le format approprié pour la zone DNS. Il doit donc construire des noms de domaine à partir de l’identifiant de l’instance, créer des enregistrements DNS IPv4 et IPv6, ajouter les informations sur l’instance provenant du contrôleur cloud et intégrer les informations de la nouvelle instance à la zone appropriée. Par exemple, l’orchestrateur utilisera l’identifiant unique de l’instance pour créer une entrée DNS « vm12345.vm.cloud.example.com », puis l’ajoutera à la zone example.com existante.
La dernière étape de la distribution des métadonnées dans l’ensemble du cloud d’entreprise consiste à renseigner le contrôleur de mise à disposition d’applications BIG-IP LTM avec les informations de la nouvelle instance, telles que le nom d’hôte, l’adresse IP, le type d’application (ou le pool sur BIG-IP LTM) et les informations de surveillance.
Étape 4 : notification de la machine virtuelle
À l’étape 2, le contrôleur cloud a demandé à l’hyperviseur de démarrer la machine virtuelle associée à l’instance nouvellement provisionnée. Une fois cette machine virtuelle opérationnelle comme prévu et disponible pour les connexions, elle en informe l’orchestrateur au moyen d’une alerte d’événement transmise sur le bus de messages. L’orchestrateur traite alors cette alerte et lance un workflow qui demande à BIG-IP LTM de marquer la nouvelle machine virtuelle comme disponible dans le pool, puis de commencer à lui envoyer et à lui distribuer de nouvelles connexions selon la méthode d’équilibrage de charge. BIG-IP LTM commence également à surveiller la nouvelle instance à l’aide du moniteur d’application précédemment configuré et affecté au pool d’applications.
L’alerte d’événement émise par la machine virtuelle nouvellement démarrée incitera également l’orchestrateur à demander au système global de supervision du cloud d’entreprise de commencer à surveiller l’instance virtuelle. À ce stade, l’instance virtuelle nouvellement provisionnée est opérationnelle dans le cloud d’entreprise et traite les demandes de services applicatifs. Il s’agit du mode de fonctionnement normal de tous les services qui font partie du cloud d’entreprise.
Provisionnement automatisé
Le provisionnement manuel constitue la première étape du workflow de provisionnement des services au sein du cloud d’entreprise, mais ce n’est pas le mode de provisionnement le plus fréquent. Dans un système fonctionnant de manière fluide, le cloud d’entreprise évolue vers un système d’autosurveillance plus dynamique et plus souple, et provisionne automatiquement de nouveaux services en fonction des besoins et de la demande. Ce provisionnement automatique agile est au cœur de toute plateforme cloud et nécessite des événements et des workflows de provisionnement automatisé supplémentaires afin de surveiller les événements en temps réel et d’y réagir.
Étape 1 : Surveillance et alertes
La première étape de tout système de provisionnement automatique est la supervision, qui consiste à collecter et à détecter les événements dans l’ensemble du système. Lors de la première phase de provisionnement manuel, les systèmes de supervision ont été alimentés avec des informations sur les instances virtuelles, telles que leur nom, leur emplacement, le type de supervision et les seuils d’événement. Ces informations permettent de surveiller automatiquement la disponibilité et les performances des applications et des instances virtuelles. Dès qu’un événement est détecté par le système de supervision — par exemple, lorsqu’une instance virtuelle donnée consomme plus de 75 % des ressources processeur disponibles —, celui-ci génère un événement sur le bus de messages afin d’avertir l’orchestrateur de l’épuisement des ressources.
Étape 2 : collecte des données
Dans un scénario classique de provisionnement automatisé, l’orchestrateur est chargé de créer une nouvelle instance virtuelle afin d’alléger la charge en ressources de l’instance actuelle. Deux instances virtuelles ou plus seront utilisées pour répartir les charges de calcul et de réseau de l’application.
Pour lancer un workflow de provisionnement automatisé, l’orchestrateur doit collecter les événements des composants et demander les métadonnées nécessaires au provisionnement d’une nouvelle instance virtuelle. Dans l’architecture de référence de F5 et IBM, les métadonnées sont stockées dans le DNS et renseignées dans le cadre du workflow initial de provisionnement manuel. Le DNS renvoie à l’orchestrateur des informations telles que le type d’application, l’emplacement géographique et les seuils de provisionnement.
Étape 3 : lancement du workflow
Lors de la dernière étape d’un workflow de provisionnement automatisé, l’orchestrateur transmet au contrôleur cloud, via le bus de messages, les métadonnées obtenues auprès du DNS. Cette étape automatisée simule en substance celle au cours de laquelle un administrateur saisit les informations relatives à la machine et lance manuellement le workflow de provisionnement. Le contrôleur cloud reçoit ces informations (comme il les recevrait de l’administrateur dans le cadre d’un provisionnement manuel) et lance un nouveau workflow de provisionnement d’instance virtuelle. À partir de là, les étapes et workflows de provisionnement décrits ci-dessus sont répétés jusqu’à ce que la nouvelle instance virtuelle soit opérationnelle et accepte de nouvelles connexions.
Un déploiement cloud d’entreprise classique comprend à la fois des workflows de provisionnement manuels et automatisés. Les nouveaux services ou applications sont initialement déployés à l’aide d’un workflow manuel afin qu’un administrateur puisse contrôler comment et où le service est déployé. Une fois le service opérationnel, les workflows de provisionnement automatisés gèrent le provisionnement en fonction des besoins en ressources et de leur disponibilité.
Conclusion
Le choix de déployer un cloud privé d’entreprise ne doit pas se faire au prix d’une complexité accrue ou de problèmes d’interopérabilité. Tout déploiement cloud vise à faciliter la création de nouveaux services et à fournir une infrastructure informatique plus agile. Un cloud d’entreprise apporte cette agilité au centre de données, tout en améliorant considérablement la facilité de gestion et le contrôle.
En collaboration avec IBM, F5 a créé une architecture de référence pour un cloud d’entreprise à provisionnement automatique. Cette architecture est conçue pour être modulaire et flexible, afin de permettre l’intégration de composants existants selon les besoins et la connexion de l’ensemble du cloud d’entreprise à toute autre plateforme cloud via des API et une infrastructure de messagerie partagée. Aucun cloud d’entreprise privé n’est tout à fait identique à un autre. Toutefois, l’architecture de F5 et IBM s’adapte à différents environnements, tout en offrant les avantages d’une infrastructure agile à tout déploiement d’applications ou centre de données.
1 Babcock, Charles (18 janvier 2011). « Les clouds privés prennent leur essor. » Information Week. Web.
PUBLIÉ LE 10 JANVIER 2012