Évaluation des techniques et technologies en vue de l’adoption du modèle Zero Trust
Par Mudit Tyagi et Ken Arora
Après avoir examiné le « pourquoi » —les principes directeurs1 — du modèle Zero Trust, il convient ensuite de s’intéresser au « comment » — les techniques et technologies utilisées pour mettre en œuvre ces principes.
Dans une perspective plus large, les principes du modèle Zero Trust peuvent être appliqués à l’ensemble du cycle de vie du développement des applications, notamment à la conception du système, aux plateformes matérielles utilisées et aux procédures d’approvisionnement.2 Toutefois, ce document aborde les aspects opérationnels de la mise en œuvre du modèle Zero Trust pour protéger les applications et les données lors de leur exécution.
Techniques et technologies
De manière générale, la sécurité Zero Trust s’appuie sur des technologies pour atteindre l’un des trois objectifs distincts suivants :
- Appliquer des contraintes transactionnelles : Qui peut faire Quoi à Qui.
- Fournir à l’opérateur humain du système une bonne compréhension de la situation.
- Mettre en œuvre des mesures plus avancées de réduction des risques et de remédiation, en s’appuyant sur les indicateurs de suspicion assistés par l’apprentissage automatique (ML) et sur le profil risque-rendement de la ou des transactions concernées.
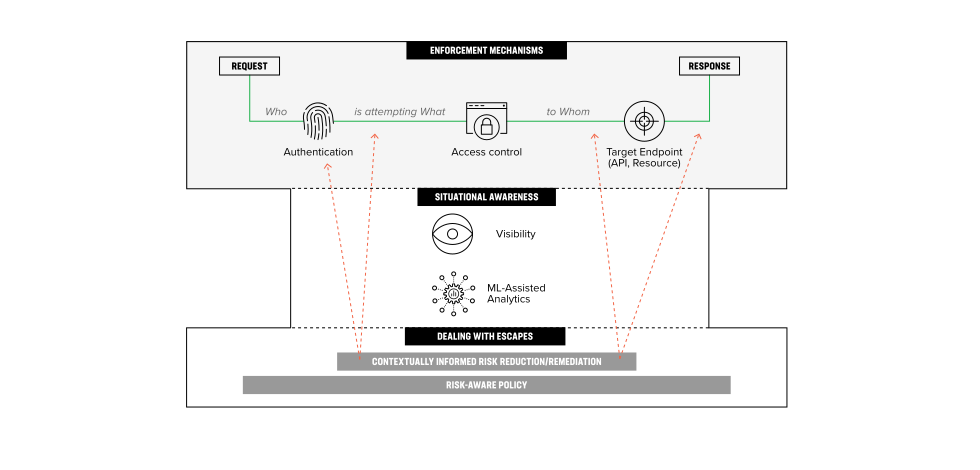
Le schéma suivant illustre ce modèle transactionnel global de sécurité Zero Trust. Les sections suivantes examinent plus en détail chaque catégorie de technologies.
Mise en application : authentification et contrôle d’accès
Motivations
Les deux premières technologies — l’authentification et le contrôle d’accès — sont étroitement liées et découlent directement des principes de « vérification explicite » et de « moindre privilège », puisqu’elles sont au cœur de l’application du principe déterminant «Qui peut faire Quoi ». Les implémentations plus sophistiquées de l’authentification surveillent en permanence le comportement d’un acteur, conformément à l’approche d’« évaluation continue ».
Authentification
Les technologies d’authentification visent à établir la confiance dans une identité attestée : Qui intervient dans une transaction. Le processus d’authentification comporte trois composantes :
- L’acteur formule une attestation, ou déclaration, indiquant son identité.
- Certaines données, généralement fournies par l’acteur, prouvent la véracité de l’attestation.
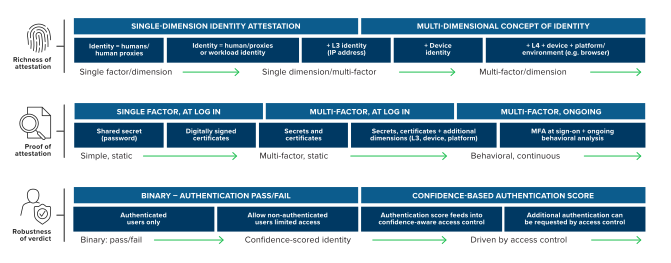
- Le système émet un verdict ou prend une décision quant à la probabilité que l’attestation soit exacte — l’acteur est bien celui qu’il prétend être. Le graphique ci-dessous présente les différents aspects de l’authentification ainsi que les modèles de maturité associés à chacun d’eux. Il est suivi d’une analyse approfondie de chaque aspect.
Attestation
La forme la plus élémentaire d’attestation est souvent désignée par le terme « utilisateur » : un être humain, ou un agent agissant pour le compte d’un être humain, qui souhaite effectuer une transaction. Toutefois, dans le cas d’une architecture Zero Trust utilisée au sein d’une application, un acteur peut être une charge de travail (telle qu’un processus, un service ou un conteneur) ; le concept général d’identité doit donc inclure ce type d’acteurs. Dans d’autres cas, la notion de Qui englobe non seulement l’être humain ou la charge de travail, mais aussi d’autres considérations ou dimensions de l’identité. Dans cette perspective, les dimensions supplémentaires de l’identité peuvent inclure l’appareil ou la plateforme de l’utilisateur ou de la charge de travail, l’écosystème utilisé pour l’interaction ou encore l’emplacement de l’agent. Par exemple, une utilisatrice nommée « Alice » peut se trouver sur un PC identifié par l’étiquette « ABC- 0001 », utiliser une instance de navigateur spécifique dotée d’une empreinte numérique et se connecter depuis l’adresse IPv4 10.11.12.13.
Preuve d’identité
Certains systèmes permettent aux utilisateurs non authentifiés, parfois appelés utilisateurs « invités » ou « anonymes », d’effectuer un nombre limité de transactions. Pour ces systèmes, les étapes supplémentaires consistant à prouver son identité et à obtenir une décision du système ne sont pas pertinentes. Toutefois, pour toute identité déclarée spécifique, les méthodes suivantes sont couramment utilisées pour étayer cette déclaration :
- Connaissance d’un secret partagé, tel qu’un mot de passe.
- Un type d’identifiant fourni par un tiers de confiance, tel qu’un certificat signé.
- Interrogation — automatisée (comme la prise d’empreinte de l’appareil) ou active (comme un test CAPTCHA) — de l’utilisateur, de la charge de travail ou de la plateforme.
- Métadonnées relatives à l’acteur, telles que la géolocalisation, la réputation de l’adresse IP ou l’heure d’accès.
- Analyse comportementale, telle que l’analyse biométrique passive ou les schémas d’interaction avec l’application au sein des processus de travail.
Souvent, lorsqu’un degré de confiance élevé est requis, plusieurs méthodes sont utilisées. C’est notamment le cas dans le modèle Google BeyondCorp,3 qui exige une authentification multifacteur (MFA) avant d’autoriser les transactions à plus forte valeur. Les solutions d’authentification les plus sophistiquées associent un « niveau de confiance » à chaque identité et définissent un niveau de confiance minimal pour chaque type de transaction, en fonction de sa valeur et du risque qu’elle présente.
Authentification statique ou dynamique
Enfin, il convient de noter que certaines de ces méthodes ne sont pas des actions statiques et ponctuelles, mais qu’elles peuvent et doivent s’inscrire dans la durée, conformément au principe d’« évaluation continue ». Dans ce cas, le score de confiance attribué à l’attestation d’identité peut augmenter ou diminuer au fil du temps. Par exemple, l’empreinte numérique du navigateur ou l’adresse IP peut changer au cours d’une même session utilisateur, ce qui pourrait être considéré comme suspect et réduire le niveau de confiance. À l’inverse, à mesure que davantage de données sont recueillies sur le comportement de l’acteur au cours d’une session, le score de confiance peut augmenter ou diminuer selon la manière dont le comportement actuel se compare aux observations antérieures.
Dans les systèmes plus avancés, l’authentification dynamique peut fonctionner de concert avec le contrôle d’accès. À un premier niveau d’interaction, la politique de contrôle d’accès peut définir un score de confiance minimal pour différentes catégories de transactions, comme indiqué précédemment. Au niveau suivant, le sous-système de contrôle d’accès peut transmettre des informations au sous-système d’authentification, généralement en demandant une authentification supplémentaire afin d’augmenter le score de confiance jusqu’au seuil minimal.
Contrôle d’accès
Après avoir utilisé des techniques d’authentification pour déterminer qui intervient dans une transaction, les questions suivantes sont : qu’est-ce que cet acteur est autorisé à faire ? Et auprès de qui ? C’est le domaine des technologies de contrôle d’accès.
Pour prendre une analogie avec la sécurité physique, imaginez que vous souhaitiez visiter une base militaire. Après avoir déterminé avec certitude si vous êtes un civil, un responsable politique ou un militaire, les gardes s’appuieraient sur cette information pour décider dans quels bâtiments vous pourriez entrer et si vous pourriez emporter un appareil photo dans chacun des bâtiments auxquels vous seriez autorisé à accéder. La politique régissant ces choix pourrait être très générale et s’appliquer à tous les bâtiments (par exemple, « les responsables politiques peuvent entrer dans n’importe quel bâtiment »), ou être plus précise (par exemple, « les responsables politiques ne peuvent entrer que dans les bâtiments <A> et <B>, mais ne peuvent emporter un appareil photo que dans le bâtiment <A> »).
Dans le contexte de la cybersécurité, les techniques de contrôle d’accès doivent respecter le principe de « moindre privilège » propre au modèle Zero Trust. Autrement dit, une politique de contrôle d’accès optimale n’accorderait à l’acteur que les privilèges strictement nécessaires et lui refuserait tous les autres. En outre, une politique robuste idéale serait subordonnée à un niveau minimal précis de confiance dans l’authenticité de l’identité de l’acteur, le seuil de confiance étant défini pour chaque privilège accordé.
Par conséquent, la valeur d’une solution de contrôle d’accès peut être évaluée en fonction de son degré d’alignement sur ces principes. Plus précisément, une solution de sécurité Zero Trust doit intégrer un contrôle d’accès, et la technologie employée doit être évaluée selon les dimensions présentées ci-dessous et décrites par la suite.
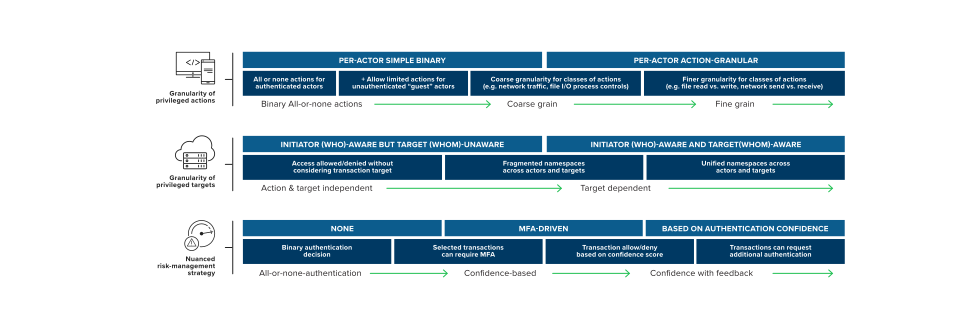
- Quel est le niveau de granularité des privilèges de contrôle d’accès ?
- Quel est le niveau de granularité de l’action — le « quoi » dans la transaction ? S’agit-il de :
- Binaire: autoriser « toutes » les transactions ou « aucune ». Dans l’analogie de la base militaire, cela reviendrait à dire que « tous les soldats peuvent entrer dans n’importe quel bâtiment et faire tout ce qu’ils veulent » et que « les civils ne peuvent entrer dans aucun bâtiment ».
- Grossier: Granularité au niveau du point de terminaison de l’API ou du « type » de transaction (comme les E/S de fichiers, les communications réseau et le contrôle des processus). Dans notre exemple, cela permettrait de nuancer les actions autorisées, par exemple : « les responsables politiques peuvent entrer dans les bâtiments, mais pas prendre de photos ».
- Fin: Au niveau de la sous-API (c’est-à-dire en fonction des paramètres ou de la version de l’API) ou du « sous-type » de transaction (comme l’accès en lecture seule aux fichiers ou la réception TCP uniquement). Pour reprendre une dernière fois notre analogie, cela permettrait des contrôles plus précis, par exemple : « les civils ne peuvent entrer dans les bâtiments que s’ils sont accompagnés d’un soldat ».
- Existe-t-il un niveau de granularité concernant la cible de l’action — le « qui » de la transaction ? S’agit-il :
- Sans granularité au niveau de la cible : la politique de contrôle d’accès ne tient pas compte de la cible de l’action. Dans notre exemple, cette approche correspondrait à un niveau de granularité permettant d’autoriser l’accès à certains bâtiments, mais pas à d’autres, les bâtiments étant la cible de l’action « entrer ».
- Granularité par cible, au niveau de l’infrastructure: la politique de contrôle d’accès peut prendre en compte la cible de l’action, mais utilise une balise ou une étiquette propre à l’infrastructure, telle que l’adresse IP, le nom DNS ou le nom du conteneur Kubernetes (K8S) de la cible. La politique pourrait ainsi s’appliquer au niveau de chaque bâtiment, mais chaque base militaire pourrait utiliser une convention de nommage différente pour ses bâtiments.
- Granularité au niveau de la cible, avec prise en compte de l’identité : la politique de contrôle d’accès peut inclure la cible de l’action et l’identifier à l’aide du même espace de noms d’identité (par exemple, SPIFFE) que celui utilisé pour l’acteur (le « qui »). Par rapport à l’approche précédente, cette méthode présente l’avantage de permettre à toutes les bases militaires d’utiliser un système cohérent pour identifier les bâtiments, ce qui rend la politique plus facilement transposable.
- Quel est le niveau de granularité de l’action — le « quoi » dans la transaction ? S’agit-il de :
- Comment la solution de contrôle d’accès prend-elle en compte la notion d’actions plus ou moins risquées ?
- Non sensible au risque: la solution de contrôle d’accès traite tous les privilèges de contrôle d’accès de manière identique lorsqu’il s’agit de décider d’autoriser ou d’interdire l’action.
- Gestion des risques via l’authentification multifacteur: La solution de contrôle d’accès gère les risques en permettant à la politique de préciser que certaines transactions autorisées doivent néanmoins faire l’objet d’une authentification multifacteur, en fonction de l’acteur (Qui), de l’action (Quoi), ou de la cible (À qui) concernés par la transaction.
- Gestion des risques fondée sur le niveau de confiance : la solution de contrôle d’accès gère les risques en permettant à la politique de spécifier que toute transaction peut néanmoins exiger un niveau de confiance minimal dans l’authenticité de l’acteur, en fonction de l’action (« Quoi ») et de la cible (« Qui ») de la transaction. L’authentification multifacteur peut accroître ce niveau de confiance, bien que d’autres moyens puissent être utilisés ; dans d’autres cas, la transaction peut être totalement refusée si elle présente une valeur élevée et que l’authenticité de l’acteur est jugée trop incertaine.
Compte tenu du principe d’« évaluation (et réévaluation) continue », le degré de confiance accordé à l’authenticité de l’acteur doit évoluer au fil du temps. Dans une solution simple, il peut s’agir d’un simple délai d’expiration ; dans des systèmes plus sophistiqués, le niveau de confiance peut varier en fonction des observations du comportement de l’acteur au fil du temps.
Connaissance de la situation : motivations liées à la visibilité et à l’analyse contextuelle assistée par le ML
Si l’authentification et le contrôle d’accès mettent en œuvre les approches « toujours vérifier » et « moindre privilège », alors la visibilité et l’analyse contextuelle constituent le fondement des principes « évaluer en continu » et « présumer une compromission ».
La visibilité est le préalable indispensable à l’analyse : un système ne peut pas atténuer les risques qu’il ne peut pas détecter. Ainsi, l’efficacité de la solution de sécurité Zero Trust sera directement proportionnelle à la profondeur et à l’étendue des données de télémétrie pouvant être recueillies à partir des opérations du système et du contexte externe. Toutefois, une infrastructure de visibilité moderne sera capable de fournir bien plus de données, de métadonnées et d’éléments contextuels potentiellement utiles qu’un être humain non assisté ne pourrait raisonnablement traiter dans les délais impartis. Face au besoin de disposer de davantage de données et de les transformer plus rapidement en informations exploitables, l’assistance automatisée des opérateurs humains constitue donc une exigence essentielle.
Cette assistance est généralement mise en œuvre à l’aide d’algorithmes automatisés couvrant un large éventail d’approches, de l’analyse fondée sur des règles aux algorithmes avancés d’apprentissage automatique, en passant par les méthodes statistiques. Ces algorithmes transforment le flot massif de données brutes en une connaissance de la situation exploitable et opérationnelle, que les opérateurs humains peuvent utiliser pour procéder à une évaluation et, si nécessaire, prendre des mesures correctives. C’est pourquoi l’analyse assistée par l’apprentissage automatique va de pair avec la visibilité.
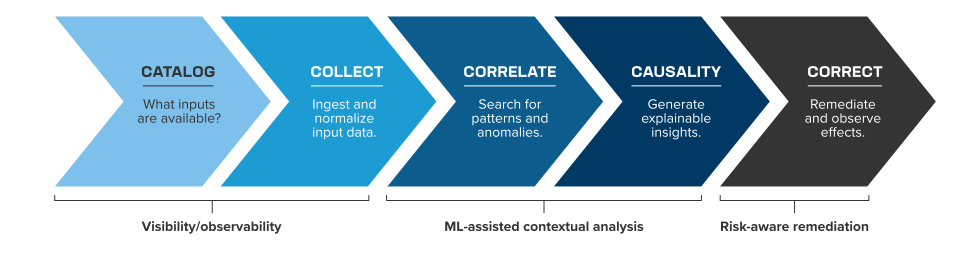
Le pipeline général allant des données brutes (visibilité) à l’action (remédiation) est présenté ci-dessous :
Visibilité
La visibilité correspond à la mise en œuvre — au « comment » — du principe Zero Trust d’« évaluation continue ». Elle consiste notamment à tenir un inventaire des sources de données disponibles (Catalog) et à assurer la télémétrie en temps réel ainsi que la conservation des données historiques (Collect).
La maturité de la mise en œuvre de la visibilité dans le cadre d’une approche Zero Trust doit être évaluée selon quatre facteurs :
- Latence : Dans quelle mesure les données sont-elles proches du temps réel ?
La latence détermine le délai minimal dans lequel il est possible de réagir à une menace potentielle. La latence d’une solution Zero Trust doit se mesurer en secondes, voire moins ; dans le cas contraire, toute analyse, aussi précise soit-elle, risque fort d’arriver trop tard pour empêcher les conséquences de l’exploitation, telles que l’exfiltration ou le chiffrement de données, ou encore l’indisponibilité due à l’épuisement des ressources. Les systèmes plus sophistiqués peuvent permettre des mesures d’atténuation synchrones et asynchrones. Une mesure d’atténuation synchrone empêcherait la finalisation de la transaction tant que la visibilité et l’analyse complètes ne seraient pas achevées. Comme ce type de mesure est susceptible d’accroître la latence de la transaction, ce mode de fonctionnement serait réservé aux transactions particulièrement anormales ou risquées, tandis que toutes les autres transactions pourraient envoyer des données de télémétrie et être analysées de manière asynchrone. - Exploitabilité : Dans quelle mesure les données sont-elles facilement exploitables ?
Cette question est pertinente lorsque les données proviennent de plusieurs sources ou de différents types de capteurs, ce qui est fréquent. Ce facteur se décompose généralement en deux sous-problématiques.
Au niveau syntaxique, il s’agit de déterminer comment les données peuvent être extraites et représentées. Par exemple, si la réputation d’une adresse IP source se présente sous la forme d’un champ textuel (tel que « malveillante », « suspecte », « inconnue », etc.) dans un message syslog provenant d’une source, et sous la forme d’un champ numérique à encodage binaire dans un fichier de données provenant d’une autre source, il convient de définir une représentation canonique. La sérialisation des données sera nécessaire pour extraire et transformer les données entrantes dans cette représentation.
Au niveau sémantique, les différentes sources peuvent varier non seulement par leur syntaxe et leur mode de transport, mais aussi par leur sémantique. Pour reprendre l’exemple de la réputation d’une adresse IP, un fournisseur peut attribuer un score de menace numérique, tandis qu’un autre peut classer l’adresse IP dans une catégorie telle que « nœud TOR », « contrôle DNS » ou « hameçonnage ». La solution de visibilité doit également fournir un mécanisme permettant de normaliser les données entrantes selon une syntaxe cohérente. - Exhaustivité : Quelle est l’étendue et la profondeur des données disponibles ?
L’un des principaux avantages d’une solution de visibilité de haute qualité est sa capacité à détecter les activités suspectes pouvant indiquer une éventuelle compromission. Pour y parvenir efficacement, la solution doit recevoir des données de télémétrie provenant de toutes les « couches » pertinentes de la mise à disposition des applications : l’application elle-même, bien sûr, mais aussi l’infrastructure applicative, l’infrastructure réseau, tous les services appliqués à l’application ou utilisés par celle-ci, et même les événements survenant sur l’appareil client. Par exemple, le fait qu’un utilisateur se connecte depuis un nouvel appareil, jamais détecté auparavant, peut être légèrement suspect en soi ; mais lorsque cette information est associée à des données réseau (telles qu’une géolocalisation GeoIP indiquant un pays étranger), le niveau de suspicion augmente. Ce niveau de suspicion se traduit par un score de confiance plus faible quant à l’identité de l’utilisateur. Dans le cadre d’une politique de sécurité Zero Trust, lorsque cet acteur tente d’effectuer une transaction à forte valeur (comme un transfert de fonds vers un compte à l’étranger), la solution de contrôle d’accès peut décider de bloquer la transaction en raison de ce faible niveau de confiance.
Dans une approche Zero Trust, plus la solution de visibilité est approfondie et complète, plus le système peut limiter les transactions de manière appropriée et détecter efficacement les compromissions. - Gouvernance : Dans quelle mesure les exigences légales et les exigences liées aux licences en matière d’utilisation des données sont-elles prises en charge ?
Enfin, toute collecte de données doit être conforme aux exigences légales et aux exigences liées aux licences concernant la sécurité, la conservation et l’utilisation des données. Une solution de visibilité robuste doit donc répondre à chacun de ces besoins. Les contraintes d’utilisation des données imposées par la gouvernance doivent être prises en compte dans une solution de visibilité fondée sur le modèle Zero Trust. Par exemple, si une adresse IP est considérée comme une information à caractère personnel (PII), son utilisation et sa conservation à long terme à des fins d’analyse doivent respecter les usages autorisés.
Analyse contextuelle assistée par machine
Outre la visibilité, l’autre dispositif nécessaire à la mise en œuvre de l’« évaluation continue » est l’outillage analytique permettant de réaliser une évaluation pertinente, c’est-à-dire une évaluation pouvant être exploitée par une solution Zero Trust.
L’un des aspects à prendre en compte lors de l’analyse est l’étendue et la diversité des données d’entrée. Les algorithmes d’analyse peuvent se limiter à un seul flux de données provenant d’une source unique, ou examiner plusieurs flux issus de diverses sources de données et de toutes les couches de l’infrastructure et de l’application.
- La contextualisation la plus élémentaire s’effectue dans le périmètre d’un seul « type » ou « flux » de données (par exemple, un flux d’événements contenant des « informations de connexion des utilisateurs avec l’heure et l’adresse IP source »), généralement en tenant compte du contexte historique et/ou des données de plusieurs utilisateurs. Cette analyse peut fournir des informations élémentaires, telles que « cet utilisateur <X> ne s’est jamais connecté à cette heure de la journée » ou « cet utilisateur <X> semble toujours se connecter immédiatement après l’utilisateur <Y> ». Le premier constat peut réduire le niveau de confiance dans l’identité ; le second peut révéler un schéma plus global, potentiellement malveillant.
- Une contextualisation plus avancée prend en compte la dimension temporelle et les instances multiples, non seulement pour un seul « type » de données, mais établit également des corrélations temporelles entre différents « types » ou « flux » de données. Par exemple, il peut s’agir de corréler les données de connexion des utilisateurs avec des actions spécifiques au niveau applicatif (telles qu’un transfert d’argent ou la mise à jour des coordonnées d’un contact de messagerie) ou au niveau réseau (telle qu’une recherche de géolocalisation basée sur l’adresse IP).
Un deuxième aspect particulièrement pertinent de l’analyse dans le cadre du modèle Zero Trust consiste à gérer le volume et le débit des données ingérées, qui dépasseront les capacités d’assimilation de tout être humain. Une forme d’assistance automatisée est donc nécessaire pour produire des informations exploitables par l’humain. Là encore, le degré de sophistication de cette assistance peut être décrit comme une progression.
- Visualisation uniquement : La première étape consiste en une simple présentation des statistiques et des événements, généralement au moyen de tableaux de bord accessibles depuis un portail de gestion. Les données présentées reposent sur les flux de données collectés (généralement une série chronologique ou une coupe longitudinale des utilisateurs ou des transactions sur une période déterminée). Les tableaux de bord plus avancés permettent de trier et de regrouper les données, ainsi que de les examiner en détail grâce à des filtres. Dans ce modèle, l’humain se charge de l’exploration des données, de la hiérarchisation des événements, de l’analyse et des mesures correctives, l’automatisation facilitant principalement l’exploration des données.
- Visualisation avec règles statiques configurables : L’extension la plus courante de la visualisation consiste à permettre à l’utilisateur de définir des règles statiques, à des fins d’alerte ou de remédiation. Voici quelques exemples de telles règles : « notifier l’utilisateur <John> si <la charge du processeur dépasse 80 % pendant 5 minutes> » ou « exiger <une authentification multifacteur par e-mail> si <l’API [Y] est appelée et que le pays n’est pas [États-Unis]> ». Ces règles peuvent se limiter à des règles prédéfinies par le fournisseur de la solution. Les sous-systèmes plus avancés fondés sur des règles peuvent également autoriser des règles personnalisées écrites par un ingénieur SecOps. Dans les deux cas, les règles appliquées sont généralement contrôlées (et définies, si nécessaire) par le biais de la configuration.
- Visualisation avec assistance par apprentissage automatique : Le niveau suivant fait appel à des techniques plus avancées permettant de détecter des anomalies comportementales et/ou des transactions correspondant aux schémas de transactions malveillantes précédemment identifiées. Bien que de nombreuses techniques soient utilisées (et qu’une analyse approfondie des compromis techniques et commerciaux dépasse le cadre de ce document), certains points essentiels sont à prendre en compte :
- Intervention humaine requise : Certaines techniques d’apprentissage automatique nécessitent un « entraînement » (autrement dit, un apprentissage supervisé), ce qui signifie qu’un corpus de données de taille raisonnable doit être préalablement catégorisé à l’aide d’un « classificateur » fiable et digne de confiance. Souvent, pour garantir une catégorisation fiable, le « classificateur » est en définitive une personne ou un groupe de personnes. Dans ce cas, il convient de prendre en compte l’intervention humaine nécessaire. D’autres techniques (autrement dit, l’apprentissage non supervisé) détectent les anomalies et/ou reconnaissent les schémas de manière autonome, sans intervention humaine.
- Explicabilité : Les résultats produits par un système d’apprentissage automatique découlent de l’évaluation des données d’entrée au regard d’un modèle. Ce modèle peut reposer sur une série de questions simples auxquelles il est facile de répondre, telles que : « Cet utilisateur a-t-il été vu sur cet appareil au cours du mois dernier ? » Il peut également s’appuyer sur une similitude facile à expliquer, par exemple : « Cet utilisateur correspond au profil général que j’ai observé chez les utilisateurs qui ne se connectent jamais pendant les heures de travail. » Dans d’autres cas, le modèle peut reposer sur l’application d’un ensemble complexe d’opérations d’algèbre vectorielle aux données d’entrée, sans logique de haut niveau facilement discernable. Ce dernier cas est clairement moins explicable — il s’apparente davantage à une « boîte noire » — que les deux exemples précédents. Dans certains cas, l’explicabilité est un facteur important pour la compréhension humaine ou l’auditabilité. Dans ces situations, un modèle explicable sera nettement préféré à un modèle impénétrable.
- Disponibilité d’un score de confiance : Comme indiqué précédemment, une mesure indiquant le degré de confiance du modèle dans une décision — autrement dit, donnant une idée de la probabilité relative d’un faux positif ou d’un faux négatif — est souvent très utile. Certains algorithmes produisent naturellement une mesure de confiance ; pour d’autres, notamment ceux fondés sur des règles, un niveau de confiance doit être explicitement défini comme l’une des sorties. Dans les deux cas, les algorithmes capables de fournir un score de confiance sont plus robustes que ceux qui ne le peuvent pas.
Comme pour l’approche fondée sur des règles, l’assistance par apprentissage automatique peut être utilisée uniquement à des fins de détection ou être associée à une remédiation automatique. Elle peut également être combinée à un système fondé sur des règles, dans lequel le « verdict » (ou l’avis ou le niveau de confiance) du modèle peut servir de donnée d’entrée pour une règle, par exemple : « effectuer l’action <X> si <l’évaluateur ML [bot_detector_A] signale un bot avec un niveau de confiance supérieur à 90 %> ».
Gestion des contournements : remédiation automatisée fondée sur les risques
Le dernier principe de l’approche « zéro rouille » consiste à « partir du principe qu’une compromission aura lieu ». Pour être clair et remettre les choses en perspective, les méthodes d’authentification et de contrôle d’accès correctement mises en œuvre permettent d’empêcher l’immense majorité des transactions malveillantes. Toutefois, par excès de prudence, il convient de supposer que les mécanismes d’application de l’authentification et du contrôle d’accès finiront par être contournés par un adversaire suffisamment motivé ou chanceux. La détection des compromissions, indispensable pour réagir rapidement à ces incidents, nécessite une bonne visibilité et une analyse assistée par ordinateur. C’est donc précisément parce que les autres mécanismes de protection seront parfois mis en échec que les technologies de visibilité alimentant une analyse contextuelle assistée par l’apprentissage automatique sont essentielles à la solution de dernier recours de la sécurité zéro confiance : la remédiation fondée sur les risques.
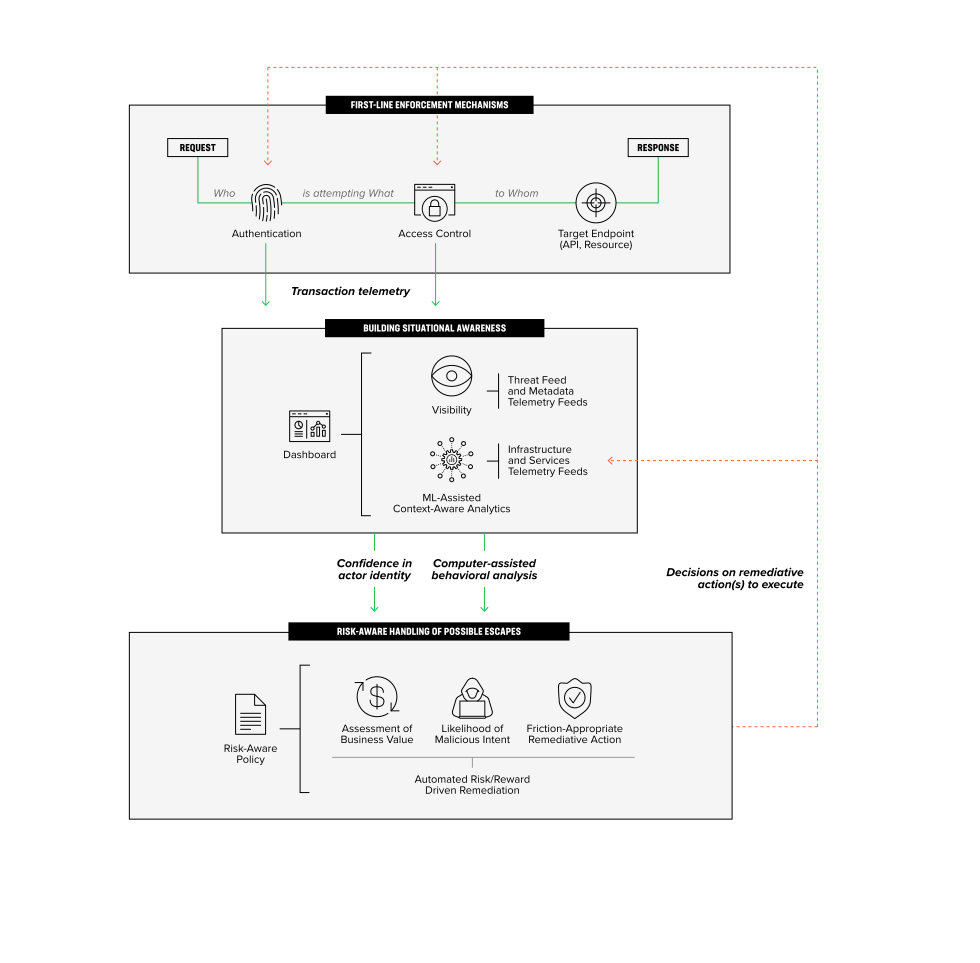
Dans les cas de « faux négatifs », où une transaction réellement malveillante a réussi à contourner l’authentification et le contrôle d’accès, le mécanisme de remédiation automatisée fondée sur les risques doit être utilisé comme ultime filet de sécurité. Toutefois, cette technologie intervenant en dernier recours pour les transactions ayant franchi les contrôles préalables, le risque est plus élevé de requalifier à tort un « vrai négatif » (une transaction valide et souhaitable) en « faux positif » (une transaction signalée à tort comme malveillante). Pour limiter ce risque, toute mesure de remédiation déclenchée en raison d’un soupçon d’activité malveillante qui, d’une manière ou d’une autre, n’aurait pas été détectée par l’authentification ou le contrôle d’accès doit reposer sur les trois facteurs suivants :4
- Valeur commerciale de la transaction : Les transactions présentent différents niveaux de risque et de bénéfice. Par exemple, la consultation d’un compte bancaire est moins risquée qu’un virement vers un compte à l’étranger. De même, pour une compagnie aérienne, l’achat d’un billet est susceptible de générer un bénéfice commercial plus important que la consultation des retards de vols en cours. La valeur commerciale correspond au bénéfice commercial potentiel, pondéré en fonction du profil de risque de la transaction. Il est plus acceptable de tolérer les éventuels « faux positifs » résultant d’une remédiation préventive pour les transactions à faible bénéfice et à haut risque que pour celles à bénéfice élevé et à faible risque, qui présentent une forte valeur commerciale.
- Degré de confiance dans la « malveillance » présumée : Bien entendu, toutes les recommandations de remédiation spéculative ne se valent pas. Plus précisément, outre le rapport risque-récompense mentionné ci-dessus, l’autre facteur clé est le degré de confiance dans les hypothèses relatives à cette transaction, notamment la confiance dans l’identité attestée de l’acteur. En résumé, la probabilité d’un « faux négatif » — c’est-à-dire la probabilité que les mécanismes de contrôle ne se soient pas déclenchés alors qu’ils auraient dû — est inversement proportionnelle au degré de confiance accordé à l’acteur. Et puisque la remédiation fondée sur les risques vise à réduire les « faux négatifs », plus le degré de confiance est faible, plus le système doit être enclin à appliquer des mesures de remédiation.
- Impact de la remédiation : Enfin, toutes les mesures de remédiation ne se résument pas à une décision binaire — autoriser ou bloquer. Il existe en effet diverses techniques de réduction des risques, allant de celles qui sont visibles par l’utilisateur (par exemple, demander des identifiants supplémentaires ou une authentification multifacteur, ou proposer un test tel qu’un CAPTCHA) à celles qui lui sont pratiquement invisibles (effectuer une inspection plus approfondie du trafic, notamment à l’aide d’une solution DLP, ou réaliser une analyse plus poussée et exigeante en ressources de calcul). L’impact de ces formes supplémentaires de réduction des risques — mesuré en fonction des contraintes subies par l’utilisateur et des coûts opérationnels pour l’application (par exemple, ceux liés à la DLP ou à une analyse exigeante en ressources de calcul) — constitue donc le troisième facteur à prendre en compte. Les mesures de remédiation à faible impact et transparentes pour le client sont préférables aux tests à plus fort impact visibles par celui-ci, tandis que le blocage pur et simple de la transaction est l’option la moins souhaitable. Toutefois, le blocage peut être approprié lorsque le niveau de confiance est élevé, ou pour les transactions risquées dont le niveau de confiance ne peut pas être suffisamment renforcé par les autres mécanismes de réduction des risques.
Conclusions
La sécurité Zero Trust est une approche plus moderne que les précédentes stratégies de sécurité, telles que la défense en profondeur. Elle prolonge les pratiques existantes en adoptant une vision de la sécurité centrée sur les transactions : Qui tente de faire Quoi à Qui. Cette approche permet de sécuriser non seulement les accès externes à une application, mais aussi les composants internes de celle-ci.5 Fondée sur cette vision transactionnelle, la sécurité Zero Trust repose sur un ensemble de principes fondamentaux visant à protéger les applications dans l’environnement actuel, plus complexe et exigeant. Ces principes sont ensuite associés à un ensemble de solutions, ou méthodes, au niveau des sous-systèmes qui les mettent en œuvre. Les principes fondamentaux et leur correspondance avec les méthodes de mise en œuvre sont résumés ci-dessous.
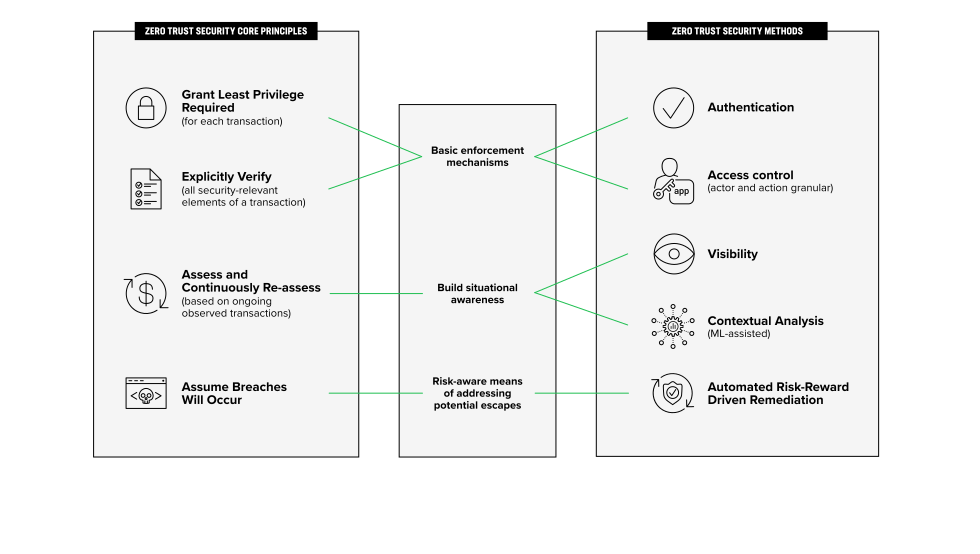
Ces outils — méthodes d’authentification, de contrôle des accès, de visibilité, d’analyse contextuelle et de remédiation tenant compte des risques — sont nécessaires et suffisants pour prévenir une grande variété de types d’attaques.
Ressources
1 https://www.f5.com/services/resources/white-papers/why-zero-trust-matters-for-more-than-just-access
2 Le modèle Zero Trust peut, et devrait, être appliqué même « en amont » du pipeline CI/CD. Les outils tels que les outils d’évaluation des vulnérabilités, l’analyse statique, les bases de données de CVE, les bases de données sur la réputation du code open source et les systèmes de surveillance de l’intégrité de la chaîne d’approvisionnement sont conformes à l’approche Zero Trust.
3 https://cloud.google.com/beyondcorp-enterprise/docs/quickstart
4 Notez que la frontière entre le contrôle d’accès contextuel tenant compte des risques et le sujet plus général de la remédiation tenant compte des risques est floue, et qu’il existe un certain chevauchement.
5 Souvent appelée protection intra-applicative « Est-Ouest », par opposition à la protection « Nord-Sud » des accès à l’application.