
Sécurité Zero Trust : pourquoi le Zero Trust est essentiel (et pas seulement pour les accès)
Résumé
Ces dernières années, le concept de « zéro confiance » s’est imposé comme l’un des thèmes majeurs en matière d’accès aux réseaux et aux applications. Dans cet article, nous montrons que la zéro confiance repose fondamentalement sur un petit ensemble de principes simples, applicables non seulement au contrôle des accès, mais aussi, plus largement, à l’ensemble du domaine de la cybersécurité.
Ce document présente un cadre englobant les grands concepts liés au modèle Zero Trust et les met en perspective avec le contexte commercial actuel qui guide les responsables de la sécurité des applications. Enfin, il décrit le système de convictions sur lequel repose le modèle Zero Trust, moteur des outils et des dispositifs de sécurité destinés à faire face aux menaces actuelles et émergentes, qui feront l’objet d’un prochain document.
Ce livre blanc poursuit un double objectif : premièrement, présenter l’approche de la sécurité que les responsables métier des applications devraient adopter et, deuxièmement, introduire un cadre destiné aux professionnels de la sécurité, que nous approfondirons dans de futurs livres blancs.
ZTS : commencez par les principes, pas par les technologies
Le terme « zero trust » est associé à différents concepts situés à divers niveaux d’abstraction : il désigne parfois une architecture de solution spécifique, parfois une recommandation visant à mettre en œuvre des technologies particulières, et parfois encore une propriété d’un produit. Nous estimons que la sécurité zero trust est avant tout un état d’esprit — un système de convictions — dont découlent des techniques et des tactiques qui s’appuient sur des technologies spécifiques, lesquelles peuvent ensuite être mises en œuvre pour faire face à un large éventail de menaces de sécurité.
Le système de croyances qui sous-tend la sécurité Zero Trust (ZTS) peut être considéré comme l’étape suivante de l’évolution d’une approche de la sécurité amorcée il y a plusieurs années avec la « défense en profondeur ». Celle-ci repose sur l’idée que, même si chaque dispositif de défense pris isolément présente un risque faible mais réel d’être compromis, l’ajout de couches de protection supplémentaires pour les actifs critiques réduit ce risque, ralentit les attaquants et les contraint à mobiliser davantage de ressources pour mener à bien leur attaque.
Le modèle Zero Trust représente l’aboutissement de cette approche selon trois dimensions :
- Premièrement, cette approche fait évoluer le principe de protection, qui ne repose plus sur un ensemble de simples « filtres » contrôlant l’accès à l’application, mais sur un ensemble de protections mieux adaptées aux actifs et appliquées de manière contextuelle à chaque transaction du système. Pour chaque transaction, il s’agit de déterminer : qui tente d’effectuer quelle action sur quoi. Le « qui » et le « quoi » peuvent désigner n’importe quel composant du système ou utilisant celui-ci, qu’il s’agisse d’un humain, d’un processus automatisé ou d’un élément de code. La notion d’identité est essentielle pour déterminer qui agit et sur quoi, tandis que les privilèges accordés à une identité permettent de définir ce qui peut être fait.
- Deuxièmement, elle considère que l’évaluation de la décision de sécurité n’est pas statique et absolue, mais plutôt dynamique et adaptative, et qu’elle doit être continuellement réévaluée à la lumière des comportements observés. La décision concernant le traitement de chaque transaction – autoriser l’interaction, la bloquer, renforcer le niveau de confiance, etc. – doit également tenir compte du contexte commercial global et, plus précisément, de l’arbitrage entre risques et avantages.
- Enfin, cette approche part du principe que, quel que soit le nombre de couches de protection mises en place, un adversaire suffisamment motivé ou chanceux finira par compromettre ou contourner les protections. Par conséquent, la détection rapide de toute compromission et l’atténuation des tentatives d’exploitation doivent également constituer un élément clé de la stratégie globale.
Cette évolution résulte en partie du temps et de l’expérience, mais elle est de plus en plus portée par la convergence de deux autres tendances en matière de sécurité des applications. Plus précisément, les architectures applicatives actuelles ouvrent un champ potentiel bien plus vaste de vulnérabilités — notamment les menaces provenant de « l’intérieur » de l’infrastructure applicative — que la sophistication croissante des adversaires d’aujourd’hui permet d’exploiter. Heureusement, les progrès réalisés parallèlement dans le domaine des outils de sécurité, en particulier lorsque ceux-ci sont associés à des capacités modernes de collecte et d’analyse des données, ont permis la mise en œuvre concrète de composantes essentielles de la stratégie de défense.
La suite de cette introduction présente une vue d’ensemble du cadre et du périmètre de notre approche de la sécurité Zero Trust. Les sections suivantes approfondissent ensuite la problématique et son lien avec d’autres approches contemporaines du Zero Trust, avant d’aborder les convictions fondamentales — le « pourquoi » — qui doivent guider le choix des technologies de sécurité et leur mise en œuvre. De futures publications se pencheront sur le « comment », c’est-à-dire sur les exigences imposées à certaines technologies telles que l’authentification, le contrôle des accès et l’analyse assistée par l’IA dans le cadre du modèle de maturité Zero Trust.
ZTS : tout commence par le pourquoi
L’approche « Commencer par le pourquoi » de Simon Sinek est un outil efficace pour présenter le cadre ZTS, comme l’illustre la figure 1 ci-dessous. Vous pouvez lire ce schéma de l’extérieur vers l’intérieur, en partant des catégories de menaces auxquelles répond le ZTS, puis en examinant plus en détail les méthodes de sécurité employées, pour enfin ramener l’ensemble à des principes communs. Vous pouvez également l’aborder de l’intérieur vers l’extérieur, en prenant les convictions fondamentales comme cap : elles déterminent les outils et techniques appropriés, qui permettent ensuite de faire face à un large éventail de menaces.
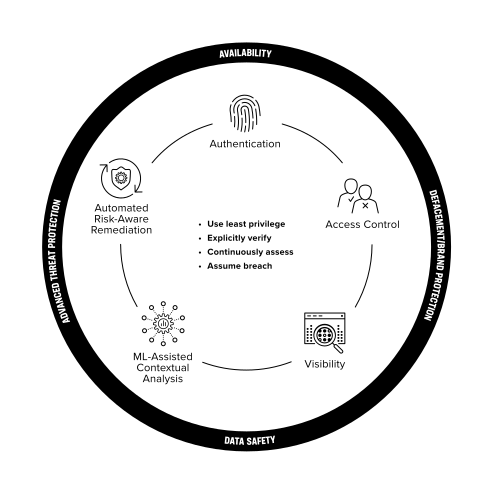
Les sections suivantes examinent en détail chaque couche concentrique de ce schéma, mais en résumé :
- Les convictions fondamentales de l’approche découlent de la formulation du cas d’usage comme suit :
« Qui tente de faire quoi (quelle action) à qui ? »- Pour établir qui et à qui, vérifiez explicitement toute attestation d’identité.
- Une fois que vous avez établi Qui, appliquez le principe du moindre privilège pour limiter Ce qui peut être effectué.
- Évaluez et réévaluez en permanence les trois facteurs que sont qui, quoi et à qui, et continuez à vérifier leur conformité aux contraintes de la politique.
- Toujours partir du principe que des failles de sécurité et des compromissions se produiront. Soyez prêt à intervenir si l’action (Quoi à Qui), sur la base d’une analyse risques-avantages (la probabilité d’une fraude lors de l’authentification, pondérée par l’impact commercial de l’approbation erronée d’une transaction), dépasse un seuil de sécurité acceptable prédéfini.
- Les méthodes utilisées sont les suivantes :
- Authentification et contrôle d’accès pour déterminer Qui avec un certain niveau de confiance, puis limiter les privilèges relatifs à Quelles actions doivent être autorisées pour cette identité à l’égard d’une cible Qui spécifique.
- Visibilité et analyse assistée par l’apprentissage automatique pour observer et évaluer en continu le contexte complet de chaque transaction – Qui fait Quoi à Qui.
- Remédiation automatisée tenant compte des risques pour intervenir dans une transaction lorsque le niveau risque-bénéfice dépasse le seuil de tolérance défini.
- Faire face à un large éventail de cyberattaques en appliquant les méthodes suivantes :
- Les attaques traditionnelles telles que la défiguration ou l’exfiltration de données – Vous pouvez contrer ces attaques en détectant la compromission d’identité ou l’élévation de privilèges, et en utilisant des techniques d’authentification et de contrôle d’accès afin de définir par des politiques qui peut faire quoi .
- Attaques visant la disponibilité/attaques DDoS — Luttez contre ces attaques en combinant l’authentification et le contrôle d’accès à des mesures correctives tenant compte des risques. Par exemple, bloquez (ou limitez le débit de) l’accès des acteurs non authentifiés ou insuffisamment authentifiés qui tentent d’effectuer des transactions gourmandes en ressources.
- Menaces avancées, telles que les rançongiciels ou les attaques de la chaîne d’approvisionnement -- Vous pouvez contrer ces menaces en détectant les changements et les anomalies dans les comportements afin de déterminer qui fait quoi à qui, là encore en y associant des mesures correctives tenant compte des risques.
Le périmètre de ZTS
La sécurité Zero Trust s’étend de manière globale à l’ensemble des applications, de l’infrastructure et de la chaîne de livraison, et doit couvrir l’intégralité du pipeline de développement. Plus précisément, elle doit inclure :
- Pile applicative et d’infrastructure complète, « de haut en bas »
- Infrastructure matérielle de calcul, notamment les serveurs, les cartes d’interface réseau, les coprocesseurs et les composants de la carte mère
- Micrologiciels de bas niveau et BIOS du matériel.
- Le système d’exploitation de plus bas niveau, tel que l’hyperviseur ou l’exécutif d’exécution.
- Le système d’exploitation au niveau applicatif/du conteneur.
- Composants applicatifs tiers importés, qu’ils soient commerciaux ou open source.
- Tout logiciel applicatif développé en interne ou sur mesure.
- Pile complète de livraison d’applications « de gauche à droite »
- La chaîne d’approvisionnement utilisée pour la maintenance continue et les mises à niveau de chaque élément de la pile « de haut en bas ».
- Tous les composants en ligne de mise à disposition des applications, tels que les pare-feu, les répartiteurs de charge, les passerelles API, les contrôleurs d’entrée, de sortie ou de maillage, ainsi que les dispositifs en ligne de lutte contre la fraude.
- Tous les composants de mise à disposition d’applications qui influent indirectement sur le traitement du trafic, tels que les résolveurs DNS (Domain Name System), ou qui reçoivent indirectement des métadonnées, tels que les solutions de gestion des informations et des événements de sécurité (SIEM) ou les services d’identité fédérée.
Traditionnellement, l’approche Zero Trust s’est concentrée sur les équipes de développement et de livraison d’applications, souvent représentées par les profils Dev, DevOps, DevSecOps et SRE. Nous le soulignons principalement pour mettre en évidence une vision plus globale : une approche complète du Zero Trust devrait idéalement inclure des profils et des infrastructures non traditionnels, ainsi que des processus supplémentaires, tels que la stratégie d’approvisionnement de la chaîne logistique.
Énoncé du problème
L’une des principales priorités des DSI et des RSSI consiste à moderniser les technologies de l’information afin d’accélérer le développement de l’entreprise. Ils jouent également un rôle clé dans la gouvernance des risques de l’entreprise. Leur objectif est d’aider l’entreprise à satisfaire ses clients grâce à de nouvelles expériences numériques, à accroître son efficacité opérationnelle grâce à la connectivité numérique avec des tiers et à permettre aux collaborateurs d’être productifs où qu’ils se trouvent, tout en réduisant au minimum les risques pour l’entreprise. Pour ce faire, les équipes des DSI et des RSSI doivent donner à leurs collaborateurs la liberté d’utiliser les technologies, les architectures et les bonnes pratiques les plus récentes afin de gagner en agilité, tout en leur demandant de prendre les mesures de sécurité appropriées et de mettre en place des contrôles portant sur le comportement des personnes, les informations auxquelles elles accèdent et les technologies qu’elles utilisent, afin de prévenir les risques de pertes.
Les organisations doivent comprendre et maîtriser les risques liés à l’évolution des conditions de marché et de la conjoncture macroéconomique, au comportement des consommateurs, à la chaîne d’approvisionnement et aux failles de sécurité. Une évaluation précise des risques et la capacité à prendre rapidement des mesures d’atténuation constituent un avantage concurrentiel pour les entreprises. Dans ce document, nous nous concentrons sur les risques liés aux failles de sécurité, qui peuvent notamment entraîner la perte de propriété intellectuelle, l’interruption des processus métier, la perte d’informations personnelles identifiables et des amendes infligées par les autorités de réglementation. Le risque de sécurité peut être calculé en évaluant les aspects suivants de la situation considérée :
- Valeur des actifs concernés
Les actifs concernés par les transactions présentent différents niveaux d’importance. Par exemple, une base de données contenant des informations permettant d’identifier personnellement des individus a plus de valeur qu’une base de données répertoriant les points de vente qui proposent les produits fabriqués par l’entreprise. Les équipes de sécurité et informatiques peuvent utiliser un processus déterministe pour dresser l’inventaire de tous les actifs et les classer selon un score représentant leur « valeur ». - Impact d’une compromission
La nature de la compromission détermine son impact. Par exemple, l’impact du vol d’informations dans un magasin de données contenant des informations permettant d’identifier personnellement des individus est bien plus important que celui d’une interruption de la disponibilité de ce magasin. Bien que cela soit un peu plus difficile à quantifier, il est possible de répertorier différents types de compromissions et de leur attribuer un score d’« impact ». - Probabilité de compromission
La probabilité qu’une transaction entraîne la compromission d’un actif est le facteur le moins déterministe dans l’évaluation du risque associé à cette transaction. Les humains ne sont pas en mesure de traiter le volume d’observations requis. Les organisations ont donc recours à l’apprentissage automatique et à l’intelligence artificielle pour accroître le degré de confiance dans leur calcul de la probabilité de compromission.
Le défi consiste à calculer, quasiment en temps réel, le risque associé à chaque transaction et à prendre les mesures d’atténuation appropriées afin de limiter l’impact d’une éventuelle compromission.
Identifier le problème
Les impératifs d’accélération de l’activité conduisent à de nouvelles pratiques qui aggravent les risques de cybersécurité. Nous abordons ce point plus en détail ci-dessous.
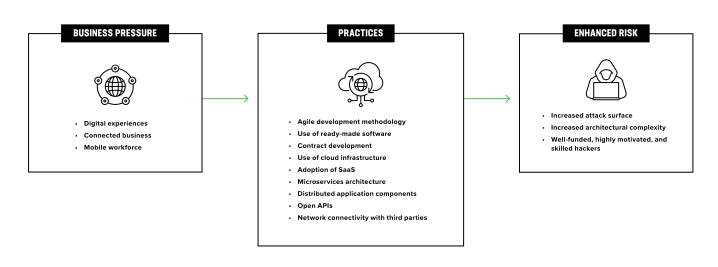
- Exigences d’accélération de l’activité
- Expériences numériques
Les consommateurs ont un appétit insatiable pour les expériences numériques et exigent des améliorations fréquentes sur plusieurs plateformes (PC, tablettes, téléphones mobiles). - Entreprise connectée
Les processus métier numériques nécessitent une connexion avec les partenaires, les fournisseurs, les distributeurs et les services proposés par d’autres entreprises. - Personnel mobile
Les employés doivent pouvoir accéder aux applications métier où qu’ils se trouvent afin de gagner en efficacité opérationnelle.
- Expériences numériques
- Pratiques pour répondre aux besoins de l’entreprise
- Méthodologie de développement Agile
Les entreprises ont adopté l’approche de développement Agile, incrémentale et itérative, qui met fortement l’accent sur la satisfaction client, au détriment de l’approche séquentielle en cascade, axée sur le respect des délais de livraison des projets. - Utilisation de logiciels prêts à l’emploi
Pour proposer de nouvelles expériences numériques le plus rapidement possible, les développeurs réutilisent du code publié en open source par leurs confrères du secteur. - Développement externalisé
L’externalisation du travail auprès de développeurs contractuels permet aux entreprises d’adapter leurs effectifs à la demande. - Utilisation de l’infrastructure cloud
L’agilité, la flexibilité, l’évolutivité et la facilité d’utilisation du cloud permettent aux développeurs d’obtenir à la demande l’infrastructure dont ils ont besoin. - Adoption du SaaS
Le logiciel en tant que service (SaaS) est avantageux pour les applications de gestion d’entreprise, car il réduit considérablement les contraintes liées à l’acquisition, au déploiement et à la maintenance de ces applications dans des centres de données privés. - Architecture de microservices
Les équipes utilisent les microservices pour assurer une livraison continue et réduire les délais de mise sur le marché. - Composants d’application distribués
Les organisations gagnent en efficacité en exécutant leurs microservices sur une infrastructure offrant les meilleurs outils pour développer ou fournir les fonctionnalités du service. Les extensions récentes des workflows existants reposent sur des architectures d’application modernes qui doivent communiquer avec les composants existants, les deux s’exécutant souvent sur des infrastructures différentes. - API ouvertes
Un écosystème composé de différents services est plus efficace que le développement de tous les services en interne par une entreprise. - Connectivité réseau avec des tiers
Les entreprises se connectent entre elles au moyen de tunnels chiffrés avec leurs partenaires, fournisseurs et distributeurs afin d’automatiser et d’optimiser leurs processus métier.
- Méthodologie de développement Agile
- Risque de sécurité accru
- Surface d’attaque accrue
L’utilisation de logiciels tiers et de bibliothèques open source ouvre la voie à des attaques contre la chaîne d’approvisionnement, et toutes les vulnérabilités des logiciels développés en externe sont également héritées. Les développeurs sous contrat cherchent avant tout à livrer les fonctionnalités dans les délais, la sécurité n’étant pas leur priorité. En outre, une fois le logiciel livré et leur mission terminée, l’examen du code et la recherche de failles de sécurité par les équipes internes s’avèrent difficiles et chronophages. Les sprints agiles sont très efficaces pour livrer des fonctionnalités, mais l’accélération du rythme de développement laisse peu de temps pour réaliser des audits de sécurité et des tests approfondis. Un seul microservice vulnérable capable de communiquer avec d’autres microservices accroît le risque de sécurité pour l’ensemble du système. Bien que l’interconnexion des entreprises améliore l’efficacité opérationnelle, elle a une conséquence majeure : une faille de sécurité chez l’une d’entre elles les affecte toutes. Les attaquants repèrent le maillon le plus faible pour se propager dans le reste du réseau. Une vulnérabilité ou une défaillance de sécurité au niveau de la plateforme SaaS ou de l’infrastructure cloud constitue un vecteur d’attaque supplémentaire, tandis que le modèle de responsabilité partagée peut compliquer la détection précoce et la correction des failles. - Complexité architecturale accrue
Les composants d’applications distribuées, développés selon différentes architectures et déployés sur plusieurs infrastructures, présentent des besoins distincts en matière de sécurité et de conformité. Il est donc plus difficile pour les équipes de sécurité de concevoir et de déployer des mécanismes adaptés afin de sécuriser les applications et les données de l’entreprise, tout en respectant les exigences réglementaires. - Des pirates informatiques compétents, très motivés et disposant de moyens financiers importants
De l’opération Aurora en 2010 à Solargate en 2020, nous avons connu une décennie de cyberattaques sophistiquées, découvertes seulement après avoir causé des dommages considérables. Des failles de sécurité ont touché des organisations dotées des meilleures technologies de sécurité et dont les équipes de sécurité étaient hautement qualifiées. Les attaquants sont restés longtemps dans l’infrastructure informatique de ces organisations avant d’être détectés. Des éléments de propriété intellectuelle et des informations personnelles identifiables ont été dérobés, des activités ont été perturbées et des organisations ont été prises en otage par des rançongiciels, alors même que les équipes informatiques et de sécurité allaient bien au-delà des exigences réglementaires visant à prévenir les cyberattaques.
- Surface d’attaque accrue
Directives du gouvernement américain
Après une série de cyberattaques persistantes visant diverses agences gouvernementales américaines aux niveaux fédéral, étatique et local, ainsi que plusieurs entreprises américaines, le président Joe Biden a publié un décret présidentiel visant à améliorer la cybersécurité du pays le 12 mai 2021. L’un des éléments clés de ce décret impose aux agences gouvernementales d’appliquer les principes du modèle Zero Trust afin de se préparer aux cyberattaques. L’administration Biden a donné suite à ce décret par une note du Bureau de la gestion et du budget (OMB) adressée aux responsables des départements exécutifs et des agences le 26 janvier 2022. Cette note de l’OMB « définit une stratégie fédérale d’architecture Zero Trust (ZTA), qui impose aux agences de respecter des normes et des objectifs précis en matière de cybersécurité d’ici la fin de l’exercice 2024, afin de renforcer les défenses du gouvernement face à des campagnes de menaces toujours plus sophistiquées et persistantes ».1 Le décret présidentiel et la note de l’OMB font tous deux référence à l’architecture Zero Trust décrite dans la publication SP 800-207 du National Institute of Standards and Technology (NIST), publiée en août 2020, et imposent aux agences gouvernementales de s’y conformer.
Architectures Zero trust et modèles de maturité
Des experts reconnus issus d’organismes publics et du secteur privé ont publié des articles qui contribuent à expliquer l’architecture Zero Trust et donnent des conseils sur la meilleure façon de l’adopter. Nous résumons ci-dessous les idées présentées dans ces articles. Nous constatons que l’essentiel des idées et recommandations qu’ils contiennent consiste à examiner chaque transaction afin de déterminer qui tente d’effectuer quelle action sur qui, puis à décider en temps réel d’autoriser ou non la transaction en fonction du calcul du risque qui lui est associé.
Institut national des normes et de la technologie (NIST) : Zero trust architecture
L’équipe du NIST énumère les principes du modèle Zero Trust et définit une architecture Zero Trust abstraite (ZTA) dans sa publication NIST SP 800-207.2 Elle examine également différentes variantes des approches Zero Trust et décrit plusieurs façons de déployer cette architecture abstraite.
Les principales abstractions abordées dans le document sont le point de décision de politique (PDP) et le point d’application de la politique (PEP), qui fonctionnent conjointement. Le point de décision de politique se compose du moteur de politique (PE) et de l’administrateur de politique (PA). Le moteur de politique utilise un algorithme de confiance pour déterminer si un sujet doit être autorisé à accéder à une ressource. Cette décision est mise en œuvre par l’administrateur de politique, qui communique avec le point d’application de la politique afin d’autoriser ou de refuser une nouvelle session, ainsi que de modifier ou de mettre fin à une session existante. Le document aborde également différentes variantes de l’algorithme de confiance, les composants réseau d’un environnement Zero Trust, ainsi que divers cas d’utilisation ou scénarios de déploiement. Enfin, il examine les moyens par lesquels des attaquants peuvent mettre en échec l’architecture Zero Trust, afin que les responsables de sa mise en œuvre soient conscients des menaces et prennent les mesures appropriées pour protéger ses composants.
Agence de cybersécurité et de sécurité des infrastructures (CISA) : modèle de maturité « Zero Trust »
Afin d’aider les agences à élaborer leurs plans Zero Trust, les experts de la Cybersecurity and Infrastructure Security Agency (CISA) ont publié un modèle de maturité Zero Trust (https://www.cisa.gov/zero-trust-maturity-model).3 Ce travail s’appuie sur l’architecture Zero Trust abstraite décrite dans la publication NIST SP 800-207. Les auteurs ont défini cinq domaines et recommandent aux organisations de progresser de manière cohérente dans l’application des principes du Zero Trust à chacun d’eux. Ces domaines sont les suivants : (i) identité, (ii) appareils, (iii) réseau, (iv) charges de travail applicatives et (v) données. Ils recommandent de recourir à la visibilité et à l’analyse, ainsi qu’à l’automatisation et à l’orchestration, dans chacun de ces cinq domaines.
Le document propose un modèle de maturité général couvrant les cinq piliers fondamentaux de l’approche Zero Trust précédemment identifiés, puis approfondit chacun de ces domaines. Les organisations peuvent utiliser ce modèle de maturité pour comprendre leur situation actuelle et définir une trajectoire progressive vers l’état optimal.
Département de la Défense (DOD) : architecture de référence Zero Trust
À la suite de la découverte des attaques SolarWinds, la National Security Agency (NSA) a publié des recommandations conseillant aux équipes de cybersécurité d’adopter un modèle de sécurité Zero Trust dans son document intitulé « Embracing a Zero Trust Security Model ».4 Des experts de l’équipe conjointe d’ingénierie Zero Trust de la Defense Information Systems Agency (DISA) et de la National Security Agency ont élaboré l’architecture de référence Zero Trust du Department of Defense (DOD).5 Les auteurs soulignent la nécessité d’adopter le modèle Zero Trust dans la déclaration suivante : « Les vulnérabilités révélées par les violations de données au sein et en dehors du DOD démontrent la nécessité d’un nouveau modèle de cybersécurité plus robuste, permettant de prendre des décisions fondées sur les risques et en toute connaissance de cause. »6
Cette architecture de référence fonde ses recommandations sur les abstractions définies dans le document NIST SP 800-207 relatif à l’architecture Zero Trust. Ce document présente un modèle opérationnel de haut niveau et en décrit les éléments en détail. Il comprend également un modèle de maturité de haut niveau ainsi qu’une cartographie des capacités permettant d’appliquer les principes du Zero Trust à différents domaines d’intérêt. Ensemble, ces documents aident les organisations à évaluer leur situation actuelle et à élaborer un plan.
Gérer les risques et la gouvernance selon les principes du Zero Trust
Adopter une posture qui « part du principe qu’une compromission a eu lieu » et suivre les principes du modèle Zero Trust peut aider les organisations dans leurs pratiques de gestion des risques et de gouvernance. Les principes Zero Trust de « surveillance continue » et de « vérification explicite » des acteurs impliqués dans les transactions permettent aux organisations d’établir un score de risque dynamique pour l’ensemble des acteurs et de leurs activités. Cette approche est conforme à la recommandation de Gartner d’utiliser la méthodologie CARTA (« évaluation continue et adaptative des risques et de la confiance ») afin d’améliorer les programmes de sécurité existants. L’adoption du principe consistant à n’autoriser que les accès aux ressources fondés sur le moindre privilège réduit le risque de perte, même en cas de compromission. Les informations générées par la surveillance continue et la vérification explicite sont également utiles pour produire des rapports de conformité.
L’état d’esprit plus en détail
Cette section vise à mettre l’accent sur l’état d’esprit — le système de croyances, le « pourquoi » — qui guide la stratégie et les décisions relatives aux outils et à la conception qu’une entreprise devrait adopter pour assurer une sécurité Zero Trust. En réalité, les motivations qui sous-tendent l’ensemble des méthodes et des technologies employées par les solutions Zero Trust actuelles peuvent se résumer à quatre principes clés simples. Cette section commence par les énumérer, puis explique comment les appliquer dans le contexte plus large du cycle de vie du développement des applications, c’est-à-dire comment les prendre en compte dès le départ, lors de la phase de conception, mais aussi sur le plan opérationnel, lors du déploiement et de l’exécution de l’application.
Principes opérationnels du modèle Zero Trust
Si les solutions Zero Trust sont considérées comme visant fondamentalement à établir la confiance dans les interactions entre systèmes – « Qui fait Quoi à Qui ? » –, alors l’établissement d’un niveau de confiance adapté à l’interaction peut être décomposé en quatre composantes.
Vérifier explicitement
Comme son nom l’indique, l’approche « Zero Trust » repose sur le principe suivant : « Ne jamais faire confiance aveuglément, toujours vérifier. » Par conséquent, tout acteur du système – le Qui et le À qui des interactions au sein du système – doit être en mesure de :
- Attester de son identité, y compris dans le cas particulier d’une identité « anonyme », si le système autorise les interactions provenant d’identités anonymes ou qui leur sont destinées, comme dans le cas d’internautes anonymes utilisant un système de réservation aérienne. Pour toutes les autres identités, l’acteur doit être en mesure d’indiquer qui il est, dans un espace de noms accepté par le système.
- Recevoir et valider les « preuves » complémentaires de l’identité déclarée de l’acteur (pour toute identité déclarée non anonyme). La nature de ces « preuves » — mots de passe, certificats, comportements, etc. — peut varier, tout comme leur fiabilité, mais le système doit être en mesure d’établir un certain niveau de confiance dans la déclaration d’identité. Les systèmes simples peuvent évaluer la fiabilité de la preuve de manière binaire (oui/non), tandis que les systèmes plus avancés peuvent lui attribuer un score de confiance numérique pouvant être explicitement pris en compte dans le cadre d’une politique fondée sur l’équilibre entre risques et bénéfices. Il convient de noter que le système peut également accroître ou réduire ce niveau de confiance par d’autres moyens, par exemple en fonction de la réponse à une demande de vérification active, voire de l’observation passive du comportement de l’acteur.
- Évaluer et ajuster le niveau de confiance accordé à l’identité déclarée, en contextualisant davantage le comportement actuel par rapport aux comportements passés. Par exemple, le système peut conserver des métadonnées historiques sur l’acteur, telles que ses données de géolocalisation antérieures et actuelles, ses plateformes matérielles, ses adresses IP, sa réputation, etc., afin d’accroître ou de réduire le niveau de confiance accordé à la « preuve » d’identité.
En outre, le principe de vérification explicite peut s’appliquer non seulement à l’identité, mais aussi à l’action, c’est-à-dire au « quoi » de la transaction. Un cas d’usage courant est celui où l’action prend la forme d’un appel d’API, par exemple une API permettant d’effectuer une requête dans une base de données. Dans cet exemple, le principe de vérification explicite permet non seulement d’avoir confiance dans l’identité de l’acteur qui appelle l’API, mais aussi de vérifier que l’action de l’API est utilisée correctement, notamment en s’assurant que les paramètres transmis à l’API respectent les contraintes appropriées.
Dans une approche mature du Zero Trust, la « preuve » n’est presque jamais absolue. Les identifiants peuvent être volés et les appareils compromis ; les contraintes relatives aux paramètres des API sont souvent incomplètes. Par conséquent, dans le contexte du Zero Trust, le terme « confiance » doit plutôt être interprété comme une indication de la probabilité que l’identité attestée ou les paramètres de la transaction soient légitimes. Le niveau de « confiance » doit donc être considéré comme un facteur clé, mais non comme le seul, dans la décision d’autoriser, de bloquer ou d’examiner plus en détail une transaction.
Principe du moindre privilège
Une fois qu’un niveau acceptable de « confiance » est établi à l’égard des acteurs participant à une transaction, l’approche zéro confiance exige que l’acteur (généralement le demandeur, le « Qui ») ne se voie accorder que l’ensemble minimal de privilèges nécessaires pour accomplir ce pour quoi il a été conçu dans ce système. Ce principe incarne ce que l’on appelle également un « modèle de sécurité positive » : une approche dans laquelle toutes les actions sont interdites par défaut, des privilèges spécifiques n’étant accordés que lorsqu’ils sont nécessaires au fonctionnement du système. Par exemple, un système de réservation peut permettre aux utilisateurs anonymes de consulter les horaires des vols, mais, conformément aux exigences de conception de l’application, un utilisateur anonyme peut ne pas être autorisé à réserver un vol.
Ces privilèges peuvent s’appliquer à des acteurs individuels ou à des catégories d’acteurs. En règle générale, les utilisateurs d’une application sont soit des personnes, soit des mandataires agissant pour leur compte, et sont regroupés en catégories telles que les « utilisateurs anonymes », les « clients », les « partenaires » ou les « employés ». Les catégories d’acteurs jugées moins fiables doivent généralement atteindre un seuil de confiance moins élevé pour réussir l’authentification, mais elles ont également accès à des API moins nombreuses ou moins sensibles. Les acteurs internes à l’application ou à son infrastructure, tels que certains services ou conteneurs au sein d’une application, peuvent souvent disposer de privilèges plus personnalisés, par exemple : « seuls les conteneurs <X> et <Y> peuvent accéder à la base de données ; seul <X> peut écrire dans le stockage d’objets, mais <Y> et <Z> peuvent y accéder en lecture ».
Un aspect important de la mise en œuvre du principe du moindre privilège consiste à chercher à l’appliquer de manière plus ciblée et réfléchie.7 Plus précisément, plutôt que d’appliquer un ensemble générique de privilèges à tous les acteurs ou à une catégorie d’acteurs, une mise en œuvre mature du modèle Zero Trust doit examiner plus précisément quelle action est tentée. Par exemple, à un niveau très général, le privilège « accès au système de fichiers » peut être accordé, mais « lecture du système de fichiers » définit plus précisément le privilège réellement requis, ce qui permet une mise en œuvre de haute qualité du modèle de sécurité positif.
Enfin, les formes les plus sophistiquées du principe de moindre privilège peuvent fonctionner conjointement avec des mises en œuvre avancées de la « vérification explicite », en considérant les privilèges accordés à un acteur non pas comme absolus, mais comme dépendant du niveau de confiance fourni par l’authentification. Ainsi, les privilèges ne sont accordés que si le niveau de confiance dans l’identité attestée (Qui) atteint un seuil minimal, les seuils étant propres à l’action tentée. Par exemple, une action particulièrement lourde de conséquences (comme l’arrêt du système) peut nécessiter un niveau de confiance d’au moins 90 % quant au fait que l’acteur est un administrateur. Dans cet exemple, si le niveau de confiance du système dans l’identité n’est que de 80 % au moment de la tentative d’arrêt, le système exige une vérification supplémentaire afin d’accroître le niveau de confiance dans l’identité attestée avant d’autoriser l’action.
Évaluer en continu
La vérification explicite et le principe du moindre privilège sont des concepts clés. Toutefois, le principe d’évaluation continue implique que ces concepts doivent être réévalués en permanence, en ce sens que :
- Toutes les transactions doivent faire l’objet d’une vérification et d’un contrôle des privilèges. Autrement dit, il ne faut pas que seule une partie des transactions soit soumise à un contrôle, par exemple « la première transaction d’une session utilisateur » ou « les transactions initiées par une charge de travail exécutée dans un conteneur Docker ». Bien que cela puisse sembler évident, de nombreuses implémentations du modèle Zero Trust ne valident pas toutes les transactions, soit en raison d’une mauvaise conception, soit par manque de visibilité. Les lacunes courantes dans ce domaine tiennent au fait que le modèle Zero Trust est appliqué uniquement aux acteurs externes, et non aux acteurs internes, et/ou que l’on suppose qu’une décision Zero Trust reste valable pendant une période prolongée.
- Les facteurs clés de l’évaluation – le niveau de confiance dans l’identité de l’acteur et les droits qui lui sont accordés – doivent être considérés comme dynamiques et susceptibles d’évoluer. Par exemple, le niveau de confiance dans une identité peut augmenter ou diminuer au fil du temps, en fonction des comportements observés et des métadonnées auxiliaires. Toute politique fondée sur ce niveau de confiance doit donc elle aussi s’adapter de manière dynamique à ses variations. En outre, un niveau de privilège précédemment accordé par une politique peut être révoqué peu après, ou le niveau de confiance minimal requis pour une action donnée peut changer. Bien que le rythme des modifications de politique puisse varier – lentement (à l’échelle des processus opérationnels humains) ou rapidement (par l’intermédiaire d’agents de gouvernance automatisés) –, le système doit être capable de réagir dynamiquement à ces changements et de les appliquer.
Partir du principe qu’une compromission a eu lieu
Le dernier principe repose sur la présomption d’adversaires extrêmement motivés, dans un contexte de saine paranoïa. Plus précisément, le postulat est le suivant : « partez du principe que vous avez subi une compromission », le terme « compromission » désignant « une transaction qui aurait dû être refusée (avec une connaissance et une exécution parfaites), mais qui a finalement été autorisée ». Cette faille peut avoir pour cause une connaissance imparfaite (par exemple, un score de confiance élevé erroné attribué lors de l’authentification en raison d’identifiants frauduleux non détectés), des limites de mise en œuvre (par exemple, une granularité insuffisante des privilèges accordés, comme le fait d’accorder le privilège « ouvrir une connexion réseau » sans pouvoir établir de distinction selon la géolocalisation de la destination réseau) ou encore une mise en œuvre incomplète du modèle Zero Trust (par exemple, lorsque celui-ci n’est pas appliqué aux composants open source vulnérables utilisés en interne).
Par conséquent, l’approche « Zero Trust » doit également déterminer la meilleure façon de gérer et de limiter l’impact de telles compromissions.
La mise en œuvre de ce principe varie davantage que celle des autres principes, mais se traduit généralement par les mesures suivantes :
- Tout d’abord, identifiez les transactions qui, bien que techniquement autorisées par la politique, sont suspectes. La notion de « suspect » dépend souvent fortement du contexte, mais elle désigne généralement : (a) des transactions anormales, très différentes des comportements observés par le passé ; (b) des groupes de transactions qui, prises individuellement, sont normales, mais qui, collectivement, sont inhabituelles — par exemple, la lecture et l’écriture d’un fichier peuvent être courantes, mais effectuer ces opérations à un rythme de 1 000 fichiers par seconde peut être inhabituel ; ou (c) des actions corrélées à un impact indésirable et inédit sur le système — par exemple, un schéma dans lequel une transaction spécifique ouvre une connexion réseau vers un nœud TOR ou entraîne une augmentation significative de la charge du processeur du système.
- Ensuite, effectuez une analyse plus approfondie, soit au moyen d’un processus entièrement automatisé, soit à l’aide d’un processus hybride contrôlé par un humain et assisté par l’apprentissage automatique, afin de déterminer si ces transactions sont non valides. Si elles sont effectivement jugées non valides, appliquez des mesures d’atténuation. Celles-ci peuvent prendre la forme d’une mise à jour générale de la politique ou, en tant que couche d’atténuation supplémentaire, d’un « filet de sécurité » venant compléter les autres mesures d’atténuation fondées sur des politiques.
Si l’approche retenue consiste à utiliser des ajustements fondés sur des politiques, ceux-ci peuvent être appliqués à l’aide de n’importe lequel des outils de politique statique disponibles. Ces ajustements peuvent, par exemple, consister à restreindre les privilèges de contrôle d’accès au niveau des transactions (c’est-à-dire ne plus autoriser Qui à faire Quoi à Qui) ou à appliquer une « norme de preuve » plus stricte (par exemple, exiger une authentification multifacteur ou un score de confiance plus élevé) pour qu’un acteur (ou une catégorie d’acteurs) puisse effectuer une action spécifique.
Si l’on choisit plutôt d’utiliser une couche de protection supplémentaire, cette stratégie peut également être mise en œuvre avec une granularité fine ou grossière. La stratégie la plus fine consisterait à bloquer précisément et uniquement les transactions qui dépassent un rapport risque-bénéfice donné. Toutefois, cette solution pourrait également entraîner des niveaux de latence inacceptables pour certaines transactions autorisées si sa mise en œuvre nécessite une analyse supplémentaire. Des stratégies à granularité plus grossière pourraient être utilisées à la place, par exemple en exécutant dans un bac à sable les futures transactions de cet acteur, voire en lui interdisant totalement l’accès au système. Dans les cas extrêmes, des méthodes d’atténuation encore plus radicales, telles que la désactivation des entrées-sorties de fichiers, peuvent être appropriées.
Bien entendu, toutes choses égales par ailleurs, une mesure d’atténuation de dernier recours à granularité fine est généralement préférable. Toutefois, il faut souvent faire des compromis en fonction des contraintes imposées par les technologies disponibles, et une mesure de dernier recours à granularité grossière vaut généralement mieux que l’absence de toute mesure. Par exemple, si la réponse à granularité grossière visant à prévenir une attaque par rançongiciel présumée consiste à désactiver les entrées/sorties de fichiers, les effets secondaires de cette réponse peuvent malgré tout être préférables à l’autre option — laisser l’acteur poursuivre ses activités dans le système sans aucun contrôle — si l’inaction devait aboutir au chiffrement du système de fichiers par un rançongiciel.
Zero Trust : tout commence vraiment avant les opérations
Le meilleur point de départ pour développer une application sécurisée selon le modèle Zero Trust se situe, sans surprise, au tout début. Les principes fondamentaux permettant de mettre en œuvre le modèle Zero Trust doivent être intégrés dès la phase de conception des processus de développement d’applications. Par conséquent, toute réflexion sur une solution Zero Trust opérationnelle intégrée au pipeline CI/CD doit commencer par une bonne compréhension de ces éléments fondamentaux, qui doivent être considérés comme des priorités dès la conception.
Le cœur de ces éléments fondamentaux doit décrire le comportement souhaité/prévu des interactions entre les différents composants du système, tout en offrant une visibilité et un contrôle suffisants pour détecter les écarts et prendre les mesures nécessaires. Les interactions prévues servent à définir l’ensemble des actions souhaitées (Quoi) pour chaque acteur (Qui) envers chaque cible (À qui). Cela étant, dans certains scénarios et environnements, les schémas d’interaction prévus peuvent être inconnus. Dans ce cas, une organisation peut s’appuyer sur une visibilité accrue pour « découvrir » l’ensemble des interactions appropriées,8 qu’elle peut ensuite formaliser dans une politique.
Par exemple, dans les solutions ZTNA actuelles, qui mettent l’accent sur le contrôle des accès aux API externes d’une application en fonction de l’identité, il est nécessaire de disposer d’une visibilité et de contrôles sur les API d’authentification. De même, dans le contexte d’une plateforme de protection des charges de travail cloud (CWPP), la détection d’une charge de travail conteneurisée compromise nécessite une visibilité sur les actions effectuées par chaque conteneur, et ce en temps réel si une remédiation en temps réel est requise.
Voici une liste des grandes catégories liées aux considérations fondamentales qui doivent faire partie du processus de conception, accompagnées d’analyses plus détaillées proposant des questions précises à examiner pour chacun des points clés :
- Quelles sont les interfaces de type boîte noire du système, c’est-à-dire ses entrées et ses sorties ?
- Quelles sont les catégories d’utilisateurs — administrateurs, utilisateurs authentifiés, utilisateurs non authentifiés, partenaires — qui interagissent avec l’application, et que doivent-elles faire ?
- Toutes les communications passent-elles par une API définie, ou existe-t-il des communications réseau « brutes » ou des communications via un magasin de données, tel qu’une base de données ou un stockage d’objets ?
- Pour les communications via une API, dans quelle mesure l’API définit-elle précisément les utilisateurs autorisés à interagir avec elle ainsi que les contraintes encadrant ces interactions (par exemple, les contraintes relatives aux paramètres, les limites de débit, etc.) ?
- Pour toute communication réseau, toutes les données transmises sont-elles chiffrées ?
- S’il existe des interfaces de données « brutes » (par exemple, si des informations sont partagées entre le client et l’application via un stockage d’objets ou une base de données), existe-t-il des journaux d’audit permettant de savoir qui a accédé à quelles informations et à quel moment ?
- De même, au niveau interne « boîte blanche », quels sont les services constitutifs qui composent les applications dans leur ensemble, y compris les éventuels services fournis par des tiers, et comment communiquent-ils entre eux ?
- Comment ces services communiquent-ils ? Quelle API est utilisée et quelles sont les contraintes (rôles, contrôles d’accès, limites de débit, paramètres, etc.) applicables à ces interactions ?
- Des questions similaires à celles évoquées ci-dessus se posent quant au degré de formalisation de l’API, à ses contraintes et au chiffrement des communications.
- Les communications « internes » (par exemple, entre charges de travail ou conteneurs) sont plus susceptibles d’utiliser la mémoire partagée et des interfaces basées sur le système de fichiers ; toutes ces interfaces doivent être identifiées.
- Comment ces services communiquent-ils ? Quelle API est utilisée et quelles sont les contraintes (rôles, contrôles d’accès, limites de débit, paramètres, etc.) applicables à ces interactions ?
- Quels mécanismes de contrôle le système met-il à disposition pour limiter l’accès aux interfaces de la boîte noire et aux voies de communication internes ?
- Existe-t-il une politique précisant qui — et quels rôles — peut appeler des API spécifiques, ainsi que les mesures prises en cas de non-respect de cette politique ? De même, quels moyens permettent de détecter et de limiter toute forme d’utilisation abusive des API, comme l’emploi de paramètres non valides ou une fréquence d’appel trop élevée ? Ces politiques peuvent-elles être mises à jour dynamiquement en fonction d’informations contextuelles provenant d’autres systèmes ?
- De même, existe-t-il des politiques encadrant les autres formes de communication entre charges de travail — systèmes de fichiers, magasins d’objets, tables de bases de données — afin de définir qui peut accéder à quels fichiers, magasins ou tables, et d’empêcher toute utilisation abusive de ces ressources (par exemple, « SELECT * from <table> ») ?
- Quels outils de visibilité (tableaux de bord, journaux, statistiques) le système met-il à disposition pour limiter l’accès à la fois aux interfaces de type boîte noire et aux voies de communication internes ?
- Le système peut-il déterminer qui appelle quelle API et à quel moment ? Ces données sont-elles conservées et, si oui, pendant combien de temps ? Dans quel délai (en temps réel, toutes les heures, etc.) sont-elles mises à disposition ? Dans quelle mesure sont-elles exploitables : s’agit-il d’un fichier journal non structuré, de données structurées au format JavaScript Object Notation (JSON) pouvant être envoyées à un service de gestion des événements et incidents de sécurité (SEIM), ou de données enregistrées dans une table de base de données Big Data ?
- Quelles sont les réponses à ces mêmes questions concernant les autres canaux de communication – mémoire, fichiers, objets, bases de données ? Qui fait quoi ? Comment ces données sont-elles exposées ?
- Au-delà des canaux de communication, quels autres mécanismes de contrôle et de visibilité le système offre-t-il pour éviter la surréservation ou la surconsommation des ressources ?
- Le système offre-t-il une visibilité sur les indicateurs de consommation des ressources (processeur, mémoire, bande passante, mise à l’échelle des pods, etc.) ? Si oui, avec quel niveau de granularité et dans quelle mesure ces données sont-elles exploitables ?
- Le système dispose-t-il de mécanismes de contrôle ou de garde-fous pour la consommation des ressources — limites de mémoire, de CPU et d’E/S de fichiers par charge de travail, suivi des appels système de création de processus, limites de mise à l’échelle verticale ou horizontale des pods, limitation du débit des API qui font appel à d’autres services ?
Poser explicitement ces questions vous aidera à repérer les lacunes dans les fondations nécessaires à la mise en œuvre du modèle Zero Trust. Souvent, le simple fait de les poser dès le début de la conception permettra de combler ces lacunes avec un minimum d’efforts de conception supplémentaires. Et lorsqu’une lacune subsiste, le simple fait d’en avoir conscience permettra de mieux cibler les efforts de sécurité supplémentaires ou d’identifier les surfaces d’attaque vulnérables.
Effectuer ce type d’analyse préalable du développement sécurisé est un élément essentiel de l’approche « Zero Trust ». Pourtant, aujourd’hui, une grande partie de l’attention portée au Zero Trust concerne ce qui se passe après la conception initiale, et la plupart des entreprises se concentrent principalement sur les aspects du Zero Trust qui interviennent après la conception. Toutefois, une réflexion menée dès la phase de conception sur les exigences nécessaires à une mise en œuvre efficace du Zero Trust évitera d’avoir à déployer des efforts supplémentaires bien plus importants pour « combler les failles » après le déploiement de l’application.
Considérations relatives à l’atténuation : rapidité, faux positifs/négatifs et risques
Comme l’illustre le principe « supposer une compromission » inhérent à cette approche, un professionnel de la sécurité doit partir du principe qu’un adversaire suffisamment déterminé parviendra à exécuter une transaction malveillante — un cas où « Qui fait Quoi à Qui » respecte les règles de la politique, mais qui, dans un monde parfait, n’aurait pas dû être autorisé. Dans ce cas, l’objectif consiste alors à disposer d’un mécanisme de dernier recours efficace capable de détecter ces situations, généralement en observant les schémas de transactions et les effets secondaires sur le système, comme décrit précédemment dans la section « supposer une compromission ».
Cependant, tout comme pour la notion d’identité, il ne sera jamais possible de déterminer avec une certitude absolue si une transaction donnée est malveillante ou non. Par conséquent, comme pour l’identité, une solution Zero Trust idéale devrait fournir un score de « confiance » quant à la légitimité de la transaction. Par exemple, si un démon lit et écrit des fichiers à un débit dix fois supérieur à la normale pendant 10 secondes, cela pourrait donner lieu à un score de confiance (quant au caractère malveillant) de 70 %. En revanche, si ce débit est multiplié par 100 et se maintient pendant une minute, le niveau de confiance pourrait atteindre 95 %. Dans cet exemple, la mesure corrective consistant à bloquer les futures écritures de fichiers présente toujours un certain risque (une probabilité de 30 % ou de 5 %) de constituer une réponse inappropriée, autrement dit un « faux positif ». La décision de prendre ou non des mesures correctives doit donc mettre en balance le risque de faux positifs et les conséquences potentielles qu’aurait le fait d’autoriser un comportement potentiellement malveillant.
Cet exemple vise à souligner que toute décision de prendre une mesure corrective visible par l’utilisateur est en réalité une décision commerciale qui tient compte de l’ensemble des risques, des coûts et des bénéfices liés à l’activité suspecte. Ajouter des obstacles à la transaction augmente la probabilité que la valeur attendue ne soit pas obtenue, tandis que ne pas intervenir ou ne pas ajouter d’obstacles entraîne un risque de compromission. Par conséquent, la décision d’agir ou non dans de tels cas dépend de trois facteurs :
- Quel risque y a-t-il à laisser se poursuivre des transactions potentiellement malveillantes ?
Ce risque peut être directement financier, comme dans le cas d’un transfert de fonds bancaires, ou entraîner des coûts indirects, qu’ils soient opérationnels (par exemple, le chiffrement de données essentielles suivi d’une demande de rançon) ou liés à l’image de marque (par exemple, le défigacement d’un site web). Il peut également y avoir des coûts juridiques ou de mise en conformité, notamment en cas de fuite de données personnelles de clients. En définitive, l’évaluation des risques relève de la gouvernance, et une bonne gouvernance saura comprendre et quantifier les risques associés à l’application. - Quels sont les effets secondaires de la mesure corrective ?
Les effets secondaires peuvent être évalués selon deux dimensions : (a) les contraintes introduites et (b) le périmètre d’impact. Les contraintes correspondent au degré de difficulté supplémentaire auquel une transaction légitime est confrontée ; elles peuvent aller d’un léger désagrément (par exemple, un niveau d’authentification supplémentaire) à une impossibilité totale (la transaction n’est tout simplement pas autorisée). Le périmètre d’impact indique si d’autres transactions indépendantes seront également affectées et, le cas échéant, combien. Par exemple, le blocage d’un utilisateur donné n’aura d’incidence que sur celui-ci, tandis que l’arrêt d’un service de journalisation compromettra l’auditabilité pour l’ensemble des utilisateurs et des transactions. - Quel est le degré de certitude que la transaction est malveillante ?
Renforcer ce degré de certitude implique généralement de recueillir davantage de données et de les recouper à partir d’un plus grand nombre de sources, deux opérations qui prennent du temps. En pratique, ce compromis revient donc souvent à se demander : « Combien de temps dois-je surveiller la situation avant de décider d’agir ? »
Ainsi, si une stratégie Zero Trust doit intégrer le fait que des compromissions se produiront, une approche réfléchie consistera à mettre en balance les risques et les bénéfices lors de la remédiation des transactions autorisées mais qui semblent suspectes. Cet arbitrage tiendra compte du niveau de risque des différentes transactions applicatives et des conséquences de la mise en œuvre de mesures correctives, celles-ci n’étant appliquées que si le niveau de risque dépasse le bénéfice commercial attendu.
1 https://www.whitehouse.gov/wp-content/uploads/2022/01/M-22-09.pdf
2 https://csrc.nist.gov/publications/detail/sp/800-207/final
3 https://www.cisa.gov/zero-trust-maturity-model
4 https://media.defense.gov/2021/Feb/25/2002588479/-1/-1/0/CSI_EMBRACING_ZT_SECURITY_MODEL_UOO115131-21.PDF
5 https://dodcio.defense.gov/Portals/0/Documents/Library/(U)ZT_RA_v1.1(U)_Mar21.pdf
6 https://dodcio.defense.gov/Portals/0/Documents/Library/(U)ZT_RA_v1.1(U)_Mar21.pdf
7 Cette réflexion préalable commence dès la phase de conception, comme décrit plus loin.
8 Ou, du moins, l’ensemble des interactions « jugées appropriées » que le système semble nécessiter. Il existe toujours un risque que l’ensemble des interactions déduit de l’observation soit incomplet ou présente un risque préexistant. Il est donc toujours préférable d’anticiper dès la conception.
PUBLIÉ LE 4 MAI 2022