El papel y el impacto de GraphQL
Por Rajesh Narayanan
Revisado por el equipo de OCTO y otros colaboradores, con aportaciones de todos ellos.
Opinión de la Oficina del CTO de F5
GraphQL se ha consolidado como un enfoque moderno y eficiente para el desarrollo de API, superando las limitaciones de las API REST tradicionales. Aunque REST se utiliza ampliamente desde los primeros tiempos de la web, GraphQL ofrece una perspectiva renovada y un mayor control a los desarrolladores. Con GraphQL, los desarrolladores pueden definir un esquema fuertemente tipado que permite a los clientes solicitar con precisión los datos que necesitan. Al evitar la obtención excesiva o insuficiente de datos, GraphQL optimiza el rendimiento y facilita la creación de aplicaciones web modernas e interactivas con requisitos complejos de consulta y modelado de datos.
Sin embargo, reconocemos que GraphQL también plantea ciertos desafíos. Este documento analiza los problemas de seguridad y la curva de aprendizaje asociados a la adopción de GraphQL. Asimismo, examinamos casos prácticos reales que describen los beneficios obtenidos por empresas de renombre que han implementado GraphQL con éxito.
Además, presentamos nuestra propia investigación sobre GraphQL y compartimos nuestras experiencias y hallazgos. Ofrecemos una breve introducción a GraphQL, lo comparamos con REST y profundizamos en los retos que resuelve. También abordamos aspectos relacionados con la seguridad para ayudar a las organizaciones a tomar decisiones fundamentadas. Nuestra investigación pone de manifiesto el potencial transformador de GraphQL. Mostramos cómo simplificamos la arquitectura de software de una suite de gestión de pruebas, lo que permitió aumentar en más de un 300 % la cantidad de datos expuestos que estaban ocultos en objetos JSON mediante GraphQL.
En conclusión, recomendamos encarecidamente que las empresas que afrontan dificultades para escalar, optimizar u operar una infraestructura de API REST consideren GraphQL como una solución viable. Nuestras conclusiones ofrecen orientación práctica a quienes se inician en la adopción de GraphQL, permitiéndoles aprovechar sus ventajas y superar los retos de forma eficaz.
Introducción a GraphQL
¿POR QUÉ GRAPHQL?
Las limitaciones de las API REST están impulsando la demanda de un nuevo enfoque tecnológico para las API.
El enfoque basado en REST (transferencia de estado representacional) se propuso originalmente como un conjunto de principios arquitectónicos para diseñar API web. REST evolucionó durante las décadas de 2000 y 2010 con la aparición de la Web 2.0, al ofrecer una forma más adecuada de implementar la arquitectura orientada a servicios (SOA) que otras tecnologías como la arquitectura común de intermediarios de peticiones a objetos (CORBA).
A medida que aumentaba el número de clientes debido a la adopción de los dispositivos móviles, crecía la demanda de datos precisos. Sin embargo, las API basadas en REST solían obtener datos en exceso o de forma insuficiente, lo que generaba ineficiencias. Este enfoque, ejemplificado por aplicaciones como Facebook, a menudo requería numerosas llamadas a la API REST para una sola actualización, lo que aumentaba el tráfico de red y perjudicaba el rendimiento y la experiencia de usuario.
GraphQL se diseñó específicamente para abordar estas limitaciones mediante un esquema fuertemente tipado y una forma más eficiente de consultar datos. Esto lo hace especialmente adecuado para casos de uso en los que se necesitan datos específicos para optimizar el ancho de banda de la red. Además, la capacidad de GraphQL para inspeccionar el esquema permite mejorar la documentación y las herramientas. Aunque una implementación más estandarizada de REST podría haber supuesto cierta competencia, las características y ventajas únicas de GraphQL lo convierten en una opción muy atractiva para las arquitecturas de aplicaciones modernas, distribuidas y con un uso intensivo de datos.
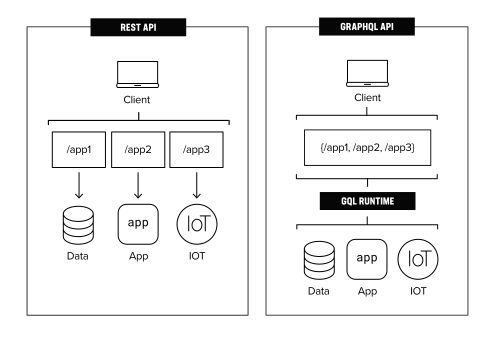
La figura 1 muestra una diferencia topológica entre la forma en que se implementan REST y GraphQL. Como se indica en «API REST frente a GraphQL», «la principal diferencia entre las API de GraphQL y REST es que GraphQL es un lenguaje de consulta, mientras que REST es un concepto arquitectónico para software basado en redes».
LA MOTIVACIÓN DE META PARA CREAR GRAPHQL
Meta creó GraphQL en 2012 (publicado como código abierto en 2015) para mejorar el rendimiento y la flexibilidad de sus aplicaciones móviles. Antes de GraphQL, las aplicaciones móviles de Meta se desarrollaban mediante una combinación de API RESTful y código nativo, lo que dificultaba la compatibilidad con la amplia variedad de dispositivos, tamaños de pantalla y condiciones de red que debían admitir.
Uno de los principales retos a los que se enfrentaban era que las API RESTful solían devolver una cantidad de datos inadecuada: a veces demasiados y otras veces demasiado pocos. Cuando la API devolvía una gran cantidad de datos que las aplicaciones móviles no necesitaban, los tiempos de carga aumentaban y el rendimiento empeoraba. Cuando devolvía muy pocos datos, las aplicaciones móviles tenían que realizar varias solicitudes a distintos endpoints para obtener todos los datos necesarios, lo que añadía latencia y complejidad al proceso.
Meta desarrolló GraphQL para que cualquier aplicación pudiera solicitar únicamente los datos que necesitaba en una sola petición. Esto permitió optimizar la transferencia de datos entre las aplicaciones móviles y los servicios de backend, lo que se tradujo en tiempos de carga más rápidos y un mejor rendimiento. Además, el tipado fuerte y las funciones de autodocumentación de GraphQL facilitaron a los desarrolladores la comprensión y el uso de la API.
VENTAJAS DE GRAPHQL
GraphQL ofrece potentes capacidades para consultar y manipular datos, lo que aporta importantes ventajas frente a los enfoques tradicionales de las API.
Esquemas fuertemente tipados
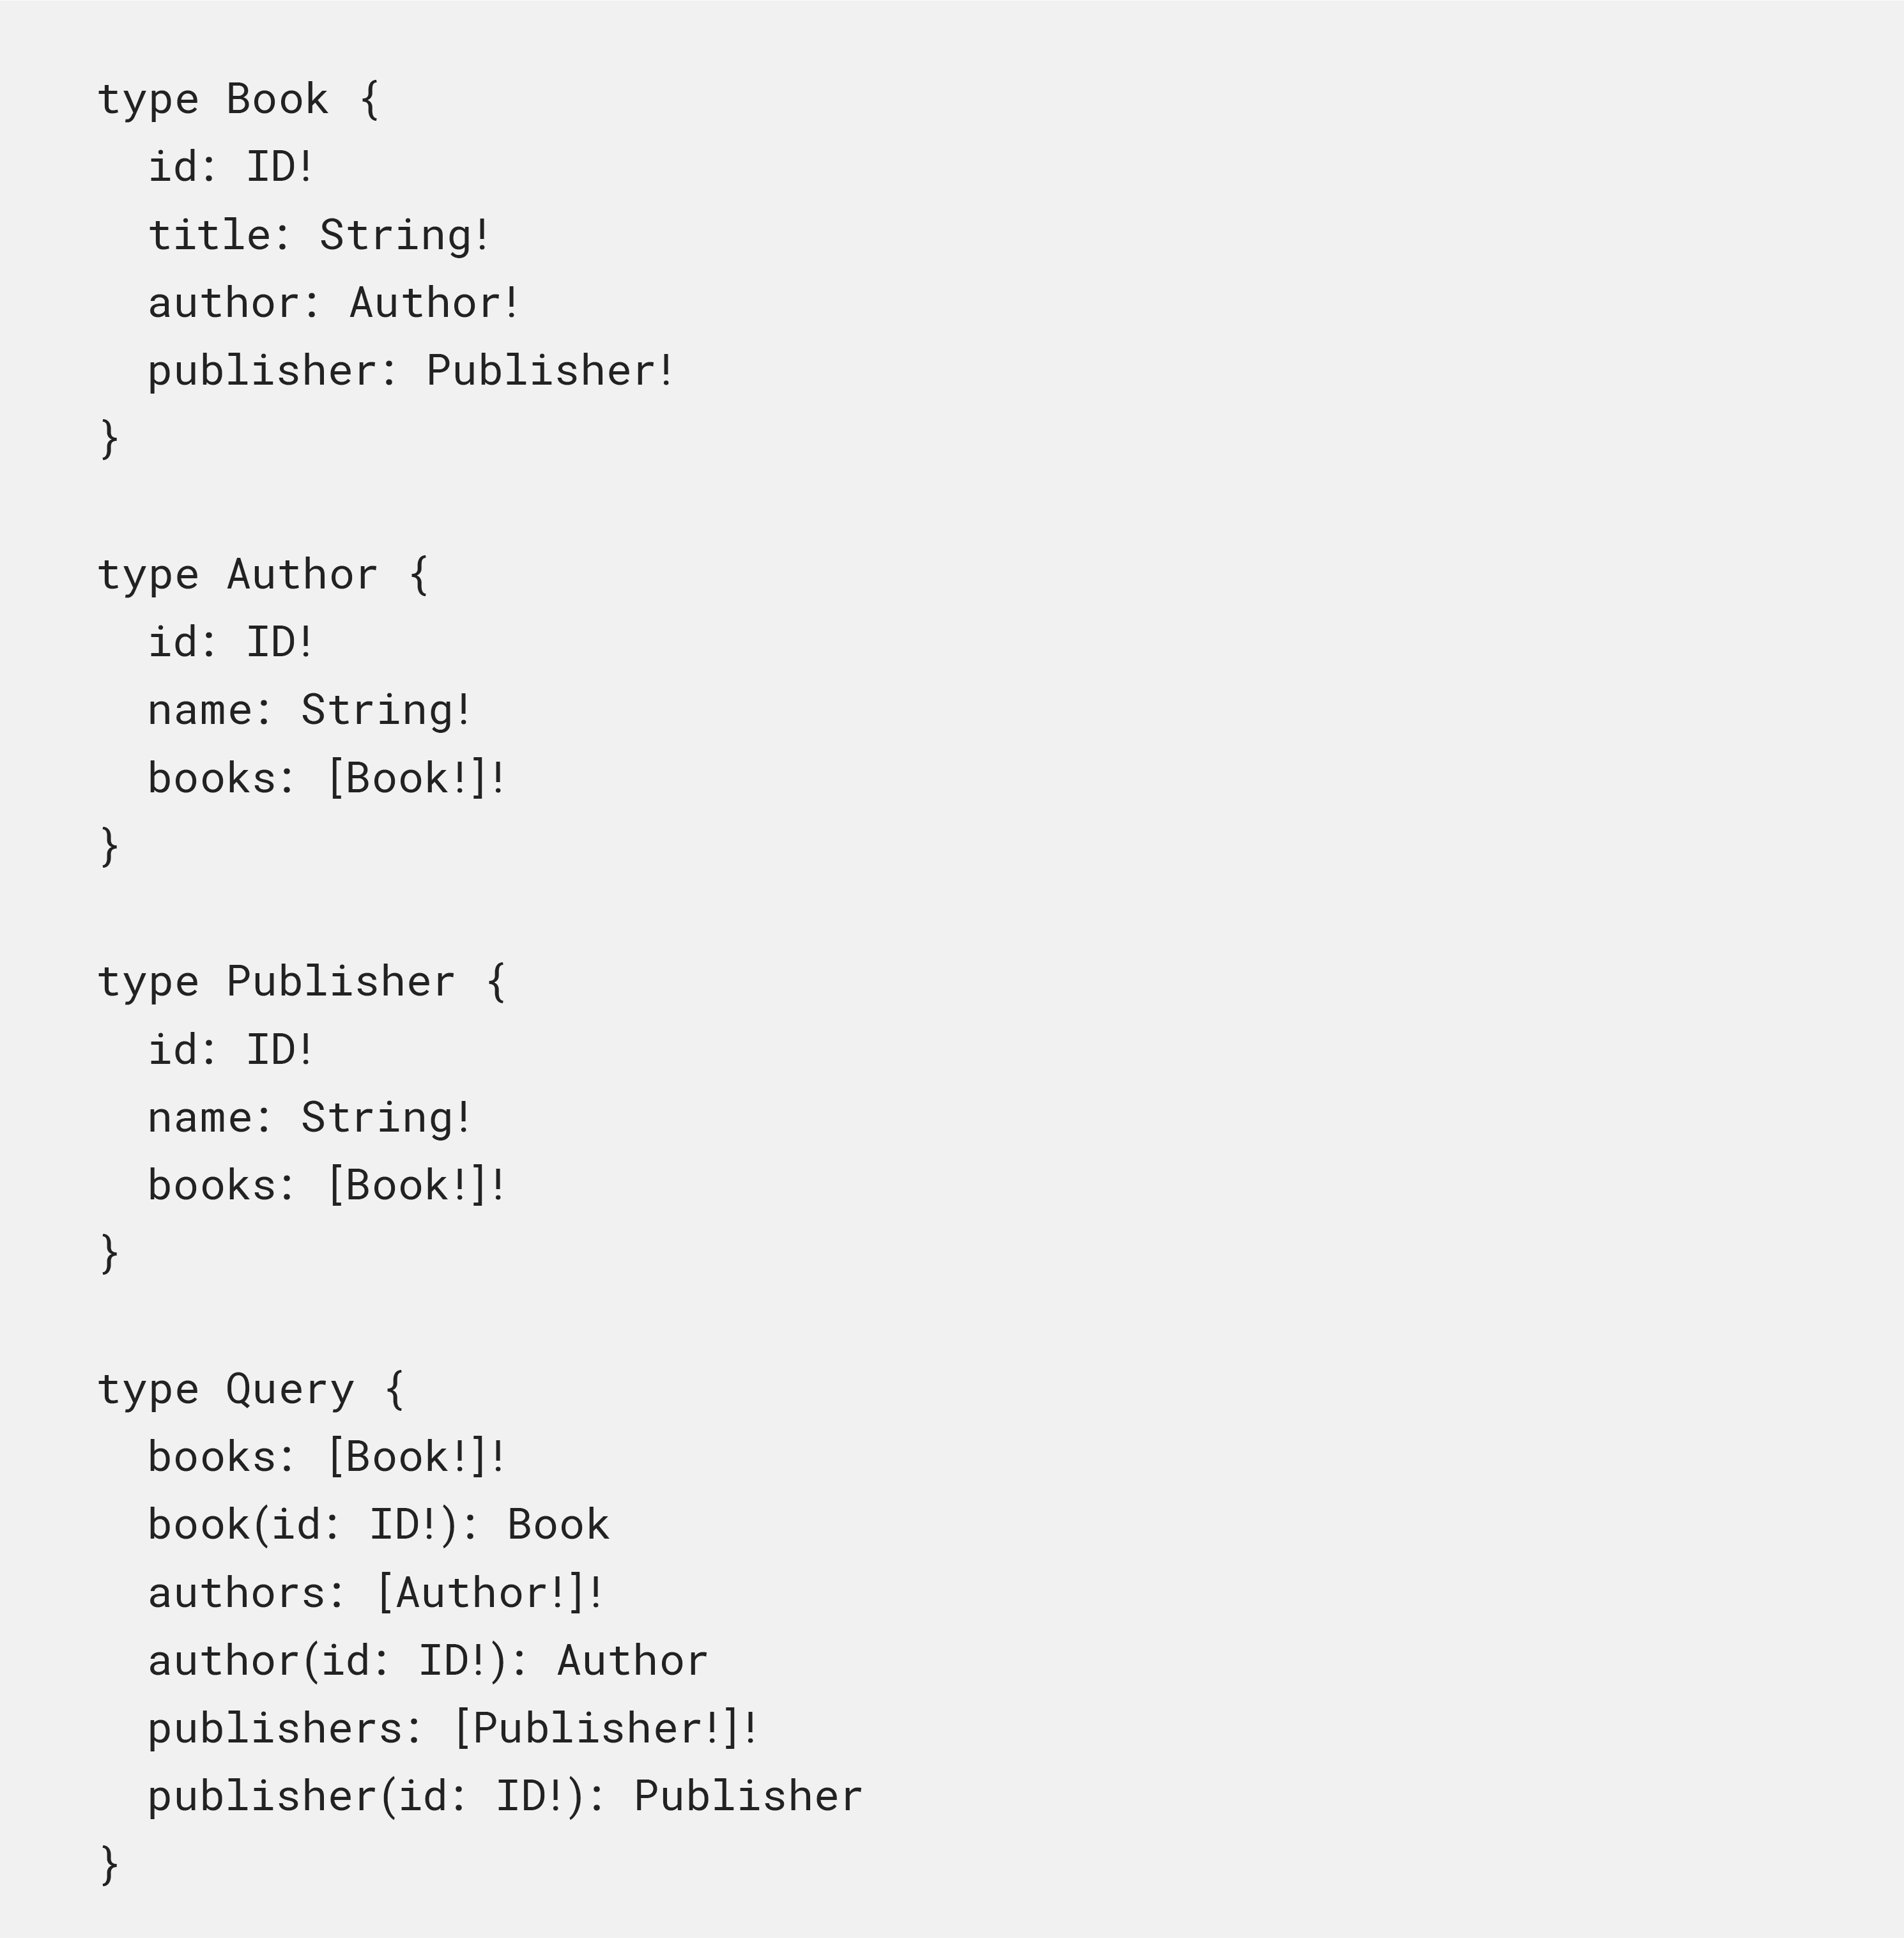
GraphQL cuenta con un esquema fuertemente tipado que garantiza claridad y precisión al definir la estructura y los tipos de datos que se pueden consultar desde una API. Supongamos que tenemos una API para una biblioteca que contiene libros, autores y editoriales.
a) Esquema de GraphQL: En GraphQL, un esquema fuertemente tipado tendría el aspecto que se muestra en la figura 2:
Los esquemas fuertemente tipados de GraphQL ofrecen ventajas en materia de seguridad, ya que permiten validar los datos de entrada, evitan la obtención excesiva o insuficiente de datos, proporcionan documentación clara y compatibilidad con herramientas, facilitan el control de versiones y contribuyen a la autorización y al control de acceso. Estas características mejoran la seguridad de las API al reducir el riesgo de vulnerabilidades comunes y garantizar una gestión adecuada de los datos y los accesos.
En el ejemplo mostrado (Figura 2), el esquema define los tipos de datos de los libros, autores y editoriales, así como las relaciones entre ellos. El esquema está fuertemente tipado, lo que significa que cada campo tiene un tipo de datos específico y que los clientes pueden consultar fácilmente el esquema para descubrir los campos disponibles y sus tipos.
b) Esquema REST: En REST, la definición del esquema tendría un tipado flexible, como se muestra en la figura 3:
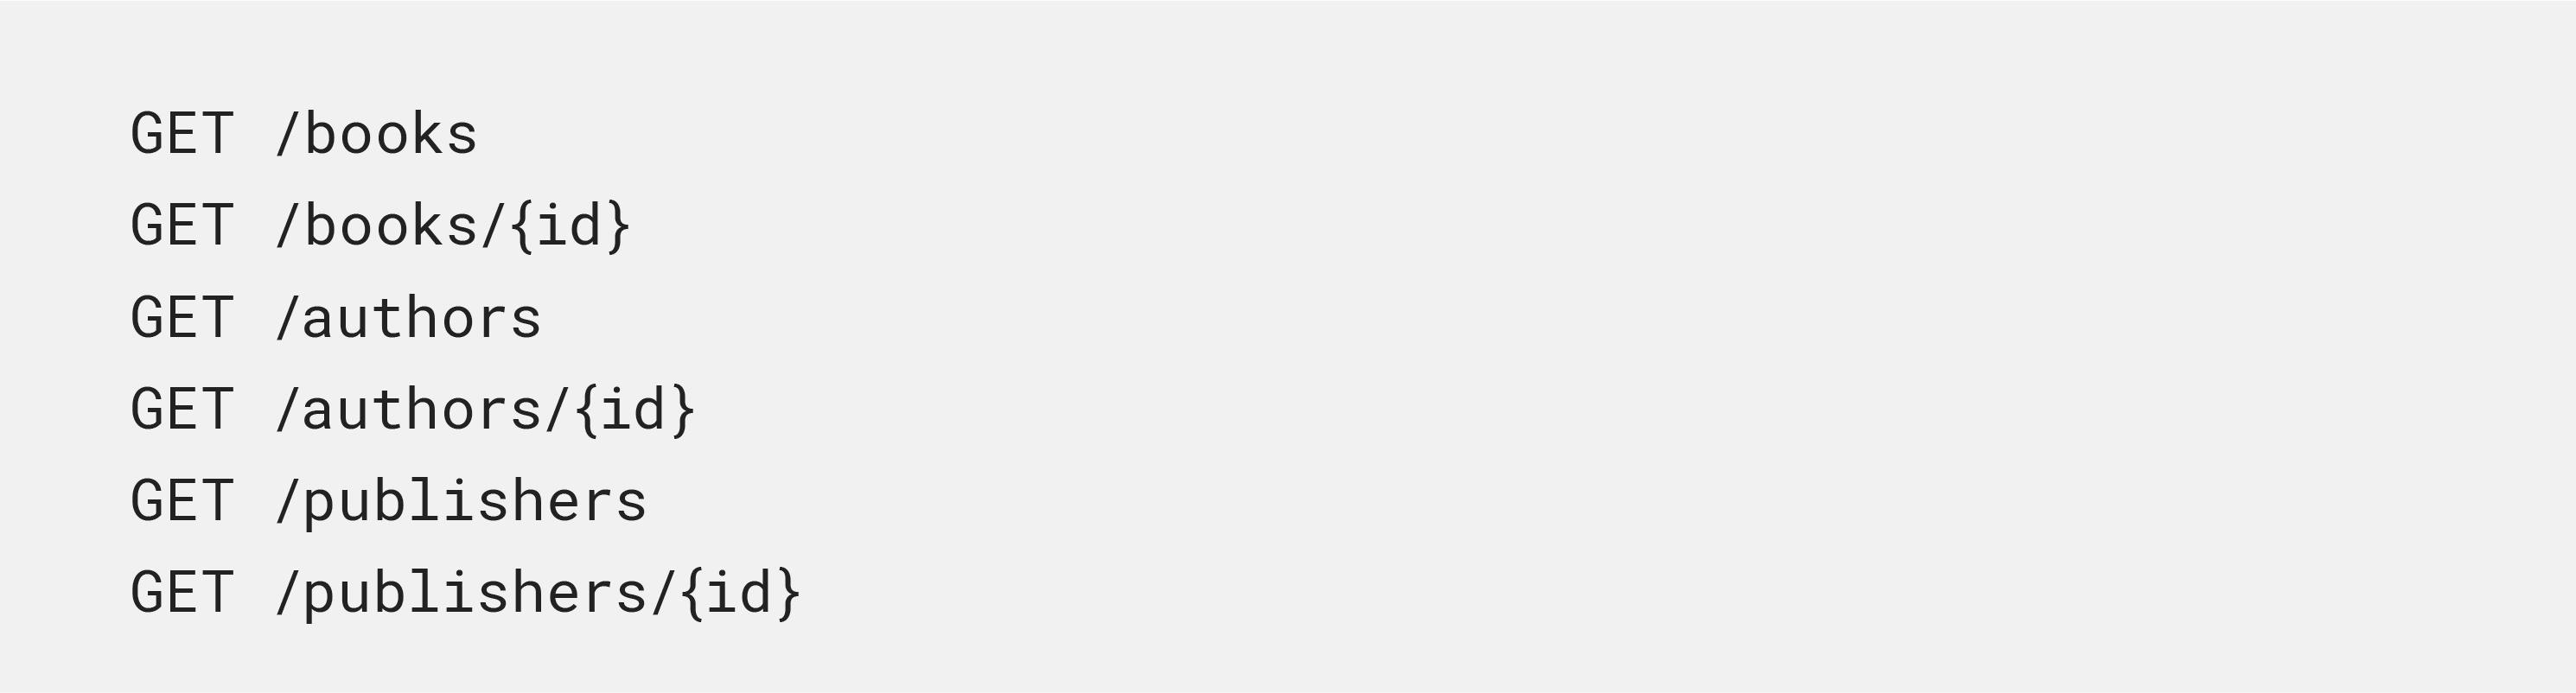
Estos endpoints devuelven objetos JSON que representan los libros, los autores y las editoriales, pero el esquema en sí no está definido explícitamente y queda sujeto a la habilidad y la interpretación del programador. Los clientes tendrán que consultar la documentación para comprender la estructura de los datos.
Más allá de REST
GraphQL ha evolucionado hasta convertirse en algo más que una alternativa mejor a REST y tiene el potencial de ser el enfoque preferido por las empresas que buscan una estrategia de datos más eficaz. Además de resolver las limitaciones de REST, existen otras razones por las que GraphQL se ha convertido en un nuevo enfoque para el diseño de API. Aunque la tabla (Figura 4) muestra las ventajas de GraphQL frente a REST, es más adecuado considerar GraphQL como una respuesta a la evolución de internet y de las distintas aplicaciones, en lugar de como una respuesta a los problemas detectados en el propio REST.
| ATRIBUTOS | GRAPHQL | REST |
|---|---|---|
MODELADO DE DATOS FLEXIBLE |
GraphQL permite a los desarrolladores definir y adaptar fácilmente las API para satisfacer requisitos cambiantes. Los clientes pueden especificar con precisión los datos que necesitan mediante el lenguaje de consulta, lo que permite un proceso de recuperación de datos más flexible y eficiente. |
Normalmente, el servidor define endpoints fijos que devuelven estructuras de datos predefinidas. Los clientes tienen un control limitado sobre la forma y la estructura de la respuesta, lo que a menudo provoca una obtención excesiva o insuficiente de datos. REST carece del control detallado sobre la recuperación y composición de datos que ofrece GraphQL. |
CONSULTAS POR LOTES |
GraphQL permite combinar varias consultas en una sola solicitud, lo que puede reducir considerablemente el número de comunicaciones de ida y vuelta entre el cliente y el servidor y mejorar el rendimiento. |
REST no dispone de ningún mecanismo integrado para agrupar varias consultas en una sola solicitud. Cada solicitud REST suele corresponder a un único recurso o endpoint. Algunos frameworks o extensiones de REST pueden ofrecer formas de agrupar varias solicitudes, pero no son nativas ni están estandarizadas como en GraphQL. |
CONSULTAS Y RESPUESTAS TIPADAS |
Los clientes pueden especificar exactamente los datos que necesitan y los servidores pueden responder únicamente con los datos solicitados, lo que reduce la obtención excesiva o insuficiente. Además, GraphQL utiliza tipado fuerte, lo que ayuda a evitar errores y mejora la compatibilidad con las herramientas. |
El tipado no se aplica de forma inherente en las consultas y respuestas. La estructura y el formato de los datos suelen estar predefinidos por el servidor, y los clientes deben interpretar y gestionar los datos en consecuencia. Esto puede reducir la seguridad de tipos. |
INTEGRACIÓN CON FRAMEWORKS DE FRONT-END |
GraphQL está diseñado para funcionar bien con frameworks de front-end como React y Vue, lo que facilita la creación de aplicaciones web modernas e interactivas. GraphQL cuenta con bibliotecas y herramientas específicas para una integración fluida. |
Aunque REST puede utilizarse con frameworks de front-end, la integración puede requerir más trabajo manual e implementaciones personalizadas. Si bien existen bibliotecas de terceros, REST no proporciona una forma estandarizada de integrarse con frameworks de front-end específicos como React o Vue. |
CONSULTAS BASADAS EN GRAFOS |
GraphQL permite realizar consultas complejas que abarcan varios recursos y relaciones en una sola solicitud, lo que facilita la obtención de los datos necesarios para crear interfaces de usuario complejas. |
REST suele seguir un enfoque centrado en los recursos, en el que cada endpoint representa un recurso o una entidad específicos. No proporciona de forma inherente un mecanismo para consultar datos de varios recursos o relaciones en una sola solicitud. |
RENDIMIENTO |
La capacidad de GraphQL para solicitar con precisión solo los datos necesarios puede permitir una recuperación de datos más eficiente y mejorar el rendimiento. |
Las API REST pueden obtener datos en exceso o de forma insuficiente, ya que los clientes tienen un control limitado sobre la estructura de la respuesta. Esto puede afectar al rendimiento, especialmente si la API devuelve datos excesivos o innecesarios. |
PRODUCTIVIDAD DE LOS DESARROLLADORES |
La naturaleza autodocumentada de GraphQL, con sus capacidades de introspección, reduce la necesidad de documentación exhaustiva y favorece una mejor comprensión del modelo de datos. El esquema con tipado fuerte y la validación de consultas fomentan una comprensión compartida y permiten detectar errores de forma temprana. GraphQL cuenta con un lenguaje de consulta intuitivo y una curva de aprendizaje más sencilla, lo que facilita la incorporación y la transferencia de conocimientos dentro de los equipos de desarrollo. |
Debido a la falta de un contrato estandarizado entre el cliente y el servidor, el conocimiento interno del equipo se resiente. Las API REST suelen depender de documentación informal o de convenciones que varían entre las distintas implementaciones. La falta de una comprensión compartida genera incoherencias y lagunas de conocimiento dentro de los equipos. Esto obliga a los desarrolladores con más antigüedad en el equipo a dedicar un tiempo valioso a formar a sus compañeros en lugar de centrarse en el problema empresarial. Esta dependencia de determinadas personas para la documentación fragmenta el conocimiento interno y dificulta que todos los miembros del equipo comprendan plenamente las capacidades y estructuras de datos de la API. |
VERSIONADO DE API |
La ventaja inherente de GraphQL en cuanto al versionado reside en la posibilidad de marcar como obsoletos los campos que se van a eliminar, lo que da tiempo a los desarrolladores del lado del cliente para adaptarse. También es posible aplicar un versionado similar al de las API REST. |
REST no ofrece de forma inherente la posibilidad de marcar campos como obsoletos. Corresponde a los desarrolladores del lado del cliente asegurarse de que utilizan la versión correcta de la API. |
Figura 4: Ventajas de GraphQL frente a REST
DESAFÍOS DE GRAPHQL
Aunque GraphQL ofrece muchas ventajas frente a las API RESTful tradicionales, su uso también plantea algunos desafíos. Entre los más habituales se incluyen:
- Curva de aprendizaje: Dado que la mayoría de los desarrolladores están más familiarizados con REST, las organizaciones que tengan previsto adoptar GraphQL deberán reservar tiempo para que sus equipos aprendan a utilizarlo de forma eficaz. GraphQL requiere una forma distinta de concebir la creación y el consumo de API, y su adopción podría exigir cambios en la arquitectura subyacente de la aplicación. Es posible que los desarrolladores tengan que aprender nuevos conceptos, como esquemas, resolutores y tipos, además de nuevas herramientas y bibliotecas. Con GraphQL, los clientes tienen un mayor control sobre los datos a los que pueden acceder, lo que puede dificultar la protección de las API. Es posible que técnicas como la validación de entradas, la autenticación y la autorización deban aplicarse de forma distinta que con las API RESTful.
- Almacenamiento en caché: El almacenamiento en caché puede ser más complejo con GraphQL, ya que los clientes pueden solicitar datos diferentes en cada consulta, lo que dificulta almacenar en caché y reutilizar las respuestas.
- Rendimiento: Aunque GraphQL permite a los clientes solicitar únicamente los datos que necesitan, también puede dar lugar a consultas más complejas y que consumen más recursos. Las API de GraphQL pueden presentar problemas de rendimiento, especialmente al consultar grandes conjuntos de datos o cuando se realizan muchas solicitudes simultáneas. Los desarrolladores deben implementar estrategias como limitar la profundidad de las consultas o garantizar que los clientes estén autorizados a acceder únicamente a los datos específicos que necesitan.
- Gestión de errores: GraphQL puede complicar la gestión de errores, ya que estos pueden devolverse como parte de la respuesta en lugar de mediante un código de estado HTTP independiente.
- Pruebas: Las pruebas con GraphQL plantean dificultades debido a la complejidad de las consultas, la falta de enfoques de prueba estandarizados, la evolución del esquema y la validación de las consultas durante la ejecución. Los desarrolladores deben dedicar tiempo a encontrar marcos y herramientas de prueba adecuados para afrontar estas dificultades. Asimismo, deben garantizar una cobertura de pruebas exhaustiva seleccionando las herramientas apropiadas y teniendo en cuenta la evolución del esquema para probar eficazmente las API de GraphQL y garantizar su funcionalidad y estabilidad.
- Monitorización: Monitorizar las API de GraphQL puede resultar complicado debido a la complejidad de las consultas, la falta de registros y métricas estandarizados y la posibilidad de que surjan problemas de rendimiento. La naturaleza dinámica de las consultas de GraphQL dificulta la predicción y monitorización de la estructura y el tamaño de los datos solicitados. La ausencia de herramientas de monitorización estandarizadas específicas para las API de GraphQL dificulta la obtención de información sobre el rendimiento de las consultas de GraphQL, el seguimiento de errores y el estado de la API. Los desarrolladores deben adoptar herramientas y prácticas de monitorización especializadas que puedan gestionar las características únicas de GraphQL para garantizar un rendimiento eficiente y un funcionamiento fiable.
Patrones de uso de GraphQL
GraphQL es una herramienta potente que puede utilizarse en una amplia variedad de aplicaciones, desde la creación de API hasta el funcionamiento de aplicaciones móviles. Su flexibilidad y capacidad para unificar fuentes de datos hacen que sea idóneo para diversos patrones de uso.
- Creación de API eficientes: Uno de los principales usos de GraphQL es crear API que puedan utilizar aplicaciones web y móviles. GraphQL ofrece una forma flexible y potente de definir y acceder a los datos, por lo que resulta idóneo para crear API que deban admitir una amplia variedad de clientes y casos de uso.
- Obtención y manipulación de datos: GraphQL se puede utilizar para obtener y manipular datos de diversas fuentes, como bases de datos, servicios en la nube y otras API. Al proporcionar una forma unificada de acceder a los datos, GraphQL puede ayudar a simplificar el proceso de creación y mantenimiento de aplicaciones basadas en datos.
- Casos de uso en tiempo real: GraphQL es muy adecuado para casos de uso en tiempo real, ya que los clientes pueden suscribirse a actualizaciones de datos específicos y recibir notificaciones cuando estos cambian. Esto puede utilizarse en aplicaciones como chats, retransmisiones en directo, paneles de control en tiempo real y muchas otras.
- Microservicios: GraphQL puede utilizarse para crear una arquitectura flexible y débilmente acoplada que permita a distintos microservicios comunicarse entre sí de forma coherente y bien definida.
- Del back-end al front-end: GraphQL se puede utilizar para crear una arquitectura de back-end para front-end (BFF), que permite a distintos clientes front-end acceder a datos y servicios de forma coherente y eficiente.
- Desarrollo móvil: GraphQL puede utilizarse para impulsar aplicaciones móviles, ya que permite acceder a datos y servicios de forma coherente y eficiente, independientemente de la plataforma o el dispositivo.
Experiencias de adopción de GraphQL en la industria (casos prácticos)
Existen motivos evidentes por los que necesitamos GraphQL, como se observa en las siguientes implementaciones en el sector:
NETFLIX
Netflix resumió su experiencia con GraphQL en 2020 en una serie de dos artículos de blog de lectura obligada para cualquier profesional de GraphQL. El caso práctico que presentó fue el sistema Studio Edge, en el que tomó sus API de estudio y rediseñó su arquitectura para GraphQL. Los equipos de contenidos de Netflix utilizan la API Studio para gestionar y supervisar la producción, la posproducción y la distribución de series y películas. La API permite acceder a una enorme cantidad de datos, incluidos metadatos sobre títulos, información sobre profesionales y mucho más.
Inicialmente, la API de Studio se creó utilizando una arquitectura RESTful tradicional, con endpoints que devolvían datos en formato JSON. Sin embargo, a medida que la API crecía y aumentaba el número de clientes que accedían a ella, quedó claro que se necesitaba una solución más eficiente.
Netflix comenzó a explorar GraphQL como posible solución para la API de Studio. Empezó creando un grafo seleccionado específicamente para esta API. Identificó varias ventajas clave, como la posibilidad de reducir el uso de la red, simplificar el acceso a los datos y mejorar el rendimiento al permitir que los clientes soliciten únicamente los datos que necesitan.
Netflix también se enfrentó a algunos retos específicos al adoptar GraphQL para la API de Studio, especialmente a la hora de gestionar la complejidad del esquema y garantizar que los clientes solo pudieran acceder a los datos que estaban autorizados a consultar.
Para abordar estos retos, Netflix desarrolló una solución personalizada denominada «Netflix GraphQL Federation», que utiliza la especificación Apollo Federation para dividir el esquema de la API de Studio en partes más pequeñas y fáciles de gestionar. También implementó un sistema para gestionar los permisos y el control de acceso, lo que le permite restringir el acceso de los clientes a determinadas partes del esquema.
En el blog también publicaron la evolución de la arquitectura de su API, desde un monolito hasta una puerta de enlace federada. La figura 5 es una adaptación de la imagen de su blog.
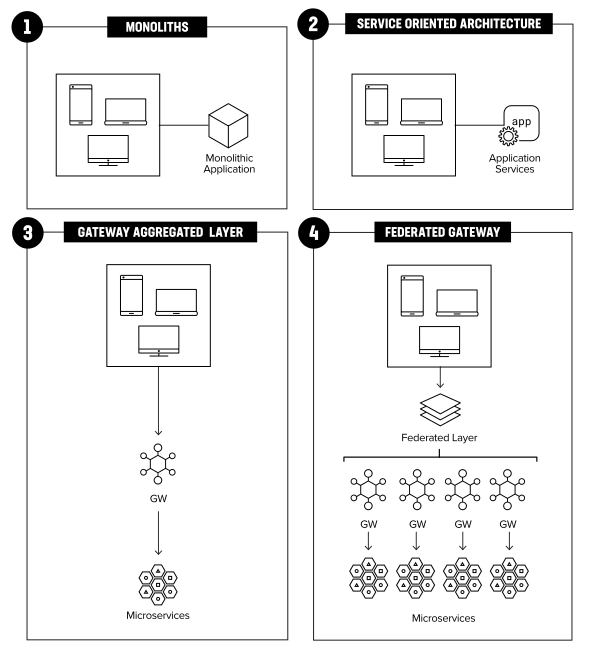
Creemos que falta otro enfoque que puede estar muy extendido en el sector, pero que aún no se ha formalizado.
Se podrían combinar la capa agregada de pasarela y la pasarela federada de la Figura 5, como se muestra a continuación:
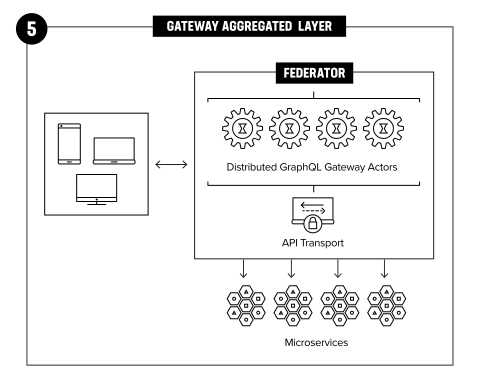
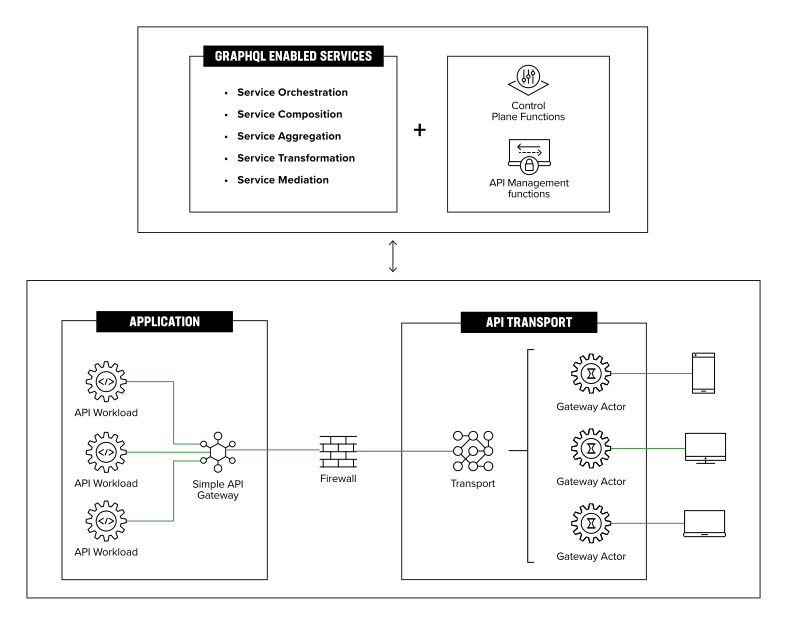
Cada icono de engranaje representa, en esencia, una instancia de GraphQL efímera y federada (también denominada actor de puerta de enlace) que puede instanciarse en tiempo real (incluso para cada transacción) en el extremo de la red, es decir, topológicamente cerca de los clientes, y conectarse a los microservicios mediante un transporte de API seguro. Esta combinación sustituye, en esencia, la capa de agregación de la puerta de enlace, o capa federada, por actores de puerta de enlace distribuidos que reúnen lo mejor de ambas funcionalidades. A esto lo denominamos arquitectura de actores de puerta de enlace de GraphQL distribuidos, como se muestra en la Figura 7.
OTROS PRIMEROS ADOPTANTES
PayPal
PayPal inició su andadura con GraphQL en 2018 cuando lo incorporó a su aplicación Checkout. Su principal preocupación respecto a REST, al igual que en el caso de Meta, era que sus principios de diseño no estaban optimizados para las aplicaciones web y móviles ni para sus usuarios. Las aplicaciones cliente realizaban numerosos viajes de ida y vuelta entre el cliente y el servidor, y tardaban aproximadamente 700 ms en obtener los datos. Esto se traducía en tiempos de renderizado más lentos, frustración para los usuarios y tasas de conversión más bajas. En el caso de la aplicación de pago, PayPal descubrió que los desarrolladores de interfaces de usuario (UI) dedicaban menos de un tercio de su tiempo a crear la interfaz, mientras que el resto lo empleaban en averiguar cómo obtener y procesar los datos.
Las otras tecnologías que el equipo de ingeniería de PayPal tuvo en cuenta fueron las API de orquestación y Bulk REST. Crear una API de orquestación daría lugar a una obtención excesiva de datos y al acoplamiento de los clientes con el servidor. PayPal llegó a la conclusión de que, con el tiempo, este enfoque puede hacer que la API se vuelva pesada, poco elegante y sirva para más de un propósito. Su experimento con Bulk REST tampoco tuvo éxito. Aunque evitaba que el equipo de ingeniería tuviera que ajustar las API de orquestación, exigía que sus clientes conocieran en profundidad el funcionamiento de las API.
La primera experiencia de PayPal con GraphQL para crear un nuevo producto fue un SDK móvil destinado a integrar PayPal Checkout en aplicaciones. Tras una semana evaluando GraphQL, el equipo de ingeniería decidió utilizarlo para su nuevo producto. Aunque la API aún no estaba lista, pudieron completar el producto antes de lo previsto sin apenas necesitar conocimientos específicos sobre PayPal. Los desarrolladores pudieron crear rápidamente una aplicación eficiente y fácil de usar, lo que convenció al equipo de ingeniería para adoptar plenamente GraphQL en su conjunto de tecnologías.
Starbucks
Starbucks contrató a un tercero para desarrollar su aplicación web progresiva (PWA).
El equipo recibió el encargo de crear un sistema de pedidos capaz de gestionar de forma eficiente y eficaz una lógica empresarial compleja. Dado que los clientes pueden personalizar sus pedidos, el equipo de desarrollo tuvo que garantizar que el sistema pudiera gestionar múltiples casos con una lógica empresarial específica y enviar los datos adecuados al lugar correcto en el momento oportuno.
GraphQL permitió al equipo crear una API eficiente con almacenamiento en caché y renderizado del lado del servidor para mejorar la funcionalidad sin conexión. El equipo también utilizó React para incorporar animaciones y crear una experiencia de usuario dinámica y atractiva.
GraphQL en F5
El objetivo de la Oficina del CTO de F5 era comprender cómo podíamos utilizar GraphQL en el ecosistema de F5. Tenemos dos proyectos en marcha que exploran el uso de GraphQL.
MEJORA DE LOS MODELOS DE DATOS Y LA VISIBILIDAD
La suite de gestión de pruebas (TMS) que ofrece F5 permite a los clientes probar los endpoints o clientes de sus propios sistemas y comprobar si son humanos o bots.
Este fue un proyecto de uso interno destinado a agilizar el desarrollo y las pruebas del software TMS. El objetivo principal era extraer los datos JSON almacenados en la base de datos SQL existente, convertirlos en datos de grafos e implementar una API GraphQL para realizar consultas.
Esto era necesario porque la base de datos actual plantea varios problemas, entre ellos el «problema de los blobs JSON», que surge al almacenar metadatos como objetos JSON en una base de datos tabular. Analizar y gestionar estos objetos resulta intrínsecamente costoso e ineficiente. Además, debido a su naturaleza de grafo, los blobs JSON contienen datos valiosos que pueden mejorar aún más los productos y la seguridad de F5. Al migrar a una base de datos de grafos dirigidos, los blobs JSON pueden analizarse y gestionarse de forma eficiente mediante relaciones dirigidas, optimizando la transferencia y el uso de los datos.
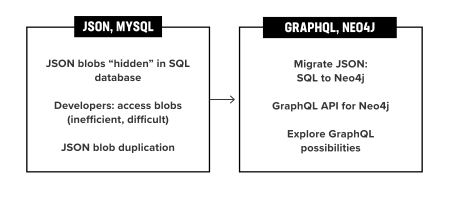
Los resultados son alentadores. Al identificar qué tablas de la base de datos relacional de TMS contienen objetos JSON, determinamos que migrar a una GraphDB y utilizar GraphQL podría multiplicar nuestra visibilidad del sistema.
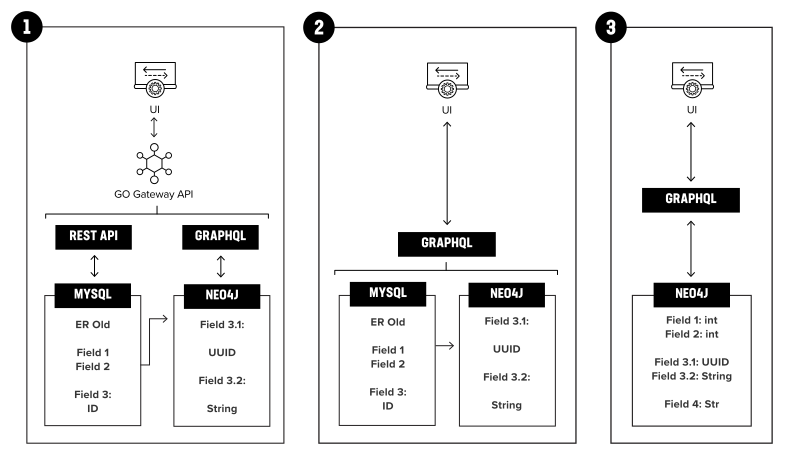
La figura 9 muestra las posibles evoluciones u opciones de implementación para este proyecto. Cada opción tiene sus propias implicaciones.
La opción 1 es la que menos afecta a la interfaz de usuario, ya que no es necesario modificar el cliente. Un modo híbrido, como el de las opciones 1 o 2, puede funcionar bien según la situación, especialmente si hay pocas columnas con objetos JSON. Además, el esquema derivado de cada JSON también sería pequeño.
Sin embargo, al planificarlo, nos dimos cuenta de que los objetos JSON necesitaban información contextual que estaba almacenada en otras columnas de la base de datos SQL. Además, el esquema almacenado en cada objeto JSON era bastante grande. Esto habría supuesto más trabajo de mantenimiento del código base. Por tanto, tras considerarlo detenidamente, decidimos rediseñar la arquitectura de la aplicación para que fuera compatible con GraphQL y Neo4J, tal como se muestra en la opción 3.
INTEGRACIÓN DE CLOUDGRAPH
CloudGraph es una API GraphQL universal, gratuita y de código abierto, y una herramienta de gestión de la postura de seguridad en la nube (CSPM) para AWS, Azure, GCP y Kubernetes (K8s). El objetivo del proyecto es utilizar CloudGraph para crear un «plugin de CloudGraph» (Figura 10) en el que se muestren los datos de F5 Distributed Cloud (F5XC), lo que permitirá mejorar la visibilidad de los recursos en la nube conectados mediante F5 Distributed Cloud.
Nuestro objetivo es integrarnos con CloudGraph para comprender en profundidad la tecnología y desarrollar futuras integraciones con CloudGraph, información útil y API de GraphQL para los datos de F5XC.
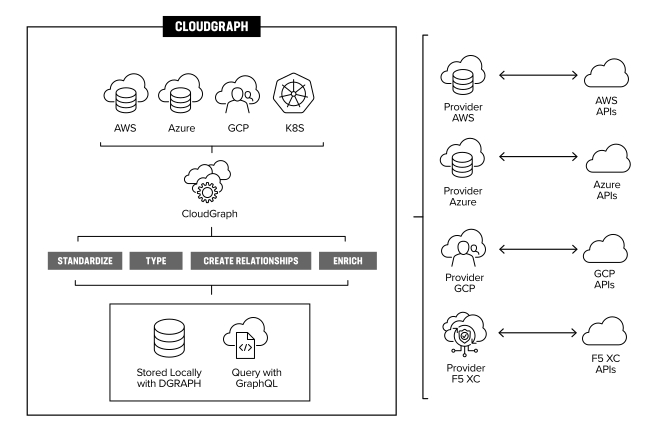
Tras integrar el proveedor personalizado de F5XC en la plataforma CloudGraph y utilizar la función de creación de relaciones de la plataforma, tendremos una mayor visibilidad de los recursos en la nube conectados mediante F5XC y de sus relaciones con otras nubes. A continuación, podremos generar consultas complejas sobre recursos de varias nubes para un mismo tenant. Esto nos permitirá ofrecer a las partes interesadas una visión global de F5XC y explorar una integración más profunda de CloudGraph para incorporar plugins adicionales de GraphQL e información personalizada sobre las operaciones en la nube relevantes para F5 y sus clientes.
A partir de las iniciativas anteriores, nuestra exploración inicial ha estado en consonancia con las experiencias descritas en los casos prácticos presentados anteriormente.
Problemas de seguridad de GraphQL
Las percepciones iniciales sobre la superioridad de GraphQL frente a REST en términos de seguridad han quedado desmentidas, ya que GraphQL, como cualquier otra tecnología, conlleva sus propios riesgos si no se implementa correctamente. Es importante reconocer que GraphQL no es intrínsecamente más seguro que otras tecnologías. Una implementación adecuada y el cumplimiento de las prácticas recomendadas son fundamentales para garantizar la seguridad de las API de GraphQL. Al desmontar este mito, podemos abordar GraphQL con una visión realista de sus implicaciones de seguridad y adoptar las medidas adecuadas para mitigar cualquier riesgo potencial.
ATAQUE DE INTROSPECCIÓN
GraphQL proporciona a los desarrolladores una potente herramienta denominada introspección, que les permite solicitar información sobre el esquema utilizado por un servicio GraphQL. Esta herramienta les permite conocer el servicio y su estructura. Sin embargo, la introspección conlleva ciertos riesgos. Habilitarla en un servicio GraphQL en producción implica que también se puede acceder a información confidencial del esquema. Esto supone un riesgo considerable, ya que los usuarios malintencionados pueden aprovechar la introspección para obtener datos confidenciales y causar posibles daños. Además, la introspección permite a estos usuarios identificar fácilmente operaciones potencialmente dañinas, puesto que pueden consultar el esquema completo y determinar qué consultas ejecutar. Las consecuencias de una filtración de este tipo pueden ser desastrosas, dependiendo de la naturaleza del esquema y de los datos que contenga.
Mitigación: Una solución para mitigar los riesgos de la introspección consiste en desactivarla en las API de producción mediante diversos frameworks. Al desactivar la introspección, los desarrolladores pierden algunas de las prácticas funcionalidades que ofrece. Sin embargo, para recuperar su utilidad, pueden registrar el esquema GraphQL de la API de producción en herramientas como GraphOS. Esto les permite mantener un acceso controlado al esquema y a su información.
INYECCIÓN SQL
La inyección SQL es un ataque ampliamente conocido y frecuente que plantea riesgos que van desde la manipulación de datos hasta la eliminación completa de la base de datos. Este sencillo ataque aprovecha la concatenación de cadenas, lo que permite a un atacante insertar código ejecutable en los datos de entrada, obtener acceso no autorizado a la base de datos y realizar modificaciones maliciosas. Curiosamente, este vector de ataque no se limita únicamente a las bases de datos SQL, sino que también puede afectar a bases de datos de grafos como Neo4j. Neo4j utiliza el lenguaje de consulta Cypher, que se asemeja a SQL y hereda sus vulnerabilidades. Este tipo de ataque, conocido como inyección Cypher, aprovecha dichas similitudes, pero también se beneficia de las soluciones existentes sin necesidad de idear otras nuevas.
Mitigación: Entre las contramedidas se incluyen la depuración de las entradas de los usuarios para detectar y evitar su explotación, así como el uso de la parametrización para desvincular dichas entradas de la creación directa de consultas. Estas medidas reducen eficazmente el riesgo de ataques de inyección. Es fundamental abordar este problema de seguridad en las implementaciones de GraphQL, pero, afortunadamente, existen soluciones conocidas y fáciles de implementar.
ATAQUE A LA API PROXY REST
Superponer una API GraphQL a una API REST puede dar lugar a vulnerabilidades de falsificación de solicitudes del lado del servidor (SSRF). Los atacantes pueden aprovecharlas modificando los parámetros enviados a la API REST a través del proxy GraphQL. Si ninguna de las dos API valida los parámetros de llamadas específicas, los atacantes pueden hacerse con el control del sistema backend. Por ejemplo, añadir "/delete" al ID de un usuario en una consulta GraphQL puede provocar la eliminación involuntaria de datos al transferirse a la API REST.
Mitigación: Aunque esta vulnerabilidad constituye una preocupación legítima, puede abordarse eficazmente definiendo tipos en el esquema de GraphQL y validando exhaustivamente los parámetros antes de enviarlos a API o servicios externos. Es importante señalar que esta vulnerabilidad, al igual que otras asociadas a GraphQL, se debe a problemas de implementación y no a problemas inherentes al propio GraphQL. Estos problemas surgen cuando se hace un uso inadecuado de GraphQL debido a una mentalidad cortoplacista, pese al gran potencial de esta tecnología.
ATAQUES POR LOTES
Las vulnerabilidades de autenticación constituyen un vector de ataque habitual en diversos sistemas, incluido GraphQL. La capacidad de GraphQL para enviar varias consultas o mutaciones en una sola solicitud lo expone a ataques por lotes, que emplean métodos de fuerza bruta.
El primer tipo de ataque consiste en obtener contraseñas de inicio de sesión mediante fuerza bruta. Los atacantes envían una solicitud con numerosas mutaciones que contienen pares de credenciales de inicio de sesión. Dado que GraphQL permite incluir muchas mutaciones en una sola solicitud, este ataque elude los controles de limitación de solicitudes y permite crear una sesión mediante fuerza bruta de contraseñas.
El segundo tipo de ataque funciona de forma similar, pero tiene como objetivo un método habitual de autenticación de dos factores (2FA) denominado contraseña de un solo uso (OTP). Se envía una única solicitud con varias mutaciones, cada una de las cuales contiene unas credenciales de inicio de sesión válidas asociadas a una variante de OTP diferente. Si alguna de las mutaciones incluye la OTP correcta, la solicitud se autenticará y se establecerá una sesión.
Mitigación: Para abordar estas vulnerabilidades se requiere un enfoque integral, ya que no existe una solución infalible. Los desarrolladores desempeñan un papel fundamental al adoptar prácticas de programación seguras y prestar especial atención a la lógica de negocio. En el servidor web, es esencial implementar medidas como limitar los intentos de inicio de sesión y validar las entradas de los usuarios. Además, se debe prestar especial atención a la detección de solicitudes con múltiples mutaciones, ya que un intento legítimo de inicio de sesión normalmente no incluye más de una mutación.
ATAQUE DE DENEGACIÓN DE SERVICIO
Estos ataques consisten en saturar el servicio GraphQL con un tráfico excesivo, lo que le impide atender las solicitudes de usuarios legítimos y puede provocar fallos en el servidor. Los ataques de denegación de servicio (DoS) pueden llevarse a cabo mediante consultas GraphQL recursivas o enviando solicitudes de consulta de gran tamaño.
En el escenario de consultas recursivas, los atacantes aprovechan la naturaleza cíclica de las definiciones del esquema de GraphQL. Por ejemplo, si el esquema incluye los tipos autor y libro, un atacante puede consultar repetidamente el autor y el libro en bucle, saturando el servidor con llamadas recursivas e interrumpiendo su funcionamiento.
Como alternativa, los atacantes pueden realizar consultas que soliciten una gran cantidad de datos de la base de datos. Por ejemplo, una consulta puede recuperar numerosos autores y todos sus libros asociados. Una solicitud de datos de tal magnitud puede ralentizar considerablemente el sistema o provocar que deje de funcionar.
Mitigación: Existen varias soluciones para mitigar este problema. La primera consiste en establecer un tiempo de espera para las consultas, lo que impide que los usuarios realicen solicitudes que superen una duración determinada. Sin embargo, es posible que esto no resuelva por completo el problema, ya que el daño puede producirse dentro del tiempo asignado. Otra solución consiste en establecer límites para la profundidad y la complejidad de las consultas. Se pueden rechazar las consultas que superen la profundidad o la complejidad establecidas y que no se ajusten a la definición del esquema. Por último, limitar la frecuencia de las solicitudes de los usuarios puede resultar eficaz. Si un usuario envía un conjunto de solicitudes muy grande o varias solicitudes consecutivas, se le puede denegar temporalmente el acceso al servidor hasta que este esté preparado para procesar solicitudes adicionales.
Patrones de despliegue de GraphQL
Existen varios patrones de despliegue para GraphQL, como se muestra, cada uno con sus propias ventajas, desventajas y consideraciones. Algunos de los patrones más habituales son:
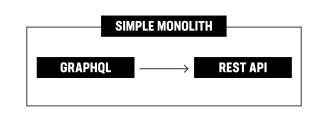
DESPLIEGUE MONOLÍTICO
Este es el patrón más sencillo y habitual para desplegar una API de GraphQL. En un despliegue monolítico, el servidor de GraphQL, la base de datos y cualquier otro servicio necesario se despliegan conjuntamente como una sola unidad. Esto puede facilitar los primeros pasos con GraphQL, pero puede resultar difícil de escalar y mantener a medida que crece la aplicación.
MONOLITOS COMPUESTOS
Los monolitos compuestos hacen referencia a una arquitectura en la que una aplicación monolítica se construye mediante una combinación de monolitos y microservicios, con GraphQL como capa de API (Figura 12). En este patrón, en lugar de dividir todo el sistema en microservicios independientes, la aplicación se desarrolla inicialmente como varios monolitos independientes que encapsulan toda la lógica de negocio y las capas de acceso a datos.
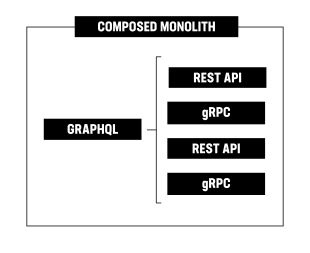
Dentro de esta estructura monolítica, GraphQL se implementa como capa de API, lo que permite a los clientes solicitar y recuperar datos de los distintos microservicios subyacentes. Esto significa que, aunque la aplicación sigue siendo monolítica desde el punto de vista del despliegue, utiliza GraphQL para combinar datos de varios servicios y presentarlos a los clientes de forma flexible y eficiente.
Este patrón ofrece ventajas como la simplificación del desarrollo y el despliegue, así como la posibilidad de aprovechar las potentes capacidades de consulta y obtención de datos de GraphQL. Permite a los desarrolladores adoptar progresivamente una arquitectura de microservicios sin renunciar a la flexibilidad y facilidad de uso que ofrece GraphQL.
SUBGRAFOS FEDERADOS
Los grafos federados en los patrones de despliegue de GraphQL combinan varios servicios GraphQL, denominados subgrafos, en un único esquema GraphQL unificado. Cada subgrafo representa un dominio o microservicio independiente, con sus propios datos y funcionalidades. Esta arquitectura utiliza una puerta de enlace central que dirige las consultas de los clientes al subgrafo adecuado en función de los campos solicitados. Al federar estos subgrafos, los desarrolladores pueden crear un grafo cohesionado que permita a los clientes realizar consultas y navegar sin interrupciones entre distintos servicios.
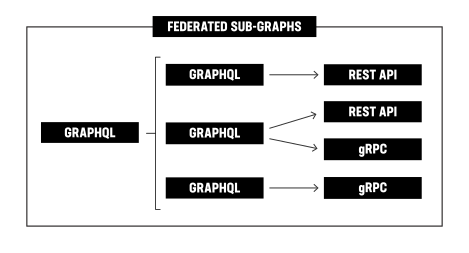
Este enfoque fomenta la modularidad, la escalabilidad y el desarrollo independiente de servicios, lo que se traduce en un mejor rendimiento y una mayor flexibilidad a la hora de crear API de GraphQL. Los subgrafos federados (Figura 13) ofrecen una forma eficaz de combinar datos de distintos servicios y crear una arquitectura distribuida y escalable.
GRAFOS HÍBRIDOS
Los grafos híbridos (Figura 14) de los patrones de despliegue de GraphQL combinan subgrafos federados y esquemas no federados mediante técnicas de composición. Este enfoque permite a las organizaciones integrar API de GraphQL existentes o sistemas heredados con microservicios federados, lo que da como resultado una API de GraphQL unificada que aprovecha las ventajas de ambos enfoques. Al fusionar esquemas y resolver las relaciones entre tipos y campos, la arquitectura de grafos híbridos ofrece flexibilidad, modularidad y escalabilidad.
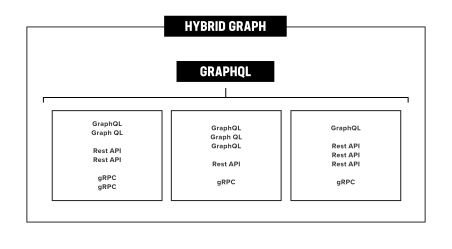
El patrón de grafo híbrido permite a las organizaciones adoptar gradualmente la federación mientras aprovechan sus recursos existentes. Facilita la integración fluida de subgrafos federados y esquemas no federados, adaptándose a distintos requisitos y fomentando la interoperabilidad. Este enfoque permite a las organizaciones crear API de GraphQL completas que pueden escalar y adaptarse a las necesidades cambiantes. Al combinar las ventajas de los servicios federados y no federados, los grafos híbridos ofrecen una solución flexible y potente para crear implementaciones de GraphQL.
Entre los retos que plantean los grafos híbridos en las implementaciones de GraphQL se encuentran la gestión de la complejidad de los esquemas combinados, la resolución de posibles problemas de sobrecarga de rendimiento, la garantía de la coherencia e integridad de los datos, la gestión de la evolución y el versionado del sistema, y las dificultades de supervisión y depuración en una arquitectura distribuida. Para superar estos retos y garantizar el correcto funcionamiento de las implementaciones de grafos híbridos, se requiere una planificación cuidadosa, optimización y prácticas de desarrollo sólidas.
ENRUTAMIENTO SIN SERVIDOR
Este patrón consiste en desplegar la API de GraphQL como un conjunto de funciones sin servidor, como AWS Lambda o Google Cloud Functions. Puede ser una forma rentable y escalable de desplegar una API de GraphQL, pero también puede introducir latencia adicional y aumentar la complejidad de la arquitectura.
El enrutamiento sin servidor plantea numerosos retos. Uno de ellos es conectar de forma fluida los subgrafos distribuidos a medida que la aplicación crece. La coordinación de varios equipos y despliegues puede volverse compleja, lo que dificulta la gestión y el escalado eficaz de los subgrafos. Garantizar la coherencia y la sincronización de los datos entre estos subgrafos supone otro obstáculo. La supervisión y la depuración en un entorno distribuido sin servidor pueden resultar más difíciles, por lo que se requieren mecanismos adecuados de registro y gestión de errores. Además, gestionar el control de acceso y la autorización en múltiples funciones sin servidor y subgrafos plantea dificultades. Abordar estos retos es esencial para garantizar el correcto funcionamiento y la escalabilidad de un despliegue de GraphQL basado en una arquitectura sin servidor.
DESPLIEGUE EN EL EDGE
En un patrón de despliegue en el edge para API de GraphQL, la API se sitúa más cerca de los clientes mediante un servicio de CDN. Esto aporta varias ventajas, como una menor latencia para obtener respuestas más rápidas, una reducción de la carga en el servidor de origen y protección frente a ataques DDoS.
Al distribuir la infraestructura de la API entre servidores perimetrales de todo el mundo, se puede gestionar el tráfico de forma más eficiente y ofrecer una mejor experiencia de usuario a escala global. Las funciones de almacenamiento en caché y filtrado de la CDN ayudan a mejorar la escalabilidad y garantizar la disponibilidad de la API, incluso ante un tráfico intenso o ataques maliciosos. Los despliegues en el perímetro pueden optimizar el rendimiento y la fiabilidad de una API aprovechando la red de servidores de las CDN.
Conclusión
Las tecnologías GraphQL han alcanzado la madurez suficiente para que las adopten las empresas tradicionales. Aunque el Ciclo de sobreexpectación de Gartner para las API de 2022 indica que aún faltan varios años para su adopción generalizada, hemos llegado a un punto de inflexión decisivo en el que ya se dispone de las herramientas necesarias. Aunque GraphQL sigue siendo relativamente nuevo, ha evolucionado hasta el punto de poder satisfacer las necesidades de empresas consolidadas y de gran envergadura.
La madurez de las tecnologías GraphAPI se debe al creciente número de empresas que están adoptando GraphQL y otras tecnologías de bases de datos de grafos. A medida que más empresas adoptan estas tecnologías, aumenta la disponibilidad de las herramientas y los recursos necesarios para utilizarlas, lo que facilita que otras empresas sigan su ejemplo. Además, las ventajas de las tecnologías GraphAPI —como la mejora de las consultas de datos y la reducción de la complejidad— gozan de un reconocimiento cada vez mayor, lo que impulsa aún más su adopción entre las empresas.
Como sector, debemos reconocer la importancia de las tecnologías GraphAPI, como GraphQL, y su potencial para superar las limitaciones de REST. Las empresas no deben pasar por alto la necesidad urgente de invertir en GraphQL y comprenderlo, especialmente en lo relativo al modelado, la diversidad y la opacidad de los datos. Aunque es fácil dejarse seducir por las funcionalidades y el potencial de GraphQL, también debemos reconocer la posible fase de desilusión tras alcanzar el pico de expectativas sobredimensionadas. Los proveedores deben dar prioridad a la mejora de sus productos para que sean plenamente compatibles con GraphQL, mientras que los departamentos de TI de las empresas —incluidos los proveedores— deben identificar qué datos se beneficiarían de su exposición mediante GraphQL para mejorar la productividad.
Los clientes deben dar prioridad a la comprensión de sus datos y reconocer que una empresa media funciona de forma distinta a los hiperescaladores que introdujeron originalmente GraphQL. Trabajemos juntos para adoptar GraphQL como un patrón eficaz de arquitectura de software e impulsar el sector hacia una mayor productividad e innovación.