
Políticas en el payload: preparación para arquitecturas de agentes de IA
Los agentes de IA están cambiando la forma en que las aplicaciones interactúan con la infraestructura. A diferencia de los sistemas tradicionales, los agentes incorporan en cada solicitud sus propios objetivos, contexto y lógica de decisión: qué hacer, cómo recuperarse y qué se considera un resultado satisfactorio. Este cambio rompe con supuestos arraigados sobre la gestión del tráfico y obliga a replantearse la infraestructura empresarial. El enrutamiento estático, los recursos compartidos y las políticas centralizadas ya no son suficientes en un mundo donde cada solicitud es autónoma.
Las arquitecturas de agentes exigen que la infraestructura evolucione de una ejecución reactiva a una interpretación en tiempo real de la intención integrada. Las empresas que reconozcan este cambio pueden prepararse adaptando sus inversiones actuales, en lugar de descartarlas.
Introducción
Los agentes de IA no son simples aplicaciones inteligentes. Representan un cambio estructural en la forma en que las aplicaciones funcionan, toman decisiones y se adaptan. A diferencia de los sistemas tradicionales, los agentes no se limitan a responder a las políticas de tráfico, sino que incorporan las suyas propias. Cada solicitud que envían contiene no solo datos, sino también lógica integrada: qué debe suceder, cómo debe funcionar el mecanismo alternativo y qué se considera un resultado satisfactorio.
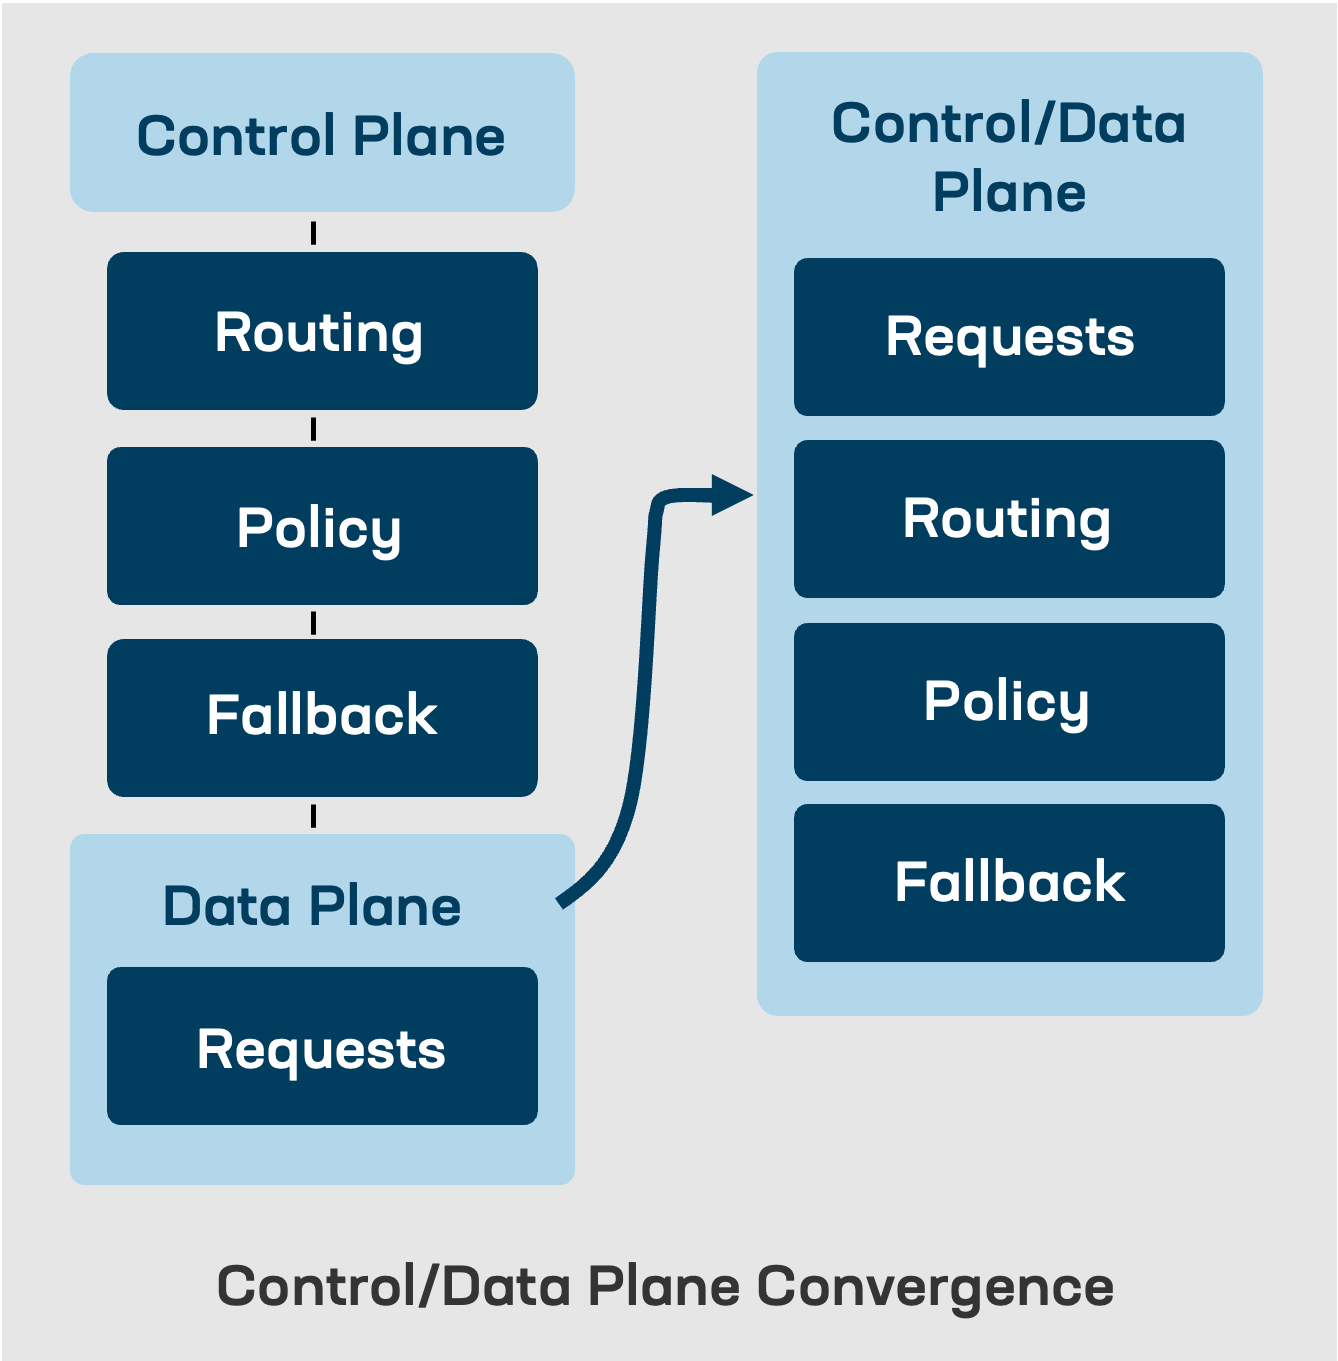
Este cambio traslada la toma de decisiones de los planos de control estáticos al propio entorno de ejecución. Elimina la separación tradicional entre los planos de control y de datos, lo que obliga a la infraestructura de tráfico —balanceadores de carga, puertas de enlace y proxies— a interpretar las políticas de cada solicitud, en lugar de limitarse a ejecutar de forma pasiva rutas preconfiguradas.
Este documento analiza cómo las arquitecturas de agentes cuestionan supuestos fundamentales de la ingeniería de tráfico, desde las comprobaciones de estado y la lógica de respaldo hasta la observabilidad y la aplicación de políticas de seguridad. Explica por qué los enfoques tradicionales, como los grupos estáticos y las métricas de estado basadas en promedios, ya no son suficientes en un mundo donde la intención se define para cada solicitud. Asimismo, sostiene que la infraestructura de capa 7 debe evolucionar o corre el riesgo de convertirse en un componente básico indiferenciado: fiable, pero estratégicamente invisible. Para adaptarse, las organizaciones deben replantearse su pila de gestión del tráfico y hacerla programable en tiempo de ejecución, consciente del contexto y compatible con protocolos nativos para agentes como Model Context Protocol (MCP). Esto implica rediseñar la lógica de respaldo, adoptar la observabilidad semántica y permitir la aplicación de políticas definidas por los agentes. Las herramientas emergentes, como el etiquetado de datos en tiempo real, ofrecen un apoyo esencial para esta transición.
En resumen, el futuro de la gestión del tráfico no consiste únicamente en entregar paquetes, sino en cumplir un propósito.
Arquitecturas de agentes: características clave
Las arquitecturas de agentes introducen un nuevo modelo operativo en el que componentes autónomos basados en IA generativa —denominados agentes— realizan tareas orientadas a objetivos, toman decisiones en tiempo real y conservan el contexto necesario para adaptar su ejecución sobre la marcha. Estos agentes funcionan de forma muy similar al encadenamiento de servicios actual, pero sin depender de flujos de trabajo preconfigurados. En su lugar, determinan el flujo de ejecución adecuado en tiempo de ejecución en función de los objetivos, el estado del entorno y los resultados observados.
Este cambio supone pasar de los sistemas tradicionales, orquestados de forma centralizada y con flujos de trabajo predeterminados, a sistemas descentralizados y dinámicos capaces de crear rutas de ejecución en tiempo real. Sustituye la previsibilidad de las cadenas estáticas de microservicios por una toma de decisiones fluida y ágil, impulsada por datos e intenciones en tiempo real.
Los sistemas basados en agentes se definen por lo siguiente:
- Ejecución orientada a objetivos: Los agentes actúan en función de instrucciones o misiones, no de flujos de trabajo estáticos. Seleccionan API, modifican parámetros y cambian de ruta en función de si están logrando su objetivo. Ejemplo: Un agente encargado de «resolver una reclamación de un cliente» podría invocar las API de facturación, cuentas y mensajería de forma diferente según los resultados anteriores.
- Contexto portátil: Los agentes llevan consigo su propia memoria, estado y políticas. Mediante el Protocolo de Contexto de Modelo (MCP) o metadatos estructurados, incorporan este contexto en cada solicitud.
- Adaptación en tiempo de ejecución: En lugar de esperar a que la infraestructura tome una decisión, los agentes se adaptan sobre la marcha, reintentando, redirigiendo, escalando o ajustando las rutas de ejecución en tiempo real.
- Observabilidad integrada: Cada acción se describe a sí misma. Los agentes pueden explicar por qué eligieron una ruta, qué se evaluó y si se alcanzó un objetivo. Esto es observabilidad como comportamiento, no solo registros y métricas.
En conjunto, estos elementos transforman el panorama de las aplicaciones, que pasa de ser predecible a ser adaptativo y estar en constante evolución.
Impacto en la gestión tradicional del tráfico
Los sistemas actuales de gestión del tráfico se basan en límites claramente definidos:
- El plano de control define la intención: qué puntos finales son válidos, qué rutas se deben priorizar y qué políticas se aplican.
- El plano de datos ejecuta las decisiones: enruta las solicitudes, aplica medidas de seguridad y equilibra la carga.
Este modelo ha funcionado bien durante décadas, especialmente en arquitecturas orientadas a servicios y entornos de microservicios. Parte de la premisa de que los flujos de tráfico pueden modelarse de antemano y de que las cargas de trabajo siguen patrones predecibles.
Ejemplos:
- Un balanceador de carga dirige
/api/logina un grupo y/api/imagesa otro. - Las comprobaciones de estado marcan los nodos como disponibles o inactivos.
- Los umbrales estáticos determinan las condiciones de conmutación por error.
Estos sistemas se basan en:
- Fuerte acoplamiento de las políticas y la configuración a recursos estáticos, como pools y miembros específicos
- Estructuras estáticas como grupos y miembros
- Enrutamiento determinista basado en la ruta, la cabecera o el protocolo
- Orquestación centralizada para la detección de servicios, las comprobaciones de estado y la lógica de respaldo
Pero los sistemas basados en agentes introducen fluidez, autonomía y una lógica autodirigida que rompen con estos supuestos.
En las arquitecturas de agentes, la separación tradicional entre el plano de control y el plano de datos comienza a desdibujarse. Los agentes no se limitan a ejecutar solicitudes, sino que incorporan la lógica que define en qué consiste la solicitud, qué condiciones deben activar mecanismos alternativos, cómo se mide el éxito e incluso cuál debe ser la ruta preferida. Tradicionalmente, estas cuestiones corresponden al plano de control, pero los agentes las codifican en cabeceras, tokens o metadatos que viajan con la propia solicitud a través del plano de datos.
Esta convergencia implica que el plano de datos ya no puede actuar como un ejecutor pasivo de decisiones centralizadas. Debe interpretar activamente las políticas sobre la marcha. La solicitud ya no es solo un paquete, sino un artefacto de políticas. Como resultado, los balanceadores de carga, las puertas de enlace y las capas de enrutamiento deben dejar de ser componentes reactivos para convertirse en intérpretes en tiempo real de la intención transmitida por los agentes.
Este cambio socava el supuesto arquitectónico fundamental de que el plano de control es estático y está centralizado. En su lugar, la lógica de decisión pasa a ser distribuida, portátil y personalizada, acompaña a cada solicitud y se ejecuta en tiempo de ejecución. No se trata solo de un cambio en el despliegue, sino de un cambio en dónde y cómo se toman las decisiones.
Esto culmina, en la práctica, lo que Kubernetes inició al abstraer la infraestructura subyacente —las redes, el almacenamiento e incluso el enrutamiento del tráfico de capa 4— y convertirla en meras «tuberías» tras una interfaz de control declarativa. No eliminó esas capas, pero las relegó a un segundo plano. Pasaron a ser invisibles, automatizadas y subordinadas a un nuevo sistema basado en intenciones.
Las arquitecturas de agentes hacen lo mismo, pero con toda la pila, no solo con la infraestructura.
Interrupciones críticas en la gestión del tráfico
Para ilustrar estas disrupciones con un ejemplo real, consideremos un escenario de entrega local de aplicaciones:
Ejemplo: Un sitio regional de comercio electrónico utiliza un ADC para gestionar el tráfico interno de la API. Se asigna a un agente de IA la tarea de optimizar la velocidad de preparación de los pedidos. El agente detecta que un endpoint específico de la API, por ejemplo, /api/inventory/check, está experimentando una degradación del rendimiento debido al aumento de la complejidad de las solicitudes y a la contención en la base de datos del backend. Los algoritmos tradicionales de balanceo de carga, incluido el de «respuesta más rápida», no logran captar los matices de esta ralentización porque calculan el rendimiento como un promedio general de todas las respuestas de un miembro determinado del pool, en lugar de hacerlo por tarea o por llamada.
Para cumplir su SLA, el agente redirige estas solicitudes de comprobación de inventario a un grupo de nodos alternativo optimizado para consultas transaccionales. Para ello, etiqueta cada solicitud con una cabecera de contexto, como X-Task-Profile: inventory-sensitive. El balanceador de carga, si está configurado correctamente, puede interpretarla y dirigir el tráfico en consecuencia. Sin embargo, dado que estos nodos no se habían asignado previamente al grupo estático asociado a /api/inventory, los servicios de direccionamiento del tráfico deben ser capaces de respetar las directivas transmitidas por el agente y resolver dinámicamente el enrutamiento sin depender de estructuras estáticas.
Este escenario pone de relieve las limitaciones de las estructuras estáticas, como los pools, y la necesidad de una gestión del tráfico programable de forma dinámica y adaptada al contexto.
Los sistemas basados en agentes cuestionan varios supuestos fundamentales de la ingeniería de tráfico:
Convergencia de los planos de control y de datos: Antes, las decisiones de enrutamiento se basaban en reglas estáticas; ahora, proceden de la propia solicitud. Esto invalida la lógica de aplicación tradicional.
Enrutamiento basado en intenciones: Los agentes enrutan el tráfico en función de los objetivos, no solo de los endpoints. Un único endpoint como /api/process podría gestionar cientos de flujos de tareas diferentes, según las directrices de los agentes.
Los grupos estáticos quedan obsoletos: Los grupos tradicionales presuponen roles fijos. Sin embargo, los agentes pueden necesitar acceso a la GPU en un momento dado y optimización de la CPU al siguiente, lo que hace que la pertenencia a un grupo sea demasiado rígida.
Las alternativas y la conmutación por error se vuelven estratégicas: Antes, la conmutación por error consistía en «probar con el siguiente servidor». Ahora, los agentes evalúan el rendimiento en tiempo real y los resultados anteriores, y deciden estratégicamente cómo proceder.
Los patrones de tráfico surgen, no se repiten: Los agentes crean flujos de trabajo bajo demanda. No se pueden predefinir todas las rutas, ya que se forman en función de las necesidades.
Estas disrupciones obligan a los balanceadores de carga, las puertas de enlace y las plataformas de observabilidad a adaptarse a una lógica de tráfico dinámica y en tiempo real.
Replanteamiento de las métricas de estado y rendimiento
Las métricas de estado y rendimiento siempre han sido fundamentales para la gestión del tráfico. Las decisiones de balanceo de carga dependen de saber si un servidor está disponible, con qué rapidez responde y qué nivel de carga soporta. Sin embargo, en los sistemas basados en agentes, el estado no es binario y el rendimiento no puede promediarse entre categorías generales. Las métricas deben reflejar si un destino es adecuado para una tarea específica, no solo si está operativo.
Por qué es importante: Las métricas de estado influyen directamente en el enrutamiento del tráfico, las decisiones de conmutación por error y la optimización del rendimiento. En un entorno nativo de agentes, cada solicitud tiene una intención distinta y puede requerir una ruta o una garantía de respuesta diferente. Los enfoques tradicionales no pueden satisfacer esta necesidad porque:
- Se basan en agregados superficiales (p. ej., el tiempo medio de respuesta) que ocultan la variabilidad específica de cada tarea.
- Evalúan el estado únicamente desde la perspectiva del servidor, sin ofrecer información sobre el éxito o la satisfacción a nivel del agente.
- Presuponen la homogeneidad del tráfico, algo que no se cumple cuando las solicitudes vienen determinadas por decisiones tomadas en tiempo de ejecución.
Ejemplo: Un conjunto de servidores de API puede aparecer como «saludable» según las comprobaciones de estado y, sin embargo, uno de ellos puede ser sistemáticamente incapaz de responder en menos de 100 ms a las consultas X-Task-Profile: inventory-sensitive. Un agente que espere este perfil de latencia lo percibirá como un fallo, aunque la infraestructura considere que todo funciona con normalidad.
Qué se necesita:
- Telemetría en tiempo real para cada solicitud que refleje la intención y los resultados observados.
- Evaluación del estado específica de cada tarea que detecta cuándo un nodo presenta un rendimiento degradado para algunas tareas, aunque funcione correctamente para otras.
- Bucles de retroalimentación que incorporan el éxito o el fracaso notificados por el agente a la lógica de enrutamiento y priorización.
Las herramientas de etiquetado de datos pueden desempeñar aquí un papel fundamental al etiquetar el tráfico en movimiento y registrar el rendimiento y la adecuación al contexto. Esto permite a los sistemas razonar no solo sobre qué ocurrió, sino sobre si se cumplió el objetivo del actor que lo inició.
Capacidades de respaldo, disyuntores y reintentos en arquitecturas de agentes
En las infraestructuras tradicionales, los mecanismos de respaldo, como los reintentos, la redirección a nodos de reserva o la activación de disyuntores, se implementan en la capa de infraestructura. Los balanceadores de carga, los proxies y las puertas de enlace utilizan umbrales predefinidos (por ejemplo, tiempos de espera o tasas de error) para determinar cuándo dejar de dirigir el tráfico a un destino y probar una alternativa.
Las arquitecturas de agentes invierten esa lógica.
Los agentes incorporan sus propias estrategias alternativas. Incluyen políticas de reintento, lógica de escalado y prioridades centradas en los objetivos en la propia solicitud. Esto añade complejidad y puede generar conflictos con los mecanismos de conmutación por error de la infraestructura.
Por qué es importante:
- La infraestructura podría interpretar un fallo como recuperable, mientras que el agente lo considera inaceptable (o viceversa).
- Tanto el agente como la infraestructura pueden intentar recurrir simultáneamente a mecanismos alternativos, lo que puede provocar reintentos redundantes, un aumento de la latencia o bucles de tráfico.
- Los disyuntores diseñados para un tráfico promedio pueden bloquear el acceso a servicios que un agente aún considera óptimos.
Riesgos principales:
- Doble mecanismo de respaldo: Tanto el agente como la infraestructura vuelven a intentarlo, lo que genera una carga innecesaria.
- Condiciones de carrera: El agente recurre a una opción más cara o menos segura, aunque el sistema habría resuelto el problema en cuestión de milisegundos.
- Fallo de la conmutación por error determinista: Las políticas estáticas no pueden adaptarse a los matices de los agentes.
- Corrupción: Los metadatos del agente tienen un formato incorrecto, faltan o no se pueden leer.
Orientaciones para la adaptación:
- La infraestructura debería evolucionar para reconocer las prioridades de reserva especificadas por el agente (p. ej., mediante
X-Fallback-Order,X-Timeout-Preference). - Los disyuntores deben tener en cuenta la intención para admitir una lógica específica por tarea o por agente, en lugar de umbrales globales.
- Considere la posibilidad de introducir una lógica de conmutación por error que tenga en cuenta la negociación, en la que los agentes propongan las estrategias que prefieran y las puertas de enlace decidan en función del estado del sistema, la carga y las políticas.
- Los sistemas de tráfico deben admitir una lógica de ejecución predeterminada cuando falten los metadatos del agente, estén incompletos o no superen la validación del esquema, garantizando una degradación gradual.
- La infraestructura debe detectar y evitar la delegación recursiva o los reintentos conflictivos de los agentes que puedan provocar bucles o aumentar el tráfico durante la degradación del sistema.
Ejemplo: Un agente encargado de realizar una comprobación de fraude en tiempo real solicita una respuesta en un plazo de 50 ms. Su lógica de respaldo prioriza un resultado parcial almacenado en caché frente a una consulta completa más lenta. Si la infraestructura no tiene esto en cuenta, puede seguir dirigiendo la solicitud al backend con todas las funcionalidades, lo que provoca una latencia perceptible para el usuario. Un modelo más cooperativo respetaría la prioridad de respaldo del agente y ofrecería la respuesta degradada más rápida.
A medida que la toma de decisiones asciende en la pila, las estrategias de contingencia deben hacer lo mismo. Los disyuntores y la lógica de reintentos no pueden permanecer estáticos ni ser opacos; deben adaptarse a las preferencias expresadas por el agente, preservando al mismo tiempo la seguridad y la equidad del sistema.
La alta disponibilidad y la conmutación por error siguen siendo importantes
Aunque las arquitecturas de agentes trasladan la toma de decisiones y la coordinación a la capa de solicitudes, la infraestructura subyacente sigue siendo responsable de garantizar la fiabilidad del sistema central. Esto significa que la alta disponibilidad (HA) y los mecanismos de conmutación por error en la capa de infraestructura siguen siendo esenciales. De hecho, cobran aún más importancia a medida que los sistemas adoptan un comportamiento más dinámico y autónomo.
Los agentes pueden dirigir el tráfico en función de los objetivos y el contexto, pero siguen dependiendo de la red para garantizar que los servicios permanezcan accesibles y sean resilientes cuando surjan problemas. Los balanceadores de carga deben detectar nodos inaccesibles, servicios con fallos o entornos degradados y redirigir el tráfico en tiempo real, independientemente de la estrategia de contingencia del agente.
Responsabilidades fundamentales que no cambian:
- Supervisar los miembros del pool y el estado de los servicios de backend
- Detectar particiones de red o fallos de enrutamiento
- Redirigir el tráfico en función del estado operativo, la disponibilidad o la degradación a nivel del sistema
- Mantener la alta disponibilidad de los servicios con estado o las sesiones cuando sea necesario
Los agentes pueden incorporar lógica para determinar «qué debe ocurrir a continuación», pero el balanceador de carga sigue siendo responsable de «la rapidez con la que nos recuperamos cuando un nodo deja de funcionar».
Es fundamental que la lógica de enrutamiento adaptativa y consciente de los agentes no comprometa la estabilidad operativa. Una infraestructura bien instrumentada debe conservar:
- Conmutación por error instantánea y reequilibrado del tráfico cuando los nodos dejan de estar disponibles
- Topologías de alta disponibilidad resilientes que protegen a los agentes y servicios frente a fallos en sistemas ascendentes
- Recuperación rápida y automatizada que complementa la lógica de conmutación por error del agente en lugar de entrar en conflicto con ella
En resumen, las arquitecturas basadas en agentes no eliminan la necesidad de conmutación por error, sino que aumentan lo que está en juego. Ahora, la infraestructura debe responder con mayor rapidez y sensibilidad al contexto, sin convertirse en un cuello de botella para el comportamiento autónomo.
Implicaciones para la gestión del tráfico empresarial
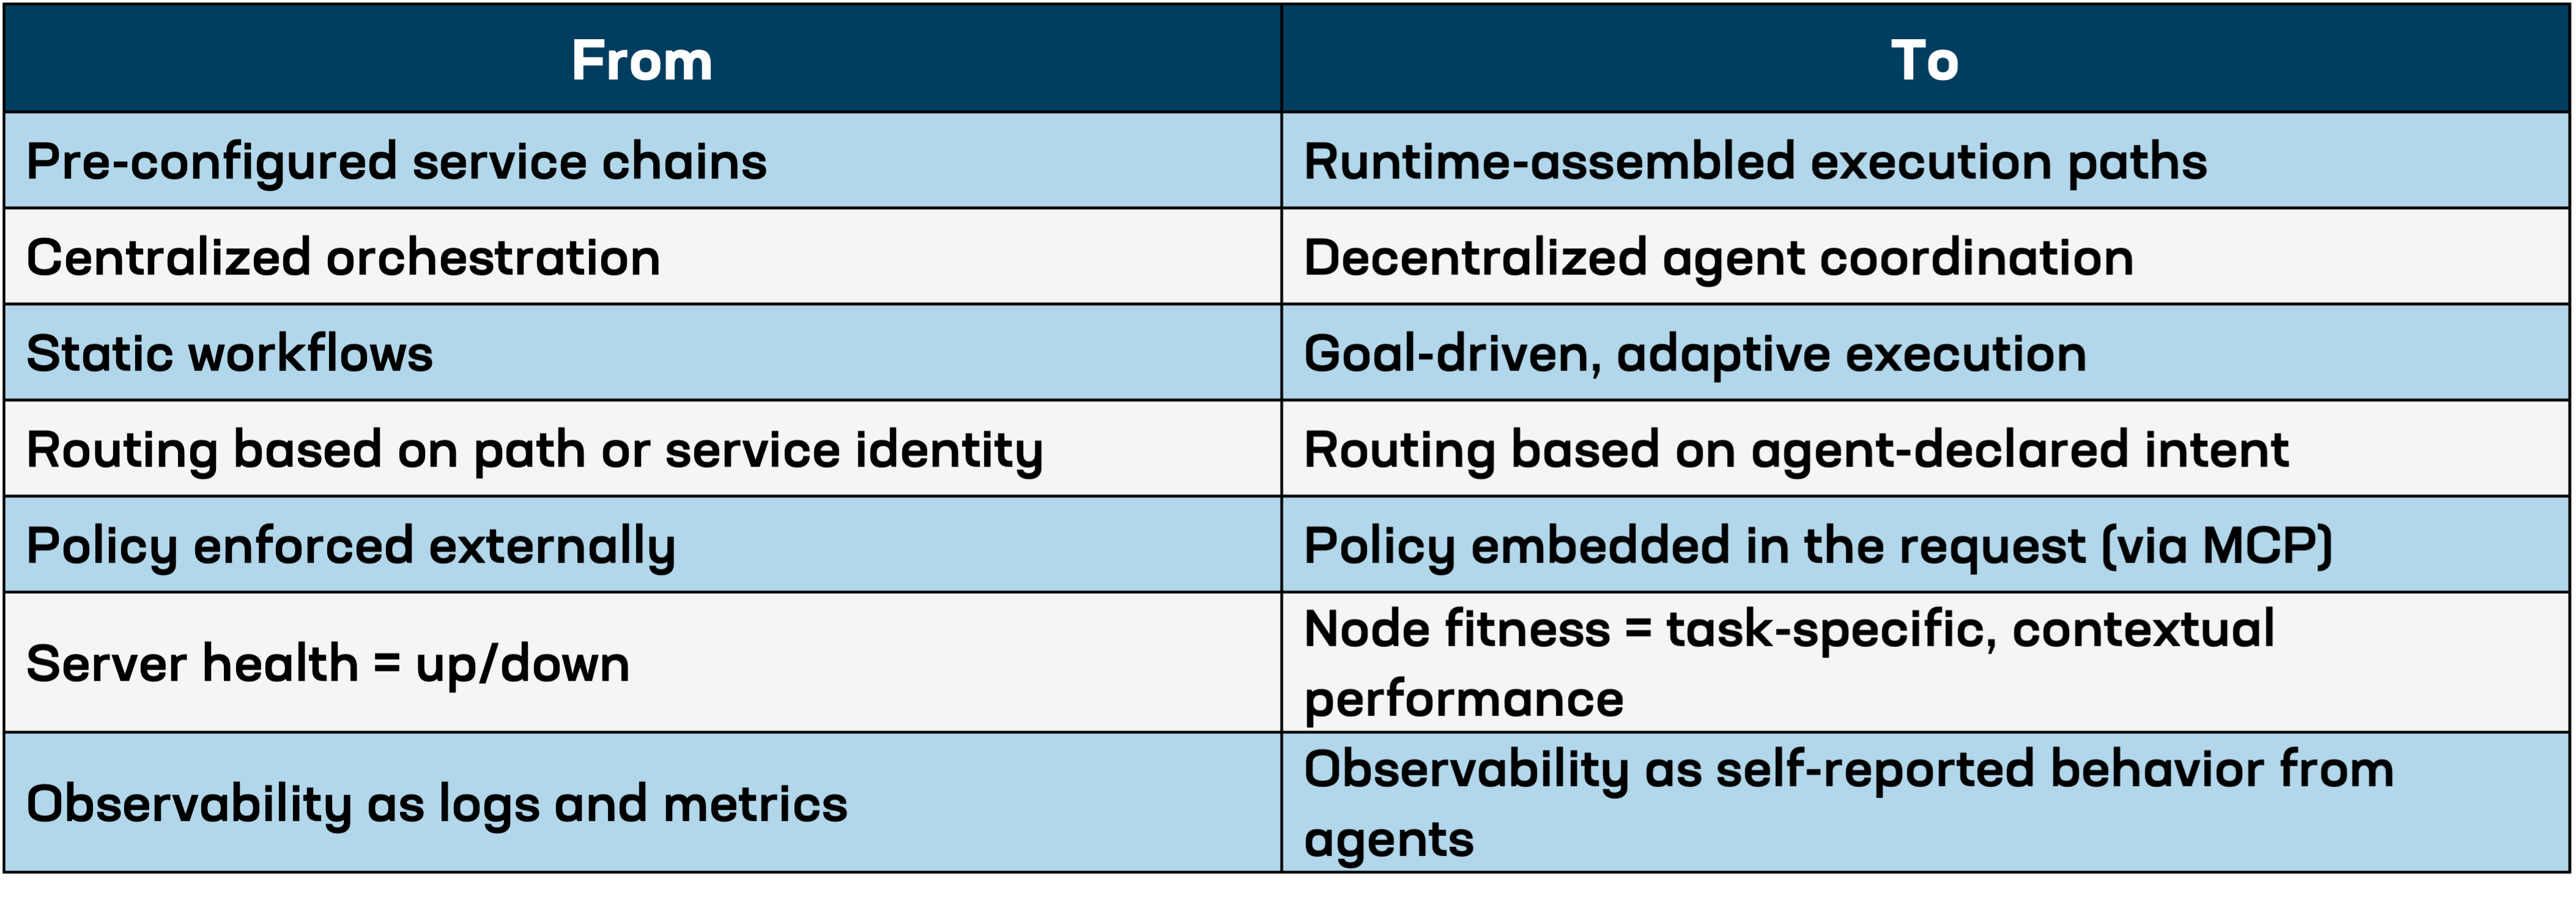
La transición a arquitecturas basadas en agentes supone un cambio fundamental en el funcionamiento de los sistemas de gestión del tráfico, como los balanceadores de carga y las puertas de enlace. Mientras que los sistemas de tráfico tradicionales tomaban decisiones basándose en políticas preconfiguradas —a menudo externas a la solicitud—, los sistemas controlados por agentes incorporan esas políticas en la propia solicitud. Esta es la base de lo que permite el Protocolo de Contexto de Modelo (MCP): la ejecución de políticas integradas para cada solicitud.
Llamaremos a este modelo «política en la carga útil». En lugar de que los sistemas centralizados analicen todos los casos excepcionales, el agente incorpora en cada solicitud las decisiones de política pertinentes (como la estrategia de respaldo, la preferencia de nodo, la tolerancia a errores o los requisitos de privacidad). A continuación, la infraestructura debe leer, interpretar y aplicar esas instrucciones de política en tiempo real.
Este nuevo modelo de ejecución transforma el papel de los componentes de gestión del tráfico:
- De responsables de la toma de decisiones a ejecutores: La infraestructura ya no determina adónde se dirige el tráfico, sino que aplica la decisión transmitida por el agente.Ejemplo: Un balanceador de carga que lea
X-Route-Preference: gpu-optimizeddebe reenviar el tráfico en consecuencia, aunque ese nodo no formara parte del grupo original. - Programable en tiempo de ejecución: las iRules y las políticas deben evaluar encabezados como
X-Intent,X-ContextoX-Goal. Esto sustituye la lógica basada en rutas preconfiguradas por una interpretación dinámica y en línea. - Enrutamiento basado en el contexto: Los ADC y otros servicios similares deben enrutar el tráfico en función de la identidad, la intención y el contexto, no solo del host o la ruta.
- Observabilidad semántica: Los registros no solo deben mostrar qué ocurrió, sino también por qué: «El agente redirigió el tráfico porque se superó el umbral de latencia» resulta más útil que simplemente «tráfico redirigido al grupo B».
Las tecnologías de etiquetado de datos y otras herramientas similares pueden facilitar esta transición al etiquetar y clasificar el contexto de las solicitudes en tiempo real, haciendo viables el enrutamiento semántico y la observabilidad.
Preparación de la infraestructura empresarial para arquitecturas de agentes
Los agentes de IA no funcionarán de forma aislada. Interactuarán con sistemas heredados, utilizarán API tradicionales, manipularán la lógica de negocio de bases de datos empresariales e invocarán funciones alojadas tanto en backends monolíticos como en microservicios. Para las empresas, esto significa que no pueden empezar de cero, sino que deben evolucionar.
La realidad: los agentes se comunicarán con todo
Las arquitecturas tecnológicas empresariales combinan:
- API SOAP con décadas de antigüedad que aún se utilizan en finanzas
- Servicios RESTful que sustentan aplicaciones web
- Colas de mensajes para sistemas de inventario asíncronos
- Microservicios nativos de la nube
- API de SaaS con límites de solicitudes y autenticación compleja
- LLM y agentes con ajuste fino
Los agentes deben aprender a desenvolverse en todo ese entorno. Y su infraestructura debe aprender a mediar en esa interacción en tiempo real, aplicando políticas que tengan en cuenta el contexto.
Qué deben preparar los equipos empresariales
1. Expón los sistemas internos mediante interfaces orientadas a la intención
Los agentes no quieren cinco endpoints, sino un único objetivo. Expón la funcionalidad de negocio (por ejemplo, «consultar el estado del pedido») mediante capas de abstracción o composiciones de API que los agentes puedan utilizar a través de un único punto de entrada semántico.
Paso de preparación: Utiliza puertas de enlace de API o mallas de servicios para consolidar los endpoints orientados a tareas con contratos claros de entrada y salida.
2. Instrumenta para obtener contexto, no solo métricas
El registro tradicional se centra en el método, la ruta y el tiempo de respuesta. Sin embargo, a los agentes les importa:
- Cuál era la tarea
- Qué alternativa se intentó
- Si se alcanzó el objetivo
Paso previo: Adopta herramientas de observabilidad semántica que etiqueten el tráfico con etiquetas como X-Intent, X-Task-Type y X-Agent-Outcome.
3. Permita la evaluación en tiempo de ejecución de las políticas integradas
Los agentes incluyen en la solicitud instrucciones alternativas, preferencias de tiempo de espera y requisitos de seguridad. La infraestructura existente descarta estos datos.
Paso previo: Amplíe las políticas de tráfico para analizar los metadatos de los agentes y actuar en función de ellos (p. ej., X-Route-Preference, X-Fallback-Order, X-Data-Class). Empiece con iRules o una solución similar de scripting en tiempo de ejecución.
4. Replantee el control de acceso y la gobernanza
Los agentes son autónomos. Necesitas saber:
- Qué agente actúa en nombre de quién
- A qué herramientas puede acceder
- A qué ámbitos de datos puede acceder
Paso previo: Integra controles de acceso basados en la identidad y controles de políticas basados en atributos (ABAC), en lugar de limitarte a listas blancas de IP o a un RBAC estático.
5. Desacoplar la lógica de respaldo y reintento
La infraestructura y los agentes no pueden competir entre sí para recuperarse. Deja que uno se encargue de los objetivos de ejecución y que el otro aplique las salvaguardas del sistema.
Paso previo: Separe claramente el ámbito de recuperación de los agentes (lo que controlan) de la conmutación por error de la infraestructura (lo que gestiona usted). Defina las reglas de negociación y las condiciones de anulación.
Conclusión
A medida que la IA evoluciona de modelos aislados a agentes autónomos, las empresas se enfrentan a un punto de inflexión estratégico. Estos agentes no operarán en entornos creados desde cero: se integrarán con las aplicaciones existentes, utilizarán API heredadas e impulsarán la toma de decisiones en sistemas empresariales críticos. Esto significa que las empresas deben prepararse desde ahora para darles soporte, no solo con nuevas herramientas, sino replanteándose cómo gestiona su arquitectura la intención, la ejecución y la gobernanza.
No estamos ante un momento de sustituirlo todo de golpe, sino ante un momento de convergencia, en el que los sistemas tradicionales y los nuevos comportamientos de los agentes deben interoperar con precisión y de forma deliberada.
Las arquitecturas de agentes están en camino. Las empresas que se preparen desde ahora no solo seguirán el ritmo, sino que liderarán.
LORI MACVITTIE
PUBLICADO EL 1 DE JULIO DE 2025