
La evolución de los controladores de entrega de aplicaciones
Introducción
En el dinámico mundo actual, las organizaciones se enfrentan constantemente al reto de ofrecer aplicaciones críticas a millones de usuarios de todo el mundo. Es sumamente importante que implementen servicios de red y de aplicaciones para que estas sean escalables, seguras y estén disponibles. Esta es una de las principales razones que han impulsado la evolución de los controladores de entrega de aplicaciones (ADC). Sin embargo, ninguna de estas funciones puede implementarse sin una base sólida en la tecnología básica de balanceo de carga. Por tanto, empecemos por comprender la importancia del balanceo de carga, cómo contribuye a una entrega eficiente de aplicaciones y cómo los ADC siguen evolucionando y adaptándose a un mundo donde la nube es la prioridad.
Factores que impulsan la demanda de balanceo de carga
El objetivo principal del balanceo de carga es distribuir el tráfico entrante de la red o de las aplicaciones entre varios servidores físicos y hacer que, de cara al exterior, estos parezcan un único servidor. Hay muchas razones para hacerlo, pero los principales factores son la necesidad de «escalabilidad», «alta disponibilidad» y «previsibilidad».
La escalabilidad es la capacidad de adaptarse de forma dinámica o sencilla a un aumento de la carga sin afectar al rendimiento existente. Por otro lado, la alta disponibilidad (HA) es la capacidad de un sitio para seguir estando disponible y accesible incluso cuando se produce un fallo en uno o varios sistemas. La virtualización de servicios (la imitación del comportamiento de componentes de software para agilizar y probar el desarrollo de aplicaciones) ofrece una oportunidad interesante tanto para la escalabilidad como para la disponibilidad. Si el servicio o punto de contacto con el usuario se separa de los servidores reales, la aplicación puede escalarse añadiendo más servidores. Además, el fallo de un servidor concreto no hará que toda la aplicación deje de estar disponible. La predictibilidad es un concepto algo menos claro, ya que engloba aspectos de la alta disponibilidad y algunas lecciones aprendidas durante el proceso. La mejor forma de describirla es como la capacidad de controlar cómo y cuándo se prestan los servicios en términos de disponibilidad y rendimiento.
Balanceo de carga: una perspectiva histórica
En los primeros tiempos de la Internet comercial, muchos aspirantes a millonarios de las puntocom descubrieron un grave problema en sus planes. Los ordenadores centrales no disponían de software de servidor web (al menos hasta la llegada del AS/400e) y, aunque lo hubieran tenido, sus presupuestos iniciales no les permitían adquirirlos. Lo que sí podían permitirse era hardware de servidor estándar disponible en el mercado, fabricado por alguno de los omnipresentes fabricantes de PC. El principal problema de la mayoría de estos equipos era que un único servidor basado en PC jamás podría gestionar el volumen de tráfico que generarían sus negocios. Y, si dejaba de funcionar, se quedaban sin conexión y sin negocio. Por suerte, algunas personas planeaban hacerse millonarias resolviendo precisamente ese problema. Así nació el balanceo de carga.
En el principio, existía el DNS
Antes de que existieran dispositivos de balanceo de carga específicos disponibles comercialmente, se realizaron numerosos intentos de aprovechar la tecnología existente para alcanzar los objetivos de escalabilidad y disponibilidad. La tecnología más extendida (y que aún se utiliza) era el DNS round-robin.
Con este método, el DNS asignaba varias direcciones IP únicas a distintos servidores bajo el mismo nombre DNS. Esto significaba que, la primera vez que un usuario solicitaba la resolución de «www.example.com», el servidor DNS dirigía cada nueva conexión al siguiente servidor de la lista hasta llegar al último, tras lo cual volvía de nuevo al primero. Esta solución era sencilla y permitía distribuir uniformemente las conexiones entre un conjunto de máquinas.
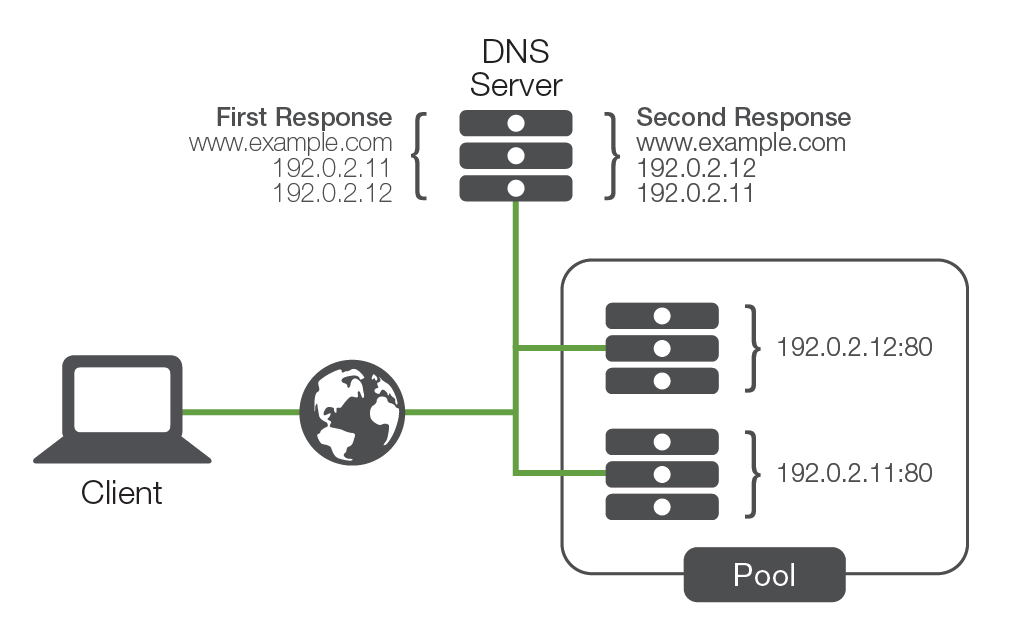
Desde el punto de vista de la escalabilidad, esta solución funcionaba extraordinariamente bien, ya que permitía añadir una cantidad prácticamente ilimitada de servidores a un nombre DNS. Sin embargo, en cuanto a la disponibilidad, la solución planteaba un obstáculo, pues el DNS no podía saber si los servidores incluidos en la lista estaban operativos o no. Si un servidor dejaba de estar disponible y un usuario intentaba acceder a él, la solicitud podía enviarse a un servidor que estuviera caído.
Otro factor que impulsó el uso del DNS round-robin fue la previsibilidad, es decir, un alto grado de confianza en que un usuario sería dirigido a un servidor concreto. Esto gira en torno a la idea de persistencia: el concepto de garantizar que, una vez iniciada una sesión o cuando el usuario reanuda una sesión suspendida anteriormente, el balanceo de carga no lo redirija a un nuevo servidor. Se trata de una cuestión muy importante que el DNS round-robin no podía resolver.
Balanceo de carga propietario mediante software
Para abordar este problema, una de las primeras soluciones diseñadas específicamente para ello consistió en integrar el balanceo de carga directamente en el software de la aplicación o en el sistema operativo (SO) del servidor de aplicaciones. Aunque existían tantas implementaciones diferentes como empresas que las desarrollaban, la mayoría de las soluciones se basaban en sencillos trucos de red. Por ejemplo, una de estas soluciones asignaba a todos los servidores de un grupo (también conocido como clúster) una dirección IP adicional, además de su propia dirección IP física.
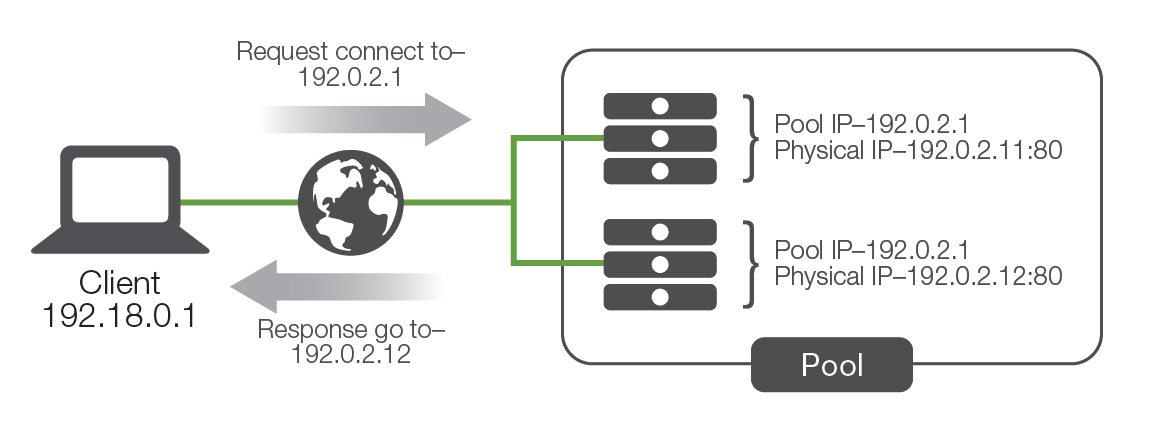
Cuando los usuarios intentaban conectarse al servicio, se conectaban a la IP del grupo en lugar de a la IP física del servidor. El primer servidor del grupo que respondía a la solicitud de conexión redirigía al usuario a una dirección IP física (la suya propia o la de otro sistema del grupo) y se iniciaba la sesión del servicio. Una de las principales ventajas de esta solución era que los desarrolladores de aplicaciones podían utilizar distintos tipos de información para determinar a qué dirección IP física debía conectarse el cliente. Por ejemplo, podían hacer que cada servidor del grupo llevara un recuento de cuántas sesiones estaba atendiendo cada miembro del grupo y, a continuación, dirigir las nuevas solicitudes al servidor con menor carga.
Al principio, la escalabilidad de esta solución era evidente. Bastaba con configurar un nuevo servidor y añadirlo al grupo para aumentar la capacidad de la aplicación. Sin embargo, con el tiempo, la escalabilidad del equilibrio de carga basado en aplicaciones empezó a ponerse en duda. Como los miembros del grupo debían mantenerse en contacto constante entre sí para decidir a cuál de ellos se dirigiría la siguiente conexión, el tráfico de red entre dichos miembros aumentaba exponencialmente con cada nuevo servidor que se añadía al grupo. Cuando el grupo alcanzaba cierto tamaño (normalmente entre 5 y 10 hosts), este tráfico empezaba a afectar tanto al tráfico de los usuarios finales como al uso del procesador de los propios servidores. Por tanto, la escalabilidad era excelente siempre que no fuera necesario superar un número reducido de servidores (por cierto, inferior al admitido por el sistema de turno rotatorio de DNS).
La alta disponibilidad (HA) mejoró drásticamente con el DNS de turno rotatorio (round-robin) y el balanceo de carga por software. Dado que los miembros del grupo se comunicaban constantemente entre sí y que los desarrolladores podían aprovechar su amplio conocimiento de la aplicación para determinar si un servidor funcionaba correctamente, estas soluciones prácticamente eliminaban la posibilidad de que los usuarios llegaran a un servidor incapaz de atender sus solicitudes. Sin embargo, cabe señalar que cada nueva incorporación de funciones inteligentes de alta disponibilidad repercutía en el uso de los servidores y de la red, lo que limitaba aún más la escalabilidad. El otro efecto negativo sobre la alta disponibilidad se daba en el ámbito de la fiabilidad. Muchos de los mecanismos de red utilizados para distribuir el tráfico en estos sistemas eran complejos y requerían una supervisión exhaustiva a nivel de red. Por consiguiente, estos métodos de distribución solían presentar problemas que afectaban a toda la aplicación y a todo el tráfico de la red de la aplicación.
Estas soluciones también mejoraron la previsibilidad. Dado que los diseñadores de la aplicación sabían cuándo y por qué era necesario redirigir a los usuarios al mismo servidor en lugar de distribuirlos mediante balanceo de carga, podían incorporar una lógica que ayudara a garantizar que los usuarios mantuvieran la persistencia cuando fuera necesario. También utilizaron la misma tecnología de «agrupación» para replicar la información de estado de los usuarios entre servidores, eliminando muchos de los casos que, de otro modo, habrían requerido persistencia. Por último, gracias a su profundo conocimiento de la aplicación, pudieron desarrollar mejores algoritmos de balanceo de carga basados en el estado real de la aplicación, en lugar de utilizar parámetros como las conexiones, que no siempre reflejaban adecuadamente la carga del servidor.
Además de las posibles limitaciones en cuanto a la escalabilidad real y los problemas de fiabilidad, el balanceo de carga propietario basado en aplicaciones presentaba otro inconveniente: su desarrollo y mantenimiento dependían del proveedor de la aplicación. El principal problema era que no todas las aplicaciones ofrecían tecnología de balanceo de carga (o agrupación de recursos) y, cuando lo hacían, a menudo no era compatible con la proporcionada por otros proveedores de aplicaciones. Aunque varias organizaciones desarrollaban software de balanceo de carga independiente del proveedor y a nivel del sistema operativo, este sufría, por desgracia, los mismos problemas de escalabilidad. Además, al no estar estrechamente integrado con las aplicaciones, estas «soluciones» de software también planteaban dificultades adicionales en materia de alta disponibilidad.
Hardware de balanceo de carga basado en red
La segunda generación de soluciones de balanceo de carga diseñadas específicamente para este fin surgió en forma de dispositivos basados en red. Estos son los verdaderos precursores de los actuales controladores de entrega de aplicaciones. Estos dispositivos se encontraban físicamente fuera de las propias aplicaciones y, aunque comenzaron como balanceadores de carga, realizaban el balanceo mediante técnicas de red mucho más sencillas, como NAT. Presentaban al exterior una dirección de servidor virtual y, cuando los usuarios intentaban conectarse, reenviaban la conexión al servidor real más adecuado.
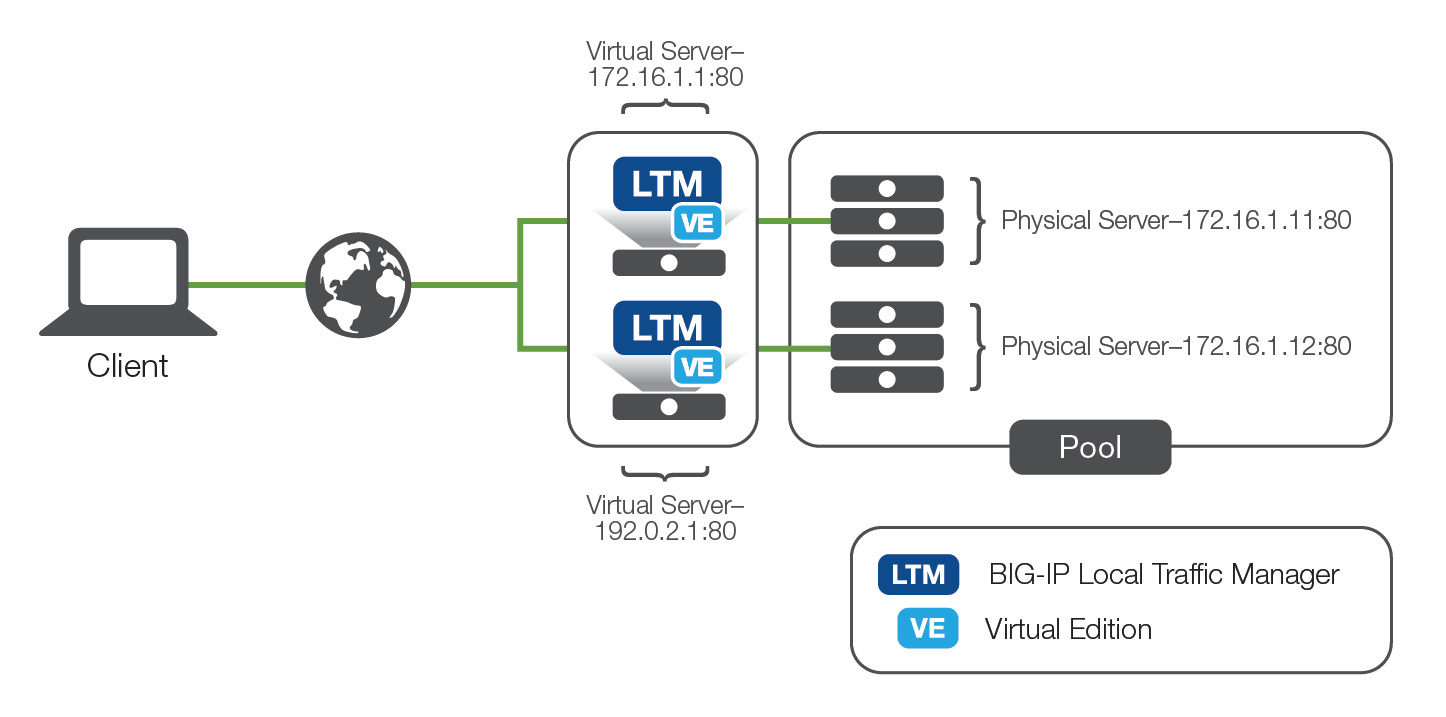
El balanceador de carga podía controlar exactamente qué servidor recibía cada conexión y utilizaba «monitores de estado» cada vez más complejos para garantizar que el servidor de aplicaciones (un servidor físico real) respondiera según lo previsto. Si el servidor no respondía correctamente, el balanceador de carga dejaba de enviarle tráfico automáticamente hasta que ofreciera la respuesta deseada. Aunque los monitores de estado rara vez eran tan exhaustivos como los creados por los propios desarrolladores de la aplicación, el enfoque basado en hardware de red podía proporcionar servicios básicos de balanceo de carga a casi cualquier aplicación de manera uniforme y coherente, creando por fin un punto de entrada al servicio verdaderamente virtualizado y exclusivo para los servidores de aplicaciones.
Desde el punto de vista de la escalabilidad, las organizaciones que empezaron a sustituir el balanceo de carga basado en software por una solución basada en hardware observaron una drástica reducción del uso de sus servidores. Esto evitó que tuvieran que adquirir servidores adicionales a corto plazo y contribuyó a aumentar el retorno de la inversión a largo plazo.
Del mismo modo, la alta disponibilidad (HA) ayudó a reducir la complejidad de la solución y a proporcionar un equilibrio de carga independiente de las aplicaciones, lo que se tradujo en una mayor fiabilidad y una solución más completa. El hardware de equilibrio de carga basado en red permitió al propietario de la empresa ofrecer un alto nivel de disponibilidad para todas sus aplicaciones, en lugar de limitarlo a las pocas que incorporaban equilibrio de carga.
La previsibilidad fue un componente fundamental que aportó el hardware de balanceo de carga basado en red. Ahora era mucho más fácil predecir adónde se dirigiría una nueva conexión y manipular su destino. Estos dispositivos dotaron de inteligencia al proceso, lo que a su vez ayudó a crear una distribución controlada de la carga (frente a la distribución no controlada del DNS dinámico). Esto permitió a los propietarios de las empresas distribuir la carga entre los servidores en función de la capacidad de cada servidor para gestionarla.
La llegada del equilibrador de carga basado en red y de la virtualización aportó nuevas ventajas en materia de seguridad y gestión, como ocultar la identidad de los servidores de aplicaciones a la comunidad de Internet y permitir el «drenaje» de las conexiones de un servidor para poder desconectarlo y realizar tareas de mantenimiento sin afectar a los usuarios. Esta es la base sobre la que surgieron los ADC.
Controladores de entrega de aplicaciones
Con una función central de equilibrio de carga, que también actúa como proxy completo, el departamento de TI vio una excelente oportunidad para incorporar y consolidar servicios nuevos y emergentes. Esto hizo que el dispositivo de equilibrio de carga evolucionara hasta convertirse en una plataforma ADC extensible. En pocas palabras, el proxy es la base del equilibrio de carga y la tecnología subyacente que hace posibles los ADC.
Al hablar de la seguridad de los ADC, la virtualización creada por el proxy (la tecnología base) es fundamental. Ya se trate de la descarga del cifrado SSL/TLS, la autenticación centralizada o incluso los cortafuegos con conocimiento de las aplicaciones, la eficacia de estas soluciones radica en que un equilibrador de carga (en su versión de hardware o virtual) constituye el punto común de virtualización para todas las aplicaciones. La autenticación centralizada es un ejemplo clásico. Tradicionalmente, los mecanismos de autenticación y autorización siempre se han integrado directamente en la propia aplicación. Al igual que ocurre con el equilibrio de carga basado en aplicaciones, cada implementación dependía de la aplicación y era específica de ella, lo que daba lugar a numerosos métodos diferentes. En cambio, al aplicar la autenticación en el punto de entrada virtualizado de todas las aplicaciones, se puede utilizar un método de autenticación único y uniforme. Esto no solo simplifica drásticamente el diseño y la gestión del sistema de autenticación, sino que también mejora el rendimiento de los propios servidores de aplicaciones al eliminar la necesidad de que realicen esa función. Además, evita tener que dedicar tiempo y dinero —especialmente en aplicaciones desarrolladas internamente— a crear procesos de autenticación para cada aplicación por separado.
La disponibilidad es el atributo de los ADC que más fácilmente puede vincularse con el balanceador de carga original, ya que está relacionada con todos sus atributos básicos: escalabilidad, alta disponibilidad y previsibilidad. Sin embargo, los ADC van aún más allá que los balanceadores de carga. En los ADC, la disponibilidad también abarca conceptos avanzados como las dependencias entre aplicaciones y el aprovisionamiento dinámico. Los ADC son capaces de comprender que, hoy en día, las aplicaciones rara vez funcionan de forma autónoma, pues suelen depender de otras aplicaciones para cumplir su cometido. Este conocimiento aumenta la capacidad del ADC para garantizar la disponibilidad de las aplicaciones al tener en cuenta también estos otros procesos. Los ADC más inteligentes del mercado también ofrecen interfaces programáticas que les permiten modificar dinámicamente la forma en que prestan sus servicios en función de información externa. Estas interfaces permiten el aprovisionamiento dinámico y el escalado vertical automático necesarios en entornos modernos, como la nube y los despliegues en contenedores.
La mejora del rendimiento fue otra evolución lógica del concepto de equilibrio de carga. Los balanceadores de carga mejoraban de forma inherente el rendimiento de las aplicaciones al garantizar que las conexiones no solo se dirigieran a servicios disponibles (y que respondieran en un plazo aceptable), sino también a aquellos con el menor número de conexiones o el menor uso del procesador. De este modo, cada nueva conexión era atendida por el sistema con mayor capacidad para gestionarla. Más adelante, cuando la descarga de SSL/TLS (mediante hardware dedicado) se convirtió en una prestación habitual de las soluciones de equilibrio de carga, se redujo tanto la sobrecarga computacional del tráfico cifrado como la carga de los servidores de back-end, lo que también mejoró su rendimiento.
Los ADC actuales van aún más allá. Estos dispositivos suelen incluir tecnologías de almacenamiento en caché, compresión e incluso control de velocidad para mejorar aún más el rendimiento general y la entrega de las aplicaciones. Además, en lugar de ser implementaciones estáticas de dispositivos independientes tradicionales que proporcionan estos servicios, un ADC puede utilizar su inteligencia de aplicaciones integrada para aplicarlos únicamente cuando aporten una mejora del rendimiento, optimizando así su uso.
Por ejemplo, la tecnología de compresión —pese a la creencia generalizada— no resulta necesariamente beneficiosa para todos los usuarios de la aplicación. Sin duda, los usuarios con poco ancho de banda pueden beneficiarse enormemente de paquetes más pequeños, ya que el cuello de botella es el rendimiento efectivo. Incluso las conexiones que deben recorrer largas distancias pueden beneficiarse, pues unos paquetes más pequeños implican menos viajes de ida y vuelta para transportar los datos, lo que reduce el impacto de la latencia de red. Sin embargo, las conexiones de corta distancia (por ejemplo, dentro del mismo continente) con un gran ancho de banda podrían ofrecer un peor rendimiento al aplicar la compresión. Dado que el rendimiento efectivo no es necesariamente el cuello de botella, la sobrecarga adicional de la compresión y la descompresión añade una latencia que el aumento del rendimiento no llega a compensar. En otras palabras, si no se gestiona correctamente, la tecnología de compresión como solución puede ser peor que el problema original. Sin embargo, al aplicar la compresión de forma inteligente solo cuando vaya a mejorar el rendimiento general, un ADC optimiza el uso y el coste de esta tecnología, dejando más ciclos de procesador disponibles para las funciones que mejor puedan aprovecharlos.
Hacia dónde se dirige el mundo
Dado que la transformación digital es un imperativo estratégico de gran importancia, muchas empresas han comenzado su transición a la nube. Ante el creciente número de aplicaciones que están surgiendo y transformando el mundo que nos rodea, se considera que las organizaciones que migren a la nube disfrutarán de numerosas ventajas, como una mayor agilidad, unos costes operativos mejor ajustados, escalabilidad bajo demanda y una mayor dedicación a su actividad principal.
La «nube» no es una única entidad amorfa de recursos compartidos de computación, almacenamiento y redes, sino que está formada por una compleja combinación de proveedores, infraestructuras, tecnologías y entornos que suelen desplegarse en múltiples nodos distribuidos por todo el mundo. Por este motivo, muchas empresas han desplegado aplicaciones en varias nubes diferentes: públicas, privadas e incluso combinaciones de todas ellas. Esta es la multinube: la nueva realidad.
Incluso en este panorama en rápida evolución, hay varios factores que están ralentizando la adopción de la nube. El primer reto es la proliferación de entornos multinube, en los que las aplicaciones existentes se han migrado mediante un enfoque de «lift and shift» y las aplicaciones «nativas de la nube» se han implementado de forma no planificada ni gestionada. Además, para satisfacer sus necesidades a corto plazo, las organizaciones tienden a utilizar plataformas en la nube dispares, arquitecturas diferentes, servicios de aplicaciones diversos y múltiples conjuntos de herramientas. Esto genera una gran complejidad arquitectónica en toda la empresa y hace que trasladar aplicaciones de un entorno a otro sea mucho más difícil, por no hablar de costoso.
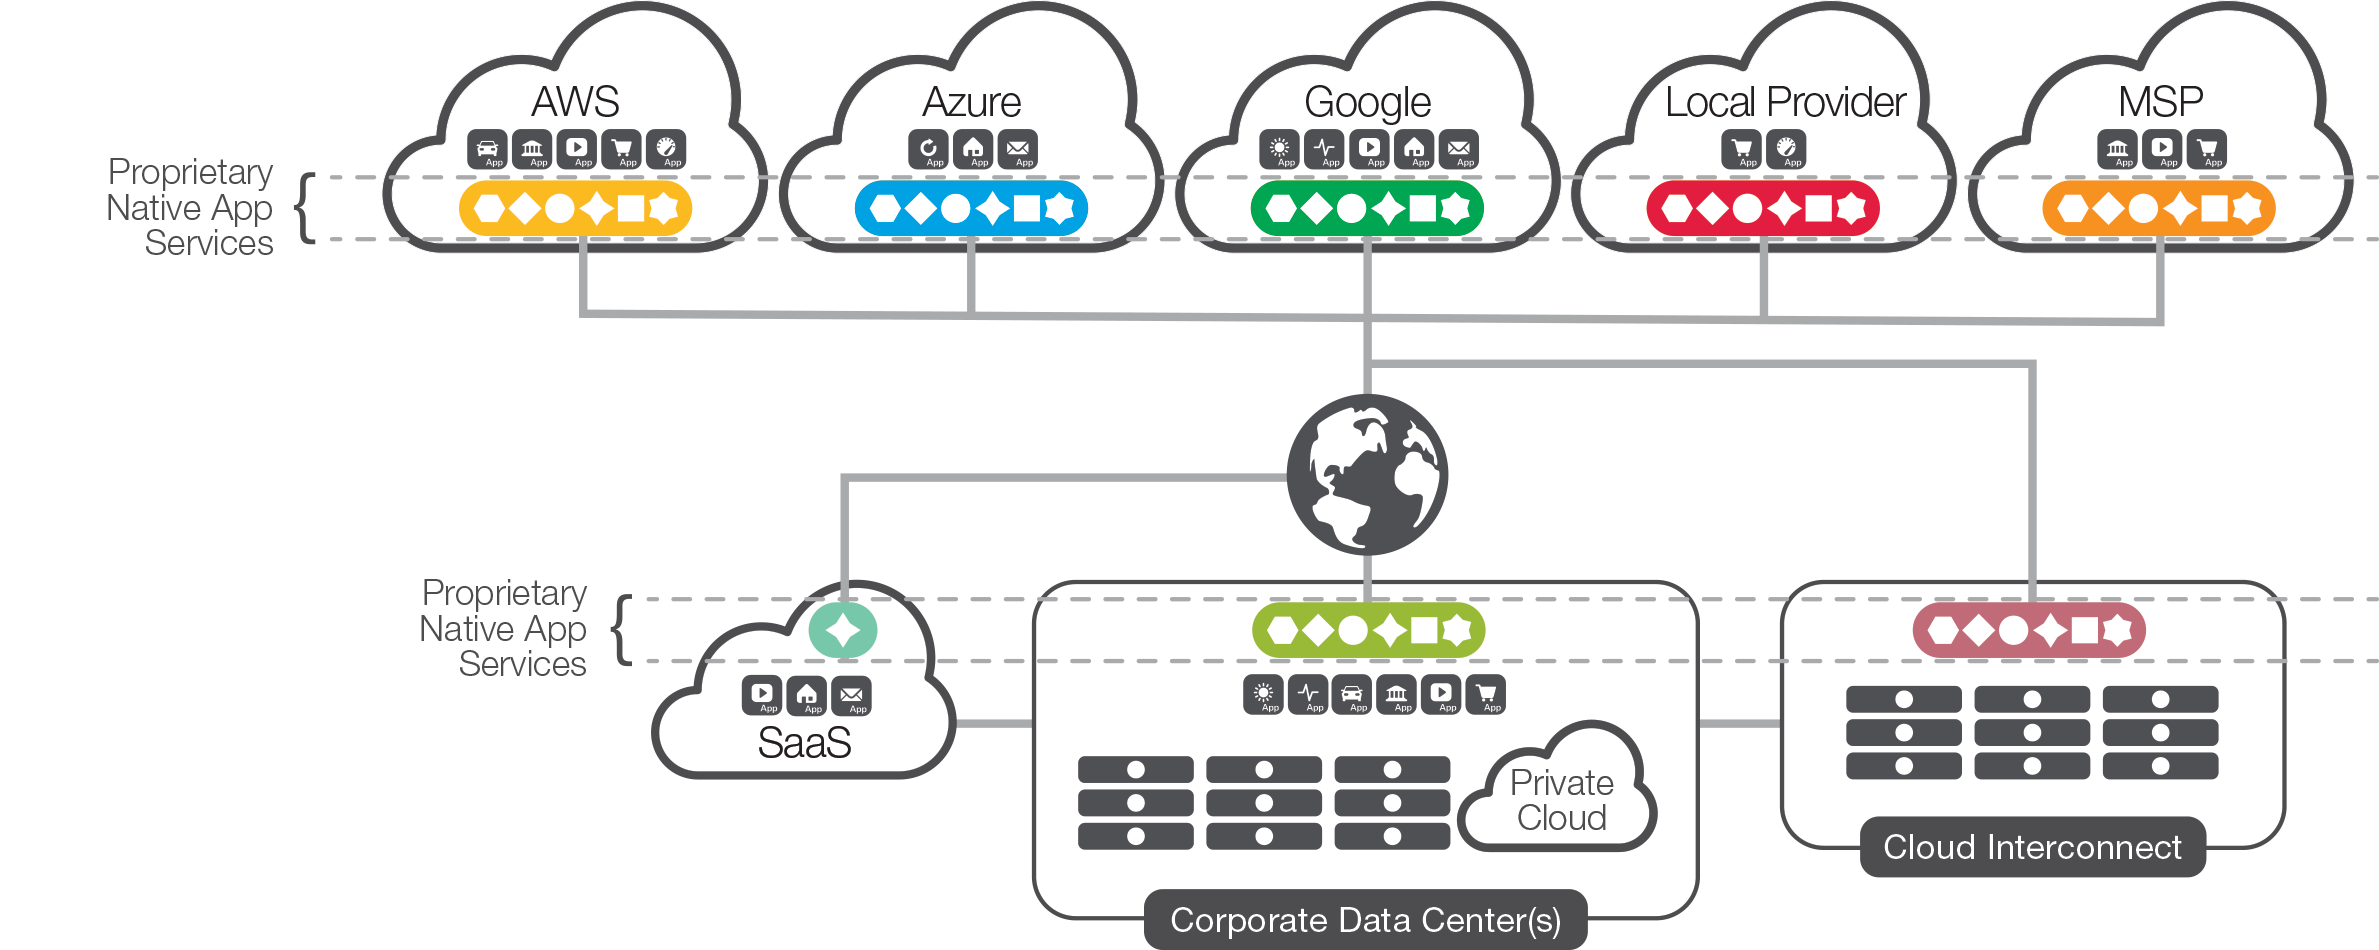
A pesar de estos retos, las nuevas implementaciones en nubes públicas y privadas, así como entre ellas, aumentarán inevitablemente en los próximos años. La multinube se acerca rápidamente y ha llegado el momento de que las empresas implementen servicios de aplicaciones inteligentes y ADC que no se limiten a admitir un número reducido de aplicaciones ni a funcionar únicamente en hardware y en una sola nube.
Resumen
Los ADC son la evolución natural de la posición crítica en la red que ocupaban los balanceadores de carga del pasado. Aunque los ADC deben mucho a aquellos dispositivos ya obsoletos, constituyen una categoría claramente nueva que no solo ofrece disponibilidad, sino también rendimiento y seguridad. Como su nombre indica, se ocupan de todos los aspectos necesarios para entregar una aplicación de la mejor manera posible.
Gracias a funciones avanzadas como la inteligencia de aplicaciones, la descarga de SSL y las interfaces programáticas, los ADC modernos pueden ayudar a las organizaciones a ampliar su negocio y llegar a los usuarios en cualquier lugar y momento. Ante las necesidades en constante evolución del mundo tecnológico, los ADC también tienen una mayor capacidad para adaptarse a las tecnologías más recientes en entornos multinube y de contenedores.
En definitiva, podemos afirmar con seguridad que los ADC no solo serán el principal canal y punto de integración a través del cual las aplicaciones se entregarán de forma más rápida, inteligente y segura, sino que seguirán evolucionando y adaptándose a un mundo centrado en la nube.
PUBLICADO EL 10 DE SEPTIEMBRE DE 2017