Seguridad de confianza cero: por qué es importante (y no solo para el acceso)
Resumen
Uno de los temas centrales en el acceso a redes y aplicaciones en los últimos años ha sido el concepto de «confianza cero». En este documento, mostramos cómo, en esencia, la confianza cero puede definirse mediante un pequeño conjunto de principios sencillos que pueden aplicarse no solo al acceso, sino también, de forma más amplia, a todo el ámbito de la ciberseguridad.
Este documento presenta un marco que engloba los conceptos generales de la confianza cero y los relaciona con el contexto empresarial actual que guía a los responsables de la seguridad de las aplicaciones. Por último, describe el conjunto de principios de la confianza cero, que impulsa las herramientas y las implementaciones de seguridad destinadas a hacer frente a las amenazas actuales y emergentes, y que será el tema central de un próximo documento.
Este documento tiene un doble objetivo: en primer lugar, transmitir la mentalidad de seguridad que deberían adoptar los responsables de negocio de aplicaciones y, en segundo lugar, presentar un marco de referencia para los profesionales de la seguridad que desarrollaremos en futuros documentos técnicos.
ZTS: Empiece por los principios, no por las tecnologías
El término «confianza cero» se asocia con distintos conceptos en diversos niveles de abstracción: a veces se entiende como una arquitectura de solución específica; otras, como una recomendación de aplicar determinadas tecnologías; y, en otras ocasiones, puede referirse a una característica de un producto. Creemos que la seguridad de confianza cero es, en esencia, una mentalidad —un sistema de creencias— de la que surgen técnicas y tácticas que aprovechan tecnologías específicas y que pueden aplicarse para hacer frente a un amplio abanico de amenazas de seguridad.
El sistema de creencias en el que se basa la seguridad de confianza cero (ZTS) puede considerarse el siguiente paso en la evolución de una mentalidad de seguridad que comenzó hace años con la «defensa en profundidad». La defensa en profundidad parte de la idea de que, si bien cualquier barrera defensiva individual tiene una probabilidad pequeña, pero real, de ser vulnerada, añadir más capas de protección para los activos clave reduce esa probabilidad, ralentiza a los atacantes y les obliga a emplear más recursos para llevar a cabo un ataque con éxito.
La confianza cero representa una evolución de esta mentalidad en tres dimensiones:
- En primer lugar, transforma el planteamiento de la protección, que pasa de ser un conjunto de simples «filtros» que controlan el acceso a la aplicación a un conjunto de medidas de protección más adecuadas a los activos, aplicadas según el contexto a cualquier transacción del sistema. El enfoque de cada transacción consiste en comprender: quién intenta realizar qué acción sobre quién. Tanto «quién» realiza la acción como «quién» la recibe pueden ser cualquier componente que forme parte del sistema o lo utilice, ya sea una persona, un elemento automatizado o un fragmento de código. El concepto de identidad es clave para determinar quién realiza la acción y quién la recibe, y el concepto de privilegios concedidos a una identidad se utiliza para definir qué se puede hacer.
- En segundo lugar, considera que la evaluación de las decisiones de seguridad no es estática y absoluta, sino más bien dinámica y adaptativa, y que debe revisarse continuamente a la luz de los comportamientos observados. La decisión sobre cómo proceder con cada transacción —ya sea permitir la interacción, bloquearla, aumentar el nivel de confianza, etc.— también debe tener en cuenta el contexto empresarial más amplio y, en concreto, el equilibrio entre riesgos y beneficios.
- Por último, da por sentado que, por muchas capas de protección que se implementen, un adversario con suficiente motivación o suerte logrará vulnerar o eludir las protecciones. Por lo tanto, la detección oportuna de cualquier intrusión y la mitigación de los intentos de explotación de vulnerabilidades también deben ser una parte fundamental de la estrategia global.
Esta evolución ha sido, en parte, fruto del tiempo y la experiencia, pero cada vez está más impulsada por la confluencia de otras dos tendencias en la seguridad de las aplicaciones. En concreto, las arquitecturas de aplicaciones actuales amplían considerablemente el abanico de posibles vulnerabilidades —en particular, las amenazas procedentes del «interior» de la infraestructura de las aplicaciones— que los atacantes de hoy en día pueden aprovechar gracias a su creciente sofisticación. Afortunadamente, los avances paralelos en las herramientas de seguridad, especialmente cuando se utilizan junto con capacidades modernas de recopilación y análisis de datos, han permitido llevar a la práctica componentes clave de la estrategia defensiva.
El resto de esta introducción ofrece una visión general del marco de nuestro enfoque de la seguridad de confianza cero, así como de su alcance. A partir de ahí, las siguientes secciones profundizan en el planteamiento del problema y su relación con otros enfoques actuales de confianza cero, para dar paso a un análisis de los principios fundamentales —el «porqué»— que deben orientar la elección de las tecnologías de las soluciones y su aplicación. En futuros documentos se profundizará en el «cómo»: los requisitos que deben cumplir tecnologías específicas, como la autenticación, el control de acceso y el análisis asistido por IA, en relación con el modelo de madurez de confianza cero.
ZTS: Todo empieza por el porqué
El enfoque «Empieza por el porqué» de Simon Sinek es una herramienta eficaz para explicar el marco ZTS, como se muestra en la figura 1 a continuación. Este gráfico puede interpretarse de fuera hacia dentro, empezando por los tipos de amenazas que aborda ZTS, profundizando después en los métodos de seguridad utilizados y, por último, sintetizándolo todo en unos principios comunes. También puede interpretarse de dentro hacia fuera, tomando las convicciones fundamentales como guía, de las que surgen las herramientas y técnicas adecuadas que permiten hacer frente a un amplio abanico de amenazas.
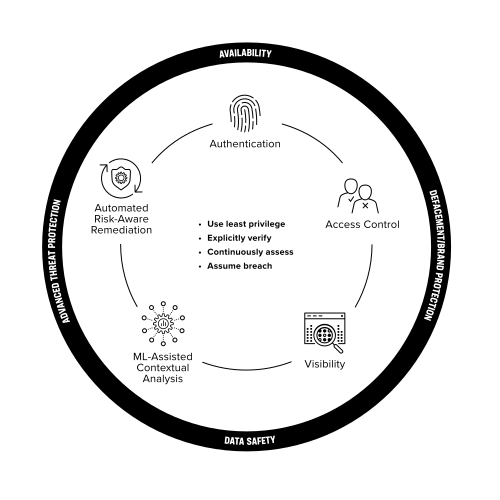
En las siguientes secciones se analiza en profundidad cada capa concéntrica de este diagrama, pero, en resumen:
- Los principios fundamentales del enfoque parten de plantear el caso de uso de la siguiente manera:
«¿Quién intenta hacer qué (acción) a quién?»- Para determinar quién y a quién, verifique explícitamente cualquier acreditación de identidad.
- Una vez que hayas determinado quién, utiliza el principio de mínimo privilegio para limitar qué se puede hacer.
- Evalúe y reevalúe continuamente los tres factores: quién, qué y a quién, y siga comprobando que se respetan las restricciones de la política.
- Parta siempre de la base de que se producirán brechas de seguridad y los sistemas se verán comprometidos. Esté preparado para intervenir si la acción (qué a quién), según un análisis de riesgos y beneficios (la probabilidad de fraude en la autenticación, ponderada por el impacto empresarial de la aprobación errónea de una transacción), supera un umbral de seguridad aceptable previamente establecido.
- Los métodos utilizados son:
- Autenticación y control de acceso para determinar quién con cierto grado de confianza y, después, limitar los permisos relativos a qué (acciones) se deben permitir a esa identidad con respecto a un destinatario específico: a quién se dirigen.
- Visibilidad y análisis asistido por aprendizaje automático para observar y evaluar continuamente el contexto completo de cada transacción: quién hace qué a quién.
- Corrección automatizada basada en el riesgo para intervenir en una transacción cuando la relación riesgo-beneficio supera el umbral de tolerancia especificado.
- Hacer frente a una amplia variedad de ciberataques aplicando estos métodos:
- Ataques tradicionales como la desfiguración de sitios web o la exfiltración de datos: puede hacer frente a estos ataques detectando identidades comprometidas o escaladas de privilegios, y utilizando técnicas de autenticación y control de acceso para limitar quién puede hacer qué mediante políticas.
- Ataques contra la disponibilidad/DDoS -- Para hacer frente a estos ataques, combine la autenticación y el control de acceso con medidas de mitigación basadas en el riesgo. Por ejemplo, bloquee el acceso (o limite la tasa de solicitudes) a los actores no autenticados o con una autenticación insuficiente que intenten realizar transacciones que consuman muchos recursos.
- Amenazas avanzadas, como el ransomware o los ataques a la cadena de suministro -- Puede hacer frente a estas amenazas detectando cambios y anomalías en los patrones de comportamiento de quién hace qué a quién, de nuevo en combinación con medidas de mitigación adaptadas al riesgo.
El alcance de ZTS
La seguridad de confianza cero abarca de forma integral toda la pila de aplicaciones, infraestructura y entrega, y debe extenderse a todo el proceso de desarrollo. Más concretamente, debe incluir lo siguiente:
- Toda la pila de aplicaciones e infraestructura, de principio a fin
- Base de hardware de computación, incluidos servidores, tarjetas de interfaz de red, coprocesadores y componentes de la placa base
- Firmware de bajo nivel y BIOS del hardware.
- El sistema operativo de la capa más baja, como el hipervisor o el núcleo de ejecución.
- El sistema operativo a nivel de aplicación o contenedor.
- Componentes de aplicaciones de terceros incorporados, ya sean comerciales o de código abierto.
- Cualquier software de aplicación desarrollado internamente o a medida.
- Pila completa de entrega de aplicaciones de extremo a extremo
- La cadena de suministro utilizada para el mantenimiento continuo y las actualizaciones de cada elemento de la pila, «de arriba abajo».
- Cualquier componente de entrega de aplicaciones en línea, como cortafuegos, equilibradores de carga, puertas de enlace de API, controladores de entrada/salida/malla y dispositivos de mitigación del fraude en línea.
- Cualquier componente de entrega de aplicaciones que afecte indirectamente a la gestión del tráfico, como los resolutores del sistema de nombres de dominio (DNS), o que reciba metadatos de forma indirecta, como las soluciones de gestión de eventos e información de seguridad (SIEM) o los servicios de identidad federada.
Tradicionalmente, la confianza cero se ha centrado en los equipos de desarrollo y entrega de aplicaciones, a menudo representados por los perfiles de Dev, DevOps, DevSecOps y SRE. Lo señalamos principalmente para ofrecer una visión más amplia: un enfoque integral de la confianza cero debería incluir, idealmente, perfiles e infraestructuras no tradicionales, así como flujos de trabajo adicionales, como la estrategia de aprovisionamiento de la cadena de suministro.
Planteamiento del problema
Una de las principales prioridades de los CIO y los CISO es modernizar las tecnologías de la información para impulsar el negocio. También desempeñan un papel clave en el gobierno del riesgo corporativo. Su objetivo es ayudar a la empresa a cautivar a los clientes con nuevas experiencias digitales, aumentar la eficiencia operativa mediante la conectividad digital con terceros y permitir que los empleados sean productivos desde cualquier lugar, al tiempo que se minimizan los riesgos empresariales. Esto exige que los departamentos de los CIO y los CISO den a sus equipos libertad para utilizar las tecnologías, arquitecturas y buenas prácticas más recientes para ganar agilidad y, al mismo tiempo, les encomienden la tarea de adoptar las medidas de seguridad adecuadas y establecer controles sobre el comportamiento de las personas, la información a la que acceden y la tecnología que utilizan, con el fin de evitar la exposición a pérdidas.
Las organizaciones deben comprender y controlar los riesgos relacionados con los cambios en las condiciones del mercado y macroeconómicas, el comportamiento de los consumidores, la cadena de suministro y la exposición a amenazas de seguridad. Una evaluación precisa de los riesgos y la capacidad de adoptar rápidamente medidas para mitigarlos constituyen una ventaja competitiva para las empresas. En este documento nos centramos en el riesgo derivado de la exposición a amenazas de seguridad, que, entre otras consecuencias, puede provocar la pérdida de propiedad intelectual, la interrupción de los procesos empresariales, la pérdida de información de identificación personal y la imposición de multas por parte de los organismos reguladores. El riesgo de seguridad puede calcularse evaluando los siguientes aspectos de la situación objeto de análisis:
- Valor de los activos implicados
Los activos implicados en las transacciones tienen distintos niveles de importancia. Por ejemplo, una base de datos que contiene información de identificación personal es más valiosa que una que enumera los puntos de venta que comercializan productos fabricados por la empresa. Los equipos de seguridad y TI pueden utilizar un proceso determinista para crear un inventario de todos los activos, clasificados mediante una puntuación que representa el «valor» de cada activo. - Impacto de una vulneración
La naturaleza de la vulneración determina su impacto. Por ejemplo, el impacto del robo de información de un almacén de datos que contiene información de identificación personal es mucho mayor que el de una interrupción de la disponibilidad de dicho almacén. Aunque resulta algo más impreciso, es posible enumerar distintos tipos de vulneraciones y asignarles una puntuación de «impacto». - Probabilidad de que se produzca una vulneración
La probabilidad de que una transacción dé lugar a la vulneración de un activo es el factor menos determinista a la hora de evaluar el riesgo asociado a dicha transacción. Las personas no pueden gestionar el volumen de observaciones necesarias, por lo que las organizaciones recurren al aprendizaje automático y a la inteligencia artificial para aumentar la fiabilidad de sus cálculos de la probabilidad de que se produzca una vulneración.
El reto consiste en calcular el riesgo asociado a cada transacción prácticamente en tiempo real y adoptar las medidas de mitigación adecuadas para controlar el impacto de una posible vulneración de la seguridad.
Identificar el problema
Las exigencias de acelerar el negocio dan lugar a nuevas prácticas que agravan los riesgos de ciberseguridad. A continuación, analizamos este punto con más detalle.
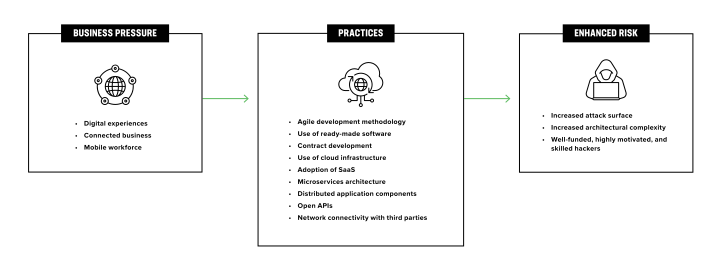
- Exigencias de aceleración empresarial
- Experiencias digitales
Los consumidores tienen un deseo insaciable de experiencias digitales y exigen mejoras frecuentes en múltiples plataformas (ordenadores, tabletas y teléfonos móviles). - Empresa conectada
Los procesos empresariales digitales requieren conexión con socios, proveedores, distribuidores y servicios prestados por otras empresas. - Plantilla móvil
Los empleados deben poder acceder a las aplicaciones empresariales desde cualquier lugar para realizar sus tareas de forma eficiente.
- Experiencias digitales
- Prácticas para satisfacer las necesidades empresariales
- Metodología de desarrollo ágil
Las empresas adoptaron un enfoque de desarrollo ágil, incremental e iterativo, centrado en la satisfacción del cliente, en lugar del enfoque secuencial en cascada, que se centra en la entrega de los proyectos dentro de los plazos previstos. - Uso de software listo para usar
Para ofrecer nuevas experiencias digitales lo antes posible, los desarrolladores reutilizan código que otros profesionales del sector publican como código abierto. - Desarrollo por contrato
Subcontratar el trabajo a desarrolladores externos ayuda a las empresas a ampliar su plantilla según sus necesidades. - Uso de infraestructura en la nube
La agilidad, la flexibilidad y la escalabilidad de la nube, junto con su facilidad de uso, permiten a los desarrolladores obtener la infraestructura que necesitan bajo demanda. - Adopción de SaaS
El software como servicio (SaaS) ofrece ventajas para las aplicaciones de gestión empresarial, ya que reduce considerablemente la carga que supone adquirir, implementar y mantener dichas aplicaciones en centros de datos privados. - Arquitectura de microservicios
Los equipos utilizan microservicios para lograr una entrega continua y reducir el tiempo de comercialización. - Componentes de aplicaciones distribuidas
Las organizaciones ganan en eficiencia al ejecutar microservicios en infraestructuras que ofrecen las mejores herramientas para desarrollar o proporcionar las funcionalidades del servicio. Las ampliaciones más recientes de los flujos de trabajo heredados se realizan mediante arquitecturas de aplicaciones modernas que necesitan comunicarse con los elementos heredados, y ambos suelen ejecutarse en infraestructuras diferentes. - API abiertas
Un ecosistema de servicios diversos es más eficiente que una empresa que desarrolla todos los servicios por su cuenta. - Conectividad de red con terceros
Las empresas se conectan con sus socios, proveedores y distribuidores mediante túneles cifrados para automatizar y agilizar los procesos empresariales.
- Metodología de desarrollo ágil
- Mayor riesgo de seguridad
- Mayor superficie de ataque
El uso de software de terceros y bibliotecas de código abierto genera oportunidades para los ataques a la cadena de suministro y hace que se hereden todas las vulnerabilidades del software desarrollado externamente. Los desarrolladores externos tienen como objetivo entregar las funcionalidades a tiempo y la seguridad no es su prioridad. Además, una vez que entregan el software y abandonan el proyecto, a los equipos internos les resulta difícil y laborioso revisar el código y detectar brechas de seguridad. Los sprints ágiles son muy eficientes a la hora de entregar funcionalidades, pero la mayor velocidad de desarrollo deja poco tiempo para realizar auditorías y pruebas de seguridad exhaustivas. Un solo microservicio vulnerable que pueda comunicarse con otros microservicios aumenta el riesgo de seguridad para todo el sistema. Aunque la interconexión entre empresas mejora la eficiencia operativa, una consecuencia grave es que las brechas de seguridad de cualquiera de ellas afectan a todas las demás. Los atacantes buscan el eslabón más débil para propagarse por el resto. Una vulnerabilidad o un fallo de seguridad en la plataforma SaaS o en la infraestructura en la nube se convierte en un vector de ataque adicional, y el modelo de responsabilidad compartida puede complicar la detección temprana y la subsanación. - Mayor complejidad arquitectónica
Los componentes de las aplicaciones distribuidas, desarrollados con distintas arquitecturas y desplegados en múltiples infraestructuras, tienen diferentes necesidades de seguridad y cumplimiento normativo. Esto dificulta que los equipos de seguridad diseñen e implementen mecanismos adecuados para proteger las aplicaciones y los datos empresariales y cumplir los requisitos normativos. - Hackers bien financiados, muy motivados y altamente cualificados
Desde la Operación Aurora de 2010 hasta Solargate de 2020, hemos vivido una década de ciberataques avanzados que solo se descubren después de haber causado graves daños. Se produjeron brechas de seguridad en organizaciones equipadas con la mejor tecnología de seguridad, gestionada por equipos de seguridad altamente cualificados. Los atacantes permanecieron en la infraestructura informática de estas organizaciones durante largos periodos antes de ser detectados. Se robó propiedad intelectual e información de identificación personal, se interrumpieron las operaciones empresariales y las organizaciones fueron víctimas de secuestros mediante ransomware, pese a que los equipos de TI y de seguridad iban más allá del mero cumplimiento de las normativas concebidas para mantener a raya los ciberataques.
- Mayor superficie de ataque
Directrices del Gobierno de Estados Unidos
Tras una oleada de ciberataques persistentes contra diversos organismos gubernamentales federales, estatales y locales de Estados Unidos y varias empresas estadounidenses, el presidente Joe Biden emitió una orden ejecutiva para mejorar la ciberseguridad del país el 12 de mayo de 2021. Uno de los elementos clave de esta orden es que los organismos gubernamentales utilicen los principios de confianza cero para prepararse frente a los ciberataques. Tras esta orden, la Administración Biden publicó un memorando de la Oficina de Gestión y Presupuesto (OMB) dirigido a los responsables de los departamentos y organismos del poder ejecutivo el 26 de enero de 2022. Este memorando de la OMB «establece una estrategia federal de arquitectura de confianza cero (ZTA) que exige a los organismos cumplir determinadas normas y objetivos de ciberseguridad antes de que finalice el ejercicio fiscal de 2024, con el fin de reforzar las defensas del Gobierno frente a campañas de amenazas cada vez más sofisticadas y persistentes».1 Tanto la orden ejecutiva como el memorando de la OMB hacen referencia a la arquitectura de confianza cero descrita en la publicación SP 800-207 del Instituto Nacional de Estándares y Tecnología (NIST), publicada en agosto de 2020, y exigen que los organismos gubernamentales la adopten.
Arquitecturas de confianza cero y modelos de madurez
Referentes de organismos gubernamentales y del sector privado han publicado documentos que ayudan a explicar la arquitectura de confianza cero y ofrecen recomendaciones sobre la mejor manera de adoptarla. A continuación, resumimos las ideas recogidas en estos documentos. Cabe señalar que la esencia de estas ideas y sugerencias consiste en examinar cada transacción para determinar quién intenta realizar qué acción sobre quién, y decidir en tiempo real si se permite o se deniega la transacción en función del cálculo del riesgo asociado a ella.
Instituto Nacional de Estándares y Tecnología (NIST): Zero trust architecture
El equipo del NIST enumera los principios de confianza cero y define una arquitectura abstracta de confianza cero (ZTA) en su publicación NIST SP 800-207.2 Además, analiza las variantes de los enfoques de confianza cero y describe distintas formas de implementar la arquitectura abstracta.
Las principales abstracciones que se analizan en el documento son el punto de decisión de políticas (PDP) y el punto de aplicación de políticas (PEP), que trabajan conjuntamente. El punto de decisión de políticas se compone del motor de políticas (PE) y del administrador de políticas (PA). El motor de políticas utiliza un algoritmo de confianza para decidir si se debe conceder a un sujeto acceso a un recurso. El administrador de políticas ejecuta esta decisión y se comunica con el punto de aplicación de políticas para permitir o denegar una nueva sesión y modificar o finalizar una sesión existente. Además, el documento analiza variantes del algoritmo de confianza, los componentes de red para un entorno de confianza cero y diversos casos de uso o escenarios de despliegue. Por último, se examinan las formas en que los atacantes pueden vulnerar la arquitectura de confianza cero, para que los responsables de su implementación tengan presentes las amenazas y adopten las medidas adecuadas para proteger los componentes de su arquitectura de confianza cero.
Agencia de Ciberseguridad y Seguridad de las Infraestructuras (CISA): Modelo de madurez de confianza cero
Con el objetivo de ayudar a los organismos a desarrollar sus planes de confianza cero, los expertos de referencia de la Agencia de Ciberseguridad y Seguridad de las Infraestructuras (CISA) publicaron un modelo de madurez de confianza cero (https://www.cisa.gov/zero-trust-maturity-model).3 El trabajo se basa en la arquitectura abstracta de confianza cero descrita en el documento NIST SP 800-207. Los autores han identificado cinco áreas y recomiendan que las organizaciones avancen de forma constante en la aplicación de los principios de confianza cero en cada una de ellas. Estas áreas son: (i) identidad, (ii) dispositivos, (iii) red, (iv) cargas de trabajo de las aplicaciones y (v) datos. Recomiendan el uso de la visibilidad y el análisis, así como de la automatización y la orquestación, en cada una de las cinco áreas.
El documento ofrece un modelo de madurez de alto nivel que abarca los cinco pilares fundamentales de la confianza cero identificados anteriormente y, a continuación, profundiza en cada área. Las organizaciones pueden utilizar el modelo de madurez para comprender su estado actual y trazar un camino iterativo hacia el estado óptimo.
Departamento de Defensa (DOD): Arquitectura de referencia de confianza cero
Tras descubrirse los ataques a Solar Winds, la Agencia de Seguridad Nacional (NSA) publicó unas directrices en su documento «Adopción de un modelo de seguridad de confianza cero», en las que recomendaba a los equipos de ciberseguridad adoptar dicho modelo.4 Los expertos del equipo conjunto de ingeniería de confianza cero de la Agencia de Sistemas de Información de Defensa (DISA) y la Agencia de Seguridad Nacional elaboraron la arquitectura de referencia de confianza cero del Departamento de Defensa (DOD).5 Los autores expresan la necesidad de adoptar el modelo de confianza cero con la siguiente afirmación: «Las vulnerabilidades puestas de manifiesto por las brechas de datos dentro y fuera del DOD demuestran la necesidad de un modelo de ciberseguridad nuevo y más sólido que facilite la toma de decisiones bien fundamentadas y basadas en el riesgo».6
Esta arquitectura de referencia basa sus recomendaciones en las abstracciones definidas en el documento NIST SP 800-207 sobre arquitectura de confianza cero. El documento presenta un modelo operativo de alto nivel y describe sus elementos en detalle. También incluye un modelo de madurez de alto nivel y un mapa de capacidades para aplicar los principios de confianza cero a diversas áreas de interés. En conjunto, estos documentos ayudan a las organizaciones a evaluar su situación actual y a elaborar un plan.
Gestión del riesgo y la gobernanza con principios de confianza cero
Adoptar una actitud que dé por hecho que se ha producido una brecha de seguridad y seguir los principios de confianza cero puede ayudar a las organizaciones en sus prácticas de gestión de riesgos y gobernanza. Los principios de confianza cero de «supervisión continua» y «verificación explícita» de los actores que intervienen en las transacciones permiten a las organizaciones establecer una puntuación de riesgo dinámica para todos los actores y sus actividades. Esto está en consonancia con la recomendación de Gartner de utilizar la metodología de «evaluación continua y adaptativa del riesgo y la confianza» (CARTA) para mejorar los programas de seguridad existentes. Adoptar el principio de conceder acceso a los recursos únicamente con los privilegios mínimos necesarios reduce el riesgo de pérdidas incluso cuando se produce una brecha de seguridad. La información generada por la supervisión continua y la verificación explícita también resulta útil para elaborar informes de cumplimiento normativo.
La mentalidad en más detalle
Esta sección se centra en la mentalidad —el sistema de creencias, el «porqué»— que orienta la estrategia y las decisiones sobre las herramientas y el diseño que una empresa debe adoptar para aplicar la seguridad de confianza cero. De hecho, los fundamentos de todos los métodos y tecnologías que componen las soluciones actuales de confianza cero pueden resumirse en cuatro principios clave sencillos. Esta sección comienza con una enumeración de estos principios, seguida de un análisis de cómo pueden aplicarse en el contexto más amplio del ciclo de vida del desarrollo de aplicaciones; es decir, cómo tenerlos en cuenta desde el principio, en la fase de diseño, y también en el plano operativo, durante el despliegue y la ejecución de la aplicación.
Principios operativos de confianza cero
Si se entiende que las soluciones de confianza cero consisten fundamentalmente en generar confianza en las interacciones entre sistemas —«Quién hace Qué a Quién?»—, el proceso de generar un nivel de confianza adecuado para cada interacción puede dividirse en cuatro componentes.
Verificar explícitamente
Como su nombre indica, la mentalidad de confianza cero se basa en «No confíes ciegamente, verifica siempre». Por lo tanto, cualquier actor del sistema —el quién y el a quién en las interacciones del sistema— debe ser capaz de:
- Acreditar su identidad, incluido el caso especial de una identidad «anónima», si el sistema permite interacciones cuyo origen o destino sean identidades anónimas, como los navegadores anónimos en un sistema de reservas de vuelos. Para todas las demás identidades, el actor debe poder indicar quién es, en un espacio de nombres que el sistema acepte.
- Recibir y validar «pruebas» complementarias de la identidad declarada del actor (para cualquier identidad declarada que no sea anónima). La naturaleza de las «pruebas» —contraseñas, certificados, comportamientos, etc.— puede variar, al igual que su solidez, pero el sistema debe ser capaz de establecer cierto grado de confianza en la declaración de identidad. Los sistemas sencillos pueden valorar la confianza en las pruebas de forma binaria, con un sí o un no, mientras que los sistemas más avanzados pueden disponer de una puntuación numérica de confianza que pueda utilizarse explícitamente como referencia en una política basada en la relación entre riesgo y beneficio. Cabe señalar que el sistema también puede aumentar o reducir la confianza por otros medios, como la respuesta a un desafío activo o incluso la observación pasiva del comportamiento del actor.
- Evaluar y ajustar la confianza en la identidad acreditada a partir de una contextualización adicional del comportamiento actual con respecto a comportamientos anteriores. Por ejemplo, el sistema puede conservar metadatos históricos sobre el actor, como su geolocalización anterior y actual, sus plataformas de hardware, direcciones IP, reputación, etc., con el fin de aumentar o reducir la confianza en la «prueba» de identidad.
Además, el principio de verificación explícita puede aplicarse no solo a la identidad, sino también a la acción: el «qué» de la transacción. Un caso de uso habitual es aquel en el que la acción se expresa como una llamada a una API, por ejemplo, para realizar una consulta a una base de datos. En este ejemplo, el principio de verificación explícita puede utilizarse no solo para confiar en la identidad del actor que llama a la API, sino también para verificar que la acción de la API se utiliza correctamente, por ejemplo, comprobando que los parámetros que se pasan a la API cumplen las restricciones pertinentes.
En un enfoque maduro de confianza cero, las «pruebas» casi nunca son absolutas. Las credenciales de identidad pueden ser robadas y los dispositivos pueden verse comprometidos; las restricciones de los parámetros de las API suelen ser incompletas. Por tanto, el término «confianza» en el contexto de la confianza cero debe interpretarse más bien como una indicación de la probabilidad de que la identidad acreditada o los parámetros de la transacción sean legítimos. Así pues, el nivel de «confianza» debe considerarse un factor clave, pero no el único, a la hora de decidir si se permite, se bloquea o se examina más a fondo una transacción.
Mínimo privilegio
Una vez establecido un nivel aceptable de «confianza» en los actores que participan en una transacción, el enfoque de confianza cero exige que al actor (normalmente, el solicitante, el «quién») se le concedan únicamente los privilegios mínimos necesarios para desempeñar la función para la que está diseñado en ese sistema. Este principio representa lo que también se conoce como «modelo de seguridad positivo»: un enfoque en el que todas las acciones están prohibidas por defecto y solo se conceden privilegios específicos cuando son necesarios para el funcionamiento del sistema. Por ejemplo, un sistema de reservas puede permitir a los usuarios anónimos consultar los horarios de los vuelos, pero, según los requisitos de diseño de la aplicación, puede que no les permita reservar un vuelo.
Estos privilegios pueden aplicarse a actores individuales o a clases de actores. Por lo general, los consumidores de una aplicación son personas o entidades que actúan en su nombre y se agrupan en clases como «usuarios anónimos», «clientes», «socios» o «empleados». Las clases de actores menos fiables suelen requerir un umbral de confianza más bajo para superar la autenticación, pero también tienen acceso a un menor número de API o a API menos sensibles. Los actores internos de la aplicación o de su infraestructura, como determinados servicios o contenedores de una aplicación, a menudo pueden tener privilegios más específicos, como «solo los contenedores <X> e <Y> pueden acceder a la base de datos; solo <X> puede escribir en el almacén de objetos, pero <Y> y <Z> pueden leer su contenido».
Un aspecto importante a la hora de implementar el principio de mínimo privilegio es procurar aplicarlo de forma más personalizada y planificada.7 En concreto, en lugar de aplicar un conjunto genérico de privilegios a todos los actores o a una clase de actores, una implementación madura de confianza cero debería tener una visión más detallada de qué acción se está intentando realizar. Por ejemplo, a un nivel muy general, se puede conceder el privilegio de «acceso al sistema de archivos», pero «lectura del sistema de archivos» define con mayor precisión el privilegio que realmente se necesita, lo que permite una implementación de alta calidad del modelo de seguridad positiva.
Por último, las aplicaciones más sofisticadas del principio de mínimo privilegio pueden combinarse con implementaciones maduras del principio de «verificar explícitamente», considerando que los privilegios autorizados para un actor no son absolutos, sino que dependen del nivel de confianza que proporciona la autenticación. Así, los privilegios solo se conceden si la confianza en la identidad acreditada (Quién) alcanza un umbral mínimo, que se establece específicamente para la acción que se intenta realizar. Por ejemplo, una acción con un impacto especialmente significativo (como apagar el sistema) puede requerir un nivel de confianza del 90 % o superior en que el actor es un administrador. En este ejemplo, si la confianza del sistema en la identidad es solo del 80 % cuando se intenta apagarlo, el sistema exigiría una verificación adicional para aumentar la puntuación de confianza en la identidad acreditada antes de permitir la acción.
Evaluar continuamente
La verificación explícita y el principio de mínimo privilegio son conceptos clave; sin embargo, el principio de evaluación continua refleja la necesidad de evaluar constantemente dichos principios, en el sentido de que:
- Todas las transacciones deben someterse a verificación y control de privilegios. En otras palabras, no se debe inspeccionar únicamente un subconjunto de transacciones, como «la primera transacción de una sesión de usuario» o «las transacciones que se inician desde una carga de trabajo de un contenedor Docker». Aunque esto pueda parecer evidente, muchas implementaciones de confianza cero no validan todas las transacciones, ya sea por un diseño deficiente o por falta de visibilidad. Las deficiencias más habituales en este ámbito se deben a que la confianza cero solo se aplica a los actores externos, pero no a los internos, y/o a que se da por hecho que una decisión de confianza cero sigue siendo válida durante un periodo prolongado.
- Los factores clave de la evaluación —la confianza en la identidad del actor y los permisos que se le conceden— deben considerarse dinámicos y sujetos a cambios. Por ejemplo, la confianza en una identidad puede aumentar o disminuir con el tiempo en función de los comportamientos observados y de los metadatos de canales auxiliares, por lo que cualquier política basada en la confianza también debe ajustarse dinámicamente a esos cambios. Además, un nivel de privilegios concedido previamente por una política puede revocarse poco después, o puede cambiar el nivel mínimo de confianza necesario para realizar una acción. Aunque los plazos de los cambios en las políticas pueden variar —pueden producirse lentamente (al ritmo de los procesos operativos humanos) o con rapidez (mediante agentes de gobernanza automatizados)—, el sistema debe ser capaz de responder dinámicamente a esos cambios y aplicarlos.
Asumir que se ha producido una brecha de seguridad
El último principio se basa en la presunción de que existen adversarios muy motivados, en un contexto de sana paranoia. En concreto, la premisa es «da por hecho que ya has sufrido una brecha de seguridad», donde «brecha» se define como «una transacción que debería haberse denegado (con un conocimiento y una ejecución perfectos), pero que, en cambio, se permitió». La causa de que esta transacción eluda los controles puede ser un conocimiento imperfecto (por ejemplo, una puntuación de confianza elevada e incorrecta en la autenticación debido a credenciales fraudulentas no detectadas), limitaciones de implementación (por ejemplo, que los privilegios concedidos no tengan un nivel de detalle suficiente, como disponer del privilegio de «abrir una conexión de red», pero sin poder diferenciar en función de la geolocalización del destino de la conexión) o una implementación incompleta del modelo de confianza cero (por ejemplo, no aplicarlo a componentes vulnerables de código abierto utilizados internamente).
Por lo tanto, la mentalidad de confianza cero también debe contemplar la mejor manera de gestionar y minimizar el impacto de dichas brechas de seguridad.
La aplicación de este principio varía más que la de los demás, pero generalmente se concreta en:
- En primer lugar, identifique las transacciones que, aunque técnicamente estén permitidas por la política, resulten sospechosas. Lo que se considera «sospechoso» suele depender mucho del contexto, pero las interpretaciones habituales son: (a) transacciones anómalas muy distintas de los comportamientos observados anteriormente; (b) grupos de transacciones que, por separado, son normales, pero que en conjunto resultan inusuales; por ejemplo, leer y escribir un archivo puede ser habitual, pero hacerlo a un ritmo de 1000 archivos por segundo puede resultar inusual; o (c) acciones que guardan relación con un efecto no deseado y no observado anteriormente en el sistema; un ejemplo sería un patrón en el que una transacción concreta abre una conexión de red con un nodo TOR o provoca un aumento significativo de la carga de la CPU del sistema.
- A continuación, realice un análisis más profundo, mediante un flujo de trabajo totalmente automatizado o uno híbrido controlado por personas y asistido por aprendizaje automático, para determinar si esas transacciones no son válidas. Si se determina que no lo son, aplique medidas de mitigación. Estas pueden consistir en una actualización general de las políticas o, como capa adicional de mitigación, en una «red de seguridad» que refuerce las demás medidas de mitigación basadas en políticas.
Si el enfoque elegido consiste en realizar ajustes basados en políticas, estos pueden aplicarse mediante cualquiera de las herramientas de políticas estáticas disponibles. Algunos ejemplos de estos ajustes serían restringir los privilegios de control de acceso a nivel de transacción (es decir, dejar de permitir que Quién haga Qué a Quién) o, como alternativa, aplicar un «estándar de prueba» más estricto (es decir, exigir autenticación multifactor o una puntuación de confianza más alta) para que un actor (o una clase de actores) realice una acción específica.
Si, por el contrario, se opta por utilizar una capa adicional de protección de último recurso, esta estrategia también puede implementarse con un nivel de granularidad fino o grueso. La estrategia más granular consistiría en bloquear única y exclusivamente aquellas transacciones que superen una determinada relación entre riesgo y beneficio, aunque esta solución también podría añadir niveles de latencia inaceptables a algunas transacciones permitidas si la implementación requiere análisis adicionales. En su lugar, podrían emplearse estrategias menos granulares, como ejecutar las futuras transacciones de ese actor en un entorno aislado o incluso impedir por completo su acceso al sistema. En casos extremos, podrían resultar adecuados métodos de mitigación aún menos granulares, como desactivar la entrada y salida de archivos.
Por supuesto, en igualdad de condiciones, suele ser preferible una mitigación de último recurso más granular. Sin embargo, a menudo es necesario hacer concesiones en función de las limitaciones de las tecnologías disponibles, y una medida de último recurso menos granular suele ser mejor que ninguna. Por ejemplo, si la respuesta menos granular para frenar un posible ataque de ransomware consiste en desactivar la entrada y salida de archivos, los efectos secundarios de esa respuesta pueden seguir siendo preferibles a la alternativa —permitir que el actor siga operando en el sistema sin control—, suponiendo que el resultado de la inacción fuera un sistema de archivos cifrado por ransomware.
Confianza cero: en realidad, empieza antes de las operaciones
El mejor punto de partida para desarrollar aplicaciones seguras con un enfoque de confianza cero es, como cabría esperar, el principio. Los fundamentos que permiten poner en práctica los principios de confianza cero deben incorporarse desde la fase de diseño de los procesos de desarrollo de aplicaciones. Por tanto, cualquier debate sobre una solución operativa de confianza cero integrada en el flujo de CI/CD debe comenzar por comprender estos elementos fundamentales, que deben ser consideraciones prioritarias en el diseño.
El núcleo de estos elementos fundamentales debe reflejar el comportamiento deseado o previsto de las interacciones entre los comportamientos del sistema, junto con la visibilidad y el control suficientes para detectar desviaciones y actuar ante ellas. Las interacciones previstas se utilizan para definir el conjunto de acciones deseadas (qué) de cada actor (quién) sobre cada objetivo (a quién). Dicho esto, puede haber escenarios y entornos en los que se desconozcan los patrones de interacción previstos. En esos casos, una organización puede aprovechar una mayor visibilidad para «descubrir» el conjunto de interacciones adecuadas,8 que luego podrá plasmar en políticas.
Por ejemplo, en las soluciones ZTNA actuales, que se centran en el control de acceso basado en la identidad a las API externas de una aplicación, es necesario disponer de visibilidad y control sobre las API de autenticación. O bien, en el contexto de una plataforma de protección de cargas de trabajo en la nube (CWPP), detectar una carga de trabajo de un contenedor comprometida requiere visibilidad sobre las acciones que realiza cada contenedor, y esta visibilidad debe ser en tiempo real si se requiere una corrección en tiempo real.
A continuación se enumeran las categorías generales relativas a las consideraciones fundamentales que deben formar parte del proceso de diseño, junto con un análisis más detallado que plantea preguntas específicas sobre las que reflexionar para cada uno de los puntos clave:
- ¿Cuáles son las interfaces de caja negra —entradas y salidas— del sistema?
- ¿Cuáles son los tipos de usuarios —administradores, usuarios autenticados, usuarios no autenticados, socios— que interactúan con la aplicación y qué necesitan hacer?
- ¿Todas las comunicaciones se realizan a través de una API definida, o existen comunicaciones de red «en bruto» o comunicaciones a través de un almacén de datos, como una base de datos o un almacén de objetos?
- En el caso de las comunicaciones a través de una API, ¿hasta qué punto están definidos los usuarios que pueden interactuar con ella y las restricciones aplicables a esas interacciones (p. ej., restricciones de parámetros, límites de frecuencia de las solicitudes, etc.)?
- En cualquier comunicación de red, ¿se transmiten cifrados todos los datos?
- Si existen interfaces de datos «en bruto» (por ejemplo, si se comparte información entre el cliente y la aplicación a través de un almacén de objetos o una base de datos), ¿hay registros de auditoría que permitan saber quién ha accedido a qué información y cuándo?
- Del mismo modo, a nivel interno de «caja blanca», ¿qué servicios componen las aplicaciones en su conjunto, incluidos los servicios proporcionados por terceros, y cómo se comunican entre sí?
- ¿Cómo se comunican estos servicios? ¿Qué API se utiliza y qué restricciones (roles, controles de acceso, límites de solicitudes, parámetros, etc.) se aplican a esas interacciones?
- Se plantean preguntas similares a las anteriores sobre el grado de formalización de la API y sus restricciones, así como sobre el cifrado de las comunicaciones.
- Es más probable que las comunicaciones «internas» (p. ej., entre cargas de trabajo o contenedores) utilicen memoria compartida e interfaces basadas en el sistema de archivos; se deben identificar todas estas interfaces.
- ¿Cómo se comunican estos servicios? ¿Qué API se utiliza y qué restricciones (roles, controles de acceso, límites de solicitudes, parámetros, etc.) se aplican a esas interacciones?
- ¿Qué mecanismos de control ofrece el sistema para limitar el acceso a las interfaces de caja negra y a las vías de comunicación internas?
- ¿Existe una política que indique quién —qué roles— puede invocar determinadas API y qué ocurre si se incumple dicha política? Del mismo modo, ¿qué medios existen para detectar y mitigar cualquier tipo de uso indebido de las API, como el uso de parámetros no válidos o una frecuencia de invocación excesiva? ¿Se pueden actualizar dinámicamente estas políticas en función de la información contextual procedente de otros sistemas?
- Del mismo modo, ¿existen políticas que restrinjan las demás formas de comunicación entre cargas de trabajo —sistemas de archivos, almacenes de objetos, tablas de bases de datos— en cuanto a quién puede acceder a qué archivos, almacenes o tablas, y que impidan el uso abusivo de esos recursos (p. ej., «SELECT * from <table>»)?
- ¿Qué visibilidad (paneles de control, registros, estadísticas) ofrece el sistema para limitar el acceso tanto a las interfaces de caja negra como a las vías de comunicación internas?
- ¿Puede el sistema identificar quién invoca cada API y en qué momento? ¿Se conservan estos datos y, de ser así, durante cuánto tiempo? ¿Con qué rapidez se ponen a disposición estos datos (en tiempo real, cada hora, etc.)? ¿Hasta qué punto son fáciles de procesar? ¿Se trata de un archivo de registro no estructurado, de datos estructurados en formato JavaScript Object Notation (JSON) que pueden enviarse a un servicio de gestión de eventos e incidentes de seguridad (SEIM) o de datos almacenados en una tabla de una base de datos de big data?
- ¿Cuáles son las respuestas a estas mismas preguntas cuando se trata de otras vías de comunicación: memoria, archivos, objetos, bases de datos? ¿Quién hace qué? ¿Cómo se exponen esos datos?
- Más allá de las vías de comunicación, ¿qué otros mecanismos de control y visibilidad ofrece el sistema para evitar la sobreasignación o el consumo excesivo de recursos?
- ¿Ofrece el sistema visibilidad sobre las métricas de consumo de recursos (CPU, memoria, ancho de banda, escalado de pods, etc.)? En caso afirmativo, ¿con qué nivel de detalle y hasta qué punto resulta fácil utilizar esos datos?
- ¿Dispone el sistema de controles o mecanismos de protección para el consumo de recursos, como límites de memoria, CPU y E/S de archivos por carga de trabajo, seguimiento de las llamadas al sistema para la creación de procesos, límites de escalado vertical y horizontal de los pods o límites de frecuencia para las API que invocan otros servicios?
Plantear estas preguntas de forma explícita le ayudará a descubrir dónde existen carencias en las bases necesarias para implementar un modelo de confianza cero. A menudo, el mero hecho de plantearlas en las primeras fases del diseño permitirá subsanar esas carencias con un esfuerzo de diseño adicional mínimo. Y, cuando persista alguna carencia, el simple hecho de conocerla ayudará a determinar dónde prestar más atención a la seguridad o a identificar superficies de ataque vulnerables.
Realizar este tipo de análisis previo de desarrollo seguro es una parte fundamental de la mentalidad de confianza cero. Sin embargo, hoy en día gran parte de la atención en torno a la confianza cero se centra en lo que ocurre después del diseño inicial, y la mayoría de las empresas se centran principalmente en los aspectos de la confianza cero posteriores al diseño. No obstante, tener en cuenta, durante la fase de diseño, los requisitos para una implementación eficaz de la confianza cero evitará tener que dedicar esfuerzos adicionales mucho mayores a «tapar los agujeros» una vez desplegada la aplicación.
Consideraciones sobre la mitigación: rapidez de respuesta, falsos positivos y negativos, y riesgo
Como refleja la premisa de «dar por hecho que se ha producido una brecha» de este enfoque, un profesional de la seguridad debe asumir que algún adversario con suficiente motivación conseguirá ejecutar una transacción maliciosa: un caso de Quién hace Qué a Quién que cumple las reglas de la política, pero que, en un mundo ideal, no debería haberse permitido. En tales casos, la atención pasa a centrarse en disponer de un mecanismo eficaz de «última línea de defensa» que permita detectar esos casos, normalmente a partir de la observación de patrones de transacciones y efectos secundarios en el sistema, tal como se describe en la sección anterior sobre «dar por hecho que se ha producido una brecha».
Sin embargo, al igual que ocurre con el concepto de identidad, nunca se podrá saber con absoluta certeza si una transacción concreta es maliciosa o no. Por tanto, al igual que en el caso de la identidad, una solución ideal de confianza cero debería indicar una puntuación de «confianza» en la legitimidad de la transacción. Por ejemplo, observar que un demonio lee y escribe archivos a un ritmo 10 veces superior al habitual durante 10 segundos podría dar lugar a una puntuación de confianza (en su carácter malicioso) del 70 %, pero observar que el ritmo se multiplica por 100 y se mantiene durante 1 minuto podría elevar esa confianza al 95 %. En este ejemplo, tomar la medida correctiva de impedir futuras escrituras de archivos seguirá teniendo cierta probabilidad (del 30 % o del 5 %) de ser una respuesta incorrecta: un «falso positivo». Por tanto, la decisión de aplicar o no medidas correctivas debe sopesar el riesgo de falsos positivos frente al posible impacto de permitir un comportamiento que podría ser malicioso.
El objetivo del ejemplo es destacar que cualquier decisión de adoptar una medida correctiva perceptible para el usuario es, en realidad, una decisión empresarial que tiene en cuenta todos los riesgos, costes y beneficios asociados a la actividad sospechosa. Introducir obstáculos adicionales en la transacción aumenta la probabilidad de que no se obtenga el valor esperado, pero no intervenir ni añadir obstáculos conlleva el riesgo de que se vea comprometida la seguridad. Por tanto, la decisión de actuar (o no) en estos casos depende de tres factores:
- ¿Qué riesgo supone permitir que continúen transacciones potencialmente maliciosas?
Este riesgo puede ser directamente económico, como en el caso de una transferencia de fondos bancarios, o conllevar costes indirectos, ya sean operativos (por ejemplo, el cifrado de registros esenciales para exigir un rescate) o de imagen de marca (por ejemplo, la alteración no autorizada de un sitio web). También puede haber costes legales o de cumplimiento normativo, como los derivados de la filtración de datos personales de los clientes. En esencia, la asignación del riesgo es una cuestión de gobernanza, y una buena gobernanza implica comprender y cuantificar los riesgos de la aplicación. - ¿Cuáles son los efectos secundarios de aplicar la medida correctiva?
Los efectos secundarios pueden evaluarse en dos dimensiones: (a) la fricción introducida y (b) el radio de impacto. La fricción indica cuánto más difícil resulta que una transacción legítima siga adelante; puede ir desde una ligera incomodidad adicional (p. ej., un nivel más de autenticación) hasta la imposibilidad de realizarla (la transacción simplemente no se permite). El radio de impacto se refiere a si también se verán afectadas otras transacciones independientes y, en tal caso, cuántas. Por ejemplo, bloquear a un usuario concreto solo afectará a ese usuario, pero detener un servicio de registro afectará a la capacidad de auditar a todos los usuarios y todas las transacciones. - ¿Qué grado de certeza hay de que la transacción sea maliciosa?
Aumentar el grado de certeza suele implicar recopilar más datos y correlacionar información de más fuentes, dos tareas que requieren tiempo, por lo que, en la práctica, este dilema suele reducirse a: «¿Cuánto tiempo debo observar antes de decidirme a actuar?»
Así pues, aunque una estrategia de confianza cero debe asumir que se producirán brechas de seguridad, un enfoque bien planteado sopesará los riesgos y los beneficios de aplicar medidas correctivas a las transacciones permitidas que parezcan sospechosas. Esta evaluación tendrá en cuenta el nivel de riesgo de las distintas transacciones de las aplicaciones y las consecuencias de aplicar medidas correctivas, que solo se adoptarán si el nivel de riesgo supera el beneficio empresarial esperado.
1 https://www.whitehouse.gov/wp-content/uploads/2022/01/M-22-09.pdf
2 https://csrc.nist.gov/publications/detail/sp/800-207/final
3 https://www.cisa.gov/zero-trust-maturity-model
4 https://media.defense.gov/2021/Feb/25/2002588479/-1/-1/0/CSI_EMBRACING_ZT_SECURITY_MODEL_UOO115131-21.PDF
5 https://dodcio.defense.gov/Portals/0/Documents/Library/(U)ZT_RA_v1.1(U)_Mar21.pdf
6 https://dodcio.defense.gov/Portals/0/Documents/Library/(U)ZT_RA_v1.1(U)_Mar21.pdf
7 La planificación previa comienza en la fase de diseño, como se describe más adelante.
8 O, al menos, el conjunto de interacciones que se consideran «adecuadas» y que el sistema parece requerir. Siempre existe el riesgo de que el conjunto de interacciones identificado mediante la observación esté incompleto o presente algún riesgo preexistente. Por tanto, siempre es preferible planificar de antemano durante el diseño.
PUBLICADO EL 4 DE MAYO DE 2022