Acteurs de passerelle distribuée : l’évolution de la gestion des API
Par Rajesh Narayanan
Relu et enrichi par : Ian Smith, Sam Bisbee, Andrew Stiefel, Lori MacVittie, Mike Wiley et d’autres contributeurs.
Avis du bureau du CTO de F5
L’équipe de l’Office of the CTO de F5 explore depuis plus d’un an le domaine technologique lié aux API. Ce nouveau livre blanc s’inscrit dans la continuité de nos efforts visant à mieux comprendre l’écosystème des API, en constante évolution.
Les difficultés que nous avons décrites concernant la gestion de la prolifération des API entraîneront des difficultés liées à la prolifération des passerelles d’API. Les approches traditionnelles ne suffiront pas à les résoudre. Si les technologies de graphes telles que GraphQL sont très prometteuses pour maîtriser la complexité associée aux API, elles ne constituent qu’une partie de la solution, car les difficultés vont au-delà de la connectivité, de la sécurité et du routage. Forte de près de trente ans d’expertise dans la mise à l’échelle des systèmes et des applications, l’approche adéquate repose sur une architecture distribuée — et non fédérée — qui utilise GraphQL sans pour autant en dépendre exclusivement.
Ce livre blanc explore une approche architecturale distribuée visant à relever les défis liés à la prolifération des passerelles d’API.
Résumé
L’économie numérique reposera sur les API, donnant ainsi naissance à une économie pilotée par les API. À la suite du livre blanc sur la prolifération des API, nous avons cherché à comprendre comment éliminer ou atténuer les effets de la prolifération des API. Si GraphQL semblait prometteur pour en limiter les conséquences, il tend toutefois à faire peser sur les développeurs la responsabilité de réécrire une grande partie du code de leurs API. Une nouvelle approche de GraphQL met cependant en avant sa capacité à être utilisé comme un acteur de passerelle efficace. L’acteur de passerelle est une fonction ou un processus créé à proximité du client et qui lance une requête API. Il fait office de passerelle API initiale sur laquelle aboutit la requête. Il peut également être éphémère et être supprimé une fois la requête traitée.
Outre le fait que les développeurs et les équipes d’exploitation privilégient la gestion des API plutôt que les passerelles API, nous avons également constaté le problème de la prolifération des passerelles API due à la prolifération des API. Du point de vue des développeurs, la principale préoccupation est de s’assurer que l’API fonctionne correctement et dans les délais impartis. En revanche, l’équipe d’exploitation se concentre davantage sur des aspects tels que la découverte, la sécurité, la facilité d’utilisation et les contrôles d’accès. Les passerelles API constituant aujourd’hui un composant essentiel de l’infrastructure des API, il est devenu évident que la prolifération des API entraîne une multiplication des déploiements de passerelles API, ce qui conduit à leur prolifération.
L’architecture des API doit évoluer pour s’adapter à leur prolifération, tout en simplifiant le déploiement et les opérations. L’architecture proposée représente la prochaine étape de l’évolution des modèles de conception des passerelles d’API. Bien que GraphQL ne soit ni au cœur de cette architecture ni indispensable, il peut améliorer le modèle d’acteur de passerelle.
Résumé
L’écosystème de gestion des API doit abandonner la gestion de passerelles API monolithiques au profit d’une approche plus moderne de la conception des systèmes. Il gagnera ainsi en agilité et en efficacité.
“Nous sommes à un tournant dans l’architecture des API, car les passerelles API traditionnelles ne suffisent plus à gérer l’ampleur et la complexité de l’écosystème émergent des API.”
Prolifération des passerelles API – Gérer les monolithes distribués
La prolifération des API, qui constitue déjà un défi au sein de l’économie des API, entraîne également une prolifération des passerelles API, une situation dans laquelle la gestion des API devient incontrôlable en raison de la diversité des technologies proposées par les fournisseurs de passerelles API et des partis pris des équipes qui les gèrent. Nous sommes à un tournant dans l’architecture des API, car la passerelle API traditionnelle (API-GW) — une couche logicielle dédiée qui sert de point d’entrée aux appels d’API — ne suffit plus à gérer l’ampleur et la complexité de l’écosystème émergent des API.
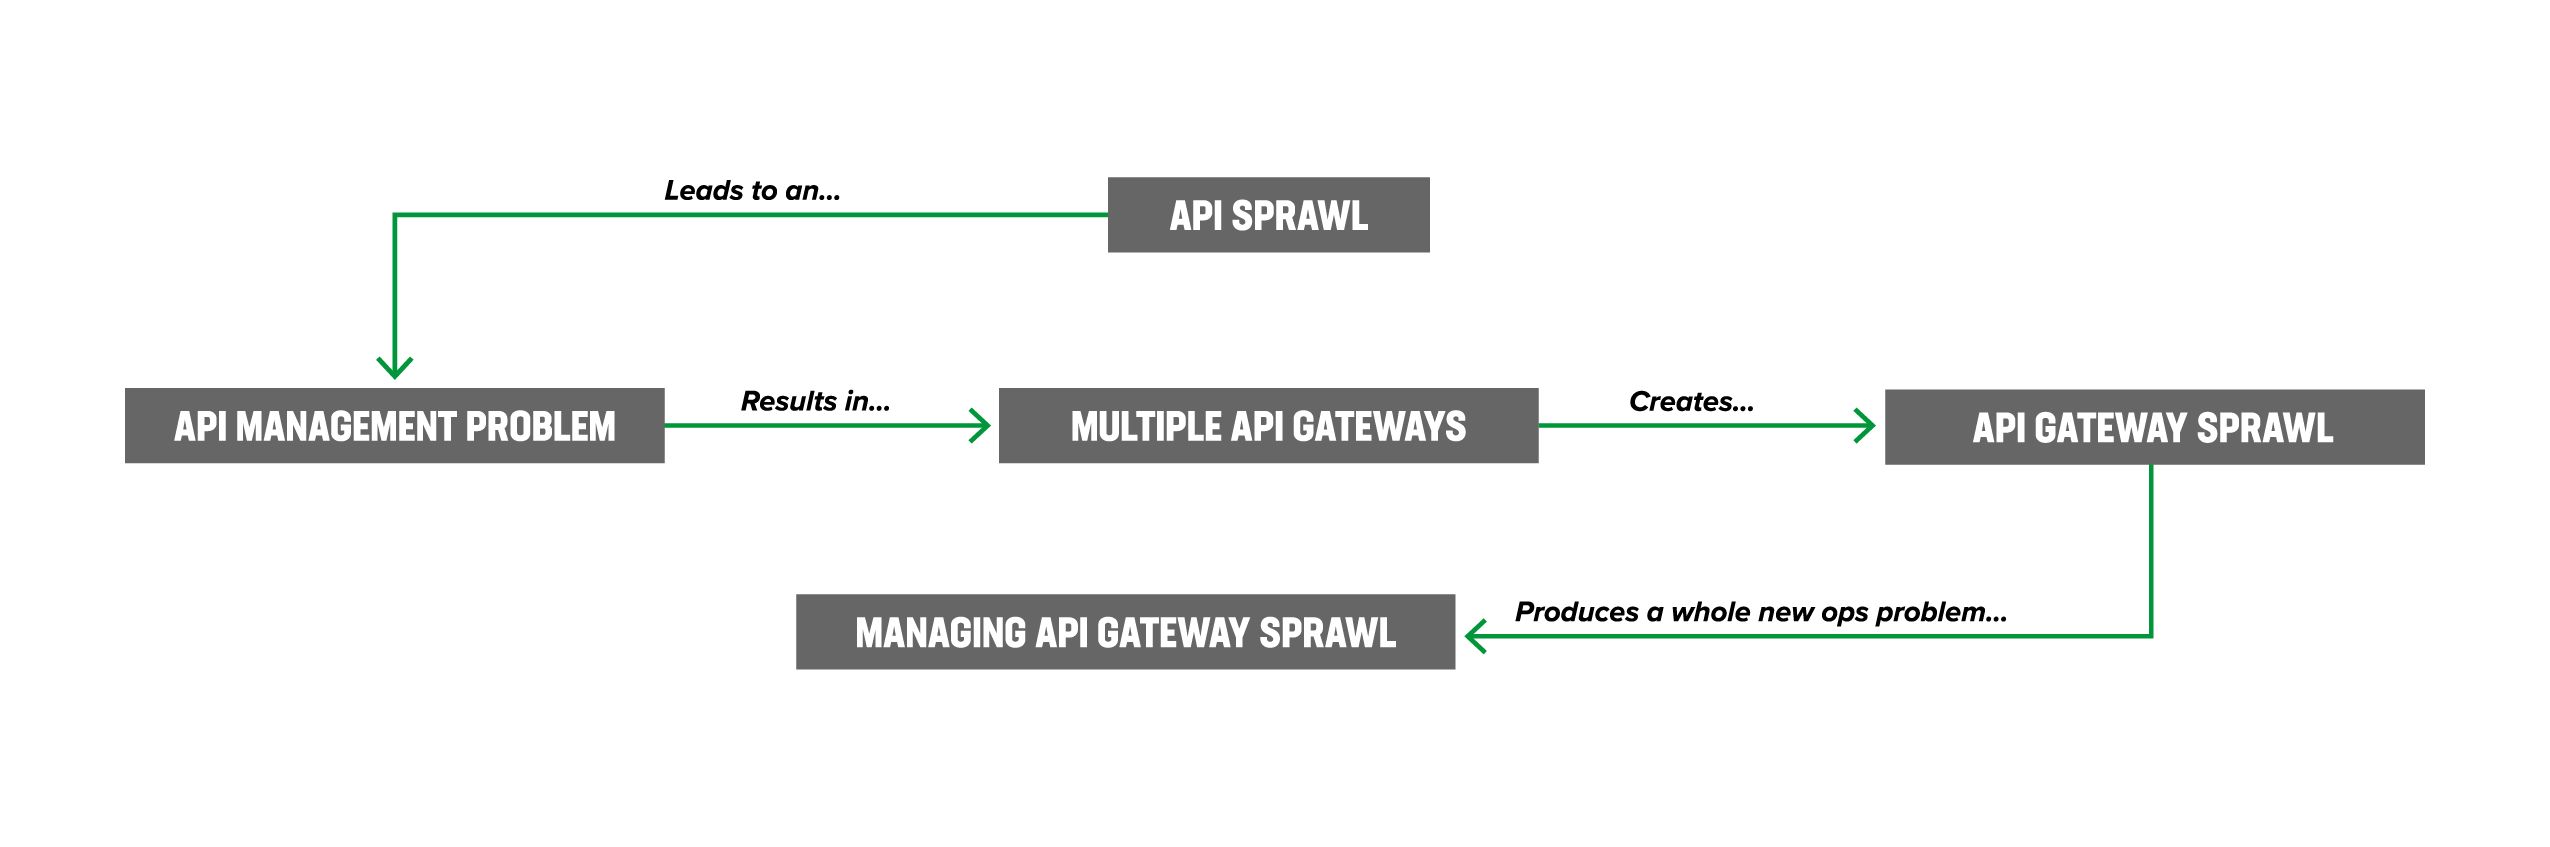
La figure 1 illustre comment nous sommes passés de la gestion de la prolifération des API à celle de la prolifération des passerelles d’API.
Le modèle de conception ci-dessus évoque un plan de contrôle centralisé, les passerelles d’API constituant le plan de données distribué, comme illustré à la figure 2.
Les passerelles d’API sont un composant essentiel des architectures logicielles modernes, car elles offrent un point centralisé de contrôle et de sécurisation des API. Cependant, à mesure que le nombre de fonctionnalités proposées par ces passerelles a augmenté, celles-ci sont devenues de plus en plus complexes et difficiles à gérer. Dans de nombreux cas, elles ont évolué vers des systèmes monolithiques regroupant un large éventail de fonctionnalités au sein d’une solution unique.
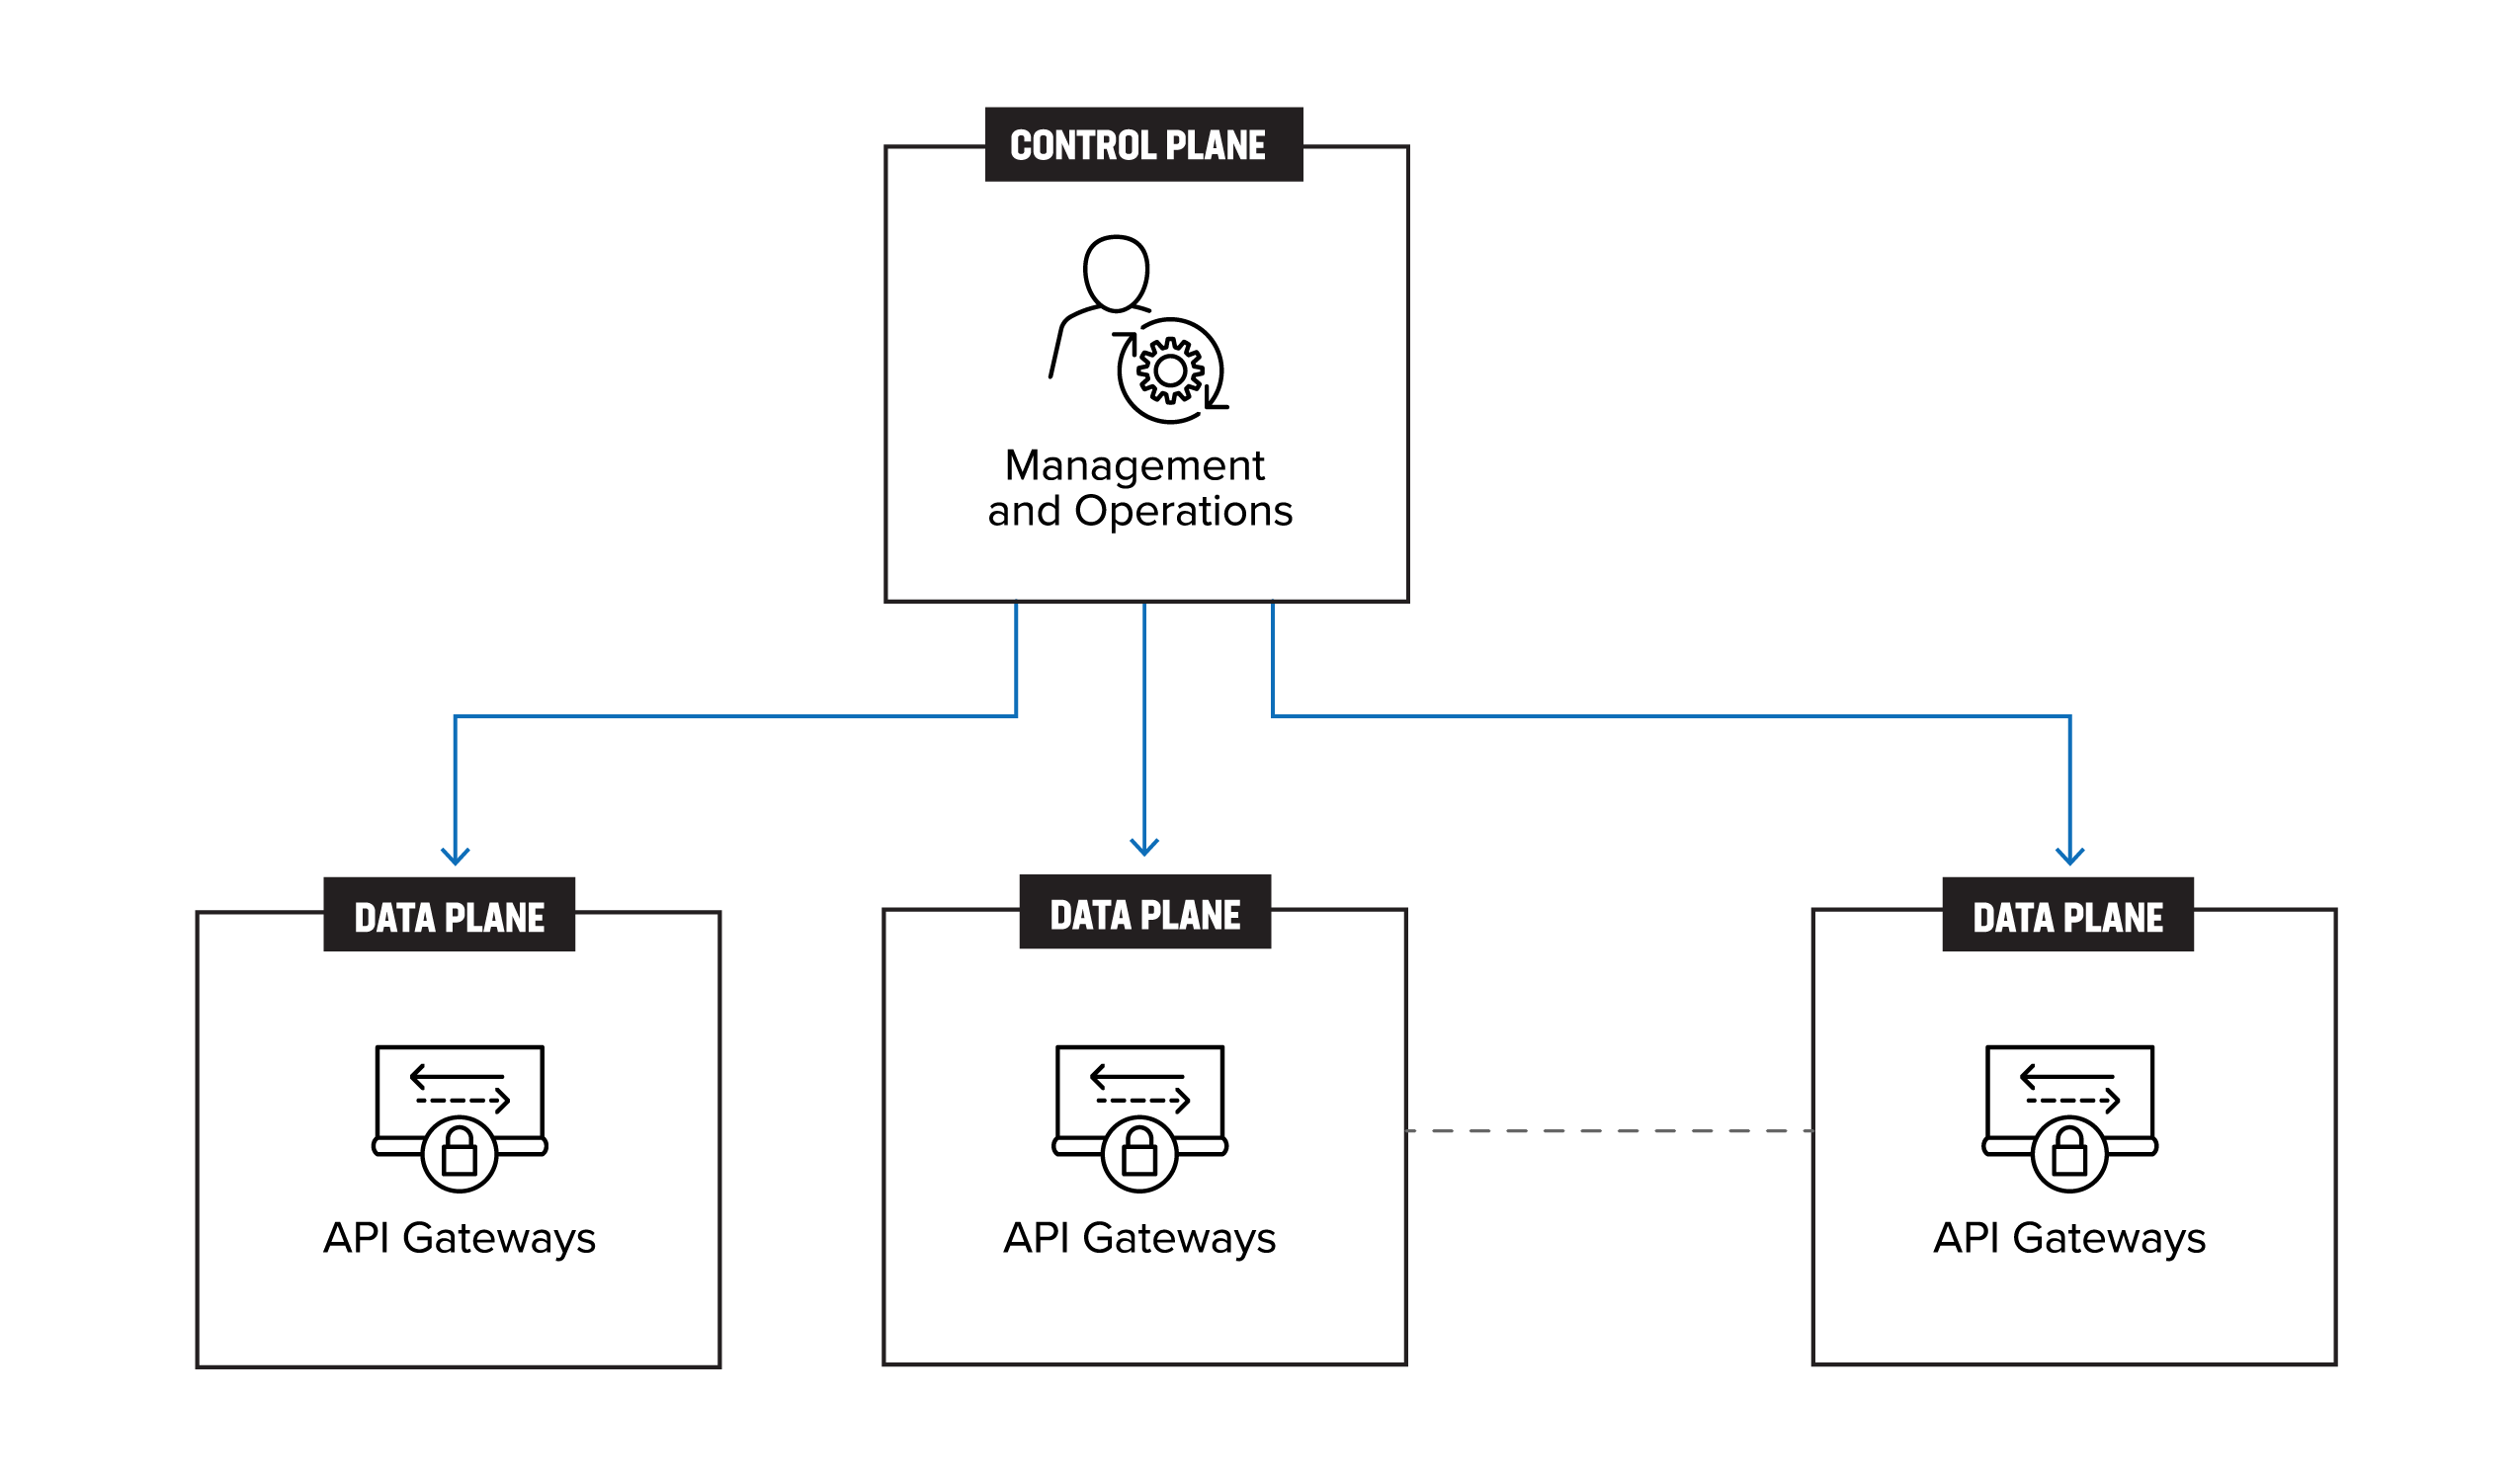
Bien que la gestion de plusieurs passerelles puisse donner l’impression d’une architecture distribuée, elle est en réalité loin de constituer une véritable distribution. En effet, les passerelles restent étroitement couplées et partagent des ressources et des configurations difficiles à dissocier. Par conséquent, de nombreuses entreprises finissent par gérer des monolithes distribués, avec tous les défis que cela implique.
Architectures de passerelles API traditionnelles
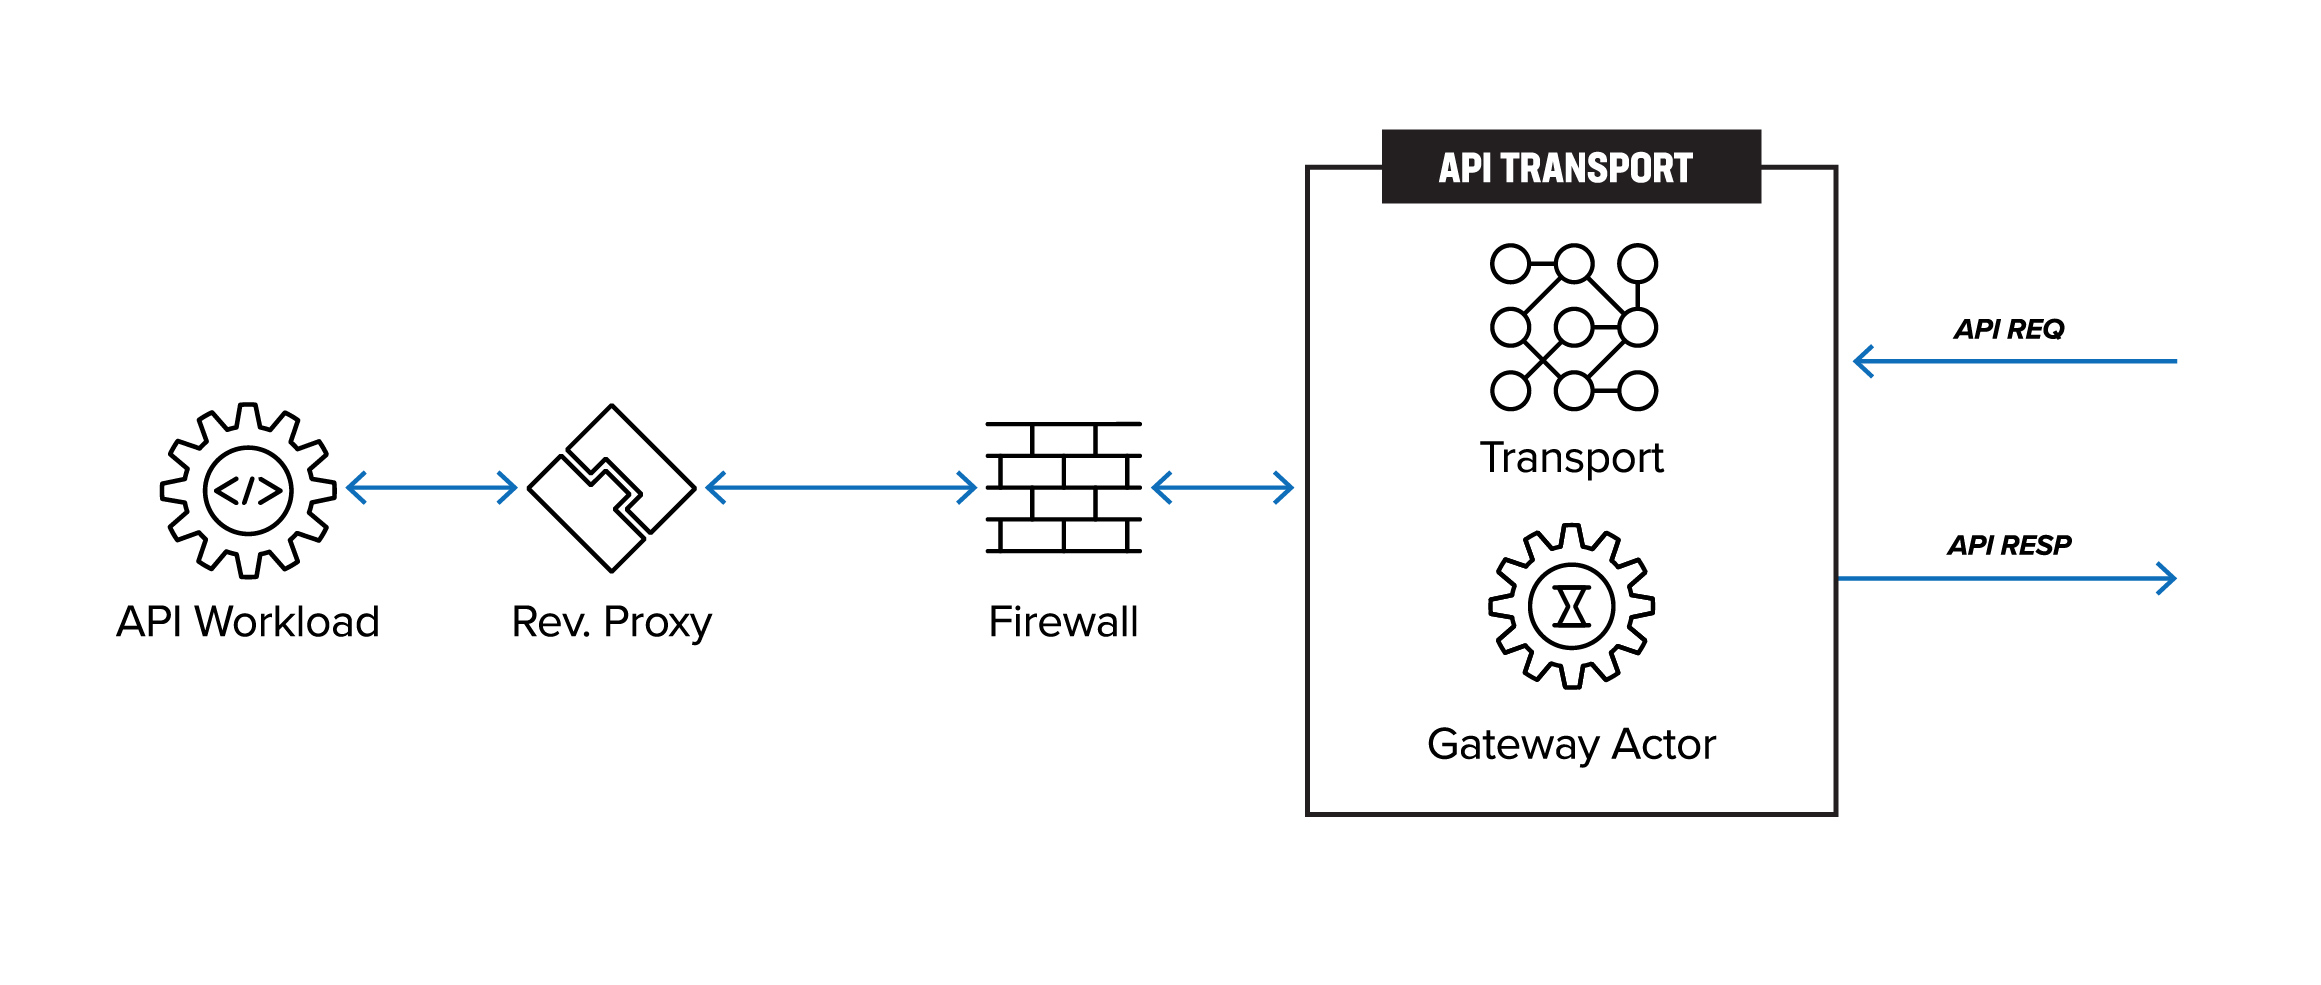
La figure 3 présente l’architecture des passerelles d’API existantes. Les requêtes API provenant du client sont d’abord transmises via un réseau partagé ou dédié et traversent un pare-feu avant d’atteindre la passerelle d’API. Celle-ci, qui fait office de proxy inverse, achemine ensuite le trafic vers la charge de travail de l’API.
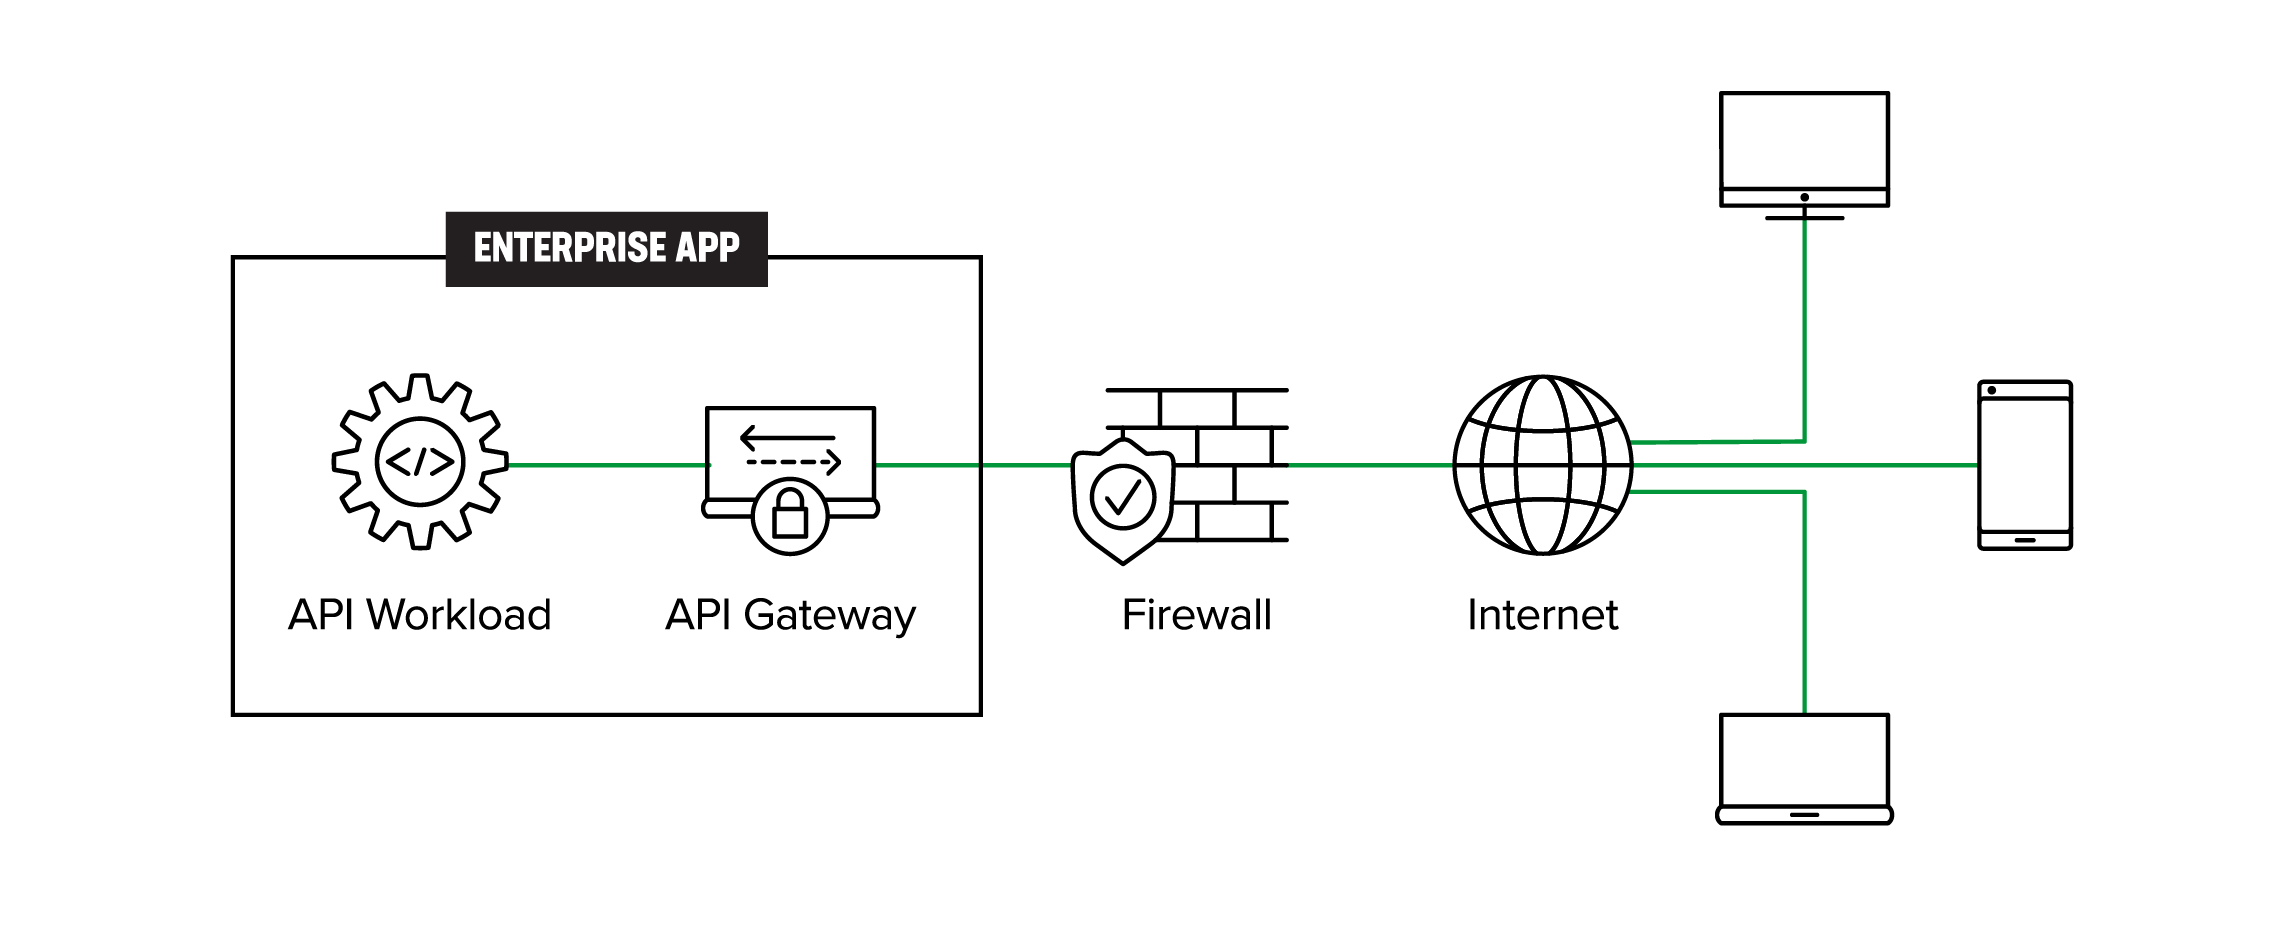
La passerelle d’API (API-GW) traditionnelle devient un goulet d’étranglement pour la gestion des API lorsque des passerelles d’API sont déployées dans toute l’entreprise, ou lorsque les charges de travail des API sont déplacées, sur le plan opérationnel, entre différentes régions, zones ou plusieurs clouds, voire vers la périphérie, dans un contexte de prolifération des API. Plusieurs API-GW sont mises en place par différentes équipes sans point unique de gestion et de contrôle à l’échelle de l’entreprise. Si un service d’API ou un groupe de services d’API est transféré vers une autre infrastructure (cloud ou autre), l’équipe d’exploitation doit disposer d’une méthode permettant de migrer tous les aspects de la gestion des API : enregistrement, découverte, authentification, mise en réseau, sécurité et politiques de gouvernance, de gestion des risques et de conformité (GRC).
L’architecture représentée dans la figure 3 n’est donc ni évolutive ni viable à long terme, car elle conduit progressivement à devoir gérer des monolithes distribués (figure 2).
Deux problèmes sont à l’origine du goulet d’étranglement que constitue la passerelle d’API : (1) la multiplication des fournisseurs de passerelles d’API et (2) la nécessité d’adapter progressivement l’échelle à mesure qu’une entreprise exécute davantage d’applications dans un nombre croissant d’environnements.
- Prolifération des fournisseurs de passerelles API : La gestion de la prolifération des fournisseurs de passerelles API constitue un défi humain, car il peut être difficile de convaincre toutes les équipes d’adopter un fournisseur unique, et la migration vers un nouveau fournisseur peut s’avérer fastidieuse. Par conséquent, les organisations consacrent du temps et des ressources à la gestion de plusieurs fournisseurs de passerelles. Bien qu’il soit possible de remédier à ce problème, cela n’est pas toujours réalisable dans la pratique.
- Mise à l’échelle des applications : La mise à l’échelle des applications devient problématique lorsqu’une application doit prendre en charge davantage d’utilisateurs sur un même site ou être déployée sur plusieurs sites. Elle doit alors évoluer horizontalement ou verticalement. Toutefois, à mesure que l’application évolue, les passerelles API doivent elles aussi être mises à l’échelle et, dans certains cas, être déployées sur plusieurs sites afin de répondre aux besoins de mise à l’échelle imposés par les modèles d’architecture actuels. La gestion opérationnelle des passerelles API peut ainsi devenir complexe.
Solution : un modèle d’acteur de passerelle distribuée
La figure 4 illustre un modèle d’acteurs de passerelle distribués visant à limiter la prolifération des passerelles d’API. Bien que le modèle distribué ne soit pas nouveau en soi, ce document le formalise dans le contexte des passerelles d’API. Les clients lancent la requête API. Les acteurs de passerelle distribués sont éphémères et instanciés à la demande, aussi près que possible du client. Il incombe alors à la couche de transport de l’API d’acheminer la requête API de l’acteur de passerelle vers la passerelle d’API simplifiée, qui la dirige ensuite vers la charge de travail API appropriée. Bien que la prise en charge de GraphQL par les acteurs distribués relève davantage d’un détail que d’une condition nécessaire au fonctionnement de ce modèle, elle permet néanmoins de proposer des fonctionnalités telles que l’orchestration de services. Ainsi, au lieu de créer une nouvelle couche d’orchestration de services, GraphQL pourrait assurer cette fonction.
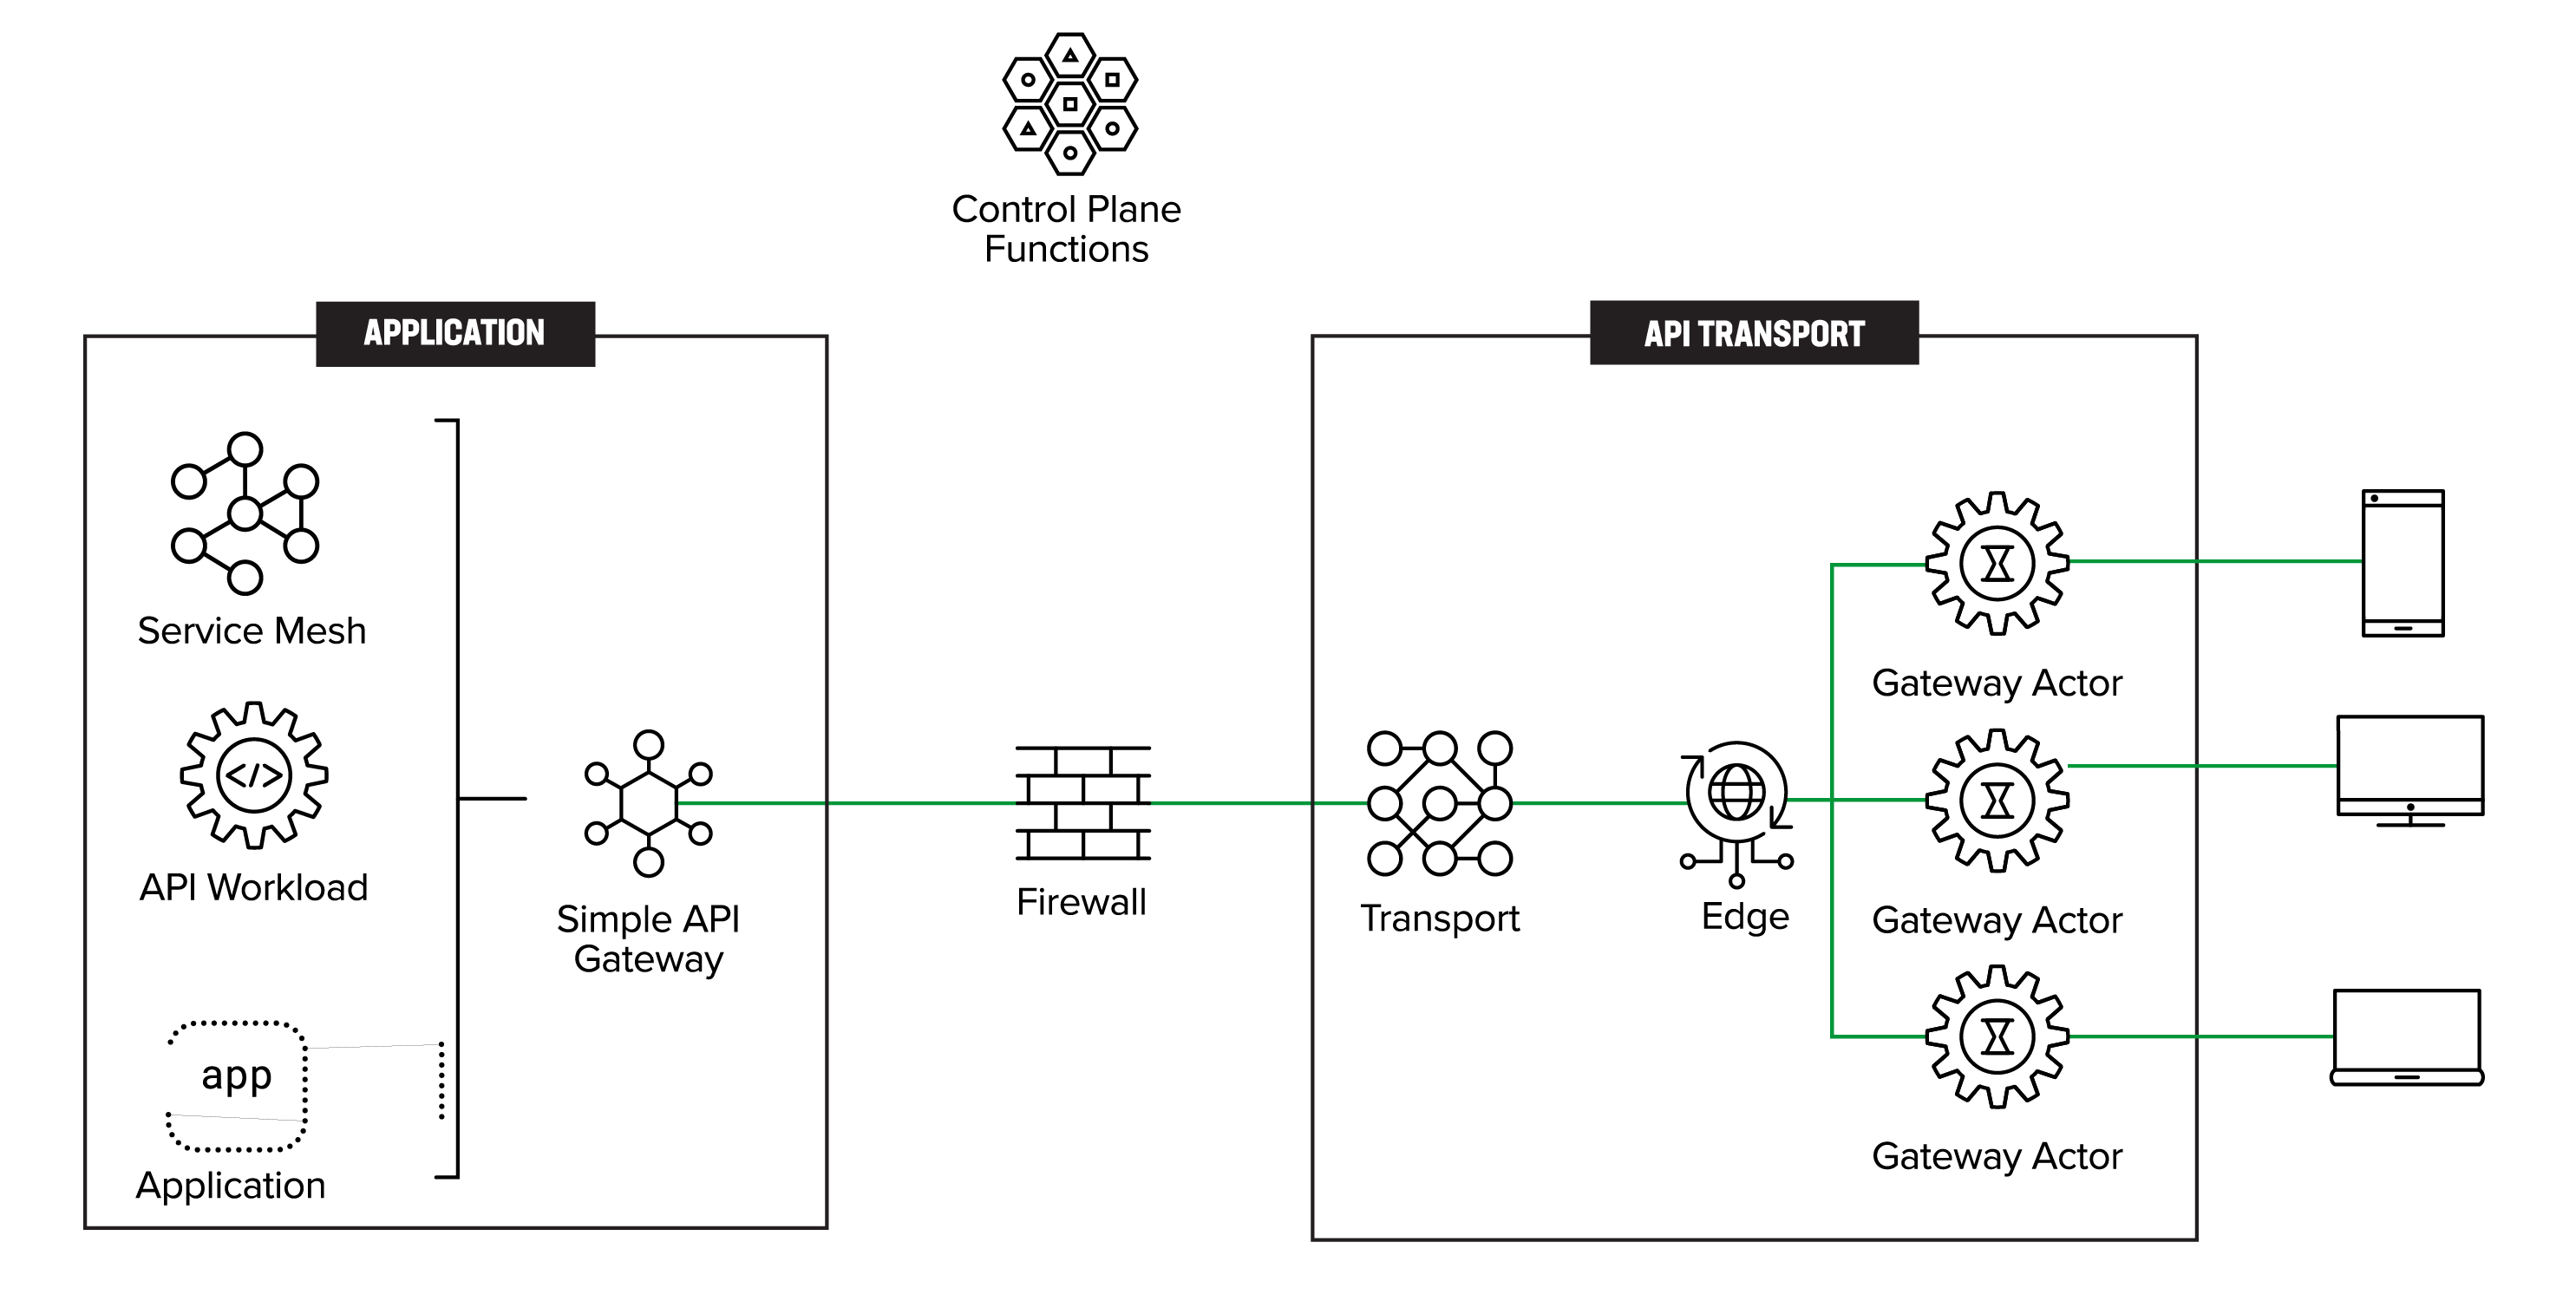
Pour clarifier, le trafic circule de droite à gauche. Autrement dit, les clients se trouvent à droite et les requêtes API sont initiées par le client, comme illustré à la figure 5.
Un nouveau modèle de déploiement émerge, reposant sur des acteurs de passerelle afin de remplacer les passerelles d’API ou de réduire la dépendance excessive à leur égard pour gérer les API au sein d’une entreprise et entre plusieurs entreprises. Bien que GraphQL ne soit pas indispensable à cette architecture, son introduction arrive à point nommé, car l’acteur de passerelle constitue le vecteur idéal pour prendre en charge GraphQL.
“Un nouveau modèle de déploiement émerge, qui utilise des acteurs de passerelle afin de remplacer les passerelles d’API ou de réduire la dépendance excessive à leur égard pour gérer les API au sein d’une entreprise et entre ses différentes entités. ”
Rôle des passerelles API dans la gestion des API
Pour mieux comprendre les passerelles API, il est important d’examiner tout d’abord les différents composants d’une infrastructure moderne de gestion des API.
Infrastructure et fonctions de gestion des API
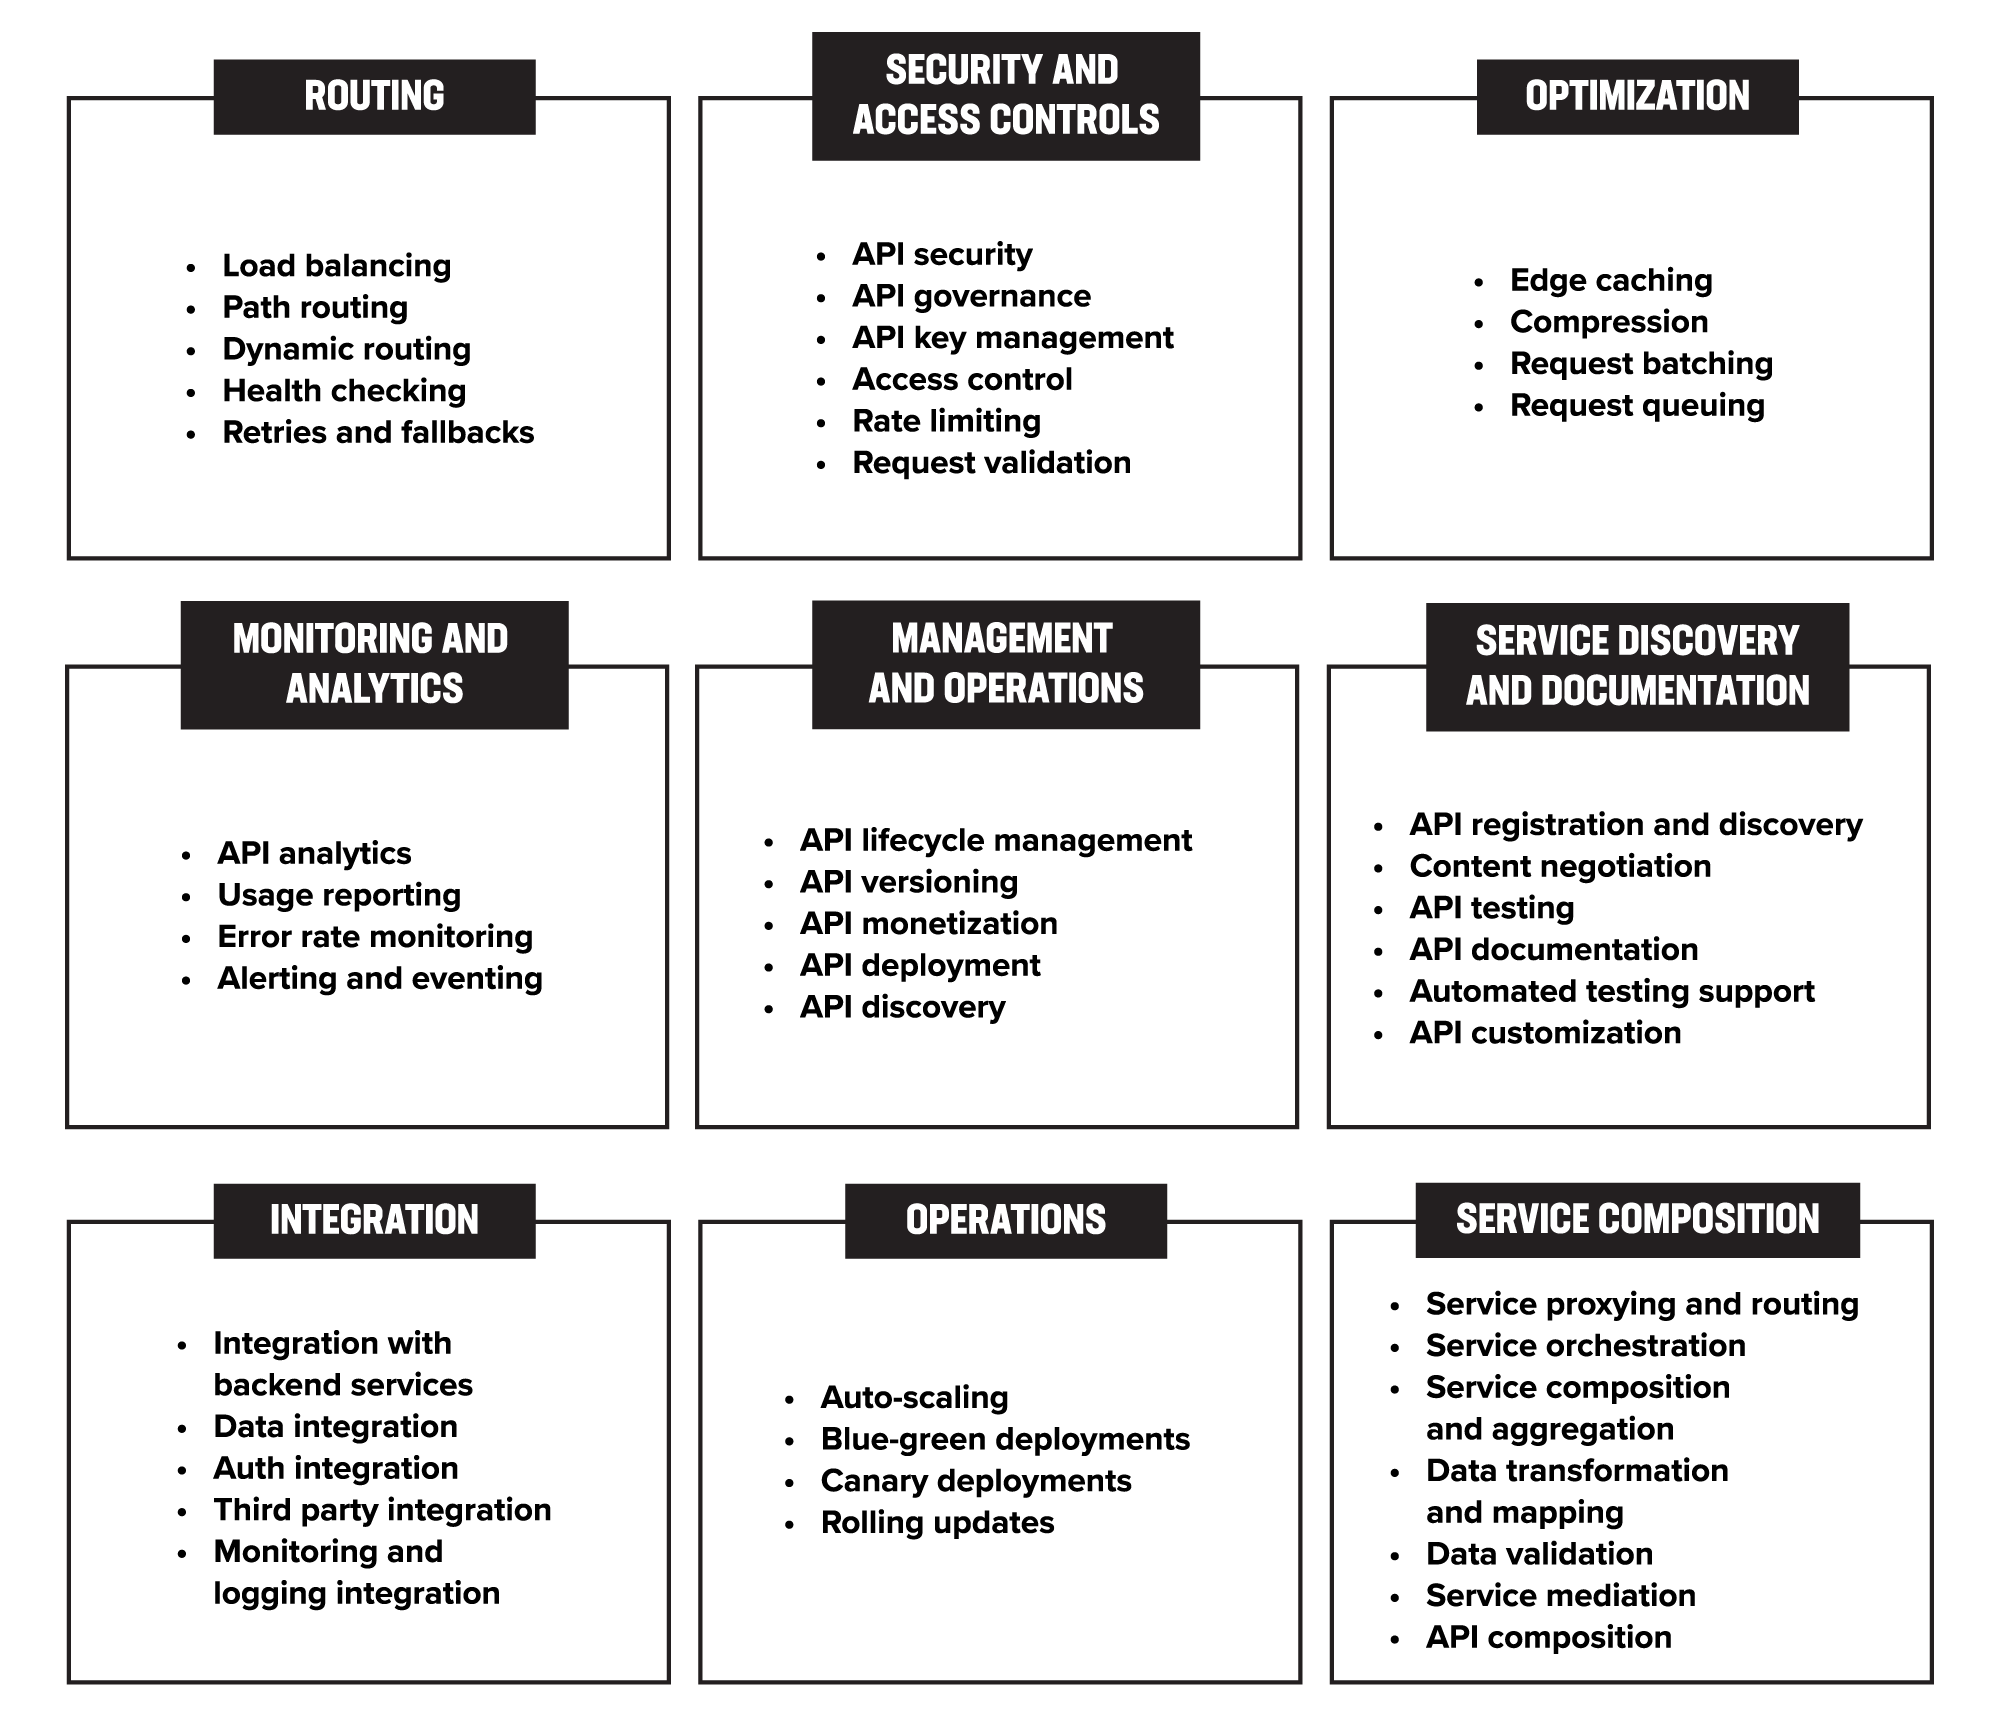
La figure 6 offre une représentation visuelle complète des différentes fonctionnalités et composantes essentielles à la gestion des API. Outre les passerelles API, nécessaires pour acheminer et gérer le trafic vers les services back-end, il existe plusieurs autres composantes d’infrastructure importantes. Il peut notamment s’agir de solutions d’authentification, de limitation du débit, de mise en cache et de maillage de services. En intégrant ces fonctionnalités, les organisations peuvent mieux maîtriser leurs API, renforcer la sécurité et optimiser les performances.
Fonctionnalités courantes des passerelles API
Examinons les fonctionnalités courantes et bien connues des passerelles API :
- Routage: achemine les requêtes vers le service backend approprié en fonction du chemin ou du contenu de la requête.
- Authentification et autorisation: authentifie et autorise les requêtes via un point d’entrée unique, afin de garantir que seuls les clients autorisés puissent accéder aux services backend.
- Limitation du débit: limite le débit auquel les clients peuvent envoyer des requêtes aux API sous-jacentes, afin d’éviter une utilisation excessive et de protéger les services backend contre les surcharges.
- Mise en cache: met en cache les réponses des API sous-jacentes, réduisant ainsi le nombre de requêtes à envoyer aux services backend et améliorant les performances.
- Traduction de protocoles : assure la traduction entre différents protocoles, tels que HTTP et WebSockets, afin de permettre aux clients d’accéder aux API sous-jacentes à l’aide de différents protocoles.
- Équilibrage de charge: Répartit les requêtes entre plusieurs services backend, améliorant ainsi l’évolutivité et la fiabilité.
- Sécurité : Gère les tâches de sécurité, telles que le chiffrement et le déchiffrement, afin de garantir la transmission sécurisée des données.
- Analyse et surveillance : Suit et consigne les indicateurs d’utilisation et les informations sur les erreurs, offrant ainsi une visibilité sur la manière dont le système est utilisé et aidant à identifier les goulots d’étranglement en matière de performances ainsi que les erreurs.
- Gestion des versions: gère la gestion des versions des API sous-jacentes, permettant aux clients d’accéder à différentes versions de l’API en fonction de leurs besoins.
- Découverte de services: détecte les services backend disponibles et achemine dynamiquement les requêtes vers ceux-ci, permettant ainsi une découverte de services plus dynamique et plus flexible.
Contexte : gros plan sur les passerelles API
Après avoir analysé les fonctionnalités de l’infrastructure de gestion des API, nous avons constaté qu’il était nécessaire de mieux comprendre le rôle des passerelles API et d’étudier des solutions alternatives à l’architecture monolithique actuelle de ces passerelles.
L’augmentation du nombre d’API entraîne déjà leur prolifération ainsi que celle des passerelles d’API. Parallèlement, un nombre croissant de clients deviennent mobiles ou fortement distribués, tandis que l’infrastructure de calcul est désormais disponible partout, y compris en périphérie. Nous avons donc besoin d’une approche capable d’améliorer l’agilité, la flexibilité, l’évolutivité, les performances et la sécurité de l’écosystème des API.
Cette nouvelle approche nécessite une conception rationalisée capable de tirer pleinement parti des avantages d’une architecture véritablement distribuée.
Passerelles API
Nous analysons plus en détail les fonctionnalités et le périmètre d’une passerelle API afin d’en faire ressortir les subtilités et les limites.
Une passerelle API est un composant essentiel des infrastructures actuelles de gestion des API. Fondamentalement, elle fait office de proxy inverse : elle sert d’intermédiaire entre les clients et les services backend tout en effectuant diverses opérations sur les requêtes entrantes. Par exemple, elle peut assurer l’authentification, limiter le débit, acheminer les requêtes, appliquer des politiques de sécurité, effectuer une surveillance et gérer le versionnement avant de transmettre la requête au service backend approprié. Une fois que ce dernier a traité la requête et renvoyé une réponse, la passerelle API peut effectuer des opérations telles que la mise en cache, la traduction de protocoles et le traitement de la réponse avant de la transmettre au client.
Avec la multiplication des API, les passerelles d’API ont évolué pour intégrer diverses fonctionnalités allant au-delà du simple routage, devenant ainsi de véritables systèmes monolithiques. Elles prennent désormais en charge des tâches telles que l’authentification et la limitation du débit afin d’améliorer les performances et de réduire la charge pesant sur les services backend. Toutefois, malgré ces fonctionnalités étendues, les passerelles d’API restent un point d’accès unique aux services backend, ce qui peut poser problème dans les environnements fortement distribués.
En particulier, l’essor des infrastructures cloud, multicloud hybrides et edge a rendu plus difficile le maintien de l’agilité, de la sécurité et de la facilité de gestion avec une approche reposant sur une passerelle API. Les clients, les appareils et les charges de travail applicatives pouvant être répartis sur un large éventail d’emplacements, une passerelle API n’est pas nécessairement adaptée pour fournir le niveau requis d’architecture compatible avec l’edge.
Défis liés aux passerelles API
Comme elles prennent en charge un large éventail de tâches et doivent s’intégrer à de multiples systèmes, les passerelles API sont généralement difficiles à déployer et à gérer. Bien que leur gestion puisse être complexe, elle reste essentielle pour garantir la disponibilité, la sécurité et l’évolutivité d’une API. Les entreprises ont tendance à utiliser des outils spécialisés, tels que des plateformes de gestion des API, afin de gérer et de surveiller plus efficacement leurs passerelles API.
La liste ci-dessous n’est pas exhaustive, mais voici quelques-uns des facteurs qui contribuent à la complexité des passerelles API :
- Gestion de la configuration: les passerelles API proposent souvent un large éventail d’options et de paramètres de configuration qui doivent être gérés et maintenus, tels que les règles de routage, la limitation du débit et les paramètres de sécurité. La gestion de ces paramètres peut s’avérer complexe et chronophage, en particulier à mesure que le nombre d’API sous-jacentes et de clients augmente.
- Intégration avec d’autres systèmes: les passerelles doivent s’intégrer à un large éventail d’autres systèmes, tels que les systèmes d’authentification et d’autorisation, les répartiteurs de charge et les bases de données. Cette intégration peut s’avérer complexe, notamment lorsque les systèmes sous-jacents sont mal intégrés ou que la passerelle API doit prendre en charge plusieurs protocoles ou formats de données. La situation devient encore plus problématique lorsqu’une entreprise utilise plusieurs déploiements de passerelles API provenant de différents fournisseurs.
- Évolutivité et disponibilité: les passerelles d’API doivent être capables de traiter un grand nombre de requêtes et de garantir une haute disponibilité, ce qui peut être complexe à gérer, en particulier lorsqu’il faut prendre en charge un grand nombre de services back-end et de clients.
- Sécurité: en tant que composants essentiels de la sécurité des API, les passerelles API doivent être configurées et gérées de manière à protéger les données sensibles et à contrôler les accès. Cette tâche peut s’avérer complexe et nécessite une surveillance et une gestion continues.
- Gestion des versions: À mesure que le nombre d’API sous-jacentes et de clients augmente, il peut devenir de plus en plus difficile de gérer les différentes versions de l’API et de s’assurer que les clients accèdent à la bonne version.
- Surveillance et dépannage: les passerelles d’API peuvent collecter et générer de grandes quantités de données. Dans une grande entreprise, elles peuvent être réparties sur de nombreux sites, ce qui complique la mise en corrélation des événements affectant l’état de santé global de l’application et le dépannage des problèmes.
Prolifération des passerelles API
La prolifération des passerelles API désigne la multiplication de passerelles API indépendantes au sein d’une organisation. Les différentes équipes ou unités opérationnelles créent souvent leurs propres API, ce qui peut entraîner la mise en place de plusieurs passerelles API indépendantes pour gérer ces différentes API. Les équipes peuvent également utiliser des passerelles API provenant de différents fournisseurs ou reposant sur différentes solutions afin de gérer différents types d’API.
Cela conduit au déploiement de plusieurs passerelles d’API, chacune offrant un ensemble de fonctionnalités différent.
La prolifération des passerelles API engendre plusieurs difficultés supplémentaires :
- Mise à l’échelle de la gestion des passerelles API : la présence de plusieurs passerelles API indépendantes peut compliquer leur gestion et leur maintenance, en particulier à mesure que le nombre d’API sous-jacentes et de clients augmente.
- Inefficacités du trafic est-ouest: la présence de plusieurs passerelles peut contraindre les requêtes à transiter par plusieurs d’entre elles, ce qui augmente la latence et réduit les performances.
- Uniformité des politiques de sécurité : la gestion de plusieurs passerelles peut s’avérer difficile et entraîner des politiques de sécurité incohérentes, ce qui complique la protection des données sensibles et le contrôle des accès.
- Gouvernance standardisée: Avec plusieurs passerelles, il peut être difficile de s’assurer que toutes les API sont correctement gouvernées et respectent les normes et les bonnes pratiques.
- Coûts accrus: L’utilisation de plusieurs passerelles peut entraîner une hausse des coûts liés à l’infrastructure, aux ressources de développement et à la maintenance.
- Difficultés d’intégration accrues: La présence de plusieurs passerelles complique l’intégration avec d’autres systèmes et technologies, tels que d’autres bases de données, des entrepôts de données et des outils d’analyse de données.
Les entreprises doivent s’efforcer de centraliser la gestion et la gouvernance de leurs API et d’utiliser un seul type de passerelle API. Bien que cela permette d’atténuer les difficultés susmentionnées liées à la prolifération des passerelles API, la mise en place d’une stratégie homogène en la matière est loin d’être simple.
Défis liés à la standardisation des passerelles API au sein d’une entreprise
À mesure que les entreprises se développent de manière organique ou par le biais d’acquisitions, les équipes internes rattachées à des unités opérationnelles spécifiques peuvent être en désaccord lors du choix d’une technologie ou d’un fournisseur de passerelle API. Cela peut notamment s’expliquer par les raisons suivantes :
- Technologie: les différentes équipes ou unités opérationnelles utilisent des piles technologiques différentes ou privilégient des solutions de passerelle API différentes, ce qui complique la standardisation autour d’un seul type de passerelle.
- Systèmes existants: certaines équipes disposent de systèmes existants qui ont été conçus avec un autre type de passerelle API. Il serait difficile de remplacer ces systèmes par une nouvelle passerelle, surtout s’ils sont toujours utilisés.
- Personnalisation: certaines équipes personnalisent leurs passerelles d’API existantes pour répondre à des exigences spécifiques et auront du mal à reproduire ces personnalisations sur une nouvelle passerelle.
- Coût de remplacement: le remplacement des passerelles d’API existantes par une nouvelle passerelle standardisée peut s’avérer coûteux, tant en matière de développement que de maintenance.
- Formation des développeurs: Les équipes ont des niveaux d’expertise variables et peuvent avoir besoin de se familiariser avec une nouvelle technologie de passerelle proposée par un autre fournisseur, ou de suivre une formation à son utilisation — un processus qui peut être à la fois long et coûteux.
- Ressources limitées: Les organisations disposent de ressources limitées en matière de développeurs, de budget et de temps pour effectuer ce changement, ce qui complique la mise en œuvre d’une nouvelle passerelle.
- Dépendances des applications: les différentes équipes ou unités opérationnelles dépendent de leurs passerelles existantes de diverses manières, notamment en raison de leur intégration à des systèmes spécifiques ou d’autres intégrations personnalisées, ce qui complique le passage à une nouvelle passerelle.
- Solutions tierces: Les équipes qui utilisent des solutions tierces intégrées à la passerelle auront des difficultés à migrer vers une nouvelle solution qui ne prend pas en charge ces solutions tierces.
Ainsi, si une application existante est gérée par une équipe bien établie ayant des convictions bien arrêtées, celle-ci ne souhaitera pas adopter un autre modèle de déploiement afin de ne pas perturber son service.
Nous pouvons donc conclure qu’une nouvelle approche est nécessaire, qui tienne compte des nombreuses limites de l’infrastructure d’API existante, tout en soulignant que la prolifération des passerelles d’API constitue l’un des principaux enjeux.
Considérations de conception
La liste suivante n’est pas exhaustive, mais résume certaines des principales considérations de conception qui, selon nous, devraient être prises en compte lors de l’élaboration de la solution :
- Coexister avec les déploiements actuels : Alors que les organisations s’efforcent de suivre l’évolution constante du paysage technologique, il est courant que les entreprises disposent de divers déploiements de passerelles API. Il n’est pas envisageable de remplacer intégralement l’infrastructure API existante, car cela risquerait de perturber des activités critiques. Tout nouveau déploiement doit donc être conçu de manière à pouvoir coexister avec l’architecture actuellement en place.
- Standardiser les fonctions de la passerelle API: l’objectif principal de la stratégie API d’une entreprise doit être de standardiser les fonctionnalités de sa passerelle API, ce qui peut s’avérer complexe en raison de la diversité des API et des besoins variables des différentes unités opérationnelles. Cette standardisation est néanmoins essentielle pour créer une infrastructure stable et sécurisée capable d’accompagner la transformation numérique de l’entreprise.
- Tirer parti des déploiements en périphérie : L’infrastructure en périphérie peut non seulement accroître de manière exponentielle le nombre d’API, mais elle permet également aux entreprises de rapprocher leurs composants de passerelle de la périphérie. En effet, l’infrastructure utilisée pour créer des API peut également servir à créer des composants de passerelle distribués. La solution doit donc tirer pleinement parti de la proximité entre l’infrastructure en périphérie et les clients à l’origine des requêtes API.
- Indépendance vis-à-vis du transport : Lors de la mise en œuvre d’une architecture d’acteurs de passerelle distribués, il est essentiel de veiller à ce qu’elle ne dépende d’aucun mécanisme de transport particulier. Qu’une entreprise souhaite utiliser des réseaux IP traditionnels, des réseaux superposés, des VPN ou une infrastructure de messagerie à faible latence, la solution doit être indépendante du mécanisme de transport. Cela offre une plus grande flexibilité et permet aux entreprises de choisir le mécanisme de transport le mieux adapté à leurs besoins et exigences spécifiques.
- Prise en charge de GraphQL : GraphQL est un choix de plus en plus répandu pour le développement d’API en raison de ses nombreux avantages par rapport aux API REST traditionnelles. L’un de ses principaux atouts est sa capacité à fournir un accès précis aux données, ce qui permet aux clients d’indiquer exactement les données dont ils ont besoin dans une seule requête. En outre, GraphQL peut simplifier l’agrégation de données provenant de plusieurs services, ce qui en fait une architecture adaptée à la composition et à l’orchestration des services. Cela permet de réduire la charge réseau et d’améliorer les performances, en particulier dans un système distribué où plusieurs services d’API sont sollicités pour répondre à une seule requête. Enfin, grâce à son schéma fortement typé et à son langage de requête, GraphQL peut faciliter la découverte des API et le développement côté client.
- La sécurité est un prérequis : l’objectif de conception primordial est de renforcer la posture de sécurité des API de l’entreprise. La solution pourrait prendre en charge certaines fonctionnalités, telles que l’authentification et l’autorisation des requêtes API, la mise en œuvre de contrôles d’accès et la protection contre les menaces de sécurité courantes, comme les attaques par script intersite (XSS) et par injection SQL. La nouvelle solution ne doit en aucun cas compromettre le modèle de menace existant ni le modifier au point d’altérer la surface d’attaque. En faisant de la sécurité une priorité de conception, l’architecture doit offrir un environnement plus sûr pour les communications avec les API, réduisant ainsi le risque de violations de données et d’autres incidents de sécurité.
Des exigences spécifiques peuvent être définies à partir de ces considérations de conception, que nous avons intégrées à notre solution d’acteurs de passerelle distribuée (DGA).
Acteurs de passerelle distribués
Maintenant que nous avons étudié en détail les passerelles API, nous pouvons expliquer la solution des acteurs de passerelle distribuée.
Conception des acteurs de passerelle distribuée
Le modèle de conception des acteurs de passerelle distribués (DGA) s’inspire de l’edge computing et des ressources informatiques disponibles à proximité du client. L’idée centrale consiste à distribuer massivement chaque acteur de passerelle au plus près du client et à ne le faire exister que pendant la durée de la transaction, avant de le supprimer à la fin de celle-ci.
“Le modèle de conception des acteurs de passerelle distribués (DGA) s’inspire de l’informatique en périphérie et des ressources informatiques disponibles à proximité d’un client.”
Hypothèses
Voici quelques-unes des hypothèses sur lesquelles repose cette solution.
L’edge computing est devenu plus répandu, et nous pouvons désormais trouver des ressources de calcul géographiquement plus proches du client. Les acteurs de passerelle peuvent être instanciés sur ces nœuds d’edge computing. L’objectif est de disposer d’une implémentation dans laquelle le DGA est très léger et éphémère, afin qu’il puisse être instancié sur n’importe quelle infrastructure d’edge computing.
Le transport des API est un composant essentiel de l’infrastructure, car il implique la mise en place d’un réseau entre les acteurs de passerelle et la passerelle API. Le type d’infrastructure requis dépend du fournisseur ou de l’entreprise et peut varier. Par exemple, un grand fournisseur de cloud public peut utiliser son propre réseau fédérateur pour assurer le transport des API. Une autre mise en œuvre pourrait consister en un bus de messagerie à faible latence reposant sur un réseau existant à haut débit et à faible latence au sein d’un centre de données d’entreprise.
Fonctions de la passerelle API
Pour rappel, la passerelle API est essentiellement un proxy inverse dont la fonction principale consiste à acheminer le trafic HTTP vers les charges de travail API appropriées. Cette approche est pertinente lorsque toutes les API sont regroupées au même endroit, par exemple au sein d’un réseau local sur site ou d’un cloud privé virtuel (VPC) dans une zone de disponibilité. Toutefois, à mesure que le nombre d’API augmente, qu’elles sont réparties dans une infrastructure hybride ou qu’elles deviennent simplement mobiles, cette conception de la passerelle API devient inefficace, complexe à exploiter et coûteuse.
Même si les avis peuvent diverger quant à la manière de classer toutes les fonctionnalités décrites dans la figure 6, nous pouvons convenir que l’infrastructure de gestion des API est devenue un déploiement complexe composé de nombreux éléments qui doivent être soigneusement orchestrés.
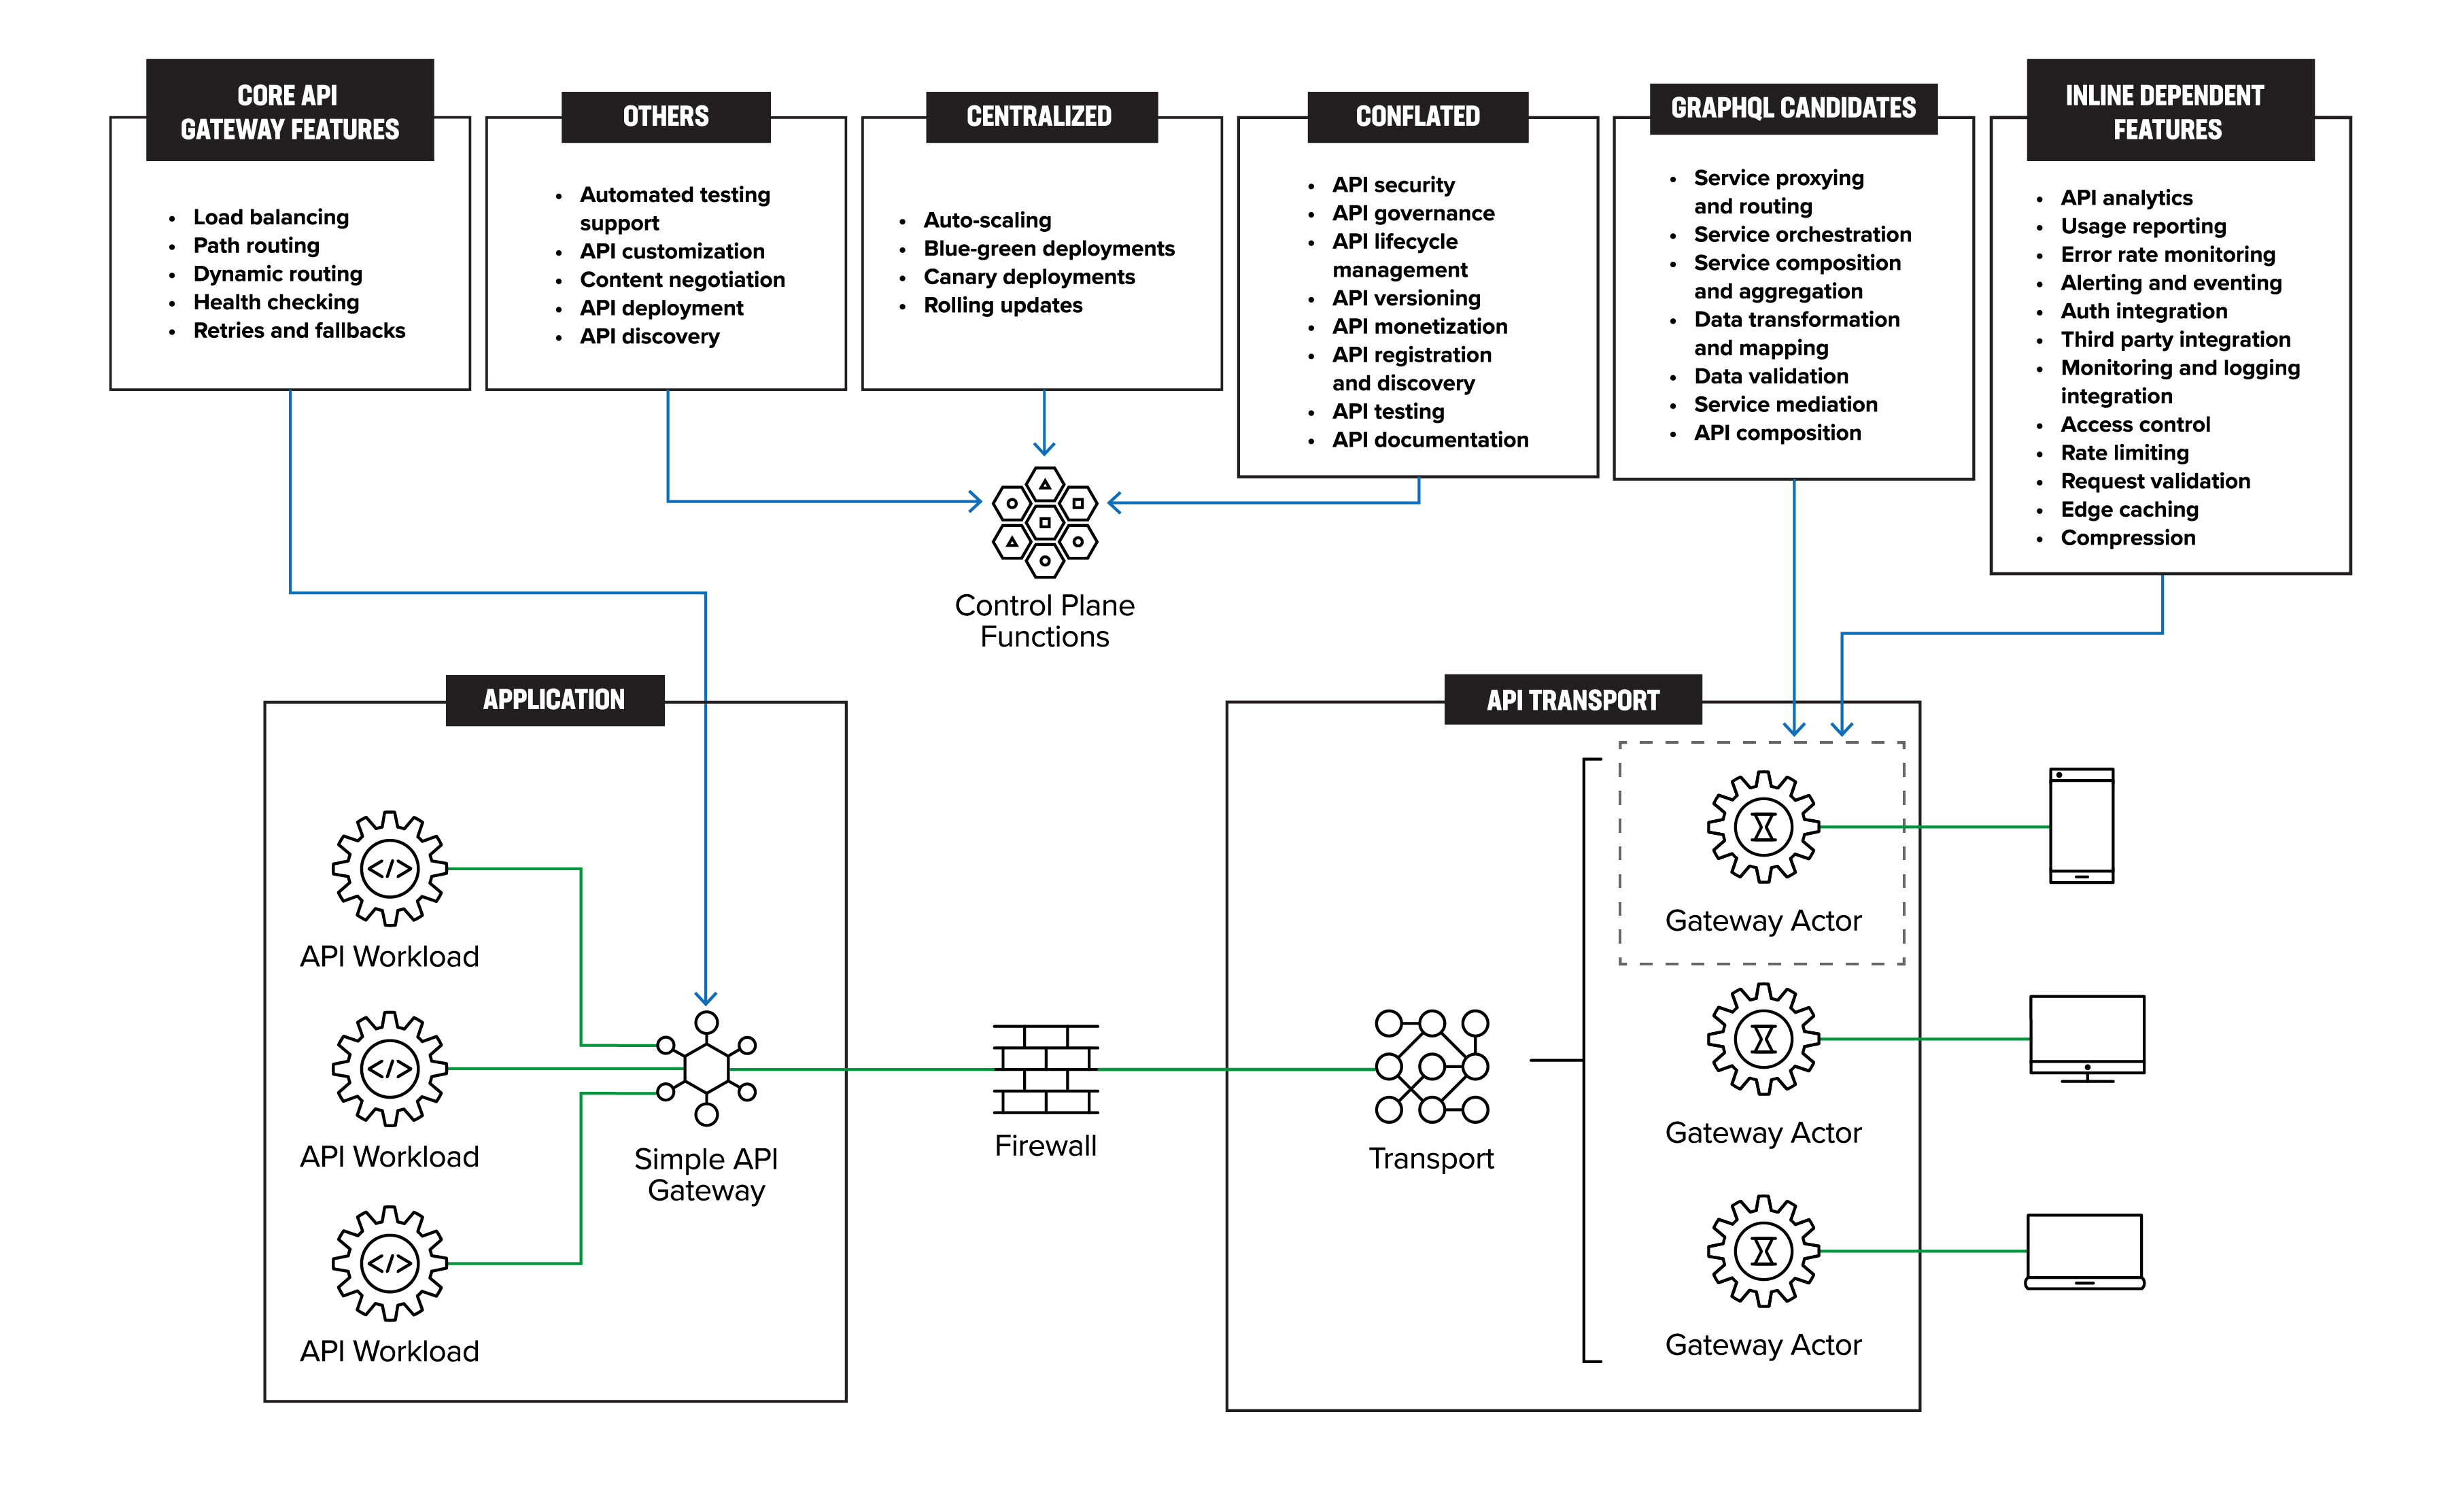
La figure 7 met en correspondance les différentes fonctionnalités et fonctions de la gestion des API présentées dans la figure 6 avec l’architecture des acteurs de passerelle distribuée. Cette représentation illustre visuellement la manière dont chaque fonctionnalité et fonction s’inscrit dans l’approche DGA, en soulignant l’intégration fluide des composants de gestion des API au sein de l’architecture.
Fonctions centralisées
La plupart des fonctionnalités énumérées ci-dessus comportent une composante de gestion qui peut être centralisée de manière logique. Notre objectif n’est pas de repenser l’architecture du plan de gestion, mais, si possible, de supprimer certaines fonctions.
Fonctions principales de la passerelle API
Il s’agit de fonctions du plan de données, qu’il est donc préférable d’implémenter dans l’API et de colocaliser avec les charges de travail applicatives. Les passerelles API sont un composant essentiel des architectures modernes de microservices et servent de point d’entrée à l’ensemble du trafic externe. Nous avons classé parmi leurs fonctions principales le routage, l’équilibrage de charge, le routage dynamique, les contrôles d’intégrité, les nouvelles tentatives et les mécanismes de repli.
Une passerelle d’API dirige les requêtes entrantes vers le microservice approprié, répartit le trafic entre plusieurs instances, prend en charge le routage dynamique, surveille l’état de santé des microservices et de leurs instances, relance les requêtes ayant échoué et fournit des réponses de secours lorsqu’un microservice est indisponible ou défaillant. D’autres fonctions, telles que l’authentification, l’autorisation, la limitation du débit, la mise en cache et la journalisation, peuvent être distribuées en périphérie ou centralisées, selon les exigences spécifiques du système.
Cette approche modulaire permet de bénéficier d’une architecture plus flexible et optimisée. Elle est au cœur de notre recommandation visant à simplifier, moderniser et faire évoluer l’infrastructure d’API de l’entreprise.
Fusionné
Les fournisseurs confondent souvent à tort la passerelle API et la gestion des API, considérant cette dernière comme faisant partie des fonctions de la passerelle API. Il s’agit pourtant de deux fonctions distinctes qui doivent être traitées séparément. Une passerelle API est chargée d’acheminer les requêtes des clients vers les services back-end, tandis que la gestion des API englobe un ensemble plus large de fonctionnalités, telles que le contrôle des accès, la limitation du débit, l’analyse des données et la gestion du portail des développeurs.
“Bien que certains fournisseurs puissent proposer à la fois des fonctions de passerelle API et de gestion des API au sein d’un même produit, il est important de comprendre les différences entre ces fonctions et de les évaluer séparément en fonction de leurs exigences spécifiques.”
Bien que certains fournisseurs puissent proposer à la fois des fonctions de passerelle API et de gestion des API au sein d’un même produit, il est important de comprendre les différences entre ces fonctions et de les évaluer séparément en fonction de leurs exigences spécifiques. Le regroupement de ces fonctions peut prêter à confusion et potentiellement limiter la flexibilité et l’évolutivité de l’infrastructure API d’une organisation. Ce point est également essentiel pour comprendre notre position concernant la distribution de la fonctionnalité de passerelle API.
Acteur de passerelle – Fonctionnalités intégrées
Les fonctionnalités répertoriées ici sont des fonctions essentielles qui doivent être intégrées au chemin de données. Dans une architecture de passerelle distribuée, certaines fonctions intégrées de la passerelle API sont également distribuées. Ces fonctions comprennent le contrôle d’accès, la limitation du débit, la validation des requêtes, l’analyse des API, les rapports d’utilisation, la surveillance du taux d’erreur, les alertes et la gestion des événements, l’intégration de l’authentification, l’intégration de services tiers, l’intégration des outils de surveillance et de journalisation, la mise en cache en périphérie et la compression.
Le passage de ces fonctions à un modèle de passerelle distribuée présente les avantages suivants :
- Réduction de la charge sur la passerelle API: contribue à réduire la charge sur la passerelle API centralisée et à améliorer les performances et l’évolutivité du système.
- Accélérer les temps de réponse: Accélérez les temps de réponse et réduisez la latence en déployant ces fonctions au plus près des clients. Grâce à la mise en cache des données et de la fonction, les passerelles API hébergées en périphérie peuvent répondre rapidement aux requêtes entrantes.
Par exemple, le contrôle d’accès, la limitation du débit et la validation des requêtes peuvent être pris en charge par un acteur de passerelle en périphérie, déployé au plus près des clients. Cela permet de réduire le nombre de requêtes que la passerelle API centralisée doit traiter, améliorant ainsi ses performances et son évolutivité. De même, l’analyse des API, les rapports d’utilisation, la surveillance du taux d’erreur, les alertes et la gestion des événements, ainsi que l’intégration des outils de surveillance et de journalisation peuvent être pris en charge par des passerelles en périphérie, capables de collecter et d’agréger les données provenant de plusieurs microservices.
Acteurs de passerelle – Candidats GraphQL
Aujourd’hui, la composition et l’orchestration de services constituent une fonctionnalité importante prise en charge par les passerelles API. Bien que cela puisse devenir assez complexe, l’absence de cette fonctionnalité dans la passerelle API simplifiée serait problématique. Nous pensons que GraphQL peut constituer une approche intéressante de la composition de services, en faisant office de couche intermédiaire pour les API existantes.
Grâce à sa visibilité sur l’ensemble des API, la passerelle API constitue un emplacement logique pour effectuer la composition de services. Elle permet ainsi aux développeurs de combiner les API situées derrière la passerelle afin d’enrichir la logique métier, sans avoir à créer de nouveaux services, qui peuvent être combinés plus facilement dans une couche de composition de services.
La composition de services dans GraphQL est rendue possible par l’utilisation d’un schéma fortement typé, qui définit la structure des données accessibles aux clients. Ceux-ci peuvent utiliser ce schéma pour élaborer des requêtes précisant exactement les données dont ils ont besoin, quels que soient les services ou les sources qui les fournissent. Les résolveurs, des fonctions qui associent les requêtes aux sources de données, permettent de récupérer les données auprès du service ou de la source appropriés. Toutefois, même si GraphQL promet une meilleure sécurité, celle-ci dépend avant tout du développeur qui écrit le code.
Autres fonctionnalités
Certaines fonctionnalités restantes ne sont pas mises en évidence dans la Figure 6 : fonctionnalités de gestion des API et d’infrastructure. Ces fonctionnalités peuvent être transférées vers des fonctions individuelles de gestion et d’exploitation ou vers des fonctions du plan de données.
Nous avons délibérément choisi d’utiliser le terme « acteur » afin de ne pas suggérer une implémentation ou une technologie fournisseur particulière. L’implémentation de l’acteur de passerelle pourrait reposer sur des méthodes, des fonctions, des workers, des threads et des processus, mis en œuvre à l’aide d’infrastructures basées sur des machines virtuelles, des conteneurs, des architectures sans serveur ou d’autres approches propres à un fournisseur.
Fonctionnalités et comportement du composant
L’approche adoptée avec l’architecture DGA (Distributed Gateway Actors) simplifie les fonctions de la passerelle API et déplace les autres fonctionnalités intégrées soit vers la périphérie, soit vers le plan de contrôle.
Plan de contrôle
Outre les fonctionnalités de la passerelle d’API, l’architecture DGA recommande également d’identifier les fonctions qui gagneraient à être prises en charge dans le plan de contrôle en tant que composant logiquement centralisé, plutôt que d’être intégrées à une passerelle d’API monolithique. La gestion et le contrôle de l’infrastructure d’API existante peuvent être étendus afin d’inclure cette fonctionnalité supplémentaire.
Passerelle API simplifiée
La simplification de la passerelle API consiste donc à définir un ensemble standard de fonctions essentielles que tous les fournisseurs de passerelles API peuvent gérer au moyen d’un ensemble commun de paramètres de configuration.
Une entreprise souhaitant opérer cette transformation pourrait déployer l’architecture DGA application par application, sans perturber les déploiements existants ni devoir procéder à une migration complète.
Acteurs de passerelle distribués
Un aspect important de la DGA est que chaque « acteur de passerelle » est éphémère et n’est instancié que pour la durée d’une session d’API (c’est-à-dire le temps qu’un client effectue un appel d’API).
Un acteur de passerelle distribuée peut offrir davantage de flexibilité, d’évolutivité et de rentabilité qu’une passerelle d’API traditionnelle. Au lieu de s’appuyer sur plusieurs passerelles d’API monolithiques provenant de différents fournisseurs pour agréger et gérer le trafic des API, l’acteur de passerelle permet aux développeurs de définir et de déployer des instances de passerelle individuelles pour chaque API, au plus près de la périphérie du réseau. Les API elles-mêmes pourraient ainsi offrir un contrôle accru et une personnalisation mieux adaptée à leurs besoins spécifiques.
Cette nouvelle approche offre également une meilleure évolutivité, car les développeurs peuvent facilement créer des instances de l’acteur de passerelle selon les besoins afin de gérer l’augmentation du trafic, sans avoir à se soucier de la charge liée à la gestion d’une passerelle centralisée de grande envergure.
Outre ses avantages techniques, l’acteur de passerelle permet également de réaliser des économies par rapport à une passerelle d’API traditionnelle, car les entreprises ne paient que pour les instances éphémères de l’acteur de passerelle qu’elles utilisent. Ce modèle de déploiement peut ouvrir la voie à de nouvelles sources de revenus.
“Outre ses avantages techniques, l’acteur de passerelle permet également de réaliser des économies par rapport à une passerelle API traditionnelle, en permettant aux entreprises de ne payer que pour les instances éphémères de l’acteur de passerelle qu’elles utilisent. ”
Placement de l’acteur de passerelle
En s’appuyant sur une couche de transport d’API, les DGA dissocient essentiellement le point d’entrée des API de la passerelle d’API. Les DGA peuvent être déplacées en périphérie, c’est-à-dire au plus près du client effectuant l’appel d’API. Les API peuvent aboutir dans les DGA, puis être acheminées par n’importe quel moyen. Cette approche diffère de la Figure 3 : architectures traditionnelles de passerelles d’API où le trafic client entre dans le réseau à un emplacement topologiquement adjacent aux passerelles d’API.
Conclusion
Notre intention a donc été de proposer une approche indépendante des fournisseurs et des modes de déploiement, car les différents fournisseurs peuvent disposer de leur propre propriété intellectuelle pour concevoir ces composants afin d’atteindre des objectifs similaires à ceux décrits.
Dans cet article, nous avons synthétisé les enseignements tirés de plusieurs trimestres de recherche sur la prolifération des API, les architectures Edge 2.0, l’économie des API (https://www.f5.com/company/blog/inverting-the-api-is-the-digital-transformation-that-enterprises-need-to-participate-and-compete-in-an-api-economy) et GraphQL. Bien qu’aucun consensus ne se dégage encore concernant les infrastructures d’API existantes, nous estimons qu’une nouvelle approche est nécessaire.
La seule promesse de libérer la valeur que recèle chaque appareil ou entité à travers le monde constitue une raison suffisante pour explorer une nouvelle approche. Nous devons aujourd’hui nous affranchir de l’infrastructure d’API existante, car même si elle semble distribuée, elle reste monolithique en profondeur.
Nous proposons une approche fondée sur des acteurs de passerelle GraphQL distribués, indépendante des fournisseurs, afin de libérer tout le potentiel de l’économie émergente des API.