Principes fondamentaux d’Edge 2.0
Par Rajesh Narayanan et Michael Wiley
Introduction
La définition de l’edge a toujours été étroitement liée à l’évolution de l’architecture des centres de données. Au cours de la dernière décennie, l’architecture des infrastructures d’entreprise a connu une transformation rapide, passant des centres de données sur site aux architectures cloud distribuées actuelles. Nous considérons l’Edge 2.0 comme une évolution technologique qui permettra aux applications de tirer parti d’une architecture cloud distribuée.
Chaque personne, organisation ou entité a sa propre interprétation de l’edge. Pour certains, l’edge peut être une antenne-relais ; pour d’autres, il peut s’agir de leur appareil mobile. Pour les fournisseurs de services cloud (CSP), l’edge désigne une infrastructure gérée qui s’intègre de manière transparente à leurs systèmes back-end. Dans les applications militaires, l’edge correspond au théâtre des opérations, qu’il soit terrestre, maritime ou aérien. Chaque fois que nous lisons quelque chose sur l’edge, son interprétation se résume généralement aux capacités de calcul, de mise en réseau et de stockage de l’infrastructure et/ou à son emplacement.
Mais nous considérons également l’Edge 2.0 comme l’expérience qu’il offre à toutes les parties prenantes de l’écosystème, et pas seulement comme l’infrastructure elle-même ou son emplacement.
Ce document décrit les fonctionnalités que doit offrir l’Edge 2.0, indépendamment de son infrastructure physique ou virtuelle, ainsi que de l’endroit où il se trouve ou est instancié. L’objectif n’est pas d’expliquer comment concevoir une meilleure application distribuée, mais de mettre en lumière les capacités dont l’Edge 2.0 doit disposer pour permettre la création d’applications distribuées optimales répondant à un besoin particulier.
“Edge 2.0 concerne l’expérience, et non l’infrastructure ou son emplacement.”
Qu’est-ce que l’Edge 2.0 ?
Du point de vue d’une entité présente sur ce cloud distribué, la périphérie se situe là où se trouve actuellement cette entité. Nous proposons donc une définition d’Edge 2.0 centrée sur l’expérience, qui ne dépend pas uniquement de l’emplacement ou du type de l’infrastructure, ni de l’entité qui la contrôle.
Edge 2.0 vise à améliorer l’expérience des applications, des équipes d’exploitation et des développeurs. Edge 2.0 doit prendre en compte les métapropriétés de l’application (telles que les SLA et les SLO) en s’adaptant à l’évolution de ses besoins. Edge 2.0 doit être simple à exploiter et éviter aux équipes d’exploitation d’avoir à créer de nouvelles automatisations pour chaque application distribuée. Edge 2.0 doit réduire les difficultés rencontrées par les développeurs lorsqu’ils développent et déploient à grande échelle des applications distribuées, en prenant en charge de manière transparente la sécurité, la gouvernance et les objectifs de niveau de service.
Prenons l’exemple d’une application bancaire. L’objectif d’Edge 2.0 n’est pas d’améliorer la logique métier de la transaction, mais de la rendre plus sécurisée, plus rapide et confidentielle, de permettre son utilisation dans toutes les zones géographiques (selon les besoins) et d’adapter sa capacité à la hausse ou à la baisse afin de répondre aux objectifs de l’entreprise.
Concepts et assertions
Voici les principaux concepts et affirmations de cet article :
- Edge centré sur l’expérience : établit les fondements de l’Edge 2.0 autour de l’expérience qu’il offre, plutôt que d’un actif ou de ses emplacements.
- Considérations de conception : précise les principaux éléments de conception à prendre en compte pour réussir la mise en œuvre de l’architecture Edge 2.0.
- Infrastructure hétérogène : souligne que la conception d’un cloud distribué implique de prendre en compte le contrôle décentralisé de l’infrastructure.
- La télémétrie comme fondement : souligne que la télémétrie constitue un élément fondamental qui doit être pris en charge à tous les niveaux de l’infrastructure. Sans télémétrie, une stratégie axée sur les données perd de sa substance.
- Défis inter-clusters : souligne un défi fondamental d’Edge2.0, qui réside dans son fonctionnement inter-clusters plutôt qu’intra-cluster.
- Interfaces adaptatives : présente les interfaces adaptatives et propose une comparaison claire avec les interfaces déclaratives et impératives.
- Plateforme d’applications Edge 2.0 (EAP) : présente l’EAP comme un cadre permettant à Edge 2.0 de s’adapter aux besoins des applications.
Sujet(s) non traité(s)
Il y a plusieurs sujets que nous n’avons pas encore abordés dans cet article :
- Distribution des données applicatives : ce domaine englobe de nombreux sous-thèmes, tels que les réseaux de diffusion de contenu (CDN), la distribution du stockage, la distribution des données, la mise en cache, etc. De nouvelles technologies émergent également, comme les types de données répliquées sans conflit (CRDT). Un cadre Edge 2.0 devrait inclure la prise en charge de la distribution des données applicatives dans son périmètre.
- Distribution des fonctions : l’évolution de l’informatique en périphérie peut être envisagée comme un rapprochement des fonctions et de la logique du cœur du cloud vers l’endroit où l’événement est généré ou les données sont stockées. Compte tenu de l’importante puissance de calcul désormais disponible en périphérie, nous devons résoudre des problèmes similaires à ceux habituellement traités dans les architectures cloud traditionnelles si nous voulons tirer parti de cette puissance. Il peut s’agir, par exemple, des réseaux superposés, des charges de travail des intergiciels et d’autres types de charges de travail interdépendantes et plus complexes que les cas d’usage élémentaires observés aux débuts de l’informatique en périphérie, tels que les storlets, qui sont de simples flux sans état exécutés au plus près des données.
- Il existe probablement d’autres domaines qui n’ont pas été abordés. L’objectif du cadre est d’être extensible afin que des responsabilités puissent être ajoutées selon les besoins.
Évolution de l’Edge
La figure 1 illustre au mieux la coévolution des architectures Edge et des centres de données. Les versions Edge 1.0 et 1.5 reposaient sur la notion de site d’origine et sur le transfert des données et des services depuis ce site vers le consommateur. Edge 1.0 correspondait au déploiement d’une infrastructure Internet principalement axée sur l’optimisation de l’utilisation de la bande passante grâce à la mise en cache distribuée des contenus, autrement dit aux réseaux de diffusion de contenu. Les CDN constituent un modèle de conception fondamental, car le volume total de contenu à transférer sera toujours supérieur à la bande passante disponible.
À mesure que les coûts des processeurs et de la mémoire chutaient, des fermes de calcul sont apparues aux côtés des nœuds CDN. Les applications étaient utilisées sous forme de services par l’intermédiaire d’architectures orientées services (SOA). D’où la désignation d’Edge 1.5 comme réseau de distribution de services.
“Chaque entité considère, de son propre point de vue, qu’elle se trouve à la périphérie.”
Une caractéristique commune à l’Edge 1.0 et à l’Edge 1.5 est la notion de site d’origine. Avant l’essor du mobile, les personnes, les appareils et les objets téléchargeaient principalement du contenu ou utilisaient le service en tant que consommateurs. Le site à l’origine du service restait distinct de celui du consommateur.
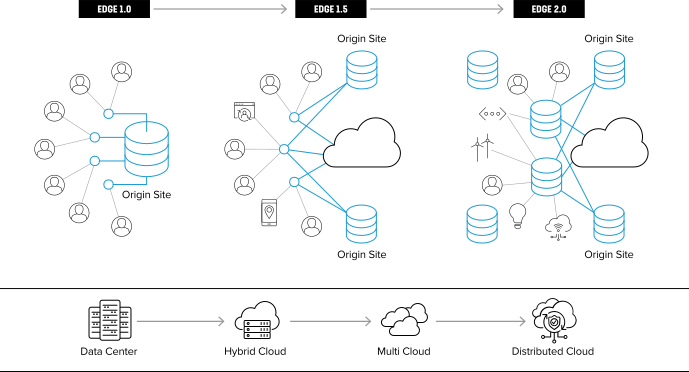
Cependant, dans l’Edge 2.0, toute entité peut faire office de site d’origine ou de consommateur. Le flux de trafic a changé. Les personnes, les téléphones et les appareils produisent activement des données lorsqu’ils chargent du contenu ou génèrent des données périodiques. Les applications deviennent des consommatrices, car elles dépendent d’autres applications. Toutes les entités peuvent agir en tant que productrices ou consommatrices d’un service : API, personnes, appareils IoT ou applications web, back-end et headless. De son propre point de vue, chaque entité de l’infrastructure se considère comme étant à la périphérie.
Le cloud distribué constitue la dernière étape de l’évolution du centre de données. La puissance de calcul est devenue véritablement omniprésente, des appareils mobiles aux objets du quotidien connectés au réseau dans lesquels elle est intégrée. Parallèlement, les architectures logicielles ont évolué pour permettre le développement d’applications distribuées et évolutives.
Conséquences de l’edge computing : une complexité accrue
L’omniprésence et l’hyperdistribution des ressources de calcul et de stockage offrent aux entreprises la possibilité d’accélérer leur transformation numérique. Mais cette évolution rapide n’est pas sans conséquences.
La plupart des entreprises disposent généralement d’infrastructures hétérogènes et d’environnements non uniformes. Pour faire évoluer efficacement de tels environnements, les systèmes déployés doivent assurer une orchestration et une automatisation complexes. Les évolutions rapides des besoins de l’application, notamment en matière de processeur et de bande passante, complexifient les opérations dans un cloud distribué. Cette situation accroît la pression sur les équipes d’exploitation, qui ne disposent pas toujours des moyens nécessaires pour répondre efficacement à l’évolution des besoins de l’application ou du client final.
Ces problèmes entraînent une complexité opérationnelle qui neutralise les gains potentiels pour une entreprise engagée dans une transformation numérique.
Certains des problèmes et artefacts interdépendants résultant de cette complexité sont présentés ci-dessous.
“Les bénéfices de la transformation numérique sont réduits à néant si la technologie est complexe à exploiter.”
Les modèles de sécurité doivent constamment évoluer
Les clouds hybrides augmentent la surface d’attaque susceptible d’être compromise par divers vecteurs d’attaque. Les différents cas d’usage engendrent de multiples défis en matière de sécurité et, à mesure que l’infrastructure évolue, nous devons constamment nous adapter. La question qui se pose est donc la suivante : seules les recommandations technologiques changeront-elles fréquemment, ou les modèles de conception utilisés pour mettre en œuvre la sécurité évolueront-ils eux aussi ?
Voici quelques-uns des problèmes que posent les approches existantes :
- Le périmètre défini par logiciel (SDP) ne s’adapte pas facilement à grande échelle, car les solutions les plus répandues reposent sur des agents, ce qui ne facilite pas les déploiements opérationnels simples.
- La mise en œuvre d’un accès réseau Zero Trust (ZTNA) est souvent peu réaliste, car les solutions ZTNA nécessitent le déploiement d’un ensemble de services de production, tels que l’inspection du trafic, la gestion centralisée des journaux, une infrastructure à clés publiques (PKI) mondiale, la gestion des identités, et bien plus encore.
- Le Secure Access Service Edge (SASE) associe le réseau en tant que service et la sécurité en tant que service, un véritable jargon d’acronymes désignant plusieurs technologies complexes à mettre en œuvre. En outre, le SASE tend à se concentrer sur les réseaux étendus définis par logiciel (SD-WAN), ne couvrant ainsi qu’une faible partie des cas d’usage liés à la périphérie du réseau d’entreprise.
- Les disparités entre les infrastructures des différents fournisseurs de cloud public et des modèles de sécurité déjà complexes, tels que la gestion des identités et des accès (IAM), conduisent souvent les équipes à renforcer les fournisseurs de manière disparate et à mettre en place des configurations multicloud fastidieuses.
“La sécurité consiste à toujours courir après le palet.”
Défis liés à l’automatisation
L’un des principaux défis liés à l’hyperdistribution des ressources de calcul basse consommation et à faible coût disponibles en périphérie réside dans la capacité à orchestrer et à planifier l’infrastructure de manière uniforme. Les équipes d’exploitation peinent à faire évoluer et à prendre en charge les applications qui tirent parti du cloud distribué, car celles-ci intègrent généralement des technologies hétérogènes ayant des exigences d’administration différentes.
Bien que les plateformes d’automatisation telles que Terraform offrent des moyens avancés de personnaliser l’automatisation, les équipes d’exploitation doivent toujours assurer la maintenance de scripts pour de multiples combinaisons : par exemple, cinq configurations de calcul différentes, quatre types de pare-feu et trois types d’équilibreurs de charge. Le coût humain lié à la gestion et à la maintenance des scripts d’automatisation ne permet pas de passer à l’échelle.
Cela contraint les utilisateurs de l’infrastructure à continuer d’interagir avec les équipes d’exploitation par l’intermédiaire de systèmes de gestion des demandes, qui font obstacle à l’automatisation des workflows existants. Le centre de services se retrouve submergé de demandes et doit privilégier la sécurité et la stabilité au détriment de l’agilité.
Prolifération des API
Avec l’évolution vers le multicloud, les architectures de microservices sont déjà devenues la méthode de référence pour développer de nouvelles applications. Les API sont publiées et peuvent être instanciées à tout moment et partout où cela est nécessaire, ce qui entraîne leur prolifération. La découverte, la connectivité et la gestion autonomes de ces API deviennent alors un défi majeur.
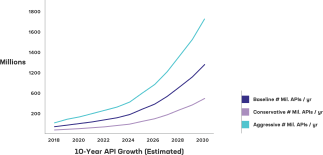
Un changement de paradigme est nécessaire pour faire face à la prolifération des API. Nos modèles internes montrent que même des hypothèses modérées concernant certains paramètres, tels que le nombre de développeurs d’API dans le monde, le nombre d’API développées par chaque développeur et par an, ainsi que la durée de vie des API, aboutissent à plusieurs centaines de millions (voire plusieurs milliards) d’API actives simultanément d’ici 2030 (figure 2). Le rapport 2021 sur la prolifération des API offre une vue d’ensemble complète de ce sujet émergent.
Faible visibilité de bout en bout sur le système
La complexité croissante oblige les entreprises à mettre en place une visibilité granulaire et pertinente sur l’ensemble du système, de bout en bout. Dans les environnements cloud distribués, les applications s’étendent sur plusieurs piles d’infrastructure hétérogènes gérées par des entités distinctes.
En outre, aucun opérateur n’est aujourd’hui incité à fournir à ses clients professionnels un accès aux données de télémétrie natives de son infrastructure. Lorsqu’elles déploient des applications dans un cloud distribué, les entreprises manquent donc cruellement de visibilité et doivent recourir à plusieurs outils d’observabilité. Pour combler ces lacunes, ces outils proviennent généralement de différents fournisseurs et interviennent à divers niveaux de l’infrastructure ou des piles applicatives.
Les métriques d’infrastructure non standard ne font qu’aggraver les difficultés au sein de l’entreprise. En règle générale, elles ne sont pas harmonisées en raison des silos opérationnels et d’autres facteurs, tels que l’hétérogénéité des infrastructures entre les différents environnements. Par exemple, les métriques varient d’un fournisseur de cloud public à l’autre, et les technologies des centres de données sur site ne suivent pas non plus de norme commune en la matière.
“De nombreuses entreprises avancent à l’aveugle faute d’une « pratique d’observabilité ».”
Résultat commercial : expérience dégradée
Les charges de travail génératrices de revenus et les systèmes critiques mobilisent généralement la majeure partie des ressources opérationnelles et du budget disponibles au sein d’une entreprise. Parallèlement, les projets de moindre envergure, bien que moins complexes, tendent à constituer la majorité des applications de l’entreprise. La figure 3 illustre ce phénomène sous la forme d’une distribution à longue traîne du nombre de projets qu’une entreprise est susceptible de gérer par rapport à leur complexité opérationnelle.
Bien que les applications de moindre envergure puissent présenter une complexité opérationnelle plus faible, les processus et workflows de mise en production restent encore souvent manuels, et plusieurs semaines peuvent être nécessaires pour que les demandes de service passent par les différentes équipes opérationnelles. Par exemple, le déploiement d’une application nécessitant des ressources réseau dédiées et des politiques de sécurité granulaires peut d’abord exiger que les équipes de sécurité globales définissent et approuvent ces politiques. La demande de service peut ensuite être transmise à l’équipe réseau afin de planifier les configurations requises pour les sous-réseaux et le routage. Enfin, la validation des règles de pare-feu peut nécessiter l’intervention d’une autre équipe opérationnelle, responsable de la gestion des pare-feu.
Imaginons maintenant qu’il faille gérer la complexité décrite ci-dessus pour chaque application déployée sur un cloud distribué dont l’entreprise ne possède aucune partie de l’infrastructure sous-jacente. Le nombre considérable de petits projets ou d’applications à intégrer et à prendre en charge ne permet pas aux équipes d’exploitation de tous les accompagner, ce qui soulève un problème de priorisation et ouvre la voie au libre-service.
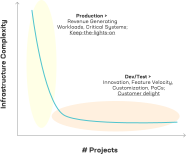
Ce problème de priorisation est particulièrement manifeste lorsque les investissements des équipes d’infrastructure se concentrent sur la prise en charge des systèmes critiques et générateurs de revenus, ne laissant que peu de temps ou de budget pour de tout nouveaux projets, qui nécessitent leur propre cycle de développement, de test et de préproduction avant leur mise en production. Il en résulte une réduction des capacités et des investissements consacrés au rythme de déploiement des fonctionnalités, à la personnalisation et à l’innovation au service de nouveaux produits, ce qui finit par entraîner une stagnation de l’entreprise et de son offre.
“Les équipes chargées de l’infrastructure sont submergées par la complexité.”
Espace des solutions Edge
L’évolution de l’écosystème edge élargit considérablement le champ des solutions en offrant la possibilité de relever ces défis grâce à une plateforme applicative.
La figure 4 présente l’espace des solutions Edge 2.0. Nous considérons ici que l’ensemble des éléments relevant d’une architecture cloud distribuée constitue la totalité de cet espace.
Ainsi, dans le contexte de l’espace des solutions, Edge 2.0 doit offrir l’expérience souhaitée par chacun des acteurs suivants :
- Toutes les entités relevant du périmètre de la solution — applications, personnes et appareils agissant en tant que consommateurs, ou applications web backend et sans interface qui constituent les services.
- Les équipes SRE et les responsables de ces applications, tout en maintenant les garde-fous de sécurité et de conformité réglementaire attendus pour l’infrastructure.
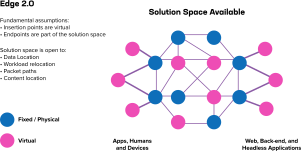
Edge 2.0 sera simple à exploiter, sécurisé et conforme, et offrira une expérience de haute qualité à toutes les entités de l’écosystème qui y participent.
Considérations relatives à la conception d’Edge 2.0
Sécurisé par défaut
Un cloud distribué amplifie ce problème de sécurité à grande échelle, car le nombre de points de terminaison augmente de façon exponentielle. À une telle échelle, la complexité de mise en œuvre d’une solution augmente elle aussi. En matière de sécurité, l’application doit partir du principe que l’environnement dans lequel elle est actuellement déployée est déjà compromis. De même, l’infrastructure ne doit faire confiance à aucune application qui s’y exécute.
Ces idées trouvent leur fondement dans les concepts de l’approche Zero Trust, et l’exemple BeyondCorp1 illustre leur application au cas d’usage de l’accès aux applications. À l’avenir, Edge 2.0 étendra ce modèle en s’appuyant sur les cinq principes fondamentaux suivants :
- L’identité est fondamentale : dans Edge 2.0, l’identité est omniprésente. Chaque instance d’entité possède sa propre identité unique à l’échelle mondiale, ainsi qu’une place dans la hiérarchie de l’organisation et un niveau de privilège. L’identité doit être un critère essentiel non seulement pour le trafic nord-sud, mais aussi en interne pour les accès est-ouest.
- Principe du moindre privilège : les actions autorisées pour un acteur doivent être limitées à celles qui lui sont strictement nécessaires pour remplir son rôle dans le système. Par exemple, il est possible de limiter, conformément aux spécifications de conception, le sous-ensemble de charges de travail autorisées à communiquer avec le serveur de base de données.
- Authentification continue : toute déclaration faite par un acteur du système doit pouvoir être vérifiée et doit l’être explicitement chaque fois qu’elle se produit. L’authentification ne doit pas reposer uniquement sur des mécanismes explicites tels que des secrets partagés ou une chaîne de confiance, mais doit également prendre en compte les schémas comportementaux implicites et les métadonnées contextuelles.
- Surveillance et évaluation constantes : les actions de tous les acteurs du système doivent être surveillées, ce qui renforce le rôle essentiel des technologies de collecte et d’entreposage des données dans une architecture Edge 2.0. En outre, ces activités doivent être évaluées en continu afin de détecter et de contrer les tentatives d’exécution d’actions interdites ou dangereuses. L’évaluation doit être réalisée à grande échelle et quasiment en temps réel, ce qui implique un recours généralisé aux techniques d’automatisation et d’apprentissage automatique.
- Présumer une compromission : compte tenu des ressources dont disposent aujourd’hui les adversaires les plus sophistiqués, il faut partir du principe que tout système a été compromis d’une manière ou d’une autre. Par conséquent, les politiques entièrement déterministes fondées sur l’identité des charges de travail et des utilisateurs, qui imposent un accès basé sur les privilèges représenté par a et b, sont souvent insuffisantes pour prévenir toutes les attaques. Un système Edge 2.0 pleinement mature doit donc également être capable d’évaluer en temps réel les risques et les bénéfices sur la base d’une surveillance et d’une évaluation continues.
“Partez toujours du principe que l’infrastructure est déjà compromise. Le défi consiste alors à y déployer une application en toute sécurité.”
Fournit une observabilité native
Edge 2.0 doit intégrer la télémétrie en tant que composant de premier ordre au cœur de la pile d’infrastructure, fournir un moyen simple et évolutif de collecter des données télémétriques entre les différentes couches de l’infrastructure et les transmettre à une plateforme commune. Les équipes chargées de l’observabilité peuvent ainsi examiner l’« état de l’infrastructure » selon leurs besoins. Les équipes applicatives peuvent alors se concentrer sur la logique métier sans avoir à instrumenter explicitement leurs piles applicatives.
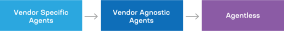
À l’heure actuelle, les technologies d’observabilité sont encore largement propriétaires et propres à chaque fournisseur. De nombreux agents spécifiques à différents fournisseurs collectent donc des signaux similaires et se disputent de précieuses ressources de mémoire et de processeur.
L’étape logique suivante consiste à utiliser un collecteur de télémétrie indépendant des fournisseurs, qui permet de transmettre en continu les données d’infrastructure et de trafic à une plateforme de données centralisée.
De nombreuses équipes produit peinent à justifier l’investissement dans l’instrumentation, car les efforts engagés doivent être associés à une opportunité de revenus. L’infrastructure doit être instrumentée comme toute autre fonction ou tout autre processus métier, car l’équipe doit comprendre son comportement afin de l’optimiser en fonction des objectifs de l’entreprise. Le débat devrait donc porter davantage sur les éléments à instrumenter en priorité que sur la nécessité même de l’instrumentation.
Pour obtenir des mesures plus granulaires et plus précises du comportement de l’application, nous prévoyons que l’instrumentation sera « décalée vers la gauche », en étant mise en œuvre dès la phase de codage — Figure 5.
“L’instrumentation doit intervenir plus tôt dans le cycle de développement.”
Prend en charge les interfaces adaptatives
Dans la logique du cloud distribué, si l’on descend de quelques couches, chaque cloud dispose, dans son périmètre (local ou mondial), de son propre gestionnaire, administrateur, orchestrateur, etc. Chacun fonctionne de manière autonome et prend ses propres décisions, tout en fournissant des interfaces que d’autres entités peuvent utiliser selon leurs besoins.
Ainsi, la notion de cloud distribué repose essentiellement sur une administration et un contrôle décentralisés. Il est impossible d’échapper à cette réalité, et il est important de la reconnaître afin de mieux saisir les nuances entre les interfaces adaptatives, déclaratives et impératives.
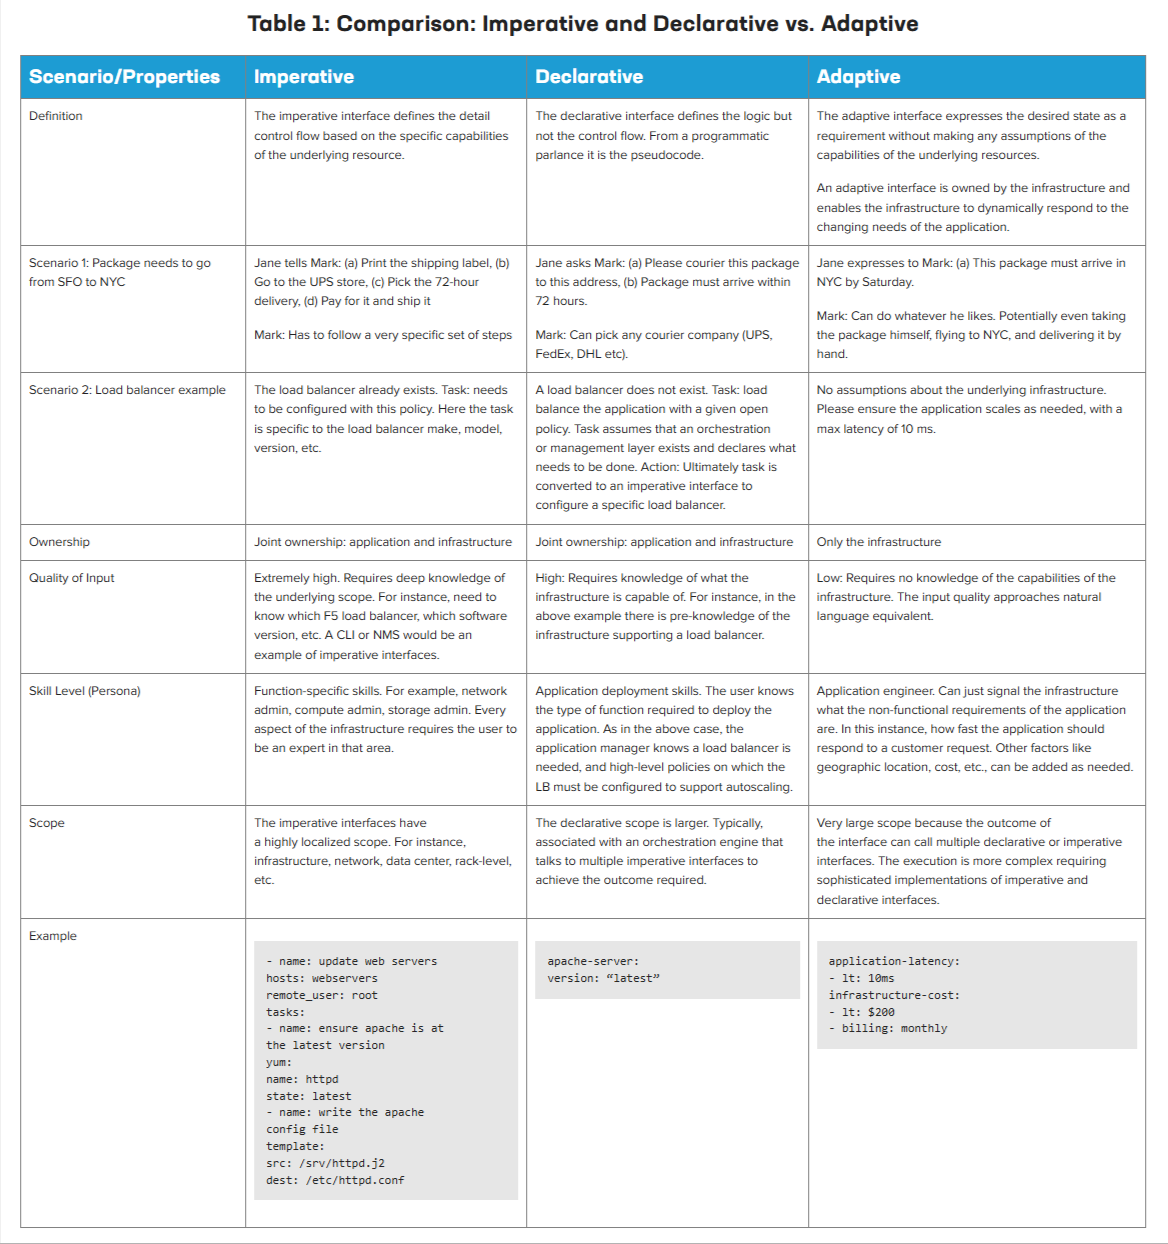
Pour exploiter efficacement l’infrastructure Edge 2.0, les interfaces impératives et déclaratives ne suffisent pas, car elles reposent encore sur des artefacts conçus manuellement, qui sont par essence des structures statiques incapables de s’adapter assez rapidement à des conditions en constante évolution.
Nous devons nous orienter vers une approche fondée sur les résultats, et les systèmes doivent être suffisamment intelligents pour ajuster les politiques sur l’ensemble de l’infrastructure (de bout en bout) afin d’atteindre ces résultats. C’est ce que nous appelons des interfaces adaptatives.
Pour être clair, les interfaces impératives, déclaratives et adaptatives ne s’excluent pas mutuellement :
Impérative : Cette approche est très prescriptive et définit en détail une série d’actions permettant d’atteindre l’état souhaité. La configuration d’un routeur, par exemple, est une action impérative. Dans le scénario ci-dessus, les actions prescrites seront précises : choix du centre de données, quantité de ressources processeur/mémoire, bande passante requise, routes spécifiques, etc. Le niveau de précision des données d’entrée du modèle est très élevé et exige donc une connaissance et une expertise approfondies de l’infrastructure. Il est nécessaire de connaître à la fois le modèle et la structure de l’infrastructure.
Déclaratif : La particularité de l’approche déclarative est qu’elle se concentre sur la description de l’état souhaité, plutôt que sur les actions permettant de l’atteindre. La qualité des données d’entrée est moindre, même si l’application doit tout de même connaître au moins la structure de l’infrastructure sous-jacente.
Adaptatif : Se distingue des approches impérative et déclarative. Une interface adaptative se concentre sur l’objectif ou le but recherché plutôt que sur l’état. Elle vise à saisir l’objectif de la partie prenante qui souhaite déployer l’application, plutôt que de s’appuyer sur une connaissance préalable du système sous-jacent. L’approche adaptative se distingue en ce qu’elle ne présuppose aucune connaissance des capacités de l’infrastructure sous-jacente. Aucune contrainte ne définit la manière de « mener à bien la tâche » ; elle constitue donc une approche à part entière.
Avec l’approche adaptative, le niveau de précision des données d’entrée est faible et se rapproche du langage naturel. Les responsables d’applications peuvent envoyer une requête indiquant au contrôleur d’infrastructure le résultat attendu, au lieu d’avoir à déclarer la capacité requise ou à configurer précisément une ressource.
“Proclamation : nous déclarons qu’il est impératif qu’Edge 2.0 prenne en charge les interfaces adaptatives.”
Résout le problème inter-clusters
Par définition, un cloud distribué prend en charge tous les types d’architectures applicatives : monolithiques, microservices ou serverless. Quelle que soit l’architecture, les applications utilisent des API pour fournir leurs services.
Les problèmes liés à la découverte des API, à la connectivité et à la sécurité du réseau sont en grande partie résolus grâce à l’utilisation d’un maillage de services, mais celui-ci ne les résout qu’au sein du cluster (intra-cluster).
Les applications Edge 2.0, quant à elles, exploitent des API au sein d’une infrastructure cloud hyperdistribuée, autrement dit dans un environnement multicluster. Les nouvelles applications sont conçues avec des API qui franchissent les frontières organisationnelles et géographiques. Certaines de ces API peuvent être des API privées ou partenaires, situées derrière plusieurs couches de pare-feu et sans route explicite entre elles, même si elles peuvent être découvertes. Ce problème d’hétérogénéité des clusters (intercluster) ne dispose d’aucune solution à la fois élégante, légère, évolutive, sécurisée et pratique.
Nous avons traité en détail la question des API dans le rapport 2021 « API Sprawl »2, qui répond à de nombreuses questions susceptibles de se poser. La figure 6 illustre la différence entre les communications inter-clusters et intra-cluster.
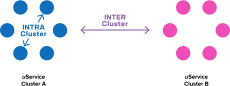
Intra-cluster : Dans une architecture monolithique, il se peut que très peu d’API soient exposées, la communication interne entre les modules s’effectuant par d’autres méthodes de communication interprocessus. À l’inverse, une architecture de microservices se décompose en dizaines, voire en centaines d’API.
Quoi qu’il en soit, chaque cluster d’applications est développé et géré selon une approche bien définie. Par exemple, dans le cas d’une architecture de microservices, une équipe peut utiliser n’importe quel type de maillage de services — Istio, Linkerd, Aspen Mesh ou autre. Chaque approche dispose de ses propres moyens pour gérer et contrôler les API au sein de son cluster, autrement dit, en intra-cluster.
Il existe de nombreuses solutions dans ce domaine, et l’objectif d’Edge 2.0 n’est pas de réinventer l’existant ni de contraindre les organisations ou les équipes de développement à adopter une nouvelle technologie supplémentaire.
Inter-clusters : À mesure que le nombre de services fournis via des API augmente, de nouvelles applications sont créées à partir de services déjà développés ou adoptés par différentes équipes applicatives au sein de l’entreprise, puisqu’il est inutile de réinventer la roue.
De nouvelles applications sont également développées en combinant de différentes manières des API publiques et privées. Du point de vue de l’architecture, les applications modernes s’appuient sur des services fournis par d’autres clusters. Dans un cloud distribué, ces clusters sont déployés à l’échelle mondiale et peuvent donc être situés sur n’importe quelle infrastructure capable d’héberger l’application ou de faire partie du cluster applicatif.
Portée d’un cluster d’applications
Pour rappel, la portée d’un cluster d’applications ne se limite pas à une seule organisation. Les clusters peuvent s’étendre entre deux réseaux, applications ou silos organisationnels quelconques, voire entre deux entreprises.
Le périmètre couvre tout l’éventail des permutations et combinaisons possibles, ce qui accroît de manière exponentielle la complexité des opérations. La figure 7 illustre les différentes permutations du trafic au sein du périmètre de déploiement des applications.
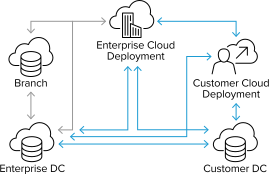
Une entreprise type dispose de différentes architectures applicatives. Selon l’équipe chargée du développement et du déploiement, il peut s’agir de diverses variantes de maillage de services, d’une application Web 2.0 reposant sur une architecture orientée services ou encore d’un déploiement logiciel monolithique. Les API sont donc disséminées dans toute l’entreprise, qu’il s’agisse d’API privées ou de l’utilisation d’API publiques. Ce problème n’est pas encore résolu. La communication entre les API réparties sur plusieurs sites est essentielle, mais reste un problème difficile à résoudre pour les entreprises de toutes tailles.
Il existe plusieurs solutions pour gérer les API au sein d’un cluster (par exemple, un contrôleur d’entrée, une passerelle API, etc.), mais aucune ne permet encore de gérer les communications d’API inter-clusters de manière pratique, évolutive et sécurisée. Nous limitons donc le périmètre du contrôle et de la gestion unifiés des API aux problématiques inter-clusters.
Garantit l’autonomie
L’un des avantages sous-estimés du cloud est l’autonomie qu’il offre au « consommateur de services cloud ». Les entreprises et les entrepreneurs peuvent déployer leurs propres infrastructures à la demande, tout en bénéficiant d’un niveau de contrôle proche d’un contrôle total.
Le principe de conception fondamental que doit respecter une plateforme Edge 2.0 consiste à offrir au client du cloud une expérience autonome, tout en mettant en place les garde-fous appropriés. Étant donné que les entités peuvent apparaître dans n’importe quelle infrastructure (de confiance ou non), ces garde-fous doivent être mis en œuvre de manière à ne pas alourdir la charge de l’unité opérationnelle ou de l’équipe DevOps chargée de développer l’application.
Résumé des principes
Le nouveau défi posé par Edge 2.0 concernera la découverte, l’identité, la confiance et l’observabilité entre les différents services.
Même dans les entreprises de taille moyenne, le nombre d’API produites chaque année est considérable. Comment les équipes peuvent-elles découvrir ces services au sein de l’entreprise ? Et comment peuvent-elles savoir si ces services sont toujours valides et à qui ils appartiennent ? Peuvent-elles être certaines qu’il s’agit de services validés et dignes de confiance ? Le problème se complexifie lorsque les équipes souhaitent utiliser des services créés par des clusters situés hors du périmètre de l’entreprise, par exemple ceux de fournisseurs SaaS ou d’applications exécutées sur des appareils en périphérie, qui échappent totalement au contrôle administratif des équipes chargées de l’infrastructure de l’entreprise.
Plateforme applicative Edge 2.0
Compte tenu des défis présentés dans les sections précédentes, nous devons considérer l’ensemble du cloud distribué comme une plateforme. À un niveau global, nous définissons l’objectif de la solution : découvrir de manière autonome (sans intervention humaine), mettre à l’échelle et sécuriser les applications distribuées sur une infrastructure décentralisée.
En substance, nous pouvons décrire le rôle de la plateforme applicative Edge 2.0 (EAP) comme suit :
- Découverte, identité et confiance des API
- Planification et orchestration de l’infrastructure
- Connectivité sécurisée des applications
“Découvrez, faites évoluer et sécurisez de manière autonome les applications distribuées sur une infrastructure décentralisée.”
Périmètre de l’EAP
L’infrastructure englobe l’ensemble de l’espace de solutions dans lequel des éléments d’infrastructure peuvent apparaître et disparaître en permanence. La propriété de l’infrastructure et de ses ressources, d’une part, et l’administration et le contrôle de ces ressources, d’autre part, sont deux notions distinctes. Le propriétaire d’une infrastructure peut attribuer une infrastructure donnée ou l’une de ses instances à une autre organisation, qui en assure la gestion et la configuration, ou en reprendre le contrôle selon les besoins. L’organisation chargée de gérer et de configurer les éléments peut ensuite les affecter à des projets ou applications spécifiques. Ce concept n’est pas nouveau : par exemple, les fournisseurs de services cloud proposent un contrôle administratif hiérarchique que les équipes informatiques d’une entreprise peuvent utiliser pour fournir à leur tour une infrastructure en tant que service (IaaS) aux unités opérationnelles internes, aux équipes, etc. Le principal enjeu d’Edge 2.0 consiste à mettre en œuvre ce modèle à grande échelle dans un cloud hyperdistribué, qui constitue l’état actuel et futur de l’infrastructure en périphérie.
C’est ici que le périmètre de l’EAP entre en jeu. La figure 8 ci-dessous présente le périmètre de l’EAP dans le contexte de différents types d’interfaces. Chaque EAP assure l’orchestration au sein de son périmètre local à l’aide d’interfaces déclaratives et impératives. Dans le cas présent :
- Les interfaces déclaratives / impératives seraient les API AWS, les API Azure, etc.
- Les interfaces adaptatives seraient entièrement nouvelles et devraient être définies au cas par cas.
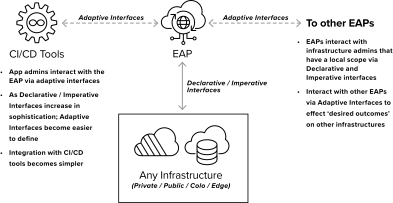
Pour tirer parti du cloud distribué, l’EAP doit être en mesure d’exploiter l’ensemble des nœuds et des entités disponibles par l’intermédiaire d’un cloud distribué. L’objectif est que chaque EAP devienne l’équivalent, pour la couche applicative, du concept de système autonome3 utilisé dans les réseaux IP.
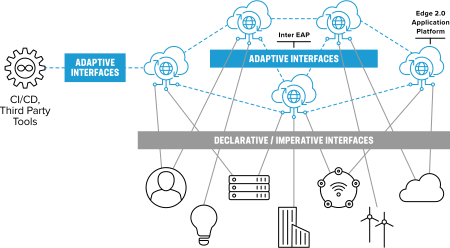
En rassemblant tous ces éléments (figure 9 ci-dessous), nous pouvons désormais obtenir une vue d’ensemble de la manière dont plusieurs EAP peuvent être déployées sur une infrastructure cloud décentralisée et interagir entre elles de manière autonome.
Les interfaces adaptatives facilitent également l’intégration des outils de CI/CD et d’autres applications de gestion du cycle de vie des applications au cloud distribué. Les plateformes de CI/CD peuvent interagir directement avec l’EAP au moyen d’interfaces adaptatives simples qui indiquent uniquement le résultat souhaité.
Il est important de noter que la communication entre EAP peut également être assurée au moyen d’interfaces adaptatives.
Le cadre EAP
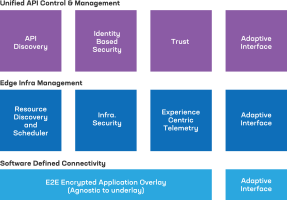
Le cadre EAP, illustré à la figure 10, organise les responsabilités en fonction des capacités de chaque instance EAP. Le rôle de l’EAP est d’assurer l’interface avec les contrôleurs de l’infrastructure sous-jacente — qu’il s’agisse d’une infrastructure en tant que service (IaaS), d’une plateforme en tant que service (PaaS) ou d’un logiciel en tant que service (SaaS) — ainsi que d’orchestrer et de planifier les ressources appropriées selon les besoins.
Contrôle et gestion unifiés des API
L’avenir sera marqué par une économie pilotée par les API, dans laquelle celles-ci ne se limiteront plus à une simple approche d’architecture logicielle simplifiée par un maillage de services. Une API deviendra le principal moyen par lequel toute entité participant à un cloud distribué fournira son service.
Comme nous l’avons établi, le nombre d’API publiques et privées disponibles dans le monde se chiffrera en centaines de millions, voire en milliards, au cours de la prochaine décennie. Les API transformeront notre économie, ce qui exige d’examiner de plus près les fonctionnalités que l’EAP devra mettre en œuvre pour soutenir cette économie.
Découverte des API
La prolifération imminente des API exige que chaque API puisse être découverte à l’intérieur comme à l’extérieur de l’EAP. Avec le cloud distribué, les API peuvent se trouver n’importe où, sur plusieurs clusters.
L’hypothèse sous-jacente est que la découverte des API constitue véritablement un problème inter-clusters. Le périmètre d’une EAP peut englober de nombreux clusters d’applications utilisant différentes approches logicielles (des microservices aux architectures monolithiques), chacun mettant en œuvre sa propre stratégie de passerelle API. Une EAP fournit un référentiel commun dans lequel toutes les API peuvent être enregistrées et découvertes à l’échelle de son périmètre, et pas seulement au sein d’un même cluster. Cette distinction est essentielle pour déterminer les limites des stratégies de passerelle API existantes, comme celles employées dans un maillage de services, par exemple.
Le défi pour l’EAP consiste à permettre la découverte d’une API, à fournir la documentation appropriée sur son utilisation et à gérer son cycle de vie afin d’en assurer la cohérence, l’exactitude et le versionnage. L’EAP met en œuvre un mécanisme permettant d’informer les entités qui utilisent ses API de l’état actuel des API concernées. Il peut s’agir simplement de définir des dates d’expiration ou de transmettre explicitement ces informations par l’intermédiaire d’un système de messagerie.
Sécurité axée sur l’identité
La posture de sécurité adoptée consiste, pour une application, à considérer que l’infrastructure sur laquelle elle est actuellement déployée est déjà compromise.
Le pilier essentiel de la mise en œuvre de cette posture de sécurité repose sur l’identité. Chaque point de terminaison d’API doit disposer d’une identité unique à l’échelle mondiale. Les politiques et les contrôles de sécurité sont gérés séparément dans un référentiel central.
Les API doivent être déclarées comme publiques ou privées, ce qui déclenche la configuration automatique des composants de sécurité de l’infrastructure sous-jacente pour l’API concernée.
Toutes les communications entre applications sont soumises par défaut à une politique de refus systématique. Ce n’est pas parce qu’une API est visible qu’une autre application peut l’appeler. Cette autorisation doit être explicitement configurée dans la politique de sécurité de l’application.
“Même la confiance a une durée de vie limitée : elle doit être vérifiée régulièrement.”
Confiance : une réputation qui se construit au fil du temps
L’EAP doit garantir que toutes les API relevant de son périmètre sont dignes de confiance et, parallèlement, que toutes les API externes utilisées par les services relevant de son périmètre le sont également.
« On ne peut pas prouver la confiance, c’est justement ce qui en fait de la “confiance” » – Extrait de Traitors sur Netflix
La confiance est essentiellement une « réputation qui se construit au fil du temps » et doit être continuellement réévaluée afin de s’assurer qu’elle n’est pas tombée en dessous d’un niveau acceptable. Cette approche est de plus en plus courante pour modéliser et mettre en œuvre la confiance dans les systèmes : celle-ci doit être évaluée en permanence plutôt que considérée comme acquise de manière statique lors de l’exécution initiale.
La nature fluctuante de la confiance au fil du temps peut constituer un défi pour certaines entreprises qui ne disposent pas du temps nécessaire pour établir une réputation mutuelle entre leurs systèmes et ceux de tiers. Les infrastructures comme les API peuvent causer des ravages si cette réputation ne fait pas l’objet d’une surveillance étroite.
Si un service relevant du périmètre de l’EAP accède à une API externe, la plateforme doit mettre en œuvre un mécanisme permettant au service appelant de s’assurer de l’exactitude de la réponse reçue de cette API. Ce n’est pas parce que la réponse de l’API semble valide qu’elle est digne de confiance. Elle peut être inexacte en raison de problèmes de qualité, ou des données erronées peuvent y avoir été délibérément introduites afin de nuire à la compétitivité de l’entreprise. Cette capacité à attribuer un indice de confiance à chaque API, qu’elle soit interne ou externe, est propre au modèle EAP.
Une stratégie pour mettre en œuvre la confiance consiste à calculer sa moyenne sur la « période » la plus récente plutôt que sur l’ensemble de l’historique du service. Cela revient à comparer les « meilleurs avis » aux « avis les plus récents » pour un produit sur Amazon. Le produit peut très bien avoir quatre étoiles, mais si la plupart des évaluations négatives datent des six derniers mois, cela indique une récente perte de confiance, tandis qu’un afflux de commentaires positifs au cours des six derniers mois témoignerait d’une correction du problème ou d’un rétablissement de la confiance.
Le facteur de confiance ne se limite pas à déterminer si une API est connue pour être une source de données fausses ou trompeuses. La réputation d’une EAP dépendra également de la manière dont elle gère et met à jour les API relevant de son périmètre. En outre, la « confiance » est également relative. Le service A peut faire confiance au service C, tandis que le service B peut avoir une expérience différente avec ce dernier.
Gestionnaire d’infrastructure en périphérie
Le cloud distribué constituant le socle de l’infrastructure Edge 2.0, il est impératif que les ressources relevant du périmètre d’une EAP soient faciles à découvrir, sécurisées et instrumentées. Les éléments suivants peuvent être considérés comme un ensemble de recommandations relatives aux capacités requises du gestionnaire de l’infrastructure Edge.
Découverte et ordonnancement
Au sein d’un EAP, les ressources peuvent être planifiées selon les besoins. De nouvelles ressources peuvent arriver ou partir de manière dynamique en raison de la mobilité. Un EAP peut également envoyer des demandes à d’autres EAP, ou en recevoir de leur part, afin qu’ils découvrent et planifient des ressources pour son compte selon les besoins.
Sécurité
Pour rappeler la posture de sécurité : l’infrastructure sur laquelle l’application est déployée est déjà compromise. L’EAP doit donc garantir la sécurité de l’application déployée dans son périmètre.
Quel que soit le niveau d’administration, le cadre EAP doit prendre en compte plusieurs aspects de la sécurité, notamment (sans s’y limiter) :
Menaces externes : Par exemple, les attaques par déni de service distribué (DDoS) et les menaces persistantes avancées (APT). Celles-ci peuvent être atténuées en appliquant les bonnes pratiques de sécurité existantes, telles que la prévention des attaques DDoS, l’utilisation de pare-feu, etc. Il est recommandé de rendre ces mesures obligatoires pour l’ensemble du trafic.
Attaque de l’homme du milieu : Tout le trafic doit être chiffré, sans partir du principe que la couche applicative prendra les mesures appropriées. Cela garantit la confidentialité élémentaire des données face à tout dispositif susceptible d’intercepter le trafic et protège l’intégrité des données contre toute manipulation pendant leur transmission.
Menaces internes : La portée de la couche d’infrastructure doit être limitée et principalement axée sur sa propre protection. Il est recommandé d’empêcher une ressource au sein de l’infrastructure de lancer une attaque interne contre le gestionnaire de l’infrastructure.
Télémétrie centrée sur l’expérience
Si l’Edge 2.0 se définit par l’expérience qu’il offre, et non par l’actif ou son emplacement, il en découle naturellement que la télémétrie doit elle aussi être centrée sur l’expérience.
La question est la suivante : de quelle expérience parlons-nous ? Il s’agit de celle de toute entité qui réside dans une infrastructure ou l’utilise pour produire ou consommer un service : applications, appareils, personnes, applications back-end, bases de données, etc. Le point de vue adopté sur l’expérience est donc celui de l’entité. Tout service produit ou consommé par une entité est directement lié aux ressources de calcul, de stockage et de réseau qui lui sont allouées.
Mais il ne suffit pas de mesurer l’expérience ; il faut également disposer d’un moyen de l’améliorer.
Toute entité qui utilise ou fournit un service peut déterminer si elle bénéficie de l’expérience demandée. Toutefois, dans les environnements cloud distribués, il peut être quasiment impossible d’expliquer ce qui s’est passé au niveau de la couche d’infrastructure et a entraîné cette mauvaise expérience.
Les métriques de haut niveau telles que l’utilisation du processeur, la mémoire, la bande passante et les mesures de latence ne suffisent pas à déterminer pourquoi une application ne bénéficie pas de l’expérience demandée3. Les métriques doivent présenter une granularité temporelle fine et être collectées en profondeur dans la pile applicative ainsi que, lorsqu’elles sont disponibles, dans les différentes couches de la pile d’infrastructure.
Une stratégie robuste, évolutive et extensible en matière de télémétrie et de données est essentielle à l’EAP. Les stratégies d’apprentissage automatique (ML) et d’intelligence artificielle (AI) peuvent ensuite être mises à profit pour prendre la meilleure décision quant à la réservation de nouvelles ressources ou à l’optimisation de l’utilisation des ressources existantes.
“Analogie avec l’océan : les réseaux sous-jacents aspirent à ressembler aux fonds océaniques, calmes, sereins et presque immuables au fil du temps, tout en restant un environnement sombre soumis à une forte pression. Un réseau sous-jacent qui tente de répondre à chaque exigence de chaque application ne fait que propager les torrents turbulents et les tourbillons de la surface jusqu’aux fonds marins.”
Connectivité applicative définie par logiciel
Bien que les problèmes de connectivité et d’accessibilité soient considérés comme résolus, de nombreuses équipes réseau peinent encore à adapter leur infrastructure réseau aux besoins dynamiques de la couche applicative. Une plateforme doit également répondre à ces défis.
Pourquoi séparer le plan de connectivité des applications
Le problème des approches existantes tient au fait que nous transposons les besoins de connectivité des applications à la connectivité du WAN d’entreprise, en particulier dans un cloud distribué. Pour gérer un réseau de cloud distribué, il est possible de recourir à différentes stratégies SDN ou à des méthodes reposant uniquement sur le routage. Toutefois, ces solutions dépendent fortement de l’homogénéité de l’infrastructure et ne permettent donc pas de garantir un comportement cohérent.
Le seul moyen de fournir à l’application un réseau sécurisé, stable et évolutif à l’échelle mondiale consiste à dissocier le plan de connectivité applicative du réseau sous-jacent, comme nous allons le voir ci-après.
Pile de connectivité proposée
Dans le cadre de l’évolution vers une architecture cloud distribuée, le nouveau modèle SDN consiste à orchestrer conjointement les réseaux sous-jacents et les réseaux superposés, et à permettre la programmabilité de bout en bout du chemin applicatif.
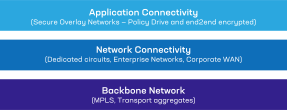
Avec Edge 2.0, nous devons apporter ce même niveau de stabilité, y compris lors de la connexion aux réseaux d’entreprise. Nous proposons de séparer le plan de connectivité des applications de la connectivité du réseau d’entreprise. Le modèle de connectivité des applications peut suivre ou non la même connectivité SDN que celle observée avec les réseaux superposés des centres de données (par exemple, VXLAN, NVGRE ou autres), ou des modèles SDN basés sur BGP.
Tous les réseaux n’ont pas été séparés en réseaux superposés (overlay) et sous-jacents (underlay). Les équipes réseau considèrent désormais cette programmabilité conjointe comme une exigence importante pour permettre une automatisation de bout en bout, pour laquelle la séparation du réseau sous-jacent et du réseau superposé est essentielle.
La séparation du plan applicatif du réseau sous-jacent et du transport évite aux équipes réseau d’avoir à répondre activement à chaque requête applicative. Leur rôle se limite alors à fournir des chemins robustes, stables et clairement définis, en veillant à optimiser l’utilisation de la bande passante agrégée tout en réduisant au minimum les latences.
Modèle d’interface adaptative
Le principe fondamental d’un EAP est qu’il est indépendant, autonome et qu’il gère un sous-ensemble de l’espace global des solutions. Toutefois, les EAP ont besoin d’un moyen de communiquer entre eux, de proposer leurs ressources ou d’en demander à d’autres EAP. Cette approche présente plusieurs avantages.
Interface simplifiée
Une interface axée sur les résultats évite à l’EAP d’avoir à connaître les détails de l’autre infrastructure. Supposons qu’il existe deux EAP : A et B. Chaque EAP dispose d’un périmètre local au sein de son infrastructure pour planifier et réserver des ressources. L’EAP-A n’a pas besoin de connaître les ressources fournies par l’EAP-B. Si, par exemple, l’EAP-A ne peut pas répondre aux besoins de l’application et nécessite des ressources d’infrastructure relevant du périmètre de l’EAP-B, il peut simplement lui communiquer l’objectif souhaité. Il incombe alors à l’EAP-B de faire appel à des interfaces déclaratives ou impératives afin de réserver, d’allouer et de configurer des ressources issues de son pool de ressources disponibles. L’EAP-B doit également veiller au respect des SLO de ce service au sein de son infrastructure.
Si une syntaxe commune facilitera l’amorçage d’un premier ensemble d’API adaptatives, la mise en œuvre gagnera progressivement en sophistication et en maturité grâce au traitement du langage naturel et à l’IA, ce qui permettra de réduire le niveau de qualité requis pour les données d’entrée.
Fonctionnalités de l’EAP
- Multilocataire : Bien que le maillage d’EAP présenté à la figure 9 corresponde à un déploiement unique, il est possible d’avoir plusieurs EAP par cloud. Une autre application pourrait communiquer avec un autre EAP ou avec un maillage d’EAP.
- Conçu pour évoluer : Chaque maillage est un réseau pair à pair (P2P) capable d’évoluer horizontalement. Les EAP pairs peuvent déterminer de manière autonome quels EAP disposent de chaque type de ressource et comment s’y connecter. L’IA et le ML amélioreront encore la façon dont chaque EAP planifie l’utilisation des ressources dans son propre périmètre ou sollicite d’autres EAP selon les besoins.
- Réseau intégré : Pour permettre aux applications de se connecter à travers le cloud distribué, l’EAP doit prendre en charge un réseau intégré indépendant de l’infrastructure sous-jacente.
Mise en pratique
La figure 12 illustre le rôle des différentes couches lors du déploiement d’une application dans un cloud distribué.
Les principaux points de cette représentation sont les suivants :
- Chaque EAP a une portée locale, et toutes ses capacités ne sont pas représentées dans la figure 10. L’EAP doit prendre en charge les fonctions de découverte et de planification des ressources. Les EAP planifient les ressources en communiquant avec le contrôleur d’infrastructure approprié au moyen d’API adaptatives.
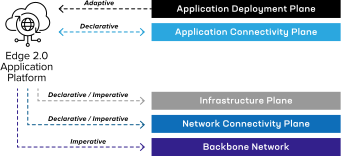
- La connectivité applicative n’est pas la même chose que la connectivité réseau : comme dans le modèle de side-car du maillage de services, les ressources permettant de connecter des applications dans un environnement multicloud doivent faire partie de l’infrastructure applicative. On pourrait faire valoir que le plan d’infrastructure assure également la connectivité réseau des applications et qu’il devrait donc se situer sous la couche réseau. Ce serait également correct d’un point de vue technique, mais nous avons choisi de l’intégrer au plan de « connectivité applicative », car il s’agit principalement de fonctions réseau.
- Le plan d’infrastructure doit être considéré comme distinct du plan applicatif.
- La connectivité réseau est distincte du transport, car il s’agit essentiellement de réseaux routables spécifiques, séparés de la connectivité applicative.
- Le plan de transport peut être considéré comme un ensemble de réseaux dorsaux agrégés pouvant être provisionnés, à condition que l’opérateur télécom mette en place les processus et les API nécessaires pour connecter la couche réseau supérieure.
Résumé
Ce livre blanc vise à approfondir certains aspects du manifeste Edge 2.0 d’origine. Nous y avons introduit de nouveaux thèmes afin d’informer les différentes parties prenantes, tant au sein des organisations qu’à l’échelle du secteur.
Edge 2.0 repose sur le concept d’un cloud distribué dans lequel chaque entité peut participer à la fois en tant que source et destinataire de services. L’idée centrale est qu’Edge 2.0 sera axé sur l’expérience, et non sur les ressources ou leur emplacement.
La plateforme d’applications en périphérie (EAP) est présentée comme un ensemble de fonctionnalités permettant de concrétiser l’Edge 2.0 sur un cloud distribué.
Les détails de mise en œuvre ont été délibérément omis afin de présenter une vision indépendante des fournisseurs.