L’IA suscite beaucoup d’émotions. Certains pensent qu’elle n’est que la dernière d’une longue série de modes et qu’elle rejoindra bientôt les NFT et les téléviseurs 3D aux oubliettes. D’autres construisent des bunkers en prévision de l’avènement d’IA générales malveillantes qui prendraient conscience d’elles-mêmes et domineraient le monde. Au milieu de toutes ces exagérations, une réalité peut être affirmée avec certitude : l’IA est liée à une grande quantité de données.
L’IA suscite beaucoup d’engouement et provoque chez les commentateurs enthousiasme, inquiétude ou scepticisme. Mais chez F5, nous nous intéressons à ce qu’en pensent les professionnels sur le terrain. Afin de mieux cerner les défis et préoccupations actuels, nous avons mené une analyse approfondie des opinions exprimées au sein de la plus grande communauté en ligne de professionnels de la sécurité, à savoir le subreddit r/cybersecurity de Reddit. Dans la première partie de son article consacré à cette étude, intitulée « Que pensent les équipes SecOps de l’IA ? », Shawn Wormke en a résumé les principales conclusions. Toutes les citations sont directement tirées de commentaires publiés par des professionnels de la sécurité entre juillet 2024 et juin 2025. Nous allons ici examiner plus en détail la principale préoccupation de l’année liée à l’IA : la sécurité des données.
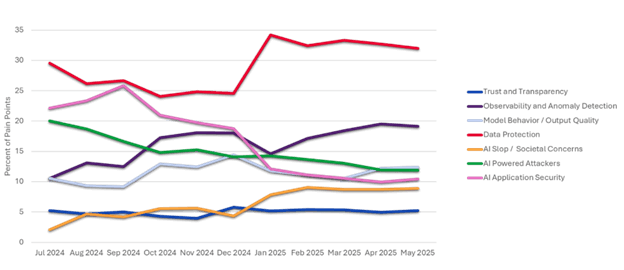
Les préoccupations se sont cristallisées autour de la divulgation de données sensibles, de l’IA fantôme et de la conformité
Beaucoup imaginent un paysage des menaces liées à l’IA dans lequel des individus malveillants exploitent l’IA pour mener des attaques d’ingénierie sociale sophistiquées et déployer des hordes de bots intelligents. Ces menaces sont bien réelles, mais les professionnels de la sécurité décrivent une situation nettement plus naïve, tout aussi préjudiciable et bien plus répandue. Ainsi, les préoccupations des équipes SecOps concernant l’utilisation abusive de l’IA en interne ont été évoquées 2,3 fois plus souvent que celles liées à son utilisation à des fins malveillantes.
“« Dans un monde où l’IA est extrêmement puissante, d’autres sont peut-être angoissés par l’IA, mais ma seule inquiétude concerne les clients et les collègues qui l’utilisent pour faire des choses incroyablement stupides, et non les adversaires qui s’en servent pour faire des choses incroyablement intelligentes. » — Commentaire publié sur le subreddit r/cybersecurity de Reddit”
Cela nous amène au cœur du premier problème : la divulgation d’informations sensibles. Comme l’a résumé un professionnel : « Soyons réalistes, tout le monde utilise des LLM au travail et saisit toutes sortes d’informations sensibles dans les prompts. » À mesure que les modèles disposent de fenêtres contextuelles plus étendues et que davantage de types de fichiers peuvent être utilisés avec la génération augmentée par récupération (RAG), les employés ont compris que le moyen le plus rapide d’obtenir une réponse éclairée consiste à fournir au LLM toutes les informations dont il pourrait avoir besoin. Cette pratique va directement à l’encontre du principe du moindre privilège, pilier essentiel du modèle Zero Trust. En termes simples, « il existe toujours une tension entre sécurité et capacités ».
Les stratégies traditionnelles d’application des politiques ne fonctionnent pas
La démarche logique adoptée par la plupart des organisations pour sécuriser l’IA consiste à mettre en place une politique d’utilisation acceptable (AUP). Il existe un large éventail de stratégies, mais il est généralement admis que les méthodes traditionnelles de dissuasion et de restriction sont insuffisantes.
“« Interdire l’utilisation d’une technologie, quelle qu’elle soit, semble produire l’effet inverse et ne fait qu’inciter à l’utiliser hors de votre contrôle… Dire simplement “vous ne pouvez pas utiliser ceci” n’empêchera pas les gens de le faire… Lorsque vous aurez découvert l’infraction et que les RH de votre organisation seront en mesure de les licencier, ils auront déjà utilisé les données de votre organisation dans l’IA de leur choix. » — Commentaire publié sur le subreddit r/cybersecurity de Reddit”
Comme l’explique un utilisateur, les outils traditionnels tels que les pare-feu d’applications web (WAF) et le filtrage DNS ne font que retarder l’inévitable : « En les bloquant, vous contraignez en réalité vos données à transiter par ces services gratuits. Avec les listes noires, ce sera toujours un jeu du chat et de la souris. » Cela nous amène à l’un des défis les plus débattus de l’année écoulée : l’IA fantôme. De nouveaux modèles sont publiés chaque jour, et des interfaces pour ces modèles sont développées à l’intuition toutes les heures. Les utilisateurs trouveront toujours des moyens de contourner les politiques qu’ils considèrent comme des obstacles à la bonne exécution des priorités liées à leur fonction.
Ces deux préoccupations majeures que sont l’IA fantôme et la divulgation de données sensibles se conjuguent pour créer le pire scénario possible pour les équipes de sécurité : une exposition généralisée sans aucune visibilité. Les utilisateurs peuvent recourir à des LLM grand public pour réduire leur temps de lecture, quitte à téléverser des documents confidentiels. Toutefois, grâce à des solutions de détection de l’IA fantôme, l’équipe SecOps pourrait observer ces interactions et mettre en œuvre plusieurs mesures d’atténuation des risques. Elle pourrait surveiller plus étroitement la personne concernée lors de ses prochaines interactions, ou lui restreindre l’accès aux ressources critiques jusqu’à ce que son comportement évolue. En l’absence d’une telle solution, les contre-mesures traditionnelles, comme les pare-feu et le blocage DNS, ne font que pousser les utilisateurs vers des interfaces peu connues reposant sur les mêmes modèles fondamentaux, réduisant ainsi la visibilité sur la nature, les modalités et l’origine des comportements à risque.
La conformité est le point de convergence de toutes les expositions
Alors que les exigences de conformité se multiplient, avec notamment le règlement européen sur l’IA et le règlement général sur la protection des données (RGPD), qui viennent s’ajouter aux réglementations sectorielles existantes, les organisations dépourvues d’une gouvernance adéquate des données d’IA s’exposent à de lourdes amendes, à une responsabilité juridique et à une érosion de la confiance du public.
“« Les outils qui ne disposent pas de journaux d’audit robustes ou qui ne permettent pas de restreindre le partage des données utilisateur sont également à proscrire. Certains interdisent tout simplement tout ce qui n’est pas conforme à SOC 2 ou au RGPD. Pour beaucoup, tout dépend du niveau de risque acceptable : si un outil ne peut pas garantir le contrôle des informations sensibles, il est écarté. » — Commentaire publié sur le subreddit r/cybersecurity de Reddit”
Les professionnels de la sécurité ont déjà connu leur lot de technologies pour lesquelles l’enthousiasme et la volonté de rester au niveau de la concurrence ont pris le pas sur les considérations de sécurité. Le cloud computing a suivi une trajectoire similaire à celle que connaît aujourd’hui l’IA : une adoption rapide et l’attente de nouvelles possibilités prometteuses, suivies de mauvaises configurations généralisées, d’accès excessifs et de défaillances du modèle de responsabilité partagée. Cela vous rappelle quelque chose ? La principale différence tient au fait que, dans le cloud, le nombre d’acteurs susceptibles de contribuer au risque global était nettement plus restreint. La nouvelle frontière de la sécurité de l’IA élargit désormais le champ d’attention immédiat : au-delà des architectes et ingénieurs cloud, jusqu’ici considérés comme les principaux suspects, il englobe toute personne ayant accès à des données sensibles, ainsi que les modèles eux-mêmes.
“« Il existe encore un écart assez net entre les entreprises d’IA qui investissent dans la sécurité et la conformité, et celles qui espèrent que leurs clients seront tellement enthousiasmés par la technologie qu’ils feront l’impasse sur ces étapes. » — Commentaire publié sur le subreddit r/cybersecurity de Reddit”
Les professionnels ont bien compris leur mission
Il n’y a jamais eu de technologie qui n’ait comporté un certain niveau de risque, ni pour laquelle le monde entier ait déclaré d’une seule voix : « C’est trop risqué, arrêtons tous immédiatement. » Les professionnels de la sécurité savent qu’une mission importante et difficile les attend.
“« La cybersécurité est une question de risque, et non une simple opposition entre sécurité et insécurité. L’IA générative présente de nombreux risques… Cela signifie-t-il qu’elle est si peu sûre qu’il ne faudrait même pas y toucher avec des pincettes ? Je ne le pense pas. Il s’agit avant tout de mettre en balance les avantages et les risques pour l’entreprise, en tenant compte de ses objectifs et de son appétence au risque. » — Commentaire publié sur le subreddit r/cybersecurity de Reddit”
Garantir que les interactions de l’IA avec les données soient encadrées par des garde-fous efficaces et fassent l’objet d’une observabilité continue est une tâche complexe, mais indispensable si l’adoption de l’IA se poursuit au rythme actuel.
F5 prend déjà des mesures importantes pour relever ces défis, et nous continuerons à nous appuyer sur les retours des équipes SecOps pour orienter nos priorités. En savoir plus ici.
À propos de l’auteur

Articles de blog associés

Les progrès en matière de cryptographie post-quantique masquent un manque de préparation plus général
Un nouveau rapport 2026 de F5 Labs sur l’état de préparation à la cryptographie post-quantique (PQC) du million de sites web les plus consultés fait état de progrès, mais aussi d’un manque préoccupant de mesures d’atténuation proactives.

Stratégies de sécurité pour l’IA multimodèle : deux mesures à prendre dès maintenant
Les mesures clés que les entreprises peuvent prendre dès aujourd’hui pour améliorer la visibilité sur l’IA multimodèle et renforcer la cybersécurité face à la croissance fulgurante de l’IA agentique.

Comment les RSSI peuvent mesurer les risques de sécurité liés à l’IA
Découvrez comment CASI, ARS et les renseignements sur les menaces de F5 Labs aident les RSSI à mesurer les risques de sécurité liés à l’IA tout au long de son cycle de vie.

Inférence : l’élément le plus important de l’IA dont vous faites semblant d’ignorer l’existence
Faire évoluer l’IA à grande échelle implique de faire évoluer l’inférence. Découvrez pourquoi les serveurs d’inférence sont essentiels pour gérer les performances, la télémétrie et la sécurité des charges de travail d’IA en production.

Que pensent les équipes SecOps de l’IA ? Partie 2 : Protection des données
F5 a mené une analyse approfondie des opinions exprimées par les professionnels de la sécurité sur Reddit au sujet de l’IA.
Que pensent les équipes SecOps de l’IA ?
F5 a mené une analyse approfondie des opinions exprimées par les professionnels de la sécurité sur Reddit concernant l’IA.