NGINX가 연결을 처리할 때 비동기 이벤트 기반 방식을 사용한다는 것은 잘 알려져 있습니다. 즉, 기존 아키텍처의 서버처럼 요청마다 별도의 전용 프로세스나 스레드를 생성하는 대신, 하나의 워커 프로세스에서 여러 연결과 요청을 처리합니다. 이를 위해 NGINX는 소켓을 논블로킹 모드로 사용하며, epoll 및 kqueue와 같은 효율적인 방식을 활용합니다.
전체 프로세스의 수가 적고(일반적으로 CPU 코어당 하나뿐) 일정하게 유지되므로 메모리 사용량이 훨씬 적고 작업 전환에 CPU 사이클이 낭비되지 않습니다. 이러한 접근 방식의 장점은 NGINX 자체의 사례를 통해 잘 알려져 있습니다. NGINX는 수백만 건의 동시 요청을 성공적으로 처리하며 확장성도 매우 뛰어납니다.
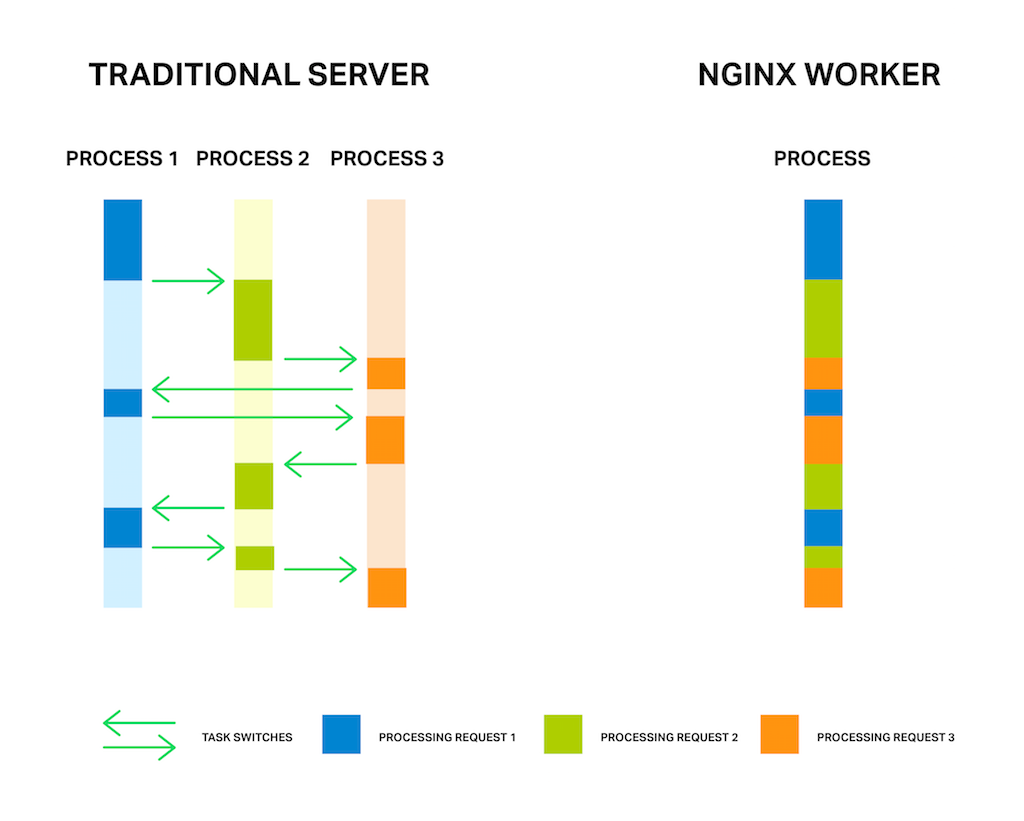
하지만 비동기 이벤트 기반 접근 방식에도 여전히 문제가 있습니다. 제가 즐겨 표현하듯이, 일종의 ‘적’이 있는 셈입니다. 그 적의 이름은 바로 블로킹입니다. 안타깝게도 많은 서드 파티 모듈이 블로킹 호출을 사용하며, 사용자뿐만 아니라 때로는 모듈 개발자조차 그 단점을 인식하지 못합니다. 블로킹 작업은 NGINX의 성능을 저하시킬 수 있으므로 반드시 피해야 합니다.
현재 공식 NGINX 코드에서도 모든 경우에 블로킹 작업을 피할 수 있는 것은 아닙니다. 이 문제를 해결하기 위해 새로운 ‘스레드 풀’ 메커니즘이 NGINX 버전 1.7.11에 구현되었으며 NGINX Plus 릴리스 7에도 도입되었습니다. 이것이 무엇이고 어떻게 사용해야 하는지는 나중에 살펴보겠습니다. 이제 우리의 적과 정면으로 마주해 봅시다.
편집자 주 – NGINX Plus R7에 대한 개요는 저희 블로그의 NGINX Plus R7 발표를 참조하세요.
NGINX Plus R7의 다른 새로운 기능에 대한 자세한 설명은 다음 관련 블로그 게시물을 참조하세요:
- 이제 NGINX Plus에서 HTTP/2 완벽 지원
- NGINX의 소켓 샤딩
- NGINX Plus 릴리스 7의 새로운 대시보드<.htmla>
- NGINX Plus R7의 TCP 부하 분산<.htmla>
문제
먼저 문제를 더 잘 이해할 수 있도록 NGINX의 작동 방식에 대해 간단히 설명하겠습니다.
일반적으로 NGINX는 이벤트 핸들러로서, 연결에서 발생하는 모든 이벤트에 대한 정보를 커널로부터 받은 다음 운영 체제에 수행할 작업을 지시하는 컨트롤러입니다. 실제로 NGINX는 운영 체제를 조율하는 어려운 작업을 모두 담당하고, 운영 체제는 바이트를 읽고 전송하는 일상적인 작업을 수행합니다. 따라서 NGINX가 적시에 신속하게 응답하는 것이 매우 중요합니다.
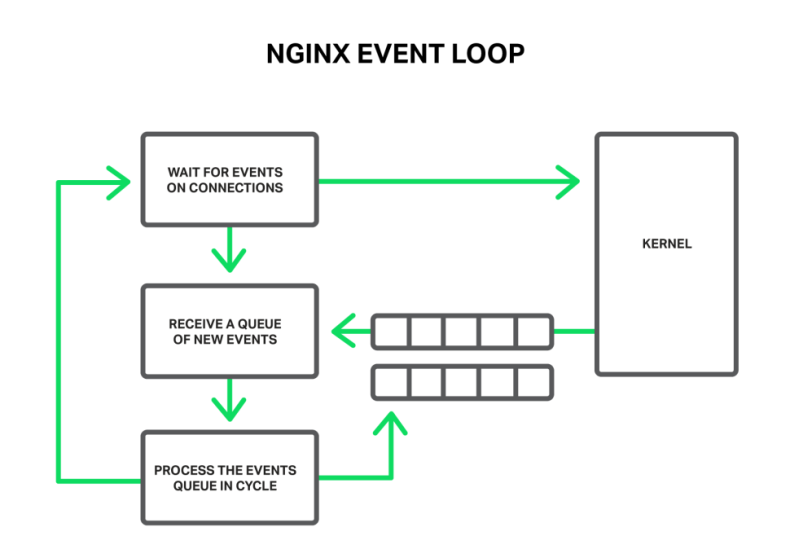
이벤트에는 시간 초과, 읽기 또는 쓰기 준비가 된 소켓에 대한 알림, 발생한 오류에 대한 알림 등이 포함될 수 있습니다. NGINX는 여러 이벤트를 수신한 다음 필요한 작업을 수행하면서 하나씩 처리합니다. 따라서 모든 처리는 단일 스레드에서 큐를 순회하는 간단한 루프를 통해 이루어집니다. NGINX는 큐에서 이벤트를 하나 꺼낸 다음, 예를 들어 소켓에 데이터를 쓰거나 소켓에서 데이터를 읽는 방식으로 해당 이벤트에 대응합니다. 대부분의 경우 이 작업은 매우 빠르게 처리되며(메모리에서 일부 데이터를 복사하는 데 몇 번의 CPU 사이클만 필요할 수도 있음), NGINX는 큐에 있는 모든 이벤트를 순식간에 처리합니다.
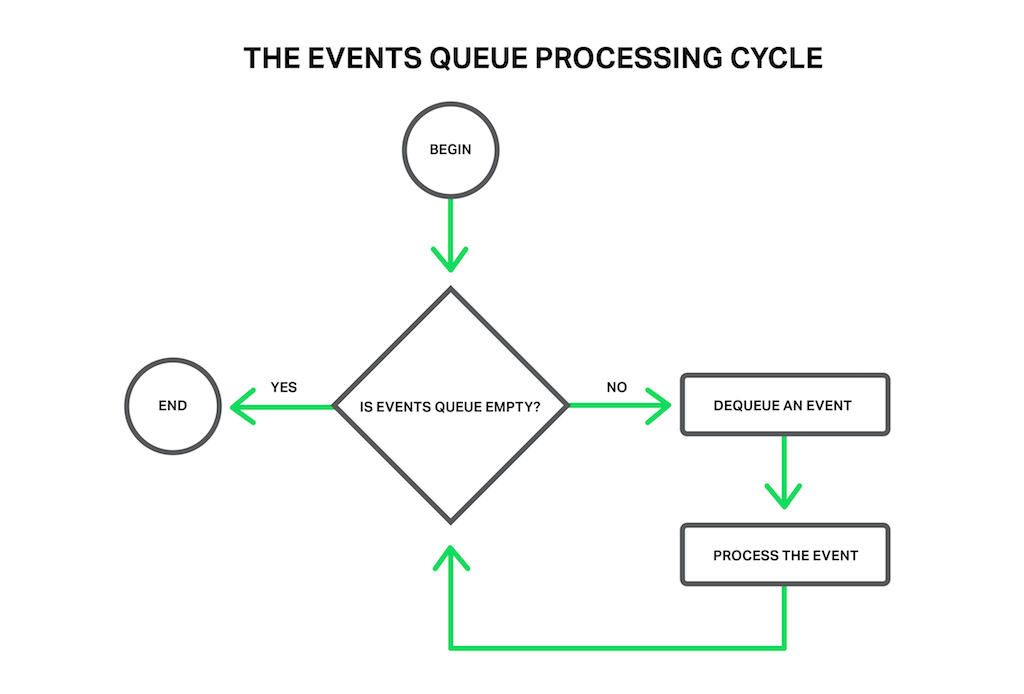
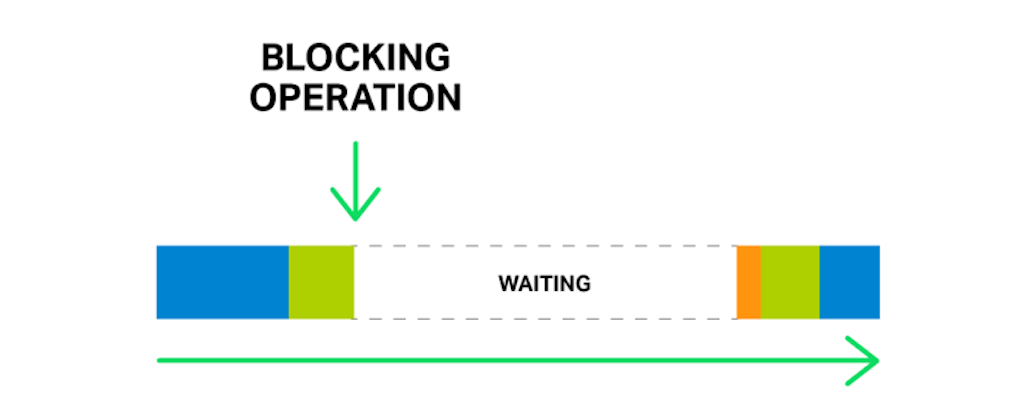
하지만 시간이 오래 걸리고 부하가 큰 작업이 발생하면 어떻게 될까요? 전체 이벤트 처리 사이클은 이 작업이 끝날 때까지 기다리느라 멈추게 됩니다.
따라서 “블로킹 작업”이란 이벤트 처리 주기를 상당 시간 중단시키는 모든 작업을 의미합니다. 작업이 블로킹되는 이유는 다양합니다. 예를 들어 NGINX가 시간이 오래 걸리고 CPU를 많이 사용하는 처리를 수행 중이거나, 리소스에 액세스하기 위해 대기해야 할 수 있습니다(예: 하드 드라이브, 뮤텍스 또는 데이터베이스에서 동기 방식으로 응답을 가져오는 라이브러리 함수 호출 등). 핵심은 이러한 작업을 처리하는 동안 워커 프로세스가 다른 어떤 작업도 수행할 수 없고 다른 이벤트도 처리할 수 없다는 점입니다. 이는 사용 가능한 시스템 리소스가 더 있고 대기열의 일부 이벤트가 해당 리소스를 활용할 수 있는 경우에도 마찬가지입니다.
매장 직원 한 명 앞에 긴 줄이 늘어서 있는 상황을 상상해 보세요. 줄 맨 앞에 있는 사람이 매장에는 없고 창고에만 있는 물건을 요청합니다. 직원은 물건을 가져오기 위해 창고로 갑니다. 이제 줄을 선 모든 사람은 그 물건이 도착할 때까지 몇 시간이나 기다려야 하므로 불만이 쌓입니다. 사람들의 반응이 어떨지 상상이 되시나요? 줄을 선 모든 사람의 대기 시간이 몇 시간씩 늘어나지만, 정작 그들이 사려는 물건은 매장에 바로 있을 수도 있습니다.
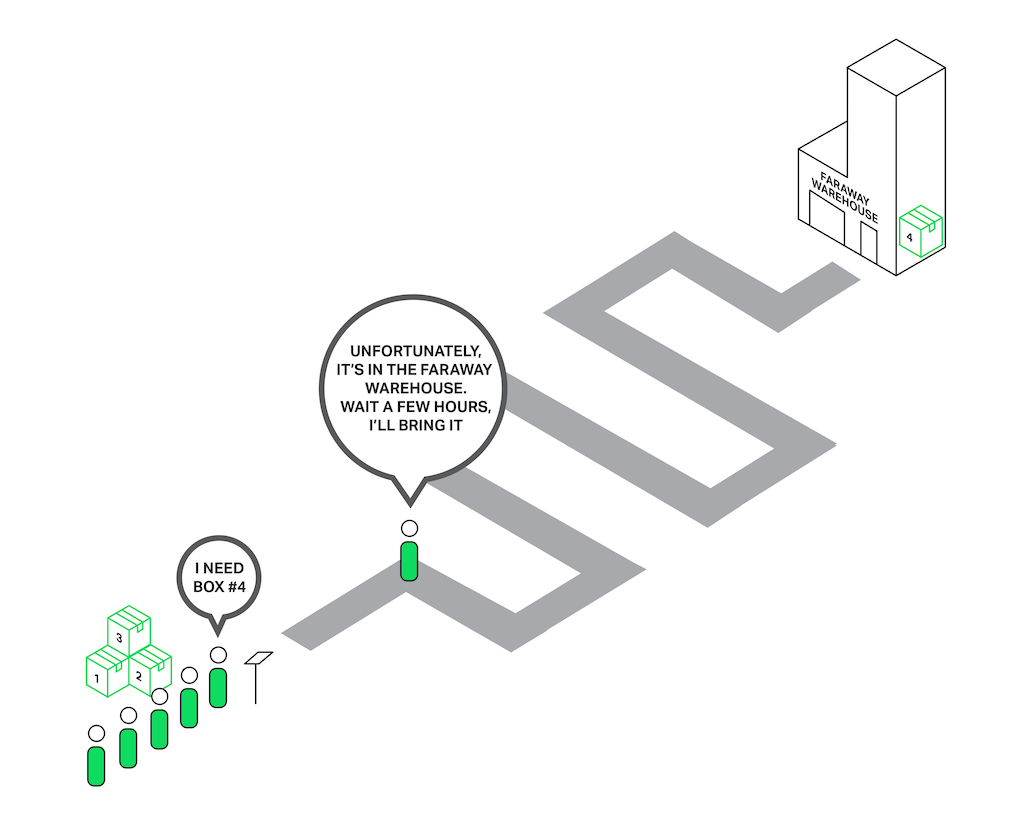
NGINX가 메모리에 캐시되어 있지 않아 디스크에서 읽어야 하는 파일을 요청할 때도 거의 같은 상황이 발생합니다. 하드 드라이브는 느리며(특히 회전식 하드 드라이브), 대기열에 있는 다른 요청은 드라이브에 액세스할 필요가 없을 수도 있지만 어쩔 수 없이 기다려야 합니다. 그 결과 지연 시간이 늘어나고 시스템 리소스가 충분히 활용되지 못합니다.
일부 운영 체제는 파일을 읽고 전송하기 위한 비동기 인터페이스를 제공하며, NGINX는 이 인터페이스를 사용할 수 있습니다(aio 지시어 참조). FreeBSD가 대표적인 예입니다. 안타깝게도 Linux는 그렇지 않습니다. Linux도 파일 읽기를 위한 일종의 비동기 인터페이스를 제공하지만, 몇 가지 중대한 단점이 있습니다. 그중 하나는 파일 액세스와 버퍼에 대한 정렬 요구 사항이지만, NGINX는 이를 잘 처리합니다. 그러나 두 번째 문제는 더 심각합니다. 비동기 인터페이스를 사용하려면 파일 디스크립터에 O_DIRECT 플래그를 설정해야 합니다. 이는 파일에 액세스할 때마다 메모리 캐시를 우회하여 하드 디스크의 부하가 증가한다는 뜻입니다. 따라서 많은 경우에 적합한 방식이라고 할 수 없습니다.
특히 이 문제를 해결하기 위해 NGINX 1.7.11과 NGINX Plus 릴리스 7에 스레드 풀이 도입되었습니다.
이제 스레드 풀이 무엇이며 어떻게 작동하는지 자세히 살펴보겠습니다.
스레드 풀
멀리 떨어진 창고에서 상품을 가져오는 불쌍한 판매 직원 이야기로 돌아가 보겠습니다. 하지만 그는 이제 더 현명해져서(화가 난 고객들에게 몰매를 맞고 정신을 차린 걸까요?) 배송 서비스를 고용했습니다. 이제 누군가 멀리 있는 창고의 상품을 요청하면 직접 창고에 가는 대신 배송 서비스에 주문을 맡깁니다. 배송 서비스가 주문을 처리하는 동안 판매 직원은 다른 고객들을 계속 응대할 수 있습니다. 따라서 매장에 상품이 없는 고객들만 배송을 기다리면 되고, 나머지 고객들은 즉시 서비스를 받을 수 있습니다.
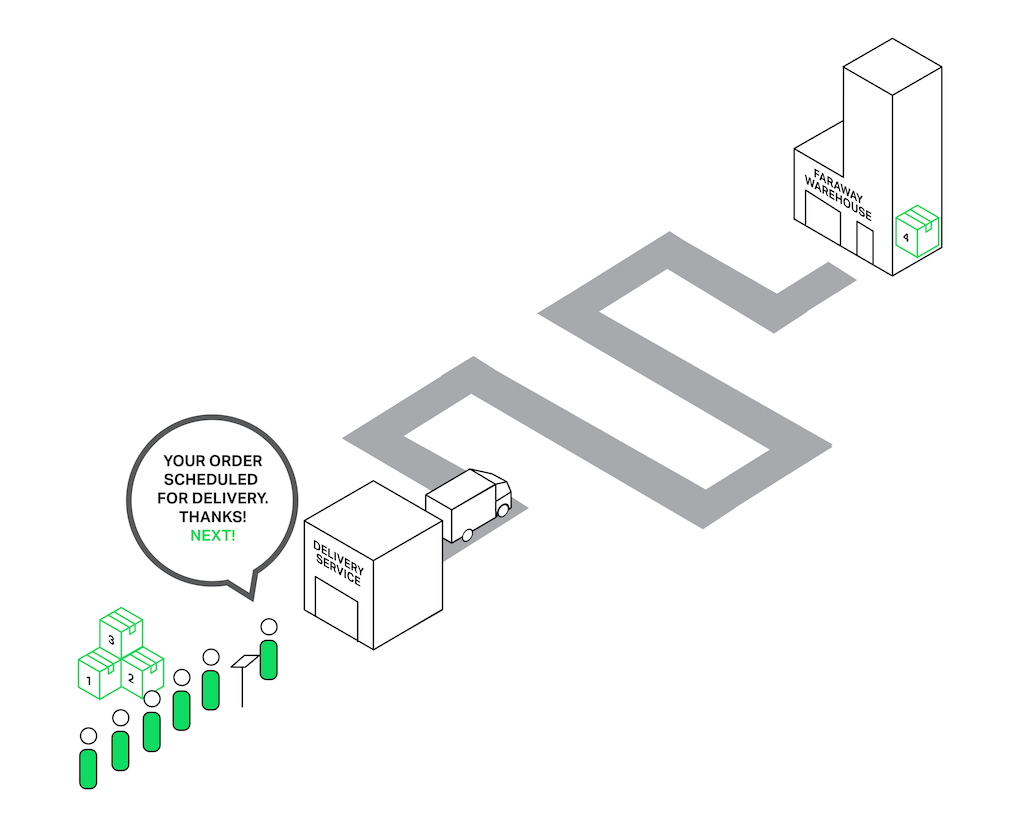
NGINX에서 스레드 풀은 배달 서비스와 같은 역할을 합니다. 스레드 풀은 작업 큐와 이 큐를 처리하는 여러 스레드로 구성됩니다. 워커 프로세스가 오래 걸릴 수 있는 작업을 수행해야 할 때는 해당 작업을 직접 처리하는 대신 풀의 큐에 넣으며, 그러면 유휴 상태인 스레드가 이를 가져와 처리할 수 있습니다.
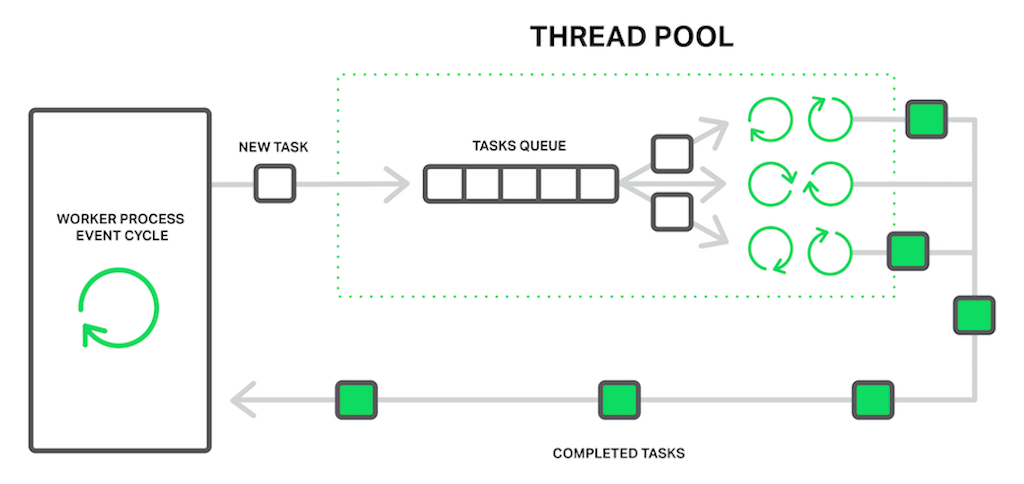
그렇다면 또 다른 큐가 있는 셈입니다. 맞습니다. 하지만 이 경우 큐는 특정 리소스의 성능에 의해 제한됩니다. 드라이브가 데이터를 제공할 수 있는 속도보다 더 빠르게 데이터를 읽을 수는 없습니다. 이제 적어도 드라이브 때문에 다른 이벤트의 처리가 지연되지는 않으며, 파일에 액세스해야 하는 요청만 대기하게 됩니다.
“디스크에서 읽기” 작업은 블로킹 작업의 가장 일반적인 예로 자주 사용되지만, 실제로 NGINX의 스레드 풀 구현은 메인 작업 사이클에서 처리하기에 적합하지 않은 모든 작업에 사용할 수 있습니다.
현재 스레드 풀로의 오프로딩은 세 가지 핵심 작업에만 구현되어 있습니다. 대부분의 운영 체제에서 사용하는 read() 시스템 호출, Linux의 sendfile(), 그리고 캐시용 파일과 같은 일부 임시 파일을 쓸 때 사용하는 Linux의 aio_write()입니다. 앞으로도 이 구현을 계속 테스트하고 벤치마킹할 예정이며, 명확한 이점이 있다면 향후 릴리스에서 다른 작업도 스레드 풀로 오프로딩할 수 있습니다.
편집자 주 – aio_write() 시스템 호출 지원은 NGINX 1.9.13 및 NGINX Plus R9에서 추가되었습니다.
벤치마킹
이제 이론에서 실전으로 넘어갈 차례입니다. 스레드 풀 사용의 효과를 보여주기 위해 블로킹 작업과 논블로킹 작업이 최악의 조합으로 섞인 상황을 시뮬레이션하는 합성 벤치마크를 수행하겠습니다.
이를 위해서는 메모리에 절대 다 들어가지 않는 데이터 세트가 필요합니다. RAM이 48 GB인 머신에서 4 MB 파일로 구성된 256 GB의 무작위 데이터를 생성한 다음, NGINX 1.9.0이 이를 제공하도록 구성했습니다.
구성은 매우 간단합니다:
worker_processes 16;
events {
    accept_mutex off;
}

http {
    include mime.types;
    default_type application/octet-stream;

    access_log off;
    sendfile on;
    sendfile_max_chunk 512k;

    server {
        listen 8000;

        location / {
            root /storage;
        }
    }
}
보시다시피 성능을 향상하기 위해 몇 가지 조정을 적용했습니다. logging과 accept_mutex는 비활성화하고, sendfile은 활성화했으며, sendfile_max_chunk를 설정했습니다. 마지막 지시어는 NGINX가 전체 파일을 한 번에 전송하지 않고 512KB 단위로 나누어 전송하도록 하므로, 블로킹 sendfile() 호출에 소요되는 최대 시간을 줄일 수 있습니다.
이 시스템에는 Intel Xeon E5645 프로세서 2개(총 12개 코어, 24개 HT 스레드)와 10Gbps 네트워크 인터페이스가 탑재되어 있습니다. 디스크 서브시스템은 RAID10 어레이로 구성된 Western Digital WD1003FBYX 하드 드라이브 4개로 이루어져 있습니다. 이 모든 하드웨어는 Ubuntu Server 14.04.1 LTS에서 구동됩니다.
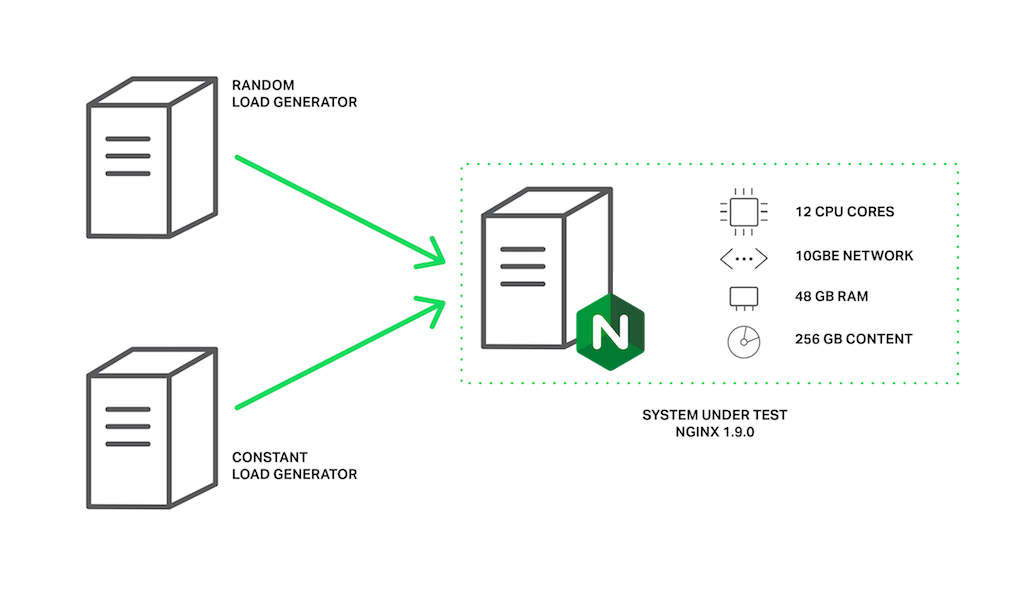
클라이언트는 사양이 동일한 두 대의 머신으로 구성됩니다. 이 중 한 머신에서는 wrk가 Lua 스크립트를 사용하여 부하를 생성합니다. 이 스크립트는 200개의 병렬 연결을 사용해 서버에 있는 파일을 무작위 순서로 요청하며, 각 요청은 캐시 미스와 디스크의 블로킹 읽기를 유발할 가능성이 높습니다. 이 부하를 무작위 부하라고 하겠습니다.
두 번째 클라이언트 머신에서는 wrk의 또 다른 인스턴스를 실행하여 50개의 병렬 연결로 동일한 파일을 반복해서 요청합니다. 이 파일은 자주 액세스되므로 항상 메모리에 유지됩니다. 일반적인 상황이라면 NGINX가 이러한 요청을 매우 빠르게 처리하지만, 워커 프로세스가 다른 요청으로 인해 차단되면 성능이 저하됩니다. 이 부하를 일정 부하라고 하겠습니다.
성능은 ifstat을 사용하여 서버 머신의 처리량을 모니터링하고 두 번째 클라이언트에서 wrk 결과를 수집하여 측정합니다.
이제 스레드 풀 없이 처음 실행해 보면 그다지 인상적인 결과는 나오지 않습니다:
% ifstat -bi eth2eth2
Kbps in  Kbps out
5531.24  1.03e+06
4855.23  812922.7
5994.66  1.07e+06
5476.27  981529.3
6353.62  1.12e+06
5166.17  892770.3
5522.81  978540.8
6208.10  985466.7
6370.79  1.12e+06
6123.33  1.07e+06
보시다시피 이 구성에서는 서버가 총 약 1 Gbps의 트래픽을 생성할 수 있습니다. top의 출력에서 모든 워커 프로세스가 대부분의 시간을 블로킹 I/O에 소비하고 있음을 확인할 수 있습니다(프로세스가 D 상태임):
top - 10:40:47 up 11 days,  1:32,  1 user,  load average: 49.61, 45.77 62.89Tasks: 375 total,  2 running, 373 sleeping,  0 stopped,  0 zombie
%Cpu(s):  0.0 us,  0.3 sy,  0.0 ni, 67.7 id, 31.9 wa,  0.0 hi,  0.0 si,  0.0 st
KiB Mem:  49453440 total, 49149308 used,   304132 free,    98780 buffers
KiB Swap: 10474236 total,    20124 used, 10454112 free, 46903412 cached Mem

  PID USER     PR  NI    VIRT    RES     SHR S  %CPU %MEM    TIME+ COMMAND
 4639 vbart    20   0   47180  28152     496 D   0.7  0.1  0:00.17 nginx
 4632 vbart    20   0   47180  28196     536 D   0.3  0.1  0:00.11 nginx
 4633 vbart    20   0   47180  28324     540 D   0.3  0.1  0:00.11 nginx
 4635 vbart    20   0   47180  28136     480 D   0.3  0.1  0:00.12 nginx
 4636 vbart    20   0   47180  28208     536 D   0.3  0.1  0:00.14 nginx
 4637 vbart    20   0   47180  28208     536 D   0.3  0.1  0:00.10 nginx
 4638 vbart    20   0   47180  28204     536 D   0.3  0.1  0:00.12 nginx
 4640 vbart    20   0   47180  28324     540 D   0.3  0.1  0:00.13 nginx
 4641 vbart    20   0   47180  28324     540 D   0.3  0.1  0:00.13 nginx
 4642 vbart    20   0   47180  28208     536 D   0.3  0.1  0:00.11 nginx
 4643 vbart    20   0   47180  28276     536 D   0.3  0.1  0:00.29 nginx
 4644 vbart    20   0   47180  28204     536 D   0.3  0.1  0:00.11 nginx
 4645 vbart    20   0   47180  28204     536 D   0.3  0.1  0:00.17 nginx
 4646 vbart    20   0   47180  28204     536 D   0.3  0.1  0:00.12 nginx
 4647 vbart    20   0   47180  28208     532 D   0.3  0.1  0:00.17 nginx
 4631 vbart    20   0   47180    756     252 S   0.0  0.1  0:00.00 nginx
 4634 vbart    20   0   47180  28208     536 D   0.0  0.1  0:00.11 nginx< 4648 vbart 20 0 25232 1956 1160 R 0.0 0.0 0:00.08 top
25921 vbart    20   0  121956   2232    1056 S   0.0  0.0  0:01.97 sshd
25923 vbart    20   0   40304   4160    2208 S   0.0  0.0  0:00.53 zsh
이 경우 처리량은 디스크 하위 시스템의 성능에 의해 제한되며, CPU는 대부분의 시간 동안 유휴 상태입니다. wrk의 결과도 매우 낮습니다:
Running 1m test @ http://192.0.2.1:8000/1/1/1  12 threads and 50 connections
  Thread Stats   Avg    Stdev     Max  +/- Stdev
    Latency     7.42s  5.31s   24.41s   74.73%
    Req/Sec     0.15    0.36     1.00    84.62%
  488 requests in 1.01m, 2.01GB read
Requests/sec:      8.08
Transfer/sec:     34.07MB
그리고 이 결과는 메모리에서 제공되어야 하는 파일에 대한 것임을 기억하세요! 지연 시간이 지나치게 긴 이유는 모든 워커 프로세스가 첫 번째 클라이언트의 200개 연결로 생성된 무작위 부하를 처리하기 위해 드라이브에서 파일을 읽느라 바빠서, 우리의 요청을 제때 처리하지 못하기 때문입니다.
이제 스레드 풀을 활용할 차례입니다. 이를 위해 aio threads 지시어를 location 블록에 추가하기만 하면 됩니다:
location / {    root /storage;
    aio threads;
}
그런 다음 NGINX에 구성을 다시 로드하도록 요청합니다.
그런 다음 테스트를 다시 실행합니다:
% ifstat -bi eth2eth2
Kbps in  Kbps out
60915.19  9.51e+06
59978.89  9.51e+06
60122.38  9.51e+06
61179.06  9.51e+06
61798.40  9.51e+06
57072.97  9.50e+06
56072.61  9.51e+06
61279.63  9.51e+06
61243.54  9.51e+06
59632.50  9.50e+06
이제 서버의 처리량은 9.5 Gbps로, 스레드 풀을 사용하지 않았을 때의 약 1 Gbps보다 크게 향상되었습니다!
아마 더 높은 성능을 낼 수도 있겠지만, 이미 실질적인 최대 네트워크 용량에 도달했으므로 이 테스트에서 NGINX의 성능은 네트워크 인터페이스에 의해 제한됩니다. 워커 프로세스는 대부분의 시간을 유휴 상태로 새 이벤트를 기다리며 보냅니다(S 상태로 top에 표시됨):
top - 10:43:17 up 11 days,  1:35,  1 user,  load average: 172.71, 93.84, 77.90Tasks: 376 total,  1 running, 375 sleeping,  0 stopped,  0 zombie
%Cpu(s):  0.2 us,  1.2 sy,  0.0 ni, 34.8 id, 61.5 wa,  0.0 hi,  2.3 si,  0.0 st
KiB Mem:  49453440 total, 49096836 used,   356604 free,    97236 buffers
KiB Swap: 10474236 total,    22860 used, 10451376 free, 46836580 cached Mem

  PID USER     PR  NI    VIRT    RES     SHR S  %CPU %MEM    TIME+ COMMAND
 4654 vbart    20   0  309708  28844     596 S   9.0  0.1  0:08.65 nginx
 4660 vbart    20   0  309748  28920     596 S   6.6  0.1  0:14.82 nginx
 4658 vbart    20   0  309452  28424     520 S   4.3  0.1  0:01.40 nginx
 4663 vbart    20   0  309452  28476     572 S   4.3  0.1  0:01.32 nginx
 4667 vbart    20   0  309584  28712     588 S   3.7  0.1  0:05.19 nginx
 4656 vbart    20   0  309452  28476     572 S   3.3  0.1  0:01.84 nginx
 4664 vbart    20   0  309452  28428     524 S   3.3  0.1  0:01.29 nginx
 4652 vbart    20   0  309452  28476     572 S   3.0  0.1  0:01.46 nginx
 4662 vbart    20   0  309552  28700     596 S   2.7  0.1  0:05.92 nginx
 4661 vbart    20   0  309464  28636     596 S   2.3  0.1  0:01.59 nginx
 4653 vbart    20   0  309452  28476     572 S   1.7  0.1  0:01.70 nginx
 4666 vbart    20   0  309452  28428     524 S   1.3  0.1  0:01.63 nginx
 4657 vbart    20   0  309584  28696     592 S   1.0  0.1  0:00.64 nginx
 4655 vbart    20   0  30958   28476     572 S   0.7  0.1  0:02.81 nginx
 4659 vbart    20   0  309452  28468     564 S   0.3  0.1  0:01.20 nginx
 4665 vbart    20   0  309452  28476     572 S   0.3  0.1  0:00.71 nginx 5180 vbart 20 0 25232 1952 1156 R 0.0 0.0 0:00.45 top
 4651 vbart    20   0   20032    752     252 S   0.0  0.0  0:00.00 nginx
25921 vbart    20   0  121956   2176    1000 S   0.0  0.0  0:01.98 sshd
25923 vbart    20   0   40304   3840    2208 S   0.0  0.0  0:00.54 zsh
CPU 리소스는 여전히 충분합니다.
The results of wrk의 결과:
Running 1m test @ http://192.0.2.1:8000/1/1/1  12 threads and 50 connections
  Thread Stats   Avg      Stdev     Max  +/- Stdev
    Latency   226.32ms  392.76ms   1.72s   93.48%
    Req/Sec    20.02     10.84    59.00    65.91%
  15045 requests in 1.00m, 58.86GB read
Requests/sec:    250.57
Transfer/sec:      0.98GB
4MB 파일을 제공하는 데 걸리는 평균 시간이 7.42초에서 226.32밀리초로 단축되었고(33배 감소), 초당 요청 수도 31배(8건에서 250건으로) 증가했습니다!
그 이유는 워커 프로세스가 읽기 작업으로 인해 블로킹된 동안 요청이 처리를 위해 이벤트 큐에서 더 이상 대기하지 않고, 유휴 스레드에 의해 처리되기 때문입니다. 디스크 하위 시스템이 첫 번째 클라이언트 머신의 무작위 부하를 처리하는 데 최선을 다하는 동안, NGINX는 나머지 CPU 리소스와 네트워크 용량을 사용하여 메모리에서 두 번째 클라이언트의 요청을 처리합니다.
여전히 만능 해결책은 아니다
블로킹 작업에 대한 온갖 우려와 몇 가지 고무적인 결과를 접하고 나니, 아마 여러분 대부분은 벌써 서버에 스레드 풀을 구성하려고 할 것입니다. 하지만 서두르지 마세요.
다행히도 대부분의 파일 읽기 및 전송 작업은 느린 하드 드라이브를 직접 다루지 않습니다. 데이터 세트를 저장할 만큼 RAM이 충분하다면 운영 체제가 자주 사용하는 파일을 이른바 “페이지 캐시”에 알아서 캐싱합니다.
페이지 캐시는 매우 효율적으로 작동하므로 NGINX는 거의 모든 일반적인 사용 사례에서 뛰어난 성능을 발휘할 수 있습니다. 페이지 캐시에서 데이터를 읽는 속도는 상당히 빠르기 때문에 이러한 작업을 “블로킹”이라고 할 수는 없습니다. 반면, 스레드 풀로 작업을 넘기면 어느 정도 오버헤드가 발생합니다.
따라서 RAM 용량이 충분하고 작업 데이터 세트가 그리 크지 않다면, NGINX는 스레드 풀을 사용하지 않아도 이미 가장 최적의 방식으로 작동합니다.
읽기 작업을 스레드 풀로 오프로드하는 기법은 매우 특정한 작업에 적용할 수 있습니다. 자주 요청되는 콘텐츠의 양이 운영 체제의 VM 캐시에 들어가지 않을 때 가장 유용합니다. 예를 들어 부하가 높은 NGINX 기반 스트리밍 미디어 서버가 이에 해당할 수 있습니다. 이것이 바로 벤치마크에서 시뮬레이션한 상황입니다.
읽기 작업을 스레드 풀로 오프로딩하는 방식을 개선할 수 있다면 좋을 것입니다. 필요한 파일 데이터가 메모리에 있는지 효율적으로 확인하고, 메모리에 없는 경우에만 읽기 작업을 별도의 스레드로 오프로딩하면 됩니다.
판매 비유로 돌아가 보면, 현재 판매원은 요청받은 상품이 매장에 있는지 알 수 없으므로 모든 주문을 항상 배송 서비스에 넘기거나 언제나 직접 처리해야 합니다.
문제의 원인은 운영 체제에 이 기능이 없다는 것입니다. 2010년에 이를 fincore() 시스템 호출로 Linux에 추가하려는 첫 시도가 있었지만 성사되지 않았습니다. 이후 preadv2()라는 새로운 시스템 호출에 RWF_NONBLOCK 플래그를 사용하는 방식으로 구현하려는 시도가 여러 차례 있었습니다(자세한 내용은 LWN.net의 「비차단 버퍼링 파일 읽기 작업」 및 「비동기 버퍼링 읽기 작업」 참조). 이 모든 패치의 운명은 여전히 불투명합니다. 안타까운 점은 이 패치들이 아직 커널에 받아들여지지 않은 주된 이유가 끊임없는 사소한 논쟁인 것으로 보인다는 것입니다.
반면 FreeBSD 사용자는 전혀 걱정할 필요가 없습니다. FreeBSD에는 이미 파일 읽기를 위한 충분히 훌륭한 비동기 인터페이스가 있으므로 스레드 풀 대신 이를 사용해야 합니다.
스레드 풀 구성
따라서 사용 사례에서 스레드 풀을 활용해 이점을 얻을 수 있다고 확신한다면, 이제 구성에 대해 자세히 살펴볼 차례입니다.
구성은 매우 쉽고 유연합니다. 먼저 --with-threads 인수를 configure 명령에 지정하여 컴파일한 NGINX 버전 1.7.11 이상이 필요합니다. NGINX Plus 사용자는 릴리스 7 이상이 필요합니다. 가장 간단한 경우 구성은 매우 단순합니다. 적절한 컨텍스트에 aio threads 지시어를 포함하기만 하면 됩니다:
# in the 'http', 'server', or 'location' contextaio threads;이는 스레드 풀에 가능한 최소 구성입니다. 실제로는 다음 구성을 축약한 것입니다:
# in the 'main' contextthread_pool default threads=32 max_queue=65536;

# in the 'http', 'server', or 'location' context
aio threads=default;
이 설정은 default라는 스레드 풀을 정의하며, 32개의 작업 스레드와 최대 65,536개의 작업을 수용할 수 있는 작업 큐를 지정합니다. 작업 큐가 과부하되면 NGINX는 요청을 거부하고 다음 오류를 기록합니다:
thread pool "NAME" queue overflow: N tasks waiting이 오류는 작업이 큐에 추가되는 속도만큼 스레드가 빠르게 작업을 처리하지 못할 수 있음을 의미합니다. 최대 큐 크기를 늘려 볼 수 있지만, 그래도 문제가 해결되지 않는다면 시스템이 그렇게 많은 요청을 처리할 수 없다는 뜻입니다.
이미 확인하셨듯이 thread_pool 지시어를 사용하면 스레드 수, 큐의 최대 길이, 특정 스레드 풀의 이름을 설정할 수 있습니다. 마지막 항목은 여러 개의 독립적인 스레드 풀을 설정하고 구성 파일의 서로 다른 위치에서 각기 다른 용도로 사용할 수 있음을 의미합니다:
# in the 'main' context
thread_pool one threads=128 max_queue=0;
thread_pool two threads=32;

http {
    server {
        location /one {
            aio threads=one;
        }

        location /two {
            aio threads=two;
        }

    }
    # ...
}
If the max_queue 매개변수를 지정하지 않으면 기본값으로 65536이 사용됩니다. 위와 같이 max_queue를 0으로 설정할 수도 있습니다. 이 경우 스레드 풀은 구성된 스레드 수만큼의 작업만 처리할 수 있으며, 대기열에서 대기하는 작업은 없습니다.
이제 하드 드라이브가 3개 장착된 서버가 있고, 이 서버를 백엔드의 모든 응답을 캐시하는 ‘캐싱 프록시’로 사용하려 한다고 가정해 보겠습니다. 예상되는 캐시 데이터의 양은 사용 가능한 RAM 용량을 훨씬 초과합니다. 사실상 개인 CDN을 위한 캐싱 노드인 셈입니다. 물론 이 경우 가장 중요한 것은 드라이브의 성능을 최대한 끌어내는 것입니다.
한 가지 방법은 RAID 어레이를 구성하는 것입니다. 이 접근 방식에는 장단점이 있습니다. 이제 NGINX를 사용하면 다른 방법을 선택할 수도 있습니다:
# We assume that each of the hard drives is mounted on one of these directories:# /mnt/disk1, /mnt/disk2, or /mnt/disk3

# in the 'main' context
thread_pool pool_1 threads=16;
thread_pool pool_2 threads=16;
thread_pool pool_3 threads=16;

http {
    proxy_cache_path /mnt/disk1 levels=1:2 keys_zone=cache_1:256m max_size=1024G
                     use_temp_path=off;
    proxy_cache_path /mnt/disk2 levels=1:2 keys_zone=cache_2:256m max_size=1024G
                     use_temp_path=off;
    proxy_cache_path /mnt/disk3 levels=1:2 keys_zone=cache_3:256m max_size=1024G
                     use_temp_path=off;

    split_clients $request_uri $disk {
        33.3%     1;
        33.3%     2;
        *         3;
    }

    server {
        # ...
        location / {
            proxy_pass http://backend;
            proxy_cache_key $request_uri;
            proxy_cache cache_$disk;
            aio threads=pool_$disk;
            sendfile on;
        }
    }
}
이 구성에서 thread_pool 지시어는 각 디스크에 전용 독립 스레드 풀을 정의하고, proxy_cache_path 지시어는 각 디스크에 전용 독립 캐시를 정의합니다.
The split_clients 모듈은 캐시 간(따라서 디스크 간) 부하 분산에 사용되며, 이 작업에 매우 적합합니다.
The use_temp_path=off 매개변수는 proxy_cache_path 지시어에 지정되며, NGINX가 임시 파일을 해당 캐시 데이터가 있는 디렉터리와 동일한 디렉터리에 저장하도록 합니다. 이는 캐시를 업데이트할 때 하드 드라이브 간에 응답 데이터가 복사되는 것을 방지하는 데 필요합니다.
이러한 모든 설정을 통해 현재 디스크 하위 시스템의 성능을 최대한 끌어낼 수 있습니다. NGINX가 별도의 스레드 풀을 통해 각 드라이브와 병렬로 독립적으로 상호 작용하기 때문입니다. 각 드라이브는 파일 읽기 및 전송을 위한 전용 작업 큐가 있는 16개의 독립적인 스레드로 처리됩니다.
고객들은 이런 맞춤형 접근 방식을 분명 좋아할 것입니다. 하드 드라이브도 마찬가지로 좋아할 수 있도록 하세요.
이 예는 특정 하드웨어에 맞게 NGINX를 얼마나 유연하게 조정할 수 있는지를 잘 보여 줍니다. 이는 마치 시스템 및 데이터 세트와 상호 작용하는 최적의 방법을 NGINX에 알려 주는 것과 같습니다. 또한 사용자 공간에서 NGINX를 세밀하게 조정하면 소프트웨어, 운영 체제, 하드웨어가 최적의 방식으로 함께 작동하여 모든 시스템 리소스를 최대한 효율적으로 활용하도록 할 수 있습니다.
결론
요약하자면, 스레드 풀은 NGINX의 오랜 숙적이자 잘 알려진 문제인 블로킹을 제거함으로써, 특히 매우 방대한 양의 콘텐츠를 처리할 때 NGINX의 성능을 한 차원 높여 주는 훌륭한 기능입니다.
그리고 앞으로 더 많은 가능성이 열릴 것입니다. 앞서 언급했듯이, 이 완전히 새로운 인터페이스를 사용하면 성능 저하 없이 시간이 오래 걸리는 모든 블로킹 작업을 잠재적으로 오프로딩할 수 있습니다. 이를 통해 NGINX에는 수많은 새로운 모듈과 기능을 도입할 수 있는 새로운 지평이 열립니다. 널리 사용되는 많은 라이브러리는 여전히 비동기 논블로킹 인터페이스를 제공하지 않으며, 이 때문에 이전에는 NGINX와 함께 사용할 수 없었습니다. 특정 라이브러리의 논블로킹 프로토타입을 직접 개발하는 데 많은 시간과 자원을 들일 수도 있지만, 과연 언제나 그만한 가치가 있을까요? 이제 스레드 풀이 도입되면서 이러한 라이브러리를 비교적 쉽게 활용할 수 있으며, 성능에 영향을 주지 않고 관련 모듈을 만들 수 있습니다.
계속 지켜봐 주세요.
NGINX Plus의 스레드 풀을 직접 사용해 보세요. 지금 30일 무료 체험을 시작하거나 사용 사례에 대해 논의하려면 문의해 주세요.
관련 블로그 게시물

시청하기: KubeCon North America 2023에서의 NGINX Gateway Fabric
이 영상에서는 KubeCon의 NGINX 부스를 찾아가, 저희가 공개한 Kubernetes Gateway API 구현을 살펴봅니다.
F5 NGINX로 대규모 WAF 플릿을 확인하고 관리하는 2가지 방법
앱 보안을 강화하는 두 가지 방법을 소개합니다. NGINX Management Suite를 통해 WAF 운영에 대한 가시성을 높이고, NGINX App Protect WAF를 활용해 코드형 보안을 구현하는 것입니다.
Ingress 컨트롤러 선택 가이드, 4부: NGINX Ingress Controller 옵션
개발 주체, 개발 철학, 프로덕션 환경 준비도, 보안 및 지원을 기준으로 어떤 NGINX Ingress 컨트롤러가 가장 적합한지 알아보세요.
진화하는 공격 환경에 NGINX App Protect Denial of Service가 적응하는 방법
NGINX App Protect Denial of Service(DoS)가 계층 7 DoS 공격을 방어하기 위해 완화 방법을 실시간으로 조정하는 방식을 설명합니다. 정상적인 사용자 행동과 서버 상태에 대한 모델을 생성하여 공격을 나타내는 이상 징후를 감지하고 맞춤형 완화 시그니처를 적용할 수 있습니다.
NGINX Instance Manager를 활용한 대규모 구성 업데이트 및 인증서 관리
NGINX Instance Manager 버전 1.0에는 두 가지 새로운 기능이 도입되었습니다. NGINX 인스턴스에 태그와 사용자 역할을 지정하면 전체 그룹에 구성을 한 번에 적용할 수 있습니다. 인증서 검사는 만료 예정인 인증서를 감지하여 서비스 중단을 방지할 수 있도록 인증서를 교체할 수 있게 해줍니다.
Netflix가 자사 CDN의 핵심으로 NGINX를 선택한 이유
Netflix가 글로벌 콘텐츠 전송 네트워크인 Open Connect의 스트리밍 미디어 기술로 NGINX를 선택한 이유를 NGINX 개발자 Gleb Smirnoff에게서 알아보세요.