ADC02 Falta de tolerancia a fallos y resiliencia
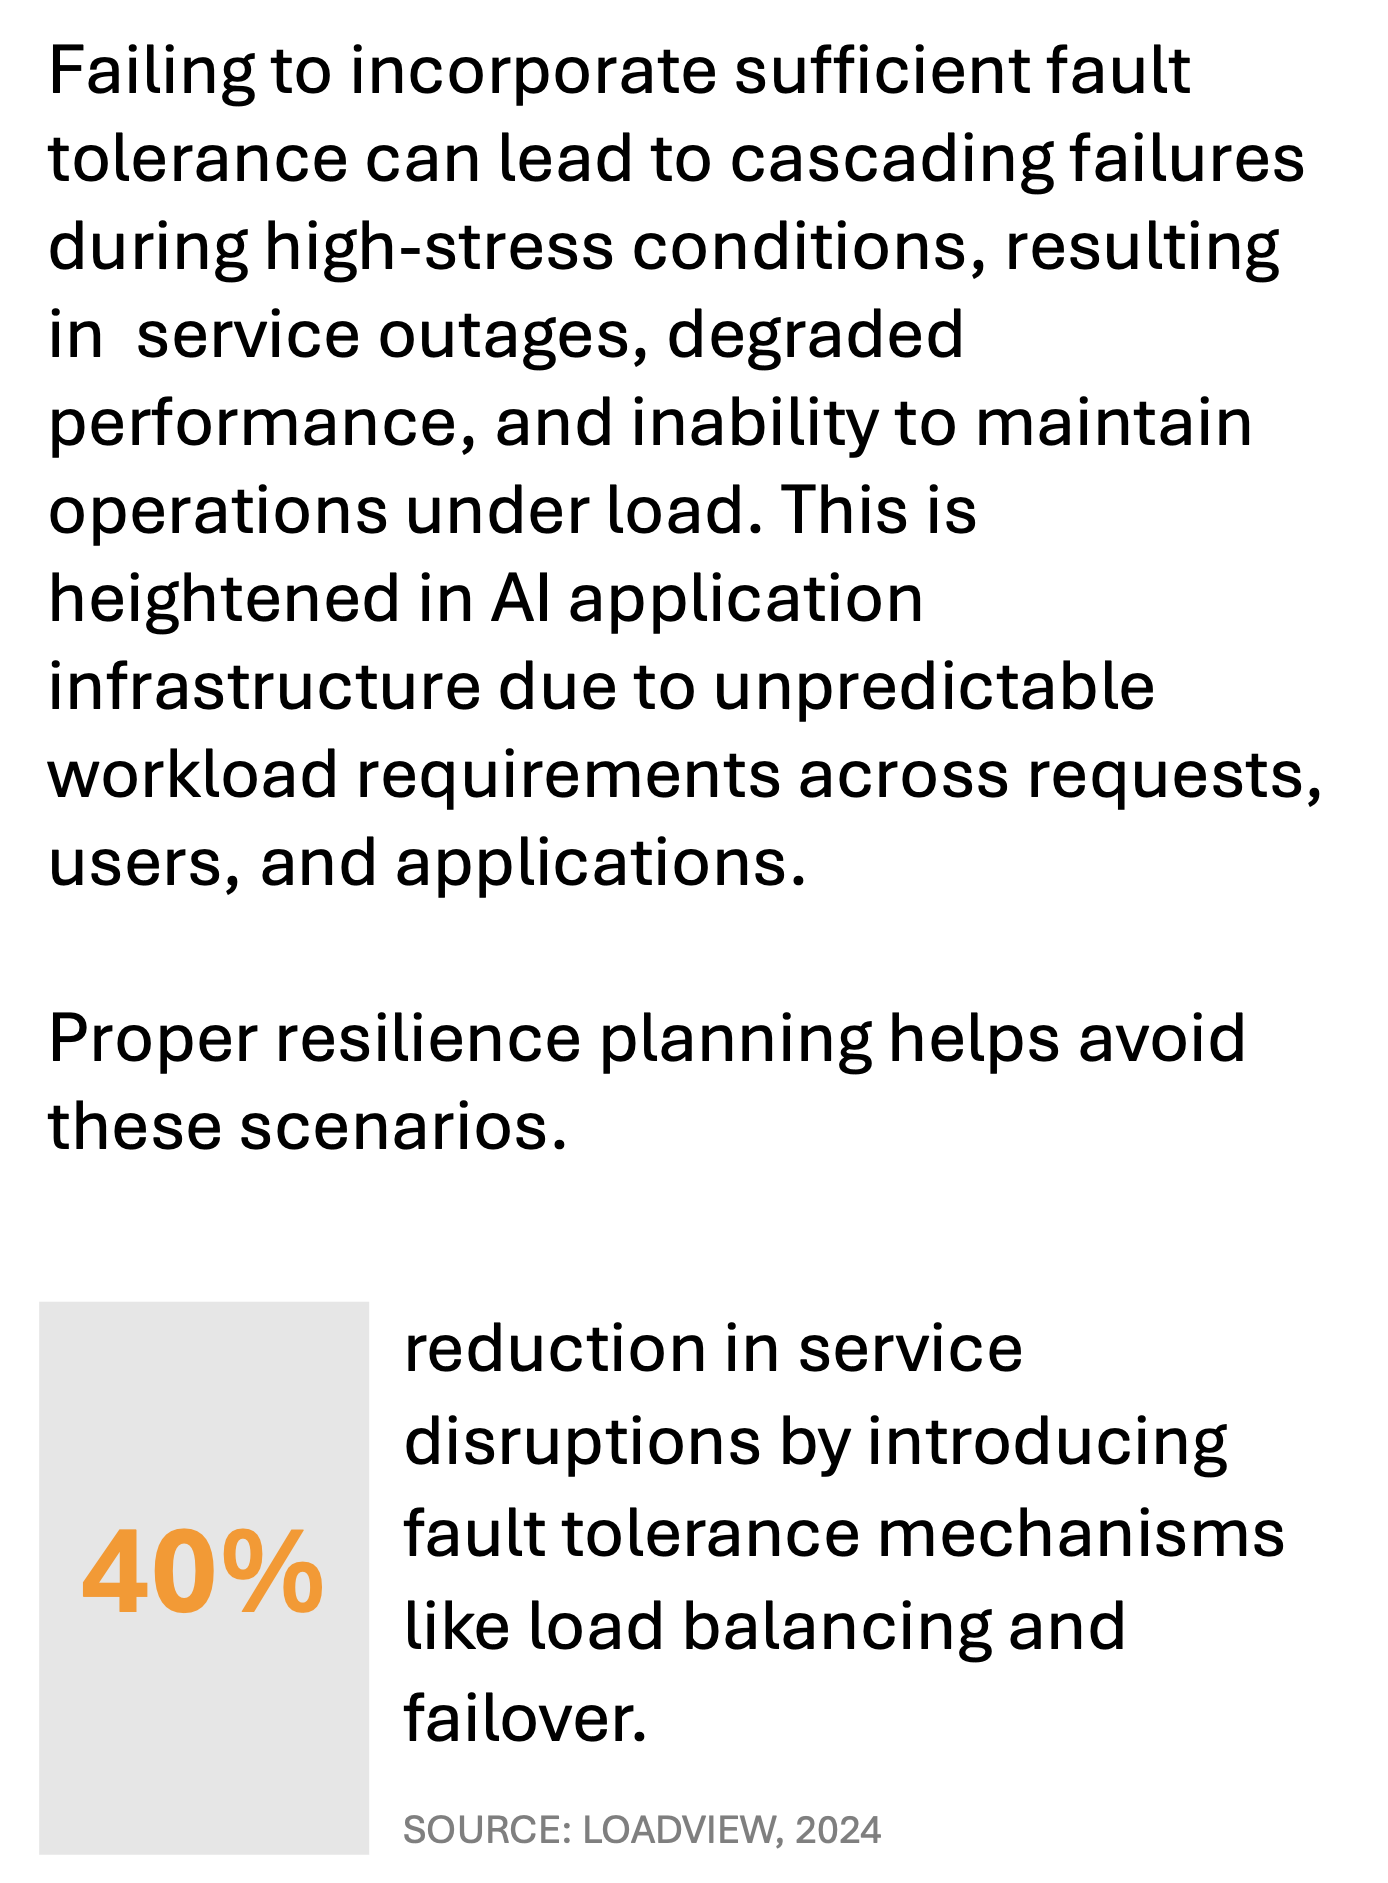
En el panorama digital actual, mantener una alta disponibilidad y resiliencia es fundamental para la entrega de aplicaciones. Sin embargo, la falta de tolerancia a fallos puede provocar fallos en cascada, interrupciones del servicio y una degradación significativa del rendimiento, especialmente en condiciones de alta exigencia. Sin mecanismos adecuados de tolerancia a fallos y resiliencia, como el equilibrio de carga y los sistemas de conmutación por error, las aplicaciones quedan expuestas a interrupciones que pueden afectar a la experiencia del usuario, la escalabilidad y la eficiencia operativa. A continuación, analizamos el impacto de una tolerancia a fallos insuficiente en áreas clave y exponemos las prácticas recomendadas para crear una infraestructura más resiliente.
Consecuencias de la falta de tolerancia a fallos y resiliencia
Impacto en el rendimiento
Las aplicaciones que carecen de tolerancia a fallos suelen tener dificultades para mantener un rendimiento constante bajo presión. Por ejemplo, sin mecanismos de conmutación por error, el fallo de un servidor puede aumentar la carga de los servidores restantes, ralentizar los tiempos de respuesta y deteriorar la experiencia del usuario. Además, cuando los sistemas no están diseñados para gestionar las fluctuaciones del tráfico, como las que se producen durante los periodos de máxima demanda, pueden verse saturados, lo que ralentiza el procesamiento y aumenta la latencia. Según el informe de LoadView de 2024 sobre el rendimiento de las redes, los sistemas sin una tolerancia a fallos adecuada experimentan un 35 % más de tiempo de inactividad en situaciones de alta carga, lo que afecta directamente al rendimiento al provocar retrasos y reducir la capacidad de respuesta.
Impacto en la disponibilidad
La disponibilidad es uno de los aspectos que se ven afectados de forma más directa cuando no existe tolerancia a fallos. Sin estrategias de redundancia o conmutación por error, un único punto de fallo puede provocar un tiempo de inactividad prolongado, ya que no hay recursos de respaldo que puedan asumir la carga en caso de que falle un servidor. Esto puede perjudicar gravemente la reputación de una organización y hacer que los usuarios pierdan la confianza. En entornos distribuidos, la falta de tolerancia a fallos puede provocar fallos en cascada, en los que un problema en un componente desencadena fallos en otras partes del sistema. Implementar una planificación de la resiliencia, por ejemplo mediante servidores redundantes y equilibrio de carga, ayuda a evitar estas interrupciones al distribuir la carga de trabajo y garantizar una disponibilidad continua.
Impacto en la escalabilidad
La escalabilidad es otra área clave que se ve afectada por la falta de tolerancia a fallos. Los sistemas que no son resilientes suelen carecer de la flexibilidad necesaria para ampliar o reducir su capacidad en función de los cambios en la demanda. Por ejemplo, si una aplicación experimenta un aumento repentino del tráfico, la ausencia de mecanismos de equilibrio de carga o conmutación por error puede impedir que el sistema gestione eficazmente ese incremento. Esto no solo limita la capacidad de escalado del sistema, sino que también obliga a las organizaciones a sobredimensionar los recursos para mantener los niveles de servicio, lo que resulta costoso e ineficiente. Un sistema resiliente puede hacer frente a un aumento de la demanda distribuyendo la carga entre varios servidores, lo que le permite escalar de forma fluida y eficiente.
Impacto en la eficiencia operativa
La ausencia de mecanismos de tolerancia a fallos puede aumentar los costes operativos y reducir la eficiencia. Cuando los sistemas no están diseñados para gestionar los fallos de forma adecuada, los equipos de TI deben dedicar más tiempo a intervenciones manuales para restablecer los servicios, lo que incrementa el tiempo de inactividad y la carga operativa. Además, sin conmutación por error y equilibrio de carga automatizados, las organizaciones pueden verse obligadas a invertir en recursos adicionales para garantizar la continuidad del servicio, lo que aumenta los costes de infraestructura. La implementación de medidas de tolerancia a fallos y resiliencia ayuda a reducir la necesidad de intervención manual, mejora la eficiencia operativa y disminuye los costes asociados al tiempo de inactividad no planificado.
Mejores prácticas para mitigar la falta de tolerancia a fallos
Para abordar los retos asociados a una tolerancia a fallos y una resiliencia insuficientes, las organizaciones deberían plantearse implementar soluciones como el equilibrio de carga, los mecanismos de conmutación por error y la infraestructura programable. Estas herramientas permiten que los sistemas gestionen los fallos de forma más eficaz, garantizando una disponibilidad continua, un rendimiento óptimo y una escalabilidad eficiente.
Equilibrado de carga y mecanismos de conmutación por error
El balanceo de carga es esencial para distribuir el tráfico de manera uniforme entre los servidores y evitar que un único recurso se convierta en un cuello de botella. Al implementar un balanceo de carga inteligente, las organizaciones pueden mejorar tanto el rendimiento como la disponibilidad. Por ejemplo, si un servidor falla, el balanceador de carga puede redirigir el tráfico a otros servidores, manteniendo el servicio operativo y reduciendo el riesgo de interrupciones. Las organizaciones que implementan el balanceo de carga y la tolerancia a fallos están mejor preparadas para gestionar cargas de trabajo dinámicas y mantener una alta escalabilidad ante fluctuaciones de la demanda (Journal of Cloud Computing).
Los mecanismos de conmutación por error mejoran aún más la resiliencia al cambiar automáticamente a recursos de respaldo cuando los servidores principales presentan problemas. Esto garantiza que las aplicaciones sigan estando disponibles incluso ante fallos inesperados.
Programabilidad y automatización
La programabilidad de la infraestructura de entrega de aplicaciones permite a las organizaciones implementar estrategias personalizadas de tolerancia a fallos que se adapten a sus requisitos específicos. Por ejemplo, los controladores de entrega de aplicaciones (ADC) programables pueden ajustar dinámicamente los flujos de tráfico en función de las condiciones en tiempo real, desviando el tráfico de los recursos que presentan fallos y optimizando el rendimiento del sistema.
La automatización también es fundamental, ya que permite detectar los fallos y responder a ellos rápidamente, lo que minimiza el tiempo de inactividad y reduce la necesidad de intervención manual. Al integrar la programabilidad y la automatización en las estrategias de tolerancia a fallos, las organizaciones pueden crear sistemas resilientes capaces de adaptarse a diversos escenarios de fallo.
Conclusión
La falta de tolerancia a fallos y resiliencia en las estrategias de entrega de aplicaciones puede provocar importantes problemas de rendimiento, una menor disponibilidad y limitaciones de escalabilidad. Mediante la implementación de mecanismos de equilibrio de carga y conmutación por error, así como de una infraestructura programable, las organizaciones pueden crear un sistema más resiliente que garantice una disponibilidad continua y un rendimiento óptimo, incluso en condiciones adversas. Priorizar la tolerancia a fallos no solo mejora la experiencia del usuario, sino que también reduce la carga operativa y facilita un escalado eficiente, garantizando que las aplicaciones estén preparadas para satisfacer las exigencias del vertiginoso entorno digital actual.