La dernière enquête NetDevOps vient de paraître, et ses résultats sont prometteurs quant à l’état du pipeline de déploiement des entreprises.
Fruit d’un effort communautaire, l’enquête NetDevOps recherche des informations détaillées que l’on trouve rarement dans les enquêtes consacrées au « réseau ». Les principales conclusions sont présentées sans détour via le lien susmentionné, tout comme les données brutes, que votre serviteur s’est empressé de télécharger pour les explorer.
La conclusion incontournable de cette enquête est que le quotidien des professionnels de l’exploitation des réseaux est de plus en plus automatisé. Des modifications de configuration à la détection des anomalies, des mises à niveau logicielles au provisionnement dès le premier jour au moyen de solutions proposées par les fournisseurs, l’automatisation est désormais la norme. Cela ne nous surprend pas ; nos propres recherches ont abouti au même constat.
Ce que j’apprécie dans cette enquête, ce n’est pas tant qu’elle confirme nos propres recherches, mais plutôt qu’elle approfondit des aspects que nous n’abordons pas en détail. Par exemple, lorsque nous nous intéressons à l’état de l’automatisation des pipelines, nous le faisons en termes généraux. L’enquête NetDevOps examine précisément ce que recouvre cette automatisation pour chaque type d’activité.
Sur treize opérations réseau différentes, 4,75 sont aujourd’hui automatisées en moyenne. Les activités liées à la configuration (génération, déploiement et archivage), ainsi que la collecte de données, la création de rapports et les contrôles de conformité, sont les plus souvent citées comme étant automatisées.
La plupart des organisations n’adoptent pas une approche immuable de l’infrastructure. Autrement dit, une majorité relative autorise les modifications de configuration via la CLI, en plus des déploiements automatisés par le pipeline. Comme nous l’avons constaté dans d’autres domaines, notamment celui de la gestion des identités, ce type de pratiques peut s’avérer problématique. Une source unique de vérité permet d’annuler facilement les modifications en cas de problème. Les modifications effectuées via la CLI augmentent l’entropie, ce qui peut accélérer l’apparition de difficultés au fil du temps.
Aujourd’hui, la détection des problèmes, c’est-à-dire des anomalies, repose principalement sur des alertes automatisées de disponibilité et de dépassement de seuils. Toutefois, un nombre croissant d’équipes NetOps se tournent vers la corrélation d’événements à l’aide de moteurs de règles ainsi que de l’IA/ML. SNMP reste la principale source de télémétrie, suivi de près par d’autres protocoles (ICMP) et par les journaux traditionnels. Les API et la télémétrie en continu sont utilisées par environ un quart des personnes interrogées. La moitié d’entre elles « envisagent » la télémétrie en continu, tandis que près d’un quart (23 %) l’évaluent. L’utilisation conjointe des API et de la télémétrie en continu témoigne de la modernisation des pratiques d’exploitation des réseaux, ces deux technologies étant essentielles pour permettre l’IA/ML et évoluer à terme vers l’AIOps.
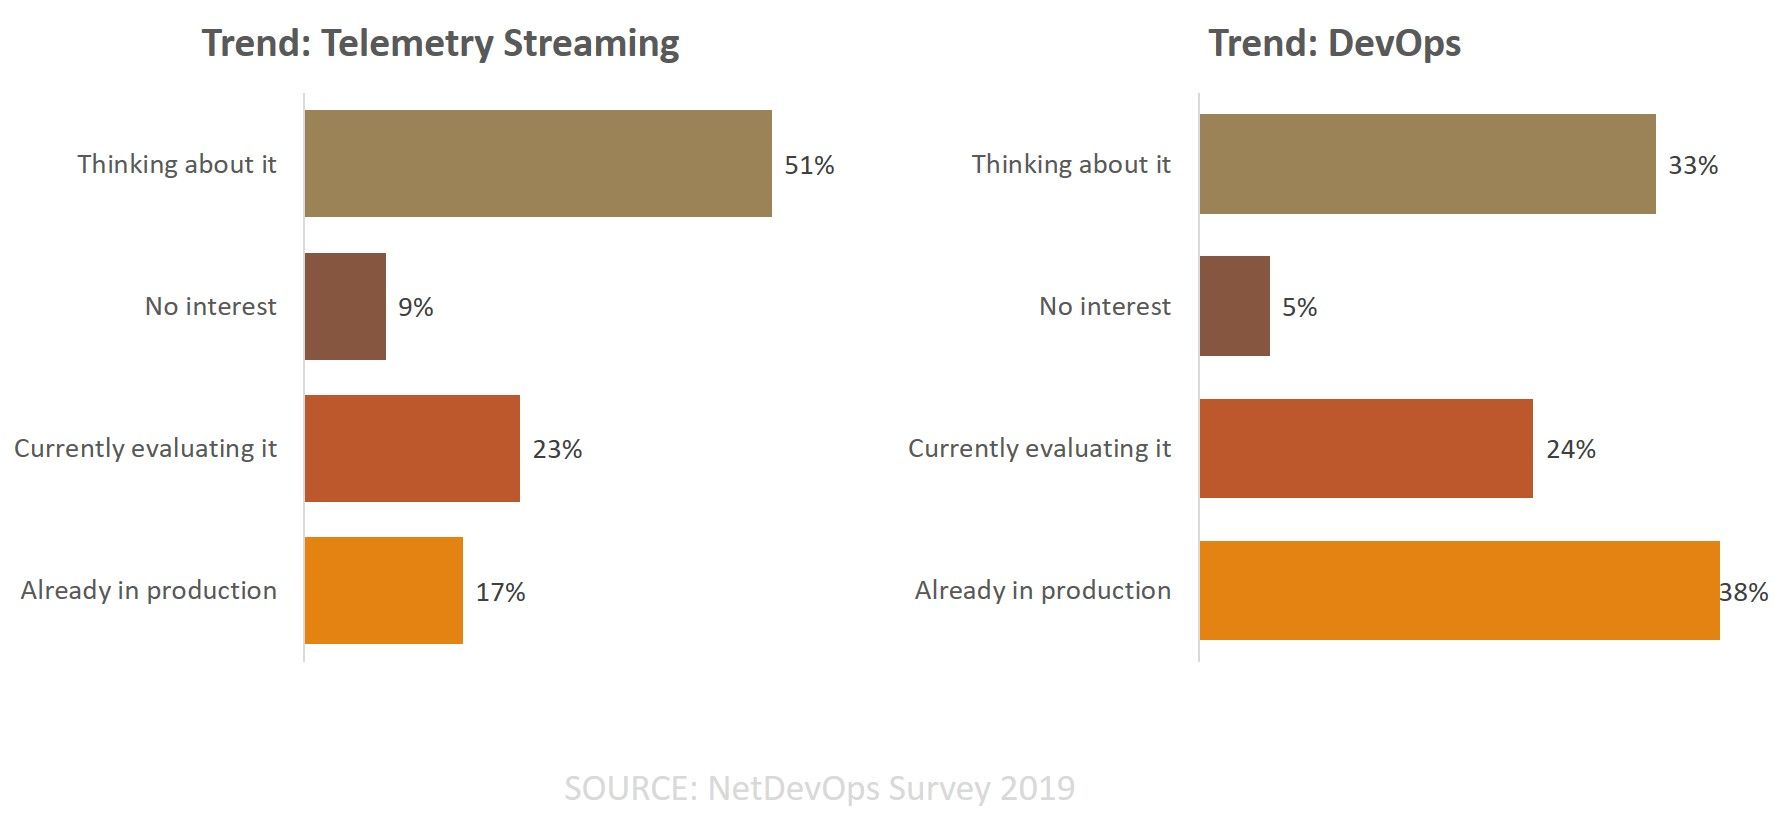
Alors que les équipes NetOps construisent leur avenir automatisé, personne ne devrait s’étonner — et surtout pas ceux qui ont suivi nos propres recherches — que Python soit leur langage de prédilection. Côté outils, Ansible s’impose clairement pour automatiser la génération et le déploiement des configurations, tandis que Git continue de gagner du terrain en tant que dépôt privilégié.
La tendance à l’automatisation est une question de survie pour la plupart des équipes chargées des opérations réseau. Plus d’un tiers d’entre elles gérant entre 251 et 1 000 appareils et un autre tiers entre 1 001 et 5 000 appareils, l’automatisation constitue le moyen le plus efficace de suivre des calendriers de déploiement toujours plus exigeants.
L’enquête NetDevOps révèle que la plupart des répondants déploient des changements majeurs en production tous les mois. La majorité d’entre eux déploient des changements majeurs « moins d’une fois par mois » ou « 1 à 5 fois par mois ». En revanche, les changements mineurs sont déployés en production plus fréquemment, chaque semaine. La majorité déploie des changements mineurs « 1 à 5 fois par semaine » ou « plus d’une fois par jour ».
Vous trouverez bien plus d’informations détaillées dans l’enquête NetDevOps et je vous recommande vivement de la lire pour prendre le pouls d’un monde des opérations réseau de plus en plus automatisé.
À propos de l’auteur

Lori MacVittie est ingénieure émérite et évangéliste en chef au sein du bureau du directeur technique de F5. Elle possède une expertise approfondie dans la fourniture d’applications, les stratégies d’automatisation et les infrastructures. Elle est réputée pour sa capacité à rendre la complexité intelligible, qu’elle définisse des garde-fous pour les agents d’IA, analyse des architectures multicloud fragiles ou explore les limites des systèmes évolutifs. Elle cumule plus de trente ans d’expérience dans le secteur, couvrant le développement d’applications, l’architecture informatique ainsi que l’exploitation des réseaux et des systèmes. Avant de rejoindre F5, elle a été rédactrice spécialisée dans les technologies et a reçu plusieurs distinctions. MacVittie est titulaire d’un master en informatique et est une autrice prolifique dont les publications couvrent la sécurité, le cloud et l’architecture d’entreprise. Elle est également une passionnée de jeux de société et de jeux vidéo, et assume pleinement ses avis bien tranchés sur le fromage.
Autres articles de Lori Mac VittieArticles de blog associés

F5 NGINXaaS pour Google Cloud : des applications résilientes et évolutives
Découvrez comment NGINXaaS s’intègre à Google Cloud pour renforcer les performances et la sécurité, et préparer vos applications critiques à un avenir propulsé par l’IA.

L’intégration de F5 Web Application Firewall (WAF) à AWS est disponible dès aujourd’hui
En faisant appel à un partenaire de déploiement AWS WAF tel que F5, vous pouvez renforcer la sécurité de vos applications web grâce à des règles personnalisées qui bloquent les schémas d’attaque courants, comme les injections SQL ou les attaques par scripts intersites (XSS).
Appliquer le principe de Peter Parker à l’inspection TLS
« Un grand pouvoir implique de grandes responsabilités. » Si l’on en trouve des échos chez Voltaire et Churchill, cette citation est surtout connue grâce aux bandes dessinées Spider-Man, où elle est attribuée à l’oncle Ben. Bien entendu, si cette phrase est si répandue dans la culture populaire, c’est notamment parce qu’elle peut s’appliquer à une multitude de situations et de sujets, y compris à l’inspection TLS.
Le NetOps a besoin de défenseurs, pas d’adversaires
Il est important de reconnaître que les équipes NetOps ne sont pas toujours celles qui font obstacle au déploiement de la dernière nouveauté, application ou service. Les freins à la rapidité sont souvent dus au fait que les organisations n’adoptent pas tous les principes du DevOps lorsqu’elles cherchent à transformer leurs opérations informatiques.
Mise à jour des services applicatifs : sécurité, rapidité et visiteurs suspects
Il est de nouveau temps de nous pencher sur les services applicatifs que les entreprises utilisent réellement pour rendre leurs applications plus rapides et plus sûres. On constate notamment une hausse du recours aux services de protection contre les bots, ainsi que la progression lente mais régulière de HTTP/2. Bien qu’il ne s’agisse pas d’une application…
Les templates prennent le contrôle du cloud
Les modèles s’imposent dans le cloud. Lisez le blog de F5 pour découvrir comment l’infrastructure en tant que code et les API déclaratives automatisent la mise à disposition des applications.