Big data. Des pétaoctets sont générés chaque heure par des millions de capteurs et de dispositifs de surveillance intégrés à des objets tout au long de la chaîne de valeur de l’entreprise. De la fabrication à la livraison, des points de vente aux consommateurs, les données sont produites dans des volumes sans précédent.
Ces données, prises isolément, n’ont aucun sens. Les données elles-mêmes sont un ensemble de 1 et de 0 organisés selon des structures spécifiques qui, lorsqu’elles sont interprétées par une application, deviennent des informations. Ces informations ne deviennent utiles qu’une fois analysées et ne créent de la valeur que lorsqu’elles donnent lieu à des actions.
Les humains ne peuvent pas analyser efficacement les données générées aujourd’hui, sans parler de celles qui le seront dans l’heure, la journée ou la semaine à venir. Pourtant, les décisions commerciales doivent de plus en plus souvent être prises quasiment en temps réel. Pour y parvenir, il faut disposer d’une puissance de calcul et de systèmes entraînés à reconnaître les signaux au milieu des montagnes de bruit accumulées chaque jour.
Il ne s’agit pas de simples conjectures. Dans « Machine Learning : le nouveau terrain d’expérimentation pour acquérir un avantage concurrentiel » — une enquête menée par MIT Technology Review Custom et Google Cloud —, plus de 60 % des personnes interrogées « ont déjà mis en œuvre des stratégies de ML [apprentissage automatique], et près d’un tiers estiment que leurs initiatives ont atteint un stade avancé ». Leur investissement conséquent dans cette technologie émergente s’explique par la recherche d’un avantage concurrentiel. « Selon les personnes interrogées, l’un des principaux atouts du ML est la possibilité d’acquérir un avantage concurrentiel, et 26 % des entreprises qui utilisent actuellement le ML estiment avoir déjà atteint cet objectif. »
Les bénéfices attendus devraient être considérables.
“Pour une entreprise type du classement Fortune 1000, une augmentation de seulement 10 % de l’accessibilité des données générera plus de 65 millions de dollars de résultat net supplémentaire.”
“Les détaillants qui exploitent pleinement le potentiel du big data pourraient augmenter leur marge d’exploitation jusqu’à 60 %.”
Jusqu’ici, tout va bien. Nous utilisons les données pour orienter les décisions qui permettent aux entreprises de prendre les devants et de se développer.
Le danger réside dans le fait de ne pas reconnaître que toute dépendance comporte des risques. Si je dépends d’une voiture pour aller faire mes courses (parce qu’il n’existe aucun transport en commun là où je vis), alors le moindre problème affectant cette voiture représente un risque. Un risque considérable. Si mon entreprise dépend du big data pour prendre des décisions (potentiellement à ma place, si l’on prend au pied de la lettre les prédictions des experts), alors le moindre problème affectant ces données représente un risque.
Je ne parle pas ici de la perte pure et simple des données, ni même de leur altération. Je parle d’une menace plus insidieuse, qui découle de la confiance que nous accordons à la véracité de ces données.
Pour pouvoir prendre des décisions à partir de données, que ce soit dans notre vie personnelle ou professionnelle, nous devons d’abord avoir confiance en leur exactitude.
Big Dirty Data
Les données erronées ne sont pas un phénomène nouveau. J’avoue qu’il m’arrive de falsifier mes informations personnelles lorsqu’elles sont demandées pour accéder à un article ou à une ressource sur Internet. Mais les nouveaux flux de données ne sont pas nécessairement exposés à ce type d’altération anodine. Ils sont menacés par des acteurs malveillants qui les corrompent délibérément dans le but de faire dévier votre entreprise de sa trajectoire.
Parce que nous prenons des décisions fondées sur les données et que nous avons tendance à ne les remettre en question que lorsque des valeurs manifestement aberrantes apparaissent, nous sommes presque aveugles à la menace d’une altération progressive. À l’image du procédé désormais éculé qui consiste à détourner quelques centimes sur des transactions bancaires, une modification subtile des données peut passer inaperçue. Une hausse progressive de la demande pour le produit X sur un marché pourrait être perçue comme le fruit d’actions marketing ou promotionnelles réussies. La conjoncture macroéconomique peut souvent expliquer une chute soudaine de la demande pour le produit Y sur d’autres marchés. Je peux avoir un impact considérable sur votre entreprise si j’ai la patience et la détermination nécessaires pour fausser les données sur lesquelles vous fondez vos décisions en matière de fabrication ou de distribution.
À quel point ? La mauvaise qualité des données entraîne une perte d’environ 30 % du chiffre d’affaires selon Ovum Research. Analytics Week a dressé une liste fascinante de faits sur le big data illustrant les conséquences similaires de données de mauvaise qualité, notamment :
“Des données de mauvaise qualité peuvent coûter aux entreprises entre 20 % et 35 % de leur chiffre d’affaires d’exploitation.”
“Les données erronées ou de mauvaise qualité coûtent chaque année 600 milliards de dollars aux entreprises américaines.”
Cela vous semble peu probable ? Le web scraping visant à recueillir des renseignements dans le cadre d’opérations d’espionnage industriel est une réalité, et des équipes se consacrent à le contrer. L’utilisation d’API rend ces opérations encore plus faciles et plus redoutables, parfois même en temps réel. Penser que personne n’introduira intentionnellement de mauvaises données dans votre flux revient donc à ignorer délibérément le fait que les acteurs malveillants ont souvent — pour ne pas dire généralement — deux longueurs d’avance sur nous.
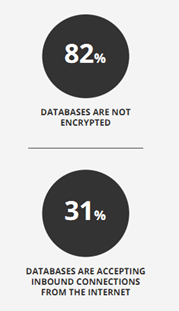
Nos pratiques de sécurité – en particulier dans le cloud, où une grande partie du big data est appelée à résider – amplifient cette menace. Un livre blanc de TDWI, sponsorisé par Information Builders, fournit de nombreux autres exemples du coût des données de mauvaise qualité. Si la plupart concernent des problèmes courants de qualité des données résultant de l’intégration de données à la suite d’acquisitions ou d’informations approximatives généralement fournies par les clients, les modèles de coûts sont extrêmement utiles pour comprendre les risques que court une entreprise lorsqu’elle se fie à des données susceptibles d’être corrompues – et les mesures qu’elle peut prendre pour y remédier.
Le recours aux configurations par défaut a été à l’origine de plusieurs failles de sécurité rien que cette année. Vous vous souvenez de la débâcle MongoDB de janvier ? Celle où les configurations par défaut laissaient les bases de données totalement accessibles à quiconque sur Internet pouvait s’y intéresser ? Et que dire de l’étude CSI de RedLock, qui a révélé que 285 consoles d’administration Kubernetes étaient complètement ouvertes. Aucun identifiant requis. Le même rapport a constaté que 31 % des bases de données non chiffrées dans le cloud acceptaient les connexions entrantes depuis Internet. Directement. Autrement dit, absolument rien ne me séparait de vos données.
Lorsque plus de 27 000 bases de données restent exposées et accessibles via Internet parce qu’aucun effort n’a été fait pour les sécuriser, on peut aisément imaginer à quel point il serait facile d’altérer les flux de données. Lorsque des organisations vont jusqu’à supprimer délibérément les contrôles de sécurité par défaut des services de stockage cloud, les laissant ainsi totalement exposés à la découverte et à la corruption, l’idée que des acteurs malveillants puissent y injecter des données corrompues passe du domaine du possible à celui du probable. Il incombe aux organisations qui s’appuient sur les données — c’est-à-dire pratiquement toutes aujourd’hui — de veiller non seulement à la manière dont elles les sécurisent, mais aussi à la façon dont elles en vérifient l’exactitude.
À l’avenir, la sécurité des entreprises pilotées par les données ne consistera plus seulement à se protéger contre leur exfiltration : elle devra également prendre en compte la menace bien réelle de leur infiltration et les moyens de la combattre.
À propos de l’auteur

Lori MacVittie est ingénieure émérite et évangéliste en chef au sein du bureau du directeur technique de F5. Elle possède une expertise approfondie dans la fourniture d’applications, les stratégies d’automatisation et les infrastructures. Elle est réputée pour sa capacité à rendre la complexité intelligible, qu’elle définisse des garde-fous pour les agents d’IA, analyse des architectures multicloud fragiles ou explore les limites des systèmes évolutifs. Elle cumule plus de trente ans d’expérience dans le secteur, couvrant le développement d’applications, l’architecture informatique ainsi que l’exploitation des réseaux et des systèmes. Avant de rejoindre F5, elle a été rédactrice spécialisée dans les technologies et a reçu plusieurs distinctions. MacVittie est titulaire d’un master en informatique et est une autrice prolifique dont les publications couvrent la sécurité, le cloud et l’architecture d’entreprise. Elle est également une passionnée de jeux de société et de jeux vidéo, et assume pleinement ses avis bien tranchés sur le fromage.
Autres articles de Lori Mac VittieArticles de blog associés

F5 NGINXaaS pour Google Cloud : des applications résilientes et évolutives
Découvrez comment NGINXaaS s’intègre à Google Cloud pour renforcer les performances et la sécurité, et préparer vos applications critiques à un avenir propulsé par l’IA.

L’intégration de F5 Web Application Firewall (WAF) à AWS est disponible dès aujourd’hui
En faisant appel à un partenaire de déploiement AWS WAF tel que F5, vous pouvez renforcer la sécurité de vos applications web grâce à des règles personnalisées qui bloquent les schémas d’attaque courants, comme les injections SQL ou les attaques par scripts intersites (XSS).
Appliquer le principe de Peter Parker à l’inspection TLS
« Un grand pouvoir implique de grandes responsabilités. » Si l’on en trouve des échos chez Voltaire et Churchill, cette citation est surtout connue grâce aux bandes dessinées Spider-Man, où elle est attribuée à l’oncle Ben. Bien entendu, si cette phrase est si répandue dans la culture populaire, c’est notamment parce qu’elle peut s’appliquer à une multitude de situations et de sujets, y compris à l’inspection TLS.
Le NetOps a besoin de défenseurs, pas d’adversaires
Il est important de reconnaître que les équipes NetOps ne sont pas toujours celles qui font obstacle au déploiement de la dernière nouveauté, application ou service. Les freins à la rapidité sont souvent dus au fait que les organisations n’adoptent pas tous les principes du DevOps lorsqu’elles cherchent à transformer leurs opérations informatiques.
Mise à jour des services applicatifs : sécurité, rapidité et visiteurs suspects
Il est de nouveau temps de nous pencher sur les services applicatifs que les entreprises utilisent réellement pour rendre leurs applications plus rapides et plus sûres. On constate notamment une hausse du recours aux services de protection contre les bots, ainsi que la progression lente mais régulière de HTTP/2. Bien qu’il ne s’agisse pas d’une application…
Les templates prennent le contrôle du cloud
Les modèles s’imposent dans le cloud. Lisez le blog de F5 pour découvrir comment l’infrastructure en tant que code et les API déclaratives automatisent la mise à disposition des applications.