
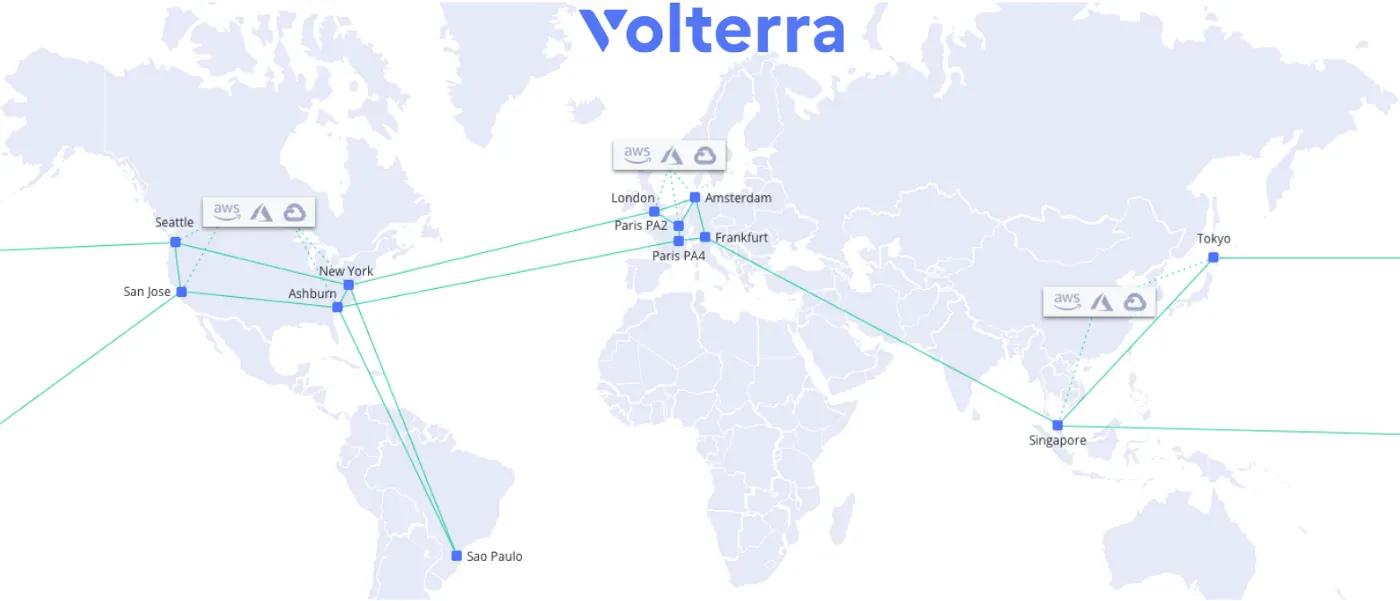
Dans le cadre de notre plan de contrôle basé sur le SaaS, nous avons construit et exploitons notre propre réseau backbone mondial (AS35280), qui s’appuie sur plusieurs liaisons 100G et 400G entre nos PoP.
Nous maîtrisons ainsi entièrement la connectivité de bout en bout entre nos points de présence régionaux, tout en offrant à nos clients une connectivité tout aussi performante et une faible latence, que ce soit entre leurs centres de données privés, leurs sites en périphérie, leurs VPC de cloud public (AWS, Azure, GCP) ou leurs fournisseurs SaaS.
Le besoin
Notre présence en Europe était déjà assez solide, avec des implantations à Paris, Londres, Amsterdam et Francfort, mais nos clients actuels et nouveaux avaient besoin d’un nouveau PoP à Lisbonne, au Portugal.
Tout cela avait été convenu au début de l’année 2020, et le déploiement était prévu pour le troisième trimestre 2020. Bien sûr, c’était avant la COVID-19 :)
Avec la crise, nous avons constaté une forte augmentation du trafic sur notre réseau fédérateur (ainsi que des attaques DDoS, mais nous y reviendrons dans un prochain article de blog), tout comme nos clients.
Ils nous ont demandé d’effectuer le déploiement avant le troisième trimestre, car ils avaient besoin de ce PoP au plus vite — plus précisément, avant la fin du mois de mai. Et comme chez Volterra, nous sommes plutôt sympas et que nous aimons aussi relever des défis, nous avons examiné attentivement le délai nécessaire pour répondre à la demande du client :
- Il nous fallait au moins deux semaines pour effectuer le déploiement et les tests,
- Et une semaine pour valider
Comme nous étions début avril, cela nous semblait convenir et nous avons décidé de poursuivre et de lancer le projet, même si c’était vraiment le pire moment possible pour le faire, en raison de :
- Interdiction de voyager,
- Aucun accès au centre de données,
- Pénurie mondiale de composants,
- Sans parler des risques pour la santé.
De quoi a-t-on besoin ?
Le déploiement d’un nouveau PoP ne se limite pas aux routeurs, aux commutateurs et aux câbles. Vous devez également :
- réaliser une étude d’ingénierie réseau afin de choisir le meilleur emplacement et les meilleurs fournisseurs de longueurs d’onde,
- conclure un accord/négocier avec le centre de données choisi (Equinix LS1 dans ce cas),
- négocier avec l’IXP afin d’obtenir des ports de peering,
- et bien sûr commander le matériel et les équipements nécessaires (routeurs, commutateurs, câbles, pare-feu, etc.)
Comment nous avons procédé
En raison de la crise actuelle, il était impossible de disposer à temps du matériel nécessaire. Nous avons donc décidé de réutiliser certains équipements dont nous disposions déjà, provenant principalement de notre laboratoire. Ce compromis était acceptable (par exemple, les routeurs utilisés seront des Juniper QFX10K au lieu des MX10K prévus).
La préparation, que nous effectuons habituellement dans un datacenter (en raison de la puissance électrique et de l’espace en baie nécessaires, mais aussi… du bruit !), allait devoir se faire à domicile à cause du confinement. Raphaël, notre CTO Infrastructure, disposait d’un bureau suffisamment grand (ainsi que d’un abonnement de 60 ampères, ce qui peut s’avérer utile lorsqu’on démarre ou alimente des équipements consommant jusqu’à 16 ampères !). Il allait donc assurer seul toute la préparation, ce qui éviterait également de faire intervenir d’autres membres du personnel ou de les obliger à sortir.
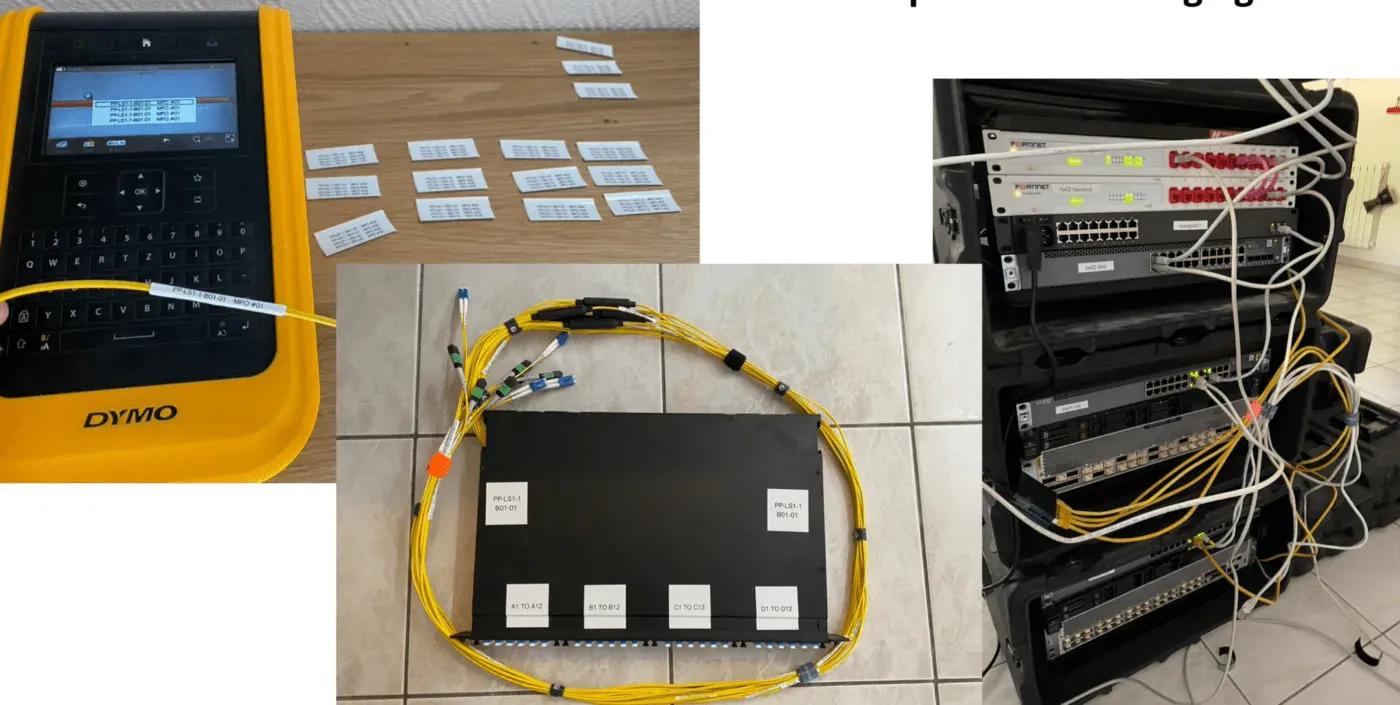
Une fois que tout a été configuré et testé à plusieurs reprises, nous avons expédié le tout à Lisbonne :
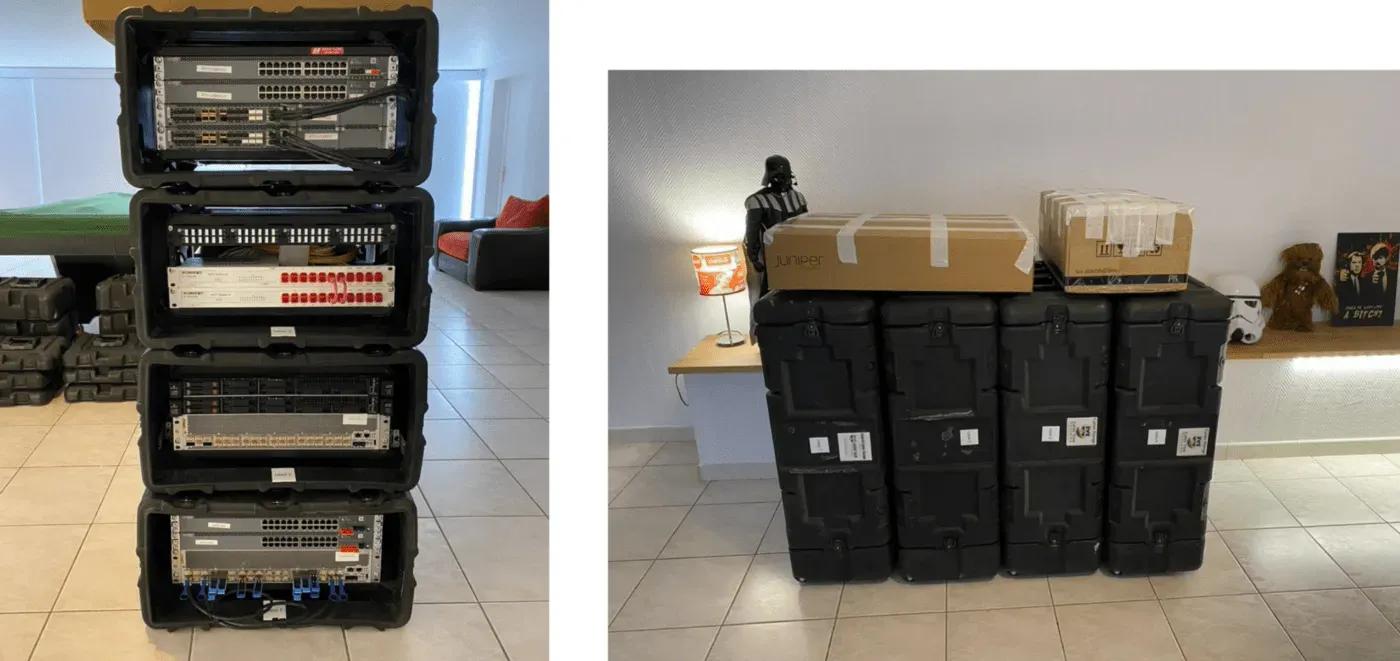
Installation d’une baie à Lisbonne par le service Remote Hands d’Equinix
Même si nous étions confiants dans la configuration que nous avions réalisée (et que nous disposions de toute façon d’un accès à distance via l’OOB ou notre backbone), c’était tout de même la première fois qu’un nouveau PoP n’était pas déployé directement par nos soins, mais par quelqu’un d’autre 😅
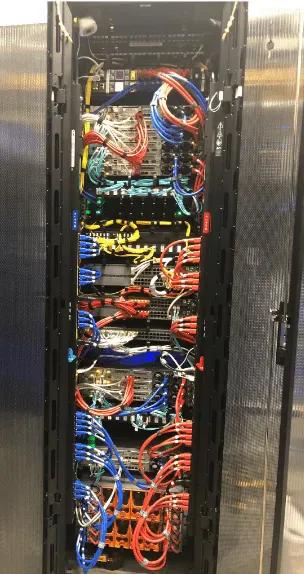
Nous utilisons la même configuration de baie partout dans le monde, et l’objectif était de rester cohérents en reproduisant cette configuration pour ce nouveau PoP de Lisbonne.
Nous avons donc dû être extrêmement précis dans les instructions que nous donnions aux techniciens d’intervention à distance d’Equinix, afin qu’ils puissent reproduire notre configuration en se contentant de « suivre le guide ».
Vous trouverez ci-dessous une partie de la procédure que nous avons envoyée à Equinix afin que leurs équipes puissent facilement installer tout le matériel dans les baies et effectuer les branchements.
Il y a de nombreux composants à gérer — non seulement les équipements matériels (routeurs, commutateurs, pare-feu, serveurs), mais aussi le câblage et, surtout, les ports des commutateurs et des serveurs auxquels raccorder les câbles.
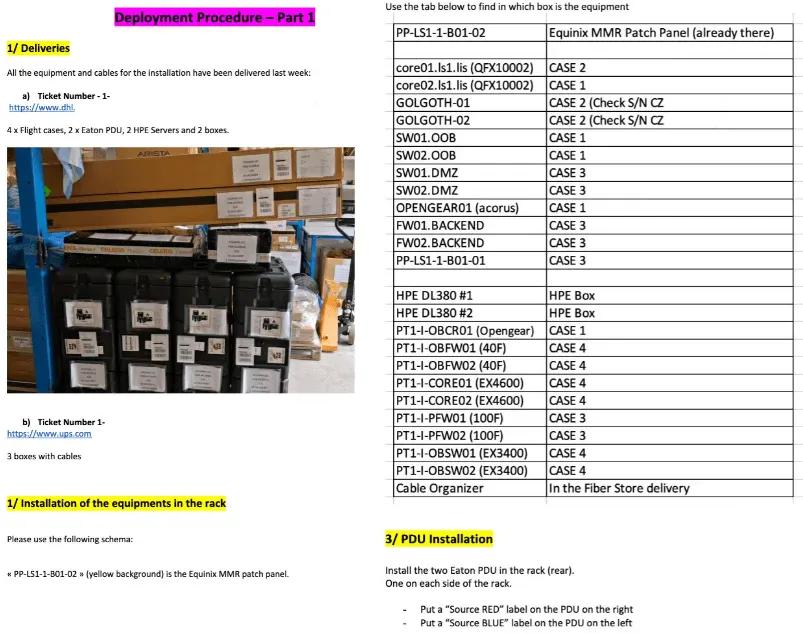
Comme vous pouvez le voir ci-dessous, la procédure est aussi détaillée que possible, sachant que les techniciens d’Equinix ont de nombreuses installations à effectuer : plus nous sommes précis, mieux c’est !
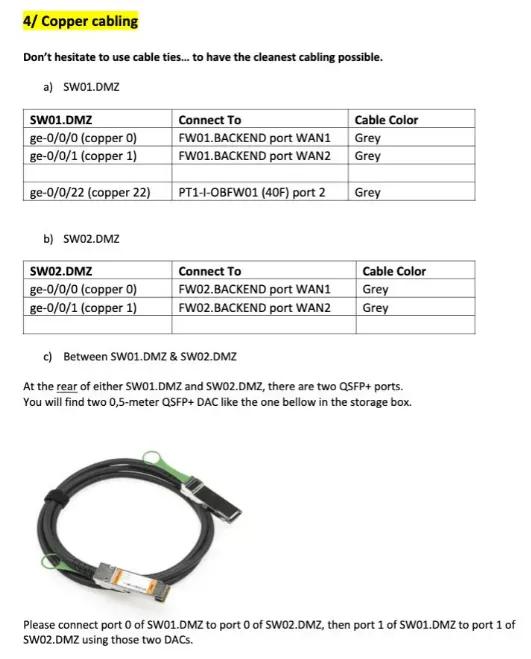
Est-ce que ça a marché ?
Oui ! L’installation a commencé le 5 mai : tous les appareils ont été montés en rack et mis sous tension, sans aucune panne matérielle. Nous avons eu de la chance, ou peut-être que, grâce à notre expérience, l’expédition et l’emballage ont été réalisés dans les règles de l’art — ou peut-être les deux — mais quoi qu’il en soit, tout a parfaitement fonctionné.
Le lendemain, les techniciens d’Equinix se sont chargés du câblage (cuivre/fibre) et, à 23 h 30, nous pouvions joindre notre PoP de Lisbonne depuis Paris avec un ping !
L’installation a été achevée le 7 mai, avec les dernières tâches à effectuer, telles que la configuration des PDU, le brassage des ports OOB et la vérification de bout en bout des ports IXP. La configuration de nos commutateurs et de notre pare-feu étant pleinement opérationnelle, nous n’avons pas eu à demander à Equinix de la modifier.
Voici à quoi ressemble l’installation finale :
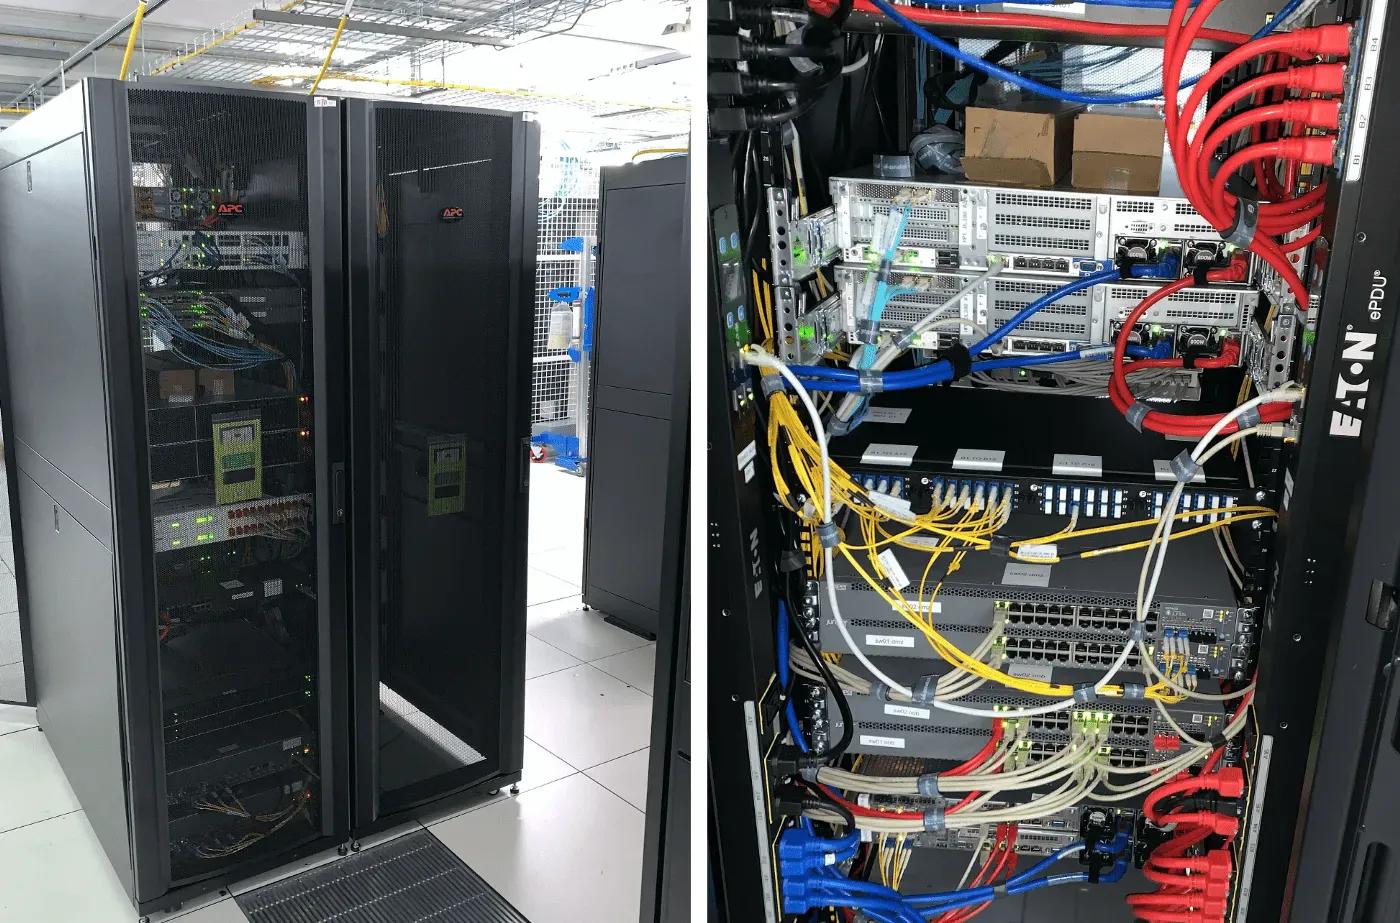
Comme nous sommes très exigeants, nous ne sommes pas entièrement satisfaits : par exemple, le panneau arrière du rack n’est pas aussi soigné que nous le souhaiterions. Mais nous y remédierons une fois la crise passée, lorsque nous pourrons de nouveau nous rendre au Portugal.
« Post-mortem » — ce qui a fonctionné, pourquoi, et ce qui peut être amélioré
Même si nous sommes extrêmement heureux et fiers d’avoir réussi à relever le défi, nous aimons prendre du recul pour réfléchir à ce qui a fonctionné, mais surtout à ce qui peut être amélioré.
Ce qui a fonctionné :
- Equinix : il est important de faire savoir à un prestataire lorsque les choses ne se passent pas bien, mais il est encore plus important de le lui dire lorsqu’elles se sont particulièrement bien déroulées — et c’est précisément le cas ici. Des équipes commerciales et de la direction aux techniciens du centre de données, l’assistance et la réactivité dont nous avons bénéficié ont été tout simplement incroyables — surtout pendant cette période difficile. Alors vraiment, bravo à Equinix !
Pourquoi cela a-t-il fonctionné ?
- Volterra était déjà principalement une entreprise distribuée privilégiant le télétravail — en particulier, notre équipe française, responsable du NetOps, est répartie dans toute la France et a l’habitude de travailler à distance à l’aide d’outils collaboratifs.
- Nous disposions de suffisamment de matériel de rechange et de laboratoire, ce qui nous a permis de respecter les délais.
- La procédure que nous avons brièvement expliquée ci-dessus est le fruit de plusieurs années de déploiement et d’expérience, ponctuées d’améliorations successives, et elle a porté ses fruits.
- Il est essentiel pour nous d’entretenir de bonnes relations avec nos fournisseurs : là encore, lorsque quelque chose ne va pas, nous les appelons sans hésiter à leur en faire part, mais cela leur permet aussi de s’améliorer, non seulement pour nous, mais également pour l’ensemble de leurs clients.
- Besoin de rapidité, de prix compétitifs et de qualité : il faut avoir des exigences élevées — ce qui implique d’investir dans les ressources AVANT d’en avoir besoin !
Quels sont les points à améliorer ?
- Nous nous sommes rendu compte que seules quelques personnes (3 à 4) dans l’entreprise étaient capables de gérer un tel déploiement — nous devons trouver un moyen de passer à l’échelle
- Nous souhaitons également améliorer notre processus de préproduction afin d’éviter d’avoir à effectuer d’abord une mise en préproduction complète.
- Enfin, un tel déploiement n’est pas seulement une question technique : les équipes commerciales et avant-vente doivent avoir conscience du temps nécessaire à l’ensemble du projet et à chacune de ses étapes, et ne pas partir du principe que NetOps peut tout résoudre, puis lui confier des projets sans évaluation préalable adéquate des délais.
Nous avons présenté ce déploiement lors de la première réunion RIPE à distance (RIPE 80). Vous pouvez regarder l’enregistrement ici :
À propos de l’auteur
Articles de blog associés

F5 NGINXaaS pour Google Cloud : des applications résilientes et évolutives
Découvrez comment NGINXaaS s’intègre à Google Cloud pour renforcer les performances et la sécurité, et préparer vos applications critiques à un avenir propulsé par l’IA.

L’intégration de F5 Web Application Firewall (WAF) à AWS est disponible dès aujourd’hui
En faisant appel à un partenaire de déploiement AWS WAF tel que F5, vous pouvez renforcer la sécurité de vos applications web grâce à des règles personnalisées qui bloquent les schémas d’attaque courants, comme les injections SQL ou les attaques par scripts intersites (XSS).
Appliquer le principe de Peter Parker à l’inspection TLS
« Un grand pouvoir implique de grandes responsabilités. » Si l’on en trouve des échos chez Voltaire et Churchill, cette citation est surtout connue grâce aux bandes dessinées Spider-Man, où elle est attribuée à l’oncle Ben. Bien entendu, si cette phrase est si répandue dans la culture populaire, c’est notamment parce qu’elle peut s’appliquer à une multitude de situations et de sujets, y compris à l’inspection TLS.
Le NetOps a besoin de défenseurs, pas d’adversaires
Il est important de reconnaître que les équipes NetOps ne sont pas toujours celles qui font obstacle au déploiement de la dernière nouveauté, application ou service. Les freins à la rapidité sont souvent dus au fait que les organisations n’adoptent pas tous les principes du DevOps lorsqu’elles cherchent à transformer leurs opérations informatiques.
Mise à jour des services applicatifs : sécurité, rapidité et visiteurs suspects
Il est de nouveau temps de nous pencher sur les services applicatifs que les entreprises utilisent réellement pour rendre leurs applications plus rapides et plus sûres. On constate notamment une hausse du recours aux services de protection contre les bots, ainsi que la progression lente mais régulière de HTTP/2. Bien qu’il ne s’agisse pas d’une application…
Les templates prennent le contrôle du cloud
Les modèles s’imposent dans le cloud. Lisez le blog de F5 pour découvrir comment l’infrastructure en tant que code et les API déclaratives automatisent la mise à disposition des applications.