Dans l’ensemble, la mise à l’échelle des applications et des API fonctionne à peu près de la même manière. Toutes deux nécessitent un type d’équilibreur de charge — généralement un proxy — afin de répartir les requêtes entre un ensemble de ressources.
Mais il existe une différence assez importante dans la manière dont ces requêtes sont réparties entre les ressources. Avec les algorithmes, il s’agit véritablement de répartir la charge, tandis qu’avec l’architecture, il s’agit de l’orienter. Cette distinction peut sembler quelque peu pointilleuse et relever davantage du monde universitaire. En réalité, le choix entre algorithmes et architecture a une incidence considérable sur la capacité de montée en charge et les performances. Puisque ces deux aspects sont précisément la raison d’être de l’équilibrage de charge, cette distinction revêt toute son importance.
Équilibrage de charge classique
La répartition de charge basée sur des algorithmes peut être simplement appelée « répartition de charge » ou, comme j’aime à la nommer, « bonne vieille répartition de charge ». C’est la méthode de mise à l’échelle que nous utilisons depuis avant le début du siècle. Son ancienneté ne signifie pas qu’elle doit être abandonnée, bien au contraire. Dans de nombreuses situations, la bonne vieille répartition de charge constitue le meilleur choix pour concilier mise à l’échelle et performances.
Comme on peut s’en douter, le bon vieil équilibrage de charge algorithmique s’appuie sur des algorithmes pour prendre ses décisions. Ainsi, des algorithmes de répartition tels que le tourniquet, le plus petit nombre de connexions, le temps de réponse le plus rapide et leurs équivalents pondérés sont utilisés pour sélectionner la ressource qui répondra à chaque requête.
La décision est simple. À l’image du ratel, les algorithmes ne se soucient de rien d’autre que de s’exécuter en fonction des données disponibles. Si cinq ressources sont disponibles, l’une d’entre elles sera sélectionnée selon l’algorithme. Point final.
Comme vous pouvez l’imaginer, l’équilibrage de charge basé sur des algorithmes est assez rapide. Avec la puissance de calcul actuelle, l’exécution de l’algorithme approprié et la prise de décision ne prennent pas beaucoup de temps. À l’exception de l’algorithme round-robin et de certains algorithmes de répartition pondérée, les algorithmes conservent un état. Cela signifie qu’ils doivent suivre des variables telles que « combien de connexions sont actuellement établies avec les ressources A, B et C ? » ou « Quelle ressource a répondu le plus rapidement à la dernière requête reçue ? ». L’équilibreur de charge doit assurer le suivi de ces informations. Celles-ci peuvent devenir très volumineuses et nécessiter davantage de ressources pour être gérées dans les environnements où sont mises à l’échelle des applications monolithiques traditionnelles nécessitant de nombreuses connexions de longue durée.
L’équilibrage de charge classique excelle dans la mise à l’échelle des microservices. En effet, chaque microservice remplit — ou devrait remplir, dans une architecture idéale — une seule fonction. La mise à l’échelle de ces services s’effectue facilement à l’aide d’un algorithme simple (généralement de type round robin), car leurs capacités et leurs performances sont globalement équivalentes. Compte tenu de la nature des architectures de microservices, qui peuvent nécessiter plusieurs appels de service pour répondre à une seule requête utilisateur, il est indispensable de prendre des décisions rapidement. L’équilibrage de charge reposant sur un algorithme simple constitue donc un choix judicieux pour ce type d’environnement.
La règle générale est la suivante : si vous mettez à l’échelle des services simples dotés d’un ensemble limité de fonctions, dont les performances sont globalement équivalentes, un simple équilibrage de charge suffira. C’est ce que l’on observe au sein des environnements de conteneurs, et c’est pourquoi une grande partie des fonctionnalités natives de mise à l’échelle reposent sur des algorithmes simples.
Pour les autres applications et cas de figure, vous devrez vous tourner vers un équilibrage de charge fondé sur l’architecture.
Répartition de charge HTTP
L’équilibrage de charge basé sur l’architecture est l’art (oui, un art et non une science) d’utiliser un équilibreur de charge pour répartir et traiter les requêtes de manière adaptée à l’architecture de l’application qu’il met à l’échelle. L’équilibrage de charge basé sur l’architecture consiste davantage à orienter le trafic qu’à le répartir. En effet, il exploite la couche 7 (généralement HTTP) pour déterminer où une requête donnée doit être acheminée, d’où l’appellation courante d’équilibrage de charge HTTP (parmi d’autres termes plus ésotériques et davantage axés sur les réseaux).
La capacité à acheminer les requêtes devient de plus en plus importante dans un monde exposé par des API et reposant sur des microservices. En effet, il faut pouvoir acheminer les requêtes d’API en fonction de leur version, utiliser des noms d’hôte ou des chemins URI pour les diriger vers des microservices spécifiques, ou encore décomposer une application selon ses fonctionnalités.
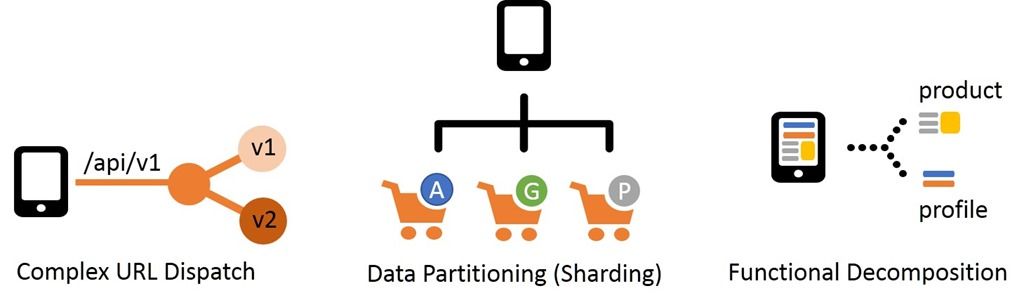
La plupart des organisations souhaitent proposer une API cohérente et facile à utiliser. Qu’il s’agisse d’encourager les développeurs citoyens à créer de nouvelles applications utilisant l’API ou de permettre aux partenaires de se connecter et de réaliser facilement des intégrations, une API simple et cohérente est indispensable pour en favoriser l’adoption.
Mais dans la pratique, les API sont souvent complexes. Elles reposent sur plusieurs services (souvent des microservices) et peuvent être réparties sur différents sites. Elles se limitent rarement à un seul service. Pour compliquer les choses, elles sont mises à jour plus fréquemment que les générations précédentes d’applications et leur rétrocompatibilité n’est pas toujours garantie. En outre, les applications mobiles peuvent utiliser à la fois des ressources anciennes et nouvelles, en partageant des images avec des applications web et en utilisant les mêmes API que tout le monde.
La mise à l’échelle de ces « applications » et API nécessite une approche architecturale de l’équilibrage de charge. Vous devez orienter le trafic avant de le répartir, ce qui implique d’utiliser un équilibreur de charge compatible avec la couche 7 (HTTP) afin de mettre en œuvre des modèles architecturaux tels que le routage par URL, le partitionnement des données et la décomposition fonctionnelle. Chacun de ces modèles est de nature architecturale et doit être davantage aligné sur la conception de l’application ou de l’API que dans le cas des applications traditionnelles.
La répartition de charge HTTP joue un rôle de plus en plus important pour faire évoluer les applications tout en conciliant efficacité et agilité, ainsi que pour prendre en charge les API.
L’évolutivité nécessite les deux
Dans la pratique, il est rare de ne rencontrer qu’un seul type de mise à l’échelle. En effet, les organisations proposent de plus en plus souvent un vaste éventail d’applications couvrant plusieurs décennies de développement, d’architectures applicatives, de plateformes et de technologies. Très peu d’entre elles peuvent se targuer de ne prendre en charge que des applications « modernes » (à moins que ce terme ne désigne tout ce qui ne s’exécute pas sur un ordinateur central).
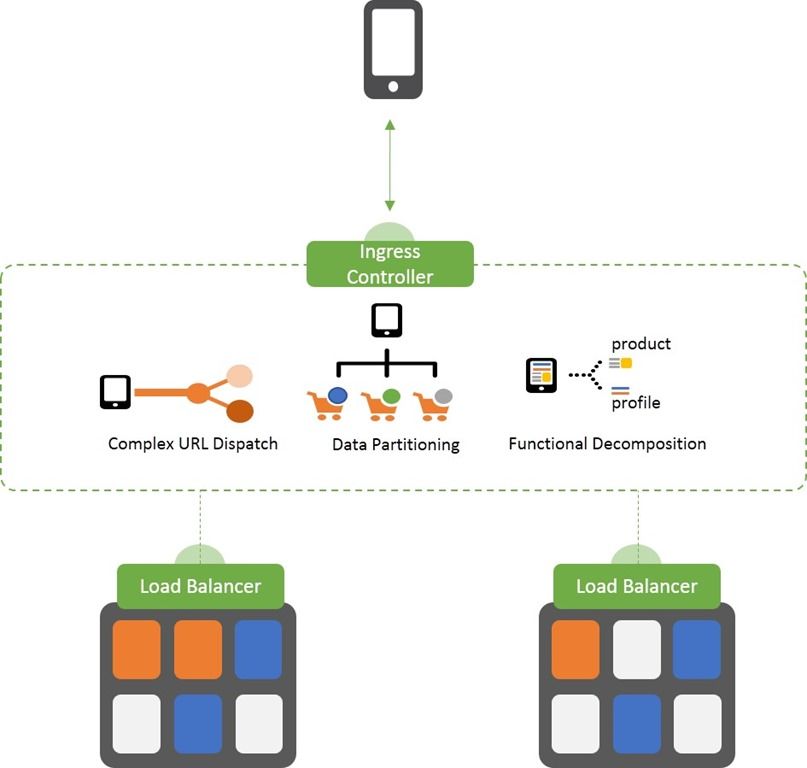
Ainsi, vous serez probablement amené à rencontrer – et à utiliser – à la fois l’équilibrage de charge algorithmique et l’équilibrage de charge architectural pour faire évoluer diverses applications. Il est donc important de bien comprendre la différence, car utiliser l’un alors que l’autre serait plus approprié peut entraîner de mauvaises performances et/ou des interruptions de service, ce qui n’est bon ni pour les utilisateurs, ni pour l’entreprise, ni pour vous, d’ailleurs.
Vous verrez de plus en plus souvent ces deux approches combinées pour assurer la montée en charge des applications modernes. Elles peuvent parfois coexister au sein d’un même service conçu pour faire évoluer à la fois la couche logique (l’API) et la couche physique (le service réel derrière l’API). Les contrôleurs de mise à disposition d’applications (ADC) constituent généralement la plateforme sur laquelle cette approche combinée est mise en œuvre, car ils sont capables de remplir ces deux fonctions avec la même efficacité.
Ces opérations sont parfois assurées par deux systèmes distincts. Par exemple, dans les environnements conteneurisés, un contrôleur d’entrée est chargé de l’équilibrage de charge architectural, tandis que les services natifs internes assurent généralement la mise à l’échelle au moyen d’un équilibrage de charge algorithmique.
Quels que soient les détails de mise en œuvre et de déploiement, les approches algorithmiques et architecturales de l’équilibrage de charge ont toutes deux un rôle à jouer dans la mise à l’échelle des applications et des API. Pour tirer pleinement parti de leurs points forts, il est essentiel d’adapter l’équilibrage de charge à l’architecture de l’application.
Passez à l’échelle.
À propos de l’auteur

Lori MacVittie est ingénieure émérite et évangéliste en chef au sein du bureau du directeur technique de F5. Elle possède une expertise approfondie dans la fourniture d’applications, les stratégies d’automatisation et les infrastructures. Elle est réputée pour sa capacité à rendre la complexité intelligible, qu’elle définisse des garde-fous pour les agents d’IA, analyse des architectures multicloud fragiles ou explore les limites des systèmes évolutifs. Elle cumule plus de trente ans d’expérience dans le secteur, couvrant le développement d’applications, l’architecture informatique ainsi que l’exploitation des réseaux et des systèmes. Avant de rejoindre F5, elle a été rédactrice spécialisée dans les technologies et a reçu plusieurs distinctions. MacVittie est titulaire d’un master en informatique et est une autrice prolifique dont les publications couvrent la sécurité, le cloud et l’architecture d’entreprise. Elle est également une passionnée de jeux de société et de jeux vidéo, et assume pleinement ses avis bien tranchés sur le fromage.
Autres articles de Lori Mac VittieArticles de blog associés

F5 NGINXaaS pour Google Cloud : des applications résilientes et évolutives
Découvrez comment NGINXaaS s’intègre à Google Cloud pour renforcer les performances et la sécurité, et préparer vos applications critiques à un avenir propulsé par l’IA.

L’intégration de F5 Web Application Firewall (WAF) à AWS est disponible dès aujourd’hui
En faisant appel à un partenaire de déploiement AWS WAF tel que F5, vous pouvez renforcer la sécurité de vos applications web grâce à des règles personnalisées qui bloquent les schémas d’attaque courants, comme les injections SQL ou les attaques par scripts intersites (XSS).
Appliquer le principe de Peter Parker à l’inspection TLS
« Un grand pouvoir implique de grandes responsabilités. » Si l’on en trouve des échos chez Voltaire et Churchill, cette citation est surtout connue grâce aux bandes dessinées Spider-Man, où elle est attribuée à l’oncle Ben. Bien entendu, si cette phrase est si répandue dans la culture populaire, c’est notamment parce qu’elle peut s’appliquer à une multitude de situations et de sujets, y compris à l’inspection TLS.
Le NetOps a besoin de défenseurs, pas d’adversaires
Il est important de reconnaître que les équipes NetOps ne sont pas toujours celles qui font obstacle au déploiement de la dernière nouveauté, application ou service. Les freins à la rapidité sont souvent dus au fait que les organisations n’adoptent pas tous les principes du DevOps lorsqu’elles cherchent à transformer leurs opérations informatiques.
Mise à jour des services applicatifs : sécurité, rapidité et visiteurs suspects
Il est de nouveau temps de nous pencher sur les services applicatifs que les entreprises utilisent réellement pour rendre leurs applications plus rapides et plus sûres. On constate notamment une hausse du recours aux services de protection contre les bots, ainsi que la progression lente mais régulière de HTTP/2. Bien qu’il ne s’agisse pas d’une application…
Les templates prennent le contrôle du cloud
Les modèles s’imposent dans le cloud. Lisez le blog de F5 pour découvrir comment l’infrastructure en tant que code et les API déclaratives automatisent la mise à disposition des applications.