
Chez Volterra, l’équipe SRE est chargée d’exploiter une plateforme edge mondiale basée sur un modèle SaaS. Nous devons relever différents défis liés à la gestion d’un grand nombre de clusters d’applications dans divers états (par exemple, en ligne, hors ligne, désactivés par un administrateur, etc.). Pour ce faire, nous nous appuyons sur l’écosystème et les outils Kubernetes, avec un modèle déclaratif fondé sur l’extraction utilisant GitOps.
Dans cet article de blog, nous décrirons :
Utiliser GitOps pour gérer et surveiller efficacement un vaste parc d’infrastructures (hôtes physiques ou cloud) et de clusters K8s
- Les outils que nous avons développés pour résoudre les problématiques liées à la CI/CD
- Orchestration des objets et gestion de la configuration
- Observabilité sur l’ensemble du parc de clusters d’infrastructure et K8s
Nous approfondirons le sujet en nous appuyant sur les enseignements tirés d’un déploiement à grande échelle (3 000 sites en périphérie), également abordés lors de ma récente présentation à Cloud Native Rejekts, à San Diego.
TL;DR (Résumé)
- Nous n’avons pas trouvé de solution simple et prête à l’emploi permettant de déployer et d’exploiter des milliers (voire potentiellement des millions) de clusters d’applications et d’infrastructure dans des clouds publics, sur site ou dans des environnements nomades.
- Cette solution devait assurer la gestion du cycle de vie des hôtes (physiques ou dans le cloud), du plan de contrôle Kubernetes et des charges de travail applicatives, ainsi que la configuration continue de divers services. En outre, elle devait répondre à nos exigences de conception SRE : définition déclarative, cycle de vie immuable, GitOps et aucun accès direct aux clusters.
- Après avoir évalué différents projets open source — par exemple Kubespray+Ansible (pour le déploiement de Kubernetes) ou Helm/Spinnaker (pour la gestion des charges de travail) — nous sommes arrivés à la conclusion qu’aucune de ces solutions ne pouvait répondre aux exigences énoncées ci-dessus sans alourdir considérablement la pile logicielle de chaque site périphérique. Nous avons donc décidé de développer notre propre démon logiciel basé sur Golang, chargé de gérer le cycle de vie de l’hôte (physique ou cloud), du plan de contrôle Kubernetes et des charges de travail applicatives.
- À mesure que nous avons fait évoluer le système pour prendre en charge 3 000 clusters et plus (au sein d’un même tenant), toutes nos hypothèses concernant nos fournisseurs de cloud public, la capacité de nos démons logiciels à monter en charge, nos outils d’exploitation et notre infrastructure d’observabilité ont été systématiquement remises en cause. Pour relever chacun de ces défis, nous avons dû repenser l’architecture de certains de nos composants logiciels.
Définition de l’Edge
- Customer Edge (CE) — Il s’agit d’emplacements clients dans le cloud (comme AWS, Azure, GCP ou un cloud privé), sur site (comme un atelier de production, une installation pétrolière ou gazière, etc.) ou nomades (comme des véhicules, des systèmes robotiques, etc.). Le CE est géré par l’équipe SRE de Volterra, mais peut également être déployé à la demande par les clients dans les emplacements de leur choix.
- Périphéries régionales (RE) — Il s’agit de points de présence (PoP) Volterra situés dans des centres de colocation au sein des principales métropoles et interconnectés par notre propre réseau fédérateur privé fortement maillé. Ces sites périphériques régionaux servent également à interconnecter de manière sécurisée les sites périphériques clients (CE) et/ou à exposer des services applicatifs sur l’Internet public. Les sites RE sont entièrement gérés et détenus par l’équipe chargée des opérations d’infrastructure de Volterra (Infra SRE).
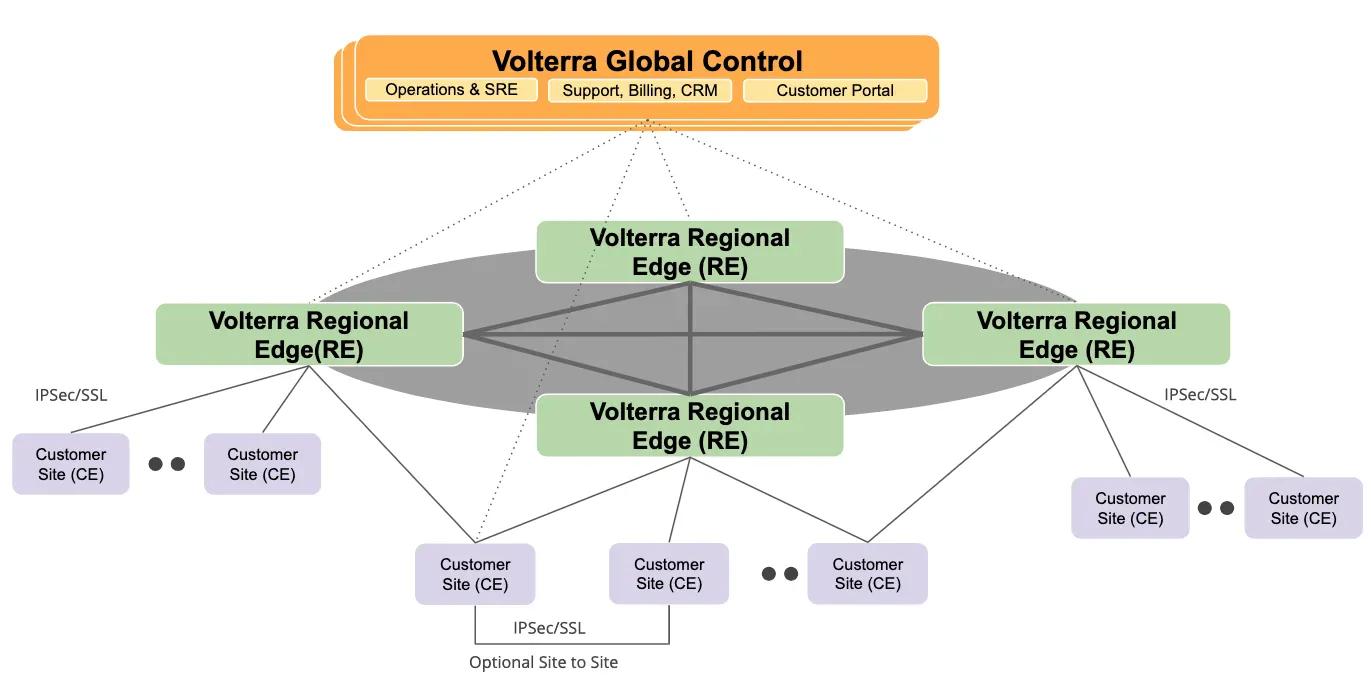
Le schéma d’architecture ci-dessus (figure 1) illustre la connectivité logique entre nos RE et nos CE, chaque CE établissant des connexions redondantes (VPN IPSec ou SSL) avec le RE le plus proche.
Exigences relatives à la gestion de la périphérie
Lorsque nous avons commencé à concevoir notre plateforme il y a environ deux ans, notre équipe produit nous a demandé de relever les défis suivants :
- Évolutivité du système — nos clients avaient besoin que nous prenions en charge des milliers (et à terme des millions) de sites périphériques, ce qui est très différent de l’exploitation de quelques clusters Kubernetes dans des régions cloud. Par exemple, l’un de nos clients possède environ 17 000 supérettes et un autre exploite plus de 20 000 bornes de recharge. Cette échelle nous a obligés à concevoir nos outils très différemment de ceux destinés à la gestion de quelques clusters.
- Déploiement sans intervention — puisque n’importe qui doit pouvoir déployer un nouveau site sans avoir de connaissances approfondies du matériel, des logiciels ou de Kubernetes. Le site en périphérie doit fonctionner comme une boîte noire qui s’allume, contacte le système central et se connecte.
- Gestion de parc — gestion simplifiée de milliers de sites et de charges de travail, sans avoir à les traiter individuellement. Un site peut être hors ligne ou indisponible au moment où une modification ou une mise à niveau est demandée. Les sites doivent donc récupérer les mises à jour lorsqu’ils se reconnectent.
- Tolérance aux pannes — les sites en périphérie doivent rester opérationnels même en cas de défaillance de l’un de leurs composants. Tout doit pouvoir être géré à distance et offrir des fonctionnalités telles que la réinitialisation aux paramètres d’usine ou la reconstruction du site en cas de panne. Nous avons dû partir du principe qu’aucun accès physique au site n’était possible.
Principes de conception (pas de Kubectl ! Pas d’Ansible ! Pas de paquets !)
Compte tenu de nos exigences et des défis liés à l’exploitation d’un système hautement distribué, nous avons décidé d’établir plusieurs principes que notre équipe SRE devait respecter afin de limiter les problèmes en aval :
- Définition déclarative — l’ensemble du système doit être décrit de manière déclarative, car cela nous permet de créer un modèle d’abstraction simple et d’effectuer des validations par rapport à ce modèle.
- Gestion immuable du cycle de vie — par le passé, nous travaillions sur de vastes installations de cloud privé à l’aide d’outils de gestion du cycle de vie autorisant les modifications, tels qu’Ansible, Salt ou Puppet. Cette fois-ci, nous souhaitions conserver un système d’exploitation de base très simple et essayer de tout fournir sous forme de conteneurs, sans gestionnaire de paquets ni outils de gestion de la configuration.
- GitOps — fournit un modèle opérationnel standard pour la gestion des clusters Kubernetes. Il nous permet également de disposer nativement de processus d’approbation, d’audits et de workflows de modification, sans avoir à développer un système supplémentaire de gestion des workflows. Nous avons donc décidé que tout devait passer par git.
- Pas de kubectl — Il s’agissait de l’un des principes les plus importants, car personne n’est autorisé à accéder directement aux clusters d’applications. Par conséquent, nous avons supprimé la possibilité d’exécuter kubectl au sein des différents clusters en périphérie ou d’utiliser des scripts exécutés depuis des emplacements centraux, notamment des systèmes de déploiement continu centralisés. Les systèmes de déploiement continu centralisés utilisant une méthode push conviennent à quelques dizaines de clusters, mais certainement pas à des milliers sans garantie d’une disponibilité réseau de 100 %.
- Pas de technologies (ni d’outils) à la mode — notre expérience passée nous a montré que de nombreux outils open source populaires ne sont pas à la hauteur de leur réputation. Après avoir évalué plusieurs projets communautaires pour le déploiement de l’infrastructure, de K8s et des charges de travail applicatives (notamment Helm, Spinnaker et Terraform), nous avons finalement utilisé uniquement Terraform pour la partie infrastructure virtuelle et développé du code sur mesure, que nous décrirons dans les prochains articles de ce blog.
Gestion du cycle de vie des sites
Dans le cadre de la gestion du cycle de vie des sites en périphérie, nous avons dû déterminer comment provisionner le système d’exploitation hôte, effectuer les configurations de base (par exemple, la gestion des utilisateurs, l’autorité de certification, les pages mémoire volumineuses, etc.), mettre en place K8s, déployer les charges de travail et gérer les modifications de configuration au fil du temps.
L’une des options que nous avons envisagées, mais finalement écartées, consistait à utiliser KubeSpray+Ansible (pour gérer le système d’exploitation et déployer K8s) ainsi que Helm/Spinnaker (pour déployer les charges de travail). Nous avons rejeté cette solution, car elle nous aurait obligés à gérer deux à trois outils open source, puis à les modifier en profondeur pour répondre à nos exigences, qui ne cessaient de croître à mesure que nous ajoutions des fonctionnalités telles que la mise à l’échelle automatique des clusters en périphérie, la prise en charge des modules TPM sécurisés, les mises à niveau différentielles, etc.
Comme notre objectif était de rester simples et de réduire au minimum le nombre de composants s’exécutant directement dans le système d’exploitation (en dehors de Kubernetes), nous avons décidé de développer un démon léger en Golang appelé Volterra Platform Manager (VPM). Il s’agit du seul conteneur Docker géré par systemd dans le système d’exploitation, et il fait office de couteau suisse en assurant de nombreuses fonctions :
Cycle de vie de l’hôte
VPM est chargé de gérer le cycle de vie du système d’exploitation hôte, notamment son installation, ses mises à niveau, ses correctifs et sa configuration. De nombreux éléments doivent être configurés (par exemple, l’allocation des pages mémoire volumineuses, /etc/hosts, etc.).
- Gestion des mises à niveau du système d’exploitation — malheureusement, l’edge ne se limite pas à Kubernetes et nous devons gérer la version du noyau ainsi que celle du système d’exploitation dans son ensemble. Notre infrastructure edge repose sur CoreOS (ou CentOS, selon les besoins du client), avec une partition active et une partition passive. Lorsqu’une mise à niveau est planifiée, les mises à jour sont toujours téléchargées sur la partition passive. Le redémarrage constitue la dernière étape de la mise à jour, au cours de laquelle les partitions active et passive sont interverties. Le seul point délicat concerne la stratégie de redémarrage (pour un cluster à plusieurs nœuds), car tous les nœuds ne peuvent pas être redémarrés simultanément. Nous avons mis en œuvre notre propre verrou de redémarrage etcd (dans VPM), afin que les nœuds d’un cluster soient redémarrés un par un.
- Gestion de l’accès des utilisateurs au système d’exploitation — nous devons restreindre les utilisateurs ainsi que leur accès à distance via SSH et à la console. VPM prend en charge toutes ces opérations, notamment la rotation des autorités de certification SSH.
- Comme nous avons développé notre propre chemin de données L3-L7, nous devons configurer des pages volumineuses de 2 Mo ou 1 Go dans le système d’exploitation hôte, selon le type de matériel (ou de machine virtuelle cloud)
Cycle de vie de Kubernetes
Gestion du cycle de vie des manifestes Kubernetes. Au lieu d’utiliser Helm, nous avons choisi la bibliothèque K8s client-go, que nous avons intégrée à VPM et dont nous avons utilisé plusieurs fonctionnalités :
- Déploiement optimiste ou pessimiste — cette fonctionnalité nous permet de classer les applications selon qu’il est nécessaire ou non d’attendre qu’elles soient opérationnelles. Elle vérifie simplement la présence de l’annotation suivante dans le manifeste K8s : ves.io/deploy: optimistic.Optimiste = crée la ressource sans attendre son statut. Ce comportement est très similaire à celui de la commande kubernetes apply, avec laquelle on ne sait pas si les pods démarrent effectivement correctement. Pessimiste = attend l’état de la ressource Kubernetes. Par exemple, pour un déploiement, le système attend que tous les pods soient prêts. Ce comportement est similaire à celui de la nouvelle commande kubectl wait.
- Actions préalables à la mise à jour, telles que le pré-téléchargement — il n’est parfois pas possible de s’appuyer sur les mises à jour progressives de K8s, en particulier lorsque le plan de données réseau est déployé. En effet, l’ancien pod est détruit avant que l’image du nouveau pod ne soit téléchargée. Or, dans le cas du plan de données, la connectivité réseau est alors perdue. La nouvelle image de conteneur ne peut donc pas être téléchargée et le pod ne démarrera jamais. L’annotation de métadonnées ves.io/prepull, accompagnée d’une liste d’images, déclenche leur téléchargement avant l’application du manifeste K8s.
- Nouvelles tentatives et restaurations en cas d’échec de l’application. Cette situation est très courante lorsqu’un serveur d’API K8s subit des interruptions intermittentes.
Configuration continue
Outre les configurations liées aux manifestes K8s, nous devons également configurer divers services Volterra via leurs API. Les configurations de VPN IPsec/SSL en sont un exemple : VPM reçoit la configuration de notre plan de contrôle global et l’applique aux différents nœuds.
Rétablissement des paramètres d’usine
Cette fonctionnalité nous permet de réinitialiser à distance un boîtier à son état d’origine et de recommencer l’intégralité du processus d’installation et d’enregistrement. Elle est essentielle pour rétablir un site qui nécessiterait autrement un accès à la console ou un accès physique.
Même si la gestion du cycle de vie de K8s peut sembler être un vaste sujet de discussion pour beaucoup, elle ne représente probablement que 40 à 50 % de la charge de travail globale de notre équipe.
Provisionnement sans intervention
Le provisionnement sans intervention des sites en périphérie, quel que soit leur emplacement (cloud, sur site ou périphérie nomade), est une fonctionnalité essentielle, car nous ne pouvons pas compter sur un accès à chaque site et ne souhaitons pas non plus mobiliser autant d’experts Kubernetes pour installer et gérer chacun d’entre eux. Cette approche n’est tout simplement pas viable à l’échelle de milliers de sites.
Le schéma suivant (figure 2) illustre le rôle de VPM dans le processus d’enregistrement d’un nouveau site :
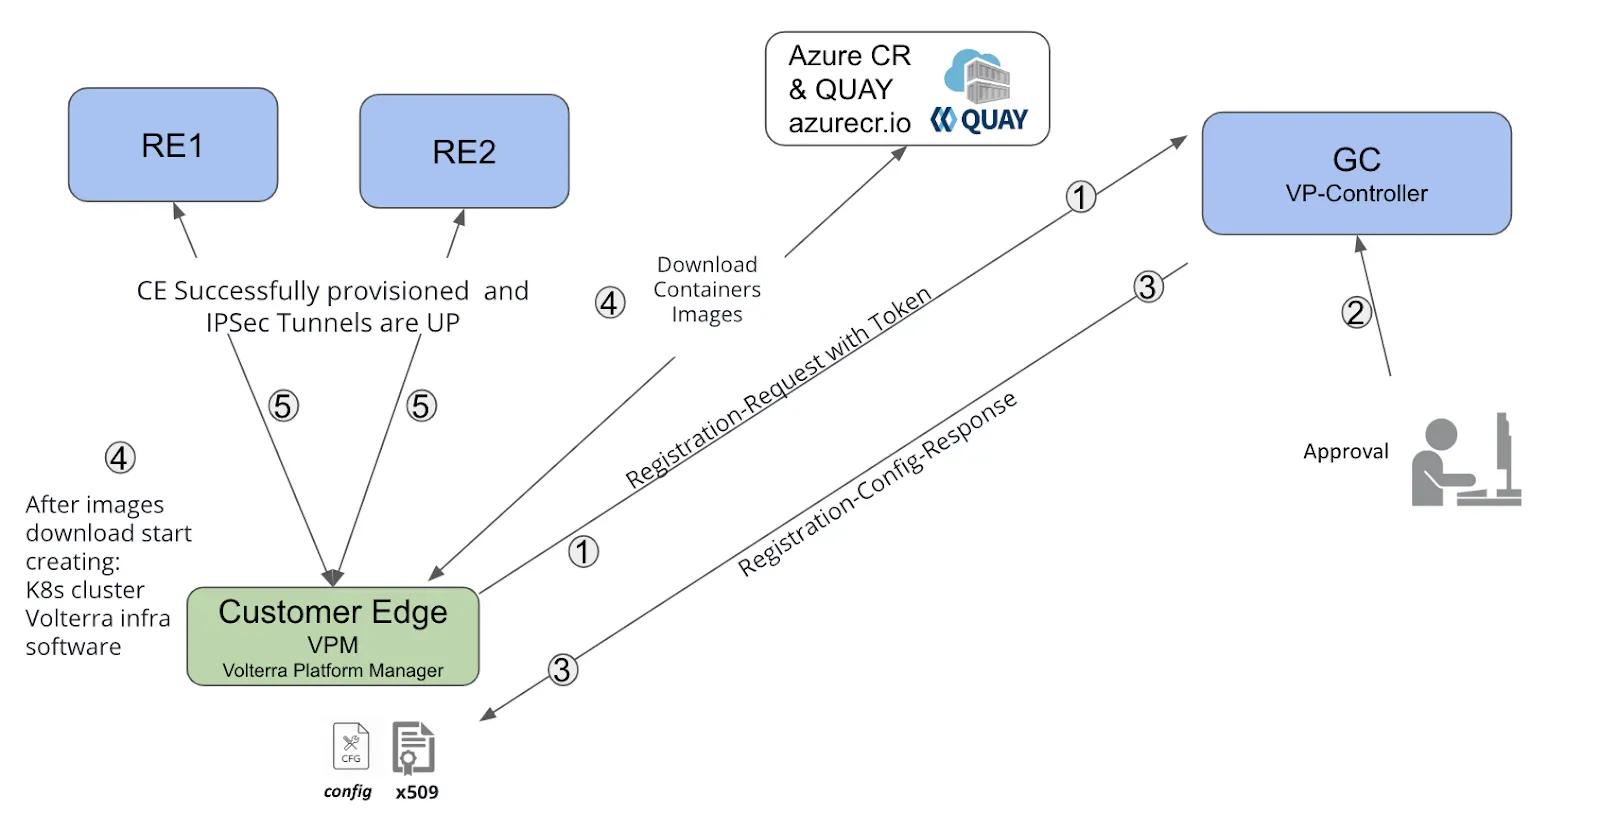
- Une fois sous tension, le VPM exécuté sur le CE (représenté par l’encadré vert) présentera un jeton d’enregistrement à notre plan de contrôle global (GC) afin de créer un nouvel enregistrement. Ce jeton est fourni dans le cadre du cloud-init de la machine virtuelle cloud. Il peut également s’agir d’une clé saisie manuellement lors du démarrage ou programmée dans le TPM pour le matériel en périphérie.
- Le GC reçoit la requête accompagnée du jeton, ce qui lui permet de créer un nouvel enregistrement pour un locataire (encodé dans le jeton). L’opérateur du client peut immédiatement voir le nouveau site périphérique sur la carte et l’approuver, tout en ayant la possibilité de saisir son nom et d’autres paramètres de configuration.
- Le VP-Controller au sein de GC génère la configuration (par exemple, détermine les nœuds K8s maître, minion, etc.) ainsi que les certificats pour etcd, K8s et VPM.
- VPM commence l’amorçage du site, notamment en téléchargeant les images Docker, en configurant les pages volumineuses, en installant le cluster K8s et en démarrant les services du plan de contrôle Volterra.
- VPM configure des tunnels redondants (VPN IPSec/SSL) vers les deux sites Regional Edge les plus proches. Ces tunnels seront utilisés pour le trafic de données et l’interconnexion entre les sites et le réseau public.
Comme vous pouvez le constater, l’ensemble du processus est entièrement automatisé. L’utilisateur n’a pas besoin de connaître les détails de la configuration ni d’effectuer la moindre étape manuelle. Il faut environ 5 minutes pour que l’appareil soit entièrement opérationnel et prêt à traiter les applications et les requêtes des clients.
Mises à niveau des logiciels d’infrastructure
La mise à niveau est l’un des problèmes les plus complexes que nous ayons eu à résoudre. Définissons ce qui est mis à niveau sur les sites en périphérie :
- Mises à niveau du système d’exploitation — cela couvre le noyau et tous les paquets système. Quiconque a déjà administré une distribution Linux standard connaît les difficultés liées aux mises à niveau entre versions mineures (par exemple, passer d’Ubuntu 16.04.x à 16.04.y), et plus encore entre versions majeures (par exemple, passer d’Ubuntu 16.04 à 18.04). Lorsqu’il s’agit de milliers de sites, les mises à niveau doivent être déterministes et ne peuvent pas se dérouler différemment d’un site à l’autre. Nous avons donc choisi CoreOS et CentOS Atomic, qui permettent d’effectuer des mises à niveau A/B avec deux partitions et un système de fichiers en lecture seule sur certains chemins. Nous pouvons ainsi revenir immédiatement à la version précédente en modifiant l’ordre de démarrage des partitions, tout en préservant la cohérence du système d’exploitation sans avoir à gérer ses paquets. En revanche, nous ne pouvons plus mettre à niveau séparément certains composants du système, par exemple le serveur openssh, en installant simplement un nouveau paquet. Toute modification apportée à un composant doit être publiée sous la forme d’une nouvelle version immuable du système d’exploitation.
- Mises à niveau logicielles — cela couvre VPM, etcd, Kubernetes et les services de contrôle Volterra exécutés en tant que charges de travail K8s. Comme je l’ai déjà indiqué, notre objectif est que tout ce qui se trouve dans K8s s’exécute dans un conteneur systemd. Heureusement, nous avons pu tout convertir en charges de travail K8s, à l’exception de trois services : VPM, etcd et kubelet.
Il existe deux méthodes connues permettant de déployer des mises à jour sur les sites périphériques :
- Approche push — une méthode push est généralement mise en œuvre à l’aide d’un outil centralisé de CD (livraison continue), tel que Spinnaker, Jenkins ou un outil de gestion de configuration basé sur Ansible. Dans ce cas, l’outil central doit avoir accès au site ou au cluster cible et être disponible pour effectuer l’opération.
- Basée sur l’extraction — une méthode basée sur l’extraction récupère les informations de mise à niveau de manière autonome, sans mécanisme de déploiement centralisé. Elle offre une meilleure évolutivité et évite également d’avoir à stocker les identifiants de tous les sites en un seul endroit.
Notre objectif en matière de mise à niveau était de maximiser la simplicité et la fiabilité, à l’image des mises à niveau classiques des téléphones portables. En outre, la stratégie de mise à niveau devait répondre à d’autres contraintes : la mise à niveau peut devoir être effectuée uniquement par l’opérateur du site, ou l’appareil peut être hors ligne ou indisponible pendant un certain temps en raison de problèmes de connectivité, entre autres. La méthode par extraction permettait de répondre plus facilement à ces exigences ; nous avons donc décidé de l’adopter pour répondre à nos besoins.
GitOps
De plus, nous avons choisi GitOps, car cette approche nous permettait de fournir plus facilement à notre équipe SRE un modèle opérationnel standard pour gérer les clusters Kubernetes et les workflows, ainsi que pour auditer les modifications.
Afin de résoudre les problèmes de mise à l’échelle liés à des milliers de sites, nous avons conçu l’architecture SRE présentée dans la figure 3 :
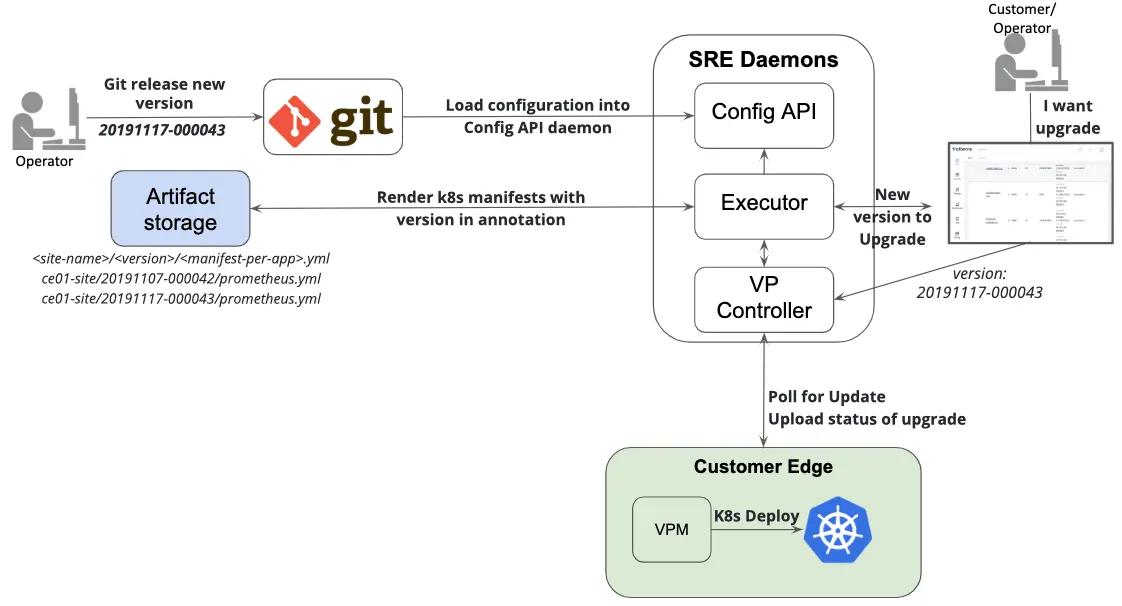
Tout d’abord, je tiens à souligner que nous n’utilisons pas Git uniquement pour stocker l’état ou les manifestes. En effet, notre plateforme doit gérer non seulement les manifestes K8s, mais aussi les configurations d’API en cours, les versions de K8s, etc. Dans notre cas, les manifestes K8s représentent environ 60 % de l’ensemble de la configuration déclarative. Nous avons donc dû concevoir notre propre couche d’abstraction DSL, stockée dans Git. Par ailleurs, comme Git ne fournit ni API ni fonctionnalité de fusion de paramètres, nous avons dû développer des démons Golang supplémentaires pour le SRE : Config API, Executor et VP Controller.
Passons en revue le processus de déploiement d’une nouvelle version logicielle en périphérie chez le client à l’aide de notre plateforme SaaS :
- L’opérateur décide de publier une nouvelle version et ouvre une demande de fusion (MR) sur le modèle Git
- Une fois cette MR approuvée et fusionnée, la CI déclenche le chargement d’une configuration du modèle Git dans notre démon SRE Config-API. Ce démon dispose de plusieurs API permettant notamment de fusionner des paramètres et de configurer le DNS interne.
- Config-API est surveillée par le démon Executor. Dès que les modifications git sont chargées, il commence à générer les manifestes K8s finaux, avec la version indiquée dans une annotation. Ces manifestes sont ensuite téléversés vers le stockage d’artefacts (de type S3) sous le chemin ce01-site//.yml
- Une fois la nouvelle version générée et chargée dans le stockage d’artefacts, Executor transmet à l’API client un nouveau statut indiquant qu’une version est disponible, à l’image des nouvelles versions proposées sur les téléphones portables.
- Le client (ou l’opérateur) peut planifier la mise à jour de son site vers la dernière version. Cette information est alors transmise à VP-Controller. VP-Controller est le démon chargé de la gestion des sites, notamment de leur provisionnement, de leur mise hors service ou de leur migration vers un autre emplacement. Son rôle a déjà été partiellement expliqué dans la section consacrée au provisionnement sans intervention et il est chargé de mettre à jour les sites en périphérie via l’API mTLS.
- La dernière étape du diagramme se déroule sur le site périphérique : une fois la connexion VPN IPSec/SSL établie, VP-Controller demande au VPM du site périphérique de télécharger les mises à jour vers la nouvelle version. Toutefois, si la connexion est interrompue ou rencontre des problèmes intermittents, le VPM vérifie la disponibilité d’une mise à jour toutes les 5 minutes.
- Les nouveaux manifestes et configurations K8s sont récupérés et déployés dans K8s. Grâce à la fonctionnalité de déploiement pessimiste décrite dans la section précédente, VPM attend que tous les pods soient prêts
- Enfin, VPM renvoie l’état de la mise à niveau à VP Controller, qui le transmet à l’API client.
Vous pouvez regarder une démonstration de l’ensemble du processus ici :
Enseignements tirés des tests menés sur 3 000 sites en périphérie
Dans les sections précédentes, nous avons décrit comment nos outils sont utilisés pour déployer les sites en périphérie et gérer leur cycle de vie. Afin de valider notre conception, nous avons décidé de créer un environnement à grande échelle comprenant trois mille sites en périphérie chez nos clients (comme illustré à la figure 4).
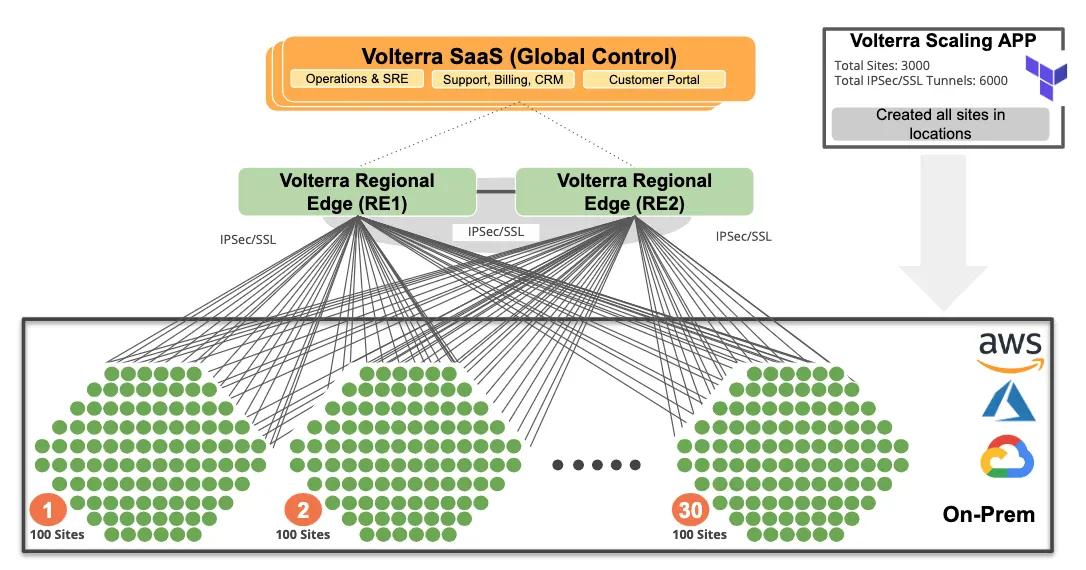
Nous avons utilisé Terraform pour provisionner 3 000 machines virtuelles sur AWS, Azure, Google et notre propre cloud bare metal sur site afin de simuler un déploiement à grande échelle. Toutes ces machines virtuelles étaient des CE (sites périphériques clients) indépendants qui établissaient des tunnels redondants vers nos sites périphériques régionaux (également appelés PoP).
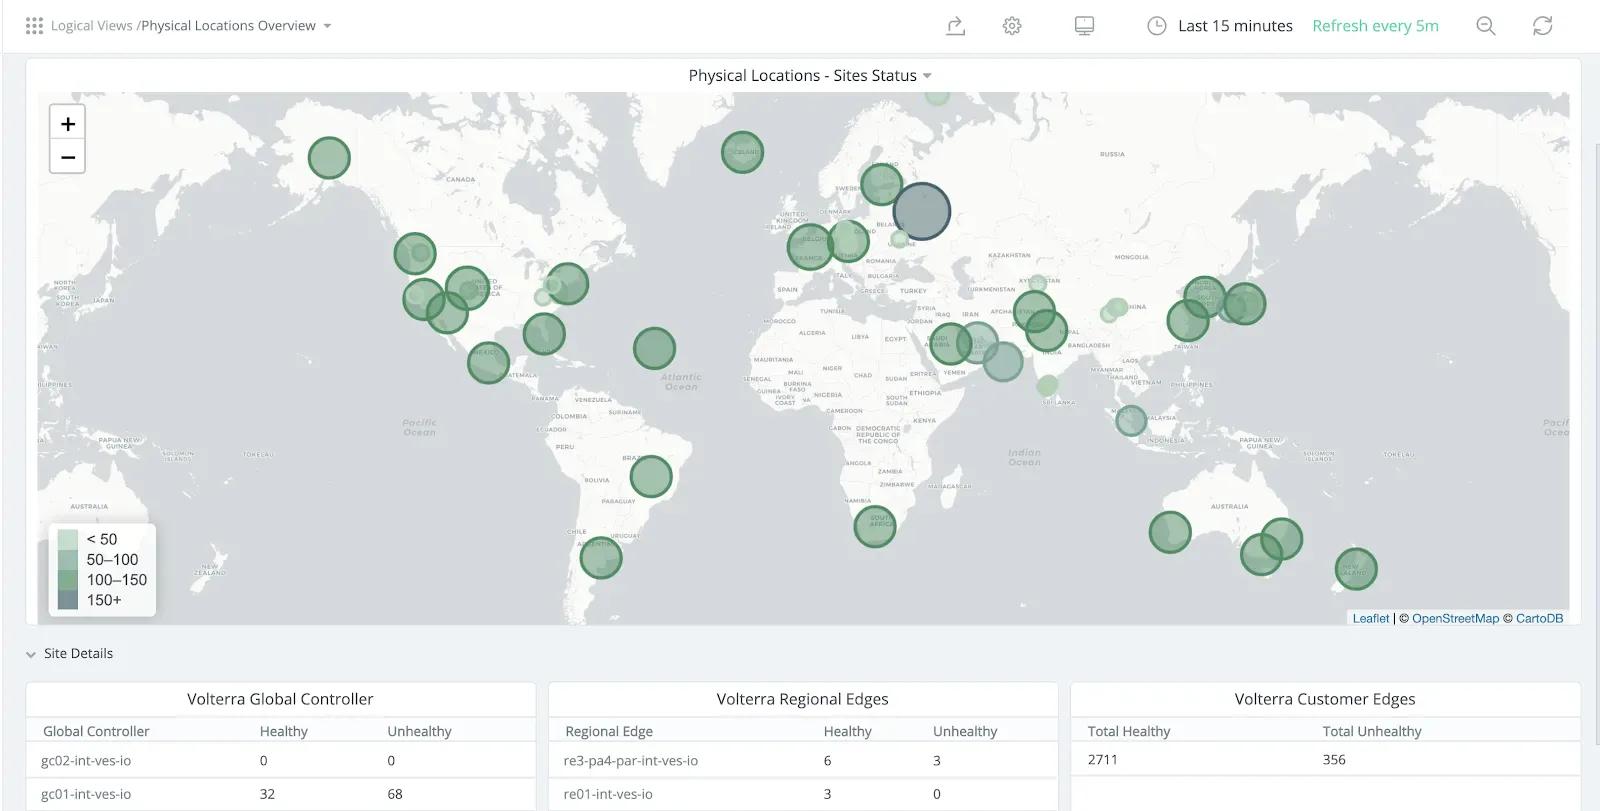
La capture d’écran ci-dessous provient de notre tableau de bord SRE et indique le nombre de sites périphériques par emplacement, représenté par la taille des cercles. Au moment de la capture, nous comptions environ 2 711 sites périphériques opérationnels et 356 défaillants.
Principales conclusions : opérations
Dans le cadre du passage à l’échelle, nous avons rencontré quelques problèmes de configuration et d’exploitation qui nous ont obligés à modifier nos démons logiciels. En outre, nous avons rencontré de nombreux problèmes avec un fournisseur de services cloud, ce qui nous a conduits à ouvrir plusieurs tickets d’assistance — par exemple, en raison de la latence des réponses de l’API, de l’impossibilité d’obtenir plus de 500 machines virtuelles dans une même région, etc.
- Optimiser VP-Controller — au départ, nous traitions les inscriptions de manière séquentielle, et chacune prenait environ deux minutes, car nous devions générer différents certificats pour etcd, kubernetes et VPM. Nous avons réduit ce délai grâce à des clés prégénérées avec une entropie plus élevée et à la parallélisation avec un plus grand nombre de workers. Cela nous a permis de traiter l’inscription de 100 sites en moins de 20 secondes. Nous avons pu prendre en charge les 3 000 sites en périphérie en ne consommant qu’environ un vCPU et 2 Go de RAM sur notre VP-Controller.
- Optimiser la distribution des images Docker — lorsque nous avons commencé à passer à l’échelle, nous avons constaté que le volume de données transmis aux sites périphériques était considérable. Chaque site périphérique téléchargeait environ 600 Mo (multipliés par 3 000), soit un total de 1,8 To de données transmises. De plus, nous avons reconstruit les sites périphériques à plusieurs reprises pendant nos tests, si bien que ce volume était en réalité beaucoup plus élevé. Nous avons donc dû optimiser la taille de nos images Docker et créer des images cloud et ISO intégrant des images Docker préchargées afin de réduire les téléchargements. Bien que nous utilisions toujours un service public de registre de conteneurs dans le cloud, nous travaillons activement à la conception d’une solution permettant de distribuer notre registre de conteneurs via les RE (PoP) et d’effectuer des mises à niveau incrémentielles (par différences binaires).
- Optimiser les opérations de la base de données de contrôle globale — tous nos services de contrôle Volterra reposent sur le framework de services Golang, qui utilise ETCD comme base de données. Chaque site est représenté sous la forme d’un objet de configuration. Chaque objet de configuration de site comporte plusieurs StatusObjects, tels que software-upgrade, hardware-info ou ipsec-status. Ces StatusObjects sont générés par différents composants de la plateforme et sont tous référencés dans une API de configuration globale. Lorsque nous avons atteint 3 000 sites, nous avons dû apporter certaines optimisations à notre schéma d’objets. Par exemple, nous avons limité le nombre de types de StatusObjects acceptés par l’API de configuration globale ou décidé de les déplacer vers une instance ETCD dédiée afin de réduire le risque de surcharge de la base de données des objets de configuration. Cela nous permet d’améliorer la disponibilité et le temps de réponse de la base de données de configuration, mais aussi de reconstruire la base de données d’état en cas de défaillance. Une autre optimisation a consisté à supprimer les opérations inutiles de listage des objets de site pour l’ensemble des locataires ou à introduire des index secondaires afin de réduire la charge sur la base de données.
Principaux enseignements : observabilité
L’observabilité d’un système distribué a posé des défis bien plus importants à mesure que nous avons fait évoluer le système.
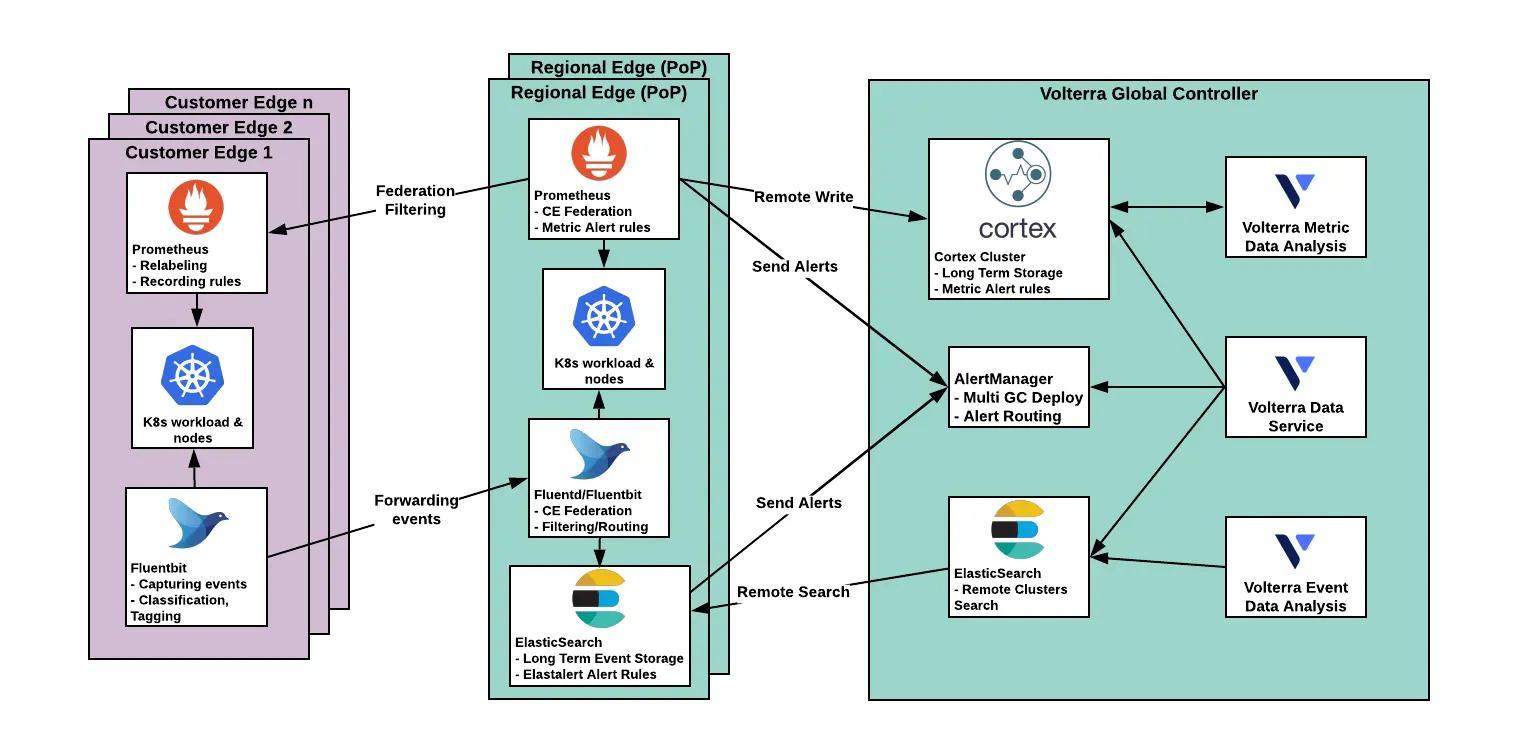
Au départ, pour les métriques, nous avons opté pour la fédération Prometheus : une instance Prometheus centrale au niveau du contrôle global fédérait les instances Prometheus déployées dans les périphéries régionales (RE), lesquelles collectaient les métriques de leurs services et fédéraient celles provenant des CE qui leur étaient connectés. L’instance Prometheus de plus haut niveau évaluait les alertes et servait de source de métriques pour des analyses plus poussées. Nous avons rapidement atteint les limites de cette approche (aux alentours de 1 000 CE) et tenté de réduire au minimum l’impact de leur nombre croissant. Nous avons commencé à générer des séries précalculées pour les histogrammes et d’autres métriques à forte cardinalité. Cela nous a fait gagner un jour ou deux, puis nous avons dû recourir à des listes blanches de métriques. Au final, nous avons réussi à ramener le nombre de séries temporelles d’environ 60 000 à 2 000 pour chaque site CE.
Finalement, après avoir poursuivi la montée en charge au-delà de 3 000 sites CE et fait fonctionner le système en production pendant de nombreux jours, il est devenu évident que cette approche n’était pas évolutive et que nous devions repenser notre infrastructure de supervision. Nous avons décidé de supprimer l’instance Prometheus de plus haut niveau (dans le contrôle global) et de scinder l’instance Prometheus de chaque RE en deux instances distinctes : l’une chargée de collecter les métriques des services locaux, l’autre de fédérer les métriques des CE. Toutes deux génèrent des alertes et envoient les métriques vers un stockage centralisé dans Cortex. Cortex sert de source pour l’analyse et la visualisation, mais ne fait pas partie du flux principal d’alertes de supervision. Nous avons testé plusieurs solutions de centralisation des métriques, notamment Thanos et M3db, et avons constaté que Cortex était la mieux adaptée à nos besoins.
La capture d’écran suivante (figure 7) montre la consommation de mémoire liée à la collecte de métriques par prometheus-cef pour 3 000 points de terminaison. Il est intéressant de noter que les 29,7 Go de RAM consommés ne représentent finalement pas tant que cela compte tenu de l’échelle du système. Cette consommation peut encore être optimisée en répartissant la collecte entre plusieurs instances ou en déplaçant l’écriture à distance vers Cortex directement en périphérie.
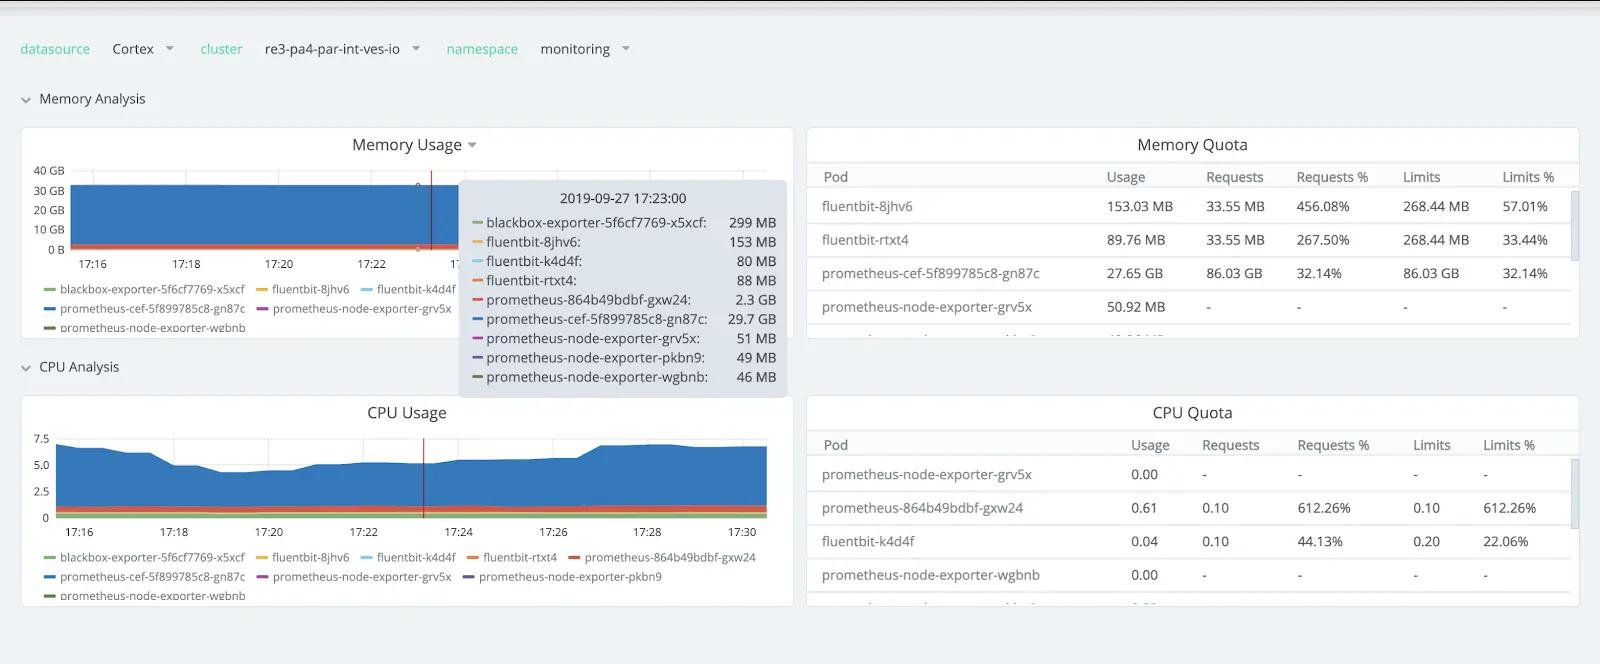
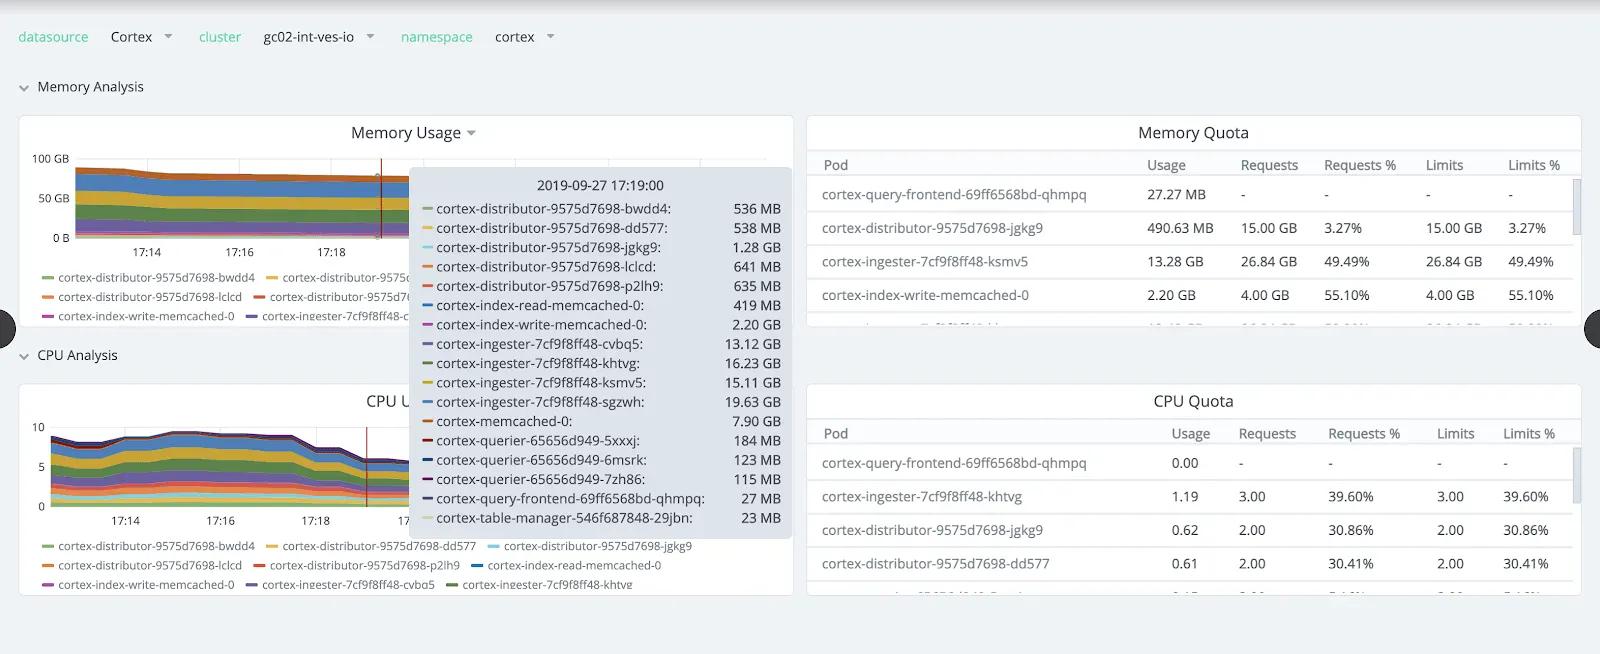
La capture d’écran suivante (Figure 8) montre la quantité de mémoire et de ressources CPU dont nous avons eu besoin pour les ingesteurs Cortex (19 Go de RAM au maximum) et les distributeurs à cette échelle. Le principal avantage de Cortex réside dans sa mise à l’échelle horizontale, qui nous permet d’ajouter davantage de réplicas, contrairement à Prometheus, dont la mise à l’échelle doit s’effectuer verticalement.
Pour l’infrastructure de journalisation des CE et des RE, nous utilisons des services Fluentbit sur chaque nœud. Ceux-ci collectent les événements des journaux des services et du système, puis les transmettent à Fluentd dans le RE connecté. Fluentd envoie les données à l’instance ElasticSearch présente dans le RE. Les données d’ElasticSearch sont analysées par Elastalert, et des règles sont définies afin de créer des alertes Alertmanager. Nous utilisons notre intégration personnalisée entre Elastalert et Alertmananger pour générer des alertes portant les mêmes libellés que celles produites par Prometheus.
Les étapes clés de notre parcours en matière de supervision :
- Utilisation de nouveaux filtres de fédération Prometheus pour supprimer les métriques et les libellés inutilisés- Au départ, nous avions environ 50 000 séries temporelles par CE, avec une moyenne de 15 libellés. Nous avons ramené ce nombre à 2 000 par CE en moyenne grâce à de simples listes blanches pour les noms de métriques et listes noires pour les noms de libellés.
- Passage d’une fédération Prometheus globale à un cluster Cortex- Le Prometheus centralisé collectait les données des instances Prometheus de tous les RE et CE - À partir de 1 000 CE, la gestion du volume de métriques est devenue intenable - Nous disposons désormais d’une instance Prometheus sur chaque RE (fédérant les instances Prometheus des CE connectés), avec écriture à distance vers Cortex
- Clusters Elasticsearch et journaux- Architecture de journalisation décentralisée - Fluent Bit, utilisé comme collecteur sur chaque nœud, transmet les journaux à Fluentd (agrégateur) dans chaque RE - Elasticsearch est déployé dans chaque RE et utilise la recherche inter-clusters à distance pour interroger les journaux depuis une seule instance Kibana
Résumé
J’espère que cet article de blog vous donnera un aperçu de tous les éléments à prendre en compte pour gérer des milliers de sites en périphérie et de clusters déployés dans le monde entier. Même si nous avons pu satisfaire et valider la plupart de nos exigences de conception initiales, de nombreuses améliorations restent encore à apporter…
À propos de l’auteur
Articles de blog associés

F5 NGINXaaS pour Google Cloud : des applications résilientes et évolutives
Découvrez comment NGINXaaS s’intègre à Google Cloud pour renforcer les performances et la sécurité, et préparer vos applications critiques à un avenir propulsé par l’IA.

L’intégration de F5 Web Application Firewall (WAF) à AWS est disponible dès aujourd’hui
En faisant appel à un partenaire de déploiement AWS WAF tel que F5, vous pouvez renforcer la sécurité de vos applications web grâce à des règles personnalisées qui bloquent les schémas d’attaque courants, comme les injections SQL ou les attaques par scripts intersites (XSS).
Appliquer le principe de Peter Parker à l’inspection TLS
« Un grand pouvoir implique de grandes responsabilités. » Si l’on en trouve des échos chez Voltaire et Churchill, cette citation est surtout connue grâce aux bandes dessinées Spider-Man, où elle est attribuée à l’oncle Ben. Bien entendu, si cette phrase est si répandue dans la culture populaire, c’est notamment parce qu’elle peut s’appliquer à une multitude de situations et de sujets, y compris à l’inspection TLS.
Le NetOps a besoin de défenseurs, pas d’adversaires
Il est important de reconnaître que les équipes NetOps ne sont pas toujours celles qui font obstacle au déploiement de la dernière nouveauté, application ou service. Les freins à la rapidité sont souvent dus au fait que les organisations n’adoptent pas tous les principes du DevOps lorsqu’elles cherchent à transformer leurs opérations informatiques.
Mise à jour des services applicatifs : sécurité, rapidité et visiteurs suspects
Il est de nouveau temps de nous pencher sur les services applicatifs que les entreprises utilisent réellement pour rendre leurs applications plus rapides et plus sûres. On constate notamment une hausse du recours aux services de protection contre les bots, ainsi que la progression lente mais régulière de HTTP/2. Bien qu’il ne s’agisse pas d’une application…
Les templates prennent le contrôle du cloud
Les modèles s’imposent dans le cloud. Lisez le blog de F5 pour découvrir comment l’infrastructure en tant que code et les API déclaratives automatisent la mise à disposition des applications.