
L’IA générative offre de nombreuses possibilités dans le cadre des opérations et du développement, mais elle soulève également de nombreux défis pour ceux qui cherchent à l’intégrer à une solution de sécurité.
L’un de ces défis consiste à déterminer comment tirer des enseignements de contenus sensibles à l’aide de LLM (grands modèles de langage), alors que ces contenus ne peuvent être partagés avec aucun service d’IA tiers, comme les politiques de sécurité utilisées pour protéger les applications et les API contre la fraude et les abus.
Un deuxième défi posé par les LLM est leur tendance à halluciner, en particulier lorsqu’on leur demande d’analyser ou de générer du contenu sur un sujet qu’ils connaissent peu. C’est souvent le cas des langages spécifiques à un domaine tels que DEX. Il s’agit d’un langage purement fonctionnel, à typage statique et non complet au sens de Turing qui, bien que clairement défini, est peu utilisé.
Le premier défi, celui de la confidentialité des données, semble à première vue insurmontable. Les entreprises de sécurité doivent prendre très au sérieux la confidentialité et la sécurité de toutes les données de leurs clients, y compris les politiques. Ainsi, bien que l’utilisation d’un LLM pour aider à tirer des enseignements des politiques soit bénéfique tant pour les pratiques opérationnelles que pour les clients, il faut une solution capable d’extraire des informations pertinentes de ces données sensibles sans les communiquer à un LLM tiers, qui ne pourrait donc pas les traiter. Le second défi, celui des hallucinations, est un problème que l’ensemble du secteur s’efforce actuellement de résoudre, en particulier lorsqu’il concerne les réponses relatives aux politiques, aux configurations et au code.
Alors que les humains voient un programme comme une séquence de caractères, le compilateur le perçoit différemment. Pour le compilateur, un programme DEX est un type de structure de données appelé AST (arbre syntaxique abstrait). Cet arbre est un graphe orienté acyclique, ce qui signifie que les politiques concernées se prêtent bien à une représentation sous forme de graphe. La solution que nous avons trouvée s’appuie donc sur une base de données orientée graphe (Neo4j) et utilise un agent GPT pour générer des requêtes GraphQL à son encontre. Cette approche répond parfaitement au premier défi, car nous pouvons utiliser GraphQL pour interroger une base de données orientée graphe contenant les données, tout en préservant leur confidentialité vis-à-vis du LLM tiers.
Le deuxième défi — les hallucinations — est plus difficile à surmonter, mais notre approche permet également d’y répondre en recourant à plusieurs techniques d’IA pour atténuer le risque. En outre, GraphQL est un langage de requête largement utilisé et bien documenté, que la plupart des modèles GPT connaissent et dont la syntaxe peut facilement être vérifiée à l’aide de nombreux outils. Cela réduit le risque d’hallucination et permet de garantir l’exactitude des requêtes avant leur utilisation.
Que sont les hallucinations de l’IA ?
Les hallucinations de l’IA désignent les cas où une IA générative produit un résultat qui ne repose pas sur des données ou des schémas réels, mais qui est inventé ou déformé. Ces hallucinations sont souvent dues aux limites ou aux biais des données d’entraînement de l’IA, ou surviennent lorsque celle-ci tente de générer un résultat pour des situations auxquelles elle n’a encore jamais été confrontée. Elles peuvent prendre la forme de contenus ou de conclusions inventés ou absurdes, qui peuvent manquer de logique ou ne pas correspondre aux données d’entrée. Par exemple, une IA génératrice de texte peut produire des phrases qui semblent plausibles, mais qui sont en réalité absurdes ou sans rapport avec le contexte fourni.
Qu’est-ce que GraphQL ?
GraphQL est un langage de requête open source destiné aux API (interfaces de programmation d’applications), ainsi qu’un environnement d’exécution côté serveur permettant d’exécuter ces requêtes à l’aide d’un système de types défini pour les données. Développé par Meta (Facebook), il vise à offrir une alternative plus efficace, puissante et flexible aux API RESTful traditionnelles. Les API GraphQL sont définies par un schéma qui précise les types de données pouvant être interrogées ou modifiées. Ce typage fort permet de disposer de meilleurs outils, ainsi que de fonctionnalités d’introspection et de validation.
Notre approche
Notre approche visant à intégrer en toute sécurité l’IA générative dans le domaine de la sécurité prend la forme d’un agent GPT. Si l’utilisation d’un langage bien documenté contribue à réduire le risque d’hallucination, nous devions trouver un moyen de restreindre l’espace de sortie de notre agent à un format permettant de détecter les erreurs par programmation, sans envoyer de données sensibles à OpenAI. GraphQL convient parfaitement comme espace de sortie, car il est suffisamment expressif pour répondre à la plupart des questions, tout en constituant une abstraction pouvant être vérifiée par programmation par rapport à un schéma connu.
Bien que nous ayons appliqué cette approche à DEX, elle convient à tout jeu de données suffisamment interconnecté et relationnel, comme les réseaux sociaux, les topologies de réseaux et d’infrastructures, les chaînes d’approvisionnement et les données géospatiales (cartographiques).
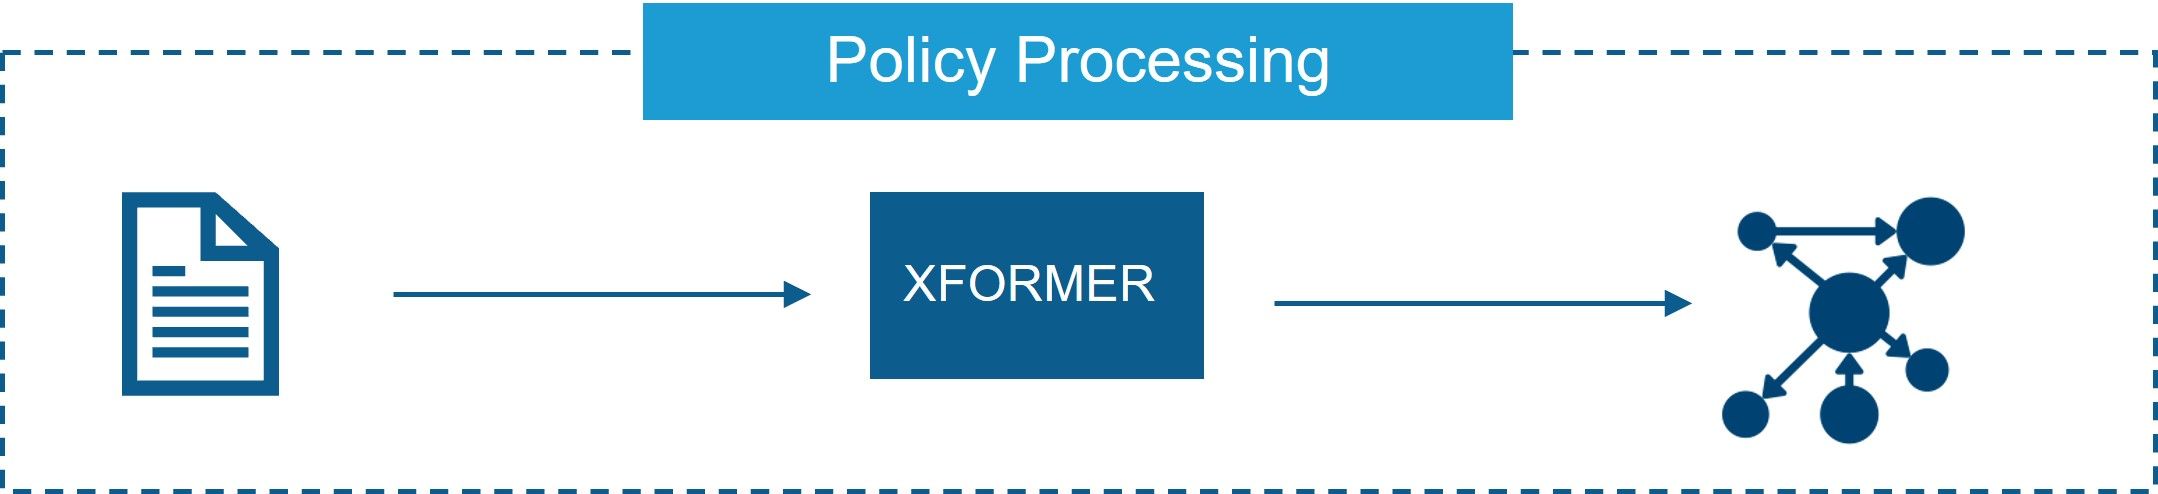
L’architecture PC-graph se compose de composants permettant de transformer DEX en une représentation sous forme de graphe. Les données de graphe ainsi obtenues sont ensuite stockées dans une base de données Neo4j. La sortie d’un agent GPT peut être envoyée via une API à un serveur GraphQL Apollo, qui exécute la requête sur la base de données de graphe.
Notre agent utilise GPT4 pour répondre aux demandes formulées en langage naturel concernant les politiques écrites en DEX. Pour ce faire, il comprend l’API pc-graph et génère une requête ou une mutation appropriée, que l’utilisateur peut ensuite examiner et exécuter.
Outre l’API pc-graph, notre agent comprend également les bibliothèques utilisées ainsi que certains concepts du langage DEX. Ces informations sont soigneusement sélectionnées afin d’être intégrées au contexte lors de l’exécution et de fournir des résultats optimaux.
L’une des difficultés est que l’agent a besoin d’une fenêtre contextuelle étendue pour contenir les parties pertinentes du schéma, ainsi que les ressources complémentaires, telles que la documentation neo4j-graphQL, qui comprend des types, des requêtes et des mutations supplémentaires générés par la bibliothèque. Avec GPT4-8k, nous manquons tout simplement de place pour assurer un apprentissage en contexte adéquat. Une fenêtre contextuelle de 32k donne des résultats acceptables, mais entraîne également un coût supplémentaire. Par exemple, nous devons envoyer le SDL GraphQL (Schema Definition Language) à OpenAI à chaque requête. Cela ne poserait pas de problème si nous pouvions affiner les modèles conversationnels GPT4 avec notre schéma, ce qui éviterait d’avoir à l’inclure dans le contexte. Toutefois, OpenAI ne prend actuellement pas cette possibilité en charge.
Nous avons identifié trois approches d’IA qui améliorent les résultats obtenus avec GPT4 :
- Chaîne de pensée
- La chaîne de pensée (CoT) est un concept d’IA qui simule des processus de pensée semblables à ceux des humains, permettant aux systèmes de suivre une séquence logique d’idées ou de concepts, à la manière dont les humains relient leurs pensées les unes aux autres. Cela facilite la compréhension du langage naturel, le raisonnement et la compréhension du contexte. Cette technique produit les meilleurs résultats lorsqu’elle est appliquée au modèle de pointe GPT-4.
- IA réflexive
- L’IA réflexive, également appelée IA consciente d’elle-même ou IA dotée de capacités de réflexion, désigne les systèmes d’intelligence artificielle capables de mener une introspection et de prendre des décisions concernant leurs propres actions et processus. Ce niveau d’IA va au-delà de l’apprentissage automatique traditionnel et des capacités élémentaires de prise de décision, car il implique un degré plus élevé de conscience de soi et d’auto-évaluation. Reflexion, un cadre destiné aux agents linguistiques reposant sur l’apprentissage par renforcement verbal, « mène une réflexion verbale sur les signaux de retour liés aux tâches, puis conserve son propre texte réflexif dans une mémoire tampon épisodique afin d’améliorer la prise de décision lors des essais ultérieurs ».
- Dialoguer avec elle-même
- Les agents de résolution par le dialogue (DERA) ont été présentés comme une méthode permettant d’améliorer de manière itérative les résultats des grands modèles de langage (LLM) grâce à la communication de retours. Cette technique fait appel à deux agents : un chercheur chargé du traitement des informations et un décideur responsable des jugements finaux. Leur interaction prend la forme d’un dialogue et confère au décideur l’autonomie nécessaire pour porter un jugement sur le résultat final.
Enfin, nous utilisons des outils qui effectuent une vérification statique des erreurs de syntaxe dans les requêtes GraphQL afin de détecter d’éventuelles hallucinations qui auraient échappé aux mesures d’atténuation initiales.
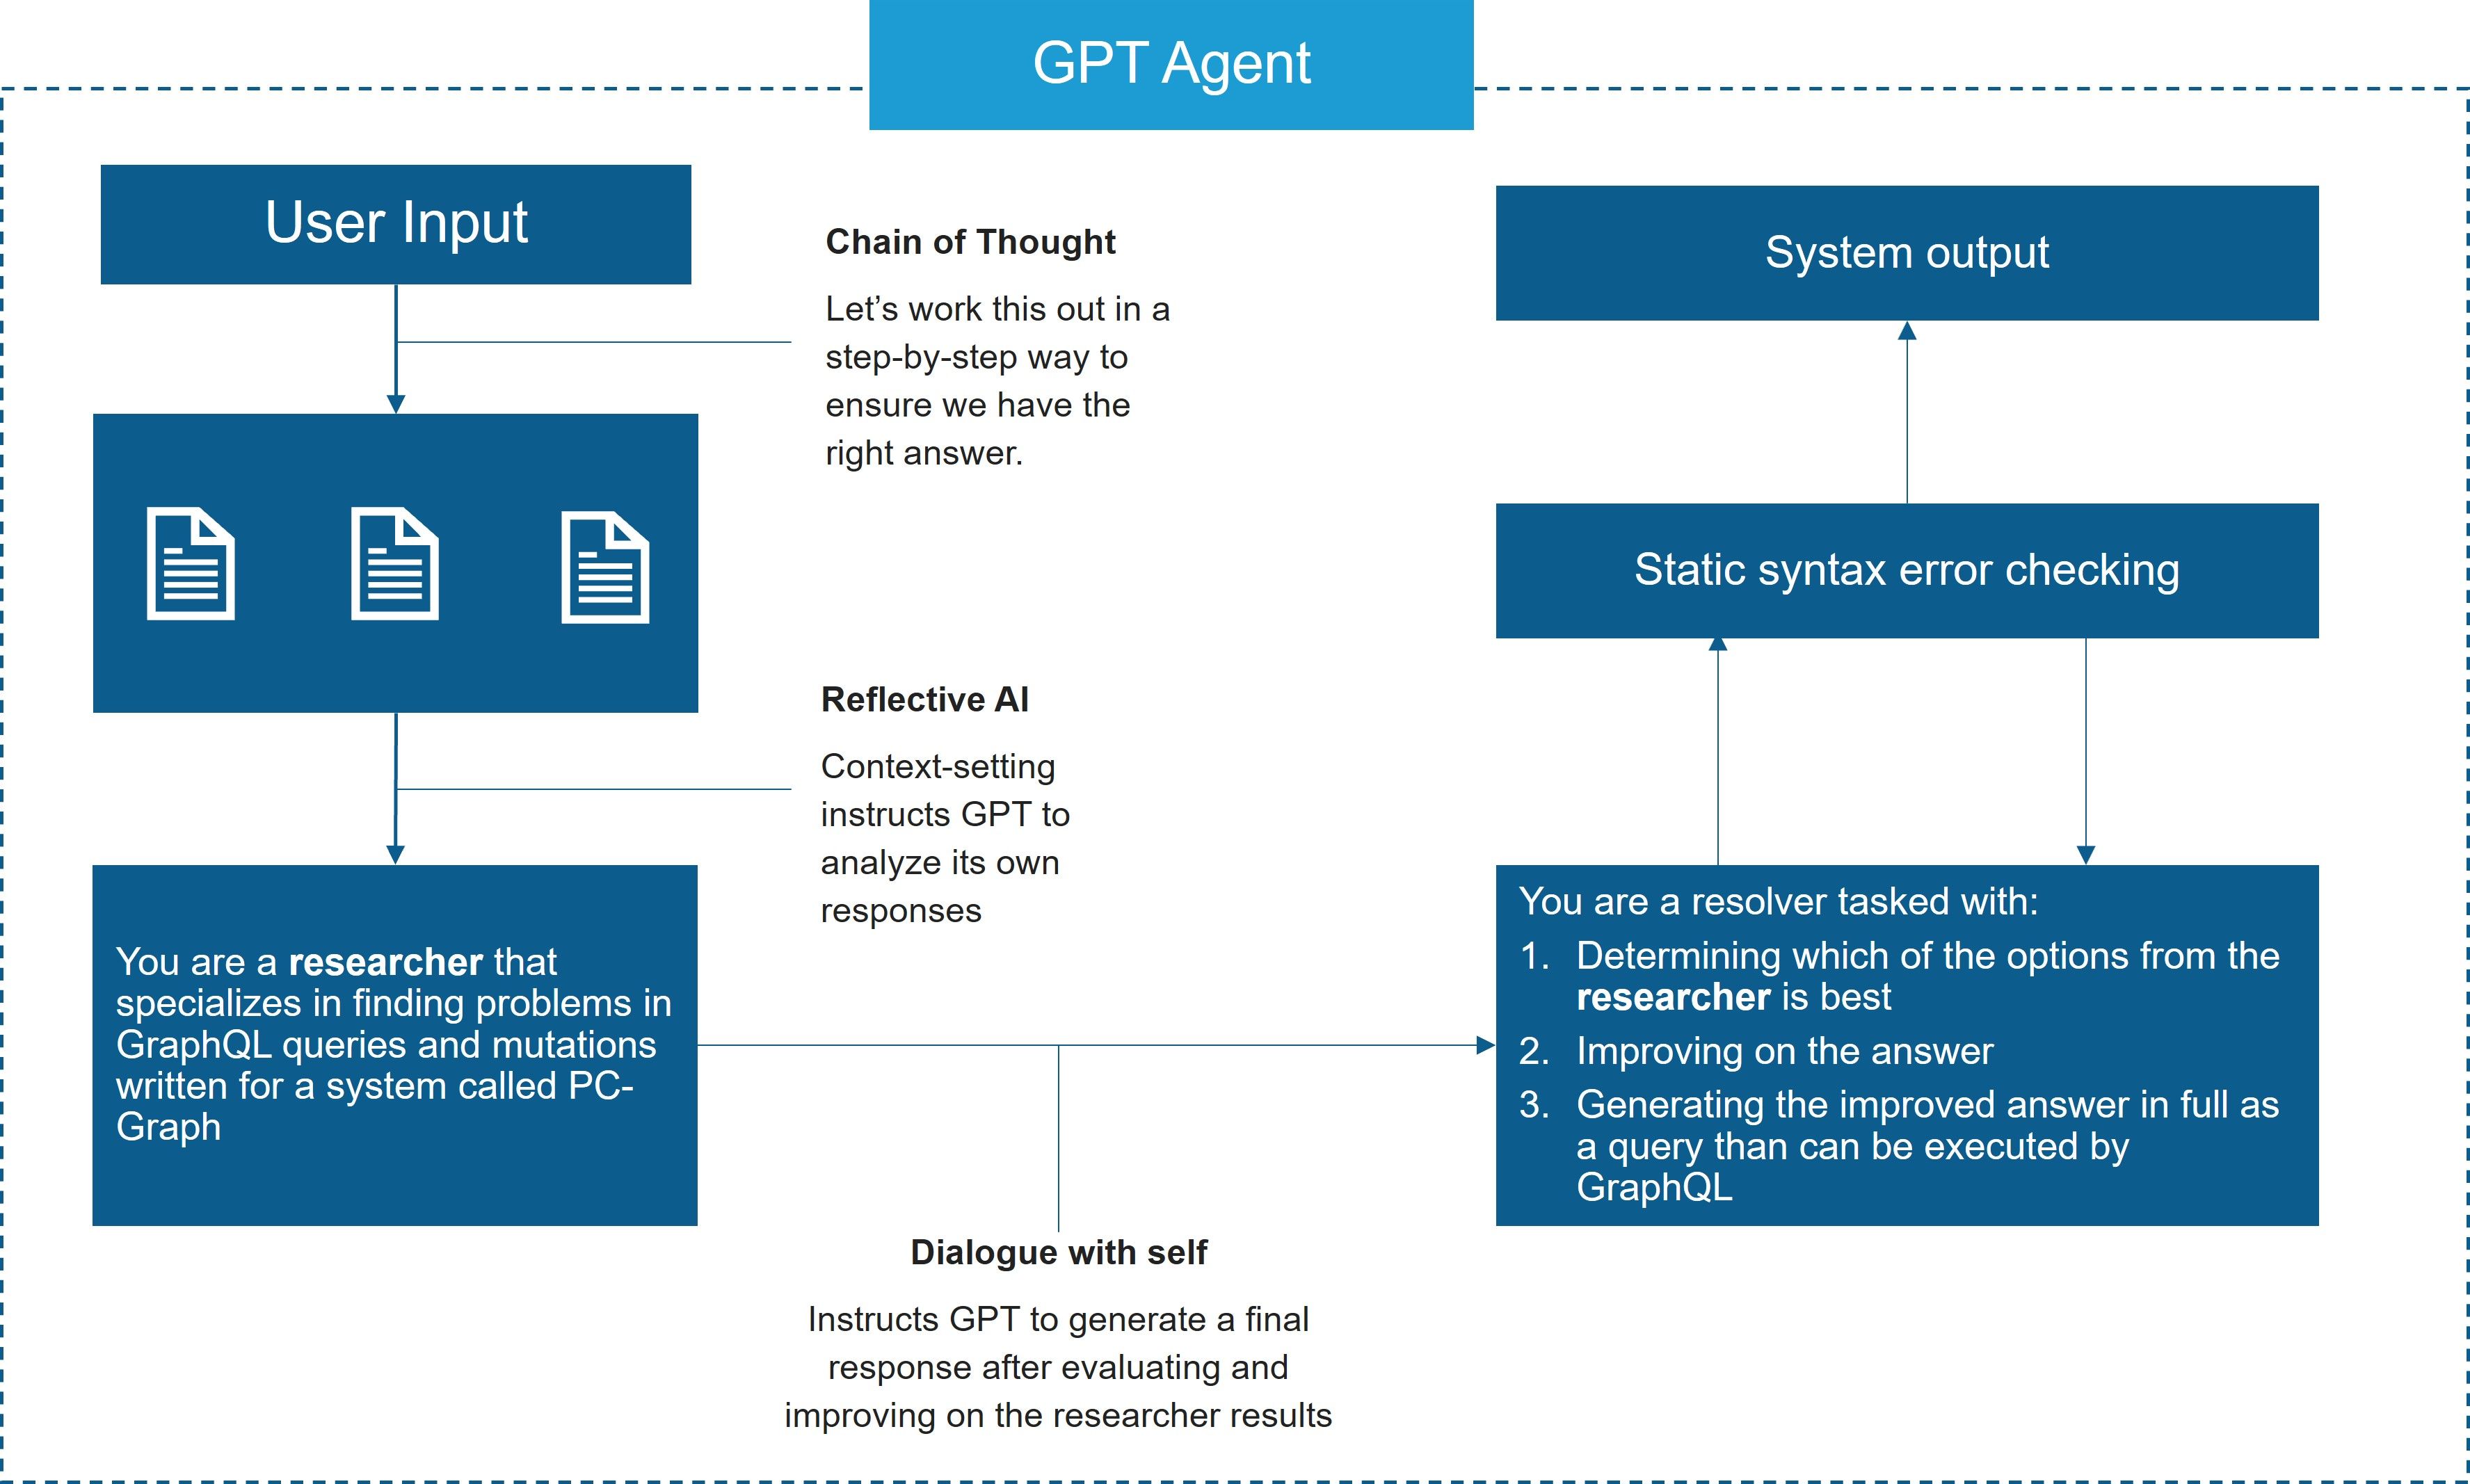
Cette conception est encore améliorée en générant dès le départ trois réponses potentielles dans une même requête. Cela permet non seulement de réduire le temps et le coût associés à une requête donnée, mais aussi d’améliorer la cohérence, car les éléments corrects d’une réponse ont davantage de chances d’apparaître. Cette approche laisse également une place à la variation aléatoire afin d’explorer des possibilités peu probables, mais néanmoins exactes.
Grâce à notre approche, nous avons pu tirer des enseignements des politiques sans partager de données privées. La qualité et la cohérence des résultats de nos requêtes se sont également considérablement améliorées, avec une réduction notable des hallucinations, en particulier pour les tâches nécessitant la création de requêtes volumineuses ou complexes comprenant plusieurs filtres et/ou fonctions d’agrégation.
D’une certaine manière, nous avons le beurre et l’argent du beurre : lorsqu’il faut choisir entre un agent créatif et un agent déterministe, nous optons tout simplement pour les deux.
À propos de l’auteur
Articles de blog associés

Pourquoi devriez-vous vous intéresser à WebAssembly ?
WebAssembly (Wasm) est un jeu d’instructions binaires portable, rapide et sécurisé, qui permet d’exécuter des applications hautes performances sur n’importe quelle plateforme.

Trois choses à savoir sur les applications d’IA
Les applications d’IA sont des applications modernes, mais elles présentent certaines particularités. Découvrez les points essentiels à connaître sur les applications basées sur l’IA.
État des lieux de la stratégie applicative 2022 : il est temps de moderniser les opérations
Il est devenu évident que, pour maintenir la dynamique de leur transformation numérique, les organisations doivent recentrer leurs efforts sur les fonctions métier. Si les expériences destinées aux clients restent prioritaires, il est également indispensable de permettre la numérisation de fonctions telles que les services juridiques, les ressources humaines et la finance. Les DSI prennent donc les commandes, tandis que la transformation numérique passe de la modernisation des applications à celle des opérations.
Clouds multiples ou multicloud : faciliter la transition
La gestion et la sécurisation des charges de travail deviennent complexes à mesure que les entreprises adoptent une stratégie de cloud connecté. Découvrez comment F5 répond au besoin d’une nouvelle approche de la mise en réseau multicloud.
L’expérience client dépend de la visibilité
Une enquête menée par Dimensional Research auprès de plus de 3 000 utilisateurs d’applications mobiles a confirmé ce que beaucoup d’entre nous pensent des attentes actuelles des clients.
Transformation numérique et explosion du portefeuille d’applications
La transformation numérique stimule la croissance des portefeuilles d’applications et modifie la manière dont celles-ci sont développées, déployées, intégrées et, en définitive, utilisées.