Cet article est adapté d’une présentation de Kevin Reedy de Belly Card, donnée lors de nginx.conf en octobre 2014. Bien que celle-ci remonte à quelques années, son contenu reste encore très pertinent aujourd’hui. Vous pouvez visionner un enregistrement de la présentation sur YouTube.
Table des matières
0:00 Introduction Vue d’ensemble Avertissement1:16 Qu’est-ce que Belly ? La pile technologique de Belly1:44 Version 0 : l’âge des ténèbres2:04 Version 1 : un nouvel espoir2:35 Version 2 : séparation de la page d’accueil et de l’API Mot à la mode du jour : architecture orientée services ! Activation de la SOA NGINX remplace ELB Configuration des serveurs en amont et virtuels Résultats4:43 Configuration avec Chef Recettes Fichiers Modèles Livres de recettes6:49 Exemple : Chef pour NGINX Installation, configuration et optimisation Routage du trafic de l’API9:46 Exemple concret avec Chef10:08 Version 2 : déploiement des applications10:40 Version 3 : la SOA partout Puis Heartbleed est arrivé SSL partout12:25 Version 4 : Docker Avantages Déploiement des conteneurs15:45 Stratégies de déploiement17:43 Options de découverte de services18:33 Architecture de Consul19:30 Fonctionnalités de Consul22:07 Consul Template Commande de démarrage de Consul Template Configuration de NGINX avec Consul Template Gestion de la configuration avec Consul Template24:35 Utilisation de Chef pour déployer Consul25:44 Conseils de pro Recherche partielle avec Chef DNS Éviter les configurations obsolètes30:35 Questions36:31 Coordonnées
0:00 Introduction
Bonjour à toutes et à tous. Je m’appelle Kevin Reedy et je travaille pour une entreprise de Chicago appelée Belly Card. Nous comptons environ cent salariés, dont vingt ingénieurs. Aujourd’hui, je vais vous expliquer comment nous gérons la répartition de charge, en particulier dans une infrastructure dynamique en constante évolution.
0:21 Vue d’ensemble
Je vais donc commencer par vous présenter l’évolution de notre pile d’infrastructure, en partant de la version 0, que j’appelle l’âge des ténèbres. Nous verrons ensuite comment nous utilisons Chef pour configurer NGINX. Puis nous expliquerons comment nous avons abandonné cette approche au profit de données provenant d’une plateforme de découverte de services appelée Consul pour configurer NGINX. Si le temps le permet, je vous donnerai quelques conseils de pro sur la configuration de NGINX, notamment en matière de gestion de la configuration.
0:49 Avertissement
Même si je vais vous parler de Chef et de Consul, je tiens à préciser que rien dans cette présentation ne leur est spécifique. Chef, Puppet, Ansible, Salt, CFEngine et tous les autres sont d’excellents produits, et vous devriez utiliser l’un d’entre eux. Nous apprécions Chef, et je suis sûr que beaucoup d’autres personnes l’apprécient également.
Il en va de même pour la découverte de services. Consul, etcd et ZooKeeper sont tous d’excellents outils, alors utilisez celui qui vous convient le mieux.
1:16 Qu’est-ce que Belly ?
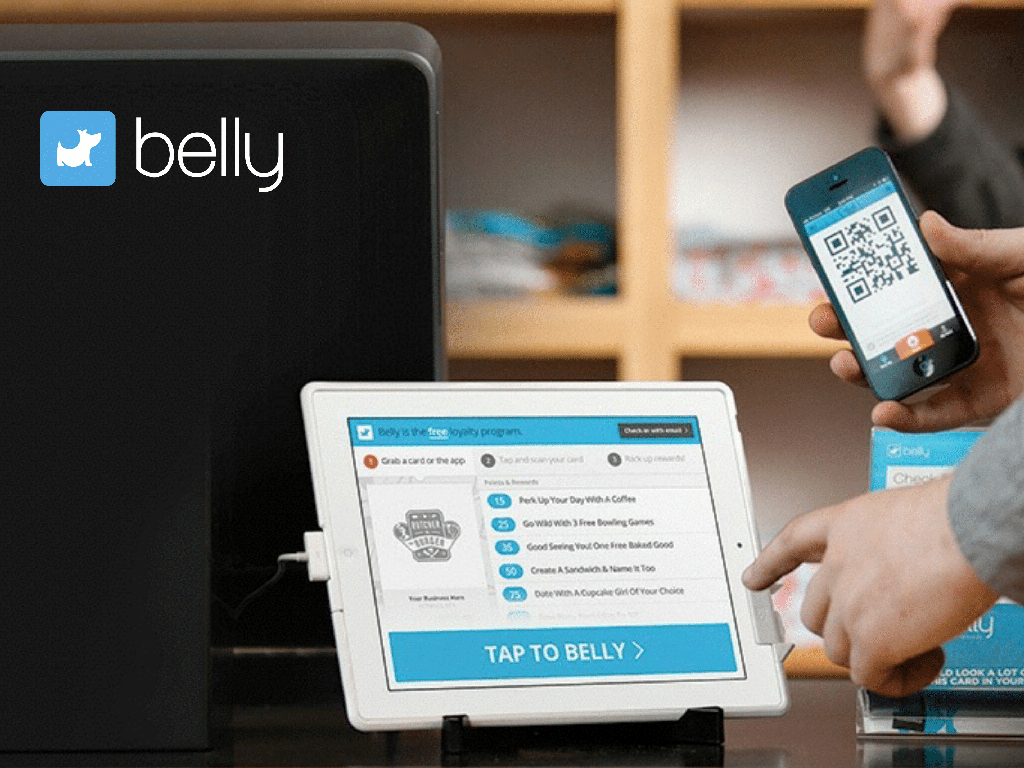
Qu’est-ce que Belly ? Il s’agit essentiellement de la version numérique d’une carte de fidélité de café, où dix boissons achetées donnent droit à une boisson gratuite. Nous installons un iPad dans le commerce, les clients scannent un QR code avec leur téléphone ou une carte physique, nous comptabilisons leurs points, leur attribuons les récompenses et développons en plus des outils marketing.
1:36 La stack de Belly
Mais je ne suis pas ici pour vous parler de l’entreprise belly. Si cela vous intéresse, vous pouvez simplement consulter notre site web. Je vais vous parler de notre infrastructure technique.
1:44 Version 0 : L’Âge sombre
Commençons donc par la version 0. À l’époque où il n’y avait que trois développeurs, avant que je n’y travaille, Belly était une application Ruby on Rails monolithique, ce qui signifiait que chaque appel d’API et chaque partie de notre site web passaient par une seule application Rails. Elle s’appuyait sur MySQL, MongoDB et Memcached, et nous la déployions sur Heroku, qui est une excellente plateforme pour démarrer.
2:04 Version 1 : Un nouvel espoir
Voici donc la version 1 – Un nouvel espoir. Nous avons décidé que Heroku ne répondrait plus à nos besoins, alors nous avons commencé à déployer avec un outil appelé Capistrano, qui est essentiellement « mieux qu’un script shell » écrit en Ruby. Il facilite les déploiements.
Nous avions environ six serveurs sur Amazon Web Services EC2. Ce nombre était fixe, mais nous l’augmentions lorsque nous savions qu’un événement important allait avoir lieu, puis le réduisions si nécessaire. En amont, nous avions AWS Elastic Load Balancer.
2:35 Version 2 : page d’accueil et API séparées
Puis un projet a vu le jour, dans le cadre duquel nous souhaitions séparer notre page d’accueil du reste de l’API. Nous voulions ainsi pouvoir faire évoluer notre page d’accueil plus rapidement et permettre à différents développeurs de travailler dessus.
2:47 Mot à la mode du jour : architecture orientée services !
Le grand mot à la mode à l’époque – et encore aujourd’hui – est l’architecture orientée services.
2:50 Mettre en œuvre une SOA
La version 2 de notre stack devait donc permettre la mise en place d’une architecture orientée services. Notre premier plan consistait à séparer la page d’accueil de l’API. Cela semble très simple : il suffit d’avoir www.bellycard.com et api.bellycard.com.
Mais cela s’est avéré vraiment complexe et pas simple du tout, car certaines de nos applications mobiles avaient été codées en dur pour utiliser www.bellycard.com/api et /api‑assets. Nos fournisseurs de services de messagerie et tous les liens de clic qui avaient déjà été envoyés par e-mail utilisaient /eo pour « ouverture d’e-mail » et /ec pour « clic dans un e-mail ». Notre application Facebook était configurée pour utiliser /facebook/callback.
3:28 NGINX remplace ELB
Cela signifiait qu’AWS Elastic Load Balancer ne nous offrait plus la flexibilité nécessaire pour acheminer ce trafic vers différentes applications. NGINX est donc venu à la rescousse. Plus précisément, nous pouvions définir plusieurs serveurs en amont et des règles de réécriture afin d’acheminer le trafic vers nos différentes applications.
3:44 Configuration des serveurs en amont et des serveurs virtuels
Dans cet exemple très simple, nous définissons un bloc upstream comprenant six serveurs pour l’API et un bloc comprenant deux serveurs pour la page d’accueil.
Il y a également deux blocs « server » [définissant des serveurs virtuels]. Sur l’un, nous écoutons les requêtes destinées à api.bellycard.com et redirigeons tout ce trafic vers les serveurs d’API. Sur l’autre, nous écoutons les requêtes destinées à www.bellycard.com et les acheminons en conséquence.
Résultats à 4 min 02 s
Cela a très bien fonctionné. Nos développeurs ont ainsi pu avancer rapidement. Notre équipe frontend travaillait sur un projet sans être bloquée par notre API. Nous avons donc déployé un troisième service, destiné, si je me souviens bien, à l’intégration avec Passbook d’Apple. Puis un quatrième, vers lequel nous avons transféré toutes nos fonctionnalités Facebook. Le cinquième devait gérer les événements liés aux utilisateurs sur notre site web.
Puis quelqu’un a décidé que ce serait une excellente idée de développer cela en Node.js. Nous nous sommes donc retrouvés avec cinq services distincts écrits dans deux langages. Ils étaient tous déployés indépendamment, sans véritable gestion de la configuration, et nous modifiions NGINX manuellement, comme beaucoup de gens à leurs débuts, j’en suis sûr.
4:43 Configuration avec Chef
Nous avions besoin d’un meilleur moyen de faire évoluer ce processus, et c’est ce que nous avons fait avec Chef.
Chef est une suite de gestion de configuration. Elle est écrite en Ruby et vous permet d’écrire votre propre gestion de configuration en Ruby, ce qui en fait un excellent outil pour les développeurs. learnchef.com est une ressource formidable pour apprendre à utiliser Chef ; vous pourrez y apprendre bien plus de choses sur Chef que je ne pourrais vous en enseigner en 45 minutes.
Je vais toutefois passer en revue quelques notions de base, afin que nous soyons tous sur la même longueur d’onde.
Recettes 5:17
Le premier type de composant de base dans Chef est une « recette ». Chef utilise de nombreux noms astucieux, comme « couteau » pour désigner un outil et « recette », et tout se trouve dans un « livre de recettes ». Cela rend l’ensemble plutôt ludique et facile à comprendre, tout en offrant une excellente métaphore, mais complique aussi énormément toute recherche sur Google.
Voici donc la recette la plus simple que j’ai pu imaginer. Installez le paquet nginx puis démarrez et activez le service nginx.
5:56 Fichiers
Vous pouvez également avoir des ressources de type fichier. Par exemple, je souhaite écrire le contenu « Hello World! » dans le fichier /usr/share/NGINX/html/index.html.
6:08 Modèles
Vous pouvez également intégrer cela à un système de modèles. Ici, j’ai deux variables g et w correspondant à Hello et Kevin, et je peux transmettre ces variables à un fichier de modèle au format ERB (un script de création de modèles Ruby).
Ainsi, au lieu de rédiger tout le contenu manuellement, nous pouvons créer un modèle indiquant le texte à lire et la personne à saluer.
6:19 Livres de recettes
Le dernier composant majeur est un cookbook, c’est-à-dire un ensemble de recettes, de fichiers et de modèles. Il comprend également des ressources, des fournisseurs et des bibliothèques, qui sont des éléments plus complexes. Vous trouverez de très nombreux cookbooks open source et autres sur https://supermarket.getchef.com, notamment pour NGINX, MySQL, Java, apt et yum, et même pour gérer vos fichiers ssh_known_hosts. La plupart des composants essentiels dont vous avez besoin pour la gestion de configuration existent probablement déjà dans un cookbook.
6:49 Exemple : Chef pour NGINX
Nous allons voir un exemple très rapide d’utilisation de NGINX avec Chef, dans lequel nous installerons NGINX et le configurerons en modifiant quelques variables. Nous utiliserons Chef pour déterminer où s’exécute notre application, puis nous configurerons NGINX afin d’acheminer le trafic vers celle-ci.
7:14 Installation, configuration et optimisation
Dans cet exemple, la première chose que nous faisons est donc de définir certains attributs de nœud. Pour chaque nœud, vous pouvez définir les valeurs des attributs en ajoutant un document JSON. Nous allons utiliser un cookbook NGINX tiers qui recherche les paramètres de ces attributs. Nous définissons worker_connections sur une certaine valeur, la directive worker_rlimit_nofile, le type d’event que nous allons utiliser dans NGINX, et même client_max_body_size.
Ensuite, nous incluons deux recettes du cookbook NGINX. La première est nginx::repo, qui configure un dépôt apt ou yum selon votre système d’exploitation. Puis [la recette nginx] installe NGINX. Vous pouvez également installer NGINX à partir des sources, mais l’utilisation de paquets est plus rapide.
Nous exploitons ensuite les fonctionnalités de recherche de Chef. Lorsque vous exécutez Chef, vous pouvez soit l’exécuter en tant qu’agent sur la machine, soit l’exécuter en mode solo, auquel cas il fonctionne essentiellement comme un script. Lorsqu’un agent est installé sur une machine, vous pouvez interroger le serveur Chef pour rechercher des nœuds et d’autres attributs.
Ici, nous demandons à Chef de nous fournir la liste de tous les nœuds auxquels la recette « belly‑api » est associée. Ensuite, nous générons à partir d’un modèle un fichier de site appelé /sites‑enabled/api. Sa source est le [fichier de] modèle appelé « api.erb » que je vais vous montrer juste après. Les variables que nous lui transmettons correspondent aux nœuds que nous venons de rechercher.
La dernière nouveauté ici est une instruction notifies qui permet de recharger le service nginx. Cela signifie que chaque fois que ce modèle est modifié, je veux que vous rechargiez ce service.
8:54 Routage du trafic de l’API
Notre fichier de modèle est donc assez simple. Nous avons un groupe de serveurs en amont appelé « api » et, dans ERB, nous parcourons tous les serveurs transmis sous forme de variable, en indiquant pour chacun son adresse IP et le port 8080. Nous ajoutons même un commentaire avec le nom du serveur. Ainsi, lorsqu’un opérateur cherchera à comprendre ce qui se passe avec ce service, ce commentaire lui sera utile.
Nous définissons également un bloc server pour écouter sur api.bellycard.com. Je redirige simplement tout le trafic vers le serveur en amont api.
9:46 Exemple concret avec Chef
Je souhaite également vous donner un exemple concret. Le texte est peut-être trop petit pour que vous puissiez le lire, mais cela vous donnera une idée de la complexité que peuvent atteindre vos recettes Chef. Voici le modèle et la recette réellement utilisés aujourd’hui sur certains de nos serveurs de production.
10:08 Version 2 : Déploiement d’applications
Revenons maintenant à notre stack. Je vous ai dit que nous avions déployé environ cinq applications et que tout se passait très bien. Nous disposions désormais d’un moyen d’acheminer le trafic vers celles-ci. Nos développeurs se sont donc emparés de cette solution et, aujourd’hui, nous comptons environ 40 applications Ruby déployées sur nos serveurs à l’aide de Chef. Le trafic est acheminé de manière entièrement dynamique à l’aide de NGINX.
Nos développeurs n’ont rien d’autre à faire que de modifier une recette pour y ajouter le nom de leur nouveau service. L’ensemble du trafic est acheminé par NGINX et configuré dynamiquement avec Chef.
10:40 Version 3 : tout passer en SOA
Nous avions également une dizaine d’applications JavaScript frontend, constituées uniquement de fichiers statiques que nous déployions sur S3, avec un CDN, [Amazon] CloudFront, en amont. Nous servions index.html depuis le compartiment S3, tandis que le reste des ressources passait par CloudFront. Nous avions aussi environ cinq autres applications que les développeurs avaient simplement déployées sur Heroku parce qu’il s’agissait au départ de projets ponctuels, qui ont fini par passer en production sans que personne en soit vraiment informé.
11:10 Puis Heartbleed est arrivé
[Les cinq applications sur Heroku] étaient distinctes — complètement indépendantes de notre infrastructure — jusqu’à ce beau jour d’avril où la faille Heartbleed a été annoncée. Beaucoup de gens se sont alors précipités pour réagir. Heartbleed était une faille d’OpenSSL qui pouvait permettre à des personnes d’extraire vos clés privées.
Comme nous utilisons Chef, nous avons pu mettre à niveau OpenSSL sur l’ensemble de nos machines dès qu’un correctif a été disponible. Je crois qu’il a été déployé en une vingtaine de minutes sur toute notre infrastructure. En revanche, AWS (et donc Heroku) a mis environ 24 heures à corriger ses équilibreurs de charge Elastic Load Balancing.
Cela nous a conduits à transférer l’ensemble de notre répartition de charge et de notre terminaison SSL vers NGINX, quel que soit l’endroit où il était déployé – aussi bien sur S3 que sur Heroku. Cela entraîne une légère baisse de performances, mais au moins, ce jour-là en avril, le jeu en valait la chandelle pour nous.
11:57 Du SSL partout
Ainsi, la version 3 de notre stack est passée de « tout en SOA » à « tout en SSL ». L’ensemble de notre trafic vers bellycard.com et ses sous-domaines transite par nos répartiteurs de charge. Pour des raisons de performances, nos ressources sont toujours servies depuis CloudFront sur un autre domaine. Nous ne voulons pas subir la surcharge liée au SSL, d’autant plus que nous ne disposons que d’un seul centre de données sur la côte Est.
12:25 Version 4 : Docker
Version 4 – le mot à la mode dont tout le monde parle cette année est Docker. Dès la version 0.5 de Docker, si je me souviens bien, nos développeurs étaient impatients de commencer à l’utiliser.
12:38 Avantages
Les raisons [d’utiliser Docker] sont simples.
Cela simplifie considérablement le déploiement des applications. Il n’y a aucun script à écrire. Vous n’avez pas à vous soucier de la compilation des ressources. Peu importe que vous développiez votre application en Ruby tandis que quelqu’un d’autre développe la sienne en Python.
En substance, cela permet de séparer les responsabilités du développement et de l’exploitation. Vos développeurs peuvent se concentrer sur le code, les bibliothèques à utiliser et même les paquets Linux à installer. Les équipes d’exploitation peuvent se préoccuper davantage de questions telles que : où vais-je déployer cette application ? Comment vais-je collecter ses journaux ? Comment vais-je la superviser ? Une fois ces problématiques d’exploitation résolues, toutes les applications fonctionneront, quel que soit le langage dans lequel elles sont écrites.
Autre avantage : cela permet à nos développeurs de lancer facilement les services dépendants sur leur propre ordinateur portable. Comme je l’ai indiqué, nous comptons désormais environ 55 applications différentes, dont beaucoup sont maintenant exécutées dans des conteneurs Docker.
Imaginons que vous travailliez sur un nouveau service d’envoi de campagnes par e-mail. Celui-ci dépend du service de messagerie. Sur votre machine de développement, vous téléchargeriez donc généralement le code, exécuteriez bundle install, lanceriez le service en arrière-plan, puis vous vous diriez : « Oh, mais en fait, celui-ci dépend d’un autre service, le service utilisateur. »
Ce service dépend d’un autre composant, qui dépend lui-même d’un autre. En réalité, le nouveau service de campagnes par e-mail dépend donc d’environ cinq autres services, ainsi que de MySQL, Elasticsearch, Redis, et la liste est encore longue.
Avec Docker, nous pouvons créer ces conteneurs à partir des mêmes recettes Chef que celles utilisées en production et fournir à nos développeurs des conteneurs qu’ils peuvent télécharger très rapidement.
Cela accélère donc le déploiement et le développement.
14:23 Déploiement de conteneurs
Ainsi, dans la version 4, nous sommes passés du déploiement de nos applications avec Chef à leur déploiement dans des conteneurs. Il existe une multitude de solutions pour y parvenir, et je suis certain qu’il y en aura encore davantage.
La première repose sur CoreOS et Fleet. CoreOS est un système d’exploitation Linux allégé sur lequel s’exécute un moteur de découverte de services appelé « etcd ». Fleet vous permet de définir des règles telles que : « Je veux qu’un conteneur s’exécute en cinq exemplaires, mais pas sur les mêmes machines que cet autre service. »
Il en existe un autre, appelé Deis, qui ressemble à Heroku en ce qu’il dispose d’une interface Git Push. Il y a aussi Mesos d’Apache et Kubernetes de Google ; Flynn est une autre solution apparue récemment. Nous avons en fait développé notre propre outil, car lorsque nous nous sommes lancés dans cette aventure, la plupart de ces outils n’étaient pas encore suffisamment aboutis pour que nous puissions les utiliser.
Notre solution s’appelle Jockey, et elle s’est révélée très efficace, car notre processus de déploiement repose sur des choix très affirmés. Ce qui est formidable avec Docker, c’est qu’il fournit essentiellement un ensemble d’API communes pour la conteneurisation. Nous n’avons ainsi pas à nous soucier de nombreux aspects dont nous devrions tenir compte si nous utilisions simplement les conteneurs LXC de Linux.
Nous prévoyons de le publier en open source, mais comme je l’ai indiqué, notre processus de déploiement repose sur des choix très tranchés, et ce qui fonctionne pour nous ne fonctionnera pas forcément pour vous.
15:45 Stratégies de déploiement
Notre stratégie de déploiement a également quelque peu changé lorsque nous sommes passés à Docker. Auparavant, nous effectuions des déploiements sans interruption de service en installant directement une nouvelle version de l’application à la place de l’ancienne. Ainsi, si ce service de fax destiné aux utilisateurs était exécuté sur quatre machines, nous utilisions Chef pour récupérer la nouvelle version, l’installer par-dessus [l’ancienne version], puis envoyer un signal au serveur web afin qu’il se recharge. Unicorn est un excellent moteur Ruby pour ce type d’opération.
Cependant, les conteneurs sont immuables. Une fois qu’un conteneur est en cours d’exécution, si vous souhaitez créer une nouvelle version, vous devez créer un nouveau conteneur. Vous pouvez éventuellement vous y connecter, exécuter des commandes supplémentaires, puis l’enregistrer, un peu comme vous le feriez avec Git. Mais pour tirer pleinement parti de Docker, votre conteneur doit véritablement être totalement immuable.
Cela signifie que nous avons dû trouver une nouvelle stratégie de déploiement, car nous ne pouvons plus effectuer de déploiement sur place. Il en existe plusieurs. Le déploiement bleu-vert est une option intéressante. Si votre application s’exécute sur quatre machines, vous la lancez sur quatre nouvelles machines, puis vous configurez votre répartiteur de charge pour qu’il redirige le trafic vers celles-ci. Une fois que vous êtes certain que tout fonctionne comme prévu, vous pouvez supprimer l’environnement bleu, et l’environnement vert devient alors le nouvel environnement bleu. Amazon propose d’excellents outils pour mettre en œuvre cette stratégie avec AWS.
Il existe également des déploiements « canary », qui consistent à déployer une instance de la nouvelle machine, à la surveiller, puis à poursuivre le déploiement si les contrôles des métriques et de l’état de santé sont concluants.
La différence avec les conteneurs, ici, c’est que vous allez réellement les supprimer et en créer de nouveaux. Il vous faut donc un système permettant de suivre l’emplacement de chaque application exécutée dans votre infrastructure.
Chef commence réellement à devenir un excellent moyen d’y parvenir. Un cookbook appelé Chef Metal est en cours d’intégration et vous permet de traiter les conteneurs comme n’importe quelle autre ressource de votre infrastructure Chef.
17:43 Options de découverte de services
Il y a aussi la découverte de services. ZooKeeper est un outil très populaire, utilisé dans tout l’écosystème Hadoop. [Airbnb] propose un excellent produit appelé SmartStack, qui permet d’effectuer des déploiements et de les suivre dans ZooKeeper.
J’ai mentionné etcd, qui est essentiellement un magasin clé-valeur distribué doté d’une interface REST. C’est un avantage considérable par rapport à ZooKeeper, qui s’apparente davantage à une bibliothèque cliente Java, car vous pouvez ainsi communiquer avec etcd depuis n’importe laquelle de vos applications. Bon nombre des solutions open source de type plateforme en tant que service que j’ai évoquées précédemment – comme Deis, Flynn et même Kubernetes de Google – utilisent etcd. Si vous utilisez CoreOS, etcd est déjà intégré et prêt à l’emploi.
Une autre solution, également basée sur REST, a vu le jour : Consul. Elle est proposée par l’équipe de HashiCorp, à l’origine de Vagrant, de Packer et de nombreux autres outils formidables. C’est finalement Consul que nous avons choisi d’utiliser.
18:33 Architecture de Consul
Voici un schéma présentant les principes fondamentaux de Consul. Vous pouvez voir qu’il existe plusieurs centres de données, chacun doté de trois serveurs. Le centre de données 1 comporte également des clients. Fait intéressant, parmi vos agents serveurs, vous élirez un agent principal, puis tous vos clients connaîtront non seulement l’ensemble des serveurs, mais aussi tous les autres clients. Ils utiliseront ensuite un protocole de gossip pour communiquer avec tous les autres agents.
Cela me rappelle une vieille publicité d’AT&T dans laquelle vous en parlez à deux amis, qui en parlent à deux amis, qui à leur tour en parlent à deux amis, et le message se propage ainsi dans tout votre réseau de nœuds. [Note de la rédaction – Presque : il s’agissait d’une publicité pour le shampooing Faberge Organics.] À titre de comparaison, avec etcd ou ZooKeeper, vous n’avez pour ainsi dire que des agents serveurs auxquels vos clients se connectent.
Avec l’approche de Consul, vous exécuteriez en fait un client Consul sur pratiquement chaque serveur, partout où nous déployons Docker et partout où nous faisons fonctionner nos répartiteurs de charge. Vous pouvez ainsi toujours communiquer avec cette API sur le port 8500 de localhost.
19:30 Fonctionnalités de Consul
Tout comme etcd, [Consul] est un magasin clé-valeur distribué. Vous pouvez définir et récupérer des clés, et le système garantit leur linéarisabilité afin qu’elles restent toujours cohérentes. Il existe quelques pièges, mais leur documentation expliquant où se situent ces problèmes est remarquable. Toutefois, contrairement à etcd, Consul considère la découverte de services comme une fonctionnalité de premier plan.
Au-delà des simples paires clé-valeur, vous pouvez également enregistrer des services, par exemple une API. Lorsque vous enregistrez un service, vous indiquez à Consul sur quel nœud il s’exécute. Ainsi, lorsque nous déployons un conteneur, nous demandons également à Consul d’enregistrer l’API de ce service sur cet hôte.
De plus, Consul dispose de contrôles d’intégrité distribués, ce qui vous permet de définir des contrôles d’intégrité de type Nagios directement dans votre plateforme de découverte de services. Lorsque vous interrogez Consul, vous pouvez demander la liste de tous les emplacements où le service d’API est en cours d’exécution. Vous pouvez transmettre un indicateur pour obtenir « tous », « uniquement ceux dont le contrôle a réussi » ou « uniquement ceux qui sont défaillants ».
Il prend également en charge plusieurs centres de données. Comme je l’ai indiqué, vous devez exécuter ce client Consul partout. Lorsque vous le démarrez, vous lui transmettez un paramètre précisant le centre de données. Si vous avez un centre de données Est et un centre de données Ouest, vous pouvez interroger votre client Consul local pour lui demander une adresse ou autre, sans avoir à savoir dans quel centre de données vous vous trouvez.
En fait, nous utilisons le centre de données pour délimiter nos environnements de préproduction et de production. La configuration d’une application en préproduction pourrait indiquer : « dis-moi où se trouve MySQL.services.consul ». Que ce service s’exécute réellement sur un nœud de préproduction ou de production, vous obtiendrez la bonne valeur sans jamais avoir à tenir compte du centre de données ou des différents environnements.
L’autre avantage majeur de cet outil (et d’etcd également) est que son interface HTTP prend en charge le long polling. Vous pouvez ainsi demander la liste de tous les serveurs qui exécutent ce service, tout en maintenant la connexion ouverte pendant 60 secondes afin d’être immédiatement informé du moindre changement. La durée d’attente peut même aller jusqu’à 10 minutes. Vous pouvez donc recevoir instantanément des notifications en cas de modification de votre infrastructure.
L’autre point que j’ai déjà mentionné, c’est que vous pouvez faire évoluer vos agents en déployant des clients partout. C’est très pratique, car vous pouvez ainsi toujours communiquer avec localhost.
Mais la grande question est la suivante : maintenant que ces données se trouvent sur une plateforme distribuée de découverte de services, comment puis-je les utiliser pour configurer NGINX ?
22:07 Consul Template
Heureusement, il existe un outil appelé « Consul Template ». Il est littéralement sorti hier, ce qui m’a obligé à modifier mes diapositives pour aujourd’hui à partir de ce point. Il s’appelait auparavant « Consul HAProxy », un nom vraiment mal choisi puisqu’il n’était en réalité pas spécifique à HAProxy.
Consul Template vous fournit une interface très simple pour créer des modèles qui suivent les changements apportés aux services, l’état de santé de ces services et même un magasin clé-valeur. Vous pouvez ainsi stocker des paramètres tels que [le nombre de] processus de travail NGINX dans le magasin clé-valeur et régénérer votre configuration lorsqu’ils changent.
La principale fonctionnalité ici est de générer des fichiers à partir de modèles, ce qui ressemble beaucoup à ce que nous faisions auparavant avec Chef. La différence majeure est qu’elle utilise le langage de modèles de Golang plutôt qu’ERB, qui repose sur Ruby. Après avoir modifié un fichier, vous pouvez éventuellement exécuter une commande à la suite de cette modification, par exemple service nginx reload.
22:59 Commande pour démarrer Consul Template
Voici donc un exemple d’exécution de Consul Template en ligne de commande. Vous le faites pointer vers votre hôte Consul réel, qui est ici consul‑prod.example.com. Dans un véritable environnement de production, je vous conseille d’exécuter Consul partout et de vous connecter à localhost.
Ensuite, vous indiquez un fichier de modèle, qui est un modèle Golang. Dans notre cas, nous indiquons /etc/consul‑templates/api. Puis vous précisez le fichier dans lequel écrire le résultat, donc dans notre cas /etc/NGINX/sites‑enabled/api. Enfin, vous indiquez une commande à exécuter : service nginx reload.
23:32 Configuration de NGINX avec Consul Template
Le modèle Consul ressemble beaucoup à une diapositive que j’avais présentée précédemment, sauf qu’au lieu d’ERB, il utilise Golang. Nous définissons donc ici deux serveurs en amont. L’un s’appelle « api » et l’autre « homepage ». Nous avons une instruction range pour l’API du service, ainsi que des variables intégrées permettant de récupérer l’adresse IP et le port sur lesquels ce service s’exécute réellement.
23:54 Gestion de la configuration avec Consul Template
L’un des grands avantages de Consul Template utilisé de cette manière est la rapidité de convergence lors des changements apportés aux services. Avant de déployer avec Docker, nous exécutions Chef toutes les 5 ou 10 minutes environ, selon la machine. C’était suffisamment rapide pour nous, car nous effectuions les déploiements sur place.
Maintenant que nous mettons en place un système de déploiement plus avancé, nous devons être informés de ces changements en quelques secondes plutôt qu’en quelques minutes. En réalité, nous le sommes en quelques millisecondes, avec une moyenne d’environ 200 millisecondes.
Cependant, la gestion de la configuration reste nécessaire pour générer des modèles. Nous ne pouvons pas simplement remplacer Chef par Consul. Nous devons encore déterminer comment déployer Consul, Consul Template et tout le reste.
24:35 Utiliser Chef pour déployer Consul
Nous utilisons donc en fait des modèles Chef pour déployer nos modèles Consul, ce qui semble un peu alambiqué. Dans notre recette Chef, nous commençons par interroger notre hôte Consul afin d’obtenir la liste de tous les services. Nous générons ensuite un modèle Consul [à l’aide des instructions template et source], puis nous lui transmettons les emplacements de notre certificat SSL et de notre clé, avant de recharger consul‑template. [Note de l’éditeur : M. Reedy a d’abord fait référence à consul‑haproxy, qui apparaît dans la première instruction notifies de la diapositive. Il s’est ensuite corrigé et a précisé que la diapositive était antérieure à la publication de Consul Template.]
Nous générons également un fichier de configuration pour Consul Template, auquel nous transmettons [des variables indiquant] l’hôte Consul, la source, la destination et la commande de rechargement. C’est véritablement le cœur de notre utilisation conjointe de Chef et Consul pour mettre à jour instantanément nos configurations NGINX.
25:44 Conseils de pro
Ensuite, j’ai quelques conseils de pro à vous donner sur Chef, Consul et la configuration de NGINX en général.
25:52 Recherche partielle avec Chef
Le premier conseil, si vous utilisez la recherche Chef pour déterminer où s’exécutent vos services, est de vous intéresser à la recherche partielle de Chef. Le problème de la recherche Chef, c’est qu’elle crée une copie du nœud entier, avec tous ses attributs. Si vous enregistrez beaucoup d’éléments dans les attributs de votre nœud, vous devrez les transférer sur le réseau lors des échanges avec votre serveur Chef, mais aussi les stocker en mémoire.
Si la recherche Chef renvoie des centaines ou des milliers de serveurs, on comprend aisément que la mémoire disponible pour la recette en cours d’exécution puisse être épuisée. La recherche partielle permet de ne renvoyer que les clés qui vous intéressent.
Par exemple, nous avions d’abord
nodes = search(:node, 'recipe:belly-api')Cette recherche renvoie absolument toutes les informations sur chaque objet. Cela inclut des informations sur son espace disque, sa mémoire vive, son processeur, ainsi que sur toutes les applications qui ont écrit leurs propres attributs de nœud.
À la place, nous pouvons utiliser une recherche partielle en créant une nouvelle table de hachage appelée « search_keys » et en lui fournissant la liste des clés qui nous intéressent – dans ce cas, uniquement le nom et l’adresse IP. Nous appelons ensuite l’API très similaire nommée « partial_search » et lui transmettons le paramètre supplémentaire [keys].
26:53 DNS
Le deuxième problème auquel nous nous sommes heurtés lorsque nous avons mis en place un équilibrage de charge devant S3 et Heroku est que NGINX utilise le DNS pour résoudre les noms d’hôte dans les blocs upstream uniquement lors du rechargement de la configuration. Cela signifie que si vous définissez comme serveur en amont s3.amazonaws.com ou anything.herokuapp.com et que son adresse change, votre équilibreur de charge ne connaît pas la nouvelle adresse IP avant le prochain rechargement.
Pour contourner ce problème, nous effectuons la résolution DNS directement dans Chef, puis déclenchons le rechargement de NGINX lorsqu’un changement est détecté. Cela a entraîné un deuxième problème : [l’ordre des adresses dans une réponse DNS] n’est pas toujours le même. Veillez donc également à trier la réponse avant de l’insérer dans votre modèle.
27:36 Éviter une configuration obsolète
L’autre problème qui se pose lorsque vous commencez à déployer une multitude de services, c’est qu’il faut éviter les configurations obsolètes. [Note de la rédaction – M. Reedy interrompt brièvement la présentation pour répondre à une question du public.] Dans Apache, NGINX et d’autres systèmes UNIX, une méthode de configuration courante consiste à créer un dossier conf.d puis à charger tout ce qu’il contient. Ainsi, si je déploie les services A, B et C, je crée service-a.conf, service-b.conf et service-c.conf.
Ensuite, je décide de remplacer le service B par le service D. Le dossier de configuration de NGINX contient alors quatre fichiers de configuration, mais le service B n’existe plus. Des conflits peuvent survenir entre B et D, car leurs noms d’hôte sont similaires.
Par le passé, nous avons envisagé deux façons de procéder [pour supprimer les configurations obsolètes]. Avec les modèles, vous pouvez ajouter une fonction :delete, mais cette approche est rapidement devenue assez difficile à gérer. Nous avions essentiellement une liste d’anciens services que nous tentions systématiquement de supprimer s’ils existaient. Cette solution ne passait pas vraiment à l’échelle.
Vous pouvez également générer toutes les configurations de vos sites dans un seul fichier. Beaucoup parlent alors de « déplacer l’idempotence vers le haut ». En substance, au lieu d’avoir une configuration NGINX qui se charge depuis plusieurs sources, regroupez tout dans votre fichier nginx.conf.
Cela devient certes un peu difficile à manier lorsque vous vous connectez directement à la machine, mais nous espérons arriver au stade où vous n’aurez plus à dépanner un fichier de configuration à chaud en production. Si cela reste encore un peu trop lourd à gérer dans vos recettes Chef, notre solution consiste à utiliser un seul fichier nginx.conf qui charge une série de sites différents. Par exemple, l’un de nos fichiers de configuration de site répertorie une trentaine de services, puis nous en avons un pour Heroku, un pour tous les services S3, etc.
Ainsi, si vous générez toutes les configurations de vos sites dans un seul fichier ou dans un petit nombre de fichiers, vous n’avez pas à vous soucier de faire le ménage. Si, du point de vue de Chef, un service disparaît, Chef cesse simplement de l’inclure dans le fichier concerné.
30:35 Questions
Q : Quel bilan tirez-vous de Consul jusqu’à présent ?
R : Nous sommes ravis de Consul. Ce que j’apprécie vraiment par rapport à une solution comme etcd, c’est que des services continuent d’être développés autour de Consul. Je n’ai pas à me soucier de la découverte de services. D’ailleurs, si vous avez des applications existantes et que vous déployez, par exemple, vos serveurs MySQL à l’aide de Consul, celui-ci fournit également une interface DNS.
Votre application n’a pas besoin de connaître Consul ; elle peut simplement demander : « quelle adresse correspond à mysqldb.services.consul ? ». Dans ce cas, Consul fait office de serveur DNS. Vous configurez votre infrastructure DNS de sorte que, si le TLD [domaine de premier niveau] se termine par .consul, la requête soit acheminée vers Consul.
La montée en charge s’est très bien passée pour nous. En production, nous exploitons environ 3 nœuds pour les agents serveurs et une soixantaine de clients. Nous n’avons rencontré aucun problème. Ils continuent d’ajouter des fonctionnalités sans compromettre la rétrocompatibilité, si bien que les mises à niveau se sont toujours très bien déroulées.
Q : Utilisez-vous NGINX Plus ?
R : Non. Nous nous sommes penchés sur cette possibilité précisément pour cette raison, lorsque nous avons commencé à travailler avec Consul. Si nous n’avions pas besoin d’un système de modèles, ce serait idéal, car nous pourrions simplement avoir un script qui écoute cette interrogation HTTP longue, puis communique avec l’API NGINX en votre nom. Le seul problème, c’est que vous aurez probablement aussi besoin d’un système de modèles au cas où NGINX redémarrerait. Il rechargerait alors immédiatement vos configurations en amont.
D’autres personnes ont également travaillé sur des solutions permettant d’interroger directement Consul avec NGINX Lua. Je n’ai pas encore vu de bonne implémentation, car elles ont tendance à relever de l’une de ces deux catégories. Dans le premier cas, elles interrogent Consul à chaque requête HTTP, ce qui est lent. Dans le second, elles chargent les données lors de la configuration, et on se retrouve avec le même problème qu’avec le DNS. Pour l’instant, le système de modèles reste donc la meilleure solution, mais je ne serais pas surpris qu’une méthode utilisant NGINX Lua voie le jour à l’avenir.
Q : Envisageriez-vous un jour d’abandonner Chef ?
R : Consul n’intègre pas vraiment de solution efficace pour gérer ces modèles, et nous déployons déjà NGINX avec Chef. À ce stade, nos recettes associées comptent des centaines, voire des milliers de lignes pour toutes les autres tâches que nous effectuons avec NGINX, notamment la journalisation, le traçage et certaines fonctionnalités OAuth. Je ne nous vois pas abandonner et remplacer Chef dans notre infrastructure, mais Consul constitue un excellent complément et un bon moyen de recevoir rapidement des notifications.
Q : Quelle est la surcharge induite par Chef ?
R : Comme la plupart de nos machines n’exécutent qu’une seule tâche, la surcharge réelle liée à Chef est assez faible. L’utilisation de la RAM reste faible lorsqu’il est inactif. En fait, il attend le déclenchement d’un minuteur, puis peut créer un processus fils. D’autres l’exécutent également via une tâche cron s’ils n’accordent pas d’importance à la rapidité de la convergence. Nous constatons une légère hausse de l’utilisation du processeur avec certaines de nos recettes les plus lourdes, mais rien qu’on ne puisse résoudre en déployant simplement un serveur supplémentaire.
Q : Dans quelle mesure avez-vous utilisé CloudFormation ?
R : Nous n’utilisons pas encore CloudFormation. C’est dans nos projets, mais l’un des changements que nous avons apportés consiste à utiliser beaucoup plus de groupes Auto Scaling. Concrètement, lorsqu’une instance démarrera, elle disposera de données utilisateur contenant sa liste d’exécution Chef.
Une nouvelle machine rejoindra un cluster avec une clé déjà intégrée à son image. Elle pourra ainsi communiquer avec notre serveur Chef, s’enregistrer et télécharger les cookbooks dont elle a besoin. Cela répond à la plupart de nos besoins auxquels CloudFormation aurait pu répondre, car nous n’utilisons pas beaucoup d’autres outils AWS qui iraient de pair avec celui-ci.
Q : Comment gérez-vous la destruction d’un serveur ?
R : Si un serveur disparaît d’un groupe Auto Scaling, vous pouvez utiliser Amazon SNS [Simple Notification Service] pour en être informé. Nous disposons d’un service très simple qui reçoit ces notifications, puis effectue le nettoyage nécessaire sur le serveur Chef.
Q : Avez-vous déjà utilisé AWS OpsWorks ?
R : Non. Nous utilisons la version hébergée de Chef depuis le début et elle nous donne entière satisfaction. Je n’en suis pas certain, mais je crois qu’OpsWorks ressemble davantage à Chef Solo, dans le sens où il sert uniquement au provisionnement. Nous continuons à exécuter Chef Agent sur la quasi-totalité de nos machines et utilisons ces mêmes recettes Chef pour générer des conteneurs Docker destinés au développement.
36:31 Coordonnées
À propos de l’auteur
Articles de blog associés
Tendances actuelles des technologies cloud natives, de l’ingénierie de plateforme et de l’IA
Découvrez les principaux enseignements tirés des réponses à l’enquête annuelle F5 NGINX sur les dernières tendances en matière de technologies cloud natives, de sécurité, d’ingénierie de plateforme et d’IA.

Quels contrôleurs Ingress NGINX sont affectés par les vulnérabilités CVE-2022-4886, CVE-2023-5043 et CVE-2023-5044 ?
Lorsque de nouvelles CVE sont signalées, il est facile de ne plus savoir si elles concernent un outil de contrôleur Ingress NGINX particulier, car il existe plusieurs projets. Cet article présente les CVE et explique comment distinguer les différents projets de contrôleurs Ingress afin de dissiper toute confusion.
Votre API est-elle en temps réel ? Testez sa latence avec l’outil rtapi de NGINX
Votre API répond-elle aux requêtes en moins de 30 ms ? Si ce n’est pas le cas, il ne s’agit pas d’une API en temps réel offrant la faible latence exigée par la grande majorité des organisations. Mesurez la latence de votre API avec l’outil rtapi de NGINX et découvrez comment NGINX peut l’aider à offrir une réactivité en temps réel.
Un testeur d’expressions régulières pour NGINX et NGINX Plus
Le testeur d’expressions régulières (regex) pour NGINX et NGINX Plus vous évite de tâtonner en vous indiquant si une expression régulière utilisée dans un bloc location ou map correspond aux valeurs comme prévu. Il génère la configuration appropriée et affiche les valeurs des groupes de capture.
Caches partagés avec les clusters de cache NGINX Plus, partie 1
Optimisez la capacité de votre cache web en le répartissant entre plusieurs serveurs de cache web NGINX ou NGINX Plus. Découvrez comment procéder dans cet article.
Introduction aux microservices
Les microservices suscitent actuellement beaucoup d’intérêt. Cet article de blog est le premier d’une série de sept consacrée à la conception, au développement et au déploiement de microservices.