Cet article explique comment Volterra aide les utilisateurs à gérer leurs applications et leur infrastructure comme une flotte. Nous verrons comment notre approche basée sur le plan de contrôle facilite l’exploitation d’une vaste flotte de clusters d’applications, et nous la comparerons à d’autres approches de gestion multicluster telles que Google Anthos, Azure Arc, Rancher, etc.
À ce stade, vous vous demandez peut-être si nous ne faisons pas qu’habiller notre discours marketing en qualifiant notre gestion multicluster d’exploitation de flotte ! La gestion multicluster et l’exploitation de flotte répondent à des cas d’usage différents et reposent sur des architectures fondamentalement distinctes. Une approche multicluster est conçue pour les scénarios comportant un nombre relativement limité de clusters, dans lesquels l’utilisateur souhaite gérer ces clusters d’infrastructure selon un modèle opérationnel cohérent. À l’inverse, l’approche par flotte est destinée aux scénarios impliquant un très grand nombre de clusters (par exemple, des clusters K8s dans des robots, des véhicules, des passerelles industrielles, des dizaines de régions de cloud public, etc.), sur lesquels l’utilisateur souhaite déployer la même application ainsi que les mêmes configurations réseau et de sécurité. Les deux sections suivantes décrivent et comparent plus en détail les approches de gestion multicluster et d’exploitation de flotte.
Approche multicluster
Une approche de gestion multicluster est conçue pour répondre aux cas d’usage dans lesquels un nombre relativement limité de clusters est géré par une seule équipe. Il peut s’agir, par exemple, de quelques dizaines de clusters répartis sur plusieurs zones de disponibilité afin de limiter l’impact potentiel d’un incident. De même, les utilisateurs peuvent choisir de déployer plusieurs clusters dans différentes régions afin de répondre aux exigences réglementaires.
Les deux exemples suivants illustrent le fonctionnement général des solutions multiclusters :
Configuration
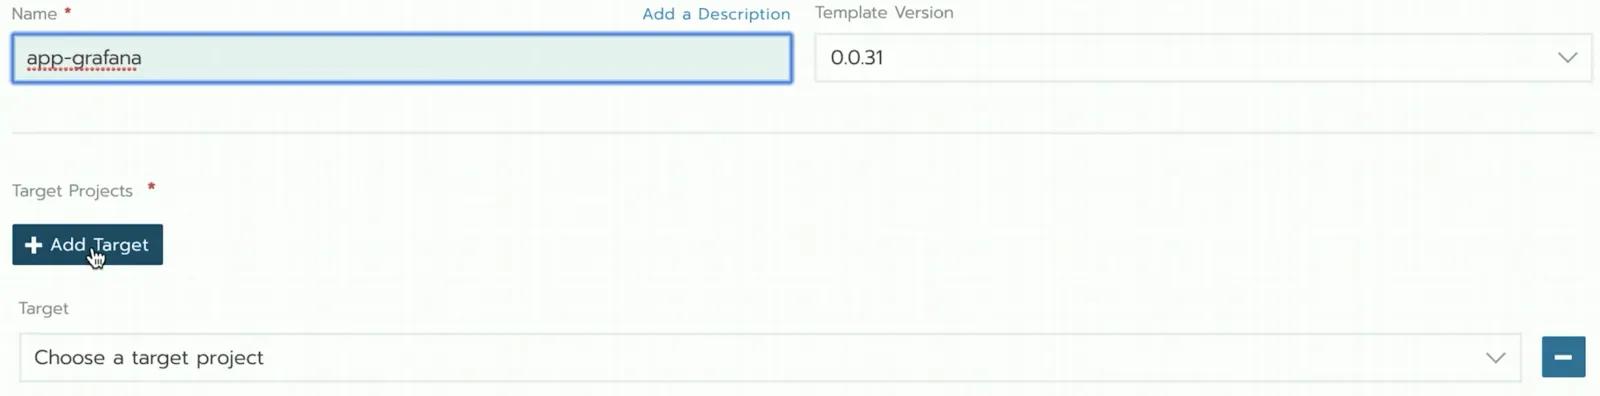
Prenons l’exemple d’un déploiement d’application utilisant l’approche multicluster de Rancher, comme illustré à la figure 1. Dans une approche multicluster, le client sélectionne un à un les sites cibles pour le déploiement de l’application. Cette méthode de sélection individuelle des sites cibles convient lorsque l’on ne dispose que de quelques clusters. En revanche, elle n’est pas conçue pour gérer, par exemple, un millier de clusters.
Observabilité
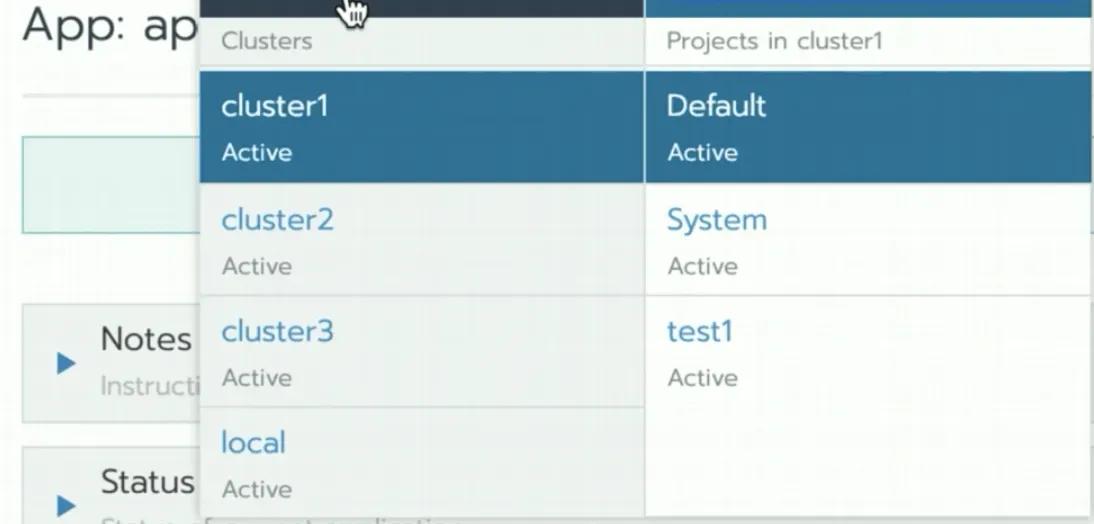
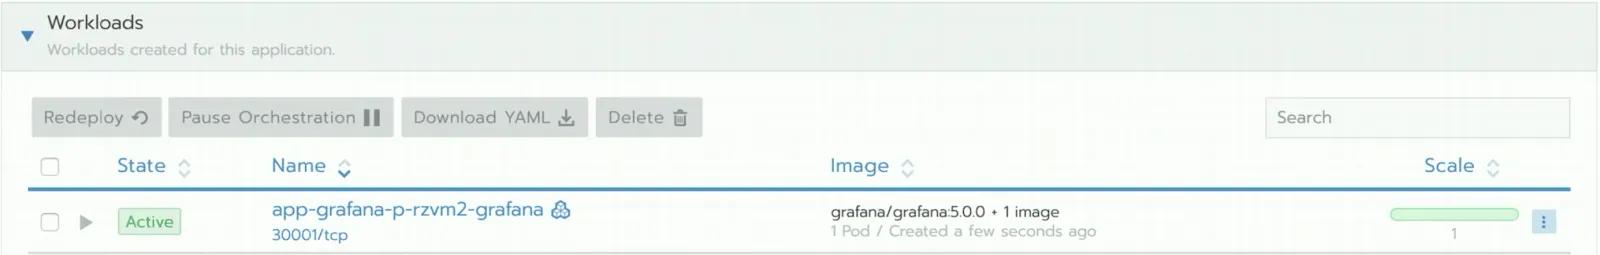
La figure 2 illustre le fonctionnement de l’observabilité dans une approche multicluster, en prenant Rancher comme exemple. Dans une telle approche, le client doit double-cliquer sur chaque cluster, un par un, pour consulter l’état des pods déployés ainsi que l’utilisation des ressources processeur et mémoire. Cette méthode, qui consiste à observer les sites cibles individuellement, convient à un petit nombre de clusters, mais pas à la gestion d’un grand nombre de clusters.
Cluster 1 :
Cluster 2 :

Une approche évidente pour résoudre le problème décrit dans le premier exemple consisterait à mettre en place une forme d’automatisation qui répéterait les tâches pour chacun des clusters. Par exemple, chaque fois qu’un nouveau cluster est ajouté, le script pourrait effectuer l’opération suivante afin de déployer une nouvelle application (checkoutservice, par exemple).
export KUBECONFIG=~/Documents/kubeconfig/ce01-ashburn-aws-staging
kubectl apply -f checkoutservice.yaml
Cependant, il faudra mettre en place une automatisation pour chaque opération — déploiement, mise à niveau, stratégie, réservation de ressources, etc. Cette automatisation devra non seulement exécuter chaque opération sur de nombreux clusters, mais aussi gérer les situations d’échec. En outre, dans les scénarios complexes — par exemple, des tests bêta sur un sous-ensemble de clusters ou des mises à niveau progressives sur l’ensemble des clusters — l’automatisation deviendra de plus en plus complexe. Nous nous en sommes rendu compte très tôt et avons conçu un plan de contrôle distribué qui fournit toutes ces fonctionnalités, en adoptant l’approche de gestion de flotte décrite ci-après.
L’approche de Volterra en matière d’exploitation de parcs
Les opérations de flotte permettent au client de définir de manière déclarative et en une seule fois ses intentions pour l’ensemble de la flotte. Le système se charge ensuite de veiller à ce que les sites concernés soient conformes aux intentions définies. Celles-ci peuvent notamment porter sur la version des logiciels applicatifs, la version des logiciels d’infrastructure (par exemple, la version du système d’exploitation), la politique réseau, la politique de sécurité et la réservation des ressources.
Une fois l’intention appliquée, le système permet aux utilisateurs de consulter l’état et la santé de la flotte. Autrement dit, les utilisateurs bénéficient d’une vue agrégée de la santé de l’infrastructure et des applications sur l’ensemble des sites de la flotte, depuis une interface unique, ce qui réduit la complexité opérationnelle pour l’équipe d’exploitation du client. Ils n’ont plus besoin d’accéder à chaque site ou cluster individuellement pour en vérifier la santé, ni de développer des outils d’automatisation pour agréger les informations.
L’approche de Volterra en matière d’exploitation de flotte repose sur trois composantes principales — la segmentation, la configuration et l’observabilité — que nous aborderons dans les sections suivantes.
Segmentation de la flotte
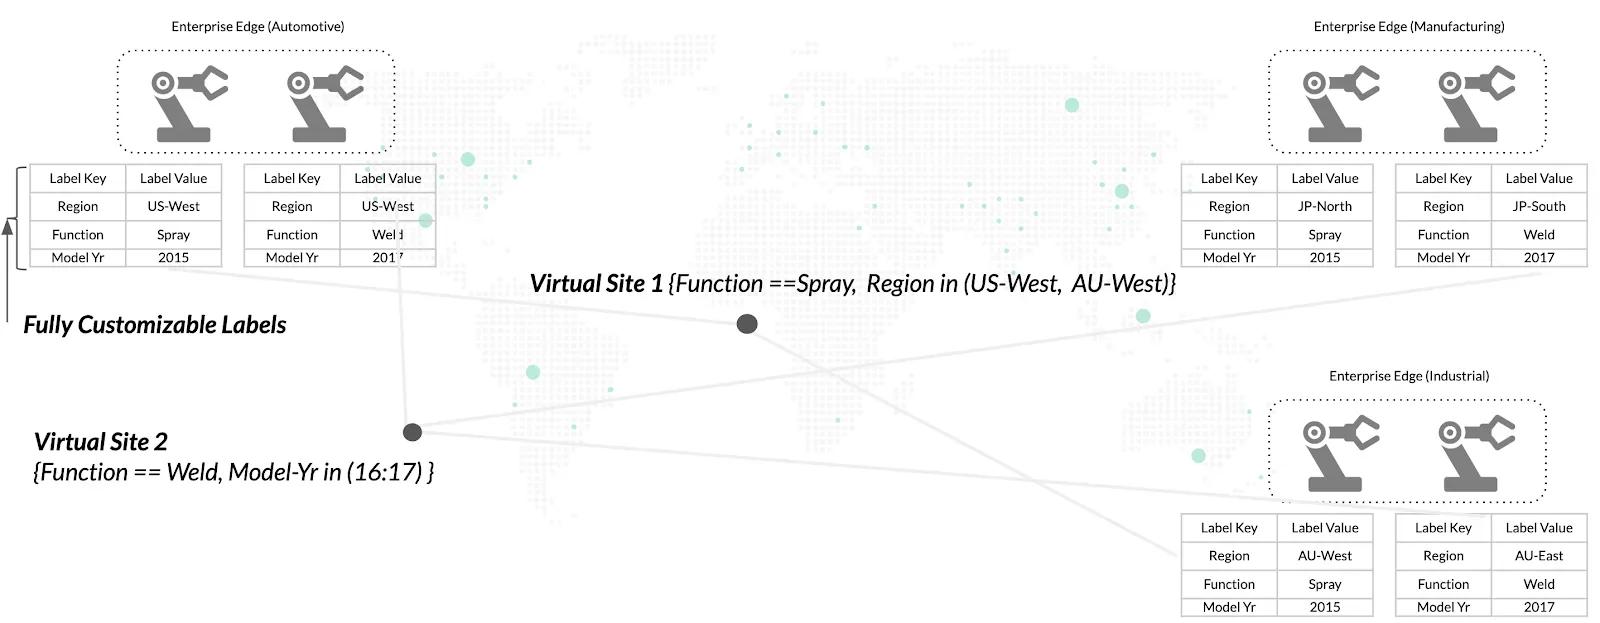
Les utilisateurs disposent souvent d’un parc composé de différents types de sites de calcul, tels que des sites de développement, de test et de production. Les différentes charges de travail doivent être déployées sur un segment précis de sites afin de respecter les politiques de l’organisation, par exemple en réservant les sites de développement aux charges de travail de développement. Nous permettons aux utilisateurs d’étiqueter les sites de manière flexible à l’aide d’un libellé composé de deux parties : une clé et une valeur. Exemples :
- Clé de l’étiquette=region. Valeur de l’étiquette = US-West, JP-North, JP-south
- année-modèle=(2015, 2016, 2017, 2018)
- fonction=(pulvérisation, soudage)
Une fois les sites étiquetés, les utilisateurs peuvent définir un « site virtuel » à l’aide de conditions basées sur les paires clé-valeur des étiquettes. Dans un environnement multicloud, ils peuvent, par exemple, étiqueter leurs sites comme étant des environnements de développement, de préproduction ou de production. La figure 3 ci-dessous présente un exemple de cas d’usage en robotique utilisant les paires clé-valeur d’étiquettes décrites précédemment.
Voici un extrait de configuration sur Volterra dans lequel l’utilisateur peut utiliser la syntaxe blend/go-sdk pour créer un site virtuel. Dans cet exemple précis, les différents sites ont été étiquetés avec la clé de libellé key=ves.io/country et la valeur de libellé ves-io-jpn.
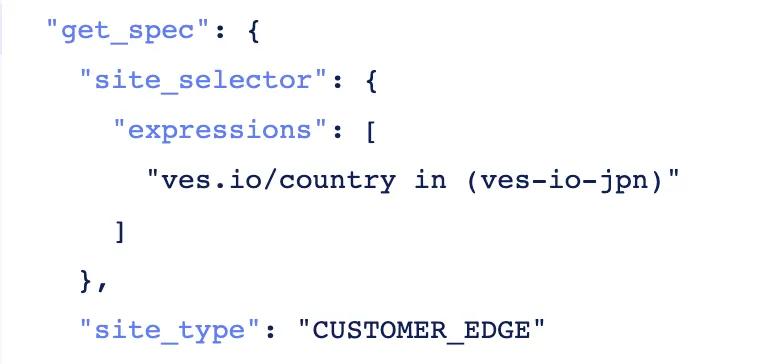
Les utilisateurs ont l’habitude d’un modèle opérationnel consistant à définir au préalable des segments de leur parc, puis à étiqueter leurs sites lors du provisionnement afin de les inclure dans ce parc. Les sites virtuels s’intègrent parfaitement à ce modèle opérationnel existant. Lorsqu’un nouveau site est provisionné avec l’étiquette appropriée, il est automatiquement inclus dans le site virtuel défini précédemment, sans aucune intervention manuelle supplémentaire. En outre, Volterra détecte les informations préconfigurées, telles que le fabricant du matériel ou le type de cloud public, afin de préremplir les étiquettes système. Les utilisateurs peuvent, s’ils le souhaitent, utiliser ces étiquettes détectées automatiquement pour définir leurs sites virtuels.
Configuration de la flotte
Les fonctionnalités de configuration de flotte sont parfaitement illustrées par les trois exemples suivants :
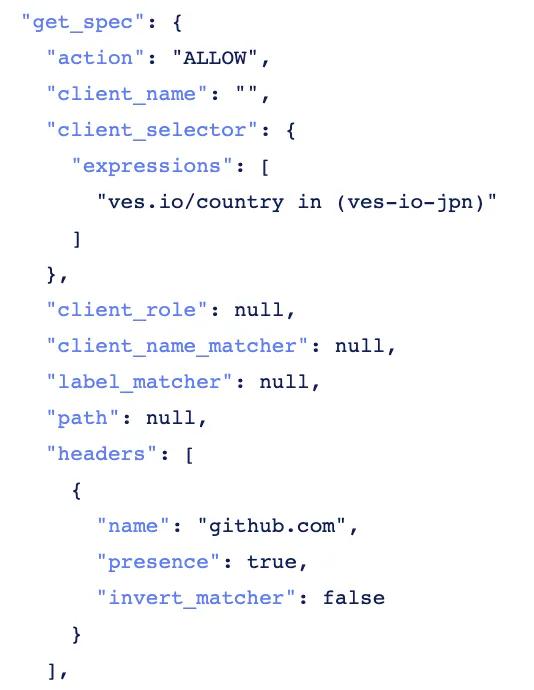
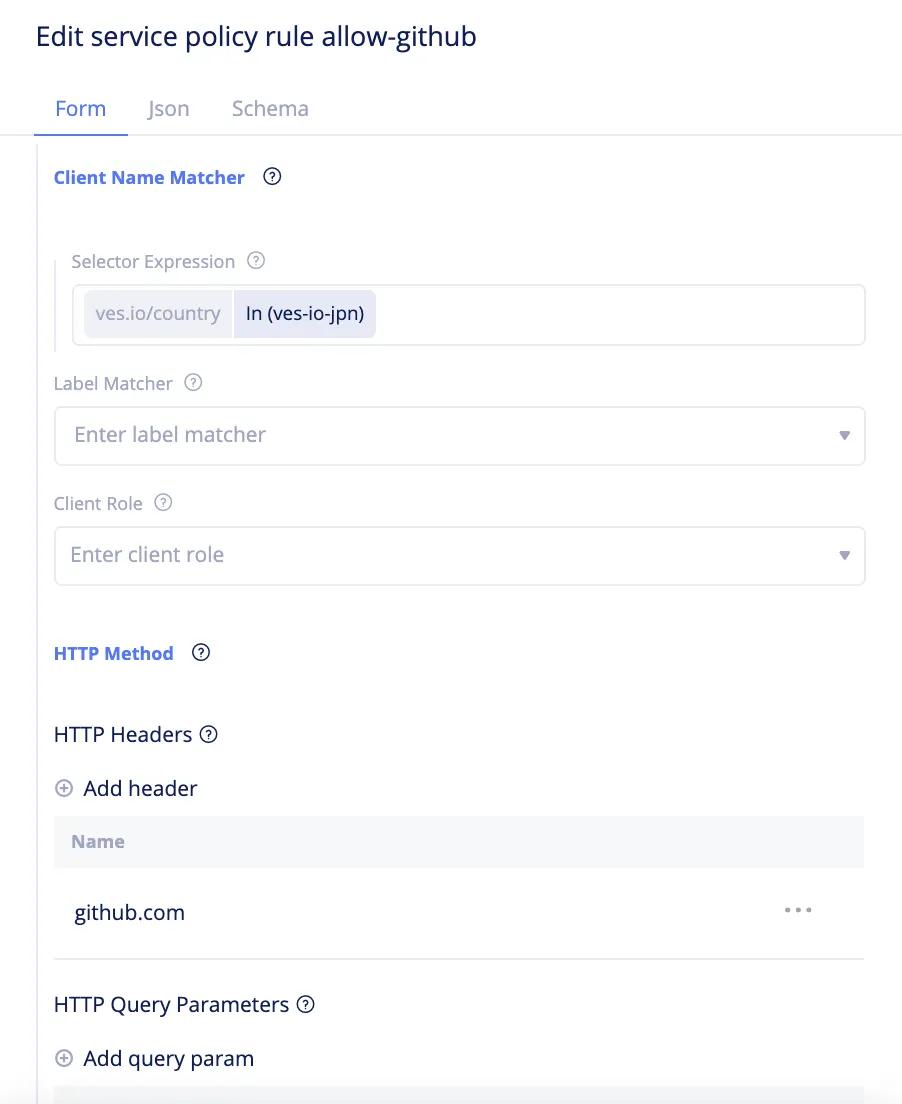
- Configuration d’une politique réseau/de sécurité -- Prenons l’exemple d’un client qui déploie un nouveau service nécessitant que chaque cluster puisse communiquer avec une URL spécifique, par exemple github.com. En général, les utilisateurs ont recours à une liste blanche, ce qui signifie que les clusters ne sont autorisés à accéder qu’à certaines destinations. Le déploiement de ce nouveau service obligerait donc les utilisateurs à intervenir sur chaque cluster et à modifier la politique réseau afin d’ajouter github.com à la liste blanche. En outre, le client souhaite effectuer des essais sur quelques sites de test avant de déployer le service sur l’ensemble des sites. Pour ce faire dans Volterra, le client commence par définir, dans la console SaaS de Volterra, un site virtuel « test » qui sélectionne une partie du parc. L’utilisateur définit ensuite une politique réseau, telle qu’une liste blanche d’URL (github.com dans cet exemple), et l’applique au site virtuel « test ». Le plan de contrôle distribué de Volterra transmet la politique réseau au plan de contrôle local de chaque site sélectionné par le site virtuel (tel que défini ci-dessus). Le plan de contrôle local de chaque site applique la politique réseau et recueille des statistiques sur les règles déclenchées pour chaque site. Une fois que le client s’est assuré que le service fonctionne comme prévu, il peut appliquer la politique réseau au site virtuel « prod », qui sélectionne les autres sites du parc. Voici un extrait de configuration au format JSON ainsi que sa représentation dans l’interface utilisateur du système Volterra.
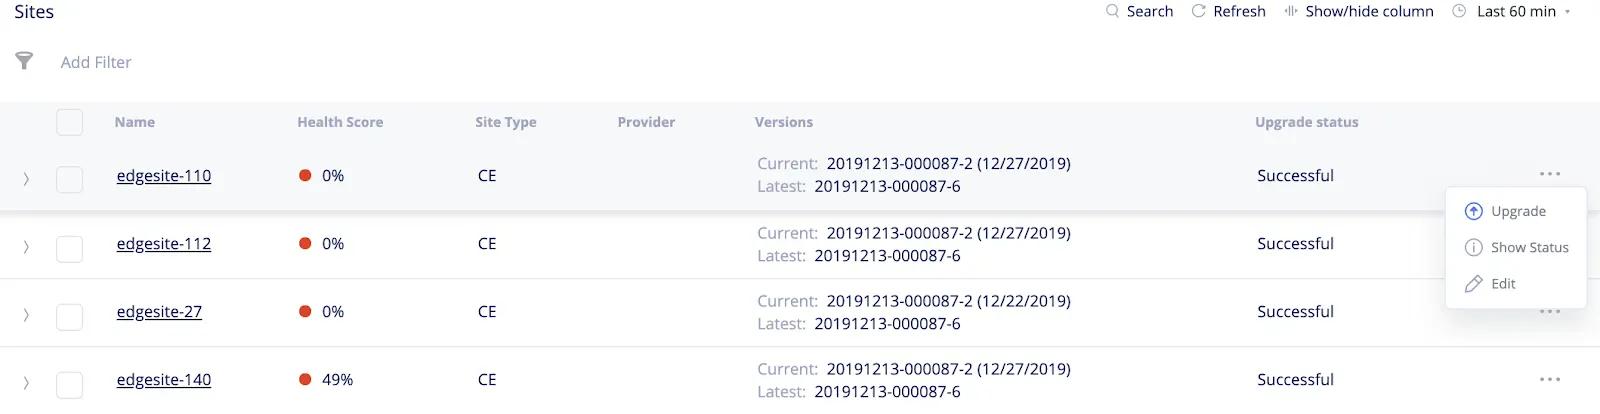
- Mise à niveau du logiciel d’infrastructure -- La fonctionnalité de configuration de la flotte permet à l’utilisateur de mettre à niveau le logiciel d’infrastructure, par exemple la version du système d’exploitation, sur l’ensemble de la flotte (ou sur une partie de celle-ci). L’utilisateur commence par indiquer qu’il souhaite faire passer le système d’exploitation de la version 1 à la version 2. Il définit ensuite une stratégie de déploiement à l’échelle de la flotte, telle qu’une mise à jour progressive ou un déploiement bleu/vert, entre autres. Une mise à jour progressive consiste à mettre à niveau successivement le système d’exploitation de chaque site de la flotte (ou d’une partie de celle-ci). Une stratégie de déploiement bleu/vert permet à l’utilisateur de tester la mise à niveau sur un ensemble de sites « bleus » (par exemple, des sites de développement) et de comparer leur état de santé à celui des sites « verts » (par exemple, des sites de production) qui n’ont pas été mis à niveau. Dans les deux cas, le plan de contrôle distribué de Volterra envoie le logiciel en version 2 au plan de contrôle local de chaque site sélectionné par le site virtuel, conformément à la stratégie de déploiement définie. Le plan de contrôle local de chaque site met à niveau le système d’exploitation selon une approche A/B : il crée une nouvelle partition, y déploie la version 2 et permet au client d’en évaluer l’état de santé. Si l’installation de la version 2 échoue, le système revient automatiquement à la version 1 dans la partition d’origine. Voici quelques captures d’écran montrant comment l’utilisateur peut mettre à niveau le logiciel d’infrastructure à l’aide du portail SaaS de Volterra. Comme l’illustre la figure suivante, l’utilisateur peut consulter la version actuelle du logiciel d’infrastructure ainsi que la dernière version disponible pour tous les sites. Il peut facilement mettre à niveau certains sites ou l’ensemble des sites, selon le modèle opérationnel.
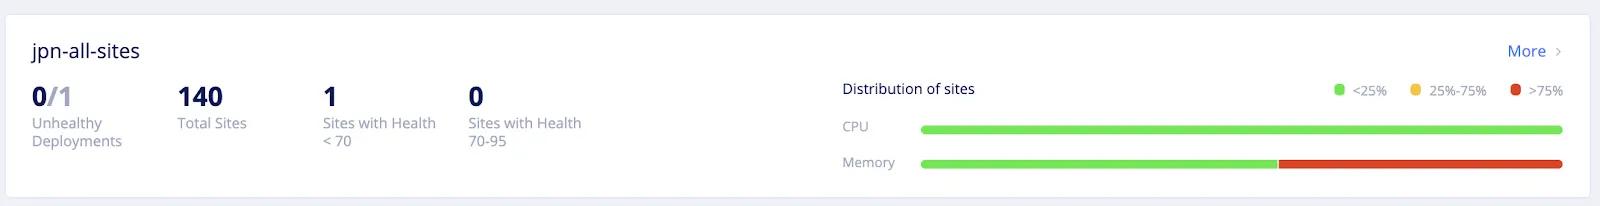
- Déploiement d’applications à l’échelle de la flotte : Volterra fournit un objet appelé Virtual Kubernetes (vK8s), qui permet aux utilisateurs de gérer des applications sur l’ensemble de leur flotte à l’aide des API Kubernetes. L’utilisateur déploie ses applications selon les méthodes Kubernetes standard (c’est-à-dire à l’aide d’un fichier Kubeconfig et des API Kubernetes), avec un fichier manifeste de déploiement, et indique le groupe de sites (ou l’ensemble de la flotte) sur lequel l’application doit être déployée. Virtual Kubernetes (vK8s) de Volterra se charge ensuite de déployer l’application sur chaque site de la flotte (ou du groupe concerné). En cas d’échec lors du déploiement de l’application, par exemple en raison de problèmes de connectivité ou d’infrastructure, Volterra Virtual Kubernetes relance continuellement le déploiement conformément au paradigme Kubernetes d’un modèle à cohérence à terme. La capture d’écran suivante montre un exemple dans lequel l’utilisateur déploie une application appelée « kuard » (voir Kubernetes-up-and-running-demo-app) sur un site virtuel appelé « jpn-all-sites », qui regroupe 140 sites de la flotte. Pour créer un déploiement, il suffit à l’utilisateur de cliquer sur « Add Deployment » et d’indiquer le site virtuel comme emplacement de déploiement.
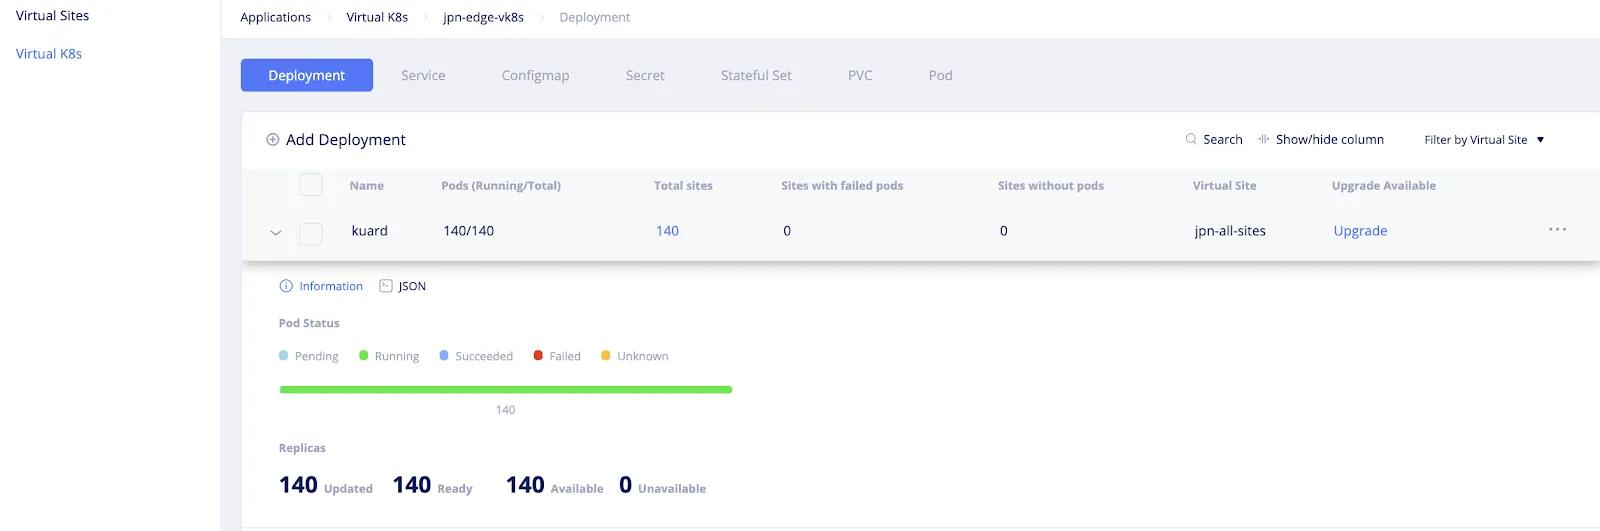
Si un nouveau site est ajouté à la flotte avec le libellé approprié, il est automatiquement intégré au site virtuel (jpn-all-sites dans cet exemple) et la configuration de la flotte (c’est-à-dire le déploiement de Kuard dans cet exemple) lui est automatiquement appliquée, ce qui réduit la charge de travail des équipes d’exploitation et élimine les erreurs humaines.
Observabilité de la flotte
Les sites virtuels et Kubernetes virtuel (vK8s) servent non seulement à la configuration, mais aussi à agréger l’état de santé des sites distribués au sein de la flotte. Il s’agit d’un outil particulièrement puissant par rapport à d’autres solutions, avec lesquelles les utilisateurs devraient développer leurs propres outils pour récupérer l’état de chaque site un par un, puis agréger les informations. Le système agrège automatiquement l’état de santé de tous les sites dans une vue unifiée, ce qui réduit la complexité opérationnelle pour l’équipe d’exploitation du client. Les données recueillies couvrent de nombreux aspects, notamment l’état du déploiement des applications, l’état de santé des sites et celui des applications.
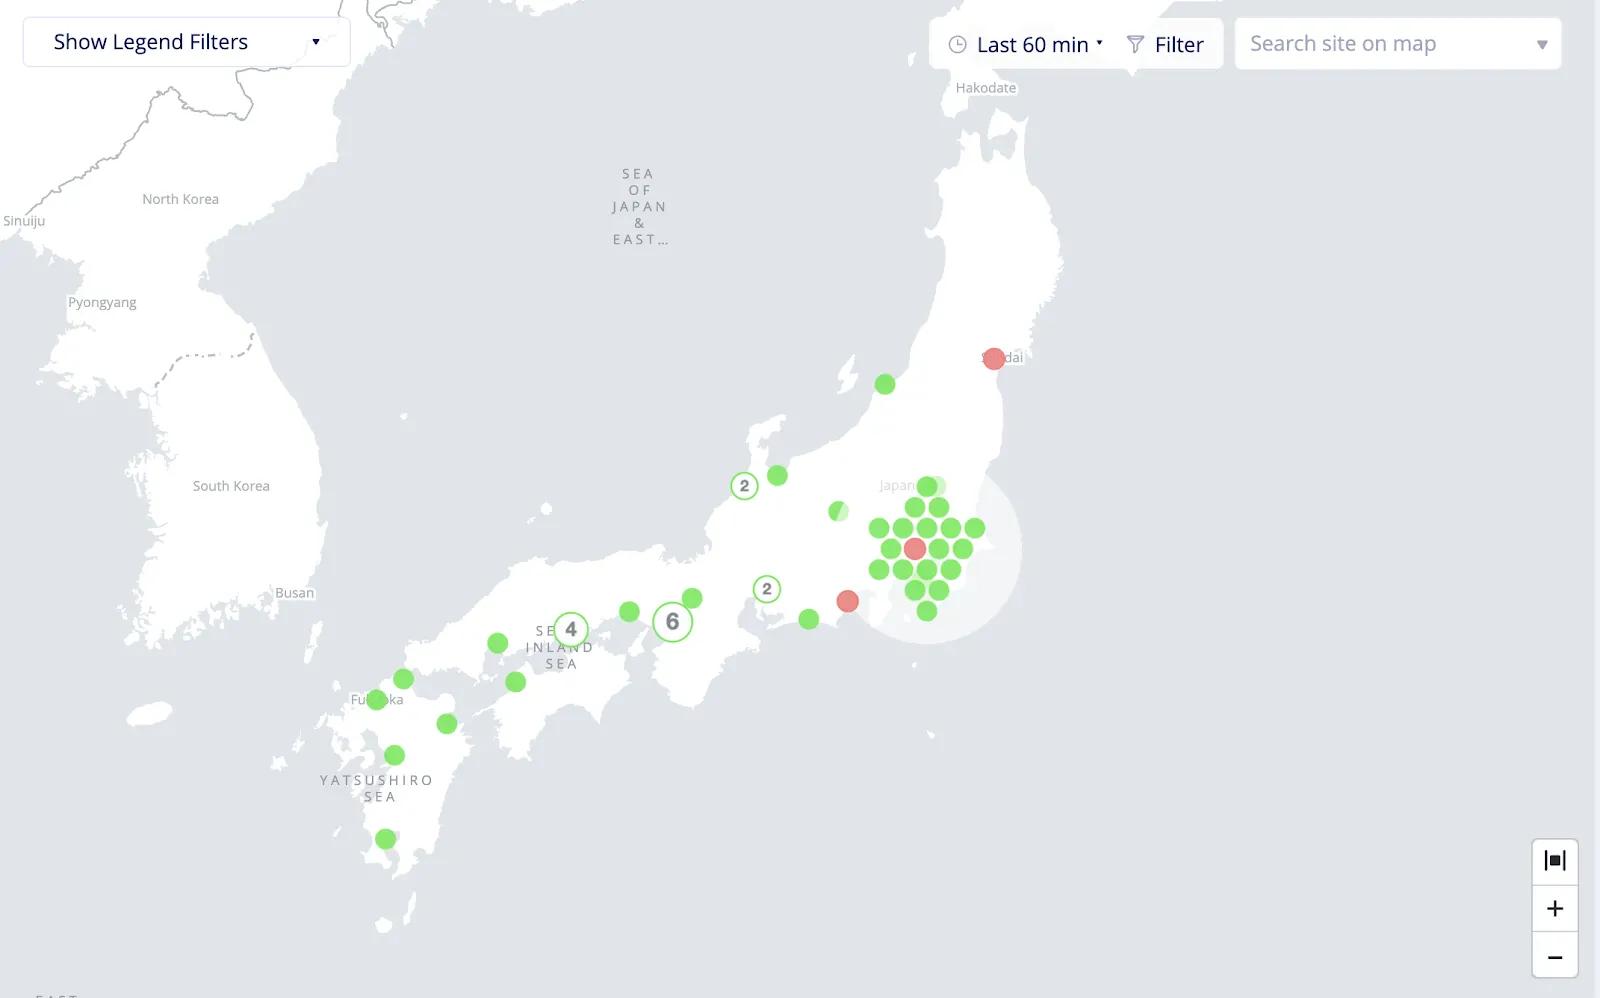
Les utilisateurs peuvent obtenir un aperçu rapide de l’état de santé de tous leurs sites sur une carte, comme illustré dans la capture d’écran suivante. La couleur indique si le score de santé est supérieur à 75 (vert), compris entre 40 et 75 (orange) ou inférieur à 40 (rouge). Le score de santé est un score agrégé qui tient compte de la connectivité, de la fiabilité, de la sécurité et des performances (c’est-à-dire de la consommation des ressources).
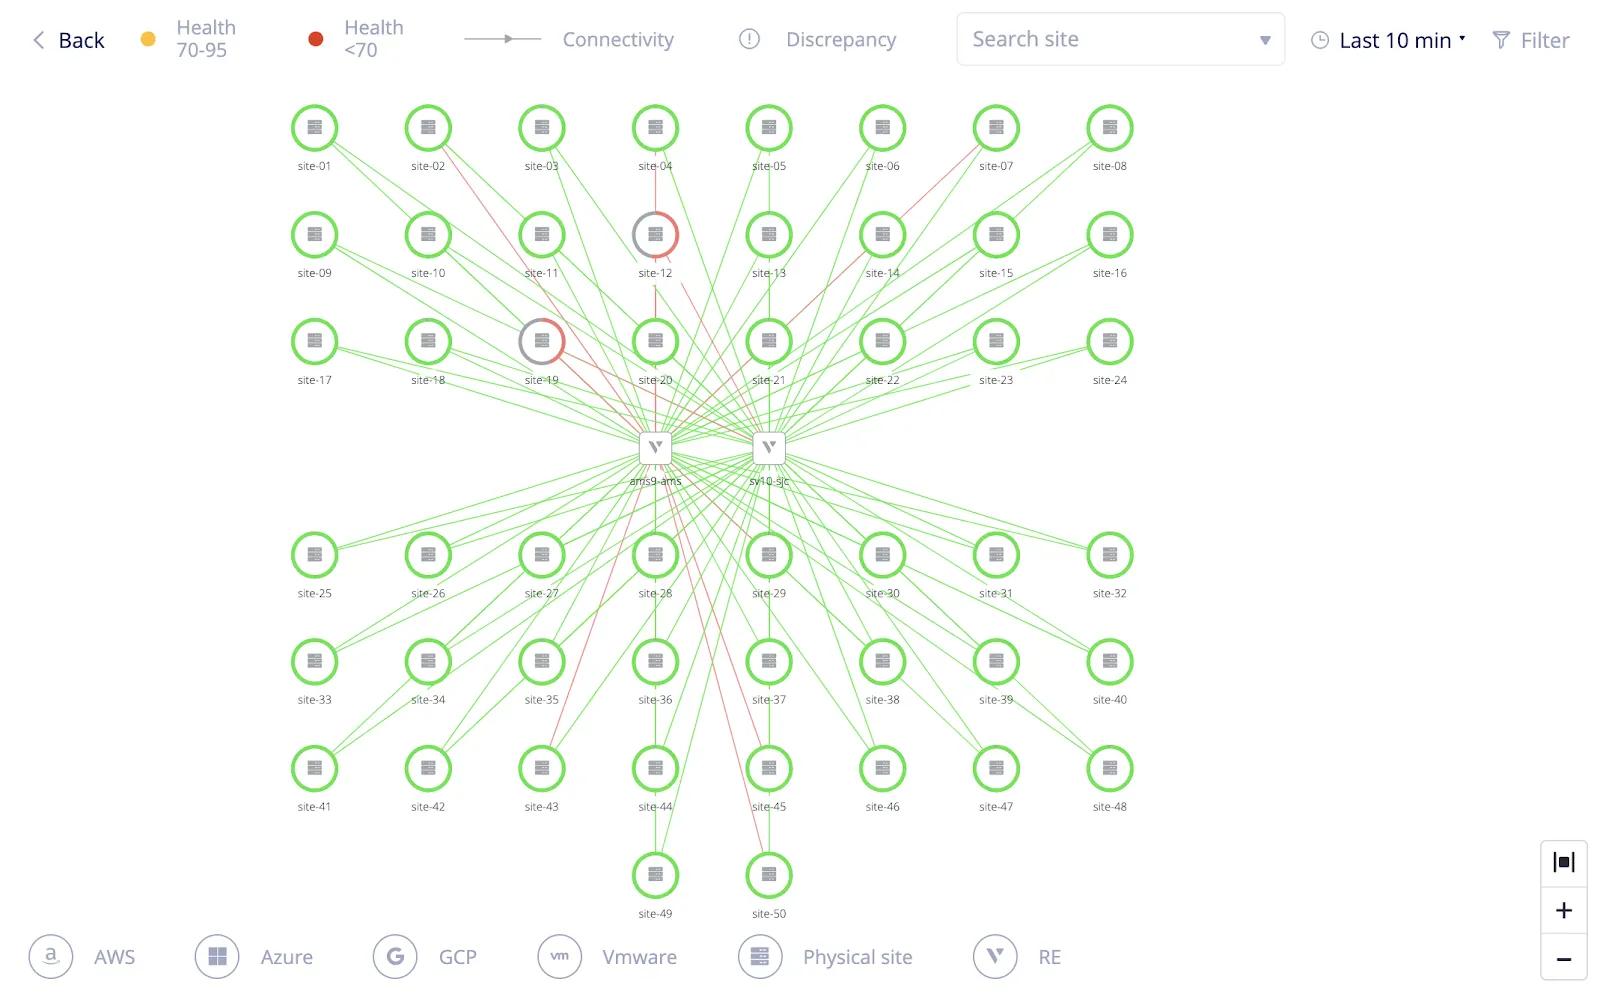
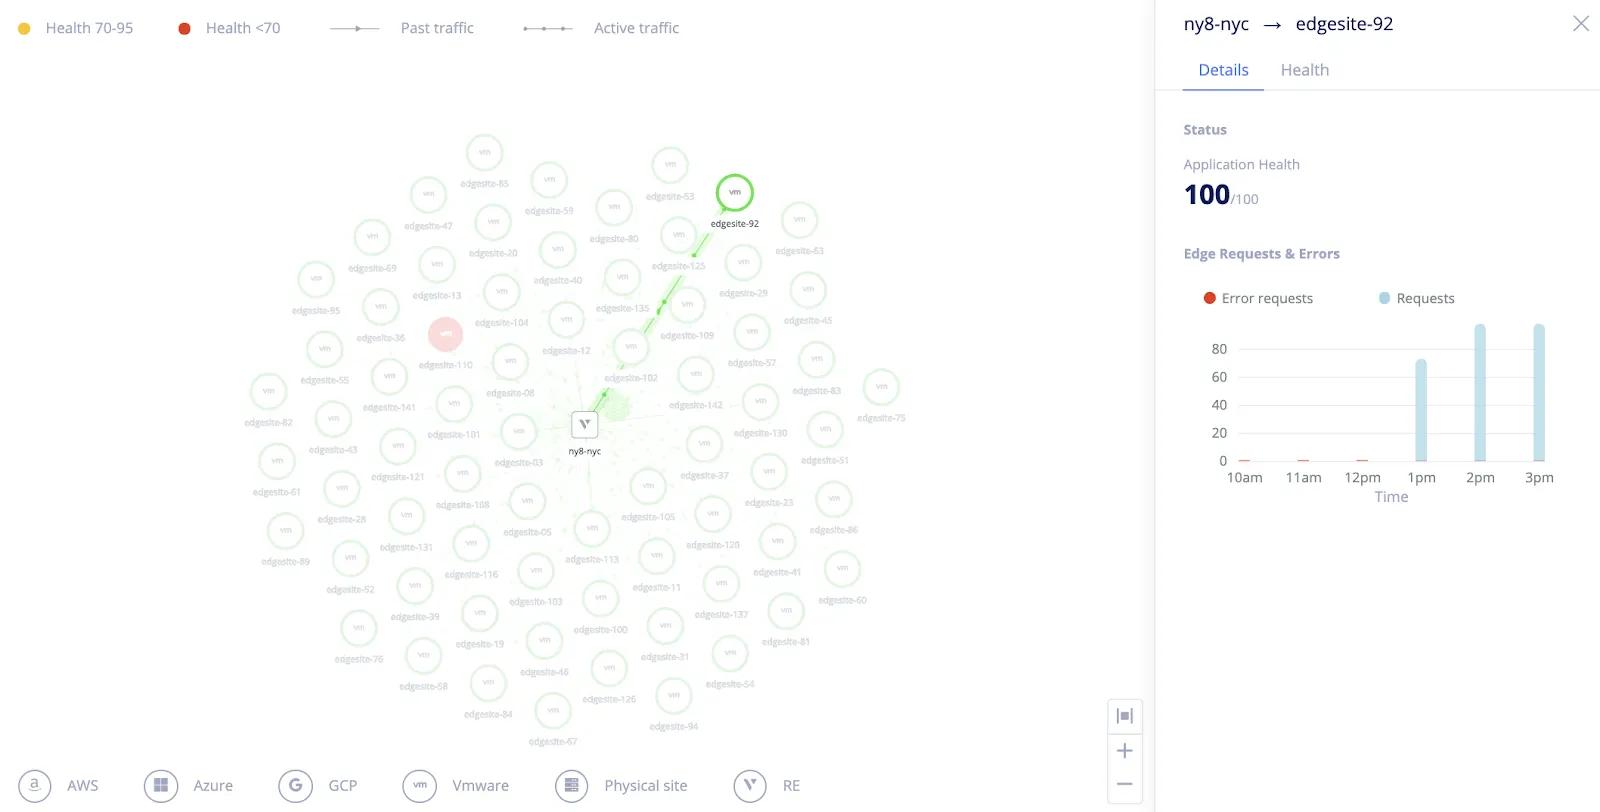
Les utilisateurs peuvent également consulter une vue agrégée de la connectivité de l’ensemble de leurs sites, ainsi que l’état de santé de chaque site. L’état de santé de la connectivité de chaque liaison reliant les sites au réseau fédérateur Volterra est également affiché, comme illustré à la figure 10. En fonction de leur état de santé, l’utilisateur peut cliquer sur les liaisons peu performantes afin d’afficher des statistiques détaillées sur les requêtes et les erreurs, et de résoudre les éventuels problèmes de connectivité, comme illustré à la figure 11.
Ensuite, l’utilisateur peut consulter des informations agrégées sur l’ensemble des sites grâce à la répartition de la charge du processeur et de la mémoire entre les différents sites. Ces informations permettent aux administrateurs informatiques ou de sites d’identifier les sites fortement sollicités et susceptibles de manquer de ressources. Les administrateurs de sites peuvent configurer des alertes afin d’être avertis lorsque la consommation de ressources dépasse certains seuils. Dans cette capture d’écran, les utilisateurs peuvent constater que la moitié des sites consomment plus de 75 % de la mémoire disponible. Ils n’ont pas besoin de cliquer sur chaque site ni de développer des outils supplémentaires pour obtenir ces informations.
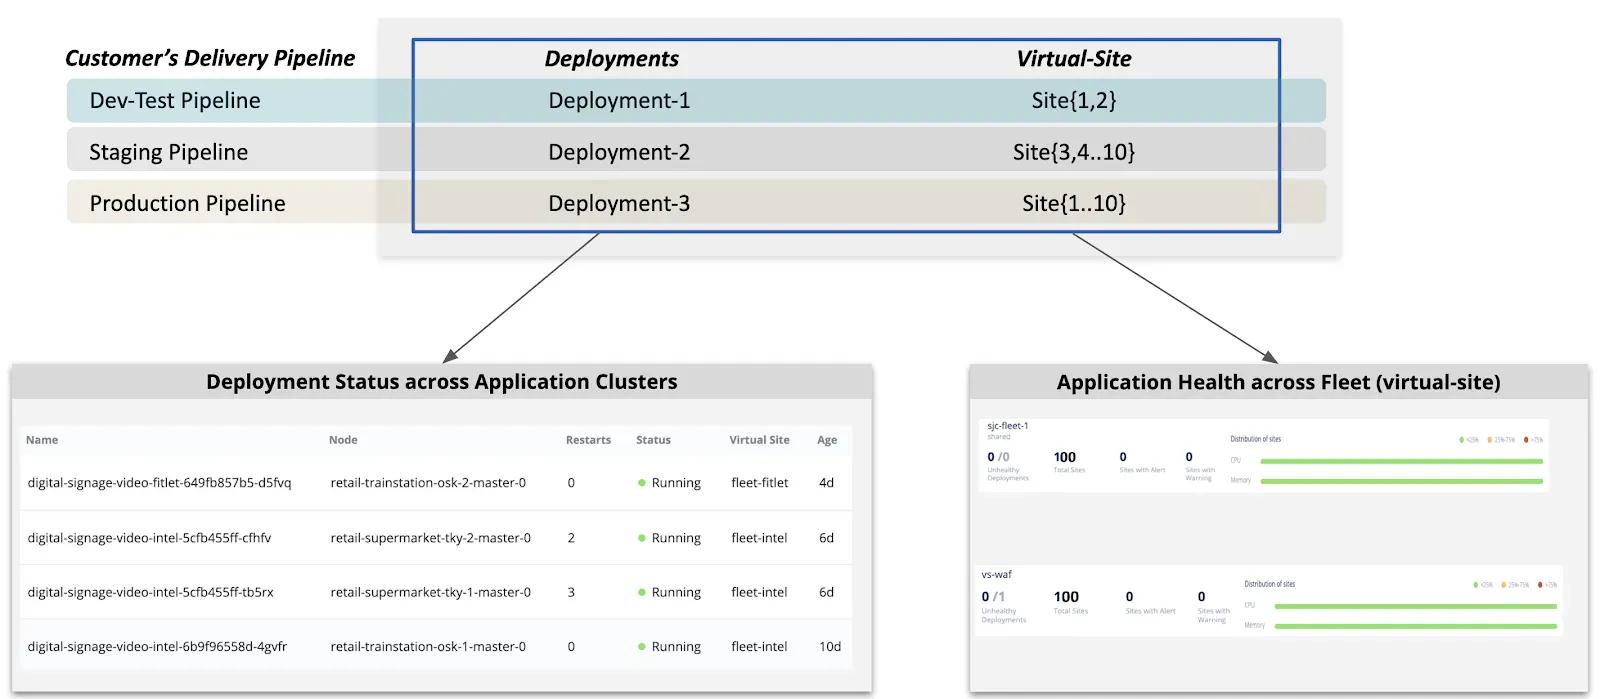
Les fonctionnalités de vérification continue de l’objet de flotte indiquent l’état des déploiements de POD — combien de POD ont été déployés, sont en cours de déploiement ou ont échoué. Une fois les POD déployés, les utilisateurs peuvent également consulter leur état de santé — s’ils sont en cours d’exécution, en attente d’une image, à court de mémoire, etc.
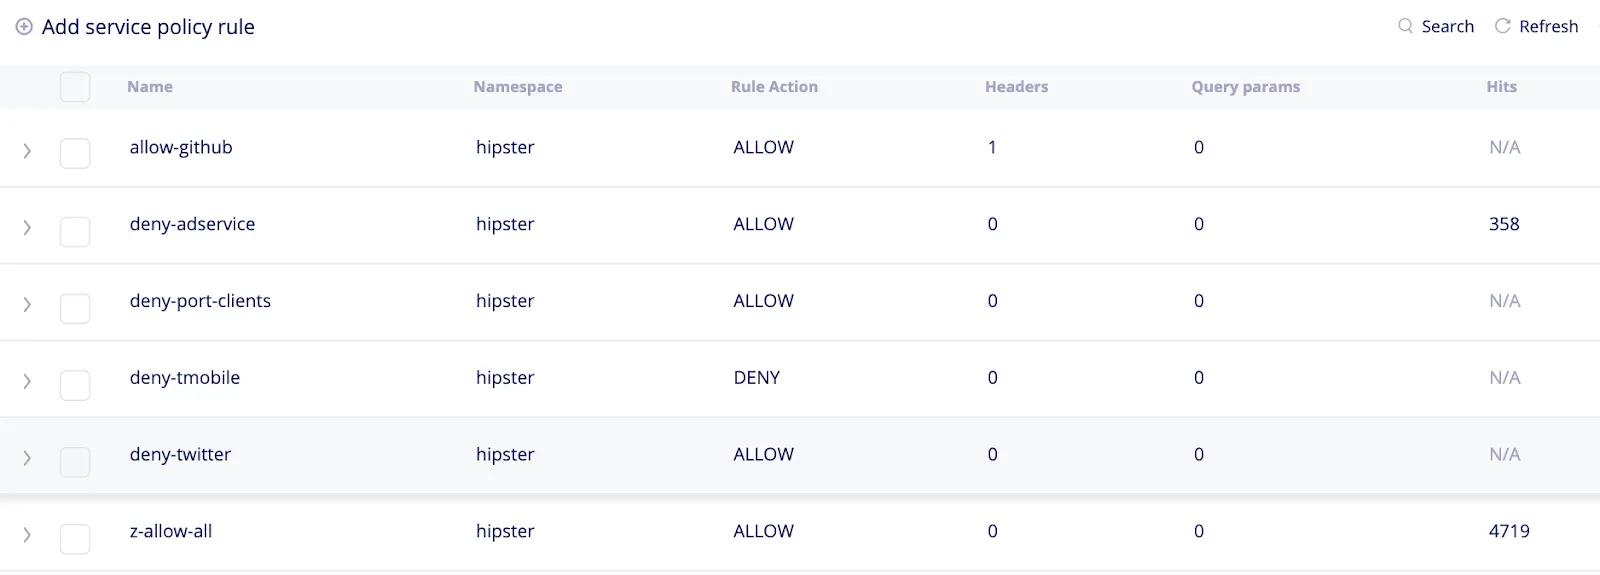
De plus, les utilisateurs peuvent consulter une vue agrégée de l’efficacité de la politique de sécurité et voir les détections sur l’ensemble de leurs sites, comme illustré dans la capture d’écran suivante.
Résumé
Pour en savoir plus sur la manière dont l’approche de Volterra en matière d’exploitation de parcs a permis de gérer un parc de 3 000 clusters, veuillez regarder la présentation de Volterra lors d’une conférence Kubernetes et lire cet article de blog de Jakub Pavlik
Dans le prochain article, intitulé « Time to Effect », j’expliquerai comment le plan de contrôle distribué et le réseau fédérateur de Volterra permettent de propager la configuration et d’en garantir la cohérence sur des sites répartis dans le monde entier, et ce, en très peu de temps. Restez à l’écoute !
À propos de l’auteur
Articles de blog associés

F5 NGINXaaS pour Google Cloud : des applications résilientes et évolutives
Découvrez comment NGINXaaS s’intègre à Google Cloud pour renforcer les performances et la sécurité, et préparer vos applications critiques à un avenir propulsé par l’IA.

L’intégration de F5 Web Application Firewall (WAF) à AWS est disponible dès aujourd’hui
En faisant appel à un partenaire de déploiement AWS WAF tel que F5, vous pouvez renforcer la sécurité de vos applications web grâce à des règles personnalisées qui bloquent les schémas d’attaque courants, comme les injections SQL ou les attaques par scripts intersites (XSS).
Appliquer le principe de Peter Parker à l’inspection TLS
« Un grand pouvoir implique de grandes responsabilités. » Si l’on en trouve des échos chez Voltaire et Churchill, cette citation est surtout connue grâce aux bandes dessinées Spider-Man, où elle est attribuée à l’oncle Ben. Bien entendu, si cette phrase est si répandue dans la culture populaire, c’est notamment parce qu’elle peut s’appliquer à une multitude de situations et de sujets, y compris à l’inspection TLS.
Le NetOps a besoin de défenseurs, pas d’adversaires
Il est important de reconnaître que les équipes NetOps ne sont pas toujours celles qui font obstacle au déploiement de la dernière nouveauté, application ou service. Les freins à la rapidité sont souvent dus au fait que les organisations n’adoptent pas tous les principes du DevOps lorsqu’elles cherchent à transformer leurs opérations informatiques.
Mise à jour des services applicatifs : sécurité, rapidité et visiteurs suspects
Il est de nouveau temps de nous pencher sur les services applicatifs que les entreprises utilisent réellement pour rendre leurs applications plus rapides et plus sûres. On constate notamment une hausse du recours aux services de protection contre les bots, ainsi que la progression lente mais régulière de HTTP/2. Bien qu’il ne s’agisse pas d’une application…
Les templates prennent le contrôle du cloud
Les modèles s’imposent dans le cloud. Lisez le blog de F5 pour découvrir comment l’infrastructure en tant que code et les API déclaratives automatisent la mise à disposition des applications.