Depuis de très nombreuses années, l’un des slogans phares du DevOps et du cloud est « concevoir pour l’échec ». Le principe est que trop d’entreprises subissent des interruptions coûteuses ainsi que des pertes de chiffre d’affaires — et de productivité — en raison de problèmes de performances liés à la capacité. Il faut donc concevoir son application et son infrastructure « pour l’échec », afin d’éviter que de tels événements cauchemardesques ne reviennent vous hanter. Hé hé. Vous avez saisi le jeu de mots ? Oui, je travaille à distance, seul dans mon bureau. Il faut bien que je me distraie parfois.
Trêve de mauvais jeux de mots, le récent succès phénoménal de Pokémon Go (vous en avez bien entendu parler, n’est-ce pas ?) s’est également traduit par une expérience extrêmement frustrante pour beaucoup. En particulier pour les parents d’enfants surexcités qui voulaient partir, TOUT DE SUITE, mais ne le pouvaient pas, car la création de comptes avait été temporairement suspendue, puis strictement limitée en raison d’une demande massive.
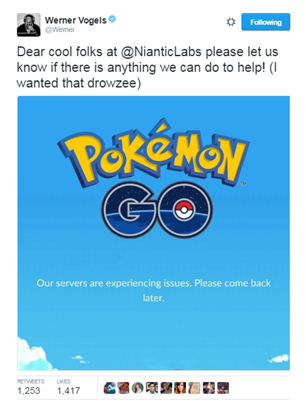
Certains pourraient faire valoir que l’offre du directeur technique d’Amazon, Werner Vogels, visant à aider l’entreprise à résoudre ses problèmes de capacité laisse entendre qu’elle n’avait pas encore « migré vers le cloud » et que c’était là le problème de fond. Mais cela suppose qu’elle ne l’avait pas fait, ce qui, à ce stade, ne me paraît pas tout à fait évident. Plus sérieusement, d’après les mises à jour de Wikipédia consacrées au développeur de réalité augmentée, celui-ci traite « plus de 200 millions d’actions de jeu par jour, tandis que les utilisateurs interagissent avec des objets réels et virtuels dans le monde physique ». Je pense qu’on peut se montrer un peu indulgent avec eux sur ce coup-là — du moins, ceux d’entre nous qui comprennent ce que cela représente en matière d’interactions entre systèmes et de transmission de paquets. Les mises à jour évoquaient des « problèmes de serveur », mais soyons sérieux : nous savons tous que, dans le jargon technique, « serveur » signifie « 15 composants différents répartis entre l’application et l’infrastructure réseau ».
Quoi qu’il en soit, la leçon à retenir ici n’est pas que le cloud est nécessairement plus à même de gérer un succès inattendu. C’est peut-être bien le cas, mais pas simplement parce qu’il s’agit du cloud. C’est parce que le cloud est conçu non seulement pour tolérer les pannes mais aussi pour monter en charge.
Je ne suis pas en mesure de déterminer pourquoi Niantic Labs n’a pas réussi à répondre à la demande. Peut-être était-ce dû à un manque de capacité, auquel cas le cloud aurait été un bon choix ; peut-être aussi que les applications et/ou l’infrastructure n’avaient pas été conçues pour monter en charge, auquel cas le cloud n’aurait peut-être été d’aucune aide. Il ne s’agit vraiment pas de leur lancer une pique (sans mauvais jeu de mots) sur ce qu’ils ont fait ou n’ont pas fait. L’idée est qu’ils illustrent parfaitement une réalité : dans un monde dominé par les applications, les organisations devraient se soucier autant de concevoir leurs systèmes pour résister aux défaillances que pour accompagner le succès. Et pas seulement un succès progressif, mais un succès instantané, du jour au lendemain, à la Pokémon Go.
Car si cela se produit, vous ne voulez pas que cet échec couronné de succès s’affiche partout sur Internet.
Les sources de données constituent une cause fréquente de problèmes d’évolutivité. Les utilisateurs de longue date de Twitter se souviendront qu’à ses débuts, le réseau social était confronté à des problèmes d’évolutivité de ses bases de données. PayPal a été l’un des premiers et des plus fervents défenseurs du partitionnement horizontal comme stratégie de mise à l’échelle pour gérer son immense nombre d’utilisateurs. Cette technique s’est depuis généralisée et s’applique aussi bien aux bases de données qu’aux services de performance et aux applications. L’un des avantages mis en avant par les sources de données NoSQL est leur meilleure évolutivité par rapport aux bases de données relationnelles traditionnelles.
Une autre source de problèmes d’évolutivité relève exclusivement de l’infrastructure. La mise à l’échelle automatique dans le cloud repose non seulement sur la capacité à ajouter automatiquement des ressources de calcul, mais aussi à augmenter la capacité du « point de terminaison de l’application ». Dans toute architecture qui s’appuie sur la mise à l’échelle pour accroître la capacité, cela implique un service d’équilibrage de charge. Lorsque les ressources de calcul sont augmentées, elles doivent être enregistrées auprès du service d’équilibrage de charge. Cela nécessite l’utilisation d’API et de scripts, ainsi que de mécanismes d’automatisation et d’orchestration. Ces composants doivent être en place avant d’être nécessaires, faute de quoi des retards surviendront si la demande exige une augmentation de la capacité.
L’intégration d’un service d’équilibrage de charge dans toute architecture applicative — sans exception — devrait être obligatoire. Un tel service répond non seulement à la nécessité de « concevoir pour résister aux pannes », grâce à sa prise en charge native du basculement entre deux instances d’application, mais aussi à celle de « concevoir pour évoluer », indispensable à la réussite. Mais ne pensez pas qu’il suffit de placer un service d’équilibrage de charge devant une application (ou un microservice, si c’est votre truc). Il est essentiel que les équipes d’exploitation mettent en place l’automatisation (scripts) et l’orchestration (processus) qui permettront à la mise à l’échelle automatique de répondre à la demande lorsqu’elle se présentera. Aujourd’hui, la mise à l’échelle est une question d’architecture, pas d’algorithmes, et il est important de réfléchir à cette architecture en amont, avant que la dette architecturale ne devienne si contraignante que vous soyez obligé de vous contenter de l’existant.
Honnêtement, Niantic Labs a bien conçu son application pour résister aux défaillances. En cas de saturation, des messages sympathiques s’affichaient à la place des pages par défaut indiquant les codes d’état HTTP, que je rencontre souvent. Ils étaient amusants et faciles à lire et à comprendre pour les enfants (je le sais, car mon enfant de 8 ans nous les lisait toutes les 20 minutes). En revanche, l’entreprise n’avait peut-être pas anticipé l’ampleur inattendue de son succès. Cela rappelle à tous qu’il est tout aussi important de concevoir une application capable de monter en charge que de la préparer aux défaillances.
Parce que sinon, la Team Rocket gagne.
À propos de l’auteur

Lori MacVittie est ingénieure émérite et évangéliste en chef au sein du bureau du directeur technique de F5. Elle possède une expertise approfondie dans la fourniture d’applications, les stratégies d’automatisation et les infrastructures. Elle est réputée pour sa capacité à rendre la complexité intelligible, qu’elle définisse des garde-fous pour les agents d’IA, analyse des architectures multicloud fragiles ou explore les limites des systèmes évolutifs. Elle cumule plus de trente ans d’expérience dans le secteur, couvrant le développement d’applications, l’architecture informatique ainsi que l’exploitation des réseaux et des systèmes. Avant de rejoindre F5, elle a été rédactrice spécialisée dans les technologies et a reçu plusieurs distinctions. MacVittie est titulaire d’un master en informatique et est une autrice prolifique dont les publications couvrent la sécurité, le cloud et l’architecture d’entreprise. Elle est également une passionnée de jeux de société et de jeux vidéo, et assume pleinement ses avis bien tranchés sur le fromage.
Autres articles de Lori Mac VittieArticles de blog associés

F5 NGINXaaS pour Google Cloud : des applications résilientes et évolutives
Découvrez comment NGINXaaS s’intègre à Google Cloud pour renforcer les performances et la sécurité, et préparer vos applications critiques à un avenir propulsé par l’IA.

L’intégration de F5 Web Application Firewall (WAF) à AWS est disponible dès aujourd’hui
En faisant appel à un partenaire de déploiement AWS WAF tel que F5, vous pouvez renforcer la sécurité de vos applications web grâce à des règles personnalisées qui bloquent les schémas d’attaque courants, comme les injections SQL ou les attaques par scripts intersites (XSS).
Appliquer le principe de Peter Parker à l’inspection TLS
« Un grand pouvoir implique de grandes responsabilités. » Si l’on en trouve des échos chez Voltaire et Churchill, cette citation est surtout connue grâce aux bandes dessinées Spider-Man, où elle est attribuée à l’oncle Ben. Bien entendu, si cette phrase est si répandue dans la culture populaire, c’est notamment parce qu’elle peut s’appliquer à une multitude de situations et de sujets, y compris à l’inspection TLS.
Le NetOps a besoin de défenseurs, pas d’adversaires
Il est important de reconnaître que les équipes NetOps ne sont pas toujours celles qui font obstacle au déploiement de la dernière nouveauté, application ou service. Les freins à la rapidité sont souvent dus au fait que les organisations n’adoptent pas tous les principes du DevOps lorsqu’elles cherchent à transformer leurs opérations informatiques.
Mise à jour des services applicatifs : sécurité, rapidité et visiteurs suspects
Il est de nouveau temps de nous pencher sur les services applicatifs que les entreprises utilisent réellement pour rendre leurs applications plus rapides et plus sûres. On constate notamment une hausse du recours aux services de protection contre les bots, ainsi que la progression lente mais régulière de HTTP/2. Bien qu’il ne s’agisse pas d’une application…
Les templates prennent le contrôle du cloud
Les modèles s’imposent dans le cloud. Lisez le blog de F5 pour découvrir comment l’infrastructure en tant que code et les API déclaratives automatisent la mise à disposition des applications.