
Voici le troisième article d’une série consacrée aux différents aspects de la création et de l’exploitation de notre service SaaS :
- Plan de contrôle pour une PaaS Kubernetes distribuée
- Maillage de services global pour les applications distribuées
- Sécurité de la plateforme pour les infrastructures, les applications et les données distribuées
- Sécurité des applications et des réseaux des clusters distribués
- Observabilité sur l’ensemble d’une plateforme distribuée à l’échelle mondiale
- Opérations et SRE d’une plateforme distribuée à l’échelle mondiale
- Framework de services Golang pour les microservices distribués
Mon premier article de blog présentait le contexte et les besoins qui nous ont conduits à créer une nouvelle plateforme pour les clouds distribués. Grâce à cette plateforme, nos clients développent un ensemble complexe et varié d’applications, notamment dans les domaines de la fabrication intelligente, de l’analyse vidéo à des fins de sécurité publique, du trading algorithmique et des réseaux 5G des opérateurs télécoms.
Étant donné que bon nombre de ces applications sont critiques, nos clients attendent de nous non seulement une sécurité multicouche, mais aussi la capacité d’apporter des améliorations continues afin de préserver la sécurité de leurs clusters distribués. Cet article de blog abordera les défis liés à la sécurisation de l’infrastructure, des applications et des données sur plusieurs clusters.
En bref (résumé)
- Si l’on sait relativement bien comment fournir aux utilisateurs et aux employés un accès sécurisé aux applications (c’est ce que nous faisons chaque jour lorsque nous accédons à nos comptes bancaires ou à nos e-mails professionnels), il est moins évident d’en faire autant pour les accès d’une application à une autre ou d’une application à des données, car aucune intervention humaine n’entre en jeu dans le processus de vérification.
- La sécurisation des applications et des données dans un environnement hétérogène (périphérie, plusieurs clouds et points de présence réseau) nous a obligés à résoudre un problème à plusieurs niveaux — identité, authentification et autorisation, secrets et gestion des clés
- Bien qu’il existe de nombreuses solutions ponctuelles pour répondre à ces quatre problématiques (par exemple, plusieurs services proposés par différents fournisseurs de cloud, Hashicorp Vault, SPIFFE/Spire, etc.), il n’existe aucune solution intégrée qui fonctionne avec plusieurs fournisseurs de cloud ou qui combine de manière transparente chacun de ces services afin d’en faciliter l’utilisation.
- Compte tenu du manque d’expertise de nos équipes de développement et DevOps quant à la manière d’assembler ces différents éléments, il est devenu essentiel que notre équipe plateforme fournisse ces fonctionnalités sous la forme d’une solution intégrée et facile à utiliser. L’évolution du paysage de la sécurité et l’apparition de nouvelles technologies compliquent encore davantage la tâche de ces équipes, qui ne disposent ni de l’expertise nécessaire ni du temps requis pour suivre tous ces changements.
- Dans le cadre de la mise en place d’une sécurité multicouche pour la plateforme, nous avons développé de nouveaux composants logiciels qui ont permis de résoudre trois problèmes critiques d’une manière totalement inédite : amorcer de façon sécurisée une identité universelle sans tomber dans le problème de la régression à l’infini (« turtles all the way down »), stocker et distribuer des secrets sans jamais avoir à craindre la compromission d’un coffre-fort central (problème de la mine d’or), et gérer les clés de manière distribuée afin de renforcer la sécurité des données au repos.
Contexte du problème de sécurité
Comme indiqué ci-dessus, la problématique de la sécurisation de l’accès des utilisateurs aux applications (par exemple, l’accès à nos comptes bancaires ou à nos e-mails) est bien comprise. Cependant, il n’est pas aussi simple d’en faire autant pour les accès d’une application à une autre ou d’une application à des données, car aucune intervention humaine n’entre en jeu dans le processus de vérification.
Pour qu’une application puisse accéder de manière sécurisée à une autre ressource — par exemple, à des données stockées dans un magasin d’objets, ou effectuer un appel d’API vers une autre application, etc. — les conditions suivantes doivent être remplies :
- Identité — le demandeur doit obtenir de manière sécurisée une identité vérifiable pouvant être utilisée à des fins d’authentification et d’autorisation lors de l’accès aux ressources requises. Le demandeur doit également recevoir de manière sécurisée les ancres de confiance nécessaires permettant de vérifier l’identité de ses pairs.
- Authentification — Lors de l’accès à une ressource donnée, le demandeur et le propriétaire de la ressource doivent vérifier mutuellement et de manière sécurisée leur identité. Le processus consistant à vérifier l’identité déclarée d’un pair par rapport à l’identité présentée est appelé authentification.
- Autorisation — une fois le demandeur authentifié, le processus consistant à vérifier s’il est autorisé ou non à accéder à la ressource est appelé autorisation.
Dans le cadre du processus d’authentification, l’application à l’origine de la requête peut présenter son identité sous la forme d’un certificat PKI, d’un secret (par exemple, un mot de passe) ou d’une clé. L’utilisation de secrets ou d’une clé comme moyen d’identification soulève deux problèmes qui doivent être résolus :
- Les secrets et les clés ne doivent pas être stockés directement dans le code, car cela constitue un vecteur d’attaque facile à exploiter et la fuite de clés peut avoir de graves conséquences.
- Si les secrets sont stockés dans un coffre-fort externe, quelle identité (généralement un autre secret) doit être utilisée pour y accéder, et comment sécuriser cette identité ?
Effectuer ces opérations de sécurité (pour les interactions entre applications) de manière fiable et reproductible est un problème complexe, et ce pour de nombreuses raisons :
- Les applications peuvent être facilement clonées et instanciées (par exemple, sous forme de microservices). Comment attribuer à chaque clone une identité unique, qui peut être nécessaire à des fins d’analyse forensique, d’audit ou d’observabilité ?
- L’identité de l’application varie en fonction de l’environnement dans lequel elle s’exécute. Par exemple, l’application est la même dans les environnements de développement et de production, mais elle doit disposer d’une identité différente dans chacun d’eux.
- Comment s’assurer que l’infrastructure dans laquelle l’application est lancée ne dérobera pas son identité, ses secrets ou ses clés sans que cela soit détecté ?
- Comment protéger le coffre-fort central contre les attaques et sécuriser tous les secrets et toutes les clés qui y sont stockés ?
Par conséquent, sécuriser l’infrastructure, les applications et les données dans un environnement dynamique constitue un défi de taille. Bien que les fournisseurs de services cloud aient relevé ce défi et proposé de nombreux outils pour résoudre ces problèmes, leur intégration et leur maintenance ne sont pas aisées pour les raisons suivantes :
- Complexité — Chaque fournisseur de services cloud exige que le client configure et gère plusieurs services. Par exemple, dans AWS : le service de métadonnées, les rôles IAM, les comptes de service, le RBAC, le KMS et le gestionnaire de secrets. Chacun de ces services diffère considérablement d’un fournisseur de services cloud à l’autre, tant sur le plan de la sémantique que des API et de la supervision.
- Interopérabilité — Même lorsque les services des fournisseurs de cloud sont configurés et opérationnels, aucun d’entre eux ne permet l’interopérabilité. Par exemple, une machine virtuelle exécutée dans GCP ne peut pas accéder à une ressource dans AWS, car l’identité attribuée à l’aide du compte de service GCP n’est pas reconnue par une ressource AWS.
- Environnements hétérogènes — Si l’environnement est réparti entre des clouds publics et privés, plusieurs clouds publics ou, pire encore, en périphérie, la difficulté sera de déterminer comment et où stocker les secrets tels que les mots de passe, les clés, etc. : de manière centralisée ou distribuée.
- Spécifique à l’environnement — La solution de rotation et/ou de révocation des identifiants varie considérablement d’un fournisseur de cloud à l’autre, tandis qu’aucune solution de ce type n’existe pour les clusters en périphérie.
Bien que de nombreuses entreprises ne fassent appel qu’à un seul fournisseur de services cloud et puissent se contenter d’investir des ressources dans la gestion et l’amélioration des mécanismes de sécurité proposés par celui-ci, nous évoluons dans un environnement hétérogène (cloud hybride et edge computing) et avons dû concevoir une nouvelle solution pour résoudre ces problèmes.
Solution pour sécuriser une plateforme distribuée
Notre équipe a été chargée d’assurer la sécurité des applications, de l’infrastructure et des données susceptibles d’être réparties au sein d’une infrastructure distribuée, comme illustré à la figure 1.
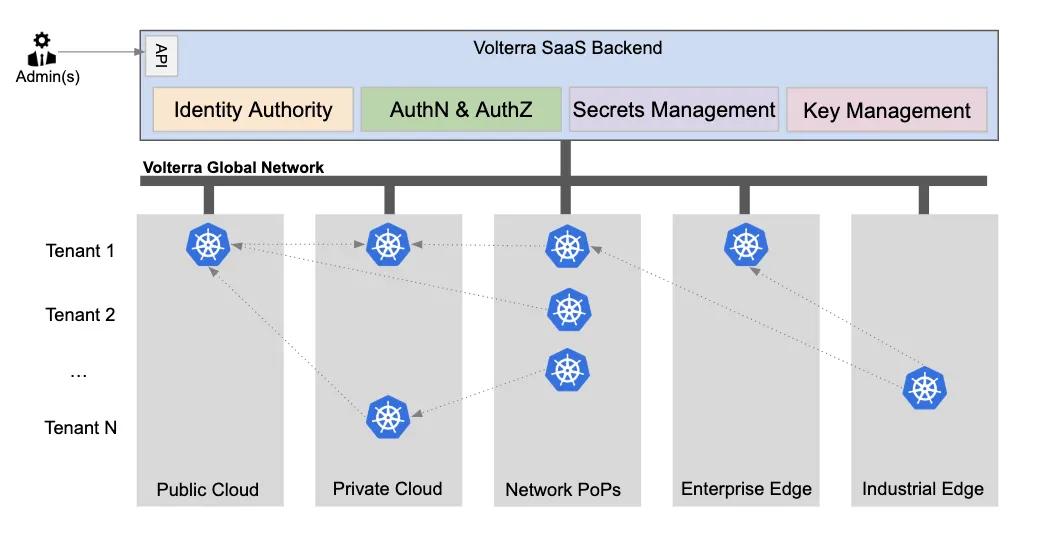
Par conséquent, notre équipe chargée de la plateforme a décidé de développer de nouveaux services logiciels intégrant les quatre aspects suivants afin de garantir la sécurité de la plateforme à la périphérie du réseau, dans n’importe quel cloud et au sein de nos points de présence réseau :
- Gestion des identités — nous expliquerons comment nous fournissons une identité basée sur une PKI, sécurisée par cryptographie et infalsifiable, non seulement aux applications, mais aussi à l’infrastructure distribuée dans un environnement hétérogène (plusieurs clouds, nos PoP mondiaux et des sites périphériques répartis géographiquement) et fonctionnant dans plusieurs environnements (par exemple, poste de développement, tests unitaires, production, etc.)
- Authentification et autorisation — notre infrastructure repose sur des microservices qui utilisent une identité basée sur une infrastructure à clés publiques (PKI) et authentifient mutuellement toutes les communications, quel que soit le protocole utilisé. Nous avons également dissocié l’autorisation de l’authentification afin qu’un moteur d’autorisation commun puisse être utilisé pour différents types de décisions d’autorisation et que la structure des politiques puisse être unifiée.
- Système de gestion des secrets — il existe de nombreux types de secrets (tels que les certificats TLS, les mots de passe, les jetons, etc.) dont nos logiciels et les charges de travail de nos clients ont besoin. La méthode la plus simple aurait pu consister à adopter un coffre-fort centralisé dans lequel tous les secrets seraient stockés, mais cette approche présentait l’inconvénient que toute compromission révélerait l’ensemble des secrets. Nous décrirons une autre approche que nous avons mise en œuvre afin d’atteindre un niveau de sécurité plus élevé, au prix d’une certaine simplicité.
- Système de gestion des clés (KMS) — la sécurité des données est essentielle pour notre système distribué, et l’équipe a dû mettre en place un KMS fonctionnant de manière transparente avec différents fournisseurs de services cloud. Le KMS doit gérer, versionner et renouveler les clés utilisées pour le chiffrement et le déchiffrement symétriques des données au repos, pour le calcul du HMAC des jetons CSRF et pour la signature numérique des fichiers binaires. Nous expliquerons comment nous prenons en charge à la fois les opérations sensibles en matière de sécurité à l’aide de ce KMS et les opérations sensibles à la latence à l’aide du système de gestion des secrets.
Identité infalsifiable pour l’infrastructure et les applications
L’identité est une question fondamentale, car de nombreux défis de sécurité peuvent être relevés plus facilement une fois le problème de l’identité résolu. Toutefois, pour résoudre cette question, nous devons définir ce que nous entendons par identité et déterminer comment en attribuer une de manière fiable. Les passionnés de cryptographie aiment apporter leur propre vision à tous les sujets, et la définition de l’identité ne fait pas exception :
L’ensemble unique et complet des caractéristiques infalsifiables et vérifiables cryptographiquement certifiées cryptographiquement par une autorité de confiance au moyen d’un protocole sécurisé et sans délégation, qui constituent ce qu’une personne ou une chose est réputée ou considérée être.
En substance, il faut une identité infalsifiable et vérifiable cryptographiquement, transmise de manière sécurisée. La délivrance d’une telle identité présente deux difficultés : 1) l’amorçage de l’identité et 2) la racine de confiance
Quelques approches sont souvent évoquées en matière d’identité, notamment SPIFFE et Hashicorp Vault. Précisons que SPIFFE est un schéma de nommage qui pourrait être utilisé dans notre système comme document d’identité (certificat X.509). Toutefois, ce format ne convient pas à certains attributs d’identité contenant des données binaires. Bien que Vault puisse être utilisé pour émettre un document d’identité, il ne résout pas les difficultés liées à l’amorçage de l’identité et au problème de la racine de confiance :
- Amorçage de l’identité — dans la vie réelle, lorsqu’une personne naît, son identité est établie par son acte de naissance. Celui-ci permet logiquement d’amorcer l’identité de la personne et, à partir de ce document, elle peut obtenir ou demander d’autres documents d’identité, tels qu’un passeport, un permis de conduire, etc. De même, dans le monde informatique, chaque lancement d’une application (ou d’un microservice) nécessite l’amorçage d’une identité. L’établissement de l’identité est l’une des premières étapes que tout code en cours d’exécution doit accomplir afin de pouvoir interagir avec d’autres services. En outre, puisqu’un même code d’application peut être lancé plusieurs fois et dans différents environnements (ordinateur portable du développeur, test unitaire ou production), chacun de ces lancements doit également établir une identité d’amorçage distincte.
- Racine de confiance — bien que l’émission d’une identité d’amorçage puisse sembler être un processus simple, la question est de savoir qui est habilité à fournir cette identité. Par exemple, dans le monde réel, l’établissement de l’identité commence lorsque l’hôpital atteste qu’un enfant est né à une date et une heure données d’une personne donnée, en partant du principe que l’hôpital établit l’acte de naissance après avoir effectué les vérifications appropriées et que celui-ci ne peut pas être falsifié. Par conséquent, l’acte de naissance peut servir de source de vérité (ou de racine de confiance). De même, lorsqu’une application est lancée par une personne ou par un code automatisé, il doit exister une racine de confiance capable d’attester de manière vérifiable l’identité de l’application lancée. Cette attestation peut ensuite servir à générer un document d’identité ultérieur pour l’application.
Par exemple, lorsqu’une machine virtuelle est lancée dans AWS, une identité d’amorçage lui est attribuée et le service de métadonnées d’AWS fait office de racine de confiance. Le document d’identité (signé par AWS à l’aide de sa propre clé cryptographique) ressemble à ceci :
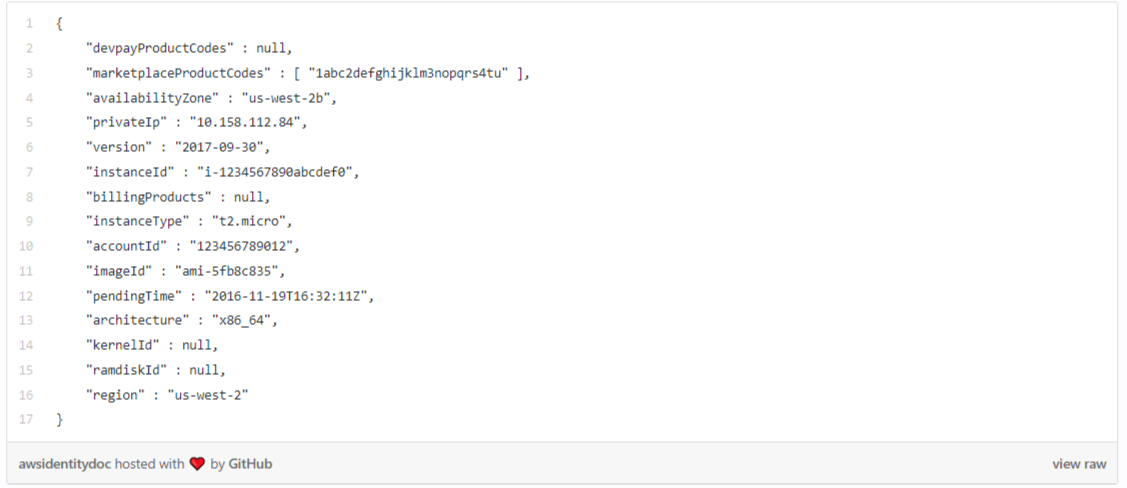
Bien que l’instanceId puisse désigner l’identité unique de l’instance d’application qui a été lancée, il doit être associé à un nom connu (myserver.acmecorp.com) que les autres applications utiliseront pour communiquer avec cette instance particulière. Par conséquent, même ce document d’identité d’amorçage AWS ne suffit pas, mais il peut servir à émettre une autre identité que les applications pourront utiliser pour communiquer entre elles.
Comme indiqué précédemment, il était essentiel pour nous de fournir une identité permettant aux applications de communiquer et de partager des informations entre différents fournisseurs de services cloud et/ou sites en périphérie (figure 2). Nous avons donc dû concevoir un système d’amorçage de l’identité et de racine de confiance fonctionnant dans tous ces environnements.
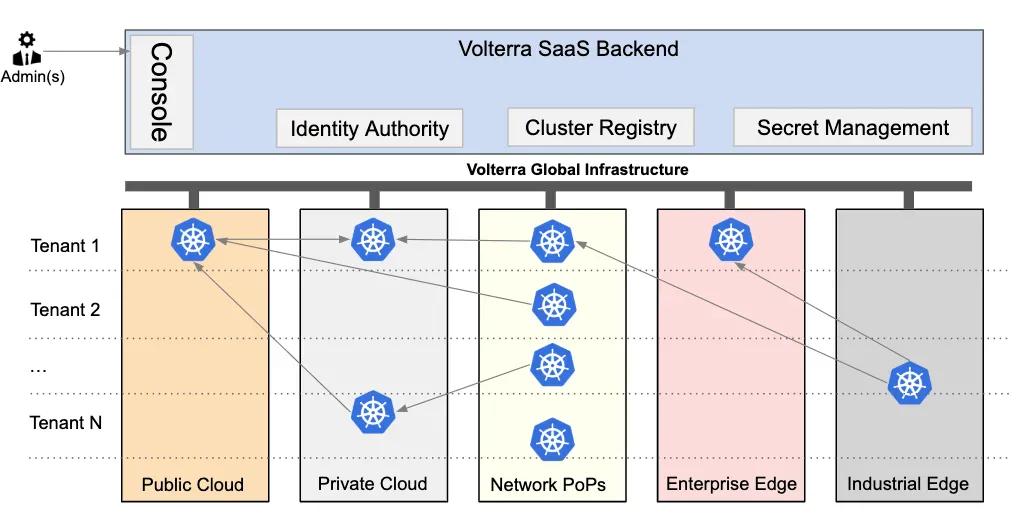
Puisque nous utilisons Kubernetes pour gérer et orchestrer les applications (aussi bien les microservices que les machines virtuelles), l’amorçage d’une identité unique pour chaque pod lancé devait être intégré au processus de création des pods de Kubernetes. La figure 3 montre comment nous nous intégrons au processus de création des pods à l’aide du mécanisme de webhook de K8s. Ce webhook, appelé Voucher, injecte un side-car de sécurité nommé Wingman dans tous les pods créés dans le cluster et fournit également les informations nécessaires, signées cryptographiquement, qui peuvent servir de racine de confiance. Ce webhook fournit un jeton signé à courte durée de vie, que Wingman utilise pour demander un certificat X.509 à l’autorité d’identité dans le backend SaaS de Volterra.
L’autorité d’identité applique les règles de création des identités de manière à minimiser le « rayon d’impact » en cas de compromission de l’un des clusters K8s. De nombreuses autres solutions reposant sur une autorité de certification racine commune ou sur une fédération de clusters K8s ne permettent pas de limiter ce rayon d’impact, ce qui a fortement influencé notre choix de conception.
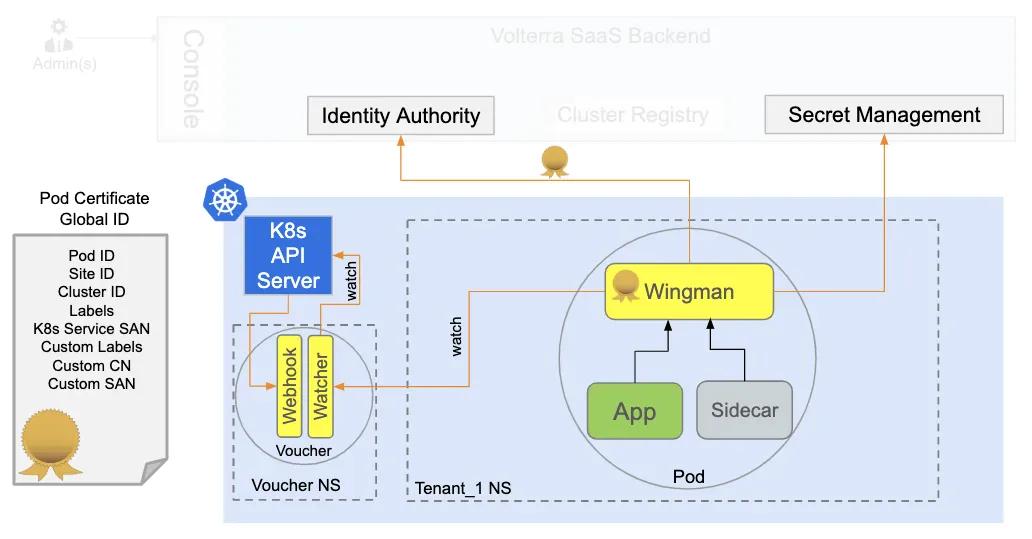
Pour un Pod donné dans K8s, les attributs peuvent changer après sa création. Par exemple, un Pod peut être rattaché à un nouveau service après sa création. Les certificats d’identité devaient donc être mis à jour pour intégrer ce nouveau service. Wingman surveille en permanence le Voucher qui suit le serveur d’API K8s afin de détecter ce type de mise à jour.
Ce mécanisme attribue une identité globale unique et universelle à chaque instance d’application exécutée sur notre plateforme, qu’il s’agisse de nos propres charges de travail ou de celles de nos clients. Cette identité unique et le side-car (Wingman) sont ensuite utilisés pour sécuriser l’ensemble des communications, des accès et des clés/secrets au sein d’un système distribué.
Authentification et autorisation
Disposer d’une identité unique par Pod constitue un excellent point de départ, car cela facilite la mise en œuvre d’une authentification mutuelle entre les services qui communiquent. Notre infrastructure sous-jacente se compose de nombreux services différents qui utilisent divers protocoles, tels que gRPC, REST, IPSec, BGP, etc. Dès le début, l’équipe s’est fixé pour objectif d’assurer l’authentification mutuelle et la sécurité des communications (canal chiffré) entre toutes les parties, quel que soit le protocole utilisé. Cela signifiait également que nous ne pouvions pas lier notre identité à une solution (par exemple, Istio) limitée à un ensemble particulier de protocoles (par exemple, HTTP/TCP plutôt que les protocoles basés sur IP).
Comme notre plateforme permet également aux clients d’exécuter les charges de travail de leur choix, nous nous attendons à ce que celles-ci puissent utiliser divers protocoles. La plateforme ne doit donc pas restreindre leurs possibilités en leur fournissant une identité limitée à un ensemble particulier de protocoles. L’authentification est au contraire dissociée de l’identité (via Wingman), ce qui permet l’intégration de différentes technologies de maillage de services. Le side-car/plan de données de notre maillage de services (présenté dans un précédent article de blog) utilise cette identité pour fournir le protocole mTLS aux charges de travail des clients.
Étant donné qu’un grand nombre de nos propres services d’infrastructure ont été développés à l’aide du Volterra Golang Service Framework (qui fera l’objet d’un prochain article de blog), nous avons décidé d’intégrer directement au framework la logique permettant d’exploiter l’identité (fournie par Wingman). Nos développeurs ont ainsi pu sécuriser nativement les communications entre leurs services, sans dépendre d’un side-car de maillage de services pour le mTLS.
L’étape logique suivante, après l’établissement d’un canal sécurisé avec authentification mutuelle, est l’autorisation — un processus qui permet au destinataire de la requête (le serveur) de déterminer s’il doit accepter ou non la requête provenant de l’appelant identifié (le client). Les motifs de refus peuvent être nombreux — limites de quota, autorisations, etc. Comme ces motifs et leurs seuils évoluent de manière dynamique, il était exclu d’utiliser un ensemble de règles (une politique) d’autorisation codées en dur sur notre plateforme.
Nous avons décidé de partir du moteur d’Open Policy Agent et avons développé une couche d’abstraction pour l’autorisation au sein du side-car Wingman. Le code de cette couche récupère dynamiquement les politiques pertinentes et les maintient en mémoire pour permettre une évaluation rapide. Comme pour l’authentification, le découplage du moteur d’autorisation de l’identité (et de l’authentification) nous a permis d’appliquer des politiques d’autorisation à plusieurs étapes du traitement des requêtes, y compris au cœur de la logique métier, et pas seulement juste après l’authentification.
Comme Wingman est intégré à toutes les charges de travail, y compris celles des clients, notre plateforme fournit nativement un moteur d’autorisation. Bien qu’Open Policy Agent (OPA) repose sur un langage puissant appelé Rego, nous souhaitions en masquer la complexité à nos développeurs et à nos clients. Toutes les politiques de notre plateforme peuvent également être définies à l’aide d’une structure beaucoup plus intuitive et facile à comprendre, qui évite aux utilisateurs (DevOps) d’avoir à apprendre Rego et réduit ainsi le risque d’erreurs. Comme pour la configuration de l’authentification, notre framework de services Golang a été connecté au moteur d’autorisation de Wingman afin d’appeler automatiquement Wingman pour les demandes d’autorisation et d’en masquer la complexité aux développeurs.
Grâce à une identité unique (émise par Wingman) pour l’authentification et à un moteur de politiques programmable (intégré à Wingman) pour l’autorisation, nous pouvons sécuriser les communications à l’aide du mTLS et contrôler chaque accès au moyen d’une politique robuste et programmable.
Gestion des secrets sans coffre-fort centralisé
Chaque jour, des ingénieurs commettent par inadvertance des erreurs en stockant des clés et des mots de passe dans leur code, qui finissent d’une manière ou d’une autre dans des dépôts publics de code ou d’artefacts. La gestion des secrets est complexe et, en l’absence d’outils faciles à utiliser et d’un processus bien défini, les développeurs ont tendance à choisir la voie la plus simple. C’est pourquoi, dès la création de l’entreprise, notre équipe chargée de la sécurité de la plateforme (à distinguer de la sécurité du réseau et des applications) s’est donné pour mission de faire en sorte que les développeurs n’aient pas à se poser des questions telles que : « Où dois-je stocker les secrets — dans le code source, dans les artefacts ou ailleurs… ? »
Lorsque nous avons commencé à développer notre plateforme, nous avons évalué deux approches courantes qui s’offraient à nous pour la gestion des secrets, mais toutes deux présentaient certaines lacunes :
- Secrets Kubernetes — Bien que nous utilisions Kubernetes et que celui-ci intègre sa propre solution de gestion des secrets, elle n’est pas particulièrement utile pour plusieurs raisons : les secrets ne sont pas chiffrés au repos, les mécanismes de définition des politiques ne sont pas exhaustifs et cette solution ne prend pas en charge les environnements multiclusters.
- Coffre-fort centralisé (par exemple, Hashicorp Vault ou Cyberark Vault) — Une autre approche aurait pu consister à utiliser un coffre-fort dans lequel les secrets sont stockés de manière centralisée et transmis aux demandeurs autorisés. Les secrets sont protégés par une clé de chiffrement unique utilisée pour le stockage chiffré du coffre-fort. Toutefois, cette approche présente un problème : le système de gestion des secrets a accès aux secrets en clair (même s’ils sont stockés sous forme chiffrée), et toute compromission du système pourrait révéler l’ensemble des secrets.
Dans notre cas, en tant que service SaaS, nous avons dû mettre au point une méthode plus robuste pour sécuriser les secrets de nos clients, afin qu’aucune compromission ne puisse les révéler.
Nous avons donc décidé de mettre en œuvre une nouvelle technique, baptisée Volterra Blindfold (marque déposée), qui fonctionne conjointement avec notre side-car de sécurité, Wingman, comme illustré à la figure 4. Cette approche permet au propriétaire du secret de le verrouiller (le chiffrer) de telle sorte qu’il ne soit jamais révélé en clair à une partie non autorisée (y compris au serveur de déchiffrement). Le secret n’est même pas stocké sur un serveur central de déchiffrement et cette architecture simplifie considérablement, à certains égards, la conception du serveur.
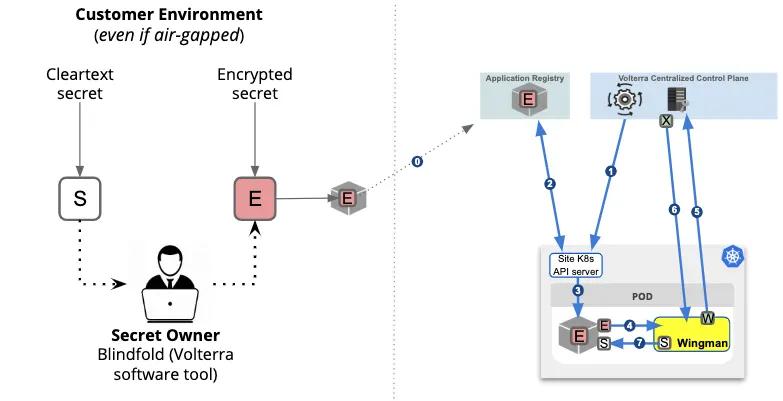
Nous mettons à la disposition des utilisateurs un outil Blindfold qui peut être utilisé dans un environnement entièrement hors ligne afin de chiffrer le secret (S), lequel peut ensuite être distribué. Par exemple, le secret peut être stocké avec la charge de travail et chargé dans le registre. Une fois cette opération effectuée, les étapes suivantes doivent avoir lieu :
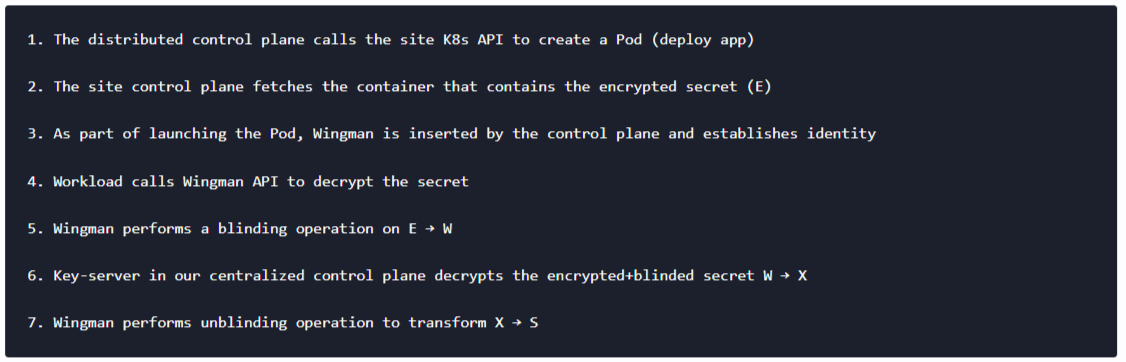
Cela garantit que le plan de contrôle centralisé n’accède jamais au secret en clair (S) et que celui-ci n’est disponible dans la mémoire d’exécution du Pod que pendant la durée de l’accès. En outre, une politique d’accès peut être appliquée afin de définir qui peut accéder à un secret. Cette politique peut reposer sur des attributs d’identité tels que le nom de l’application, l’emplacement, le niveau de conformité, etc. Il est ainsi possible d’isoler n’importe quel sous-ensemble complexe de charges de travail et de mettre en place un contrôle d’accès précis. La politique est intégrée de manière cryptographique aux processus de chiffrement, d’aveuglement, de déchiffrement et de désaveuglement — il est irréalisable sur le plan informatique de contourner l’objectif de la politique.
Grâce à notre technique unique Blindfold, qui verrouille chaque secret, et à Wingman, qui le déverrouille en fonction de règles et d’une identité infalsifiable, nous pouvons surmonter les problèmes posés par les solutions existantes et assurer la gestion des secrets dans un environnement distribué, sans jamais avoir à craindre que le référentiel central ne soit compromis.
Gestion des clés pour les systèmes distribués
Bien que la gestion des secrets et celle des clés puissent sembler être deux appellations différentes d’un même problème, il existe entre elles des différences subtiles — mais importantes en pratique — qui varient selon les interlocuteurs et la manière dont on souhaite mettre en œuvre les solutions.
Un secret désigne toute information qui doit rester confidentielle et ne pas être accessible à des parties non autorisées. D’une certaine manière, les clés cryptographiques constituent un cas particulier de secrets. La gestion des clés, quant à elle, désigne généralement un système qui stocke de manière sécurisée le matériel cryptographique sensible et en contrôle l’utilisation. Dans certains cas, le système de gestion des clés peut fournir les octets bruts de la clé aux parties autorisées et peut donc être confondu avec un système de gestion des secrets. Toutefois, dans la plupart des cas, le système de gestion des clés ne fournit pas les octets bruts du matériel cryptographique : il effectue plutôt des opérations pour le compte des demandeurs autorisés et ne leur transmet que le résultat de ces opérations. De nombreux systèmes de gestion des clés s’appuient également sur un dispositif matériel de stockage (par exemple, un HSM) pour conserver le matériel cryptographique, de sorte que la clé n’est jamais exposée en clair au logiciel.
Dans les environnements distribués, même avec un seul fournisseur de services cloud, la gestion, la synchronisation et la rotation des clés cryptographiques sont très complexes, et les solutions actuelles sont sujettes aux erreurs, inefficaces, voire peu sûres. Par exemple, si une organisation utilise aujourd’hui trois régions AWS et souhaite employer la même clé cryptographique dans chacune d’elles, elle doit synchroniser et renouveler les clés manuellement. Le problème s’aggrave encore lorsque l’environnement s’étend à plusieurs fournisseurs de services cloud, publics et/ou privés. Et même une fois toutes ces opérations effectuées, les responsables des applications doivent encore écrire du code complexe pour exploiter ces fonctionnalités KMS.
Notre plateforme masque à l’application toute la complexité de la gestion des clés en confiant l’ensemble des tâches lourdes au side-car Wingman et en fournissant à l’application une ou plusieurs interfaces simples pour effectuer des opérations de gestion des clés, notamment le chiffrement, le déchiffrement, la génération et la vérification de HMAC, la signature numérique, la vérification de signature, la récupération de clés (lorsqu’elle est autorisée), etc. La gestion des clés devient ainsi très simple, tant pour nos propres services d’infrastructure que pour les charges de travail de nos clients.
Le schéma suivant (Figure 5) montre comment le KMS de Volterra fonctionne dans différents environnements et permet aux charges de travail de déléguer leurs opérations de gestion des clés et de cryptographie au side-car Wingman. Selon la configuration, Wingman peut mettre les clés en cache et actualiser ce cache à l’insu de l’application. L’élément déterminant est ici l’identité universelle et infalsifiable que nous avons présentée précédemment. Étant donné que chaque Pod, quel que soit son emplacement, reçoit une identité unique à l’échelle mondiale, le système KMS de Volterra peut appliquer avec une grande précision des politiques d’accès aux clés cryptographiques et à des opérations spécifiques telles que le chiffrement, le déchiffrement, le calcul et la vérification de HMAC, ainsi que la signature numérique et sa vérification.
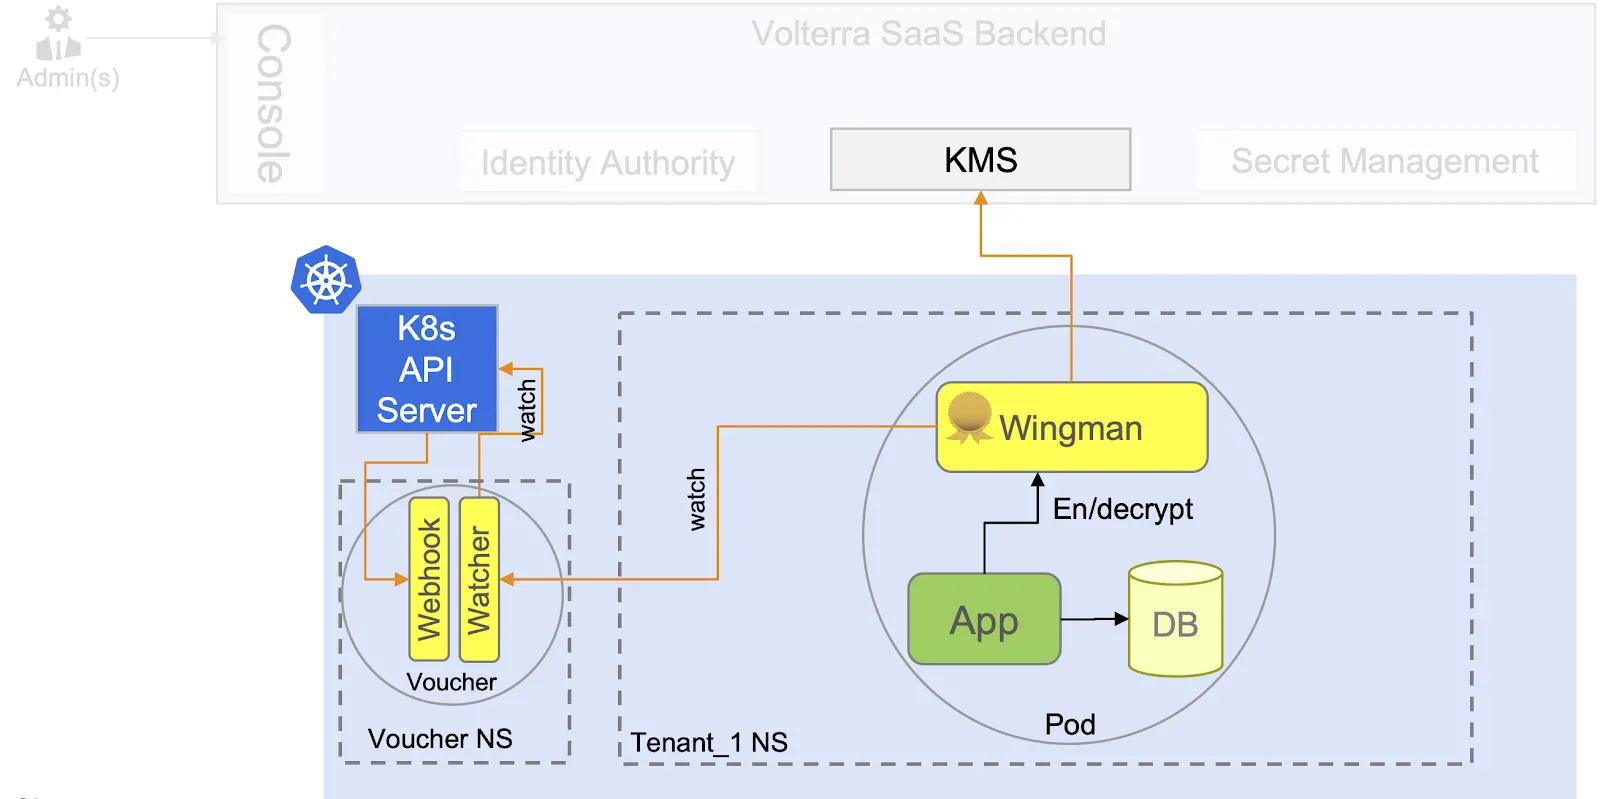
Comme toutes les clés sont gérées via le backend SaaS de Volterra, les charges de travail exécutées dans des environnements hétérogènes n’ont pas à se soucier de la synchronisation, de la rotation ou de la révocation des clés, entre autres : il leur suffit de connaître les API simples de Wingman pour répondre à tous leurs besoins de sécurisation des données au repos.
Avantages offerts par notre solution de sécurité de plateforme
Grâce à une sécurité de plateforme multicouche, nous avons pu apporter une solution complète à trois problèmes critiques d’une manière totalement inédite ! Notre système est capable d’amorcer de manière sécurisée une identité universelle qui ne souffre pas du problème des « tortues jusqu’en bas », de gérer des secrets pouvant être stockés et distribués sans jamais avoir à se soucier du problème de la mine d’or, et d’assurer la gestion des clés afin de faciliter la sécurisation des données au repos dans un environnement distribué. Cela a permis à nos équipes internes comme à nos clients de bénéficier des avantages suivants :
- Sécurité et conformité — une identité universelle infalsifiable, Blindfold et un side-car de sécurité (Wingman), entièrement intégré et géré automatiquement par la plateforme afin de sécuriser toutes les communications, d’autoriser chaque accès et de gérer les clés et les secrets dans l’ensemble d’un système distribué. Grâce à ces avancées, nous sommes en mesure de proposer une solution de sécurité plus robuste, qui nous permet, ainsi qu’à nos clients, de satisfaire plus facilement aux exigences de conformité.
- Amélioration de la productivité — grâce à une solution de sécurité intégrée à notre processus DevOps et à notre framework de services, les développeurs et les équipes DevOps peuvent facilement se concentrer sur leurs livrables sans avoir à se soucier des aspects essentiels de la sécurité des applications et des données.
- Évolution continue — l’évolution du paysage de la sécurité et l’émergence de nouvelles technologies entraînent une évolution continue de Blindfold, de Wingman et de notre framework de services Golang. Ainsi, la plateforme déploie automatiquement de nouvelles fonctionnalités sans qu’aucune modification de la logique applicative ne soit nécessaire.
À suivre…
Cette série d’articles abordera les différents aspects de la conception et de l’exploitation de notre service SaaS distribué à l’échelle mondiale, qui s’appuie sur de nombreux clusters d’applications dans le cloud public, ainsi que sur nos points de présence (PoP) de réseau privé et nos sites périphériques. Le prochain article sera consacré à la sécurité des applications et du réseau…
Nous recherchons quelques développeurs et architectes de solutions bénévoles pour nous aider à mettre cette fonctionnalité à la disposition d’une communauté plus large sous la forme d’un projet open source. Si vous souhaitez participer à cette aventure passionnante, contactez-nous directement à l’adresse asingla@volterra.io !
À propos de l’auteur
Articles de blog associés

F5 NGINXaaS pour Google Cloud : des applications résilientes et évolutives
Découvrez comment NGINXaaS s’intègre à Google Cloud pour renforcer les performances et la sécurité, et préparer vos applications critiques à un avenir propulsé par l’IA.

L’intégration de F5 Web Application Firewall (WAF) à AWS est disponible dès aujourd’hui
En faisant appel à un partenaire de déploiement AWS WAF tel que F5, vous pouvez renforcer la sécurité de vos applications web grâce à des règles personnalisées qui bloquent les schémas d’attaque courants, comme les injections SQL ou les attaques par scripts intersites (XSS).
Appliquer le principe de Peter Parker à l’inspection TLS
« Un grand pouvoir implique de grandes responsabilités. » Si l’on en trouve des échos chez Voltaire et Churchill, cette citation est surtout connue grâce aux bandes dessinées Spider-Man, où elle est attribuée à l’oncle Ben. Bien entendu, si cette phrase est si répandue dans la culture populaire, c’est notamment parce qu’elle peut s’appliquer à une multitude de situations et de sujets, y compris à l’inspection TLS.
Le NetOps a besoin de défenseurs, pas d’adversaires
Il est important de reconnaître que les équipes NetOps ne sont pas toujours celles qui font obstacle au déploiement de la dernière nouveauté, application ou service. Les freins à la rapidité sont souvent dus au fait que les organisations n’adoptent pas tous les principes du DevOps lorsqu’elles cherchent à transformer leurs opérations informatiques.
Mise à jour des services applicatifs : sécurité, rapidité et visiteurs suspects
Il est de nouveau temps de nous pencher sur les services applicatifs que les entreprises utilisent réellement pour rendre leurs applications plus rapides et plus sûres. On constate notamment une hausse du recours aux services de protection contre les bots, ainsi que la progression lente mais régulière de HTTP/2. Bien qu’il ne s’agisse pas d’une application…
Les templates prennent le contrôle du cloud
Les modèles s’imposent dans le cloud. Lisez le blog de F5 pour découvrir comment l’infrastructure en tant que code et les API déclaratives automatisent la mise à disposition des applications.