L’impact le plus important sur les opérations dû à la migration soudaine des consommateurs et des employés vers des expériences numériques est peut-être la disponibilité. Il est certain qu’un pourcentage significatif d’organisations ont rencontré des difficultés avec l’accès à distance lorsque les employés ont quitté le bureau pour travailler depuis leur domicile. Mais seule une partie d’entre eux s’est retrouvée en télétravail, tandis que des populations entières sont soudainement devenues dépendantes des équivalents numériques de la vie quotidienne.
Prenons les conclusions de Nokia, qui indique que « le trafic montant (sur certains réseaux aux États-Unis) au cours du mois de mars 2020 » a connu « une hausse de 30 % par rapport aux niveaux antérieurs à la pandémie ». Ou encore ces données qui montrent une hausse de 72 % des transactions (et de 29 % des pages vues) au cours de la deuxième semaine d’avril.
La demande d’expériences numériques est en hausse. Et pour un utilisateur, il n’y a rien de plus frustrant, ou presque, qu’une application ou un site web qui ne se charge pas. À vrai dire, il n’y a rien de plus frustrant, ou presque, pour un opérateur qu’une application ou un site web qui ne se charge pas.
Atteindre une haute disponibilité ne consiste pas simplement à insérer un répartiteur de charge dans le chemin des données. Cela fait partie de l’équation, mais ce n’est que l’une des étapes nécessaires pour garantir qu’une application ou un site web reste disponible.
La première chose à faire est de répondre à deux questions qui ne sont pas si simples :
- Comment répartir le trafic entre les serveurs afin d’assurer une haute disponibilité ?
- Quel niveau de contrôle d’intégrité est nécessaire pour valider correctement la disponibilité d’un serveur ?
À première vue, ces questions semblent plus simples qu’elles ne le sont en réalité. En effet, pour y répondre, il faut très bien connaître l’application et son infrastructure.
Commençons, voulez-vous ?
Comment répartir le trafic entre les serveurs pour assurer une haute disponibilité ?
Cette question vise en réalité à déterminer quel algorithme d’équilibrage de charge utiliser, puisque ce sont les algorithmes qui définissent la manière dont le trafic (les requêtes) est réparti entre les ressources (les serveurs). La réponse dépend de nombreux facteurs, à commencer par l’architecture de l’application et ses modes d’utilisation.
En effet, si vous cherchez à assurer la haute disponibilité d’une application traditionnelle (monolithique, client-serveur ou web à trois niveaux), vous devez envisager les habitudes d’utilisation sous un angle totalement différent.
Cela s’explique par le fait qu’un seul « serveur » back-end est chargé d’exécuter toute la logique métier. Vous essayez de vous connecter ? De commander un produit ? De parcourir le catalogue ? Tout passe par le même « serveur ». Vous pourriez alors penser qu’il suffit d’utiliser un algorithme simple, comme le round-robin, pour répartir le trafic. Que nenni, mon ami. Chaque fonction métier a des besoins différents en matière de puissance de calcul, de mémoire, de réseau et de données. Chacune impose donc une charge différente au « serveur ». Une seule instance de « serveur » peut rapidement être saturée si on lui adresse trop de requêtes gourmandes en ressources.
La meilleure façon d’optimiser la répartition des requêtes afin de garantir la disponibilité des applications traditionnelles consiste à utiliser un algorithme basé sur le plus petit nombre de connexions. La charge est ainsi répartie entre les différentes instances de « serveurs » en fonction du nombre de connexions actuellement ouvertes. Cette méthode fonctionne parce que les requêtes gourmandes en ressources prennent plus de temps à traiter et maintiennent donc les connexions actives. En dirigeant les requêtes vers les « serveurs » ayant le moins de connexions, vous augmentez les chances qu’ils restent tous disponibles.
Pour les applications modernes (basées sur des microservices), la réponse à cette question est plus simple. En effet, une application moderne est déjà décomposée en fonctions métier qui peuvent évoluer indépendamment. Il reste judicieux d’utiliser un algorithme basé sur le plus petit nombre de connexions, car certaines requêtes portant sur une même fonction peuvent consommer davantage de ressources que d’autres. Toutefois, le trafic est naturellement équilibré dans une architecture d’application moderne, si bien que pratiquement n’importe quel algorithme permettra de maintenir tous les « serveurs » disponibles.
Ce qui est intéressant (à mes yeux, en tout cas) avec la disponibilité, c’est que savoir comment répartir les requêtes ne représente que la moitié du travail. L’autre moitié ne repose malheureusement pas sur des lasers rouges et bleus, mais sur la visibilité de l’état de santé de l’application.
Quel niveau de contrôle de l’état de santé est nécessaire pour valider correctement la disponibilité d’un serveur ?
C’est ici que devrait figurer ma dissertation sur l’observabilité*, mais, par souci de concision et pour préserver votre santé mentale, je vais simplement la résumer ainsi :
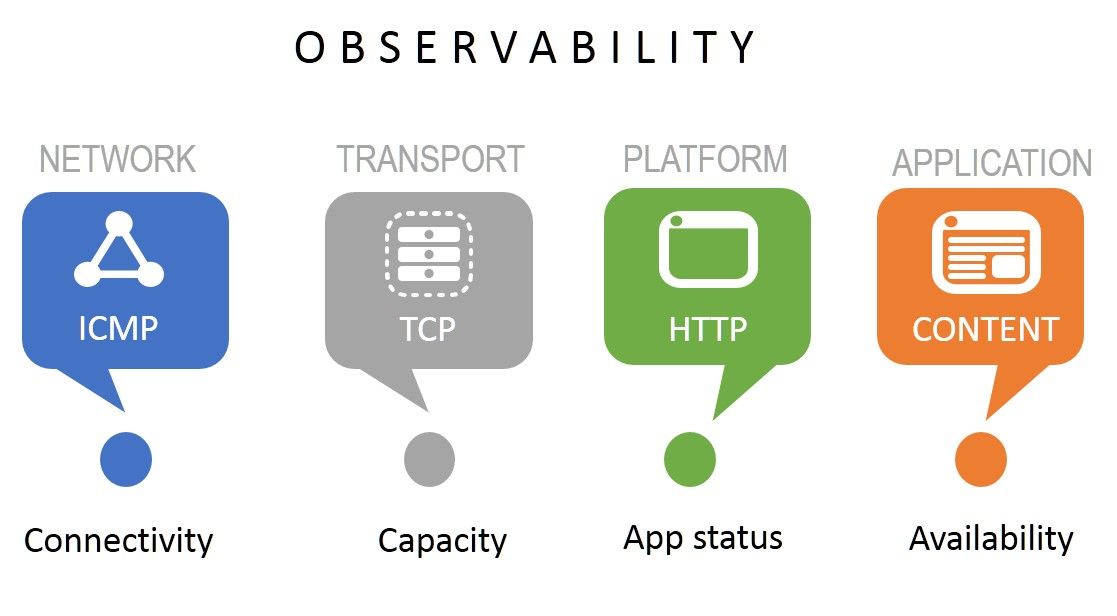
Si vous utilisez autre chose que la « disponibilité de l’application » pour déterminer l’état d’une application, vous compromettez la haute disponibilité. En effet, aucune des autres mesures observables ne vous renseigne sur l’application elle-même. La disponibilité du réseau, du transport et de la plateforme est certes nécessaire, mais tant que vous n’avez pas la certitude que l’application est prête à recevoir des requêtes, lui envoyer du trafic risque de vous attirer des ennuis.
Les quatre composantes de l’observabilité sont importantes. Après tout, si vous perdez la connectivité réseau, le reste n’a plus vraiment d’importance. Vous devez donc surveiller ces quatre indicateurs, ce qui implique de tous les vérifier. L’architecture de l’application n’y change rien. Toutes les applications dépendent des couches réseau, transport et plateforme. C’est au niveau de la couche applicative que l’architecture entre en jeu, car elle peut limiter les moyens permettant de déterminer si l’application fonctionne ou non.
Lors du développement, vous devez toujours demander qu’un moyen de « vérifier l’état de santé » de l’application soit prévu. Qu’elle s’effectue via une API ou une requête HTTP, une « vérification de l’état de santé » dédiée permet aux développeurs et aux équipes d’exploitation de s’assurer facilement que l’application fonctionne correctement. Elle peut notamment vérifier la connectivité aux ressources externes, telles que les sources de données ou les API de partenaires. Comme la défaillance de l’un de ces composants peut donner à l’utilisateur l’impression que l’application est indisponible ou ne répond pas, il est important de vérifier la disponibilité de tous les composants requis.
La haute disponibilité est plus difficile à assurer qu’il n’y paraît
La documentation marketing laisse souvent entendre que la haute disponibilité consiste simplement à cloner un serveur et à placer un répartiteur de charge devant celui-ci. Mais en réalité, garantir la haute disponibilité d’une application exige une réflexion approfondie, des mesures et une préparation rigoureuse. Il ne suffit pas de s’assurer que les instances sont disponibles : il faut également veiller à ce que toutes les applications dont elles dépendent le soient et répartir les requêtes de manière à ne surcharger aucune instance.
L’avantage de tous les efforts supplémentaires que vous consacrez à garantir la haute disponibilité des applications est d’offrir une expérience client positive et de réduire le nombre d’appels affolés tard dans la nuit signalant que des applications sont indisponibles.
* En réalité, je n’ai pas de thèse sur l’observabilité. Mais si j’en avais une, c’est ici qu’elle aurait été insérée.
À propos de l’auteur

Lori MacVittie est ingénieure émérite et évangéliste en chef au sein du bureau du directeur technique de F5. Elle possède une expertise approfondie dans la fourniture d’applications, les stratégies d’automatisation et les infrastructures. Elle est réputée pour sa capacité à rendre la complexité intelligible, qu’elle définisse des garde-fous pour les agents d’IA, analyse des architectures multicloud fragiles ou explore les limites des systèmes évolutifs. Elle cumule plus de trente ans d’expérience dans le secteur, couvrant le développement d’applications, l’architecture informatique ainsi que l’exploitation des réseaux et des systèmes. Avant de rejoindre F5, elle a été rédactrice spécialisée dans les technologies et a reçu plusieurs distinctions. MacVittie est titulaire d’un master en informatique et est une autrice prolifique dont les publications couvrent la sécurité, le cloud et l’architecture d’entreprise. Elle est également une passionnée de jeux de société et de jeux vidéo, et assume pleinement ses avis bien tranchés sur le fromage.
Autres articles de Lori Mac VittieArticles de blog associés

F5 NGINXaaS pour Google Cloud : des applications résilientes et évolutives
Découvrez comment NGINXaaS s’intègre à Google Cloud pour renforcer les performances et la sécurité, et préparer vos applications critiques à un avenir propulsé par l’IA.

L’intégration de F5 Web Application Firewall (WAF) à AWS est disponible dès aujourd’hui
En faisant appel à un partenaire de déploiement AWS WAF tel que F5, vous pouvez renforcer la sécurité de vos applications web grâce à des règles personnalisées qui bloquent les schémas d’attaque courants, comme les injections SQL ou les attaques par scripts intersites (XSS).
Appliquer le principe de Peter Parker à l’inspection TLS
« Un grand pouvoir implique de grandes responsabilités. » Si l’on en trouve des échos chez Voltaire et Churchill, cette citation est surtout connue grâce aux bandes dessinées Spider-Man, où elle est attribuée à l’oncle Ben. Bien entendu, si cette phrase est si répandue dans la culture populaire, c’est notamment parce qu’elle peut s’appliquer à une multitude de situations et de sujets, y compris à l’inspection TLS.
Le NetOps a besoin de défenseurs, pas d’adversaires
Il est important de reconnaître que les équipes NetOps ne sont pas toujours celles qui font obstacle au déploiement de la dernière nouveauté, application ou service. Les freins à la rapidité sont souvent dus au fait que les organisations n’adoptent pas tous les principes du DevOps lorsqu’elles cherchent à transformer leurs opérations informatiques.
Mise à jour des services applicatifs : sécurité, rapidité et visiteurs suspects
Il est de nouveau temps de nous pencher sur les services applicatifs que les entreprises utilisent réellement pour rendre leurs applications plus rapides et plus sûres. On constate notamment une hausse du recours aux services de protection contre les bots, ainsi que la progression lente mais régulière de HTTP/2. Bien qu’il ne s’agisse pas d’une application…
Les templates prennent le contrôle du cloud
Les modèles s’imposent dans le cloud. Lisez le blog de F5 pour découvrir comment l’infrastructure en tant que code et les API déclaratives automatisent la mise à disposition des applications.