Cet article fait suite à « Qu’est-ce qu’un bon plan de contrôle pour exploiter un grand nombre de clusters Kubernetes ? ». L’article précédent présentait l’approche unique de Volterra, Fleet Operations, pour gérer un parc de sites d’infrastructure et d’applications. Cet article décrit plus précisément un défi majeur lié à la dérive de configuration auquel une équipe d’exploitation est confrontée lorsqu’elle apporte des modifications de configuration à un grand nombre de clusters ou de sites. J’appelle ce défi le « délai de prise d’effet ».
Qu’est-ce que le délai de mise en œuvre ?
On peut simplement le décrire comme le temps nécessaire pour que l’intention d’une opération prenne effet. En voici quelques exemples :
- Combien de temps faudra-t-il pour que la configuration de ma politique de sécurité soit appliquée à tous mes sites ?
- Combien de temps faudra-t-il pour que la dernière version de mon application soit déployée sur tous les sites ?
- Combien de temps faudra-t-il pour mettre à niveau le système d’exploitation ou les logiciels d’infrastructure sur l’ensemble de mes sites répartis dans le monde entier ?
Pourquoi est-ce important ?
Quelques exemples concrets de clients permettent de répondre à cette question :
- Meltdown et Spectre — Après l’annonce des failles Meltdown/Spectre, la priorité absolue de chaque RSSI était de déterminer comment appliquer rapidement les correctifs du système d’exploitation à l’ensemble de son infrastructure. Le délai nécessaire à l’équipe d’exploitation pour concrétiser son objectif (c’est-à-dire mettre à niveau la version du système d’exploitation) était mesuré heure par heure.
- Vous avez certainement entendu parler de cette flotte de distributeurs automatiques qui a lancé une attaque par déni de service contre une université. En voici un résumé si vous n’avez pas suivi l’affaire : des pirates ont exploité une vulnérabilité zero-day et installé un logiciel malveillant qui s’est connecté à d’autres distributeurs automatiques, créant ainsi une flotte de machines zombies. Celle-ci a ensuite généré un volume considérable de trafic, provoquant une attaque par déni de service contre l’université. Après avoir détecté l’attaque, l’université a dû configurer une à une les règles de politique réseau de chaque distributeur afin d’empêcher l’accès au serveur de commande et de contrôle. Il était crucial que son intention (c’est-à-dire bloquer l’accès à un site web précis) prenne effet immédiatement sur tous les distributeurs afin d’endiguer l’attaque.
Le délai de prise d’effet est important dans de nombreuses catégories, telles que les logiciels d’infrastructure, les logiciels applicatifs, les politiques réseau et les politiques de sécurité.
Quel est le défi ?
La difficulté se fait particulièrement sentir lorsque l’équipe des opérations doit gérer
- Un grand nombre de sites
- Sites répartis dans le monde entier
- Environnements hétérogènes, c’est-à-dire des sites dans des clouds privés, publics et de télécommunications, ainsi que des appareils en périphérie
- Connectivité irrégulière des sites
Un bon exemple serait celui de l’équipe d’exploitation d’un constructeur automobile chargée de mettre à jour les logiciels et de gérer la connectivité de ses véhicules (ci-après dénommés « sites clients »). Un déploiement type comprendrait un centre de données privé depuis lequel l’équipe d’exploitation contrôle ses véhicules à l’échelle mondiale (ou régionale, selon la structure organisationnelle).
Pour mieux comprendre le défi, examinons les solutions dont dispose l’équipe d’exploitation. La plupart proposent un logiciel de gestion hébergé dans le centre de données privé du client afin d’administrer de manière centralisée un grand nombre de sites distribués. Lorsque le constructeur automobile configure une politique qui doit être appliquée à tous les véhicules, le logiciel de gestion central télécharge un script de configuration sur chaque véhicule, l’un après l’autre. Ce script peut être un playbook Ansible ou un chart Helm qui exécute une série de commandes de configuration sur chaque site. Ce processus est illustré dans le schéma ci-dessous.
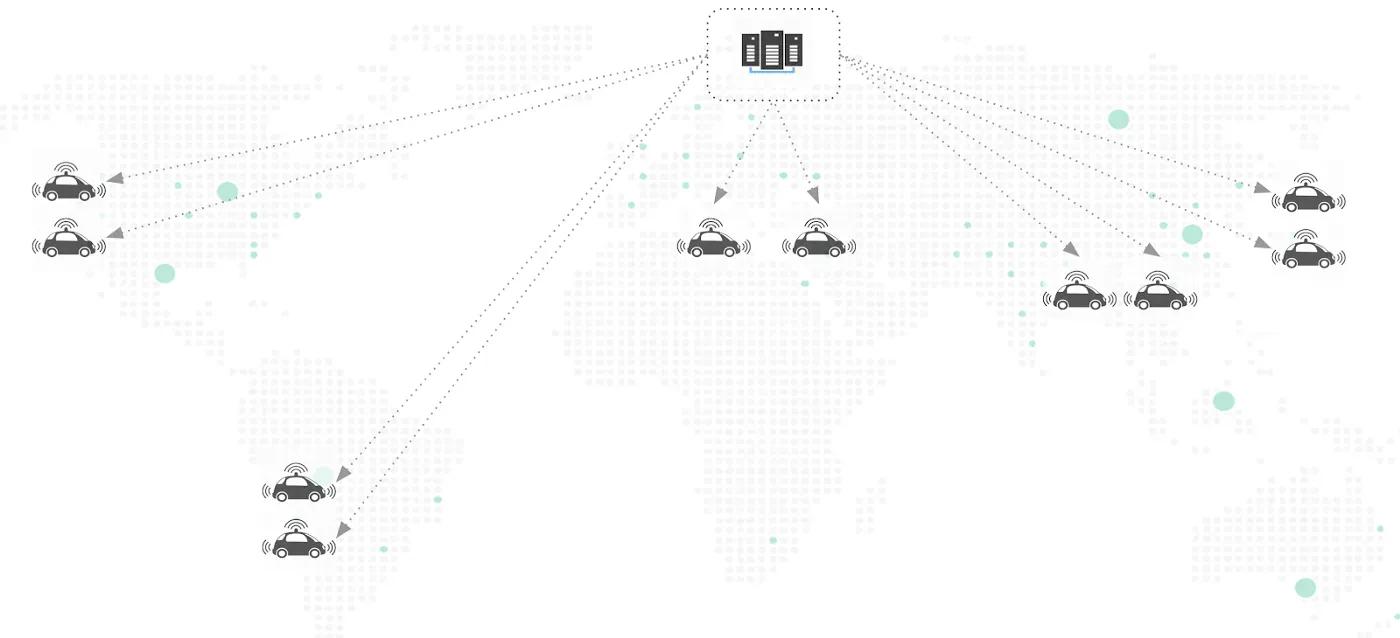
Le problème est que le délai de mise en œuvre est directement proportionnel au nombre de sites. Les éditeurs de logiciels de gestion centralisée soutiendront que, tant que toutes les opérations peuvent être effectuées à distance et de manière automatisée, il est impossible de faire mieux.
Volterra n’est pas de cet avis, et nous allons le démontrer dans cet article. Nous avons conçu un plan de contrôle distribué reposant sur une architecture hiérarchique et évolutive, afin de réduire au minimum le délai de prise d’effet.
Architecture Volterra pour un délai de mise en œuvre minimal
Les éléments fondamentaux permettant de réduire au minimum le délai d’obtention des effets sont les suivants :
- Architecture hiérarchique arborescente
- Plan de contrôle distribué conçu sur mesure
Une vue d’ensemble de l’architecture est présentée ci-dessous.
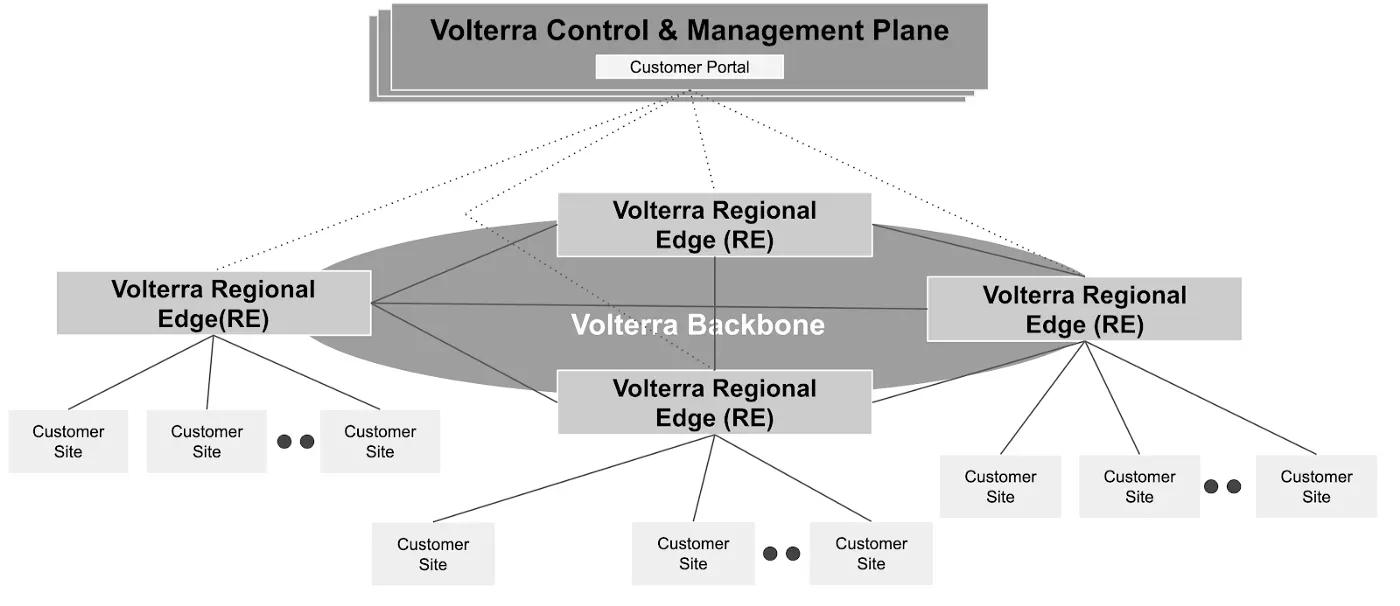
L’approche de Volterra en matière d’architecture hiérarchique consiste à créer une arborescence de nœuds pour distribuer la configuration. Chaque nœud applique un mécanisme de stockage et de transfert : il stocke la configuration localement, puis la transmet à ses nœuds enfants. Un exemple permet de mieux comprendre ce fonctionnement. Lorsqu’un utilisateur configure un objet, tel qu’une politique réseau, dans la console Volterra, le plan de contrôle et de gestion distribue la configuration aux nœuds enfants directs, les Regional Edges (RE). Chaque RE stocke la configuration localement, puis la transmet à ses nœuds enfants. Les nœuds enfants d’un RE sont les sites clients qui y sont connectés.
Une architecture hiérarchique arborescente garantit un délai de prise d’effet minimal. Ce délai dépend du nombre de niveaux de l’arborescence et du nombre d’enfants par nœud. L’arborescence comporte au maximum trois niveaux (contrôleur → RE → site client). Le nombre d’enfants par nœud est directement proportionnel au nombre de sites connectés au RE. Une instance de service est créée sur le RE afin de gérer la configuration d’un ensemble de sites. Le plan de contrôle évolutif de Volterra crée à la demande de nouvelles instances de service lorsque le nombre de sites connectés au RE augmente.
Configuration du test
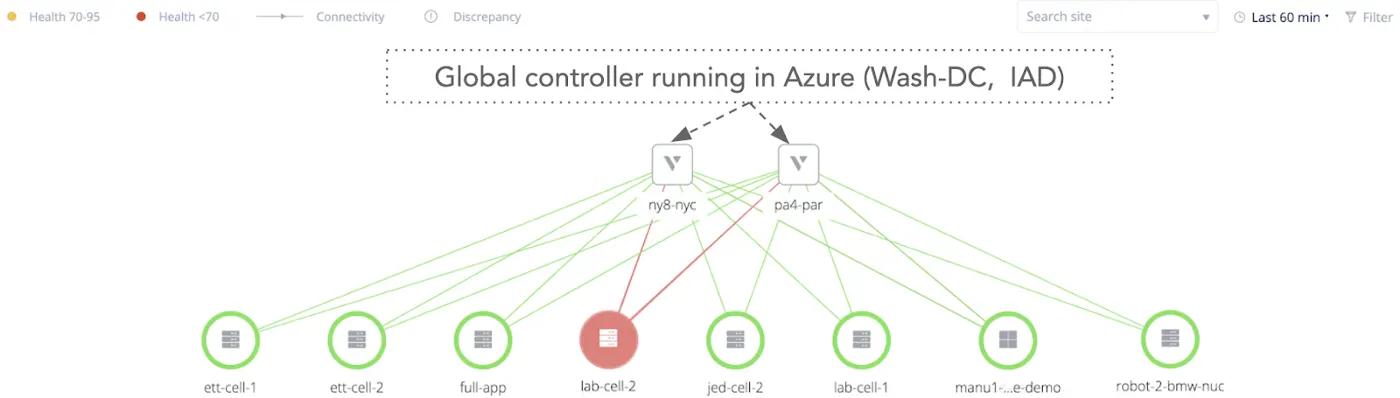
La mesure du délai de prise d’effet a été réalisée à grande échelle sur des sites clients connectés à deux points de présence régionaux situés à New York (NY8-NYC) et à Paris (PA4-PAR). Les sites clients étaient répartis dans le monde entier, notamment à Santa Clara (Californie), Houston (Texas), Madrid (Espagne), Prague (République tchèque), Londres (Royaume-Uni), etc. Ils reposaient également sur des environnements hétérogènes tels qu’AWS, des machines virtuelles (ESXi) et des passerelles Edge, notamment des Intel NUC et des Fitlet2.
Le portail client et le plan de contrôle global de Volterra s’exécutaient dans Azure (Washington-IAD). Les sites clients étaient répartis entre plusieurs espaces de noms et locataires afin de reproduire un environnement d’exploitation réel.
Les conditions de défaillance ont été simulées en arrêtant des instances de service sur le RE et en utilisant des liaisons de mauvaise qualité entre le RE et les sites clients. La figure 3 présente une vue instantanée d’un segment de l’ensemble de la flotte, au sein d’un même espace de noms.
Méthodologie du test
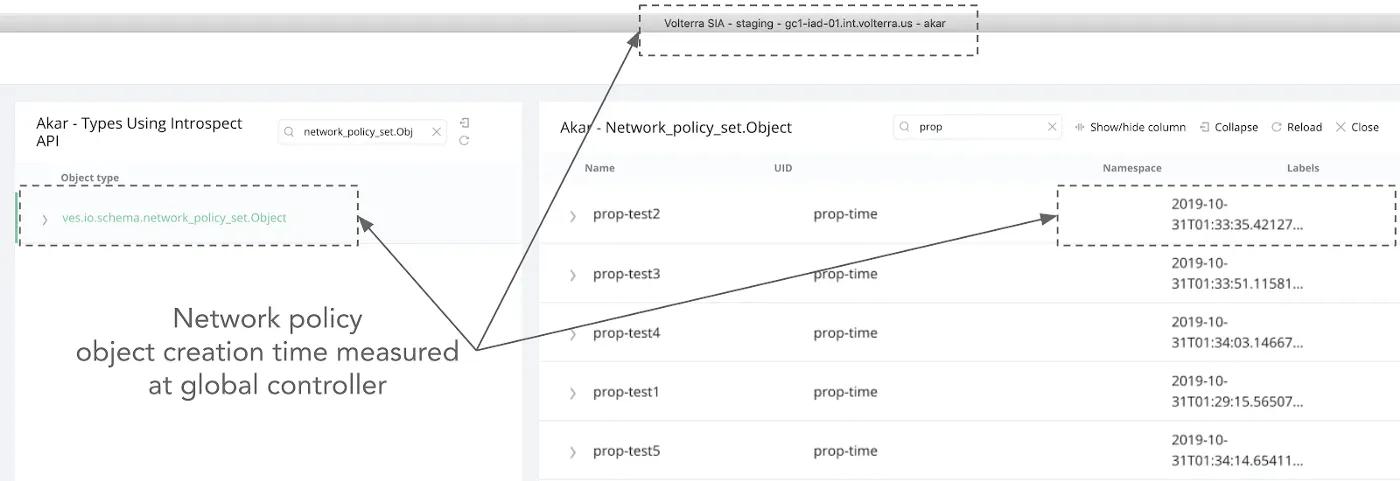
Des journaux d’audit horodatés sont enregistrés dans le système Volterra chaque fois que des objets sont configurés dans la console Volterra et que la configuration est appliquée sur chaque site client. Le temps de propagation a été mesuré comme l’intervalle entre la configuration sur le portail et son application sur le site client. La procédure détaillée, étape par étape, est décrite ci-après.
- Configurez les objets sur le portail client.
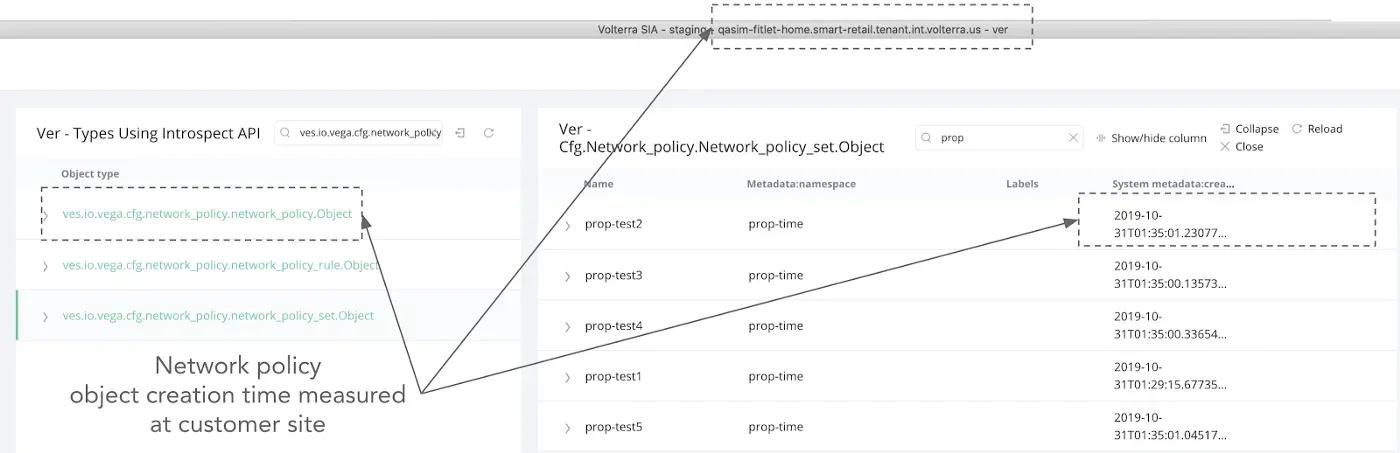
- Mesurez l’heure de début en prenant comme référence l’heure de création de l’objet sur le portail client (ci-après dénommé « Volterra Global Controller »). Voir la figure 4 pour un exemple.
- Mesurez l’heure de fin en prenant comme référence l’heure de création de l’objet sur le site du client. Voir la figure 5 pour un exemple.
Notez que les captures d’écran présentées sont des exemples et ne correspondent pas à la même itération de mesure.
Heure de début de la configuration
Heure de fin de la configuration
Résultats des tests
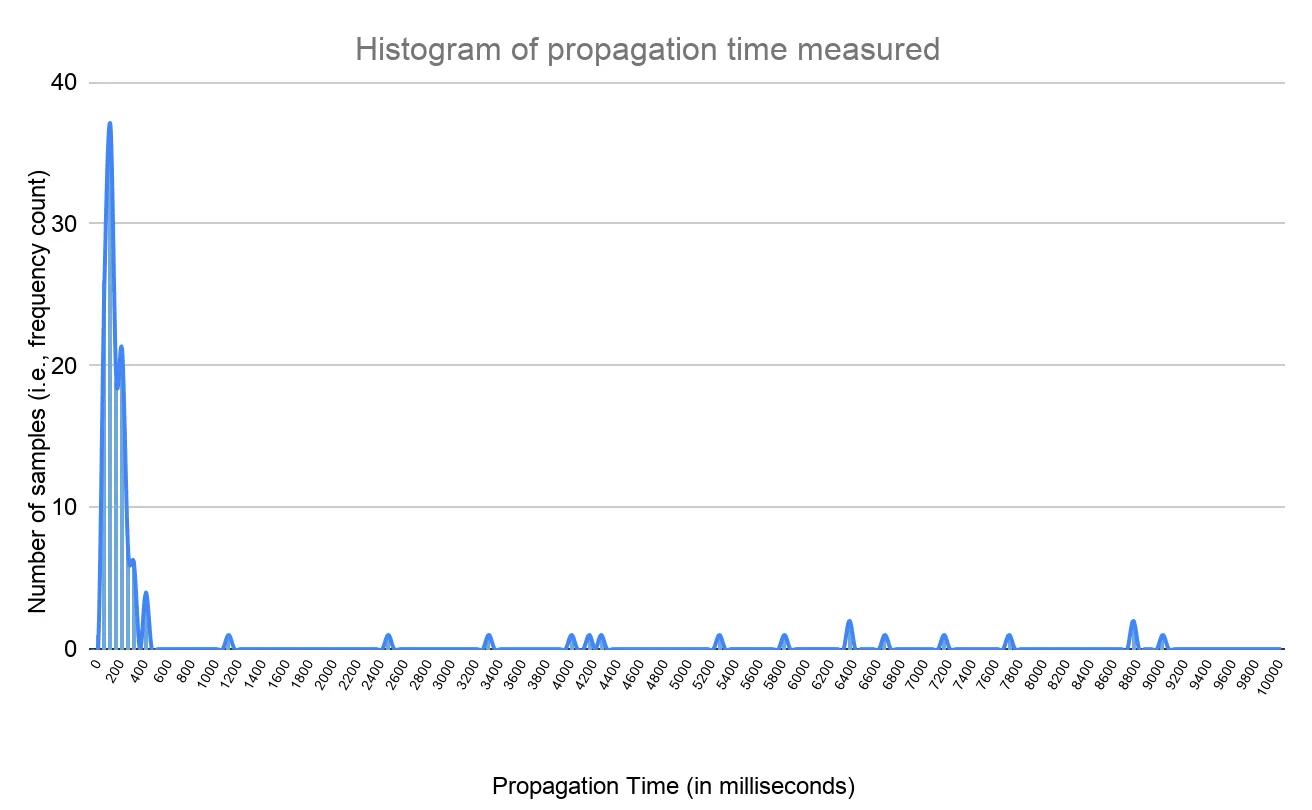
Les résultats des tests sur les délais de propagation sont présentés dans les figures 6 et 7. Le graphique de la figure 6 indique que la plupart des échantillons mesurés présentaient un délai de propagation compris entre 0 et 400 ms. Cela signifie que tous les sites clients sont mis à jour avec une nouvelle configuration dans un délai de 0 à 400 ms. Comme indiqué précédemment, des conditions de défaillance ont été simulées en redémarrant des services sur le RE et en provoquant des défaillances ou des retards de connectivité sur le site client. Dans ces conditions, le délai de propagation de la configuration est plus long et, lors de ces tests spécifiques, variait de 600 ms à 9 secondes selon le type de défaillance. Par exemple, une défaillance de la connectivité entre le RE et les sites clients augmente le temps nécessaire pour que la configuration atteigne le site client. Toutefois, le plan de contrôle distribué de Volterra présente l’avantage de suivre le principe de cohérence à terme de la configuration : il renouvelle les tentatives afin de garantir que la configuration de tous les sites clients reste conforme à l’intention définie par le client.
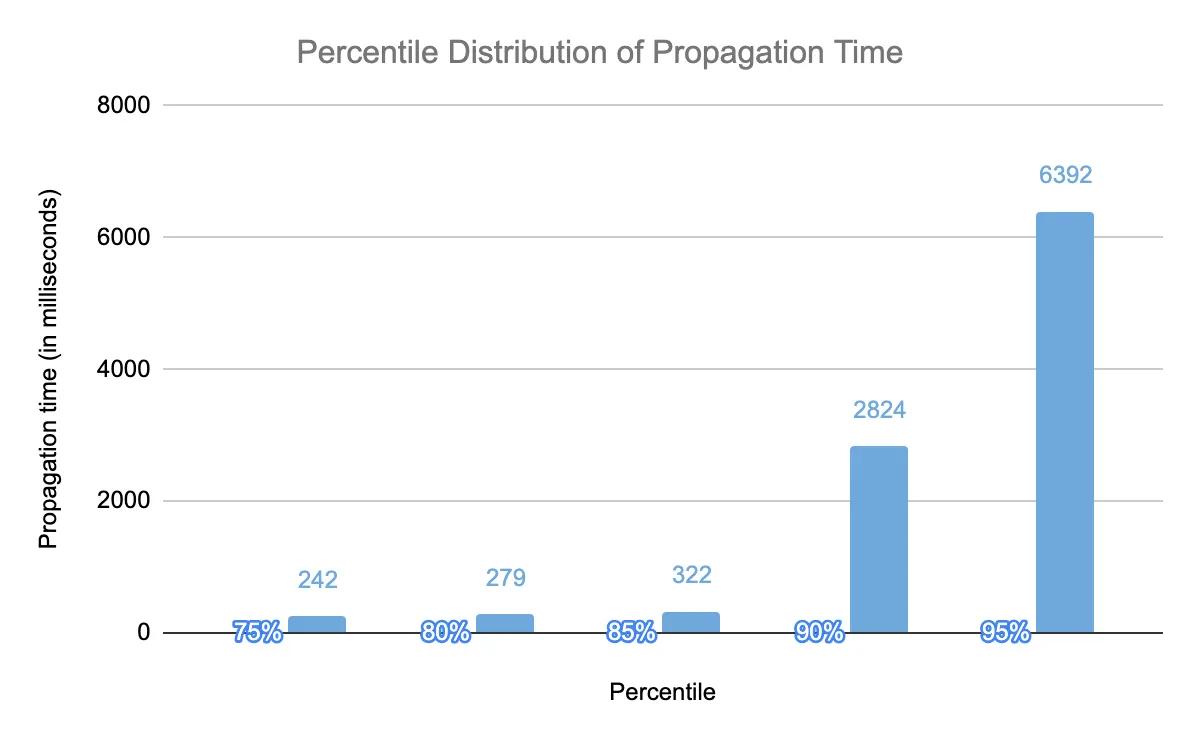
Le graphique de la figure 7 indique que, dans 85 % des cas, tous les sites clients sont mis à jour avec une nouvelle configuration en moins de 322 millisecondes. Lorsque des conditions de défaillance sont introduites, quelques sites clients peuvent connaître un délai de propagation d’environ 3 à 9 secondes.
Avertissement : Ces mesures sont étroitement liées à la topologie, à l’échelle, à l’environnement de déploiement et aux scénarios de défaillance simulés. Nous n’avons pas mesuré tous les scénarios de défaillance possibles ni testé d’autres environnements. Nous ne pouvons donc pas nous prononcer sur le délai de propagation dans des situations ou des environnements qui n’ont pas été testés. Par exemple, en cas de défaillance d’un cluster Kubernetes, le système devrait attendre la détection de la défaillance, redémarrer et tenter à nouveau d’appliquer la configuration, ce qui entraînerait un délai de propagation plus long.
Articles connexes
À propos de l’auteur
Articles de blog associés

F5 NGINXaaS pour Google Cloud : des applications résilientes et évolutives
Découvrez comment NGINXaaS s’intègre à Google Cloud pour renforcer les performances et la sécurité, et préparer vos applications critiques à un avenir propulsé par l’IA.

L’intégration de F5 Web Application Firewall (WAF) à AWS est disponible dès aujourd’hui
En faisant appel à un partenaire de déploiement AWS WAF tel que F5, vous pouvez renforcer la sécurité de vos applications web grâce à des règles personnalisées qui bloquent les schémas d’attaque courants, comme les injections SQL ou les attaques par scripts intersites (XSS).
Appliquer le principe de Peter Parker à l’inspection TLS
« Un grand pouvoir implique de grandes responsabilités. » Si l’on en trouve des échos chez Voltaire et Churchill, cette citation est surtout connue grâce aux bandes dessinées Spider-Man, où elle est attribuée à l’oncle Ben. Bien entendu, si cette phrase est si répandue dans la culture populaire, c’est notamment parce qu’elle peut s’appliquer à une multitude de situations et de sujets, y compris à l’inspection TLS.
Le NetOps a besoin de défenseurs, pas d’adversaires
Il est important de reconnaître que les équipes NetOps ne sont pas toujours celles qui font obstacle au déploiement de la dernière nouveauté, application ou service. Les freins à la rapidité sont souvent dus au fait que les organisations n’adoptent pas tous les principes du DevOps lorsqu’elles cherchent à transformer leurs opérations informatiques.
Mise à jour des services applicatifs : sécurité, rapidité et visiteurs suspects
Il est de nouveau temps de nous pencher sur les services applicatifs que les entreprises utilisent réellement pour rendre leurs applications plus rapides et plus sûres. On constate notamment une hausse du recours aux services de protection contre les bots, ainsi que la progression lente mais régulière de HTTP/2. Bien qu’il ne s’agisse pas d’une application…
Les templates prennent le contrôle du cloud
Les modèles s’imposent dans le cloud. Lisez le blog de F5 pour découvrir comment l’infrastructure en tant que code et les API déclaratives automatisent la mise à disposition des applications.