Si vous comptez tout automatiser, vous aurez intérêt à adopter une approche déclarative. Voici pourquoi.
Cela fait déjà un bon moment que nous vantons les mérites de l’approche déclarative dès qu’il est question d’automatisation, notamment dans le domaine du NetOps et des services applicatifs. Mais nous n’avons jamais vraiment expliqué pourquoi elle est importante ni quels en sont les avantages. Je compte bien y remédier dès maintenant.
Pour vous rafraîchir la mémoire, deux modèles sont actuellement utilisés pour automatiser la configuration et le déploiement de… eh bien, tout.
Le premier est le modèle impératif, dans lequel nous indiquons précisément au système cible comment effectuer ce que nous souhaitons faire. Si vous avez déjà ouvert un tunnel SSH vers un système et saisi une série de commandes spécifiques dans l’interface en ligne de commande, vous avez utilisé le modèle de configuration impératif.
La seconde approche (et celle à privilégier) est déclarative : nous indiquons au système cible ce qu’il doit faire, mais pas comment. C’est le modèle adopté par la plupart des solutions d’automatisation des réseaux pour plusieurs raisons, la principale étant le coût et le temps considérables nécessaires pour maîtriser et intégrer les centaines d’appareils et de systèmes susceptibles d’être présents dans un environnement donné.
Ainsi, dans un modèle impératif, nous devons spécifier chaque commande (ou appel d’API) nécessaire pour configurer un système. Dans un modèle déclaratif, il nous suffit généralement de spécifier des paires clé-valeur décrivant le résultat souhaité, puis de laisser un autre système se charger des commandes nécessaires pour l’obtenir.
Simple comme bonjour.
Voyons maintenant pourquoi cela est important. L’adoption d’un modèle déclaratif présente quatre avantages principaux lorsque vous cherchez à tout automatiser.
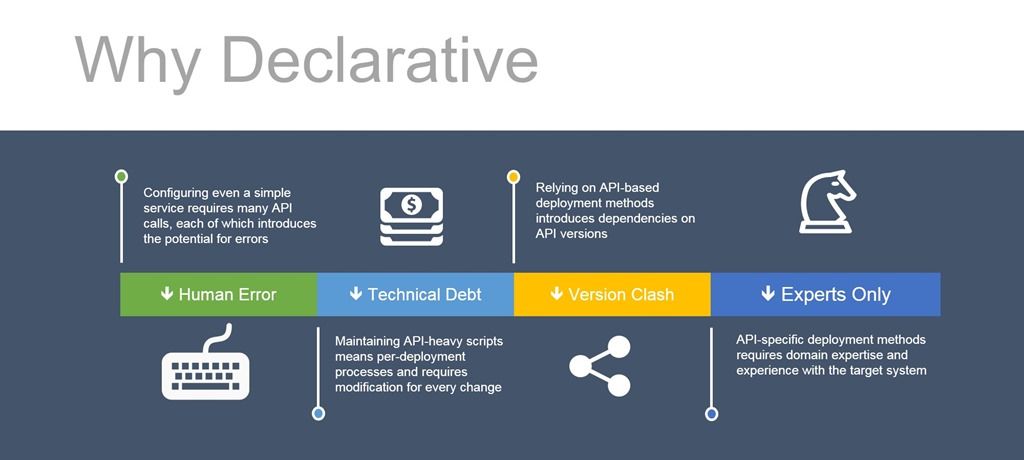
1. Réduire les erreurs humaines
Nous savons qu’environ 22 % des incidents entraînant une interruption en production sont dus à une erreur humaine. Certains incidents assez retentissants, sur lesquels je ne reviendrai pas une fois de plus, ont été directement attribués à une simple erreur humaine. Dans un modèle impératif reposant sur des appels d’API, chacun d’eux constitue un incident potentiel qui ne demande qu’à se produire. Si vous n’avez pas vérifié une variable, si vous avez oublié de contrôler un code d’erreur ou dans une centaine d’autres scénarios possibles, vous risquez de vivre un événement qui vous poussera à mettre votre CV à jour. Et ce n’est pas une bonne chose.
Un modèle déclaratif repose sur un modèle ou un fichier de configuration qui est analysé et validé avant que des appels d’API ne soient utilisés pour l’exécuter. Bien qu’il soit toujours possible de commettre des erreurs dans un fichier de configuration ou un modèle, les risques sont limités, car la quantité de code nécessaire est réduite. Or, moins de code signifie généralement moins de risques de faire une erreur.
2. Réduire la dette technique
La dette technique est cette amusante métaphore empruntée au développement qui nous rappelle le coût à long terme de nos choix. Avec les modèles impératifs, elle s’accumule de plusieurs façons. Tout d’abord, les scripts sont étroitement liés à l’API de notre système cible. Il est peu probable que cette API prenne en charge quoi que ce soit d’autre, ce qui signifie que nous développons des scripts propres à chaque système. Les étapes de configuration varieront probablement aussi d’une application à l’autre : tout ne repose pas sur HTTP, et toutes les applications basées sur HTTP ne nécessitent pas exactement la même configuration de service. Nous créons donc désormais des scripts propres à chaque application et à chaque système. Cela représente beaucoup de scripts et une dette considérable qui s’accumule du fait de ce choix.
À l’inverse, une méthode déclarative permet d’utiliser le même script et le même système pour le processus de déploiement. Même si le modèle ou la configuration restera probablement propre à l’application et au système, il ne s’agit que d’un seul fichier. Cela réduit la complexité et le nombre de scripts, et donc considérablement la dette technique. En réalité, nos choix engendreront toujours une certaine dette ; l’objectif est de la réduire au minimum.
3. Éliminer les conflits de versions
Lorsque vous liez vos processus de configuration et de déploiement à une API, vous devenez dépendant de cette version de l’API. Sur Internet, de nombreuses communautés regorgent de développeurs hostiles et furieux qui s’insurgent contre les modifications apportées à une API et le travail nécessaire pour adapter leur application. La même chose peut se produire (et se produira) avec les services réseau et applicatifs. Alors, si vous dépendez d’une version de l’API et que quelque chose change, devinez quoi ? Vous allez devoir mettre à jour (voire réécrire) des scripts jusqu’à la fin des temps*.
Mais si vous avez adopté un modèle déclaratif, vous pourrez probablement ignorer les éventuelles modifications apportées à l’API. En effet, vous n’utilisez pas l’API pour indiquer au système comment déployer un service, mais simplement ce qui doit être déployé.
4. Réduire les exigences en matière d’expertise métier
Soyons réalistes : si je veux utiliser une API pour un service réseau ou applicatif, je dois comprendre le système. Si vous ne connaissez pas la différence entre une adresse IP virtuelle et un serveur virtuel, vous êtes déjà en difficulté, alors que nous avons à peine commencé à aborder la distinction entre les nœuds et les membres. Les méthodes impératives basées sur des API exigent une connaissance suffisante du système cible pour pouvoir s’y retrouver dans sa configuration.
Avec un modèle déclaratif, une expertise moindre du système cible est nécessaire, ce qui permet plus facilement aux développeurs comme aux équipes DevOps d’utiliser cette méthode pour gérer les applications en libre-service. Bien entendu, des experts resteront nécessaires, mais les exigences imposées aux utilisateurs des services sont réduites, et la charge liée au provisionnement et au déploiement est répartie entre un plus grand nombre de parties prenantes.
Il existe d’autres raisons d’adopter un modèle déclaratif pour automatiser vos opérations réseau, mais ces quatre-là sont les plus convaincantes. En effet, elles profitent aux équipes NetOps, à l’entreprise et à un nombre croissant de parties prenantes qui ont besoin d’accéder en libre-service aux services réseau et applicatifs permettant aux applications de fonctionner plus rapidement et de manière plus sécurisée.
À propos de l’auteur

Lori MacVittie est ingénieure émérite et évangéliste en chef au sein du bureau du directeur technique de F5. Elle possède une expertise approfondie dans la fourniture d’applications, les stratégies d’automatisation et les infrastructures. Elle est réputée pour sa capacité à rendre la complexité intelligible, qu’elle définisse des garde-fous pour les agents d’IA, analyse des architectures multicloud fragiles ou explore les limites des systèmes évolutifs. Elle cumule plus de trente ans d’expérience dans le secteur, couvrant le développement d’applications, l’architecture informatique ainsi que l’exploitation des réseaux et des systèmes. Avant de rejoindre F5, elle a été rédactrice spécialisée dans les technologies et a reçu plusieurs distinctions. MacVittie est titulaire d’un master en informatique et est une autrice prolifique dont les publications couvrent la sécurité, le cloud et l’architecture d’entreprise. Elle est également une passionnée de jeux de société et de jeux vidéo, et assume pleinement ses avis bien tranchés sur le fromage.
Autres articles de Lori Mac VittieArticles de blog associés

F5 NGINXaaS pour Google Cloud : des applications résilientes et évolutives
Découvrez comment NGINXaaS s’intègre à Google Cloud pour renforcer les performances et la sécurité, et préparer vos applications critiques à un avenir propulsé par l’IA.

L’intégration de F5 Web Application Firewall (WAF) à AWS est disponible dès aujourd’hui
En faisant appel à un partenaire de déploiement AWS WAF tel que F5, vous pouvez renforcer la sécurité de vos applications web grâce à des règles personnalisées qui bloquent les schémas d’attaque courants, comme les injections SQL ou les attaques par scripts intersites (XSS).
Appliquer le principe de Peter Parker à l’inspection TLS
« Un grand pouvoir implique de grandes responsabilités. » Si l’on en trouve des échos chez Voltaire et Churchill, cette citation est surtout connue grâce aux bandes dessinées Spider-Man, où elle est attribuée à l’oncle Ben. Bien entendu, si cette phrase est si répandue dans la culture populaire, c’est notamment parce qu’elle peut s’appliquer à une multitude de situations et de sujets, y compris à l’inspection TLS.
Le NetOps a besoin de défenseurs, pas d’adversaires
Il est important de reconnaître que les équipes NetOps ne sont pas toujours celles qui font obstacle au déploiement de la dernière nouveauté, application ou service. Les freins à la rapidité sont souvent dus au fait que les organisations n’adoptent pas tous les principes du DevOps lorsqu’elles cherchent à transformer leurs opérations informatiques.
Mise à jour des services applicatifs : sécurité, rapidité et visiteurs suspects
Il est de nouveau temps de nous pencher sur les services applicatifs que les entreprises utilisent réellement pour rendre leurs applications plus rapides et plus sûres. On constate notamment une hausse du recours aux services de protection contre les bots, ainsi que la progression lente mais régulière de HTTP/2. Bien qu’il ne s’agisse pas d’une application…
Les templates prennent le contrôle du cloud
Les modèles s’imposent dans le cloud. Lisez le blog de F5 pour découvrir comment l’infrastructure en tant que code et les API déclaratives automatisent la mise à disposition des applications.