
F5 et AWS : services avancés de mise à disposition d’applications dans le cloud
Introduction
Amazon Web Services (AWS) est devenu le principal fournisseur de services d’infrastructure cloud publique à la demande (Infrastructure-as-a-Service, IaaS) et le plus répandu. Les entreprises peuvent désormais créer, tester et déployer des piles applicatives complètes sans acheter ni reconfigurer d’infrastructure sur site. Les applications de production peuvent bénéficier de services avancés de mise à disposition d’applications, tels qu’un pare-feu applicatif web (WAF), l’accélération SSL, le routage basé sur le contenu, l’équilibrage de charge, l’atténuation des attaques DDoS, la gestion des identités et des accès, ainsi que la prise en charge de plusieurs protocoles. Ces services permettent à ces applications stratégiques d’être plus rapides, plus intelligentes et plus sûres. Pour les déploiements cloud natifs sur AWS, les solutions F5 permettent de fournir ces services applicatifs aux environnements cloud AWS de manière simple et fluide.
Qu’est-ce qu’Amazon Web Services ?
En tant que fournisseur d’IaaS, Amazon Web Services (AWS) propose à la location une infrastructure de calcul suffisante pour développer des applications. Une suite applicative complète peut ainsi être développée et déployée sans aucune dépense d’investissement ni aucun coût de maintenance. Outre une infrastructure de calcul comparable à celle disponible sur site, AWS fournit des services applicatifs, adapte automatiquement les ressources de l’infrastructure et héberge les applications dans de nombreux emplacements. En raison de ces fonctionnalités supplémentaires, les bonnes pratiques propres à AWS diffèrent de celles d’un centre de données traditionnel. Pour mieux comprendre les différences entre AWS et un centre de données traditionnel, il est important de savoir comment AWS fournit ses services.
Services d’infrastructure
Pour tirer le meilleur parti d’AWS, examinons plusieurs caractéristiques importantes de son offre IaaS, telles que la répartition géographique, les instances de calcul, les concepts de réseau et de stockage.
Géographie
Pour comprendre AWS, il faut commencer par décrire physiquement la répartition des ressources. Au niveau le plus élevé, AWS comprend plusieurs régions, chacune couvrant une vaste zone géographique, comme l’est des États-Unis. Chaque région géographique contient plusieurs zones de disponibilité, ainsi nommées parce qu’elles sont conçues pour être isolées les unes des autres en cas de défaillance. Une défaillance dans une zone de disponibilité (AZ) ne se propagera pas à une autre AZ de la même région. Bien que chaque AZ soit isolée, les AZ d’une même région sont reliées par des connexions réseau à faible latence. Afin de garantir la disponibilité, il existe des modèles d’architecture permettant de mettre en place des capacités redondantes dans plusieurs AZ d’une même région.
Calcul
Les instances de calcul sont initialement des images disque logicielles, appelées Amazon Machine Images (AMI). Chaque AMI est immuable, ce qui signifie que l’ordinateur qui l’utilise ne peut y accéder qu’en lecture seule. Le démarrage d’une instance de calcul à partir d’une AMI crée une machine virtuelle en cours d’exécution dans le cloud. Les caractéristiques du matériel virtuel de l’instance de calcul peuvent varier, notamment le nombre de processeurs et la quantité de mémoire vive disponibles pour l’instance.
Réseau
Chaque instance de calcul se trouve au sein d’un cloud privé virtuel (VPC), qui correspond approximativement à un réseau local (LAN) dans le monde physique. Chaque VPC est isolé logiquement. Un VPC peut comporter plusieurs sous-réseaux, avec un routage implicite entre ceux-ci. Les sous-réseaux publics sont accessibles depuis Internet, tandis que les sous-réseaux privés ne sont accessibles qu’en interne. Pour déployer une application complète, une ou plusieurs instances de calcul sont déployées au sein d’un VPC. La communication entre plusieurs VPC est possible lorsqu’une entrée DNS est attribuée à une instance de calcul ou à un équilibreur de charge.
Stockage
Comme indiqué précédemment, chaque AMI est immuable depuis l’instance qui l’utilise. Pour le stockage persistant, AWS propose de nombreuses solutions, principalement Simple Storage Service (S3) et Elastic Block Storage (EBS). S3 est un service de stockage d’objets dans lequel un objet peut être stocké et consulté par son nom. La taille d’un objet peut aller de zéro octet à 5 To. En fait, chaque AMI est implicitement un objet S3. Les objets ne peuvent pas être modifiés, mais uniquement créés et supprimés, ce qui les rend idéaux pour les contenus relativement statiques, tels que les photographies ou les images de machines virtuelles.
EBS fournit un stockage plus proche des solutions de stockage traditionnelles. Une instance de calcul connectée à EBS considère celui-ci comme un disque dur classique. Une seule instance en cours d’exécution peut être connectée à un volume EBS à la fois ; EBS ne peut donc pas être utilisé comme stockage partagé.
Services de mise à l’échelle
En plus de fournir des composants d’infrastructure essentiels, AWS propose des services supplémentaires permettant de faire évoluer les applications. Comme AWS peut rapidement provisionner des ressources d’infrastructure, Amazon a développé des solutions permettant d’assurer la mise à l’échelle automatique et la répartition de charge de ces ressources.
Équilibrage de charge
AWS propose un service Elastic Load Balancing (ELB). À l’origine, ELB désignait un équilibreur de charge simple fonctionnant au niveau de la couche 4 et répartissant le trafic entre plusieurs nœuds sains d’un pool. Ce pool pouvait s’étendre sur plusieurs zones de disponibilité, assurant ainsi une redondance automatique en cas de défaillance dans l’une d’elles. Bien que cet équilibreur de charge offre quelques fonctionnalités réseau de base de couche 7, il fonctionne principalement au niveau de la couche 4, en acheminant simplement le trafic TCP à tour de rôle vers les nœuds du pool. Des contrôles d’intégrité déterminent quels nœuds sont disponibles et peuvent donc recevoir du trafic. AWS désigne désormais cet équilibreur de charge initial sous le nom de Classic Load Balancer afin de le distinguer du nouvel Application Load Balancer (ALB).
Mise à l’échelle automatique
Comme AWS dispose d’une capacité de réserve, il peut proposer une option permettant d’ajuster le nombre de nœuds au sein d’un pool. Le service AWS CloudWatch surveille les indicateurs de performance de chaque nœud du pool. Lorsque des seuils prédéfinis sont franchis — par exemple, lorsque l’utilisation du processeur dépasse 60 % pendant 5 minutes —, un nœud supplémentaire est provisionné. À l’inverse, lorsqu’un seuil inférieur est franchi, un nœud est supprimé. Le concepteur peut définir le nombre maximal et minimal de nœuds dans un pool, ainsi que les seuils qui déclenchent l’instanciation ou la suppression d’un nœud. L’utilisation de la mise à l’échelle automatique derrière un équilibreur de charge permet au pool de nœuds de s’étendre ou de se réduire selon les besoins, en fonction de la charge.
Services de mise à disposition d’applications F5
Bien que les applications prennent en charge les règles et la logique métier, elles ne disposent souvent pas du renforcement nécessaire à leur déploiement, leur gestion et leur exploitation en production à grande échelle. Les solutions F5 permettent aux applications de gagner en rapidité, en intelligence et en sécurité grâce aux services avancés de mise à disposition d’applications présentés dans le tableau ci-dessous.
Services avancés de mise à disposition d’applications F5
Surveillance au niveau applicatif
- Contrôles avancés de l’état de santé des applications (à l’aide d’un moniteur en plusieurs étapes)
- Contrôles d’intégrité à plusieurs niveaux (par exemple, pour vérifier que la base de données et l’application sont toutes deux disponibles)
- Contrôles d’intégrité non HTTP (tels que SIP, Microsoft Windows SQL Server et FTP)
- Des algorithmes avancés pour mieux répartir le trafic vers les serveurs les plus performants
Disponibilité mondiale
- Disponibilité des applications dans un environnement hétérogène composé de différents fournisseurs de services cloud ou centres de données
- Intégration avec les moniteurs avancés BIG-IP
- Prise en charge de DNSSEC
Plus rapide
Optimisation du réseau et du transport
- Une pile TCP configurable pouvant être optimisée pour assurer la transmission sur les réseaux WAN et cellulaires
- Une passerelle HTTP/2 qui offre les avantages d’une compression supplémentaire et du multiplexage des requêtes sans modifier l’infrastructure back-end
Optimisation des applications et des données
- Optimisation sélective des images à la volée en fonction des caractéristiques détectées du réseau ou du client
- Accélération WAN sur des tunnels chiffrés SSL avec compression adaptative et optimisation TCP
Plus intelligent
Programmabilité du chemin de données
- Contrôle programmatique complet du trafic applicatif, avec notamment la possibilité de lire, d’écrire et d’inspecter tous les aspects des données applicatives
- Langage complet et piloté par les événements
Programmabilité du plan de contrôle
- La capacité à modifier la configuration en réponse à des événements tels que des changements de charge du serveur, de comportement de l’application ou d’infrastructure
- Déclencheurs entièrement autonomes ou pilotés par une API externe
Plus sûr
Services avancés de pare-feu réseau
- Décisions relatives au contrôle du trafic fondées sur des critères allant au-delà de la simple combinaison IP:port:protocole, tels que la localisation géographique ou la réputation du terminal
- Validation du protocole HTTP
- Plages horaires et jours programmés
Services de pare-feu pour applications web
- Des outils complets pour identifier les menaces visant les applications web et bloquer le trafic malveillant
- Services de prévention des pertes de données (DLP) sortantes
Services d’accès et de gestion des identités
- Services d’authentification avancée, tels que les jetons d’authentification à deux facteurs, les CAPTCHA ou les restrictions géographiques
- Vérification des certificats clients et inspection des terminaux
- Services de fournisseur de services (SP) et de fournisseur d’identité (IdP) SAML
Atténuation des attaques par déni de service (DoS)
- Défense proactive contre les bots
- Détection et atténuation des attaques DoS de couche 7
SSL et chiffrement
- Déchiffrement SSL, inspection du trafic et rechiffrement
- Déchargement des charges de travail SSL des ressources des nœuds de calcul
Les services avancés de mise à disposition d’applications permettent à celles-ci d’atteindre un niveau de performance supérieur, tout en améliorant leur disponibilité et leur sécurité. Ces services peuvent être déployés à un point de contrôle stratégique, indépendamment de chaque application. Le découplage de ces services de la logique métier des applications permet à ces dernières de répondre aux besoins de l’entreprise sans imposer aux équipes de développement les contraintes liées à l’infrastructure, à la gestion et aux performances. Un point de contrôle stratégique permet également de traiter les questions de gouvernance de manière uniforme et indépendamment de chaque application.
Tout mettre en œuvre : F5 et AWS
Grâce à une intégration cloud native à l’infrastructure AWS, F5 permet aux entreprises de tirer pleinement parti de leurs déploiements AWS et d’offrir à leurs applications de meilleures performances, une disponibilité accrue et une sécurité renforcée. Dans la section suivante, nous verrons comment AWS et F5 fonctionnent ensemble.
Amorçage
Lorsqu’une instance de serveur démarre à partir d’une image générique, il est souvent judicieux de modifier certains paramètres ou de définir certaines configurations, comme le nom d’hôte et l’adresse IP. Sur les postes clients, ces paramètres sont définis via DHCP, mais la configuration des paramètres d’un serveur via DHCP peut souvent poser problème. Au-delà des paramètres réseau, une instance donnée peut parfois nécessiter des paquets logiciels spécifiques ou certaines configurations logicielles.
Dans le cas d’un déploiement BIG-IP, un administrateur peut souhaiter automatiser la configuration de chacun des modules, notamment celle des serveurs virtuels et des pools pour BIG-IP Local Traffic Manager (LTM), les configurations WAF propres à BIG-IP Application Security Manager ou encore les paramètres de pare-feu pour BIG-IP Advanced Firewall Manager. Toute personne installant une instance de serveur est confrontée aux mêmes problématiques : l’image de base nécessite une configuration supplémentaire pour fonctionner correctement.
AWS propose deux approches principales pour configurer une instance : créer une nouvelle AMI ou utiliser cloud-init pour modifier un serveur pendant le processus de démarrage. La création d’une nouvelle AMI convient davantage aux modifications communes à plusieurs instances et qui sont peu susceptibles d’être mises à jour fréquemment. En revanche, cloud-init est plus adapté aux modifications qui concernent un nombre plus restreint d’instances et dont la durée de vie est plus courte.
AMI
Pour les modifications destinées à être conservées sur une longue période, ainsi que pour celles communes à plusieurs instances, une bonne approche consiste à créer une nouvelle AMI en démarrant une machine à partir d’une AMI proche de la configuration souhaitée. Une fois que l’administrateur a apporté les modifications nécessaires à l’instance en cours d’exécution, celle-ci est arrêtée, puis une nouvelle AMI est générée et enregistrée auprès d’AWS. Toutes les futures instances démarrées à partir de cette AMI intégreront déjà ces modifications. Comme cette approche rend les modifications pratiquement permanentes et que la génération de la nouvelle AMI peut prendre du temps, les modifications intégrées à l’AMI sont généralement celles qui sont destinées à durer et qui peuvent être utilisées sur plusieurs instances. L’utilisation d’une AMI permet également d’accélérer le démarrage, car certains processus cloud-init peuvent prendre beaucoup de temps.
Cloud-init
Les modifications nécessaires qui se prêtent mal à une intégration dans une nouvelle AMI sont de bonnes candidates pour cloud-init, qui permet essentiellement d’exécuter un script de démarrage à chaque lancement de l’instance. L’utilisation de cloud-init permet d’intégrer à l’instance des modifications simples et propres à celle-ci.
Parmi les inconvénients de cloud-init, les modifications de configuration, telles que l’installation de paquets, doivent être exécutées au démarrage, ce qui allonge le temps de démarrage. Un démarrage prolongé a un impact réel dans les scénarios de mise à l’échelle automatique, où il peut rendre celle-ci inefficace. Pour ces raisons, les modifications qui prennent beaucoup de temps doivent être intégrées à une nouvelle AMI plutôt que réalisées via cloud-init.
La gestion de la configuration peut également s’avérer fastidieuse lorsqu’une modification peut être appliquée à plusieurs instances, mais pas à toutes. Par exemple, supposons qu’un déploiement BIG-IP particulier soit utilisé dans un groupe d’auto-scaling avec une configuration de serveur virtuel spécifique. Une même AMI pourrait être utilisée pour ces machines, tandis qu’une autre AMI pourrait l’être pour d’autres machines BIG-IP appartenant à un autre groupe d’auto-scaling. L’utilisation d’une seule AMI par groupe d’auto-scaling garantit que seules les modifications propres à chaque hôte sont nécessaires dans le cadre du processus cloud-init. Toutes les modifications communes au groupe peuvent être intégrées à l’AMI. L’inconvénient de cette approche est qu’elle nécessite une mise à jour de l’AMI pour chaque modification commune à toutes les machines.
Mise à l’échelle automatique
Les applications fournissent une fonctionnalité, généralement à plusieurs utilisateurs simultanément. À mesure qu’une application rencontre davantage de succès, elle peut dépasser les capacités de l’ordinateur sur lequel elle s’exécute. Lorsque les besoins de l’application excèdent les capacités de cet ordinateur, il convient d’évaluer les différentes options permettant d’augmenter la capacité. Il existe trois approches génériques de mise à l’échelle : la mise à l’échelle verticale, le traitement en pipeline et la mise à l’échelle horizontale.
Mise à l’échelle verticale
La mise à l’échelle verticale est l’approche la plus simple pour augmenter la capacité, car elle consiste simplement à remplacer l’ordinateur existant par un modèle plus rapide. L’installation d’un ordinateur plus rapide accélère tous les aspects de l’application, ainsi que tous les autres services exécutés sur cet ordinateur, sans qu’aucune modification de l’application ou de l’infrastructure ne soit nécessaire. L’inconvénient de la mise à l’échelle verticale est que les coûts ont tendance à augmenter de manière exponentielle à mesure que les performances s’améliorent, jusqu’à atteindre un point de rendement décroissant. Au-delà d’un certain seuil, la mise à l’échelle verticale devient trop coûteuse.
Traitement en pipeline
Le traitement en pipeline consiste à décomposer la charge de travail en étapes séquentielles, à la manière d’une chaîne de montage. Lorsque différents ordinateurs peuvent travailler indépendamment sur chaque étape, le débit global peut être augmenté. Toutefois, le traitement en pipeline n’augmente que le débit, souvent au détriment de la latence. Autrement dit, il peut améliorer les performances globales, mais réduire celles dont bénéficie un utilisateur ou une requête en particulier. Un autre inconvénient du traitement en pipeline est qu’il exige une compréhension approfondie du flux de travail pouvant être décomposé, ainsi qu’une infrastructure adaptée à cette compréhension. Il crée un couplage étroit entre les décisions relatives à l’infrastructure et la logique métier, ce qui est exactement l’inverse de ce que de nombreuses organisations cherchent à faire.
Mise à l’échelle horizontale
La mise à l’échelle horizontale consiste à ne modifier ni l’application ni l’ordinateur, mais à répartir uniformément les requêtes entre plusieurs serveurs. Comme les applications traitent généralement plusieurs requêtes indépendantes simultanément, celles-ci peuvent être réparties en toute sécurité entre plusieurs serveurs d’applications identiques. La mise à l’échelle horizontale offre également l’avantage de la redondance : la défaillance de l’un des serveurs n’entraîne pas l’indisponibilité de l’ensemble de l’application. Son inconvénient est qu’elle nécessite une orchestration externe complexe afin de garantir une répartition équilibrée des requêtes entre les différents nœuds du groupe.
Mise à l’échelle automatique AWS
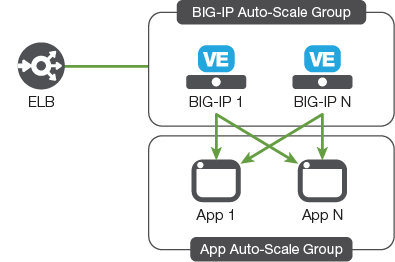
La mise à l’échelle automatique d’AWS repose sur une approche horizontale pour augmenter la capacité des applications qui en ont besoin. Le service CloudWatch surveille les nœuds d’un pool. Lorsque les nœuds franchissent des seuils prédéfinis, CloudWatch démarre automatiquement de nouveaux nœuds ou arrête des nœuds du pool, selon les besoins. Avec la plateforme BIG-IP, ce processus peut s’effectuer de deux manières : en modifiant le nombre d’instances BIG-IP ou le nombre de nœuds d’un pool situé derrière une seule instance BIG-IP. La différence entre ces deux approches dépend de l’élément mis à l’échelle : l’instance BIG-IP ou un pool.
Dans le premier scénario, un pool BIG-IP se trouve entre deux dispositifs ELB. Le premier dispositif ELB contrôle la création et la suppression des membres BIG-IP, tandis que le second constitue l’unique entrée d’un pool de serveurs pour chacune des instances BIG-IP. Cette approche est pertinente lorsque l’instance BIG-IP fournit des services avancés de mise à disposition d’applications, tels que la terminaison SSL, ou fait office de pare-feu d’applications Web. Le premier dispositif ELB assure l’équilibrage de charge tout en augmentant ou en réduisant la taille du pool selon les besoins.
Dans le second scénario, le nombre de membres du pool back-end augmente et diminue via CloudWatch, mais c’est l’instance BIG-IP qui assure l’équilibrage de charge. L’instance BIG-IP communique avec AWS pour détecter les nœuds ajoutés au pool ou supprimés de celui-ci. Cette approche est pertinente lorsque des fonctionnalités avancées d’équilibrage de charge sont utilisées, telles que le langage de script iRules, ou lorsque les requêtes sont acheminées en fonction de l’URL ou du contenu. Dans ces cas, une seule instance BIG-IP suffit pour gérer la charge des serveurs du pool back-end.
Sécurité et IAM
L’instance BIG-IP doit interagir avec l’infrastructure AWS dans au moins deux scénarios. Premièrement, un déploiement AWS multizone nécessite de modifier l’adresse IP associée à une adresse IP élastique AWS. Deuxièmement, une instance BIG-IP doit pouvoir identifier les membres du pool ajoutés et supprimés par le service AWS CloudWatch, qui augmente ou réduit le nombre de serveurs au sein d’un pool. Chaque interaction avec l’infrastructure s’effectue au moyen d’appels d’API et, comme tout autre logiciel effectuant de tels appels, l’instance BIG-IP doit s’authentifier auprès d’AWS. En règle générale, il existe deux méthodes d’authentification auprès d’AWS : à l’aide d’informations d’identification ou de rôles IAM.
Identifiants
L’approche la plus simple pour s’authentifier consiste à inclure les identifiants appropriés dans l’appel d’API. Les identifiants AWS se composent d’une clé d’accès et d’une clé secrète, qui correspondent approximativement à un nom d’utilisateur et à un mot de passe. L’administrateur génère les identifiants, que le développeur intègre ensuite à l’application. Celle-ci peut ainsi accéder aux appels d’API appropriés.
Bien que simple, l’intégration d’identifiants dans une application présente des risques de sécurité. Si le développeur ne sécurise pas les identifiants dans l’application, d’autres personnes ou logiciels pourraient les récupérer et les utiliser à des fins malveillantes. Cette approche complique également la modification des identifiants sans modifier le logiciel. Si l’utilisation d’identifiants constitue une approche raisonnable pour effectuer des tests rapides, une solution de production doit recourir à une autre méthode d’authentification. C’est pourquoi les bonnes pratiques AWS déconseillent l’utilisation d’identifiants stockés dans une application.
Gestion des identités et des accès
Une approche plus sécurisée de l’authentification des appels d’API consiste à utiliser des rôles IAM. AWS Identity and Access Management (IAM) permet aux utilisateurs de gérer l’accès à l’infrastructure AWS. Toute instance de calcul, telle qu’une machine BIG-IP, peut se voir attribuer un rôle IAM qui autorise un ensemble précis de fonctionnalités. Au démarrage de l’instance, IAM génère pour celle-ci un ensemble temporaire d’identifiants. Ces identifiants restent valides tant que l’instance fonctionne et donnent uniquement accès aux fonctionnalités d’API spécifiées. Lorsqu’elle est configurée avec un rôle IAM, l’instance BIG-IP ne stocke pas d’identifiants, mais accède uniquement aux API d’infrastructure nécessaires, ce qui offre une sécurité supérieure à celle de l’authentification basée sur des identifiants.
Disponibilité multizone
As mentioned earlier, AWS data centers exist in geographical regions, each of which can exist in an availability zone (AZ). Each AZ within a region shares nothing with other AZs: no shared power, networking, or buildings. In fact, each AZ is geographically separated from the others within a region. Because of the separation between zones, AWS subscribers can be confident that an event impacting one AZ will not impact another AZ. In other words, as a rule, at most one AZ within a region should be unavailable at any moment in time. This means that any service deployed across two or more availability zones should be continuously available.
La plateforme BIG-IP assure une haute disponibilité entre les zones de disponibilité (AZ) AWS grâce à une adresse IP élastique AWS, c’est-à-dire une adresse IP qui n’est pas intrinsèquement associée à une instance de calcul. Cette adresse IP peut être redirigée dynamiquement vers l’adresse IP privée d’une instance de calcul en cours d’exécution. Pour assurer une haute disponibilité multizone, des ensembles identiques d’instances BIG-IP et de serveurs d’applications sont placés chacun dans leur propre zone de disponibilité. Initialement, l’adresse IP élastique est attribuée à l’une des instances BIG-IP. Chaque client établit une connexion à l’adresse IP élastique, qui la redirige à son tour vers l’adresse IP privée de l’une des instances BIG-IP. En cas de défaillance, l’autre instance BIG-IP prend le relais en envoyant un appel d’API à AWS afin de demander que l’adresse IP élastique soit redirigée vers elle.
Équilibreur de charge élastique
Grâce à son intégration à l’ELB, la plateforme BIG-IP peut fournir des services applicatifs qui s’intègrent parfaitement aux fonctionnalités d’AWS, telles que les zones de disponibilité multiples et la mise à l’échelle automatique des nœuds BIG-IP.
Le placement de l’ELB devant une instance BIG-IP simplifie le déploiement sur plusieurs zones de disponibilité, car l’ELB peut répartir de manière transparente le trafic entre les différentes piles applicatives de chaque zone de disponibilité dans laquelle une instance BIG-IP fournit des services applicatifs. Cette approche simplifie la répartition de charge entre plusieurs zones de disponibilité.
Lorsque l’élasticité des instances BIG-IP est nécessaire, un ELB doté de la mise à l’échelle automatique peut ajuster automatiquement à la hausse ou à la baisse un pool d’appliances virtuelles BIG-IP fournissant des services applicatifs tels qu’un pare-feu d’applications Web, la gestion des identités ou la terminaison SSL. Dans une architecture ELB en sandwich, le trafic est acheminé vers le premier ELB, qui le répartit entre un pool d’instances BIG-IP et adapte automatiquement la capacité de ce pool. Pour simplifier la configuration de l’ensemble du pool BIG-IP, chaque instance BIG-IP dispose d’une seule adresse ELB dans le pool de serveurs. Le second ELB achemine ensuite le trafic vers le pool de serveurs en aval.
Différentes combinaisons de topologies ELB et BIG-IP offrent des fonctionnalités de mise à l’échelle automatique, de disponibilité et des services applicatifs qu’aucune de ces solutions ne peut fournir seule. En tirant parti des avantages d’ELB et de la plateforme BIG-IP, l’architecte peut fournir le niveau de service requis pour un déploiement donné.
Modèles CloudFormation
Pour permettre des déploiements reproductibles et automatisés par script, AWS fournit des modèles CloudFormation (CFT), qui simplifient à la fois le déploiement et la gestion continue. Une fois qu’un CFT a été créé pour l’architecture de service ou d’application souhaitée, AWS peut l’utiliser pour provisionner une application rapidement et de manière fiable. Les CFT sont particulièrement utiles dans les environnements DevOps, car ils permettent aux équipes de créer facilement des processus reproductibles pour les tests et le déploiement en production.
F5 prend non seulement en charge l’utilisation de CFT pour déployer des instances BIG-IP, mais fournit également plusieurs fichiers CFT de référence pour les déploiements BIG-IP courants.
L’ajustement des paramètres dans les fichiers CFT de référence permet de déployer par script des solutions BIG-IP pour différents scénarios, notamment la mise à l’échelle automatique des instances BIG-IP ou des serveurs back-end situés derrière celles-ci, ainsi que pour des scénarios plus complexes. En automatisant les déploiements reproductibles dans AWS à l’aide de CFT et de solutions F5, il est possible de déployer rapidement et sans effort des environnements applicatifs complexes.
Documentation
Bien entendu, la technologie n’est guère utile si elle ne peut pas être pleinement exploitée. C’est pourquoi F5 fournit une documentation complète. Une documentation est disponible sur la plateforme BIG-IP en général, ainsi que sur les spécificités d’une instance BIG-IP dans AWS. Pour toute question, un bon point de départ est Ask F5.
L’onglet Documentation fournit des informations sur des modules BIG-IP spécifiques, ainsi qu’une section entière consacrée à l’intégration avec AWS. Le portail AWS propose une interface de recherche donnant accès à de la documentation, des articles, la communauté et des ressources, depuis la prise en main jusqu’aux scénarios de déploiement complexes.
Pour les questions auxquelles la documentation ne répond pas, la communauté F5 DevCentral est là pour vous apporter des réponses et de l’aide.
Conclusion
La transition vers l’adoption du cloud public n’est plus un simple phénomène de mode, mais une tendance durable dans le secteur informatique. Amazon Web Services, le fournisseur de services de cloud public le plus important et le plus complet au monde, permet aux entreprises de développer, tester et déployer des applications sans aucun équipement sur site. F5 a intégré ses services avancés de mise à disposition d’applications à l’écosystème AWS et les a configurés pour rendre les applications plus rapides, plus intelligentes et plus sûres dans les environnements cloud AWS.
PUBLIÉ LE 14 MARS 2017