Princípios fundamentais do Edge 2.0
Por Rajesh Narayanan, Michael Wiley
Introdução
A definição da borda sempre esteve interligada à evolução da arquitetura dos data centers. Na última década, houve uma rápida transformação na arquitetura da infraestrutura empresarial, que se expandiu dos data centers locais para as atuais arquiteturas de nuvem distribuída. Reconhecemos o Edge 2.0 como uma mudança tecnológica que permitirá que as aplicações aproveitem uma arquitetura de nuvem distribuída.
Cada pessoa, organização ou entidade tem uma interpretação diferente da borda. Alguns podem considerar que a borda é uma torre de telefonia celular, enquanto outros podem dizer que seu dispositivo móvel é a borda. Para os provedores de serviços em nuvem (CSPs), a borda é uma infraestrutura gerenciada que se integra perfeitamente ao back-end. Para aplicações militares, a borda é o teatro de operações — seja em terra, no mar ou no ar. Sempre que lemos sobre a borda, a interpretação geralmente se resume aos recursos de computação, rede e armazenamento da infraestrutura e/ou à sua localização.
Mas também vemos o Edge 2.0 como a experiência que ele proporciona a todas as partes interessadas do ecossistema, e não apenas como o ativo de infraestrutura ou sua localização.
Este documento descreve quais devem ser as funcionalidades do Edge 2.0, independentemente de sua infraestrutura física ou virtual, ou de onde ele esteja localizado ou instanciado. O objetivo não é explicar como criar uma aplicação distribuída melhor, mas destacar os recursos que devem estar presentes no Edge 2.0 para viabilizar a criação das aplicações distribuídas mais adequadas a um requisito específico.
“O Edge 2.0 diz respeito à experiência, não à infraestrutura nem à sua localização.”
O que é o Edge 2.0?
Do ponto de vista de uma entidade que reside nessa nuvem distribuída, a borda está onde quer que a entidade esteja localizada no momento. Assim, propomos uma definição de Edge 2.0 centrada na experiência, não vinculada apenas à localização ou ao tipo da infraestrutura, nem à entidade que a controla.
O foco do Edge 2.0 é aprimorar as experiências centradas em aplicações, operações e desenvolvedores. O Edge 2.0 deve contemplar as metapropriedades da aplicação (como SLAs e SLOs), adaptando-se às mudanças em suas necessidades. O Edge 2.0 deve ser simples de operar e evitar que as equipes de operações precisem criar novas automações para cada aplicação distribuída. O Edge 2.0 deve reduzir os obstáculos enfrentados pelos desenvolvedores ao desenvolver e implantar aplicações distribuídas em escala, oferecendo suporte integrado a segurança, governança e objetivos de nível de serviço.
Como exemplo, consideremos uma aplicação bancária. O objetivo do Edge 2.0 não é aprimorar a lógica de negócios da transação, mas torná-la mais segura, rápida e privada, disponível em todas as regiões geográficas (conforme necessário) e capaz de aumentar ou reduzir sua escala conforme necessário para atender aos objetivos de negócios.
Conceitos e afirmações
A seguir, são apresentados os principais conceitos e afirmações deste artigo:
- Edge centrada na experiência: estabelece uma base para a Edge 2.0 em torno da experiência que ela proporciona, em vez de um ativo ou de suas localizações.
- Considerações de design: especifica as principais considerações de design para uma implementação bem-sucedida da arquitetura Edge 2.0.
- Infraestrutura heterogênea: destaca que projetar para uma nuvem distribuída significa considerar o controle descentralizado da infraestrutura.
- Telemetria como base: enfatiza a telemetria como um componente fundamental que deve ser compatível com todas as camadas da infraestrutura. Sem telemetria, uma estratégia centrada em dados perde força.
- Desafios entre clusters: destaca um desafio fundamental do Edge2.0, que consiste na comunicação entre clusters, em vez de dentro de um mesmo cluster.
- Interfaces adaptativas: apresenta as interfaces adaptativas, oferecendo uma comparação clara com as interfaces declarativas e imperativas.
- Plataforma de Aplicações Edge 2.0 (EAP): apresenta a EAP como uma estrutura que permite à Edge 2.0 se adaptar às necessidades das aplicações.
Tópico(s) não abordado(s)
Há vários tópicos que ainda não abordamos neste artigo:
- Distribuição de dados de aplicações: há muitos subtópicos nessa área, como redes de distribuição de conteúdo (CDNs), distribuição de armazenamento, distribuição de dados, armazenamento em cache etc. Também existem tecnologias emergentes, como tipos de dados replicados sem conflitos (CRDTs). Um framework de Edge 2.0 deve incluir em seu escopo o suporte à distribuição de dados de aplicações.
- Distribuição de funções: O avanço da computação de borda pode ser entendido como o deslocamento das funções e da lógica centrais da nuvem para mais perto do local onde o evento é gerado ou onde os dados estão armazenados. Devido à quantidade significativa de capacidade computacional que está se tornando disponível na borda, agora devemos resolver problemas semelhantes aos normalmente solucionados em arquiteturas de nuvem legadas, caso queiramos aproveitar essa capacidade. Por exemplo, redes de sobreposição, cargas de trabalho de middleware e outros tipos de cargas de trabalho interligadas e mais complexas do que os casos de uso simples observados nos estágios iniciais da computação de borda — como storlets, que são fluxos simples e sem estado executados próximos aos dados.
- Provavelmente há outras áreas que não foram abordadas. O objetivo do framework é ser extensível, de modo que novas responsabilidades possam ser adicionadas conforme necessário.
Evolução da Edge
A Figura 1 ilustra melhor a evolução conjunta das arquiteturas de Edge e de data centers. O Edge 1.0 e o 1.5 baseavam-se no conceito de um site de origem e na transferência de dados e serviços da origem para o consumidor. O Edge 1.0 consistia na implantação de uma infraestrutura de internet voltada principalmente à otimização do uso da largura de banda por meio do armazenamento distribuído de conteúdo em cache, também conhecido como redes de distribuição de conteúdo. As CDNs são um padrão de projeto fundamental, pois o volume total de conteúdo a ser transferido sempre será maior do que a largura de banda disponível.
À medida que os custos de CPU e memória caíam rapidamente, surgiram fazendas de computação junto aos nós de CDN. Os aplicativos passaram a ser consumidos como serviços por meio de arquiteturas orientadas a serviços (SOA). Daí a referência ao Edge 1.5 como Rede de Distribuição de Serviços.
“Cada entidade se considera na borda, do seu próprio ponto de vista.”
Uma característica comum do Edge 1.0 e do Edge 1.5 é a ideia de um site de origem. Antes do crescimento da tecnologia móvel, pessoas, dispositivos e objetos basicamente baixavam conteúdo ou atuavam como consumidores do serviço. O site que originava o serviço ainda era diferente daquele do consumidor.
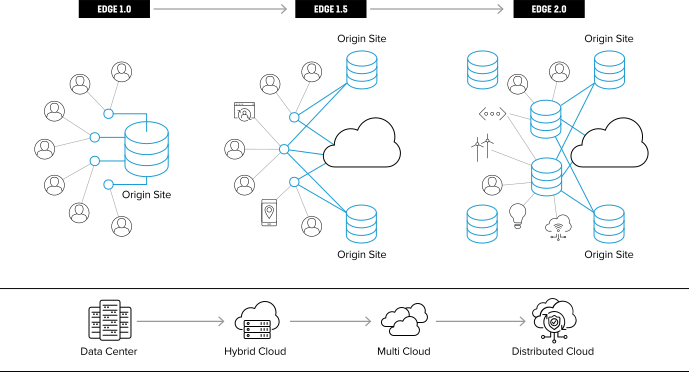
No Edge 2.0, porém, qualquer entidade pode atuar como um site de origem ou como consumidora. O fluxo de tráfego mudou. Pessoas, celulares e dispositivos produzem dados ativamente ao enviar conteúdo ou gerar dados periódicos. Os aplicativos estão se tornando consumidores à medida que passam a depender de outros aplicativos. Todas as entidades podem atuar como produtoras ou consumidoras de um serviço — APIs, pessoas, dispositivos de IoT ou aplicações web, de back-end e headless. Do seu próprio ponto de vista, cada entidade na infraestrutura considera que está na borda.
A nuvem distribuída é o estágio mais recente da evolução do data center. A computação tornou-se verdadeiramente onipresente, desde dispositivos móveis até sua incorporação em objetos do cotidiano conectados à rede. Paralelamente, as arquiteturas de software evoluíram para viabilizar aplicações distribuídas e escaláveis.
Consequências da edge computing: maior complexidade
A abundância e a hiperdistribuição de recursos de computação e armazenamento em todos os lugares criaram uma oportunidade para a rápida transformação digital das empresas. Mas essa rápida evolução tem suas consequências.
A maioria das empresas geralmente é composta por uma infraestrutura heterogênea, com ambientes não uniformes. O dimensionamento eficaz desses ambientes exige orquestração e automação complexas dos sistemas implantados. Mudanças rápidas nas necessidades da aplicação, como alterações nos requisitos de CPU e largura de banda, aumentam a complexidade das operações em uma nuvem distribuída. Isso sobrecarrega as equipes de operações, que podem não estar devidamente preparadas para responder com eficiência às mudanças nas necessidades da aplicação ou do cliente final.
As consequências desses problemas resultam em complexidade operacional, o que neutraliza quaisquer ganhos potenciais para uma empresa em processo de transformação digital.
A seguir, destacamos alguns dos problemas e artefatos interligados decorrentes da complexidade.
“Os ganhos da transformação digital são anulados se a tecnologia for operacionalmente complexa.”
Os modelos de segurança precisam acompanhar as mudanças constantemente
As nuvens híbridas resultam em uma superfície de ataque maior, que pode ser comprometida por diversos vetores de ataque. Diferentes casos de uso criam vários desafios de segurança e, à medida que a infraestrutura evolui, precisamos nos adaptar constantemente. Assim, a questão que prevemos é: apenas as recomendações tecnológicas mudarão com frequência ou os padrões de projeto para implementar a segurança também mudarão?
Veja alguns dos problemas das abordagens existentes:
- O Perímetro Definido por Software (SDP) não é facilmente escalável, pois as soluções mais populares são baseadas em agentes, o que dificulta implantações operacionais simples.
- A implementação do Acesso à Rede de Confiança Zero (ZTNA) muitas vezes é inviável, pois as soluções de ZTNA exigem uma série de serviços de produção implantados, como inspeção de tráfego, gerenciamento centralizado de logs, PKI global, gerenciamento de identidades, entre outros.
- O Secure Access Service Edge (SASE) combina rede como serviço e segurança como serviço, reunindo uma sopa de letrinhas de diversas tecnologias cuja implementação não é trivial. Além disso, o SASE tende a se concentrar em redes de longa distância definidas por software (SD-WAN), atendendo a uma pequena parcela dos casos de uso de borda de rede empresarial.
- As disparidades entre as infraestruturas de diferentes provedores de nuvem pública e os modelos de segurança já complexos, como o Gerenciamento de Identidades e Acessos (IAM), muitas vezes levam as equipes a adotar medidas de proteção fragmentadas para cada provedor e configurações multinuvem difíceis de gerenciar.
“A segurança é um problema de estar sempre correndo atrás do prejuízo.”
Desafios da automação
Um dos principais desafios da hiperdistribuição da computação de baixo consumo e baixo custo disponível na borda é a capacidade de orquestrar e programar a infraestrutura de maneira uniforme. As equipes de operações enfrentam dificuldades para dimensionar e dar suporte a aplicações que utilizam a nuvem distribuída, pois elas normalmente incluem tecnologias heterogêneas com diferentes requisitos de administração.
Embora plataformas de automação como o Terraform ofereçam recursos sofisticados para personalizar a automação, as equipes de operações ainda precisam manter scripts para diversas combinações: por exemplo, cinco configurações diferentes de computação, quatro tipos diferentes de firewall e três tipos de balanceador de carga. O custo humano de gerenciar e manter os scripts de automação não é escalável.
Isso faz com que o cliente de infraestrutura continue interagindo com as equipes de operações por meio de sistemas baseados em chamados, que representam uma barreira à automação dos fluxos de trabalho existentes. A central de serviços fica sobrecarregada com chamados e precisa priorizar a segurança e a estabilidade em detrimento da agilidade.
Proliferação de APIs
As arquiteturas de microsserviços já se tornaram o método padrão para criar novas aplicações com a evolução rumo à multicloud. As APIs são publicadas e podem ser instanciadas quando e onde necessário, levando à proliferação de APIs. A descoberta, a conectividade e o gerenciamento autônomo dessas APIs tornam-se um grande desafio.
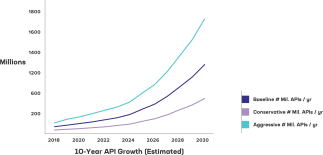
É necessária uma mudança de paradigma para lidar com a proliferação de APIs. Nossos modelos internos demonstram que mesmo premissas moderadas para parâmetros como o número de desenvolvedores de APIs no mundo, o número de APIs desenvolvidas por cada desenvolvedor por ano e a vida útil das APIs resultam em centenas de milhões (se não bilhões) de APIs simultaneamente ativas até 2030 (Figura 2). O Relatório de 2021 sobre a proliferação de APIs apresenta uma visão abrangente desse tema emergente.
Baixa visibilidade do sistema de ponta a ponta
O aumento da complexidade exige que as empresas viabilizem uma visibilidade granular e significativa de todo o sistema, de ponta a ponta. Em ambientes de nuvem distribuída, as aplicações abrangem várias pilhas de infraestrutura heterogêneas, gerenciadas por entidades distintas.
Além disso, atualmente, nenhuma das operadoras tem incentivos para disponibilizar a telemetria nativa de sua infraestrutura aos clientes corporativos. Na prática, as empresas operam às cegas ao implantar aplicações em uma nuvem distribuída e precisam recorrer a diversas ferramentas de observabilidade. Para suprir essas lacunas de visibilidade, essas ferramentas geralmente são fornecidas por diferentes empresas e atuam em pontos distintos da infraestrutura ou das pilhas de aplicações.
Métricas de infraestrutura não padronizadas agravam os problemas dentro de uma empresa. Normalmente, as métricas não são unificadas devido a silos operacionais e a outros fatores, como a falta de uniformidade da infraestrutura entre diferentes ambientes. Por exemplo, as métricas variam entre os provedores de nuvem pública, e as tecnologias de data centers locais também não seguem nenhum padrão de métricas.
“Muitas empresas operam às cegas devido à falta de uma “prática de observabilidade”.”
Resultado de negócios: experiência prejudicada
As cargas de trabalho que geram receita e os sistemas de missão crítica normalmente utilizam a maior parte dos recursos operacionais e do orçamento disponíveis em uma empresa. Enquanto isso, projetos menores, embora menos complexos, tendem a representar a maior parte das aplicações da empresa. A Figura 3 ilustra essa situação como uma distribuição de cauda longa do número de projetos que uma empresa provavelmente terá em comparação com sua complexidade operacional.
Embora aplicações menores possam ter menor complexidade operacional, os processos e fluxos de trabalho de operacionalização ainda são manuais em muitos casos, e pode levar semanas para que os chamados de serviço passem com sucesso por várias equipes operacionais. Por exemplo, a implantação de uma aplicação que exija recursos de rede dedicados com políticas de segurança granulares pode primeiro exigir que as equipes globais de segurança definam as aprovações das políticas de segurança. Em seguida, o chamado de serviço pode ser encaminhado à equipe de redes para o planejamento das configurações necessárias de sub-rede e roteamento. Por fim, pode ser necessário que outra equipe operacional, responsável pelo gerenciamento de firewalls, valide as regras de firewall.
Agora, vamos imaginar que a complexidade descrita acima precise ser tratada para cada aplicação implantada em uma nuvem distribuída, na qual a empresa não possui nenhuma parte da infraestrutura subjacente. O enorme volume de pequenos projetos ou aplicações que precisam ser integrados e receber suporte torna inviável para as equipes de operações atender a todos os projetos, criando um desafio de priorização e uma oportunidade para o autoatendimento.
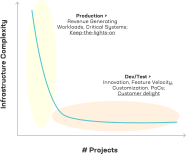
Esse problema de priorização é especialmente perceptível porque os investimentos das equipes de infraestrutura se concentram no suporte a sistemas críticos e geradores de receita, deixando pouco tempo ou orçamento para projetos totalmente novos, que exigem seu próprio ciclo de desenvolvimento, testes e preparação antes de entrarem em produção. Isso reduz a capacidade e os investimentos voltados à agilidade na entrega de funcionalidades, à personalização e à inovação que viabiliza novos produtos, culminando na estagnação da empresa e de suas ofertas.
“As equipes de infraestrutura estão soterradas em complexidade.”
Espaço de soluções de edge
A evolução do ecossistema de edge amplia significativamente o espaço de soluções, oferecendo a oportunidade de enfrentar esses desafios com uma plataforma de aplicações.
A Figura 4 mostra o espaço de soluções do Edge 2.0. Aqui, afirmamos que tudo o que se enquadra em uma arquitetura de nuvem distribuída constitui a totalidade do espaço de soluções.
Assim, no contexto do espaço de soluções, o Edge 2.0 deve proporcionar a experiência desejada por todos os seguintes públicos:
- Todas as entidades que fazem parte do escopo da solução — aplicativos, pessoas e dispositivos que atuam como consumidores, ou aplicações de backend web e headless que compõem os serviços.
- As equipes de SRE e os responsáveis por esses aplicativos, preservando as proteções de segurança e conformidade regulatória esperadas da infraestrutura.
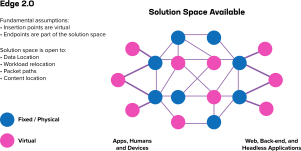
O Edge 2.0 será operacionalmente simples, seguro e em conformidade, além de proporcionar uma experiência de alta qualidade a todas as entidades do ecossistema que participam dele.
Considerações de design do Edge 2.0
Seguro por padrão
Uma nuvem distribuída agrava esse problema de segurança em escala, à medida que o número de endpoints aumenta exponencialmente. Em uma escala tão ampla, a complexidade da implementação de uma solução também aumenta. A postura de segurança deve partir do princípio de que o ambiente no qual a aplicação está implantada já foi comprometido. Da mesma forma, a infraestrutura não deve confiar em nenhuma aplicação executada nela.
A essência dessas ideias está expressa nos conceitos da mentalidade de Confiança Zero, e o exemplo BeyondCorp1 demonstra esses conceitos no caso de uso de acesso a aplicações. Daqui em diante, o Edge 2.0 amplia esse modelo com base nos cinco princípios fundamentais a seguir:
- A identidade é fundamental: no Edge 2.0, a identidade está profundamente integrada, e cada instância de entidade tem sua própria identidade globalmente exclusiva, além de seu lugar na hierarquia organizacional e seu nível de privilégio. A identidade deve ser uma consideração essencial não apenas para o tráfego norte-sul, mas também internamente para o acesso leste-oeste.
- Privilégio mínimo: as ações permitidas a um agente devem se limitar apenas àquelas necessárias para que ele desempenhe sua função no sistema. Um exemplo é restringir, com base na especificação do projeto, o subconjunto de cargas de trabalho que podem se comunicar com o servidor de banco de dados.
- Autenticação contínua: qualquer declaração feita por um ator do sistema deve dispor de um meio de verificação e ser explicitamente verificada sempre que ocorrer. A autenticação não deve se basear apenas em mecanismos explícitos, como segredos compartilhados ou cadeias de confiança, mas também deve considerar padrões implícitos de comportamento e metadados contextuais.
- Monitoramento e avaliação constantes: as ações de todos os agentes do sistema devem ser monitoradas, reforçando o papel fundamental das tecnologias de coleta e armazenamento de dados em uma arquitetura Edge 2.0. Além disso, essas atividades devem ser avaliadas continuamente para detectar e mitigar tentativas de realizar ações proibidas ou perigosas. A avaliação deve ocorrer em uma escala próxima do tempo real, o que implica o uso amplo de técnicas de automação e aprendizado de máquina.
- Presuma a violação: considerando os recursos disponíveis para os adversários sofisticados de hoje, deve-se presumir que qualquer sistema tenha sido comprometido de alguma forma. Consequentemente, as políticas totalmente determinísticas baseadas nas identidades das cargas de trabalho e dos usuários, que impõem o acesso baseado em privilégios representado por a e b, muitas vezes são insuficientes para impedir todos os ataques. Portanto, um sistema Edge 2.0 plenamente maduro também deve ser capaz de realizar avaliações de risco e benefício em tempo real, com base em monitoramento e avaliação contínuos.
“Sempre presuma que a infraestrutura já esteja comprometida. O desafio, então, é implantar uma aplicação nela com segurança.”
Oferece observabilidade nativa
O Edge 2.0 deve integrar a telemetria como um componente de primeira classe nas camadas mais profundas da pilha de infraestrutura, oferecer uma maneira simples e escalável de coletar telemetria entre as diferentes camadas da infraestrutura e disponibilizá-la em uma plataforma comum. Isso ajuda as equipes de observabilidade a consultar o “estado da infraestrutura” conforme necessário. Assim, as equipes de aplicações podem se concentrar na lógica de negócios sem precisar instrumentar explicitamente suas pilhas de aplicações.
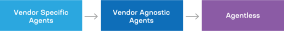
O estado atual da tecnologia de observabilidade tem sido, em grande parte, específico de cada fornecedor e proprietário. Isso levou muitos agentes específicos de fornecedores a coletarem sinais semelhantes, competindo por recursos caros de memória e CPU.
O próximo passo lógico é usar um coletor de telemetria independente de fornecedor, que permita transmitir dados de infraestrutura e tráfego para uma plataforma de dados centralizada.
Muitas equipes de produto têm dificuldade para justificar o investimento em instrumentação, pois o esforço precisa estar associado a uma oportunidade de receita. A infraestrutura deve ser instrumentada como qualquer outra função ou processo de negócios, porque a equipe precisa entender seu comportamento para otimizá-la de acordo com os objetivos da empresa. Portanto, o debate deveria se concentrar mais no que deve ser priorizado para instrumentação, e não na necessidade de instrumentar.
Para obter medições mais granulares e precisas do comportamento da aplicação, prevemos que a instrumentação será antecipada (“shift left”), sendo acionada durante a codificação — Figura 5.
“A instrumentação deve ser antecipada.”
Oferece suporte a interfaces adaptativas
Em consonância com a nuvem distribuída, ao analisarmos algumas camadas mais a fundo, cada nuvem dentro de seu escopo (local ou global) tem seu próprio gerenciador, administrador, orquestrador e muito mais. Cada uma opera de forma independente, tomando suas próprias decisões, mas disponibilizando interfaces para que outras entidades as utilizem conforme necessário.
Assim, a noção de nuvem distribuída consiste, em essência, na administração e no controle descentralizados. Não há como fugir desse fato, e é importante reconhecê-lo para compreender melhor as nuances entre interfaces adaptativas, declarativas e imperativas.
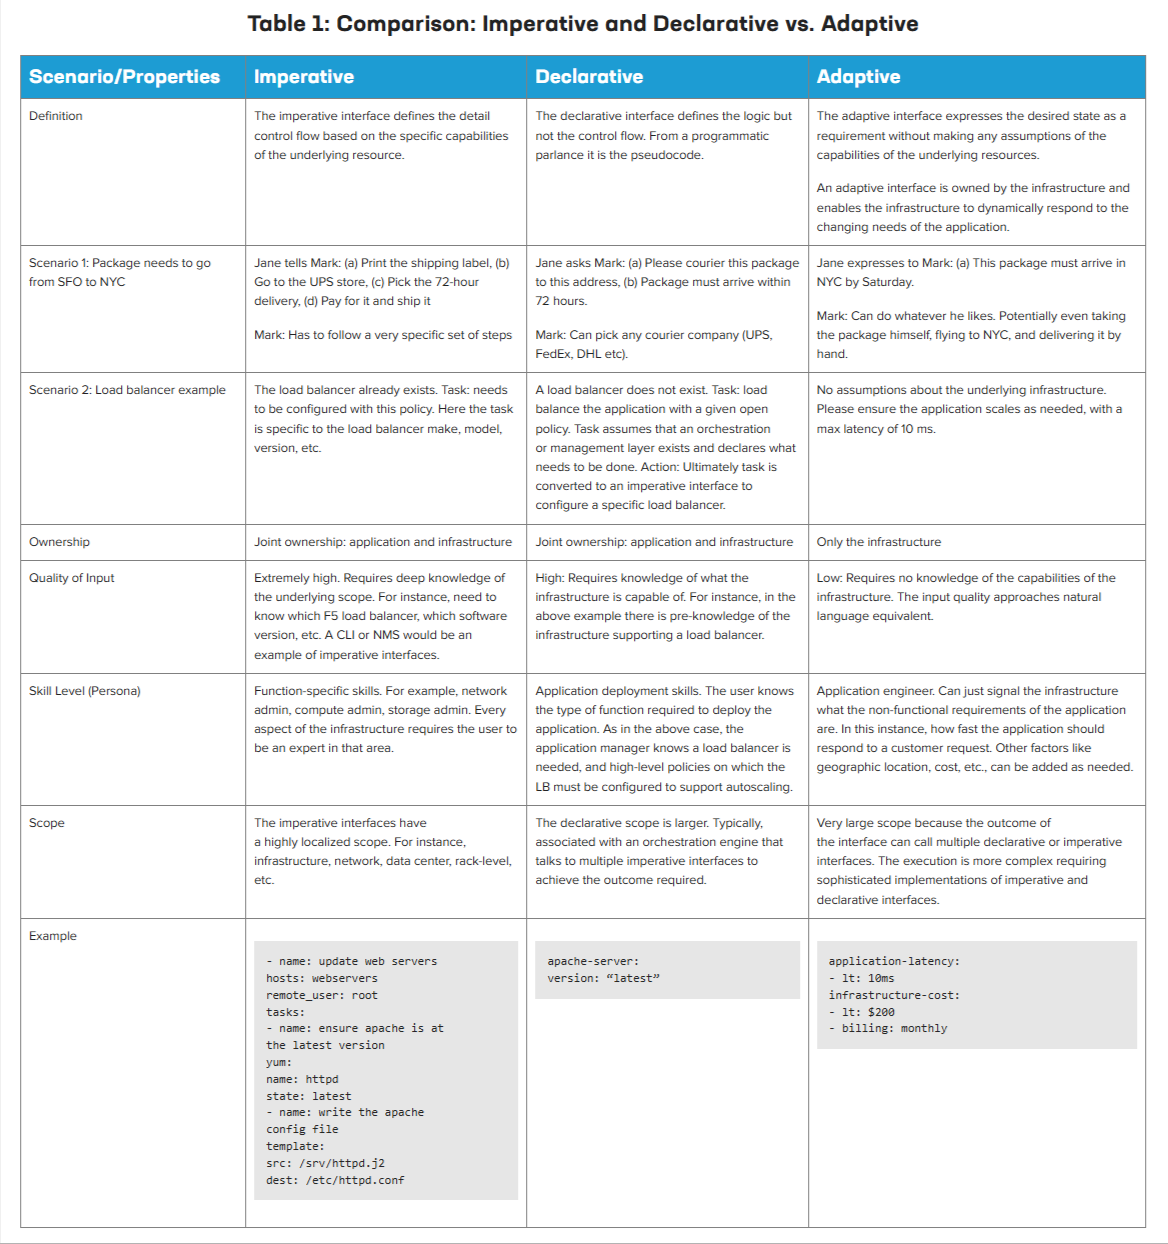
Para utilizar de forma eficaz a infraestrutura do Edge 2.0, as interfaces imperativas e declarativas não são suficientes, pois ainda dependem de artefatos criados manualmente, que são essencialmente estruturas estáticas e não se adaptam com rapidez suficiente a condições que mudam rapidamente.
Precisamos adotar uma abordagem baseada em resultados, e os sistemas devem ser inteligentes o suficiente para ajustar as políticas em toda a infraestrutura (de ponta a ponta) a fim de alcançar esses resultados. Chamamos isso de interfaces adaptativas.
Para deixar claro: interfaces imperativas, declarativas e adaptativas não são mutuamente excludentes:
Imperativa: É bastante prescritiva e define detalhadamente uma série de ações para alcançar o estado desejado. A configuração de um roteador, por exemplo, é uma ação imperativa. No cenário acima, as ações prescritivas serão precisas — qual data center, quanta CPU/memória, a largura de banda necessária, rotas específicas e muito mais. A qualidade dos dados de entrada do modelo é muito alta e, portanto, exige conhecimento e experiência mais aprofundados sobre a infraestrutura. Espera-se que tanto o modelo quanto a estrutura da infraestrutura sejam conhecidos.
Declarativo: A particularidade da abordagem declarativa é que ela se concentra em descrever o estado desejado, em vez das ações necessárias para alcançá-lo. A qualidade dos dados de entrada é menor, embora ainda seja necessário que a aplicação conheça pelo menos a estrutura da infraestrutura subjacente.
Adaptativa: Distingue-se das abordagens imperativa e declarativa. Uma interface adaptativa concentra-se no objetivo ou na meta desejada, e não no estado. O propósito da interface adaptativa é captar o objetivo da parte interessada que deseja implantar a aplicação, em vez de se concentrar em um conhecimento prévio do sistema subjacente. A abordagem adaptativa é diferente porque não pressupõe conhecer os recursos da infraestrutura subjacente. Não há restrições quanto a como “realizar a tarefa” e, portanto, ela se sustenta por si só.
Com a abordagem adaptativa, o nível de detalhamento da entrada é baixo e se aproxima da linguagem natural. Os responsáveis pelos aplicativos podem enviar uma solicitação informando ao controlador da infraestrutura o resultado esperado, em vez de precisar declarar a capacidade necessária ou configurar especificamente um recurso.
“Proclamação: declaramos que é imprescindível que o Edge 2.0 ofereça suporte a interfaces adaptativas.”
Resolve o problema entre clusters
Uma nuvem distribuída, por definição, comporta todos os tipos de arquitetura de aplicações: monolítica, de microsserviços ou sem servidor. Independentemente da arquitetura, as aplicações usam APIs para oferecer os serviços.
Os problemas de descoberta de APIs, conectividade e segurança de rede são, em grande parte, resolvidos com o uso de uma malha de serviços, mas ela só resolve esses problemas dentro do cluster (intracluster).
As aplicações Edge 2.0, por outro lado, utilizam APIs em uma infraestrutura de nuvem hiperdistribuída, essencialmente um ambiente multicluster. Novas aplicações são desenvolvidas com APIs que atravessam fronteiras organizacionais e geográficas. Algumas dessas APIs podem ser privadas ou de parceiros e estar protegidas por várias camadas de firewalls, sem uma rota explícita entre elas, mesmo que possam ser descobertas. Esse problema de clusters heterogêneos (intercluster) ainda não conta com uma solução prática que seja elegante, leve, escalável e segura.
Abordamos as APIs em detalhes no relatório API Sprawl de 2021² e respondemos nele a muitas das perguntas que podem surgir. A Figura 6 mostra a diferença entre intercluster e intracluster.
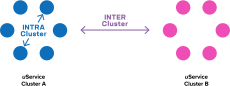
Intracluster: Em uma arquitetura monolítica, pode haver pouquíssimas APIs expostas, com a comunicação interna entre os módulos ocorrendo por meio de outros métodos de comunicação entre processos. Já uma arquitetura de microsserviços é dividida em dezenas, ou até centenas, de APIs.
Seja qual for o caso, cada cluster de aplicações é desenvolvido e gerenciado de acordo com diretrizes bem definidas. Por exemplo, em arquiteturas de microsserviços, uma equipe pode usar qualquer tipo de malha de serviços — Istio, Linkerd, Aspen Mesh ou outras. Cada abordagem tem seus próprios meios de gerenciar e controlar as APIs dentro do cluster, ou seja, intracluster.
Há muitas soluções disponíveis, e o objetivo do Edge 2.0 não é reinventar a roda nem forçar organizações ou equipes de desenvolvimento a adotar mais uma nova tecnologia.
Entre clusters: À medida que aumenta o número de serviços disponibilizados por meio de APIs, novos aplicativos são criados usando serviços já desenvolvidos ou adotados por diferentes equipes de aplicativos da empresa, pois não há necessidade de reinventar a roda.
Novas aplicações também estão sendo desenvolvidas por meio de diferentes combinações de APIs públicas e privadas. Do ponto de vista da arquitetura, as aplicações modernas utilizam serviços fornecidos por outros clusters. Em uma nuvem distribuída, esses clusters são implantados globalmente e, portanto, podem estar localizados em qualquer infraestrutura capaz de hospedar a aplicação ou fazer parte do cluster da aplicação.
Escopo de um cluster de aplicações
Reiterando, o escopo de um cluster de aplicações não se limita apenas ao âmbito de uma organização. Os clusters podem abranger quaisquer duas redes, aplicações, silos organizacionais ou até mesmo duas empresas.
O escopo abrange toda a gama de permutações e combinações possíveis, aumentando exponencialmente a complexidade das operações. A Figura 7 mostra as permutações de tráfego no escopo da implantação de aplicações.
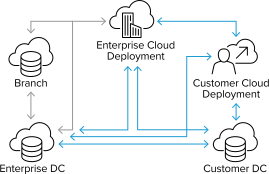
Uma empresa típica terá diferentes arquiteturas de aplicações. Pode haver diferentes tipos de malha de serviços, uma aplicação Web 2.0 baseada em arquitetura orientada a serviços ou uma implantação de software monolítico, dependendo da equipe responsável pelo desenvolvimento e pela implantação. Assim, as APIs ficam espalhadas por toda a empresa, sejam elas APIs privadas ou APIs públicas utilizadas pela organização. Esse problema ainda não foi resolvido. A comunicação entre APIs em vários locais é essencial, mas continua sendo um problema cuja solução é difícil de alcançar em empresas de qualquer porte.
Existem várias soluções para gerenciar APIs dentro de um cluster (por exemplo, controlador de ingresso, gateway de API, entre outras), mas a comunicação de APIs entre clusters ainda não conta com uma solução prática, escalável e segura. Portanto, restringimos o escopo do controle e gerenciamento unificados de APIs às questões entre clusters.
Proporciona autonomia
Um valor pouco reconhecido da nuvem é a autonomia que ela oferece ao “consumidor de nuvem”. Empresas e empreendedores podem criar suas próprias infraestruturas sob demanda, desfrutando de algo próximo ao controle total.
O princípio fundamental de design que uma plataforma Edge 2.0 deve seguir é proporcionar uma experiência autônoma ao cliente de nuvem, ao mesmo tempo que implementa as proteções adequadas. Como as entidades podem surgir em qualquer infraestrutura (confiável ou não confiável), essas proteções devem ser implementadas de modo a não sobrecarregar a unidade de negócios nem a equipe de DevOps responsável pelo desenvolvimento da aplicação.
Resumo dos princípios
O desafio emergente com o Edge 2.0 será o de descoberta, identidade, confiança e observabilidade entre diversos serviços.
Mesmo em empresas de médio porte, o número de APIs produzidas anualmente seria grande. Como as equipes descobrem esses serviços dentro da empresa? Ou, ainda, como podem saber se os serviços continuam válidos e quem é responsável por eles? Elas podem ter certeza de que se trata de um serviço validado e com uma relação de confiança estabelecida? O problema se agrava quando as equipes querem consumir serviços criados por clusters localizados fora dos limites da empresa, como provedores de SaaS ou aplicativos executados em dispositivos de borda totalmente fora do controle administrativo das equipes de infraestrutura da empresa.
Plataforma de Aplicações Edge 2.0
Considerando os desafios apresentados nas seções anteriores, precisamos enxergar toda a nuvem distribuída como uma plataforma. Em um nível mais abrangente, definimos o objetivo da solução: descobrir de forma autônoma (sem intervenção humana), dimensionar e proteger aplicações distribuídas em uma infraestrutura descentralizada.
Em essência, podemos descrever a responsabilidade da Plataforma de Aplicações Edge 2.0 (EAP) da seguinte forma:
- Descoberta, identidade e confiança de APIs
- Agendamento e orquestração de infraestrutura
- Conectividade segura de aplicações
“Descubra, dimensione e proteja aplicativos distribuídos de forma autônoma em uma infraestrutura descentralizada.”
Escopo do EAP
A infraestrutura é a totalidade do espaço de soluções no qual elementos de infraestrutura podem surgir e desaparecer continuamente. A propriedade da infraestrutura e de seus recursos, por um lado, e a administração e o controle desses recursos, por outro, são conceitos distintos. O proprietário de uma infraestrutura pode atribuir uma infraestrutura específica ou uma instância dela a outra organização, que passa a gerenciá-la e configurá-la, ou pode retomar o controle conforme necessário. A organização responsável por gerenciar e configurar os elementos pode, por sua vez, atribuí-los a projetos ou aplicações específicos. Esse conceito não é novo; por exemplo, os provedores de serviços em nuvem oferecem controle administrativo hierárquico, que pode ser usado pelas equipes de TI de uma empresa para disponibilizar Infraestrutura como Serviço (IaaS) a unidades de negócios internas, equipes etc. A principal questão para o Edge 2.0 é como implementar isso em larga escala em uma nuvem hiperdistribuída, que representa o estado atual e futuro da infraestrutura de borda.
É aqui que o escopo do EAP entra em cena. A Figura 8 abaixo mostra o escopo do EAP no contexto de diferentes tipos de interfaces. Cada EAP realiza a orquestração em seu escopo local usando interfaces declarativas e imperativas. Neste caso:
- As interfaces declarativas/imperativas seriam as APIs da AWS, as APIs do Azure etc.
- As interfaces adaptativas seriam totalmente novas e precisariam ser definidas caso a caso.
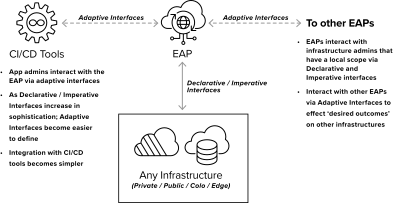
Para aproveitar os benefícios da nuvem distribuída, a EAP deve ser capaz de utilizar todos os nós e entidades disponíveis por meio de uma nuvem distribuída. A visão é que cada EAP se torne equivalente ao conceito de sistema autônomo3 das redes IP, mas na camada de aplicação.
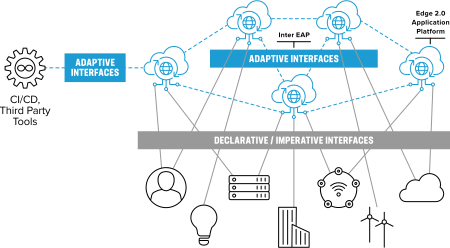
Reunindo todos esses elementos (Figura 9 abaixo), podemos agora construir uma visão de alto nível de como várias EAPs podem ser implantadas em uma infraestrutura de nuvem descentralizada, interagindo entre si de forma autônoma.
As interfaces adaptativas também facilitam a integração de CI/CD e de outros aplicativos de gerenciamento do ciclo de vida das aplicações com a nuvem distribuída. As plataformas de CI/CD podem interagir diretamente com o EAP por meio de interfaces adaptativas simples, especificando apenas o resultado desejado.
É importante observar que a comunicação entre EAPs também pode ser realizada por meio de interfaces adaptativas.
A estrutura de EAP
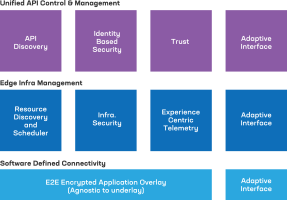
O framework EAP, conforme mostrado na Figura 10, organiza as responsabilidades de acordo com os recursos de cada instância do EAP. A função do EAP é interagir com os controladores da infraestrutura subjacente — seja ela Infraestrutura como Serviço (IaaS), Plataforma como Serviço (PaaS) ou Software como Serviço (SaaS) —, bem como orquestrar e programar os recursos adequados conforme necessário.
Controle e gerenciamento unificados de APIs
O futuro será uma economia orientada por APIs, na qual elas serão mais do que apenas uma abordagem de arquitetura de software simplificada por meio de uma malha de serviços. Uma API se tornará o principal meio pelo qual qualquer entidade participante de uma nuvem distribuída disponibilizará seu serviço.
Conforme estabelecido, o número global de APIs públicas e privadas disponíveis chegará às centenas de milhões, se não aos bilhões, ao longo desta década. As APIs transformarão nossa economia e, portanto, exigirão uma análise mais detalhada do que a EAP deve implementar para dar suporte a essa economia.
Descoberta de APIs
A iminente proliferação de APIs exige que cada API possa ser descoberta dentro e fora da EAP. Com a nuvem distribuída, as APIs podem estar em qualquer lugar, distribuídas por vários clusters.
A premissa subjacente é que o problema de descoberta de APIs é, de fato, uma questão entre clusters. O escopo de uma EAP pode abranger vários clusters de aplicações que utilizam diferentes abordagens de software (de microsserviços a arquiteturas monolíticas), cada um implementando sua própria estratégia de gateway de API. Uma EAP fornece um repositório comum para que todas as APIs sejam registradas e possam ser descobertas dentro de seu escopo, e não apenas dentro de um mesmo cluster. Essa distinção é fundamental para identificar as limitações das estratégias existentes de gateway de API, como, por exemplo, as usadas em uma malha de serviços.
O desafio para a EAP é viabilizar a descoberta de uma API, fornecer a documentação adequada sobre seu uso e gerenciar o ciclo de vida da API para garantir consistência, precisão e controle de versões. A EAP implementa um mecanismo para informar às entidades que utilizam suas APIs o estado atual das APIs específicas em uso. Isso pode ser feito simplesmente definindo datas de expiração ou enviando notificações explícitas por meio de algum sistema de mensagens.
Segurança orientada por identidade
A postura de segurança adotada pressupõe que a infraestrutura na qual uma aplicação está implantada atualmente já esteja comprometida.
O principal pilar para implementar essa postura de segurança é a identidade. Cada endpoint de API deve ter uma identidade globalmente exclusiva. As políticas e os controles de segurança são mantidos separadamente em um repositório central.
As APIs devem ser classificadas como públicas ou privadas, fazendo com que os componentes de segurança da infraestrutura subjacente sejam configurados automaticamente para a API específica.
Todas as comunicações entre aplicativos começam com uma política de negação total. O fato de uma API estar visível não significa que outro aplicativo possa chamá-la. Isso deve ser configurado explicitamente na política de segurança do aplicativo.
“Até mesmo a confiança tem prazo de validade e deve ser verificada periodicamente.”
Confiança: reputação ao longo do tempo
A EAP deve garantir que todas as APIs dentro de seu escopo sejam confiáveis e, ao mesmo tempo, que todas as APIs externas utilizadas por serviços dentro de seu escopo também sejam confiáveis.
“Não dá para provar a confiança; é isso que faz dela ‘confiança’” – De Traitors, da Netflix
A confiança é, essencialmente, uma “reputação construída ao longo do tempo”, e é preciso revalidá-la continuamente para garantir que não tenha caído abaixo de um nível aceitável. Essa abordagem tem se tornado cada vez mais comum na modelagem e implementação da confiança em sistemas, exigindo que ela seja avaliada continuamente, em vez de ser estabelecida de forma estática no início da execução.
A natureza dinâmica da confiança ao longo do tempo pode ser um desafio para algumas empresas que não dispõem de tempo suficiente para estabelecer uma reputação mútua entre seus sistemas e os de terceiros. Tanto a infraestrutura quanto as APIs podem causar estragos se essa reputação não for monitorada de perto.
Supondo que um serviço no escopo da EAP acesse uma API externa, a plataforma deve implementar um mecanismo que permita ao serviço solicitante ter certeza da exatidão da resposta recebida da API externa. O simples fato de a resposta da API parecer válida não significa que ela seja confiável. A resposta pode conter imprecisões devido a problemas de qualidade, ou essas imprecisões podem ter sido inseridas deliberadamente para reduzir a competitividade da empresa. Essa capacidade de atribuir um fator de confiança a cada API, interna ou externa, é exclusiva da arquitetura EAP.
Uma estratégia para implementar a confiança é calculá-la com base na média de um “período” mais recente, em vez de considerar todo o histórico do serviço. É como comparar as avaliações “Mais relevantes” com as “Mais recentes” de um produto na Amazon. O produto pode até ter quatro estrelas, mas, se a maioria das avaliações negativas tiver sido publicada nos últimos seis meses, isso indica uma perda recente de confiança, enquanto um aumento de comentários positivos nesse mesmo período indicaria que o problema foi corrigido ou que a confiança está sendo restabelecida.
O fator de confiança não se limita apenas ao fato de uma API ser ou não uma fonte conhecida de dados falsos ou enganosos. A reputação de uma EAP também dependerá da eficiência com que ela gerencia e atualiza as APIs sob sua responsabilidade. Além disso, a “confiança” também é relativa. O Serviço A pode confiar no Serviço C, mas o Serviço B pode ter uma experiência diferente com o Serviço C.
Gerenciador de Infraestrutura de Borda
Com uma nuvem distribuída servindo de base para a infraestrutura de Edge 2.0, é fundamental que os recursos no escopo de uma EAP sejam fáceis de descobrir, seguros e instrumentados. As recomendações a seguir podem ser consideradas um conjunto de requisitos para os recursos do gerenciador de infraestrutura de borda.
Descoberta e agendamento
Em um EAP, os recursos podem ser alocados conforme necessário. Novos recursos podem chegar ou sair dinamicamente devido à mobilidade. Um EAP também pode enviar ou receber solicitações de outros EAPs para descobrir e alocar recursos conforme necessário em seu nome.
Segurança
Reiterando a postura de segurança: a infraestrutura na qual a aplicação está implantada já está comprometida. Portanto, a EAP deve garantir a segurança da aplicação implantada em seu escopo.
Independentemente do nível administrativo, o framework EAP deve considerar diversos aspectos da segurança, incluindo, entre outros:
Ameaças externas: Por exemplo, ataques distribuídos de negação de serviço (DDoS) e ameaças persistentes avançadas (APT). Essas ameaças podem ser mitigadas com as práticas recomendadas de segurança existentes, como prevenção contra DDoS, uso de firewalls, entre outras. Recomenda-se que essas medidas sejam obrigatórias para todo o tráfego.
Ataque man-in-the-middle: Todo o tráfego deve ser criptografado, sem presumir que a camada de aplicação fará o que é necessário. Isso garante a confidencialidade básica dos dados contra quaisquer dispositivos que monitorem o tráfego e protege a integridade dos dados contra manipulações durante a transmissão.
Ameaças internas: O escopo da camada de infraestrutura deve ser limitado e direcionado principalmente à própria proteção. Recomenda-se impedir que um recurso dentro da infraestrutura lance um ataque interno contra o gerenciador da infraestrutura.
Telemetria centrada na experiência
Se o Edge 2.0 diz respeito à experiência que oferece, e não ao ativo ou à sua localização, é natural que a telemetria também seja centrada na experiência.
A questão é: à experiência de quem estamos nos referindo? Trata-se da experiência de qualquer entidade que resida na infraestrutura ou a utilize para produzir ou consumir um serviço: aplicativos, dispositivos, pessoas, aplicações de back-end, bancos de dados e muito mais. Portanto, o ponto de vista da experiência é o da entidade. Um serviço produzido ou consumido por uma entidade está diretamente relacionado aos recursos de computação, armazenamento e rede alocados a ela.
Mas não basta apenas medir a experiência; também é preciso haver uma forma de corrigi-la.
Qualquer entidade que consuma ou forneça um serviço pode determinar se está obtendo a experiência solicitada. No entanto, em ambientes de nuvem distribuída, pode ser praticamente impossível explicar o que ocorreu na camada de infraestrutura e resultou em uma experiência insatisfatória.
Métricas de alto nível, como utilização da CPU, memória, largura de banda e medições de latência, não são suficientes para determinar por que uma aplicação não está obtendo a experiência solicitada3. As métricas precisam ter granularidade temporal e ser coletadas nas camadas mais profundas da pilha da aplicação e, sempre que disponíveis, em diferentes camadas da pilha de infraestrutura.
Uma estratégia robusta, escalável e expansível de telemetria e dados é fundamental para a EAP. Estratégias de aprendizado de máquina (ML) e inteligência artificial (IA) podem então ser utilizadas para tomar a melhor decisão sobre a reserva de novos recursos ou a otimização do uso dos recursos existentes.
“Analogia com o oceano — as redes de underlay buscam ser como o fundo do oceano: silenciosas, serenas e praticamente imutáveis ao longo do tempo, embora ainda sejam um ambiente escuro e de alta pressão. Uma rede de underlay que tenta reagir a cada requisito de cada aplicação apenas leva as correntes turbulentas e os vórtices da superfície até o leito oceânico.”
Conectividade de aplicações definida por software
Embora se presuma que a conectividade e a acessibilidade sejam problemas já resolvidos, muitas equipes de rede ainda enfrentam dificuldades para adequar sua infraestrutura de rede às necessidades dinâmicas da camada de aplicação. Uma plataforma também deve lidar com esses desafios.
Argumentos para separar o plano de conectividade das aplicações
O problema das abordagens existentes é que traduzimos as necessidades de conectividade das aplicações em conectividade WAN corporativa, especialmente em uma nuvem distribuída. As abordagens para implementar uma rede de nuvem distribuída podem usar diferentes estratégias de SDN ou métodos baseados exclusivamente em roteamento. No entanto, essas soluções dependem muito da homogeneidade da infraestrutura e, por isso, não conseguem oferecer um comportamento consistente.
A única maneira de obter uma rede globalmente escalável, segura e estável para a aplicação é separar o plano de conectividade da aplicação da rede subjacente, conforme discutido a seguir.
Pilha de conectividade proposta
Na evolução rumo a uma arquitetura de nuvem distribuída, o padrão emergente de SDN consiste em orquestrar conjuntamente as redes de infraestrutura subjacente (underlay) e de sobreposição (overlay), além de permitir a programabilidade de ponta a ponta do caminho da aplicação.
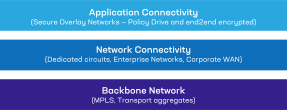
Com o Edge 2.0, precisamos proporcionar esse nível de estabilidade até mesmo ao conectar redes corporativas. Propomos que o plano de conectividade das aplicações seja separado da conectividade da rede corporativa. O padrão de conectividade das aplicações pode ou não seguir a mesma conectividade SDN observada em sobreposições de data centers (por exemplo, VXLAN, NVGRE ou outras) ou padrões de SDN baseados em BGP.
Nem todas as redes foram separadas em overlay e underlay. As equipes de rede agora reconhecem a necessidade dessa programabilidade conjunta como um requisito importante para viabilizar a automação de ponta a ponta, para a qual a separação entre as redes underlay e overlay é fundamental.
Separar o plano de aplicações da rede subjacente e do transporte elimina a necessidade de as equipes de rede responderem ativamente a cada solicitação das aplicações. Seu escopo passa a se limitar ao fornecimento de caminhos robustos, estáveis e bem definidos, com foco na otimização do uso da largura de banda agregada com as menores latências possíveis.
Modelo de Interface Adaptativa
O princípio fundamental de um EAP é que ele seja independente, autônomo e gerencie um subconjunto do espaço geral da solução. No entanto, os EAPs precisam de um meio para se comunicar e oferecer seus recursos ou solicitar recursos de outros EAPs. Essa abordagem oferece várias vantagens.
Interface simplificada
Uma interface baseada em resultados elimina a necessidade de o EAP conhecer os detalhes da outra infraestrutura. Suponha que existam dois EAPs: A e B. Cada EAP tem um escopo local de sua infraestrutura para agendar e reservar recursos. O EAP-A não precisa conhecer os recursos fornecidos pelo EAP-B. Se, por exemplo, o EAP-A não conseguir atender às necessidades da aplicação e precisar de recursos da infraestrutura que estejam no escopo do EAP-B, ele poderá simplesmente informar ao EAP-B o objetivo desejado. Caberá então ao EAP-B acionar interfaces declarativas ou imperativas para reservar, alocar e configurar recursos de seu pool de recursos disponíveis. O EAP-B também é responsável por garantir que os SLOs desse serviço sejam cumpridos em sua infraestrutura.
Embora uma sintaxe comum seja útil para viabilizar um conjunto inicial de APIs adaptativas, a implementação se tornará mais sofisticada e madura ao longo do tempo com o uso de processamento de linguagem natural e IA, reduzindo o nível de qualidade exigido dos dados de entrada.
Recursos do EAP
- Multilocatário: Embora a malha de EAPs mostrada na Figura 9 corresponda a uma única implantação, é possível ter vários EAPs por nuvem. Outro aplicativo poderia se comunicar com um EAP diferente ou com uma malha de EAPs.
- Projetado para escalar: Cada malha é uma rede ponto a ponto (P2P) e pode ser dimensionada horizontalmente. Os EAPs pares podem monitorar de forma independente quais EAPs têm cada tipo de recurso e como se conectar a ele. A IA/ML aprimorará ainda mais a forma como cada EAP aloca recursos dentro de seu próprio escopo ou recorre a outros EAPs conforme necessário.
- Rede integrada: Para que os aplicativos se conectem por toda a nuvem distribuída, o EAP deve oferecer suporte a uma rede integrada independente da infraestrutura subjacente.
Juntando Tudo
A Figura 12 ilustra o papel das diferentes camadas ao implantar uma aplicação em uma nuvem distribuída.
Os principais destaques dessa representação são:
- Cada EAP tem um escopo localizado, e nem todos os seus recursos estão indicados na Figura 10. O EAP deve oferecer suporte às funções de descoberta e agendamento de recursos. Os EAPs agendam recursos por meio da interação com o controlador de infraestrutura apropriado via APIs adaptativas.
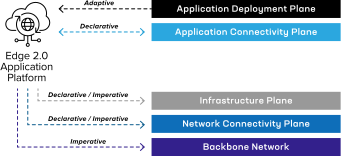
- A conectividade de aplicações não é o mesmo que a conectividade de rede — assim como no modelo sidecar de malha de serviços, os recursos necessários para conectar aplicações em ambientes multinuvem devem fazer parte da infraestrutura da aplicação. Pode-se argumentar que o plano de infraestrutura também fornece conectividade de rede às aplicações e, portanto, deveria estar abaixo da camada de rede. Isso também estaria tecnicamente correto, mas optamos por incorporá-lo ao plano de “conectividade de aplicações”, pois essas são principalmente funções de rede.
- O plano de infraestrutura deve ser considerado separado do plano de aplicação.
- A conectividade de rede é diferente do transporte, pois estamos falando essencialmente de redes roteáveis específicas, separadas da conectividade das aplicações.
- O plano de transporte pode ser entendido como um conjunto de redes de backbone agregadas que podem ser provisionadas, desde que a operadora de telecomunicações disponibilize processos e APIs para conectar a camada de rede acima.
Resumo
Este white paper busca aprofundar alguns aspectos do manifesto original do Edge 2.0. Introduzimos novos temas com o objetivo de informar diferentes partes interessadas, tanto dentro das organizações quanto no setor em geral.
O Edge 2.0 baseia-se no conceito de uma nuvem distribuída, na qual cada entidade pode participar tanto como origem quanto como destino dos serviços. O tema central é que o Edge 2.0 terá como foco a experiência, e não o ativo ou a localização.
A plataforma de aplicações de edge (EAP) é apresentada como um conjunto de recursos que permite implementar o Edge 2.0 em uma nuvem distribuída.
Os detalhes de implementação foram deliberadamente omitidos para apresentar uma visão independente de fornecedor.