Il existe un vieil adage commercial que nous connaissons tous : le client a toujours raison.
Dans cette économie numérique, il s’avère que cet adage doit être reformulé ainsi : Les données du client ont toujours raison.
Permettez-moi d’illustrer cela par une petite histoire.
J’ai récemment décidé d’acheter une nouvelle voiture et de faire reprendre l’ancienne. Je l’avais depuis environ six ans et je ne parcourais qu’environ cinq mille kilomètres par an avec. Je sais que cela paraît fou, mais c’est vrai. Je n’ai quitté l’État avec elle qu’une seule fois, pour aller voir ma famille dans l’Ohio. C’est tout. Sinon, je ne m’éloignais jamais à plus de cinquante kilomètres de chez moi. Je plaisante souvent en disant que je suis cette petite vieille qui ne prend sa voiture que pour aller à l’église le dimanche.
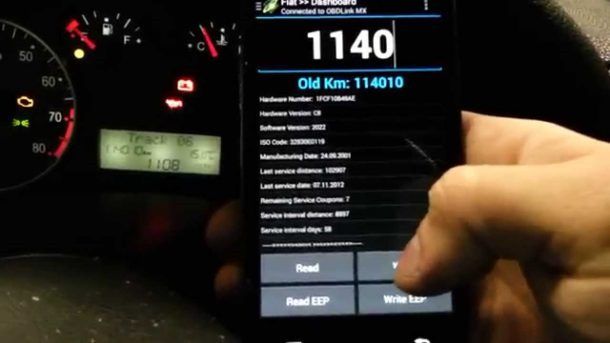
Imaginez donc ma surprise lorsque le concessionnaire m’informe que le kilométrage affiché par mon compteur est inexact — avec un écart de plus de 30 000 miles — en se fondant sur une seule ligne de données figurant dans le rapport d’historique du véhicule qu’il a consulté. Cette ligne indiquait en outre que ma voiture avait été entretenue dans le Dakota du Nord deux ans auparavant.
Cet écart est loin d’être anodin. Le kilométrage affiché au compteur influe sur la valeur de reprise, et toute falsification est illégale (elle peut entraîner une amende et une peine de prison). Comme le compteur réel affichait un kilométrage bien inférieur à celui indiqué dans le rapport, vous imaginez bien que le concessionnaire était quelque peu déconcerté. Il se retrouvait face à un choix peu enviable : me croire, moi qui affirmais n’avoir jamais emmené la voiture dans le Dakota du Nord, ou se fier aux données qui prétendaient le contraire ?
La question s’est rapidement résumée à ceci : « le client a-t-il toujours raison » ou « les données du client ont-elles toujours raison » ?
Il s’avère que ce n’est pas la première fois que quelqu’un pâtit de données erronées dans un rapport sur l’historique d’un véhicule. La plupart des données sont encore saisies manuellement, si bien que des erreurs peuvent se produire. Mais pour les corriger, la personne qui les a saisies doit reconnaître qu’elle s’est trompée. Cela suppose qu’elle se souvienne d’une erreur commise cinq, dix, voire quinze ans auparavant. Encore faut-il que le technicien ayant saisi les données soit toujours là pour reconnaître son erreur.
Au final, je suis reparti avec ma nouvelle voiture, tandis que le concessionnaire devait se charger de faire corriger le rapport. Je suis prêt à parier que beaucoup d’entre vous ont vécu une histoire similaire. Ce genre de situation n’est que trop fréquent dans une économie numérique.
Le facteur humain (et ses erreurs)
Alors que nous dépendons de plus en plus des machines pour résoudre des problèmes, exploiter des données et prendre des décisions, nous devons garder à l’esprit que les données dont nous disposons peuvent être inexactes. À un moment ou à un autre de leur chaîne de conservation, un être humain est intervenu. Or, l’une des vérités fondamentales de la nature humaine est que nous commettons des erreurs. Il suffit qu’un technicien de maintenance du Dakota du Nord ait appuyé sur la mauvaise touche il y a six ans pour que vous vous retrouviez soudain sous le feu des projecteurs, interrogé sur chacun des trajets en voiture que vous avez effectués.
Nous devons veiller à ne pas accorder une confiance excessive aux données sur lesquelles nous nous appuyons pour prendre des décisions. Nous ne devons pas seulement nous méfier des erreurs accidentelles, mais aussi des erreurs intentionnelles. Je vous le garantis : vos données sont de mauvaise qualité.
La conception du DNS est assez remarquable dans sa manière de distinguer les sources faisant autorité de celles qui ne le font pas. En cas de divergence, on sait qu’il est possible de consulter la seule véritable source pour connaître la vérité. Rien de tel n’existe pour les données clients. C’est un signal d’alerte potentiel, car les systèmes que nous utilisons aujourd’hui — et que nous utiliserons dans un avenir proche — ne sont pas nécessairement capables de déterminer ce qui est exact et ce qui ne l’est pas. Après tout, il n’existe aucun endroit où en vérifier la véracité. Aucune autorité de certification, aucune source désignée comme faisant autorité à l’image du DNS. Et, dans de nombreux cas, aucun moyen de contester les données.
Alors que nous continuons à créer des représentations numériques de nos clients à partir de fragments de données, nous devons être conscients de l’impact que ces données peuvent avoir, tant sur nous, en tant que décideurs au sein de l’entreprise, que sur les clients, en tant qu’êtres humains qui doivent vivre avec les conséquences des conclusions tirées de ces données.
En tant que fournisseurs de solutions de sécurité des applications, nous insistons souvent sur la protection des données et des identités contre leur exfiltration ou leur vol. Mais nous envisageons rarement le problème sous l’angle inverse, à savoir la possibilité bien réelle d’une corruption des données, qu’elle soit accidentelle ou malveillante.
Nous devrions le faire, avant que cela ne devienne un sujet tendance sur Twitter.
Nous avons assisté à l’essor, sous de nombreuses formes, d’attaques numériques visant des personnes en guise de représailles. Comme les opérateurs du 911 ne peuvent pas obtenir de localisation ni d’adresse précises à partir des téléphones portables, certaines victimes ont subi des canulars de swatting mortels. Le revenge porn existe bel et bien, et l’usurpation de l’identité de nos proches sur les réseaux sociaux est monnaie courante. Cela fait également plus de trois ans que Chris Rock, PDG de Kustodian, a démontré comment des fraudeurs pouvaient artificiellement « tuer » quelqu’un pour en tirer profit ou lui faire une mauvaise plaisanterie, en exploitant les failles des procédures d’enregistrement des décès de la plupart des pays, lors de la DEF CON (CS Monitor). Pour ceux qui suivent, c’était l’un des piratages utilisés dans le film Hackers, sorti en 1995, au même titre que l’annulation de la carte de crédit de quelqu’un et la publication de fausses petites annonces personnelles pour se venger d’un affront, réel ou supposé.
Ce n’est qu’une question de temps avant que de tels comportements vindicatifs ne s’étendent à la falsification de données ailleurs.
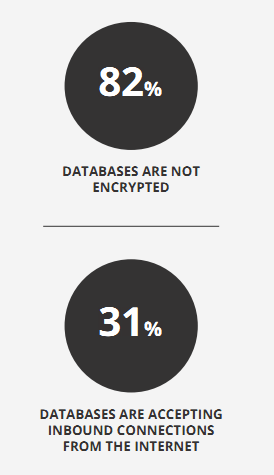
Si vous pensez que je verse dans la paranoïa, souvenez-vous du rapport CSI de RedLock de 2017 qui indiquait que 31 % des bases de données avaient un port ouvert sur Internet. Accessible à n’importe qui. Souvenez-vous de la débâcle de MongoDB, au cours de laquelle plus de 27 000 bases de données étaient accessibles au public. Une personne mal intentionnée qui tombe sur la bonne base de données laissée ouverte peut faire des ravages dans vos données.
C’est un problème, car nous avons atteint un point de bascule où les données sont souvent considérées comme une représentation inviolable et infaillible de la vérité. À cause d’une erreur de saisie, cette « vérité » aurait pu me conduire en prison.
Diligence en matière de données numériques
Alors qu’une part toujours plus importante de nos entreprises – et de nos vies – est stockée dans l’univers numérique, nous devrions prendre un peu de recul et nous rappeler que les bits et les octets de nos entrepôts de données représentent certains aspects de la vie de personnes bien réelles. Le soin avec lequel nous traitons ces données reflète notre considération pour cette personne réelle qu’est notre client. D’autant que nous ne pouvons pas savoir comment une petite donnée saisie aujourd’hui pourrait être interprétée demain au détriment du client. Après tout, l’inscription dans l’historique de mon véhicule visait simplement à consigner une vidange effectuée dans le Dakota du Nord. Il n’y avait aucune intention malveillante, mais les conséquences auraient pu être désastreuses pour moi.
Qu’il s’agisse d’élaborer des politiques de sécurité visant à prévenir l’altération des données, de contrôler l’accès aux applications et aux bases de données ou d’accorder une plus grande attention à la saisie manuelle, nous devons garder à l’esprit que, si les données ne mentent pas — elles reflètent exactement ce que la personne a saisi —, la personne qui les a saisies, elle, a peut-être menti.
À propos de l’auteur

Lori MacVittie est ingénieure émérite et évangéliste en chef au sein du bureau du directeur technique de F5. Elle possède une expertise approfondie dans la fourniture d’applications, les stratégies d’automatisation et les infrastructures. Elle est réputée pour sa capacité à rendre la complexité intelligible, qu’elle définisse des garde-fous pour les agents d’IA, analyse des architectures multicloud fragiles ou explore les limites des systèmes évolutifs. Elle cumule plus de trente ans d’expérience dans le secteur, couvrant le développement d’applications, l’architecture informatique ainsi que l’exploitation des réseaux et des systèmes. Avant de rejoindre F5, elle a été rédactrice spécialisée dans les technologies et a reçu plusieurs distinctions. MacVittie est titulaire d’un master en informatique et est une autrice prolifique dont les publications couvrent la sécurité, le cloud et l’architecture d’entreprise. Elle est également une passionnée de jeux de société et de jeux vidéo, et assume pleinement ses avis bien tranchés sur le fromage.
Autres articles de Lori Mac VittieArticles de blog associés

F5 NGINXaaS pour Google Cloud : des applications résilientes et évolutives
Découvrez comment NGINXaaS s’intègre à Google Cloud pour renforcer les performances et la sécurité, et préparer vos applications critiques à un avenir propulsé par l’IA.

L’intégration de F5 Web Application Firewall (WAF) à AWS est disponible dès aujourd’hui
En faisant appel à un partenaire de déploiement AWS WAF tel que F5, vous pouvez renforcer la sécurité de vos applications web grâce à des règles personnalisées qui bloquent les schémas d’attaque courants, comme les injections SQL ou les attaques par scripts intersites (XSS).
Appliquer le principe de Peter Parker à l’inspection TLS
« Un grand pouvoir implique de grandes responsabilités. » Si l’on en trouve des échos chez Voltaire et Churchill, cette citation est surtout connue grâce aux bandes dessinées Spider-Man, où elle est attribuée à l’oncle Ben. Bien entendu, si cette phrase est si répandue dans la culture populaire, c’est notamment parce qu’elle peut s’appliquer à une multitude de situations et de sujets, y compris à l’inspection TLS.
Le NetOps a besoin de défenseurs, pas d’adversaires
Il est important de reconnaître que les équipes NetOps ne sont pas toujours celles qui font obstacle au déploiement de la dernière nouveauté, application ou service. Les freins à la rapidité sont souvent dus au fait que les organisations n’adoptent pas tous les principes du DevOps lorsqu’elles cherchent à transformer leurs opérations informatiques.
Mise à jour des services applicatifs : sécurité, rapidité et visiteurs suspects
Il est de nouveau temps de nous pencher sur les services applicatifs que les entreprises utilisent réellement pour rendre leurs applications plus rapides et plus sûres. On constate notamment une hausse du recours aux services de protection contre les bots, ainsi que la progression lente mais régulière de HTTP/2. Bien qu’il ne s’agisse pas d’une application…
Les templates prennent le contrôle du cloud
Les modèles s’imposent dans le cloud. Lisez le blog de F5 pour découvrir comment l’infrastructure en tant que code et les API déclaratives automatisent la mise à disposition des applications.