« C’est la tempête parfaite » est peut-être une expression courante, mais elle décrit bien l’envolée incontrôlée des coûts du cloud computing. Plusieurs facteurs se conjuguent pour créer cette tempête parfaite :
- Les personnes qui déploient les charges de travail ne sont pas celles qui en assument le coût
- Il est facile de consommer des ressources d’infrastructure à la demande et de manière automatisée
- Des dépôts de code facilement accessibles permettent d’« emprunter » des fonctionnalités à du code existant écrit par quelqu’un d’autre
- Les pipelines CI/CD et les pratiques SRE aident les développeurs à intégrer et à déployer rapidement du code
En résumé, nous nous retrouvons dans une situation où les développeurs sont incités à déployer rapidement de nouvelles fonctionnalités en s’appuyant sur des blocs de code existants qui ne sont généralement ni rationalisés ni optimisés pour l’usage auquel ils sont destinés dans la nouvelle application. La rapidité de mise sur le marché étant primordiale, l’optimisation passe au second plan (très loin derrière). Si le code non optimisé nuit aux performances, il suffit d’un appel d’API pour provisionner une infrastructure plus puissante. Problème résolu !
Le problème est aggravé par le fossé, tant sur le plan des mentalités que de la structure organisationnelle, entre les personnes qui écrivent le code et celles qui paient les factures. À mesure que les coûts du cloud de l’entreprise augmentent, le directeur financier s’inquiète. Mais les développeurs à l’origine de la hausse des factures cloud sont récompensés pour la rapidité avec laquelle ils livrent leurs produits, tout en restant parfaitement inconscients des problèmes financiers qui en découlent et que les incitations en place les ont poussés à créer.
Pour résoudre ce problème, F5 NGINX et Opsani se sont associés afin de proposer une solution d’optimisation qui offre aux abonnés de F5 NGINX Ingress Controller des avantages supplémentaires à partir de leurs déploiements existants. NGINX Ingress Controller devient une solution optimisée lorsque le conteneur Opsani Servo est déployé dans les charges de travail KubeNest, où il s’appuie sur Prometheus pour collecter des métriques de débit, d’erreurs et de durée (RED). Opsani utilise ses capacités d’optimisation autonome, fondées sur l’apprentissage automatique, pour optimiser en continu l’infrastructure et garantir que la quantité adéquate de ressources est consommée afin d’améliorer les performances et de réduire les coûts.
Réduire les coûts grâce à l’optimisation du cloud
Les utilisateurs de NGINX connaissent déjà la méthode la plus simple pour réduire les coûts du cloud : utiliser des outils légers qui n’ajoutent qu’une latence minimale tout en offrant des performances fulgurantes. Et bien sûr, dans l’univers de Kubernetes, des outils simples mais puissants sont indispensables à la réussite d’un déploiement. Dans cet article de blog, nous vous expliquons comment réduire les coûts tout en améliorant les performances grâce à trois outils :
- NGINX Ingress Controller – Un contrôleur Ingress basé sur F5 NGINX Plus qui offre des performances nettement supérieures à celles des autres contrôleurs Ingress basés sur NGINX, car il s’adapte dynamiquement aux changements des points de terminaison back-end sans gestionnaires d’événements ni rechargements de configuration.
- Opsani – Une solution unique d’optimisation continue en tant que service (COaaS) qui permet d’intégrer l’optimisation continue à votre pipeline CI/CD, afin de livrer rapidement du code et de l’optimiser pour obtenir les meilleures performances au coût le plus bas possible.
- Prometheus – Un projet open source populaire de surveillance et d’alerte. Grâce au module Prometheus de NGINX Plus, le contrôleur Ingress NGINX basé sur NGINXnbsp;Plus exporte des centaines de métriques vers un serveur Prometheus.
L’un des cas d’usage les plus intéressants de la version de NGINX Ingress Controller basée sur NGINX Plus réside dans sa capacité à améliorer la visibilité dans Kubernetes grâce à la surveillance en temps réel (via le tableau de bord NGINX Plus) et aux données historiques (via Prometheus). En outre, en tant que frontal pour les charges de travail, NGINX Ingress Controller peut collecter des métriques de débit, d’erreurs et de durée (RED), puis les transmettre à Opsani (via Prometheus). Opsani utilise le machine learning pour corréler ces métriques avec l’infrastructure actuellement déployée et recommander des modifications permettant d’optimiser NGINX Ingress Controller, vos applications ou l’ensemble de la pile technologique. Vous pouvez même configurer Opsani pour qu’il vous alerte lorsque les seuils de latence et de performances définis pour NGINX Ingress Controller sont atteints.
Examinons les chiffres – Les résultats de nos tests d’optimisation
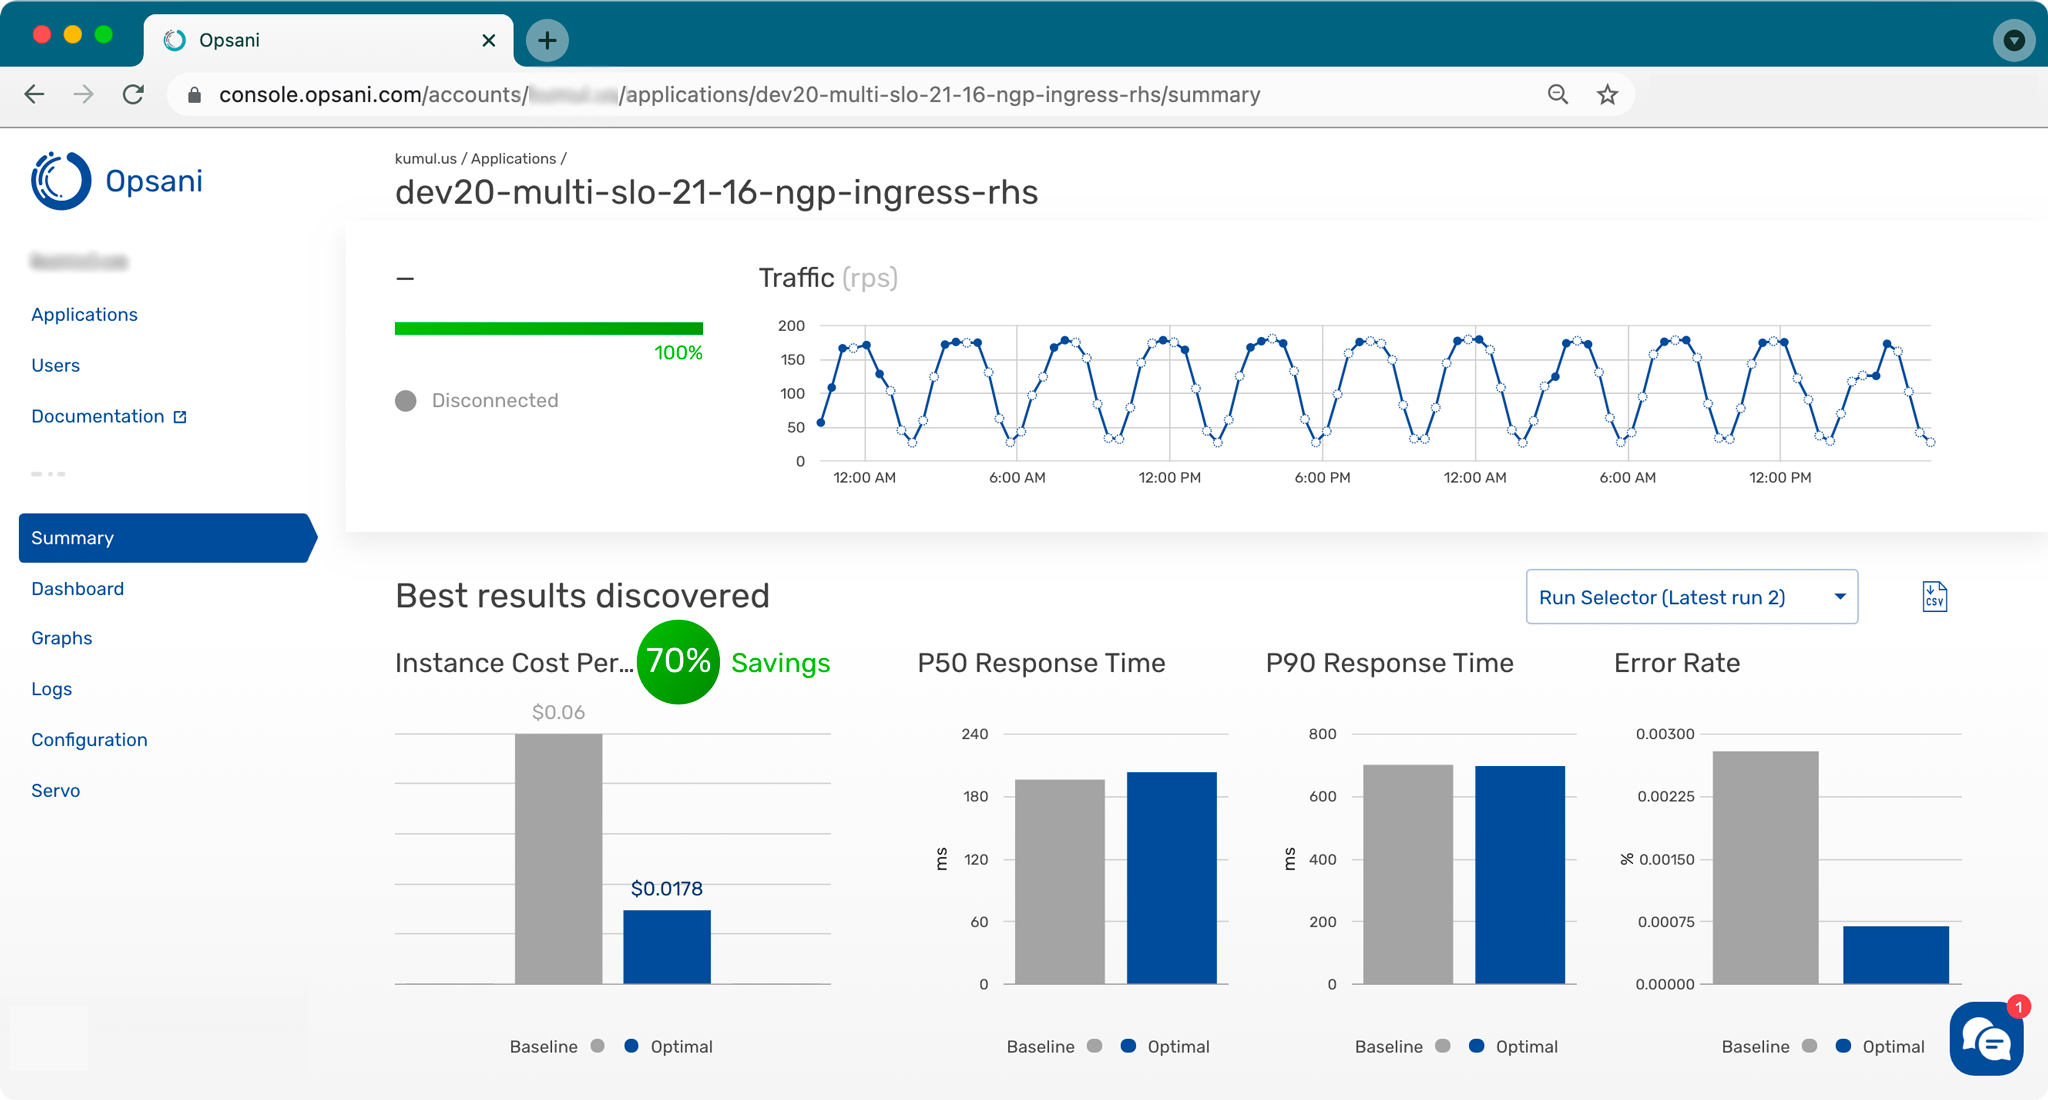
Examinons un exemple des résultats auxquels vous pouvez vous attendre en déployant NGINX Ingress Controller basé sur NGINX Plus avec Opsani et Prometheus. Comme le montre la capture d’écran, la page Résumé d’Opsani présente l’évolution du volume de trafic (requêtes par seconde, ou RPS) et met en évidence les avantages de ses optimisations par rapport aux paramètres de référence : ici, une réduction de 70 % du coût horaire des instances et une amélioration de 5 % du temps de réponse P50.
Nous nous sommes demandé comment ces résultats se compareraient à ceux de l’un des contrôleurs Ingress les plus connus : le contrôleur Ingress basé sur NGINX Open Source et maintenu par la communauté Kubernetes dans le dépôt GitHub kubernetes/ingress-nginx. (Conformément à la convention NGINX établie, nous l’appellerons le « contrôleur Ingress communautaire » dans la suite de cet article. La version de NGINX Ingress Controller basée sur NGINX Plus est maintenue par l’équipe d’ingénierie NGINX dans le dépôt GitHub nginxinc/kubernetes-ingress, aux côtés de son homologue NGINX Ingress Controller basé sur NGINX Open Source.)
Nous avons testé les performances des deux contrôleurs Ingress dans trois topologies :
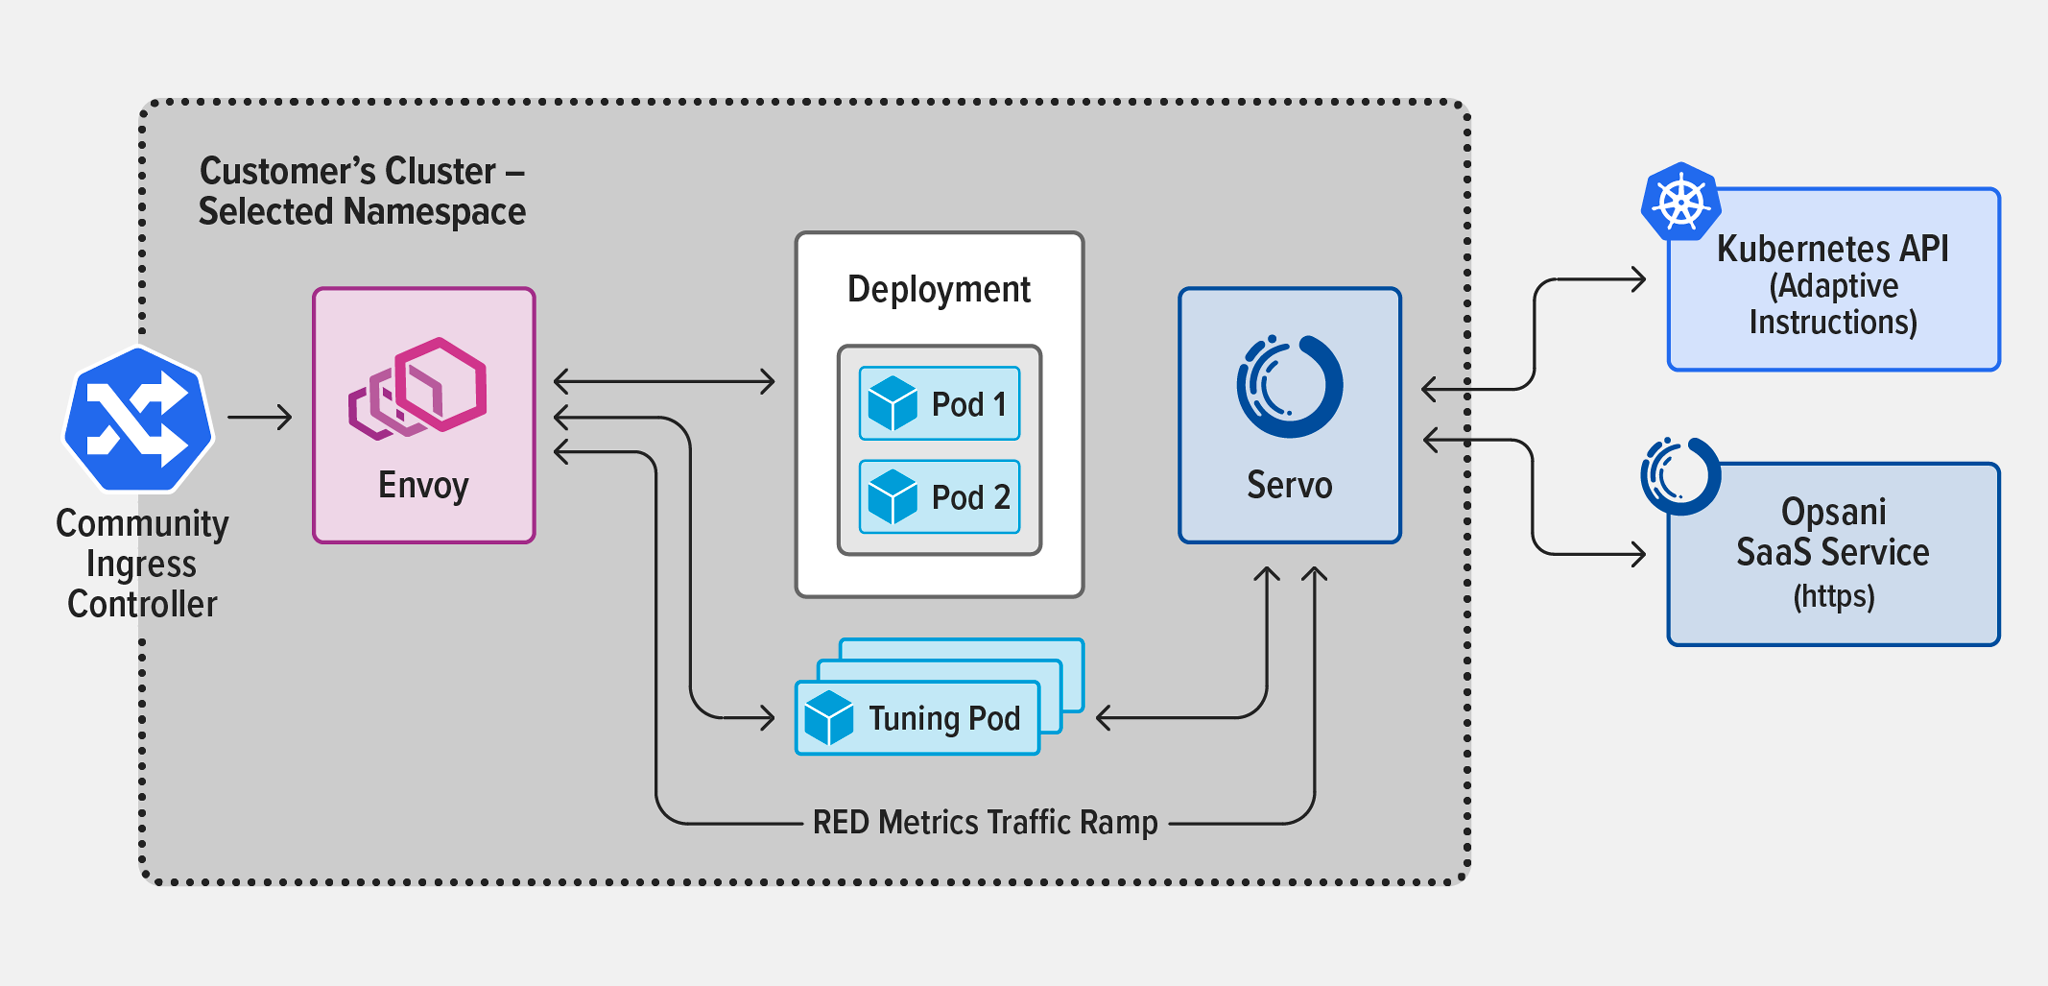
- Topologie 1 – Contrôleur Ingress communautaire, déployé selon le processus standard. Les métriques ont été recueillies en ajoutant un proxy Envoy en ligne avec l’application testée, dans un conteneur side-car au sein du pod de l’application.
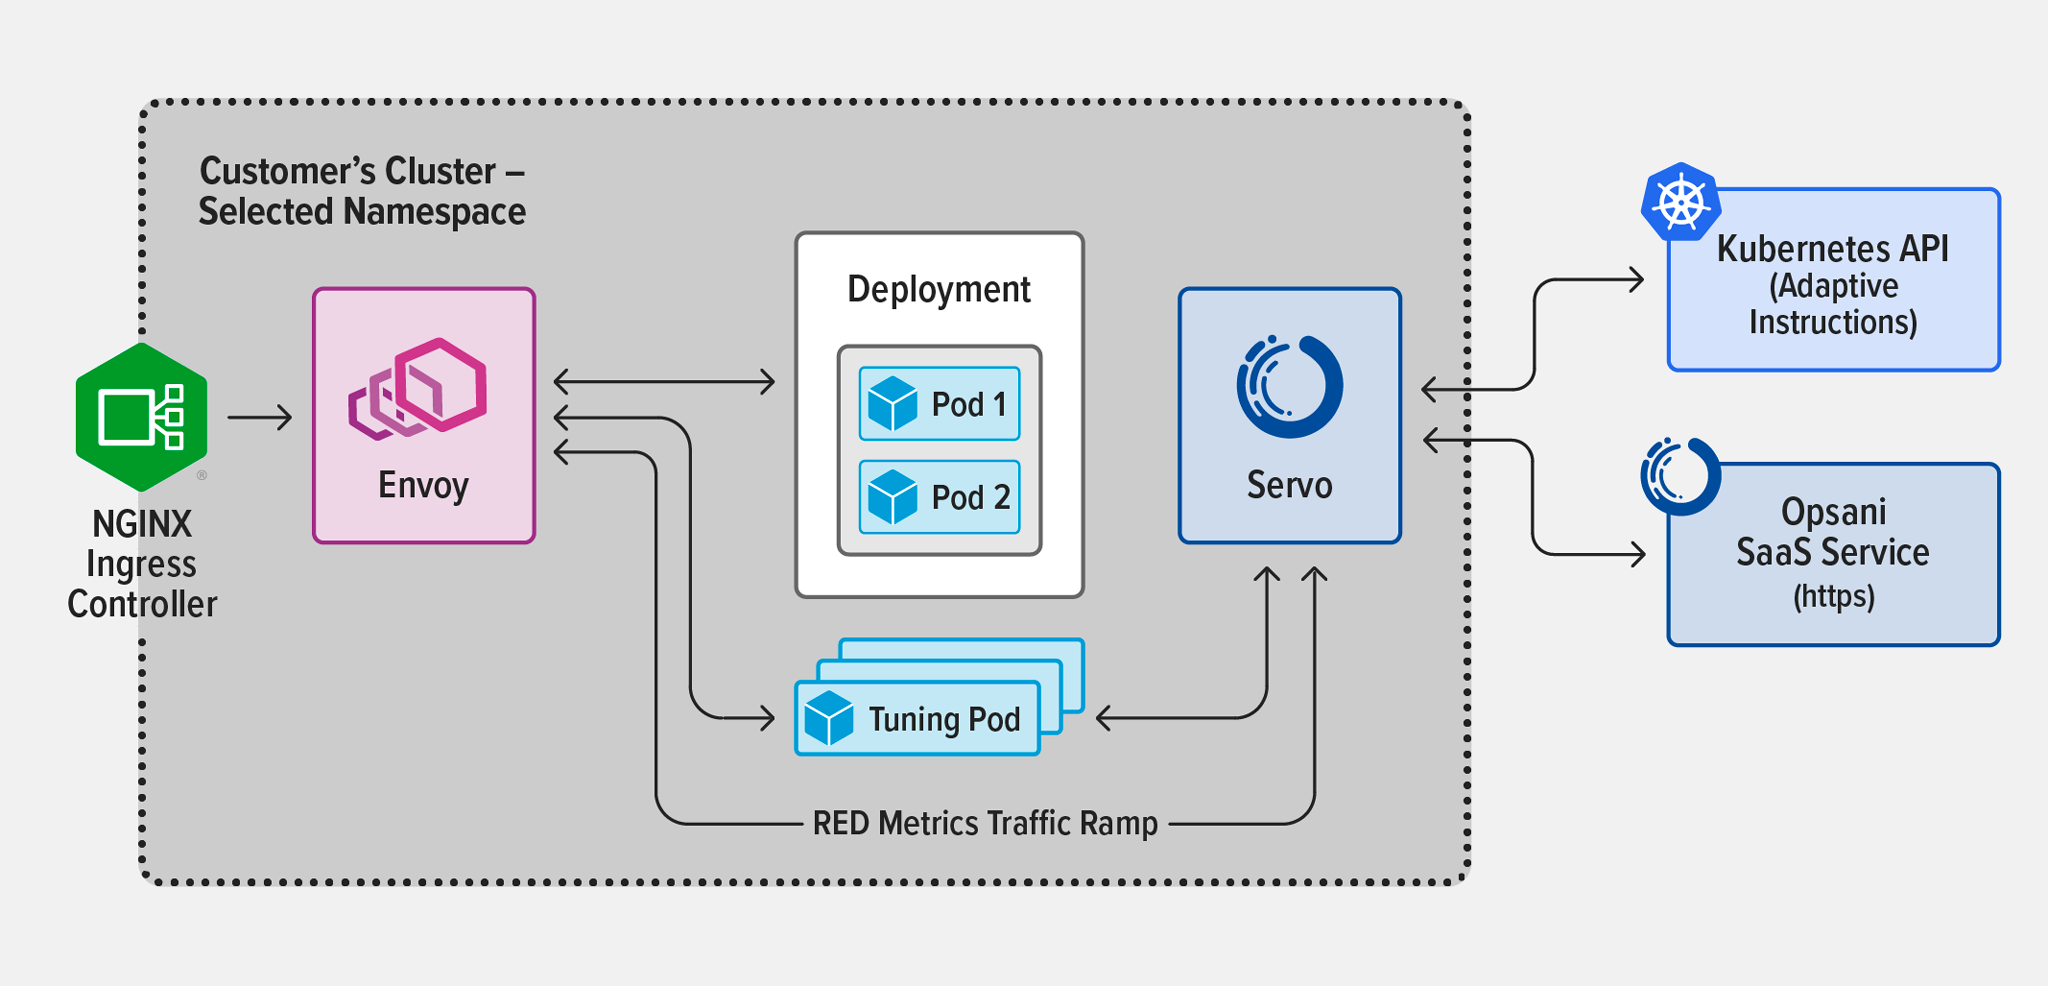
- Topologie 2 – Contrôleur Ingress NGINX basé sur NGINX Plus, déployé à l’aide de Helm. Les métriques ont été recueillies avec le même déploiement et la même configuration d’Envoy que pour le contrôleur Ingress communautaire, afin de garantir que leur collecte n’avait aucune incidence sur le processus d’optimisation des performances.
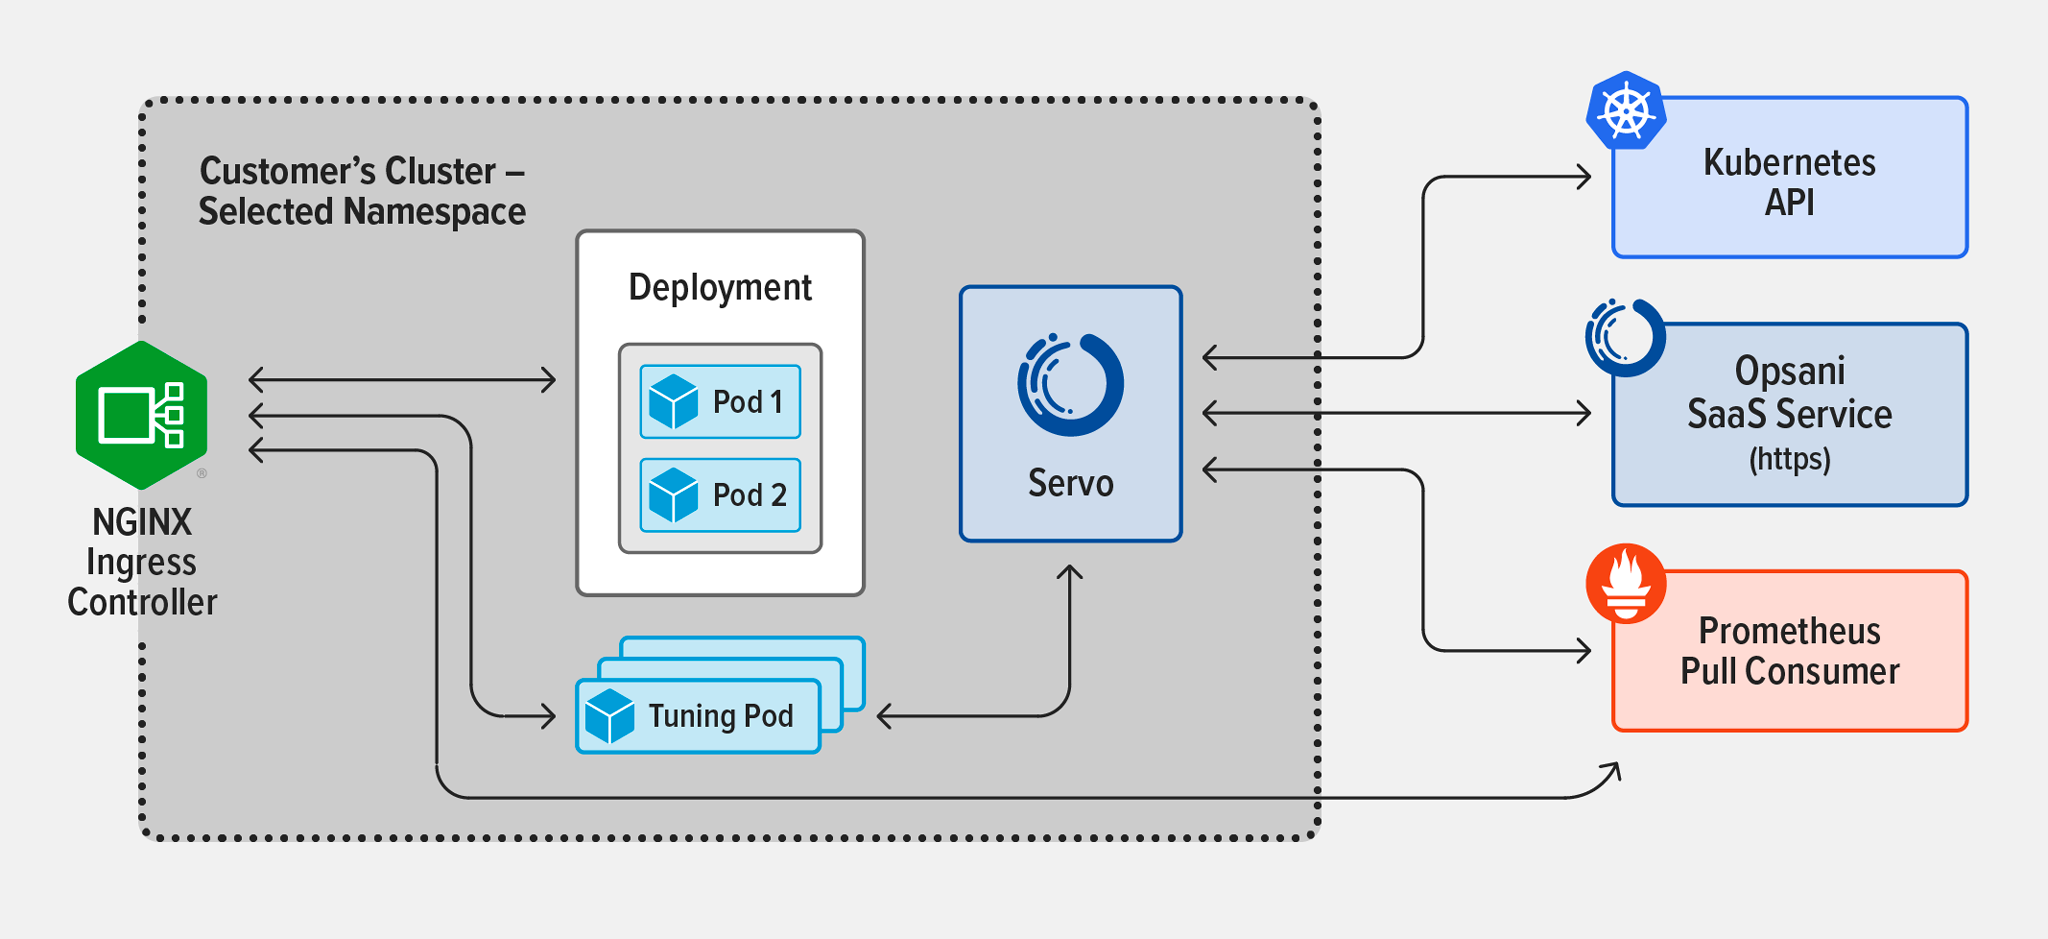
- Topologie 3 – Contrôleur Ingress NGINX basé sur NGINX Plus, également déployé à l’aide de Helm. Les métriques ont été collectées à l’aide de Prometheus.
Le tableau récapitule les résultats des tests. Comme vous pouvez le constater, le contrôleur Ingress NGINX permet de réduire davantage les coûts et d’optimiser plus efficacement le processeur et la mémoire que le contrôleur Ingress communautaire. Nous attribuons ces résultats à la répartition de charge plus efficace du contrôleur Ingress NGINX.
Les résultats relatifs au temps de réponse P50 indiquent que Prometheus est la solution idéale pour collecter les métriques, car il élimine le saut supplémentaire requis par le mécanisme de conteneur side-car d’Envoy. Envoy n’a aucun effet sur le temps de réponse P50 du contrôleur Ingress communautaire, mais augmente en réalité la latence de 4 % avec NGINX Ingress Controller. À l’inverse, Prometheus améliore de 5 % le temps de réponse P50 avec NGINX Ingress Controller.
| Topologie | Réduction des coûts (%) | Temps de réponse P50 (%) | Optimisation du processeur (%) | Optimisation de la mémoire (%) |
|---|---|---|---|---|
| 1 – Contrôleur Ingress communautaire avec Envoy | 44 | 0 | 44 | 44 |
| 2 – Contrôleur Ingress NGINX avec Envoy | 70 | 4 | 63 | 81 |
| 3 – Contrôleur Ingress avec Prometheus | 70 | -5 | 63 | 81 |
Pour savoir comment nous avons effectué les tests, consultez l’annexe.
Comment Opsani optimise le contrôleur Ingress NGINX
Opsani peut optimiser les applications même lorsque leur équilibrage de charge est insuffisant dans des environnements dynamiques. Il peut également exploiter tout type de données métriques, mais l’optimisation des services connectés est considérablement améliorée lorsque ces données proviennent d’un outil existant qui collecte des métriques réseau. À cette fin, nous utilisons un processus de déploiement simple pour intégrer Opsani à NGINX Ingress Controller.
Dans les environnements où NGINX fait office de contrôleur Ingress – ce qui est aujourd’hui le cas pour de nombreuses applications – le simple passage à NGINX Ingress Controller basé sur NGINX Plus permet de bénéficier d’un algorithme d’équilibrage de charge plus efficace sans affecter le fonctionnement des applications. Autre avantage : les métriques des applications dont la charge est équilibrée par NGINX Ingress Controller deviennent également disponibles.
La seule exigence supplémentaire consiste à déployer un unique pod Opsani avec l’application dans l’espace de noms d’optimisation. Le modèle Opsani pour NGINX Ingress Controller basé sur NGINX Plus fait pointer le point de terminaison des métriques vers le service Ingress afin de recueillir les métriques propres à l’application nécessaires à l’optimisation. En traitant les métriques de trois ou quatre périodes de pointe, le moteur Opsani atteint un niveau d’optimisation optimal en quelques heures seulement. À ce jour, nous avons obtenu une optimisation de la charge de pointe comprise entre 30 % et 70 %.
Premiers pas avec Opsani et NGINX Ingress Controller
Profitez de vos essais gratuits de NGINX Ingress Controller et d’Opsani, puis rendez-vous sur notre dépôt GitHub pour obtenir les scripts et les fichiers de configuration permettant d’utiliser NGINX Ingress Controller et Opsani avec Prometheus.
Annexe : méthodologie des tests
Prérequis
- Le contrôleur NGINX Ingress basé sur NGINX Plus est créé sous forme de conteneur.
- Kubernetes est configuré et le secret d’accès au registre est disponible pour permettre l’accès à un registre Docker privé sécurisé.
- Le contrôleur NGINX Ingress basé sur NGINX Plus est déployé via Helm dans l’espace de noms ingress.
- Une ressource NGINX VirtualServer est configurée pour pointer vers le service à optimiser (généralement le service frontend par défaut). Consultez frontend-virtualserver.yaml dans notre dépôt GitHut pour voir un exemple.
Topologie et configuration
Nous créons trois instances Opsani. Pour les topologies 1 et 2, nous utilisons le modèle Opsani Dev standard disponible pour tous les comptes Opsani. Il nous suffit de placer le contrôleur NGINX Ingress devant l’application et de le faire pointer vers le service de l’application.
Pour la topologie 3, nous utilisons le même modèle par défaut et modifions la configuration de Servo à l’aide de la ConfigMap définie dans opsani-manifests-nginx-plus.yaml dans le dépôt GitHub. Comme avec le modèle standard, nous remplaçons les variables suivantes de la ConfigMap par les valeurs appropriées :
{{ NAMESPACE }}– Espace de noms de la ressource cible{{ DEPLOYMENT }}– Déploiement cible{{ CONTAINER }}– Nom du conteneur de l’application cible
En outre, nous définissons OPSANI_ACCOUNT_NAME, OPSANI_APPLICATION_NAME et OPSANI_TOKEN conformément au document fourni avec le déploiement de l’application.
Bien que la version par défaut de ServoX pour Opsani Dev comprenne une instance Prometheus, nous déployons plutôt celle-ci dans le même espace de noms que NGINX Ingress Controller, afin de limiter la configuration nécessaire pour ClusterRole.
Nous configurons également un service afin de permettre au pod Servo de trouver et d’interroger l’instance appropriée. Cet artefact est décrit dans opsani-manifests-nginx-plus.yaml.
Une fois que Bank of Anthos s’exécute en tant qu’application web d’exemple et que l’Ingress a été vérifié, nous lançons l’instance Prometheus de l’Ingress. Enfin, nous pouvons lancer l’optimisation Opsani en appliquant le fichier opsani-manifests-nginx-plus.yaml.
À propos de l’auteur
Articles de blog associés

Tendances actuelles des technologies cloud natives, de l’ingénierie de plateforme et de l’IA
Découvrez les principaux enseignements tirés des réponses à l’enquête annuelle F5 NGINX sur les dernières tendances en matière de technologies cloud natives, de sécurité, d’ingénierie de plateforme et d’IA.

Quels contrôleurs Ingress NGINX sont affectés par les vulnérabilités CVE-2022-4886, CVE-2023-5043 et CVE-2023-5044 ?
Lorsque de nouvelles CVE sont signalées, il est facile de ne plus savoir si elles concernent un outil de contrôleur Ingress NGINX particulier, car il existe plusieurs projets. Cet article présente les CVE et explique comment distinguer les différents projets de contrôleurs Ingress afin de dissiper toute confusion.
Votre API est-elle en temps réel ? Testez sa latence avec l’outil rtapi de NGINX
Votre API répond-elle aux requêtes en moins de 30 ms ? Si ce n’est pas le cas, il ne s’agit pas d’une API en temps réel offrant la faible latence exigée par la grande majorité des organisations. Mesurez la latence de votre API avec l’outil rtapi de NGINX et découvrez comment NGINX peut l’aider à offrir une réactivité en temps réel.

Un testeur d’expressions régulières pour NGINX et NGINX Plus
Le testeur d’expressions régulières (regex) pour NGINX et NGINX Plus vous évite de tâtonner en vous indiquant si une expression régulière utilisée dans un bloc location ou map correspond aux valeurs comme prévu. Il génère la configuration appropriée et affiche les valeurs des groupes de capture.
Caches partagés avec les clusters de cache NGINX Plus, partie 1
Optimisez la capacité de votre cache web en le répartissant entre plusieurs serveurs de cache web NGINX ou NGINX Plus. Découvrez comment procéder dans cet article.
Introduction aux microservices
Les microservices suscitent actuellement beaucoup d’intérêt. Cet article de blog est le premier d’une série de sept consacrée à la conception, au développement et au déploiement de microservices.