
Qu’est-ce que la haute disponibilité ?
La haute disponibilité (HA) désigne la capacité d’un système à fonctionner en continu, sans interruption ni défaillance, généralement grâce à des mécanismes de basculement intégrés. Les systèmes à haute disponibilité sont conçus pour continuer à fonctionner même en cas d’événements imprévus.
Pourquoi la haute disponibilité est importante
L’objectif principal de la haute disponibilité (HA) est d’éviter les temps d’arrêt, c’est-à-dire les périodes pendant lesquelles un système, un service, une application, un service cloud ou une fonctionnalité est indisponible ou ne fonctionne pas correctement. Les temps d’arrêt entraînent une perte de chiffre d’affaires, une baisse de la productivité et une atteinte à la réputation de l’entreprise. La haute disponibilité est donc importante pour :
- Continuité des activités – La haute disponibilité garantit que les systèmes, fonctionnalités et fonctions critiques restent opérationnels comme prévu. Les systèmes à haute disponibilité se rétablissent rapidement après une défaillance, afin que les organisations puissent continuer à servir leurs clients comme prévu (de préférence sans interruption perceptible).
- Expérience utilisateur améliorée – Des systèmes rapides et fiables contribuent à préserver la satisfaction des clients et à éviter les conséquences négatives liées aux pertes de revenus, à la compromission des données et à la baisse de productivité.
- Avantage concurrentiel – Des niveaux élevés de disponibilité permettent aux organisations de se démarquer en proposant des services plus rapides et plus fiables que ceux de la concurrence. Cela témoigne de leur engagement en faveur de la qualité globale et de la satisfaction client.
Types de haute disponibilité
Il existe plusieurs types de haute disponibilité (HA), qui peuvent être classés selon le niveau de redondance nécessaire, le type de tolérance aux pannes requis et la nature du système à protéger. Les types de haute disponibilité les plus courants sont les suivants :
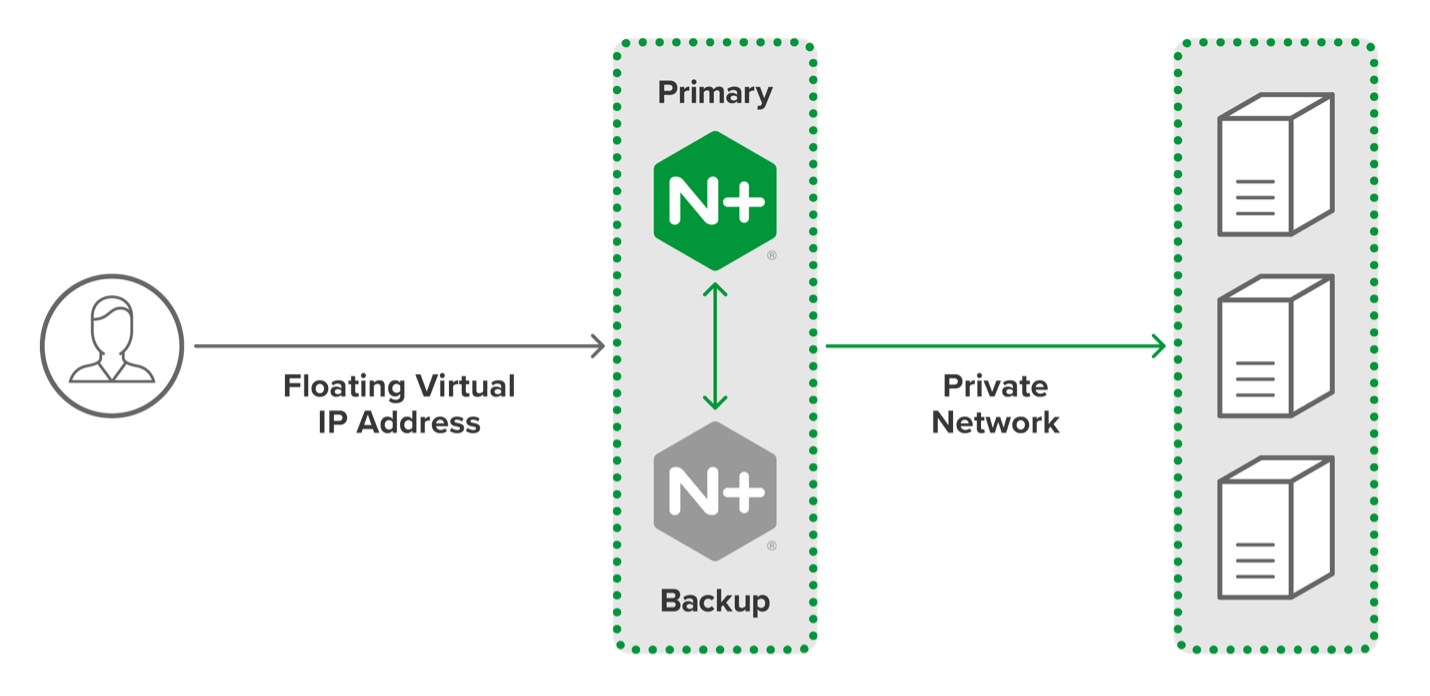
- Actif-passif – Un système de secours est maintenu en mode passif ou en veille et ne devient actif qu’en cas de défaillance du système principal. Cette méthode de protection par basculement nécessite parfois une intervention manuelle pour passer au système de secours.
- Actif-actif – Plusieurs systèmes fonctionnent simultanément et se répartissent la charge de travail. Si l’un d’eux tombe en panne, les autres prennent automatiquement le relais. Ce type de haute disponibilité nécessite une configuration et une coordination plus complexes entre les systèmes, mais offre de meilleures performances et une plus grande évolutivité qu’une solution manuelle.
Ce schéma représente un cluster haute disponibilité actif-passif composé de deux serveurs NGINX Plus. NGINX prend également en charge les configurations actif-actif et d’autres configurations haute disponibilité.
Comment la haute disponibilité est-elle mise en œuvre ?
Les mécanismes de redondance et de basculement évitent les points de défaillance uniques, de sorte que la panne d’un composant ne perturbe pas le fonctionnement global du système, de l’application ou de la fonctionnalité. Parmi les mécanismes courants figurent :
- Composants redondants – Déployez plusieurs serveurs, connexions réseau, systèmes de stockage et blocs d’alimentation au sein du système. Si un composant tombe en panne, un autre prend le relais sans interruption.
- Surveillance et alertes – Surveillez en permanence les performances et la disponibilité. Lorsqu’une panne ou un autre problème est détecté, une alerte est générée. Les administrateurs système peuvent rapidement identifier et résoudre les problèmes, réduisant ainsi le risque d’interruption de service.
- Répartition de charge – Un ou plusieurs serveurs spécialisés interceptent les requêtes destinées à un groupe de systèmes (back-end) et répartissent le trafic entre eux afin d’optimiser les performances. Si l’un des systèmes back-end tombe en panne, les répartiteurs de charge redirigent automatiquement les requêtes entrantes vers les autres systèmes.
- Mécanismes de basculement – Déployez des configurations actif-passif ou actif-actif, ou un cluster de basculement, afin qu’en cas de défaillance d’un système, un autre puisse prendre le relais avec un minimum d’interruption.
- Systèmes de sauvegarde et de récupération – Veillez à ce que les données et les applications puissent être rapidement restaurées en cas de défaillance. Les systèmes peuvent être hybrides, répartis sur différents sites, basés dans le cloud ou rapidement remis en ligne après une défaillance.
Comment assurer une haute disponibilité
Les services et les ressources que vous devez déployer pour assurer la haute disponibilité dépendent du type de système, du type de haute disponibilité et des exigences propres à votre organisation. Les éléments nécessaires sont notamment les suivants :
- Support technique – Le premier recours des organisations qui ont besoin d’aide avec leurs systèmes à haute disponibilité (HA). Le personnel de support dédié peut contribuer à identifier, diagnostiquer et résoudre les problèmes. Il peut également fournir des conseils sur les bonnes pratiques permettant de maintenir des niveaux de disponibilité élevés.
- Maintenance et mises à niveau – Pour rester opérationnels et sécurisés, les systèmes à haute disponibilité doivent faire l’objet d’une maintenance régulière et utiliser les dernières versions logicielles disponibles.
- Planification de la reprise après sinistre – Essentielle pour les organisations qui doivent restaurer rapidement leurs systèmes. Grâce à des procédures prédéfinies et documentées, les administrateurs système n’ont pas besoin de se souvenir des solutions ni d’en élaborer dans l’urgence.
- Documentation et formation – Aident les administrateurs système à comprendre comment gérer leurs systèmes à haute disponibilité. La documentation peut inclure des bonnes pratiques, des tutoriels et des sessions de formation.
Bonnes pratiques : haute disponibilité
Le respect des bonnes pratiques améliore les performances opérationnelles et réduit au minimum les interruptions coûteuses. Ces bonnes pratiques courantes peuvent être adaptées aux systèmes, aux sites et aux résultats souhaités par l’organisation.
- Intégrer la redondance – Chaque niveau du système, des composants matériels aux connexions réseau, est renforcé afin que, si un composant tombe en panne, le système continue de fonctionner comme prévu.
- Équilibrez la charge du trafic – En répartissant les requêtes entrantes entre plusieurs systèmes, vous permettez aux systèmes encore opérationnels de prendre le relais en cas de défaillance de l’un d’entre eux.
- Surveillez les performances et la disponibilité – Une surveillance continue et des alertes permettent d’identifier et de résoudre plus rapidement les problèmes.
- Testez et validez régulièrement les mécanismes de basculement – Des tests réguliers permettent de vérifier que les mécanismes de basculement sont toujours capables de prendre le relais de manière fiable en cas d’interruption.
- Procédures de sauvegarde et de récupération – Veillez à ce que les données et les applications puissent être rapidement restaurées en cas de défaillance.
- Mettez régulièrement à niveau les systèmes et assurez-en la maintenance – Cela permet de garantir le bon fonctionnement et la sécurité des applications et des systèmes.
- Former le personnel – Des tests réguliers et le renforcement des procédures doivent faire partie des pratiques opérationnelles standard, en particulier pour les personnes et les équipes responsables de la haute disponibilité.
- Envisagez des solutions cloud – Le stockage dans le cloud et la reprise après sinistre permettent aux systèmes de continuer à fonctionner, quel que soit l’endroit où la défaillance se produit.
- Surveiller la sécurité – Mettez en œuvre des mesures visant à prévenir les violations de données ou l’accès aux systèmes par des acteurs malveillants ou des utilisateurs non autorisés.