
La politique dans la charge utile : se préparer aux architectures d’agents d’IA
Les agents d’IA transforment la manière dont les applications interagissent avec l’infrastructure. Contrairement aux systèmes traditionnels, les agents intègrent à chaque requête leurs propres objectifs, leur contexte et leur logique décisionnelle : ce qu’il faut faire, comment réagir en cas d’échec et quels sont les critères de réussite. Cette évolution remet en cause des principes de longue date en matière de gestion du trafic et impose de repenser l’infrastructure d’entreprise. Le routage statique, la mutualisation des ressources et la centralisation des politiques ne suffisent plus dans un monde où chaque requête est autonome.
Les architectures d’agents exigent que l’infrastructure évolue, passant d’une exécution réactive à une interprétation en temps réel de l’intention intégrée. Les entreprises qui prennent conscience de cette évolution peuvent s’y préparer sans renoncer à leurs investissements existants, mais en les adaptant.
Introduction
Les agents d’IA ne sont pas de simples applications intelligentes. Ils représentent un changement structurel dans la manière dont les applications fonctionnent, prennent des décisions et s’adaptent. Contrairement aux systèmes traditionnels, les agents ne se contentent pas de répondre aux politiques de gestion du trafic : ils apportent les leurs. Chaque requête qu’ils envoient contient non seulement des données, mais aussi une logique intégrée : ce qui doit se produire, la manière dont le mécanisme de repli doit fonctionner et les critères de réussite.
Cette évolution déplace la prise de décision des plans de contrôle statiques vers l’environnement d’exécution lui-même. Elle abolit la séparation historique entre les plans de contrôle et de données, obligeant ainsi les infrastructures de gestion du trafic — répartiteurs de charge, passerelles et proxys — à interpréter les politiques propres à chaque requête plutôt qu’à exécuter passivement des routes préconfigurées.
Ce document examine comment les architectures d’agents remettent en cause des hypothèses fondamentales de l’ingénierie du trafic, des contrôles d’intégrité et de la logique de repli jusqu’à l’observabilité et à l’application des règles de sécurité. Il explique pourquoi les mécanismes traditionnels, tels que les pools statiques et les indicateurs d’intégrité fondés sur des moyennes, ne suffisent plus dans un monde où l’intention varie à chaque requête. Il montre également que l’infrastructure de couche 7 doit évoluer, sous peine de devenir une simple tuyauterie banalisée : fiable, mais stratégiquement invisible. Pour s’adapter, les organisations doivent repenser leur pile de gestion du trafic afin de la rendre programmable à l’exécution, sensible au contexte et compatible avec des protocoles natifs pour les agents, tels que Model Context Protocol (MCP). Cela implique de remanier la logique de repli, d’adopter l’observabilité sémantique et de permettre l’application de politiques émanant des agents. Des outils émergents, comme l’étiquetage des données en temps réel, apportent un soutien essentiel à cette transition.
En bref, l’avenir de la gestion du trafic ne consiste plus seulement à acheminer des paquets, mais à concrétiser une intention.
Architectures d’agents : caractéristiques clés
Les architectures d’agents introduisent un nouveau modèle opérationnel dans lequel des composants autonomes reposant sur l’IA générative, appelés agents, accomplissent des tâches axées sur des objectifs, prennent des décisions en temps réel et disposent du contexte nécessaire pour adapter leur exécution à la volée. Ces agents fonctionnent de manière très similaire au chaînage de services actuel, mais sans s’appuyer sur des workflows préconfigurés. Ils déterminent plutôt le flux d’exécution approprié au moment de l’exécution, en fonction des objectifs, de l’état de l’environnement et des résultats observés.
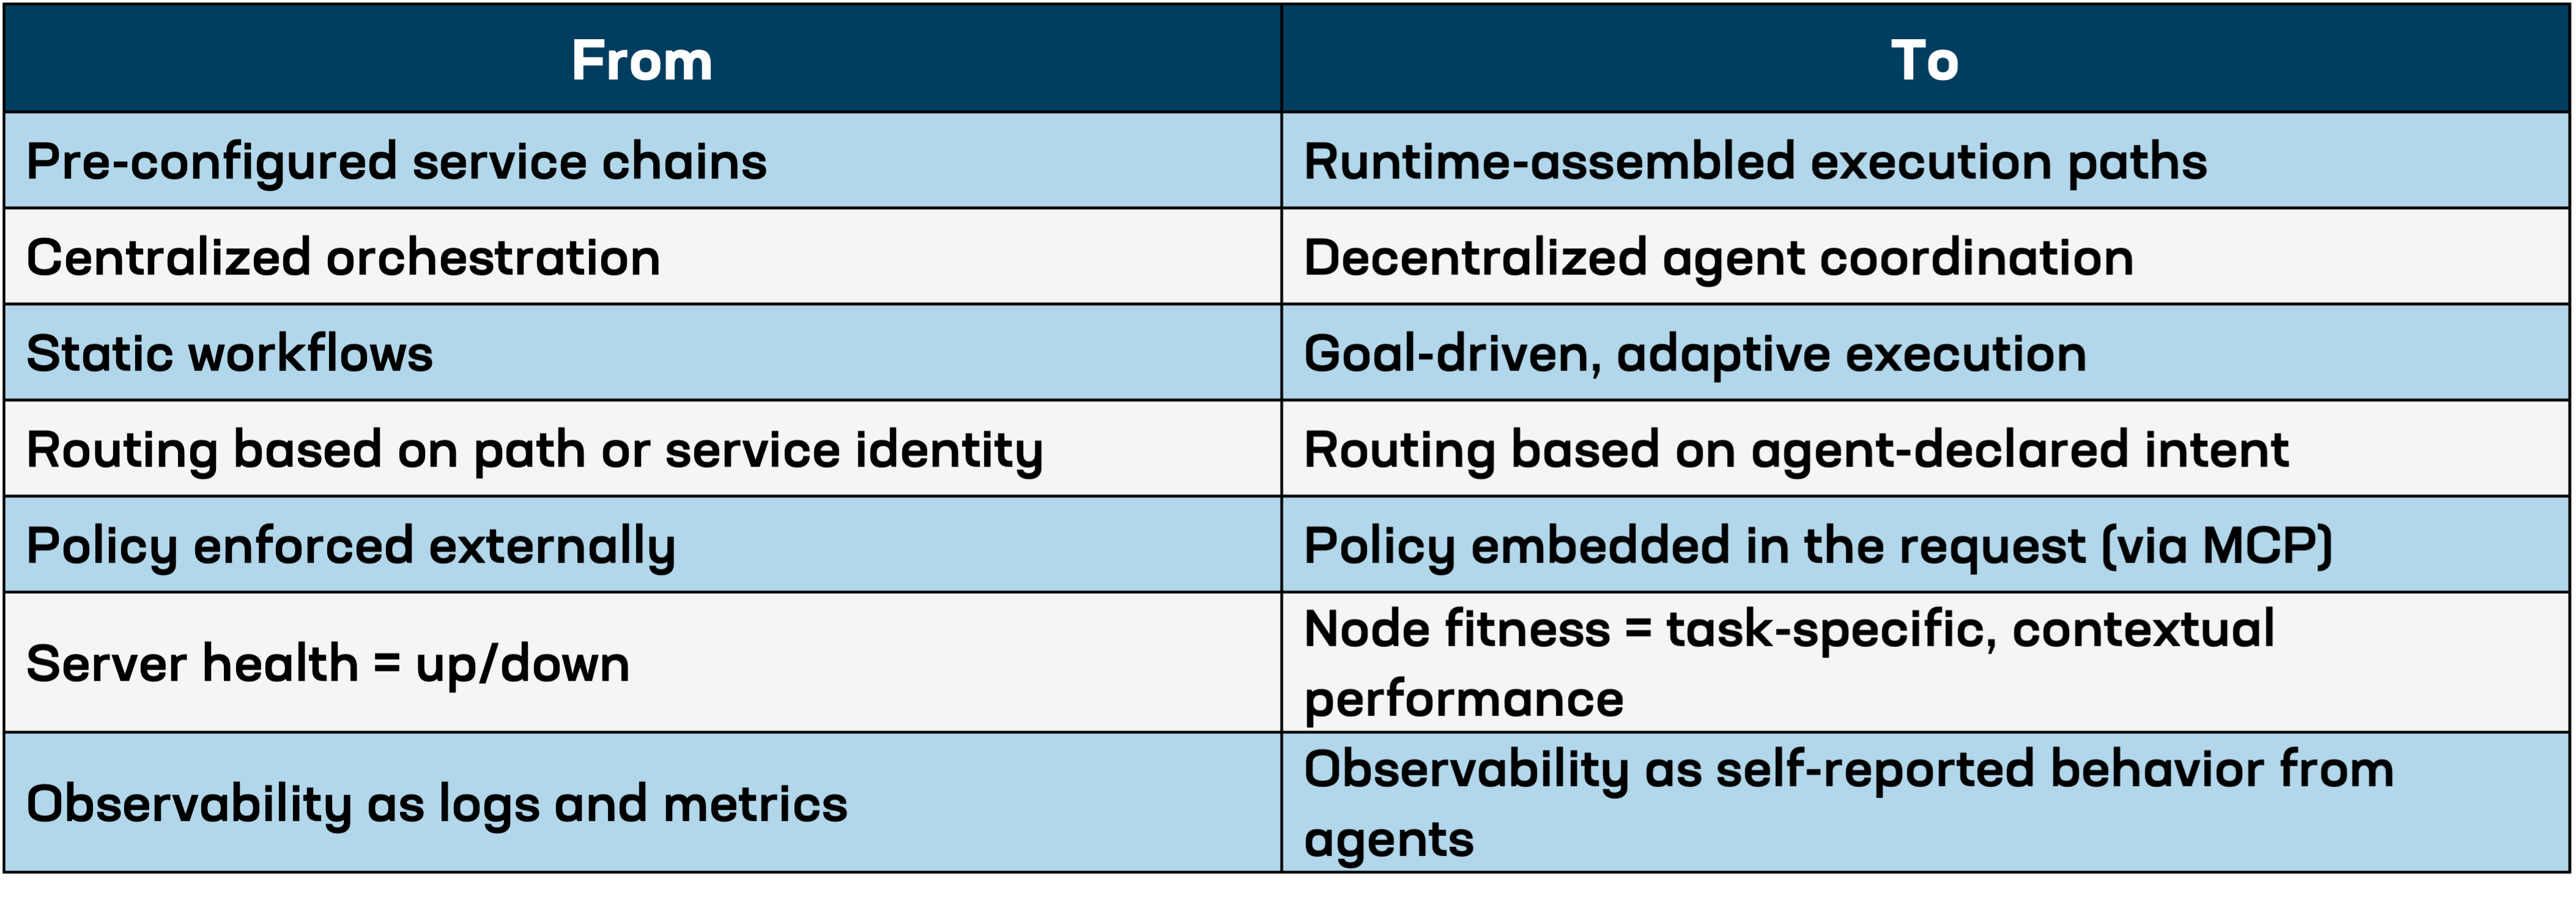
Cette évolution marque le passage de systèmes traditionnels, orchestrés de manière centralisée et reposant sur des workflows prédéfinis, à des systèmes décentralisés et dynamiques, capables de construire des chemins d’exécution en temps réel. Elle remplace la prévisibilité des chaînes statiques de microservices par une prise de décision fluide et réactive, guidée par les données en temps réel et les intentions.
Les systèmes à base d’agents se caractérisent par les éléments suivants :
- Exécution axée sur les objectifs : Les agents agissent en fonction d’instructions ou de missions, et non de workflows statiques. Ils sélectionnent des API, modifient des paramètres et adaptent leur parcours selon qu’ils atteignent ou non leur objectif. Exemple : Un agent chargé de « résoudre une réclamation client » peut faire appel aux API de facturation, de gestion des comptes et de messagerie de différentes manières en fonction des résultats précédents.
- Contexte portable : Les agents disposent de leur propre mémoire, de leur propre état et de leurs propres règles. Grâce au protocole Model Context Protocol (MCP) ou à des métadonnées structurées, ils intègrent ce contexte à chaque requête.
- Adaptation à l’exécution : Plutôt que d’attendre que l’infrastructure prenne une décision, les agents s’adaptent à la volée en effectuant de nouvelles tentatives, en réacheminant ou en faisant remonter les demandes, ou encore en ajustant les chemins d’exécution en temps réel.
- Observabilité intégrée : Chaque action est auto-documentée. Les agents peuvent expliquer pourquoi ils ont choisi une voie, ce qui a été évalué et si un objectif a été atteint. Il s’agit d’une observabilité en tant que comportement, et non de simples journaux et métriques.
Ensemble, ces éléments font évoluer le paysage applicatif, qui passe d’un environnement prévisible à un environnement adaptatif et en constante évolution.
Impact sur la gestion traditionnelle du trafic
Les systèmes actuels de gestion du trafic reposent sur des limites clairement définies :
- Le plan de contrôle définit l’intention : quels points de terminaison sont valides, quels chemins privilégier et quelles politiques appliquer.
- Le plan de données exécute les décisions : il achemine les requêtes, applique les règles de sécurité et équilibre la charge.
Ce modèle a fait ses preuves pendant des décennies, notamment dans les architectures orientées services et les environnements de microservices. Il part du principe que les flux de trafic peuvent être modélisés à l’avance et que les charges de travail suivent des schémas prévisibles.
Exemples :
- Un équilibreur de charge achemine
/api/loginvers un pool et/api/imagesvers un autre. - Les contrôles d’intégrité indiquent si les nœuds sont disponibles ou hors service.
- Des seuils statiques déterminent les conditions de basculement.
Ces systèmes reposent sur :
- Couplage étroit des stratégies et de la configuration avec des ressources statiques, telles que des pools et des membres spécifiques
- Structures statiques telles que les pools et les membres
- Routage déterministe basé sur le chemin, l’en-tête ou le protocole
- Orchestration centralisée pour la découverte de services, les contrôles d’intégrité et la logique de repli
Mais les systèmes basés sur des agents introduisent une fluidité, une autonomie et une logique autodirigée qui remettent en cause ces hypothèses.
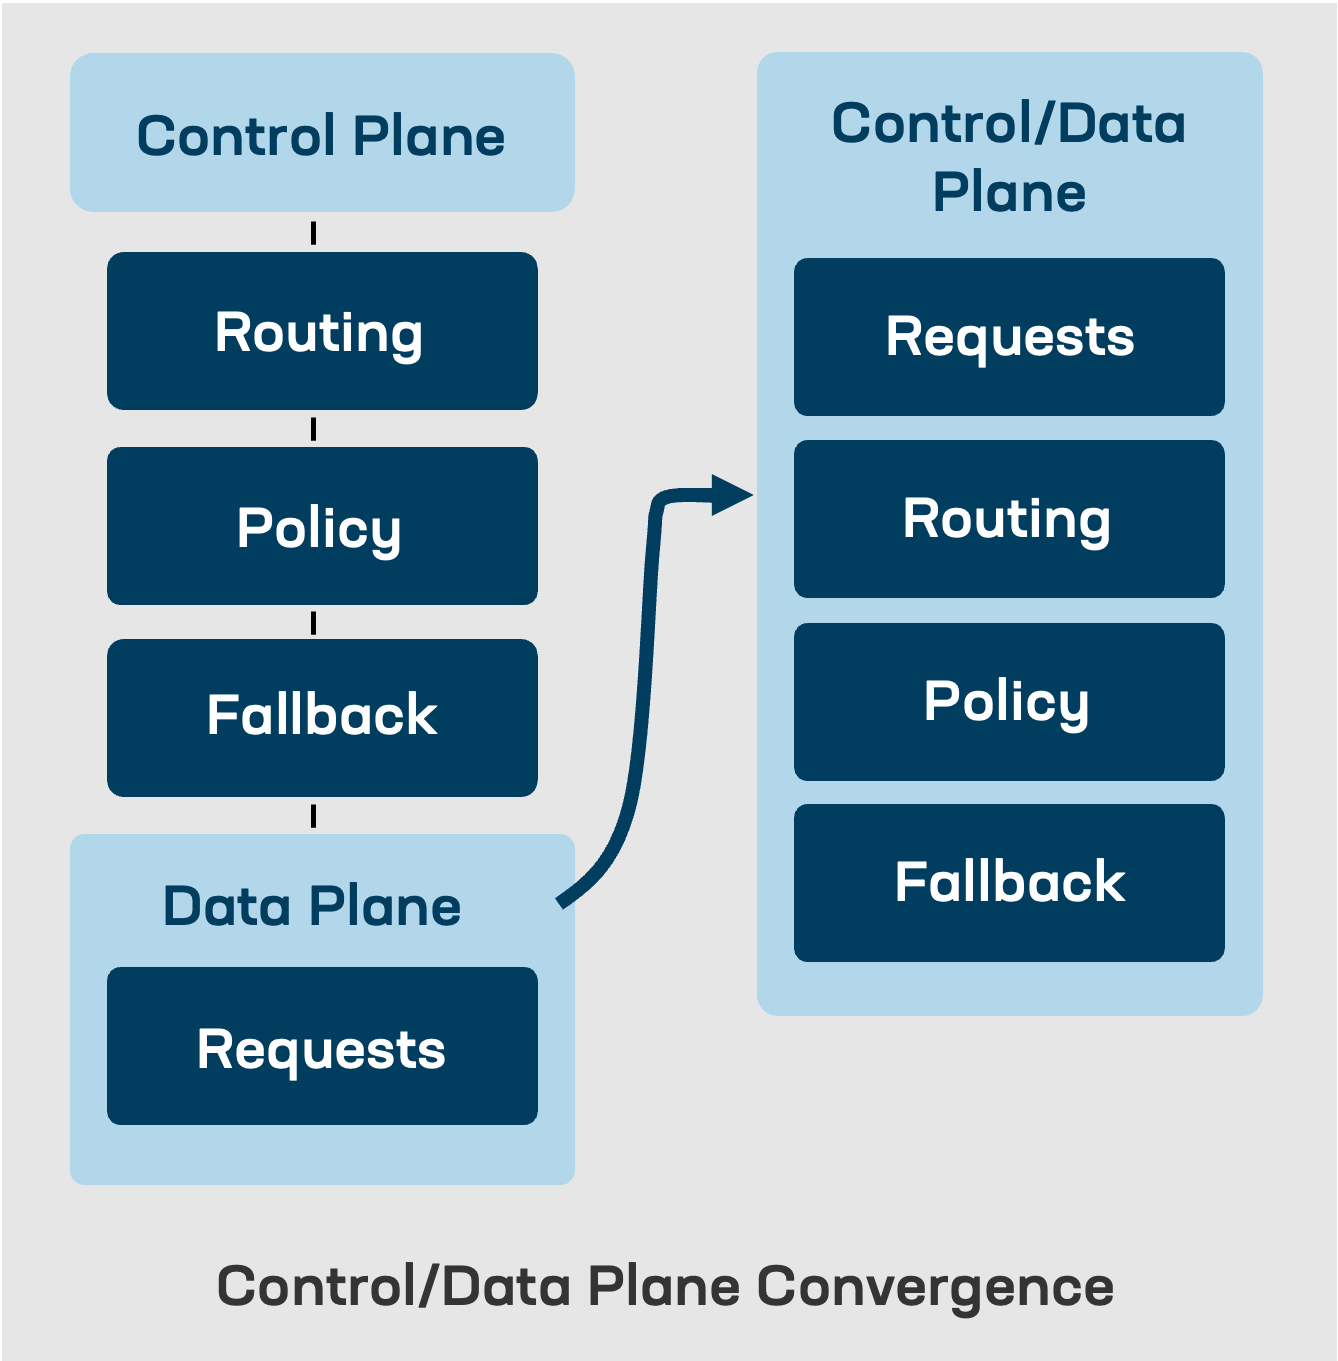
Dans les architectures à base d’agents, la séparation traditionnelle entre le plan de contrôle et le plan de données commence à s’estomper. Les agents ne se contentent pas d’exécuter des requêtes : ils intègrent la logique qui définit la nature de la requête, les conditions devant déclencher des mécanismes de repli, la manière dont la réussite est mesurée, et même l’itinéraire à privilégier. Ces aspects relèvent traditionnellement du plan de contrôle, mais les agents les encodent dans des en-têtes, des jetons ou des métadonnées qui accompagnent la requête elle-même à travers le plan de données.
Cette convergence signifie que le plan de données ne peut plus se contenter d’exécuter passivement des décisions centralisées. Il doit interpréter activement les politiques à la volée. La requête n’est plus un simple paquet : elle devient un artefact de politique. Par conséquent, les répartiteurs de charge, les passerelles et les couches de routage doivent évoluer pour passer de composants réactifs à des interprètes en temps réel des intentions véhiculées par les agents.
Cette évolution remet en cause le postulat architectural fondamental selon lequel le plan de contrôle est statique et centralisé. La logique de décision devient au contraire distribuée, portable et personnalisée : elle accompagne chaque requête et s’exécute au moment du traitement. Il ne s’agit pas seulement d’un changement dans le mode de déploiement, mais d’une transformation du lieu et de la manière dont les décisions sont prises.
Cela parachève en pratique ce que Kubernetes avait commencé en faisant abstraction de l’infrastructure sous-jacente — réseau, stockage et même routage du trafic de couche 4 — pour reléguer l’ensemble au rang de simple « plomberie » derrière une interface de contrôle déclarative. Kubernetes n’a pas supprimé ces couches, mais les a reléguées au second plan. Elles sont devenues invisibles, automatisées et subordonnées à un nouveau système piloté par les intentions.
Les architectures à base d’agents font de même, mais à l’échelle de l’ensemble de la pile, et pas seulement de l’infrastructure.
Perturbations critiques de la gestion du trafic
Pour illustrer concrètement ces perturbations, prenons l’exemple d’un scénario de livraison locale d’applications :
Exemple : Un site régional de commerce électronique utilise un contrôleur de mise à disposition d’applications (ADC) pour gérer le trafic interne des API. Un agent d’IA est chargé d’optimiser la rapidité de traitement des commandes. Il constate qu’un point de terminaison d’API spécifique, par exemple /api/inventory/check, subit une dégradation des performances en raison de la complexité accrue des requêtes et de conflits d’accès à la base de données du back-end. Les algorithmes traditionnels d’équilibrage de charge, notamment celui de la « réponse la plus rapide », ne permettent pas de rendre compte des subtilités de ce ralentissement, car ils calculent les performances sous la forme d’une moyenne globale de toutes les réponses d’un membre donné du pool, et non pour chaque tâche ou appel.
Pour respecter son SLA, l’agent redirige ces requêtes de vérification des stocks vers un autre groupe de nœuds optimisé pour les requêtes transactionnelles. Pour ce faire, il ajoute à chaque requête un en-tête contextuel, tel que X-Task-Profile: inventory-sensitive. S’il est correctement configuré, l’équilibreur de charge peut l’interpréter et acheminer le trafic en conséquence. Toutefois, comme ces nœuds n’ont pas été préaffectés au pool statique associé à /api/inventory, les services de pilotage du trafic doivent être capables de respecter les directives transmises par l’agent et de déterminer dynamiquement le routage sans s’appuyer sur des structures statiques.
Ce scénario met en évidence les limites des structures statiques telles que les pools, ainsi que la nécessité d’une gestion du trafic programmable de manière dynamique et tenant compte du contexte.
Les systèmes basés sur des agents remettent en cause plusieurs hypothèses fondamentales de l’ingénierie du trafic :
Convergence des plans de contrôle et de données : Alors qu’auparavant les décisions de routage reposaient sur des règles statiques, elles sont désormais dictées par la requête elle-même. Cela remet en cause la logique d’application traditionnelle.
Routage basé sur l’intention : Les agents acheminent le trafic en fonction des objectifs, et pas seulement des points de terminaison. Un même point de terminaison, tel que /api/process peut gérer des centaines de flux de tâches différents, selon les directives des agents.
Les pools statiques deviennent obsolètes : Les pools traditionnels reposent sur des rôles fixes. Or, les agents peuvent avoir besoin d’accéder à des GPU à un moment donné, puis de ressources optimisées pour les CPU l’instant suivant, ce qui rend l’appartenance à un pool trop rigide.
Les solutions de repli et le basculement deviennent stratégiques : Auparavant, le basculement consistait à « essayer le serveur suivant ». Désormais, les agents évaluent les performances en temps réel et les résultats passés, puis décident stratégiquement de la marche à suivre.
Les schémas de trafic émergent, ils ne se répètent pas : Les agents créent des workflows à la demande. Il est impossible de prédéfinir tous les parcours : ils se forment en fonction des besoins.
Ces bouleversements obligent les répartiteurs de charge, les passerelles et les plateformes d’observabilité à s’adapter à une logique de trafic fluide et en temps réel.
Repenser les indicateurs de santé et de performance
Les indicateurs de santé et de performance ont toujours été essentiels à la gestion du trafic. Les décisions d’équilibrage de charge reposent sur la connaissance de la disponibilité d’un serveur, de son temps de réponse et de son niveau de charge. Mais dans les systèmes pilotés par des agents, l’état de santé n’est pas binaire et les performances ne peuvent pas être moyennées sur de grandes catégories. Les indicateurs doivent refléter si une cible est adaptée à une tâche spécifique, et pas seulement si elle est opérationnelle.
Pourquoi est-ce important ? Les indicateurs de santé influencent directement l’orientation du trafic, les décisions de basculement et l’optimisation des performances. Dans un environnement conçu nativement pour les agents, chaque requête répond à une intention différente et peut nécessiter un chemin ou une garantie de réponse spécifique. Les approches traditionnelles ne peuvent pas répondre à ce besoin pour les raisons suivantes :
- Elles reposent sur des agrégats superficiels (par exemple, le temps de réponse moyen) qui masquent les variations propres à chaque tâche.
- Ils évaluent l’état de santé uniquement du point de vue du serveur, sans aucune visibilité sur la réussite ou la satisfaction des agents.
- Ils supposent une homogénéité du trafic, ce qui ne se vérifie pas lorsque les requêtes sont façonnées par des décisions prises au moment de l’exécution.
Exemple : Un pool de serveurs d’API peut être entièrement considéré comme « sain » selon les contrôles d’intégrité, alors que l’un d’eux ne parvient systématiquement pas à fournir des réponses en moins de 100 ms pour les requêtes X-Task-Profile: inventory-sensitive. Un agent qui s’attend à ce profil de latence considérera cela comme une défaillance, même si l’infrastructure ne détecte aucune anomalie.
Ce qui est nécessaire :
- Une télémétrie en temps réel pour chaque requête, reflétant l’intention et les résultats observés.
- Évaluation de l’état de santé propre à chaque tâche, permettant de détecter lorsqu’un nœud est dégradé pour certaines tâches, même s’il fonctionne correctement pour d’autres.
- Des boucles de rétroaction qui intègrent les réussites ou les échecs signalés par les agents dans la logique de routage et de priorisation.
Les outils d’annotation des données peuvent jouer ici un rôle essentiel en étiquetant le trafic en temps réel et en évaluant les performances ainsi que l’adéquation au contexte. Les systèmes peuvent ainsi déterminer non seulement ce qui s’est passé, mais aussi si cela a permis d’atteindre l’objectif de l’acteur à l’origine de l’action.
Mécanismes de repli, disjoncteurs et capacités de nouvelle tentative dans les architectures d’agents
Dans une infrastructure traditionnelle, les mécanismes de repli, tels que les nouvelles tentatives, la redirection vers des nœuds de secours ou le déclenchement de disjoncteurs, sont mis en œuvre au niveau de la couche d’infrastructure. Les répartiteurs de charge, les proxys et les passerelles utilisent des seuils prédéfinis (par exemple, des délais d’expiration ou des taux d’erreur) pour déterminer quand cesser d’acheminer le trafic vers une cible et tenter d’utiliser une autre cible.
Les architectures d’agents inversent cette logique.
Les agents disposent de leurs propres stratégies de repli. La requête elle-même intègre leurs politiques de nouvelle tentative, leur logique d’escalade et leurs priorités axées sur les objectifs. Cela accroît la complexité et peut entraîner des conflits avec les mécanismes de basculement au niveau de l’infrastructure.
Pourquoi est-ce important ?
- L’infrastructure peut considérer une défaillance comme récupérable, tandis que l’agent la juge inacceptable (ou inversement).
- L’agent et l’infrastructure peuvent tous deux tenter simultanément un mécanisme de repli, entraînant des tentatives répétées inutiles, une latence accrue ou des boucles de trafic.
- Les disjoncteurs conçus pour un trafic moyen peuvent bloquer l’accès à des services qu’un agent considère toujours comme optimaux.
Principaux risques :
- Double mécanisme de repli : L’agent et l’infrastructure réessaient tous deux, ce qui génère une charge inutile.
- Conditions de concurrence : L’agent opte pour une solution plus coûteuse ou moins sécurisée, alors que le système aurait résolu le problème en quelques millisecondes.
- Défaillance du basculement déterministe : Les politiques statiques ne peuvent pas prendre en compte les subtilités propres aux agents.
- Corruption : Les métadonnées de l’agent sont mal formées, manquantes ou illisibles.
Conseils d’adaptation :
- L’infrastructure devrait évoluer afin de prendre en compte les priorités de repli définies par l’agent (par exemple, via
X-Fallback-Order,X-Timeout-Preference). - Les disjoncteurs doivent tenir compte de l’intention afin de prendre en charge une logique propre à chaque tâche ou à chaque agent, plutôt que des seuils globaux.
- Envisagez d’introduire une logique de basculement tenant compte des négociations, dans laquelle les agents proposent leurs stratégies privilégiées et les passerelles tranchent en fonction de l’état du système, de la charge et des règles en vigueur.
- Les systèmes de gestion du trafic doivent prendre en charge une logique d’exécution par défaut lorsque les métadonnées de l’agent sont absentes, incomplètes ou ne respectent pas la validation du schéma, afin d’assurer un fonctionnement en mode dégradé.
- L’infrastructure doit détecter et empêcher les délégations récursives ou les nouvelles tentatives conflictuelles des agents susceptibles de provoquer des boucles ou d’amplifier le trafic en cas de dégradation du système.
Exemple : Un agent chargé d’effectuer une vérification antifraude en temps réel demande une réponse sous 50 ms. Sa logique de repli privilégie un résultat partiel mis en cache plutôt qu’une requête complète trop lente. Une infrastructure qui n’en tient pas compte peut malgré tout acheminer la requête vers le service principal, entraînant une latence perceptible par l’utilisateur. Un modèle plus coopératif respecterait la priorité de repli de l’agent et fournirait plus rapidement la réponse en mode dégradé.
À mesure que la prise de décision remonte dans la pile, les stratégies de repli doivent suivre le même mouvement. Les disjoncteurs et la logique de nouvelle tentative ne peuvent rester statiques ou opaques ; ils doivent s’adapter aux préférences exprimées par les agents tout en préservant la sécurité et l’équité globales du système.
La haute disponibilité et le basculement restent essentiels
Bien que les architectures à base d’agents déplacent la prise de décision et la coordination vers la couche de requêtes, l’infrastructure sous-jacente reste chargée de garantir la fiabilité du système central. Les mécanismes de haute disponibilité (HA) et de basculement au niveau de l’infrastructure demeurent donc essentiels. Ils deviennent même encore plus critiques à mesure que les systèmes adoptent un comportement plus dynamique et autonome.
Les agents peuvent orienter le trafic en fonction des objectifs et du contexte, mais ils dépendent toujours du réseau pour garantir que les services restent accessibles et résilients en cas de problème. Les répartiteurs de charge doivent détecter les nœuds inaccessibles, les services défaillants ou les environnements dégradés, et réacheminer le trafic en temps réel, quelle que soit la stratégie de repli de l’agent.
Responsabilités fondamentales qui ne changent pas :
- Surveiller les membres du pool et l’état des services backend
- Détecter les partitions réseau ou les défaillances de routage
- Rediriger le trafic en fonction de l’état de fonctionnement, de la disponibilité ou d’une dégradation au niveau du système
- Maintenir la haute disponibilité des services avec état ou des sessions lorsque cela est nécessaire
Les agents peuvent intégrer une logique permettant de déterminer « ce qui doit se passer ensuite », mais l’équilibreur de charge reste responsable de « la rapidité avec laquelle le service est rétabli lorsqu’un nœud tombe en panne ».
Il est essentiel que la logique de routage adaptative tenant compte des agents ne se fasse pas au détriment de la stabilité opérationnelle. Une infrastructure dotée d’une observabilité efficace doit conserver :
- Basculement instantané et rééquilibrage du trafic lorsque des nœuds deviennent indisponibles
- Topologies haute disponibilité résilientes qui protègent les agents et les services contre les défaillances en amont
- Une récupération rapide et automatisée qui complète la logique de repli des agents au lieu d’entrer en conflit avec elle
En bref, les architectures pilotées par des agents ne suppriment pas la nécessité d’un mécanisme de basculement : elles en renforcent les enjeux. L’infrastructure doit désormais réagir plus rapidement, avec une meilleure prise en compte du contexte, sans pour autant entraver les comportements autonomes.
Conséquences pour la gestion du trafic en entreprise
Le passage à des architectures basées sur des agents modifie fondamentalement le fonctionnement des systèmes de gestion du trafic tels que les répartiteurs de charge et les passerelles. Alors que les systèmes traditionnels prenaient leurs décisions en fonction de règles préconfigurées, souvent externes à la requête, les systèmes pilotés par des agents intègrent ces règles directement dans la requête. C’est le principe même du protocole Model Context Protocol (MCP) : permettre l’exécution, pour chaque requête, de règles intégrées.
Nous appellerons ce modèle « politique dans la charge utile ». Au lieu de confier à des systèmes centralisés l’analyse de chaque cas particulier, l’agent intègre à chaque requête les décisions de politique pertinentes (telles que la stratégie de repli, la préférence de nœud, la tolérance aux erreurs ou les exigences en matière de confidentialité). L’infrastructure doit ensuite lire, interpréter et appliquer ces instructions de politique en temps réel.
Ce nouveau modèle d’exécution transforme le rôle des composants de gestion du trafic :
- De décideurs à exécutants : L’infrastructure ne détermine plus où le trafic est acheminé ; elle applique la décision transmise par l’agent.Exemple : Un équilibreur de charge qui lit
X-Route-Preference: gpu-optimizeddoit acheminer le trafic en conséquence, même si ce nœud ne faisait pas partie du pool initial. - Programmable à l’exécution : les iRules et les politiques doivent évaluer des en-têtes tels que
X-Intent,X-ContextouX-Goal. La logique ne repose ainsi plus sur des chemins préconfigurés, mais sur une interprétation dynamique à la volée. - Routage contextuel : Les ADC et services similaires doivent effectuer le routage en fonction de l’identité, de l’intention et du contexte, et pas seulement de l’hôte ou du chemin.
- Observabilité sémantique : Les journaux doivent indiquer non seulement ce qui s’est passé, mais aussi pourquoi : « L’agent a réacheminé le trafic en raison d’un dépassement du seuil de latence » est plus utile que la simple mention « trafic acheminé vers le pool B ».
Les technologies d’annotation des données et les outils similaires peuvent accompagner cette évolution en étiquetant et en classant le contexte des requêtes en temps réel, afin de faciliter la mise en œuvre du routage sémantique et de l’observabilité.
Préparer l’infrastructure d’entreprise aux architectures d’agents
Les agents d’IA ne fonctionneront pas de manière isolée. Ils interagiront avec les systèmes existants, exploiteront les API traditionnelles, manipuleront la logique métier dans les bases de données d’entreprise et appelleront des fonctions hébergées aussi bien sur des back-ends monolithiques que sur des microservices. Pour les entreprises, cela signifie qu’il n’est pas possible de repartir de zéro : elles doivent évoluer.
La réalité : les agents communiqueront avec tout
Les environnements technologiques d’entreprise combinent :
- Des API SOAP vieilles de plusieurs décennies, toujours utilisées dans le secteur financier
- Services RESTful sous-jacents aux applications web
- Files d’attente de messages pour les systèmes de gestion des stocks asynchrones
- Microservices natifs du cloud
- API SaaS avec des limites de débit et une authentification complexe
- LLM et agents affinés
Les agents doivent apprendre à fonctionner dans l’ensemble de cet environnement. Et votre infrastructure doit apprendre à orchestrer cette interaction en temps réel, en appliquant des politiques adaptées au contexte.
Ce que les équipes d’entreprise doivent préparer
1. Exposer les systèmes internes via des interfaces adaptées aux intentions
Les agents ne veulent pas cinq points de terminaison, mais un seul objectif. Exposez les fonctionnalités métier (par exemple, « obtenir le statut de la commande ») au moyen de couches d’abstraction ou de compositions d’API que les agents peuvent utiliser via un point d’entrée sémantique unique.
Étape préparatoire : Utilisez des passerelles API ou des maillages de services pour regrouper les points de terminaison axés sur les tâches, avec des contrats d’entrée/sortie clairement définis.
2. Instrumentez pour recueillir du contexte, pas seulement des métriques
La journalisation traditionnelle se concentre sur la méthode, le chemin d’accès et le temps de réponse. Mais les agents s’intéressent plutôt aux éléments suivants :
- Quelle était la tâche
- Quelle solution de repli a été tentée
- Si l’objectif a été atteint
Étape préparatoire : Adoptez des outils d’observabilité sémantique qui étiquettent le trafic avec des libellés tels que X-Intent, X-Task-Type et X-Agent-Outcome.
3. Prendre en charge l’évaluation à l’exécution des politiques intégrées
Les agents incluent dans la requête des instructions de repli, des préférences en matière de délai d’expiration et des exigences de sécurité. L’infrastructure existante ignore ces données.
Étape préparatoire : Étendez les politiques de trafic afin d’analyser les métadonnées des agents et d’agir en conséquence (par exemple, X-Route-Preference, X-Fallback-Order, X-Data-Class). Commencez par utiliser des iRules ou un langage de script d’exécution similaire.
4. Repenser le contrôle des accès et la gouvernance
Les agents sont autonomes. Vous devez savoir :
- Quel agent agit pour le compte de qui
- À quels outils il peut accéder
- À quels périmètres de données il est autorisé à accéder
Étape préparatoire : Intégrez des contrôles d’accès fondés sur l’identité et des contrôles de stratégie fondés sur les attributs (ABAC), plutôt que de vous limiter à la mise sur liste blanche d’adresses IP ou à un contrôle d’accès statique fondé sur les rôles (RBAC).
5. Découpler la logique de repli et de nouvelle tentative
L’infrastructure et les agents ne doivent pas se livrer concurrence pour rétablir le système. Confiez à l’un les objectifs d’exécution et à l’autre l’application des mesures de protection systémiques.
Étape préparatoire : Distinguez clairement le périmètre de repli des agents (ce qu’ils contrôlent) du basculement de l’infrastructure (ce dont vous êtes responsable). Définissez les règles de négociation et les conditions de dérogation.
Conclusion
À mesure que l’IA évolue, passant de modèles isolés à des agents autonomes, les entreprises se trouvent à un tournant stratégique. Ces agents n’évolueront pas dans des environnements entièrement nouveaux : ils s’intégreront aux applications existantes, feront appel à des API héritées et orienteront les décisions au sein de systèmes métier critiques. Les entreprises doivent donc se préparer dès maintenant à les prendre en charge, non seulement en adoptant de nouveaux outils, mais aussi en repensant la manière dont leur architecture gère les intentions, l’exécution et la gouvernance.
Il ne s’agit pas de tout remplacer. C’est un moment de convergence, où les systèmes traditionnels et les nouveaux comportements des agents doivent interagir avec précision et de manière intentionnelle.
Les architectures d’agents arrivent. Les entreprises qui s’y préparent dès maintenant ne se contenteront pas de suivre : elles prendront les devants.
LORI MACVITTIE
PUBLIÉ LE 1ER JUILLET 2025