
Utiliser la technologie des conteneurs Docker avec les produits et services F5
Résumé exécutif
L’évolution des besoins informatiques et l’avènement de stratégies agiles de développement et de déploiement ont conduit à l’émergence de la « conteneurisation », une alternative à la virtualisation complète des machines, dans laquelle une application est encapsulée dans un conteneur disposant de son propre environnement d’exploitation. La conteneurisation est une solution intéressante qui permet aux développeurs d’accélérer les cycles d’itération. Elle offre également d’autres avantages en réduisant la surcharge associée aux machines virtuelles, ce qui permet une meilleure utilisation des ressources dans le centre de données défini par logiciel (SDDC).
Bien que la conteneurisation ne soit pas un concept nouveau, Docker, développé par Docker, Inc., est largement considéré comme l’implémentation de référence en raison du vaste soutien dont il bénéficie dans le secteur, de sa standardisation et de l’étendue de ses fonctionnalités. Selon l’entreprise, Docker est « une plateforme ouverte permettant de créer, de distribuer et d’exécuter des applications distribuées. Elle fournit aux programmeurs, aux équipes de développement et aux ingénieurs d’exploitation la boîte à outils commune dont ils ont besoin pour tirer parti de la nature distribuée et interconnectée des applications modernes. » Docker simplifie ainsi la gestion du cycle de vie des applications, du développement au déploiement, et garantit leur portabilité. Cette simplification est essentielle pour les entreprises, car une application peut être hébergée de différentes manières, que ce soit dans le cloud public ou sur une infrastructure de cloud privé.
Ce document présente l’orientation de F5 concernant l’utilisation des conteneurs au sein de sa technologie et la prise en charge de Docker pour la mise à disposition et la sécurité des applications. Avant d’aborder cette stratégie, il est important d’identifier les difficultés rencontrées dans les centres de données et de comprendre pourquoi ces technologies sont essentielles à la mise à disposition des applications d’entreprise de nouvelle génération.
Remarque : ce document s’adresse aux décideurs informatiques, aux architectes et aux développeurs. Il est supposé que le lecteur possède déjà des connaissances en matière de technologies de virtualisation, de développement logiciel et de processus de cycle de publication.
Défis liés à l’infrastructure des centres de données
Plusieurs études récentes sur les difficultés liées à l’infrastructure des centres de données ont mis en évidence un ensemble cohérent de besoins pour faire évoluer ces derniers :
- Méthodes de déploiement d’applications plus rapides
- Un processus amélioré de gestion des flux de travail
- Disponibilité et utilisation accrues des ressources de calcul
- Agilité accrue pour déplacer les charges de travail selon les besoins
À mesure que de nouvelles tendances émergent dans le développement d’applications, les entreprises clientes font évoluer leur vision du modèle de gestion du cycle de vie des applications comme suit :
- Les applications de nouvelle génération sont de plus en plus souvent conçues selon une approche « cloud first ».
- Linux est devenu le système d’exploitation de facto pour le développement dans le cloud.
- Applications cloud de nouvelle génération :
- Sont conçues pour être sans état et utiliser une architecture de microservices faiblement couplés.
- Utilisent des frameworks permettant de développer les services de manière indépendante, sans dépendance à une version logicielle ni à d’autres services.
- Les entreprises adoptent de plus en plus l’automatisation en utilisant des outils de gestion de la configuration (tels que Puppet, Chef et Ansible) ainsi que l’orchestration DevOps afin de gagner en agilité dans la publication de logiciels.
- À mesure que les entreprises développent de nouvelles applications et migrent leurs applications existantes vers des clouds publics, la portabilité est essentielle pour éviter toute dépendance vis-à-vis d’un fournisseur. Bien que la technologie des machines virtuelles (VM) offre un certain niveau d’abstraction, chaque hyperviseur met en œuvre son environnement différemment et n’est donc pas entièrement portable.
Docker tente de relever ces défis et s’est ainsi imposé comme une technologie de virtualisation de l’infrastructure à la fois incontournable et convaincante.
Présentation de Docker
Les conteneurs permettent la virtualisation au niveau du système d’exploitation en isolant chaque application sous la forme d’un processus du système d’exploitation. Ce concept existe depuis longtemps sous différentes formes dans des systèmes d’exploitation tels que BSD avec Jails, Oracle Solaris avec Zones et, plus récemment, Linux avec LXC. Docker s’appuie sur LXC et y a ajouté une solution simple permettant aux développeurs de créer, de conditionner et de déployer des applications sur des infrastructures cloud sans avoir recours à un hyperviseur.
Les fonctionnalités suivantes distinguent Docker des autres technologies de conteneurisation :
- Une couche d’abstraction légère (le moteur Docker) au-dessus du système d’exploitation pour gérer l’isolation et la mise en réseau entre les applications.
- Une interface de programmation d’application (API) documentée pour simplifier le déploiement d’applications sous Linux.
- Le registre Docker pour partager des applications avec d’autres utilisateurs et développeurs.
- Portabilité des applications entre les hôtes compatibles avec Docker, qu’ils soient physiques, virtuels ou hébergés dans le cloud.
- Un système de fichiers en union qui met un système de fichiers commun à la disposition de tous les conteneurs Docker.
- Un écosystème d’entreprises partenaires proposant des services et des logiciels à valeur ajoutée, permettant à Docker de s’intégrer efficacement à une grande variété de méthodes de travail en matière de développement.
Qu’est-ce qu’un système de fichiers en union ?
Un système de fichiers en union permet à chaque conteneur de fournir les services qui lui sont propres, même si le chemin d’accès et le nom de fichier correspondants entrent en conflit avec un fichier sous-jacent. Par exemple, un conteneur peut avoir besoin de la version 2.6 d’une bibliothèque Python, tandis qu’un autre peut nécessiter une version ultérieure. Le système de fichiers sous-jacent peut fournir la version 2.6, répondant ainsi aux besoins du premier conteneur. Le conteneur nécessitant la version ultérieure peut toutefois l’inclure dans son image. Cela permet de réduire la taille des images de conteneurs, puisqu’elles ne doivent contenir que les éléments strictement nécessaires à leur exécution.
Résumé de la conteneurisation Docker et de la technologie des machines virtuelles
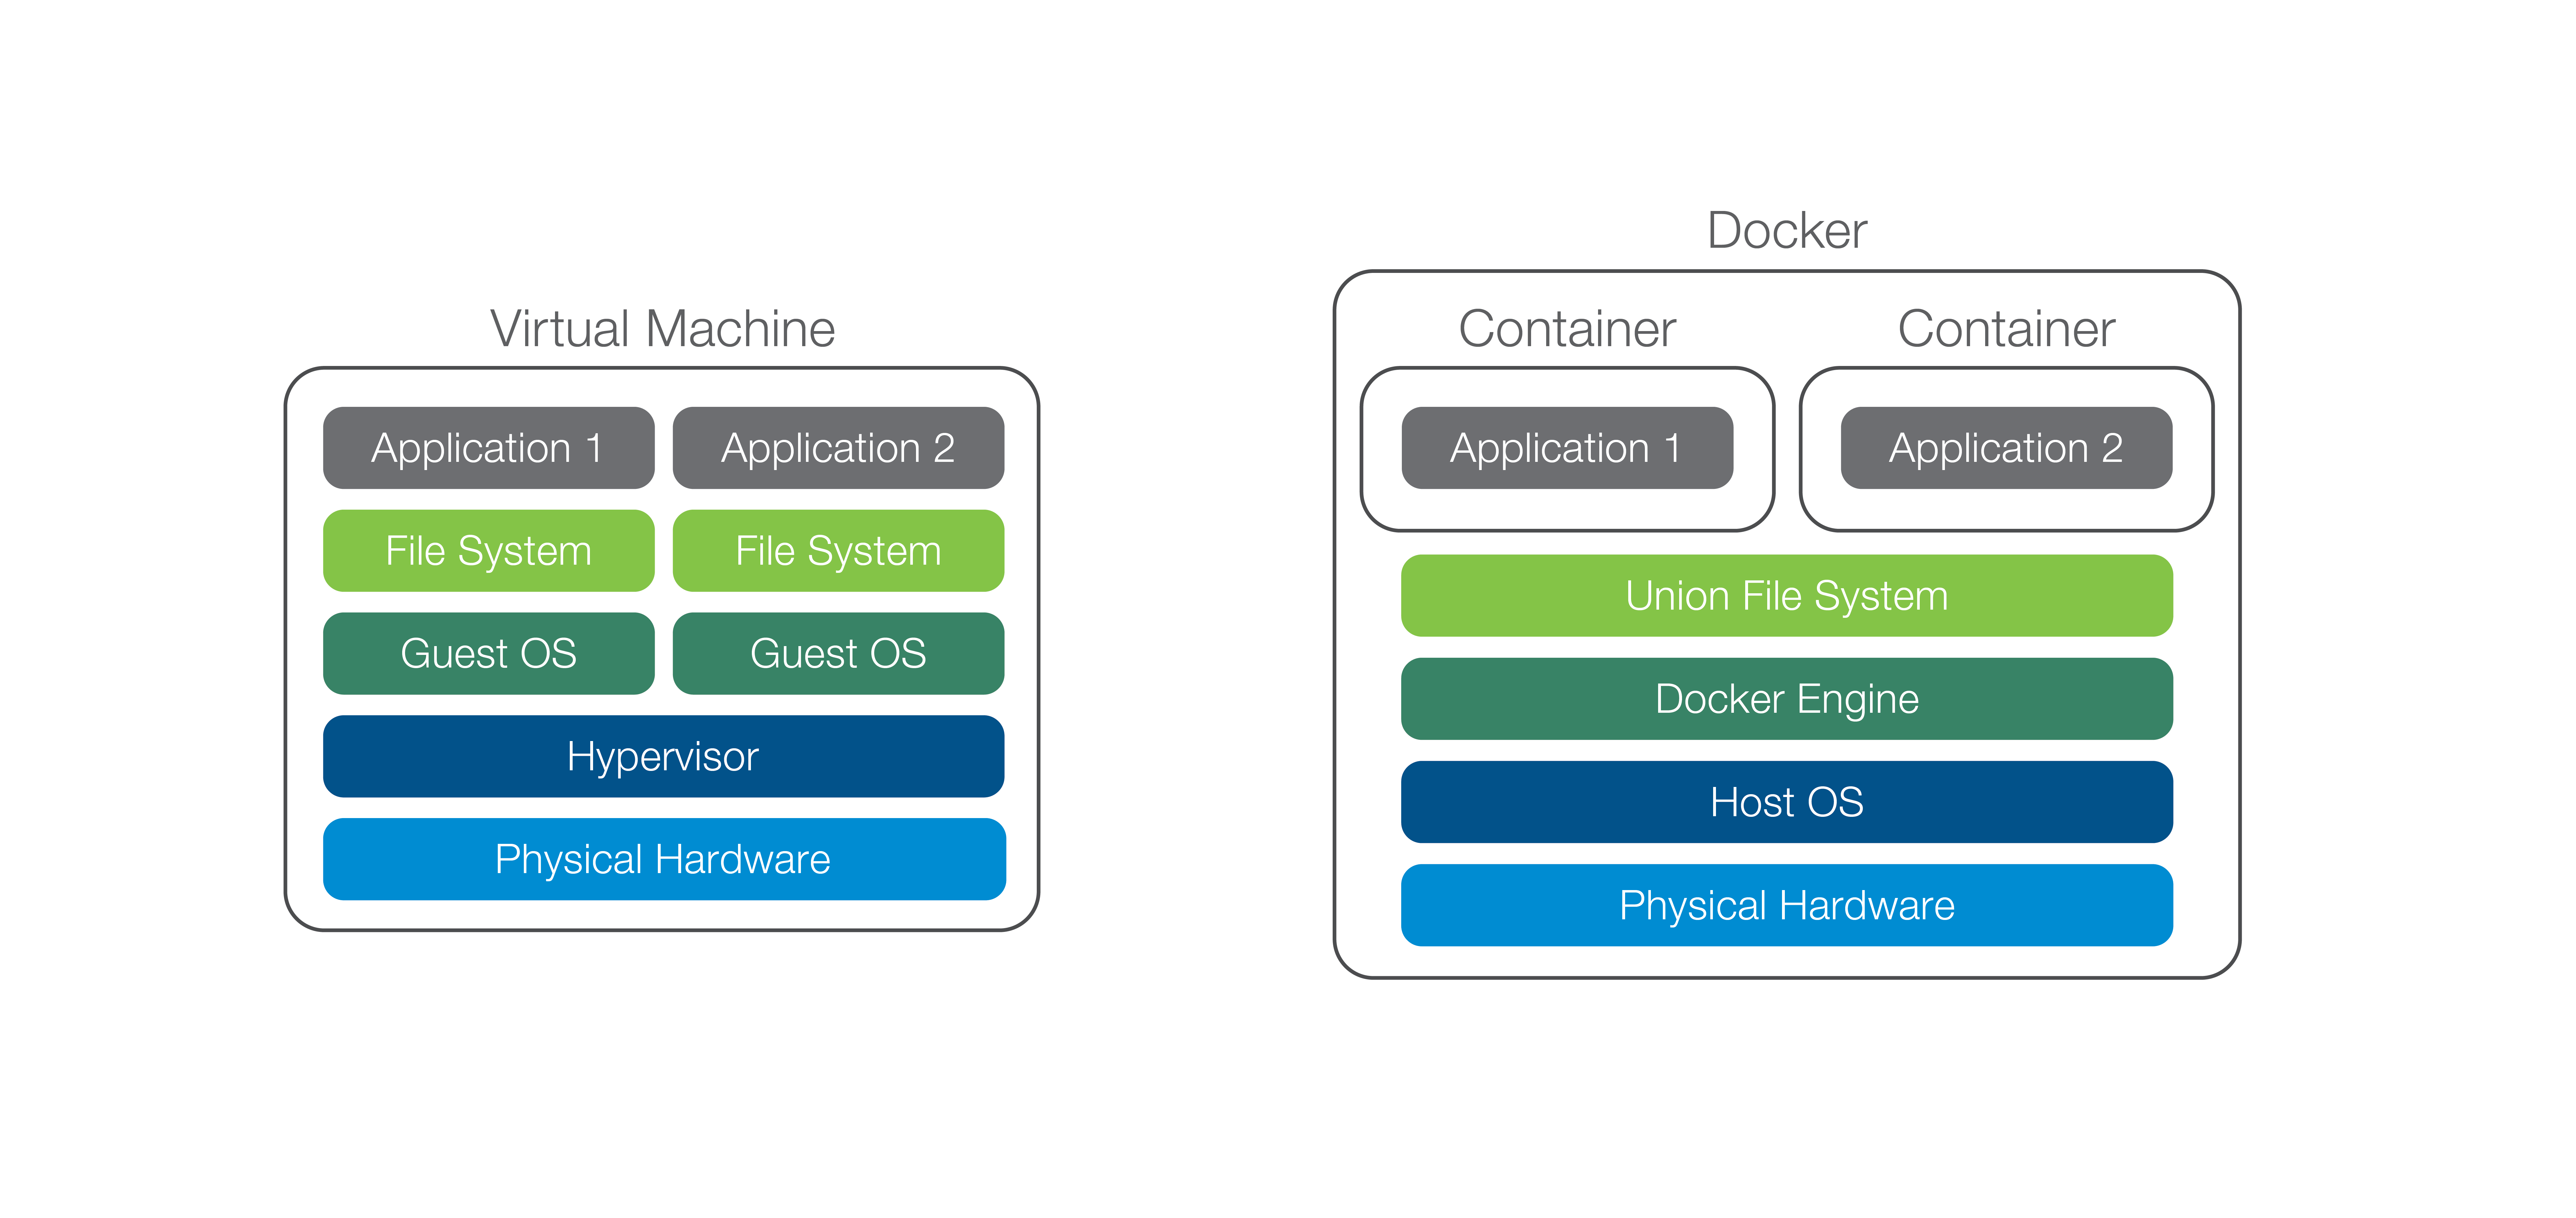
Le schéma de la figure 1 illustre les composants utilisés pour le déploiement d’applications avec des machines virtuelles et Docker. Notez que, dans cet exemple, l’approche reposant sur des machines virtuelles utilise deux systèmes d’exploitation invités pour prendre en charge deux applications. En comparaison, Docker ne nécessite qu’un seul système d’exploitation hôte pour atteindre la même densité d’applications, tout en réduisant bien entendu la surcharge nécessaire.
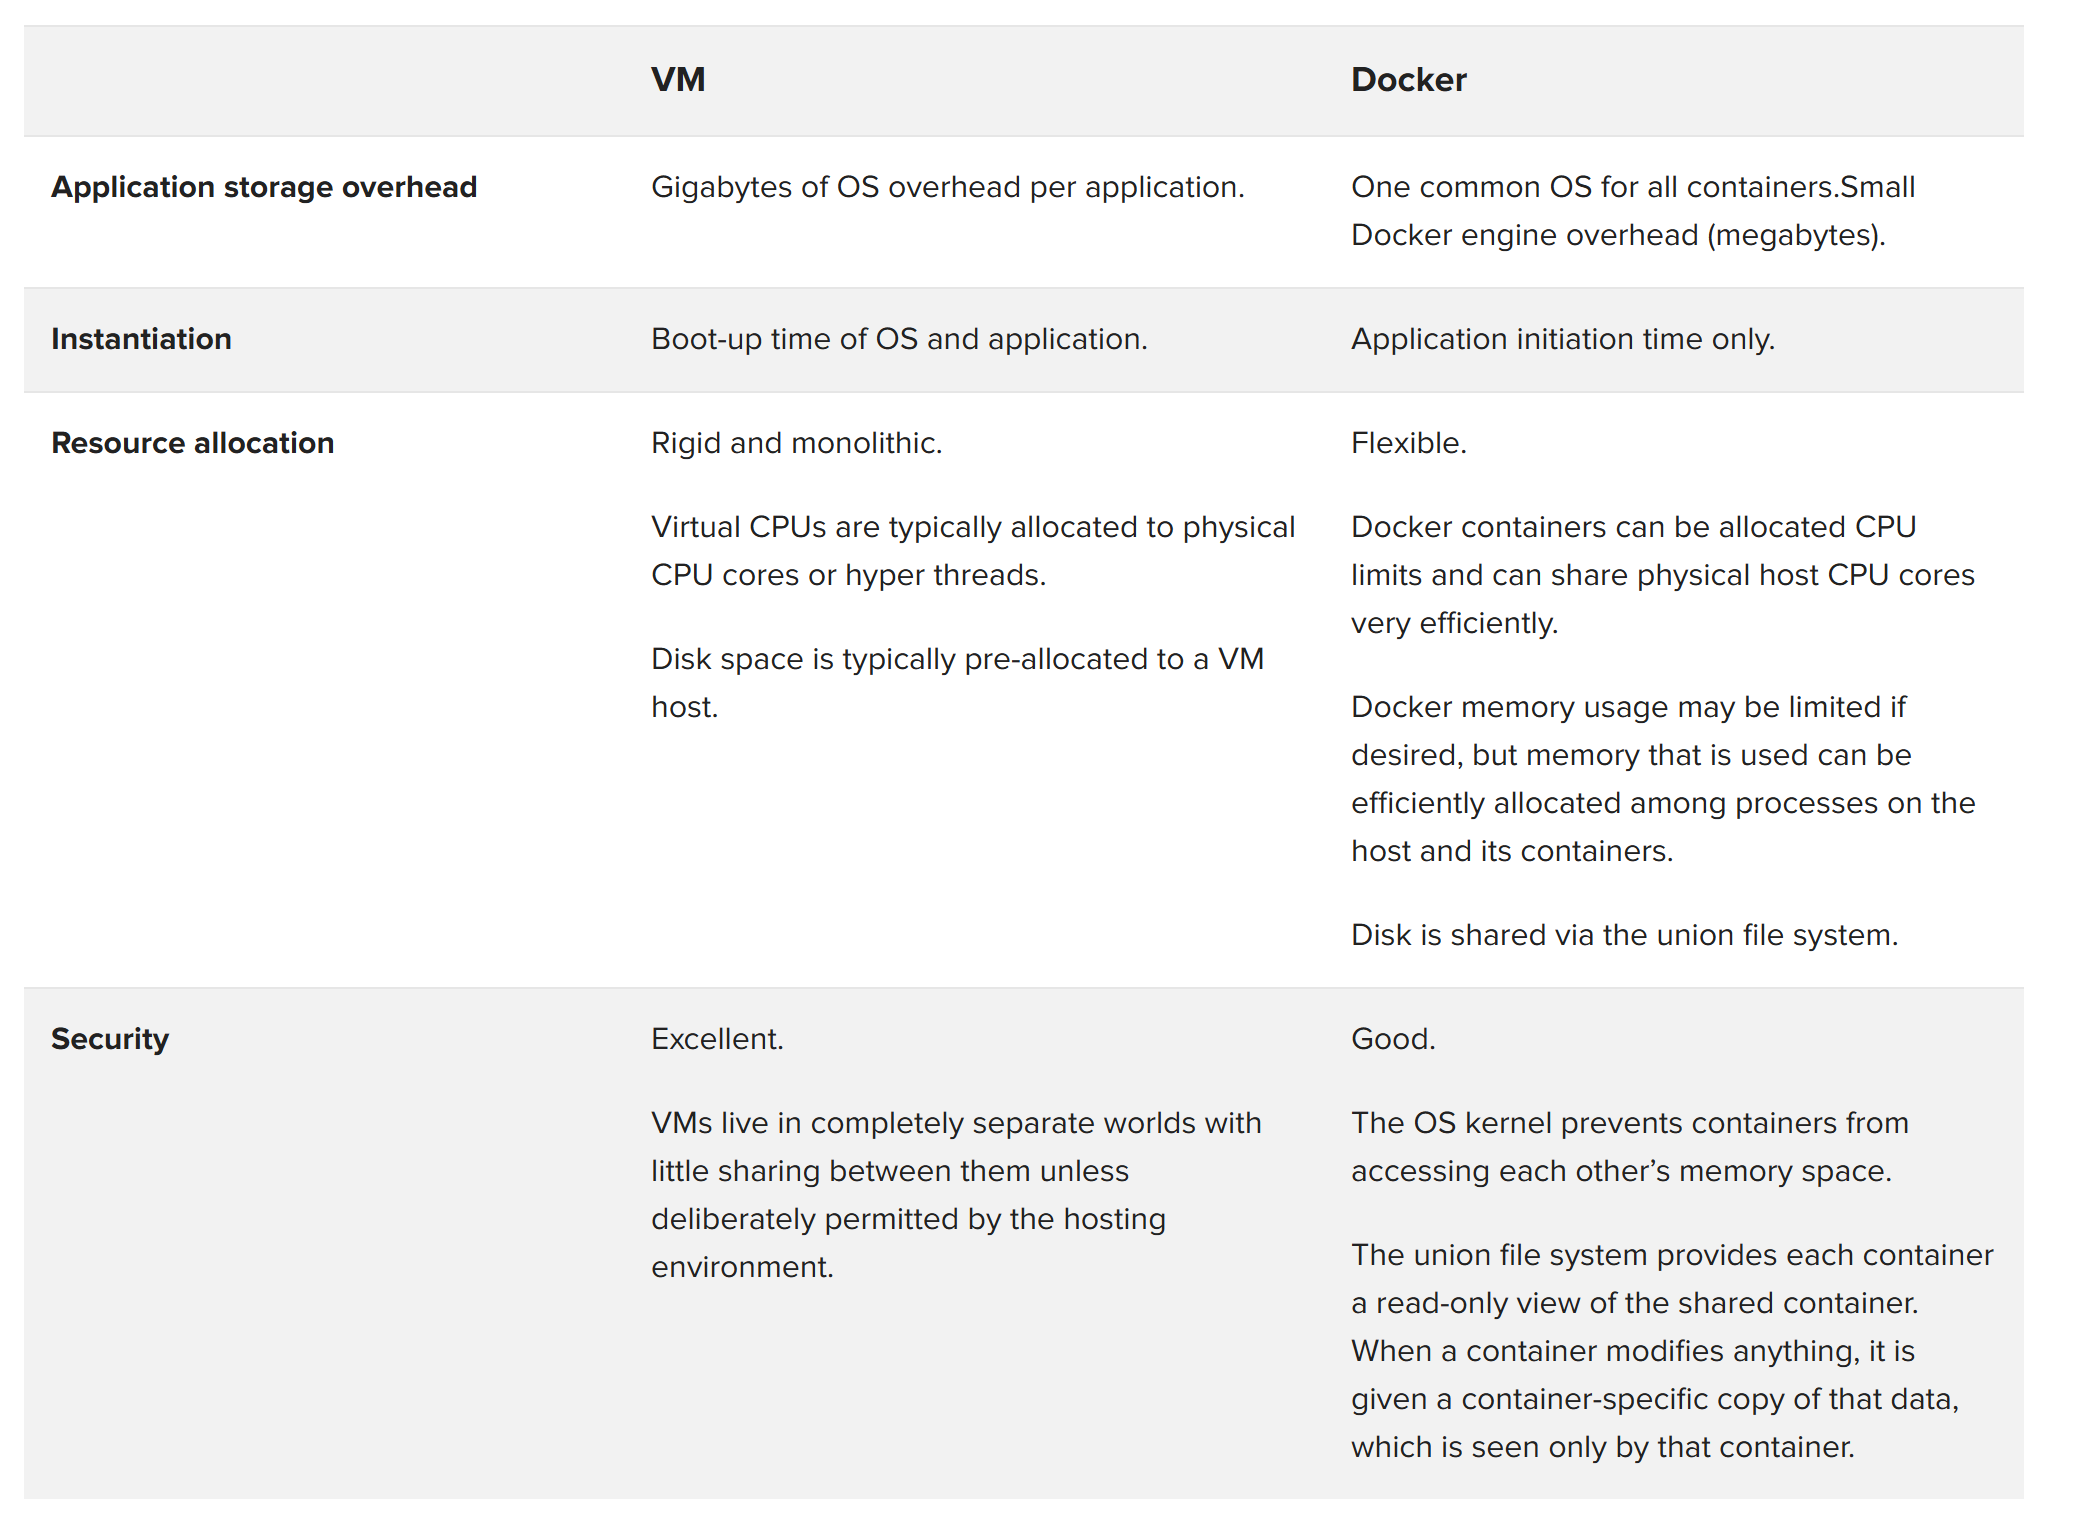
Le tableau suivant présente une comparaison des fonctionnalités des machines virtuelles et de Docker.
Docker sur des machines virtuelles
Comme indiqué précédemment, l’objectif principal de Docker est de simplifier la gestion du cycle de vie des applications. Bien que l’exécution de Docker directement sur du matériel physique soit assurément une option intéressante, son exécution sur des hyperviseurs présente certains avantages. Ceux-ci incluent la possibilité de créer des instantanés et d’effectuer des migrations à chaud d’une machine virtuelle invitée entière, deux fonctionnalités qui peuvent s’avérer essentielles pour la reprise après sinistre sans perdre l’état des opérations en cours.
Les principales solutions de gestion et d’orchestration d’infrastructures, telles que VMware vRealize Suite et OpenStack, ainsi que les clouds publics comme AWS et Azure, prennent toutes en charge Docker sur un type d’hyperviseur donné, tout en fournissant au conteneur Docker un environnement commun qui garantit la portabilité des applications quel que soit l’environnement. Ce type de modèle de déploiement hétérogène permet aux clients de commencer à utiliser Docker et de bénéficier de cycles d’itération plus rapides sans avoir à modifier l’infrastructure sous-jacente.
En passant à une seule machine virtuelle et à un seul système d’exploitation par hôte, les clients peuvent également optimiser l’utilisation des ressources, puisque les machines virtuelles n’ont plus à se les disputer. Ce gain d’efficacité tient au fait que la mémoire et le disque local peuvent être alloués à ce système d’exploitation unique, tandis que l’hyperviseur n’a plus à arbitrer entre plusieurs systèmes d’exploitation.
Présentation technique de la mise en réseau Docker
La mise en réseau vous permet de créer dans Docker Engine des réseaux virtuels couvrant plusieurs hôtes. Les conteneurs peuvent être connectés à ces réseaux où qu’ils se trouvent, ce qui vous donne un contrôle total sur la topologie du réseau et sur les conteneurs autorisés à communiquer avec les autres éléments du réseau. De plus, le système sous-jacent aux réseaux peut être remplacé par un plug-in, ce qui vous permet d’intégrer le système de mise en réseau de votre choix sans avoir à modifier l’application.
Pour prendre en charge une forte densité de conteneurs sur un hôte donné, il est important de comprendre le mécanisme par lequel chaque conteneur rejoint le réseau. Par défaut, Docker attribue à chaque conteneur une adresse privée qui n’est directement accessible que depuis un autre conteneur résidant sur le même hôte.
Pour que des services puissent accéder à un conteneur depuis un autre hôte, leur trafic doit être acheminé via la fonction de traduction d’adresses réseau (NAT) de Docker, basée sur iptables. La figure 2 en présente un exemple.
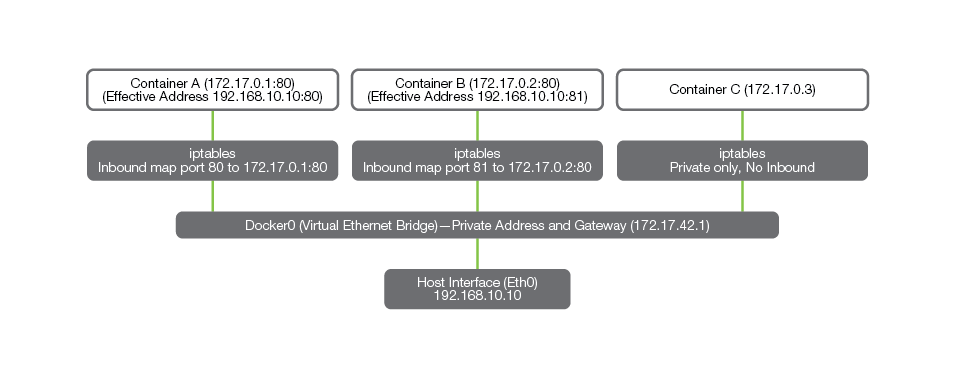
L’interface de l’hôte (Eth0) est exposée à l’aide d’une autre adresse (dans ce cas, une autre adresse RFC1918, 192.168.10.10). Une adresse dans l’espace 172.x.x/16 est automatiquement attribuée à chaque conteneur Docker lors de son démarrage. Pour qu’un conteneur puisse communiquer de manière bidirectionnelle avec des entités extérieures à son hôte, un ensemble explicite de règles doit lui être attribué via iptables.
Dans l’exemple illustré à la figure 2, les règles ont été configurées de manière à permettre aux conteneurs de communiquer au moyen d’un mappage d’adresses IP et de ports, le conteneur A étant accessible à l’adresse 192.168.10.10 sur le port 80 et le conteneur B à l’adresse 192.168.10.10 sur le port 81. Toutefois, le conteneur C ne peut communiquer avec les deux autres conteneurs qu’en utilisant l’adressage 172.17.0.x.
Docker prend également en charge IPv6 et permet l’utilisation d’adresses entièrement routables. Les conteneurs peuvent ainsi communiquer avec d’autres conteneurs situés sur des hôtes différents sans qu’il soit nécessaire d’effectuer une traduction d’adresses. Toutefois, cela ne fonctionne qu’avec IPv6 et peut donc présenter un intérêt limité dans certains environnements.
SDN et Docker
De nombreux centres de données définis par logiciel utilisent le concept de réseau défini par logiciel (SDN) pour déployer leurs systèmes invités de manière flexible. Le SDN permet de configurer des tunnels réseau isolés pour des locataires indépendants sur un même matériel physique. Il peut également être utile pour fournir une couche 2 par tunnel au sein d’un centre de données cloud qui, autrement, serait entièrement routé. La mise en réseau de Docker repose sur le concept de pont Docker, qui peut être connecté à un Open vSwitch afin d’assurer l’interopérabilité avec des technologies telles que VXLAN ou GRE.
L’utilisation d’Open vSwitch de cette manière permet de segmenter le réseau de couche 2 dans un environnement mutualisé, tout en offrant des possibilités de connexion à d’autres environnements virtualisés. Par exemple, il est probable qu’un centre de données utilisant Docker continue d’employer des machines virtuelles pour les services essentiels auxquels des ressources dédiées et prédéfinies doivent être réservées. Il peut s’agir de services de mise à disposition d’applications ou de ressources hautes performances, telles que des bases de données et des nœuds de traitement. Ces ressources peuvent être connectées au réseau au moyen de technologies telles que VXLAN ou GRE, afin que le trafic d’un locataire ne soit pas visible par les autres.
La mise à l’échelle des applications dans ce type d’environnement nécessite des services ADC capables de prendre en charge nativement les protocoles de tunnellisation. F5 offre des fonctionnalités VXLAN et GRE mutualisées, permettant ainsi de fournir aux clients du réseau, via un tunnel, des fonctions telles que l’équilibrage de charge, le déchargement SSL, le pare-feu, la sécurité des applications, la traduction d’adresses réseau (NAT) et les services DNS. En outre, F5 assure l’interopérabilité entre différents types d’encapsulation de tunnel, notamment les VLAN 802.1Q.
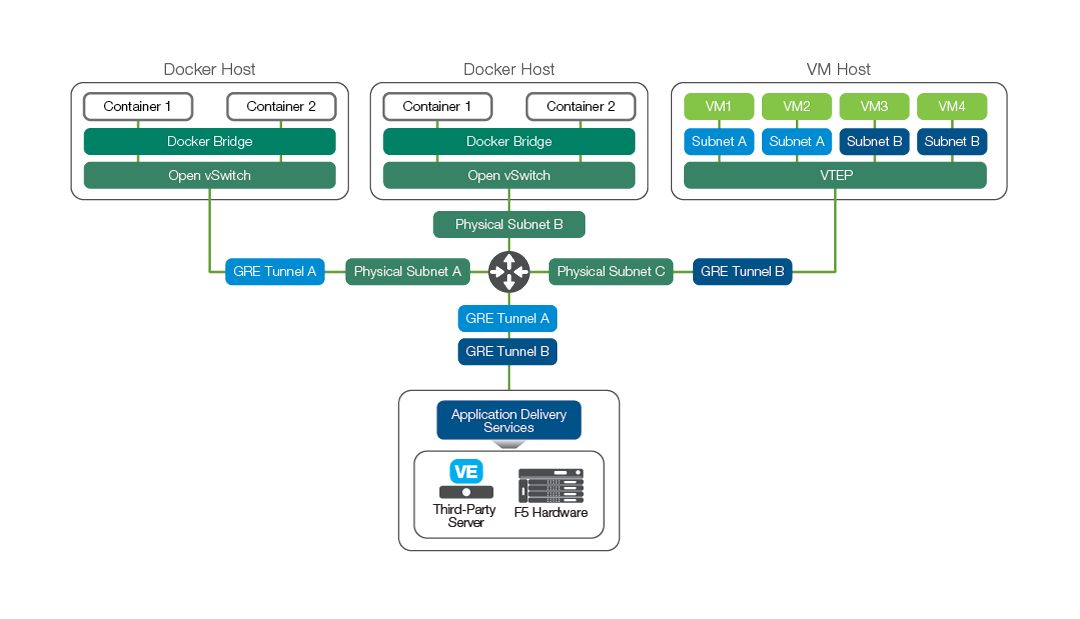
Dans l’exemple illustré à la figure 3, les couches principales de l’application, telles qu’une base de données, peuvent se trouver dans une autre partie du centre de données que les ressources utilisées pour héberger les instances Docker. Dans ce cas, le réseau du locataire peut utiliser GRE ou VXLAN pour isoler et relier les deux sous-réseaux qui seraient autrement physiquement distincts.
Une solution BIG-IP peut être intégrée de manière transparente au réseau au niveau du locataire en créant un point de terminaison de tunnel VXLAN (VTEP) sur l’instance BIG-IP. Elle fait alors partie du réseau du locataire et peut communiquer avec les instances Docker et les machines virtuelles.
À partir de la version 1.7, Docker a commencé à proposer des fonctionnalités expérimentales qui étendent ses capacités réseau de base à l’aide de concepts SDN. L’architecture de plug-ins offre une occasion intéressante d’intégrer les services réseau et de mise à disposition d’applications de F5 à divers nouveaux cas d’usage, notamment les pare-feu de nouvelle génération avec des conteneurs capables de prendre en compte les applications, l’analyse des flux de conteneurs et l’application de politiques, ainsi que la gestion du trafic par flux.
Orientation de F5 en matière de conteneurisation Docker
F5 propose une gamme de produits permettant la virtualisation. Leader du marché des contrôleurs de mise à disposition d’applications (ADC) et disposant du portefeuille de services de mise à disposition et de sécurité des applications de couches L4 à L7 le plus étendu du secteur, F5 explore en permanence des technologies innovantes et les déploie sur l’ensemble des plateformes BIG-IP, qui reposent toutes sur une infrastructure commune. La figure 4 présente la gamme de produits F5, allant du matériel personnalisé aux offres complètes de services cloud pour les couches L4 à L7. La plateforme BIG-IP est parfaitement adaptée à la prise en charge des applications exécutées dans des conteneurs Docker.
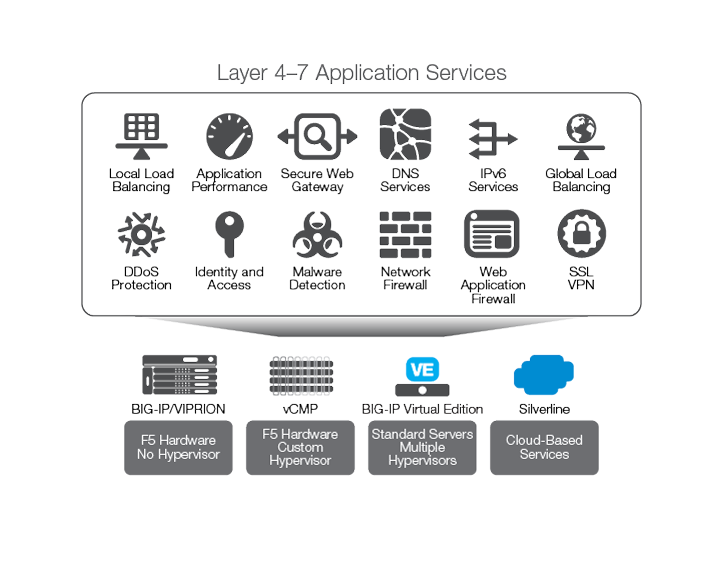
Évolution de la plateforme F5 avec Docker
Comme indiqué précédemment, F5 reconnaît les avantages de Docker dans différents cas d’usage. Toutefois, le déploiement dans une infrastructure conteneurisée en est encore à ses débuts, et plusieurs options existent pour la découverte de services (telles que Consul, etcd et Mesos-DNS), l’orchestration et la gestion du cycle de vie des services de conteneurs (notamment Mesos, OpenStack, Kubernetes, Docker et Cloud Foundry). Bien que les services réseau constituent un aspect essentiel de cet écosystème, une intégration étroite avec l’environnement d’orchestration est indispensable pour garantir un déploiement fluide. Une telle intégration est également cruciale pour rendre les services L4-L7 disponibles et transparents pour les utilisateurs qui déploient des applications basées sur des microservices dans une infrastructure conteneurisée. L’approche de F5 vise à offrir une expérience cohérente en matière de services et de visualisation, que les déploiements s’effectuent sur des serveurs physiques, dans des environnements virtualisés ou dans des conteneurs.
La première étape de la résolution du problème consiste à fournir des services réseau pour le trafic nord-sud (N-S), c’est-à-dire le trafic destiné aux « microservices côté client ». La plupart des principales plateformes d’orchestration prennent en charge le déploiement, la mise à l’échelle et l’exposition de la connectivité des services conteneurisés au monde extérieur. Grâce à une intégration étroite avec les principales plateformes d’orchestration de conteneurs, F5 permet aux systèmes BIG-IP de détecter automatiquement les microservices N-S, puis de gérer leur trafic. Par exemple, Mesosphere Marathon et Kubernetes permettent d’attribuer des « étiquettes » aux services. Ces étiquettes peuvent servir à détecter les services côté client lors de leur lancement, de leur arrêt ou de leur mise à l’échelle, puis à les ajouter automatiquement en tant que membres de pool au système BIG-IP.
L’utilisation de l’approche ci-dessus avec des appliances matérielles ou des éditions virtuelles (VE) BIG-IP permet de centraliser des fonctions critiques bénéficiant d’une accélération matérielle, telles que :
- Déchargement SSL avec gestion centralisée des certificats.
- Accélération grâce à la compression, à l’optimisation TCP et à SPDY/HTTP2.
- Pare-feu avancé avec protection contre les attaques par déni de service (DoS).
- Maîtrise des applications pour contrer les attaques au niveau de la couche applicative.
- Visibilité sur toutes les connexions réseau entrantes et sortantes.
- Débogage considérablement amélioré grâce à une journalisation intelligente et à la détection des anomalies.
F5 et traduction d’IPv4 vers IPv6 avec prise en charge du DNS
Les solutions F5 permettent de faire évoluer les applications conteneurisées, ainsi que d’assurer la traduction d’IPv4 vers IPv6 et la traduction DNS entre l’infrastructure Docker et le réseau externe. Pour utiliser une infrastructure de conteneurs Docker entièrement routable, les entreprises auront besoin non seulement d’une fonction réseau efficace de traduction d’IPv4 vers IPv6, mais aussi de la prise en charge de la traduction des requêtes DNS. L’infrastructure de conteneurs Docker peut fonctionner exclusivement en IPv6, en étant totalement isolée d’IPv4, tout en conservant une connectivité transparente avec IPv4.
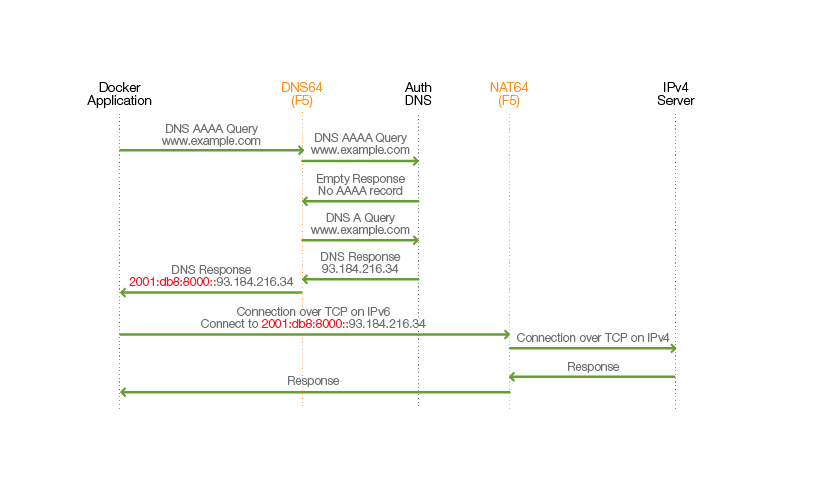
Dans l’exemple illustré à la figure 5, les services NAT64 et DNS64 ont été provisionnés (là encore, sous n’importe quelle forme, physique ou virtuelle). Le conteneur Docker tente de se connecter à www.example.com, pour lequel, dans cet exemple, aucune adresse IPv6 n’existe.
Le système BIG-IP est configuré comme résolveur DNS pour l’installation de la plateforme Docker. Il est configuré avec une adresse IPv6 pour le résolveur DNS lui-même, ainsi qu’avec une adresse de préfixe IPv6 spéciale (indiquée en rouge) pour la traduction d’IPv4 vers IPv6.
Une fois que le dispositif BIG-IP a reçu la requête DNS IPv6, il effectue d’abord une opération récursive afin de déterminer si une adresse IPv6 est disponible. Toutefois, dans cet exemple, le serveur DNS faisant autorité pour www.example.com renvoie un enregistrement vide en réponse à la requête AAAA. Le dispositif BIG-IP effectue alors une requête IPv4, pour laquelle il reçoit un enregistrement DNS A. Il ajoute l’adresse de préfixe spéciale devant l’adresse IPv4 et renvoie le résultat au client Docker.
Le client Docker dispose désormais de l’adresse résolue et établit une connexion TCP. Comme Docker utilise le préfixe spécial, la fonction NAT64 détecte qu’une traduction d’IPv6 vers IPv4 est nécessaire.
La fonction NAT64 crée une association pour la connexion entre l’adresse IPv6 de Docker, l’adresse NAT64 dotée du préfixe spécial pour ce serveur IPv4 et le serveur IPv4. La demande de connexion est envoyée au serveur IPv4. Toutes les réponses de ce serveur, qui communique via IPv4, sont traduites par la fonction NAT64 afin d’assurer la connectivité entre le conteneur Docker et le serveur IPv4.
F5 et les flux de trafic est-ouest
La prochaine étape essentielle pour parvenir à une intégration étroite consiste à fournir des services pour le trafic est-ouest (E-W), c’est-à-dire les données transitant entre des microservices qui nécessitent des services ADC. Compte tenu de la nécessité de déployer des services en quelques secondes et de la nature éphémère des microservices, l’approche de F5 consiste à activer un ADC léger. (Pour les services avancés tels que l’authentification ou la protection des applications au niveau L7, le trafic sera redirigé vers l’instance BIG-IP située à la périphérie nord-sud.)
Le nombre de services conteneurisés dans une architecture de microservices sera bien plus élevé que dans une architecture traditionnelle, avec de multiples voies de communication entre les microservices. Cette architecture risque d’entraîner une complexité accrue, rendant plus difficile le diagnostic des problèmes de performances. Par exemple, si une application affiche de mauvaises performances, il est important de disposer d’une visibilité de bout en bout sur les différents services, jusqu’à la périphérie N-S. Par conséquent, une approche de visualisation centralisée capable de mettre en corrélation les schémas de trafic entre le système BIG-IP dans le domaine N-S et l’ADC léger dans le domaine E-W est absolument essentielle au diagnostic des problèmes.
Des instances de solutions F5 BIG-IP peuvent également être insérées entre les applications afin de fournir des services d’équilibrage de charge ou de sécurité, répondant ainsi aux préoccupations de sécurité liées au trafic E-W. Par exemple, un hôte Docker peut être configuré pour acheminer le trafic d’un conteneur via un système BIG-IP à des fins d’analyse avant qu’il n’entre dans un autre conteneur. Cette opération peut être effectuée à l’aide de BIG-IP Application Security Manager™ (ASM), qui comprend le fonctionnement des applications et peut détecter si le conteneur concerné fait l’objet d’une attaque, telle que l’exploitation d’une vulnérabilité.
L’approche progressive de F5 pour la fourniture de services Docker
Aujourd’hui, de nombreux déploiements réussis chez les clients de F5 reposent sur la conteneurisation à très grande échelle. Ces organisations sont présentes dans de nombreux secteurs d’activité, notamment la finance, les télécommunications et les services SaaS. Dans ces environnements, les solutions F5 fournissent actuellement des services ADC afin de garantir des applications rapides, sécurisées et disponibles. Ces services peuvent être intégrés pour permettre aux responsables d’applications ou aux équipes DevOps de les gérer en libre-service, ou pour les orchestrer par l’intermédiaire du système de gestion des conteneurs.
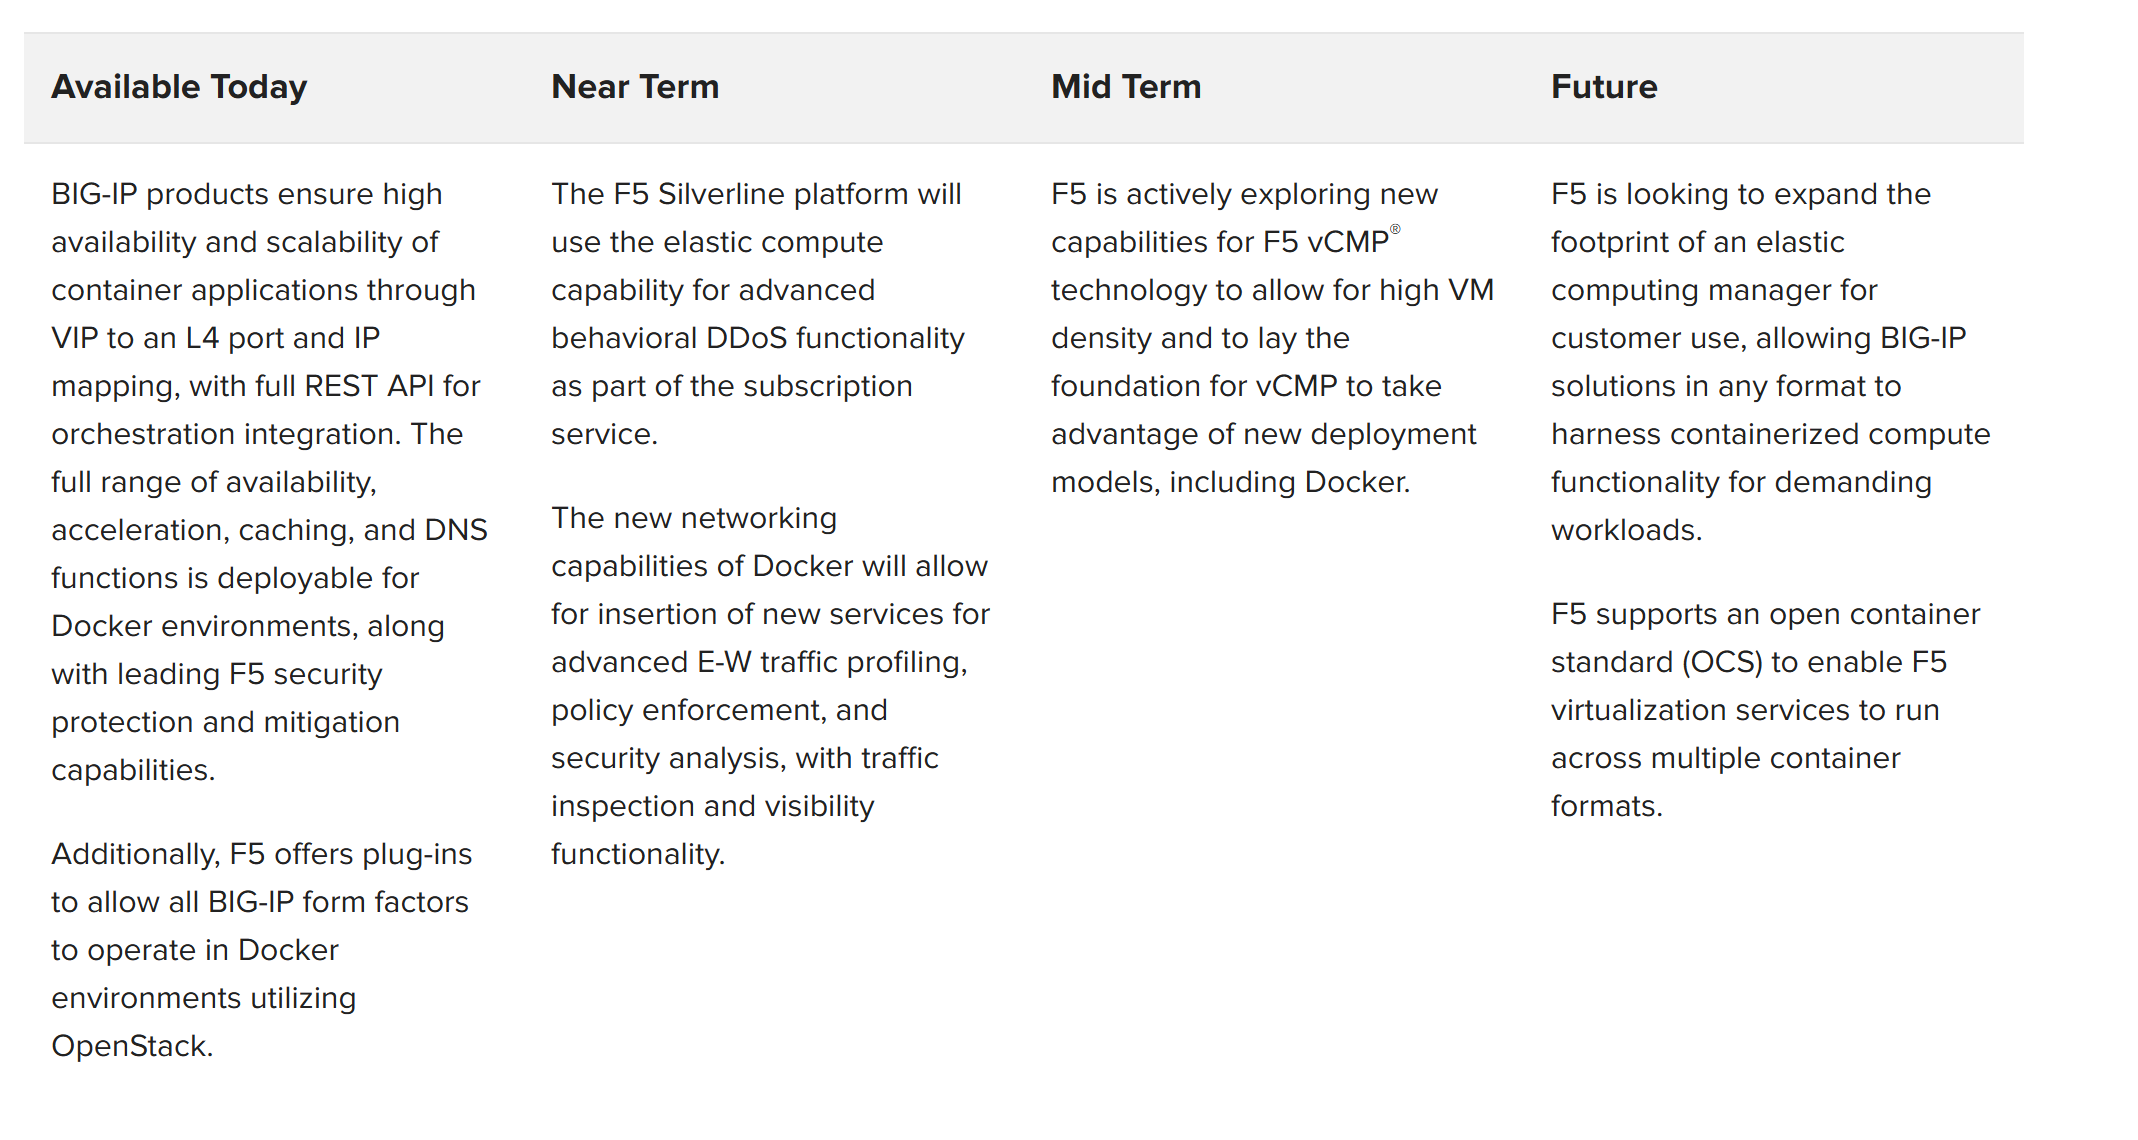
F5 prévoit d’étendre ces services à l’infrastructure conteneurisée elle-même afin de répondre aux besoins en matière de découverte de services, de gestion du trafic Est-Ouest et de sécurité. F5 prévoit également d’exploiter la conteneurisation au sein de sa gamme de produits, en tirant parti de cette technologie sur des plateformes physiques, en proposant des services logiciels dans des conteneurs et en utilisant une architecture conteneurisée au sein de la plateforme de services cloud F5 Silverline®.
Le tableau ci-dessous donne un aperçu des pistes que F5 explore ou développe activement :
Conclusion
Docker offre de réelles possibilités d’améliorer l’efficacité des centres de données, qu’ils soient physiques ou basés dans le cloud. Parallèlement, les utilisateurs de Docker peuvent avoir davantage confiance dans la portabilité de leurs applications vers de nouveaux environnements. Surtout, Docker permet aux développeurs d’applications de gagner en agilité et de commercialiser leurs applications plus rapidement. Lorsqu’ils font évoluer leur approche DevOps vers le modèle Docker, les clients en profitent souvent pour mettre en place de nouveaux workflows en libre-service, reposant sur des services standardisés plus petits sur lesquels les développeurs peuvent déployer leurs applications.
Docker permet aux applications de monter rapidement en charge grâce à l’instanciation de conteneurs légers, et les produits de mise à disposition d’applications F5 prennent pleinement en charge ces environnements. Grâce aux solutions F5 BIG-IP, les clients peuvent orchestrer l’intégralité du cycle de vie d’une application. Pour ce faire, ils disposent d’API REST complètes couvrant les opérations critiques, telles que la création et la maintenance des VIP, la gestion centralisée des certificats SSL, les services de pare-feu et la sécurité des applications avec haute disponibilité dans une architecture mutualisée.
Docker peut être utilisé selon différents modèles, notamment dans le cadre de déploiements sur des clouds publics et privés. F5 est à l’avant-garde en matière d’interopérabilité et de prise en charge de ces environnements, en proposant des fonctionnalités clés spécifiquement adaptées à OpenStack, VMware et aux principaux fournisseurs de services cloud tels qu’Amazon AWS et Microsoft Azure.
Les clients qui adoptent un modèle DevOps évolué, dans lequel Docker joue un rôle majeur, savent que les améliorations opérationnelles potentielles dépendent d’une plateforme évolutive, sécurisée, hautement disponible et aussi agile que l’exigent les nouveaux workflows. Les produits et services F5 sont conçus pour fonctionner avec le plus large éventail de technologies et de partenaires technologiques du secteur afin de concrétiser la vision de Docker. L’engagement de F5 envers Docker s’appuie sur des investissements solides dans sa feuille de route et sur l’amélioration continue de ses produits, afin de garantir la réussite de ce qui est appelé à devenir l’un des principaux modèles de déploiement du centre de données défini par logiciel.
PUBLIÉ LE 20 JUIN 2016