
L’évolution des contrôleurs de mise à disposition d’applications
Introduction
Dans le monde dynamique d’aujourd’hui, les organisations sont constamment confrontées au défi de fournir des applications critiques à des millions d’utilisateurs à travers le monde. Il est essentiel qu’elles déploient des services réseau et applicatifs afin de rendre les applications évolutives, sécurisées et disponibles. C’est l’une des principales raisons qui expliquent l’évolution des contrôleurs de mise à disposition d’applications (ADC). Toutefois, aucune de ces fonctionnalités ne peut être mise en œuvre sans s’appuyer sur de solides bases en matière de technologie d’équilibrage de charge. Commençons donc par comprendre l’importance de l’équilibrage de charge, la manière dont il permet une mise à disposition efficace des applications, ainsi que la façon dont les ADC continuent d’évoluer et de s’adapter à un monde privilégiant le cloud.
Facteurs stimulant la demande en matière de répartition de charge
L’objectif de l’équilibrage de charge est de répartir le trafic réseau ou applicatif entrant entre plusieurs serveurs physiques, tout en faisant apparaître ces serveurs comme un serveur unique aux yeux du monde extérieur. Cette approche répond à de nombreux besoins, mais les principaux facteurs sont la nécessité d’assurer l’« évolutivité », la « haute disponibilité » et la « prévisibilité ».
L’évolutivité est la capacité à s’adapter de manière dynamique ou aisée à une augmentation de la charge sans nuire aux performances existantes. La haute disponibilité (HA), quant à elle, désigne la capacité d’un site à rester disponible et accessible même en cas de défaillance d’un ou de plusieurs systèmes. La virtualisation des services (qui consiste à reproduire le comportement de composants logiciels afin d’accélérer et de tester le développement d’applications) offre des possibilités intéressantes en matière d’évolutivité et de disponibilité. Si le service ou le point de contact avec l’utilisateur est dissocié des serveurs physiques, l’application peut évoluer grâce à l’ajout de serveurs supplémentaires. En outre, la défaillance d’un serveur individuel ne rendra pas l’ensemble de l’application indisponible. La prévisibilité est une notion un peu moins claire, car elle englobe certains aspects de la haute disponibilité ainsi que des enseignements tirés au fil du temps. Elle peut être définie comme la capacité à maîtriser la manière dont les services sont fournis et le moment où ils le sont, en matière de disponibilité et de performances.
Équilibrage de charge : perspective historique
Aux débuts de l’Internet commercial, de nombreux aspirants millionnaires de la bulle Internet ont découvert une sérieuse faille dans leurs projets. Les ordinateurs centraux ne disposaient pas de logiciel de serveur web — du moins, pas avant l’AS/400e — et, même si cela avait été le cas, leur budget de jeune entreprise ne leur aurait pas permis de se les offrir. En revanche, ils pouvaient acheter du matériel serveur standard, disponible dans le commerce, auprès de l’un des innombrables fabricants de PC. Le principal problème était qu’un seul serveur basé sur un PC ne pourrait jamais gérer le volume de trafic que leur activité allait générer. Et s’il tombait en panne, leur site devenait inaccessible et leur entreprise se retrouvait à l’arrêt. Heureusement, certains comptaient faire fortune en résolvant précisément ce problème. C’est ainsi qu’est né l’équilibrage de charge.
Au commencement était le DNS
Avant l’apparition de dispositifs d’équilibrage de charge dédiés disponibles dans le commerce, de nombreuses tentatives ont été menées pour exploiter les technologies existantes afin d’atteindre les objectifs d’évolutivité et de disponibilité. La technologie la plus répandue — et toujours utilisée — était le DNS round-robin.
Avec cette méthode, le DNS attribuait plusieurs adresses IP uniques à différents serveurs sous un même nom DNS. Ainsi, lorsqu’un utilisateur demandait pour la première fois la résolution de « www.example.com », le serveur DNS dirigeait chaque nouvelle connexion vers le premier serveur de la liste, puis passait au suivant jusqu’à atteindre le dernier, avant de revenir au premier. Cette solution était simple et permettait de répartir uniformément les connexions entre un ensemble de machines.
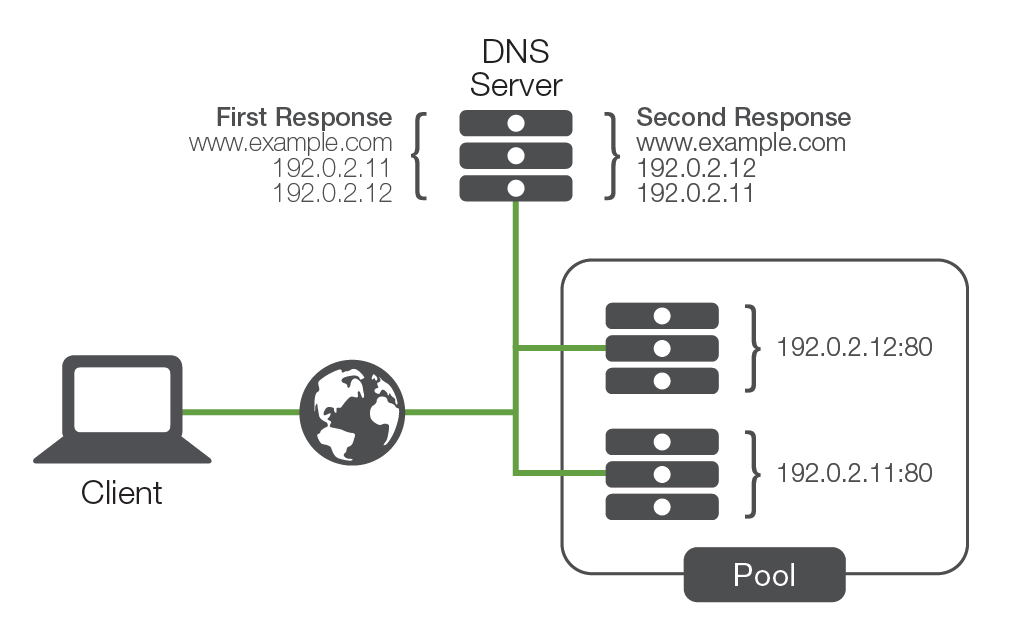
Du point de vue de l’évolutivité, cette solution fonctionnait remarquablement bien, car elle permettait d’ajouter un nombre presque illimité de serveurs à un nom DNS. Cependant, en matière de disponibilité, elle présentait un obstacle : le DNS n’était pas en mesure de savoir si les serveurs répertoriés fonctionnaient ou non. Si un serveur devenait indisponible et qu’un utilisateur tentait d’y accéder, la requête pouvait être envoyée à un serveur hors service.
Un autre facteur ayant favorisé l’utilisation du DNS round-robin était la prévisibilité, c’est-à-dire la forte probabilité qu’un utilisateur soit dirigé vers un serveur donné. Cette notion repose sur la persistance, qui consiste à s’assurer qu’un utilisateur n’est pas redirigé vers un nouveau serveur par l’équilibrage de charge une fois sa session commencée, ou lorsqu’il reprend une session précédemment suspendue. Il s’agit d’un problème majeur que le DNS round-robin ne permettait pas de résoudre.
Équilibrage de charge propriétaire dans les logiciels
Pour résoudre ce problème, l’une des premières solutions spécialement conçues à cet effet consistait à intégrer l’équilibrage de charge directement au logiciel applicatif ou au système d’exploitation (OS) du serveur d’applications. Bien que les implémentations aient été aussi nombreuses que les entreprises qui les développaient, la plupart des solutions reposaient sur des techniques réseau élémentaires. Par exemple, l’une d’elles attribuait à tous les serveurs d’un pool (également appelé cluster) une adresse IP commune, en plus de leur propre adresse IP physique.
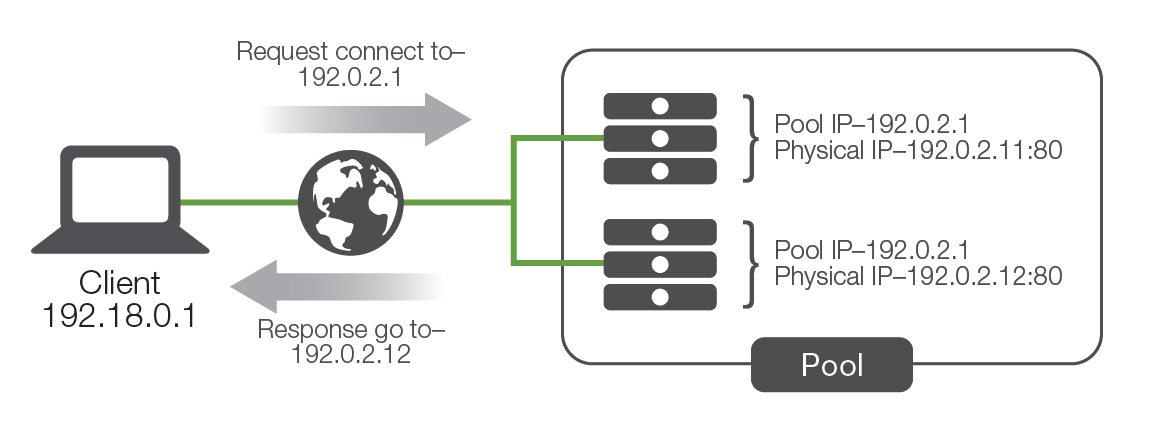
Lorsque les utilisateurs tentaient de se connecter au service, ils se connectaient à l’adresse IP du pool plutôt qu’à l’adresse IP physique du serveur. Le premier serveur du pool à répondre à la demande de connexion redirigeait l’utilisateur vers une adresse IP physique (la sienne ou celle d’un autre système du pool), puis la session de service démarrait. L’un des principaux avantages de cette solution était que les développeurs d’applications pouvaient s’appuyer sur diverses informations pour déterminer l’adresse IP physique à laquelle le client devait se connecter. Par exemple, chaque serveur du pool pouvait comptabiliser le nombre de sessions déjà prises en charge par chacun des membres du pool, puis diriger toute nouvelle demande vers le serveur le moins sollicité.
Au départ, l’évolutivité de cette solution semblait évidente. Il suffisait de mettre en place un nouveau serveur et de l’ajouter au pool pour augmenter la capacité de l’application. Toutefois, au fil du temps, l’évolutivité de l’équilibrage de charge au niveau applicatif a été remise en question. Comme les membres du pool devaient rester en contact permanent afin de déterminer vers lequel diriger la prochaine connexion, le trafic réseau entre eux augmentait de manière exponentielle à chaque ajout d’un serveur au pool. Lorsque le pool atteignait une certaine taille (généralement 5 à 10 hôtes), ce trafic commençait à affecter celui des utilisateurs finaux ainsi que l’utilisation des processeurs des serveurs eux-mêmes. L’évolutivité était donc excellente tant qu’il n’était pas nécessaire de dépasser un petit nombre de serveurs (soit, au passage, moins qu’avec la méthode DNS round-robin).
La haute disponibilité a été considérablement améliorée grâce au DNS round-robin et à l’équilibrage de charge logiciel. Comme les membres du pool communiquaient en permanence entre eux et que les développeurs pouvaient s’appuyer sur leur connaissance approfondie de l’application pour déterminer si un serveur fonctionnait correctement, ces solutions éliminaient pratiquement tout risque qu’un utilisateur soit dirigé vers un serveur incapable de traiter sa requête. Il convient toutefois de souligner que chaque ajout de fonctionnalités intelligentes de haute disponibilité avait une incidence sur l’utilisation des serveurs et du réseau, ce qui limitait davantage l’évolutivité. L’autre effet négatif sur la haute disponibilité concernait la fiabilité. Bon nombre des techniques réseau utilisées pour répartir le trafic dans ces systèmes étaient complexes et nécessitaient une surveillance approfondie au niveau du réseau. Par conséquent, ces méthodes de répartition rencontraient souvent des problèmes qui affectaient l’ensemble de l’application ainsi que tout le trafic sur le réseau applicatif.
Ces solutions ont également amélioré la prévisibilité. Comme les concepteurs de l’application savaient quand et pourquoi les utilisateurs devaient être redirigés vers le même serveur plutôt que de faire l’objet d’un équilibrage de charge, ils pouvaient intégrer une logique permettant de garantir, si nécessaire, la persistance de leurs sessions. Ils ont également utilisé la même technologie de « regroupement en pool » pour répliquer les informations d’état des utilisateurs entre les serveurs, éliminant ainsi de nombreux cas qui nécessitaient auparavant une persistance. Enfin, grâce à leur connaissance approfondie de l’application, ils étaient mieux à même de développer des algorithmes d’équilibrage de charge fondés sur l’état réel de l’application plutôt que sur des indicateurs tels que le nombre de connexions, qui ne reflétaient pas toujours correctement la charge du serveur.
Outre les limitations potentielles en matière de véritable évolutivité et les problèmes de fiabilité, l’équilibrage de charge propriétaire intégré aux applications présentait un autre inconvénient : son développement et sa maintenance dépendaient de l’éditeur de l’application. Le principal problème était que toutes les applications ne proposaient pas de technologie d’équilibrage de charge (ou de mise en pool) et que celles qui en proposaient n’étaient souvent pas compatibles avec les solutions d’autres éditeurs d’applications. Plusieurs entreprises produisaient certes des logiciels d’équilibrage de charge indépendants des fournisseurs et fonctionnant au niveau du système d’exploitation, mais ceux-ci souffraient malheureusement des mêmes problèmes d’évolutivité. De plus, faute d’une intégration étroite avec les applications, ces « solutions » logicielles rencontraient également des difficultés supplémentaires en matière de haute disponibilité.
Matériel d’équilibrage de charge réseau
La deuxième génération de solutions d’équilibrage de charge dédiées a pris la forme d’équipements réseau. Ce sont les véritables précurseurs des contrôleurs de mise à disposition d’applications actuels. Physiquement distincts des applications elles-mêmes, ces équipements étaient à l’origine de simples répartiteurs de charge, mais s’appuyaient sur des techniques réseau beaucoup plus directes, telles que la traduction d’adresses réseau (NAT), pour assurer cette fonction. Ils présentaient une adresse de serveur virtuel au monde extérieur et, lorsque des utilisateurs tentaient de s’y connecter, ils transféraient la connexion vers le serveur physique le plus approprié.
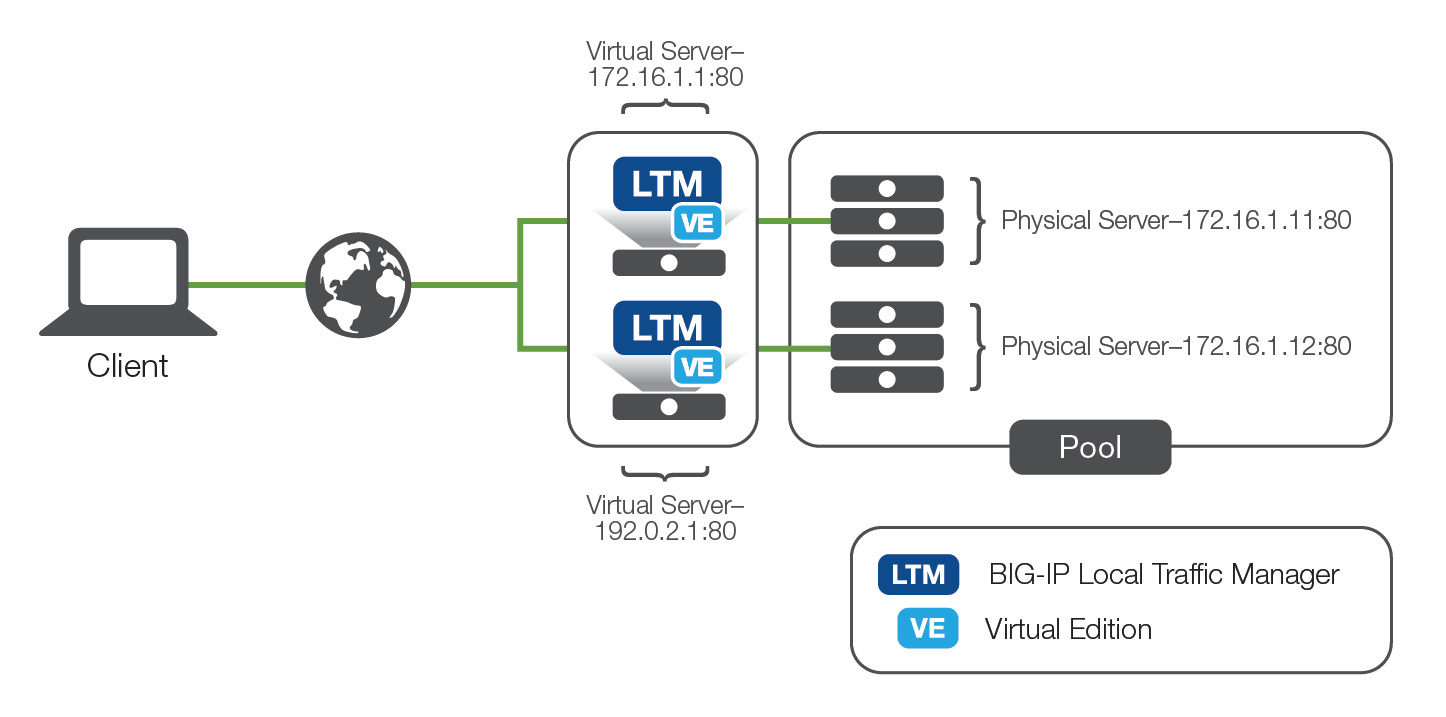
Le répartiteur de charge pouvait déterminer précisément quel serveur recevait chaque connexion et utilisait des « sondes d’intégrité » de plus en plus sophistiquées afin de s’assurer que le serveur d’applications (un véritable serveur physique) répondait comme prévu. Si le serveur ne répondait pas correctement, le répartiteur de charge cessait automatiquement de lui envoyer du trafic jusqu’à ce qu’il fournisse la réponse attendue. Bien que les sondes d’intégrité aient rarement été aussi complètes que celles conçues par les développeurs de l’application eux-mêmes, l’approche matérielle basée sur le réseau pouvait fournir des services élémentaires de répartition de charge à presque toutes les applications, de manière uniforme et cohérente, créant enfin un point d’entrée de service véritablement virtualisé propre aux serveurs d’applications.
Du point de vue de l’évolutivité, les organisations qui ont commencé à remplacer l’équilibrage de charge logiciel par une solution matérielle ont constaté une baisse spectaculaire de l’utilisation de leurs serveurs. Elles ont ainsi évité d’avoir à acheter des serveurs supplémentaires à court terme et ont pu accroître leur retour sur investissement à long terme.
De même, la haute disponibilité a contribué à réduire la complexité de la solution et à assurer un équilibrage de charge indépendant des applications, renforçant ainsi la fiabilité et l’étendue fonctionnelle de la solution. Le matériel d’équilibrage de charge réseau a permis à l’entreprise d’offrir un haut niveau de disponibilité à l’ensemble de ses applications, plutôt qu’aux seules applications dotées d’un équilibrage de charge intégré.
La prévisibilité était l’un des principaux atouts apportés par le matériel d’équilibrage de charge réseau. Il était désormais beaucoup plus facile de prévoir vers quel serveur une nouvelle connexion serait dirigée et de modifier cette orientation. Ces équipements ont rendu le processus plus intelligent, ce qui a permis de contrôler la répartition de la charge (contrairement à la répartition non maîtrisée du DNS dynamique). Les entreprises pouvaient ainsi répartir la charge entre les serveurs en fonction de la capacité de chacun à la prendre en charge.
L’avènement de l’équilibreur de charge réseau et de la virtualisation a apporté de nouveaux avantages en matière de sécurité et de gestion, notamment la possibilité de masquer l’identité des serveurs d’applications aux internautes et de « drainer » les connexions d’un serveur afin de pouvoir le mettre hors ligne pour effectuer des opérations de maintenance sans perturber les utilisateurs. C’est sur cette base que sont nés les contrôleurs de mise à disposition d’applications (ADC).
Contrôleurs de mise à disposition d’applications
Grâce à une fonction centralisée de répartition de charge, qui fait également office de proxy complet, les équipes informatiques ont trouvé un environnement idéal pour ajouter et consolider des services nouveaux et émergents. Le dispositif de répartition de charge a ainsi évolué pour devenir une plateforme ADC extensible. En termes simples, le proxy constitue la base de la répartition de charge et la technologie sous-jacente qui rend les ADC possibles.
Lorsqu’il est question de la sécurité des ADC, la virtualisation créée par le proxy (la technologie de base) est essentielle. Qu’il s’agisse du déchargement du chiffrement SSL/TLS, de l’authentification centralisée ou même de pare-feu capables de comprendre les applications, la puissance de ces solutions tient au fait qu’un équilibreur de charge (matériel ou virtuel) constitue le point d’agrégation de la virtualisation pour l’ensemble des applications. L’authentification centralisée en est un exemple classique. Traditionnellement, les mécanismes d’authentification et d’autorisation ont toujours été intégrés directement à l’application elle-même. Comme pour l’équilibrage de charge au niveau applicatif, chaque mise en œuvre dépendait de l’application concernée et lui était propre, ce qui entraînait la multiplication de méthodes différentes. À l’inverse, en appliquant l’authentification au point d’entrée virtualisé de toutes les applications, il est possible d’utiliser une méthode d’authentification unique et uniforme. Cela simplifie considérablement la conception et la gestion du système d’authentification, tout en améliorant les performances des serveurs d’applications, qui n’ont plus à assurer cette fonction. En outre, cela évite également, en particulier pour les applications développées en interne, de consacrer du temps et de l’argent à la création de processus d’authentification propres à chaque application.
La disponibilité est l’attribut d’un ADC le plus facile à rattacher au répartiteur de charge d’origine, car elle est liée à tous les attributs fondamentaux de ce dernier : évolutivité, haute disponibilité et prévisibilité. Toutefois, les ADC vont encore plus loin que les répartiteurs de charge. Pour les ADC, la disponibilité englobe également des concepts avancés tels que les dépendances applicatives et le provisionnement dynamique. Les ADC sont capables de comprendre que les applications fonctionnent désormais rarement de manière autonome : elles dépendent souvent d’autres applications pour remplir leur fonction. Cette connaissance renforce la capacité de l’ADC à assurer la disponibilité des applications en tenant également compte de ces autres processus. Les ADC les plus intelligents du marché proposent aussi des interfaces programmatiques qui leur permettent de modifier dynamiquement leur mode de prestation des services en fonction de données externes. Ces interfaces permettent le provisionnement dynamique ainsi que l’augmentation ou la réduction automatisée des capacités, indispensables aux environnements modernes tels que les déploiements cloud et conteneurisés.
L’amélioration des performances constituait une autre extension évidente du concept de répartition de charge. Les répartiteurs de charge amélioraient intrinsèquement les performances des applications en veillant à ce que les connexions soient dirigées non seulement vers les services disponibles (et répondant dans un délai acceptable), mais aussi vers ceux présentant le moins de connexions et/ou la plus faible utilisation du processeur. Ainsi, chaque nouvelle connexion était prise en charge par le système le mieux à même de la traiter. Par la suite, lorsque le déchargement SSL/TLS (à l’aide de matériel dédié) est devenu une fonctionnalité courante des solutions de répartition de charge, il a permis de réduire la surcharge de calcul liée au trafic chiffré ainsi que la charge des serveurs back-end, améliorant également leurs performances.
Les ADC actuels vont encore plus loin. Ces dispositifs intègrent souvent des technologies de mise en cache, de compression et même de régulation du débit afin d’améliorer davantage les performances globales et la diffusion des applications. En outre, contrairement aux appliances autonomes traditionnelles qui fournissent ces services de manière statique, un ADC peut s’appuyer sur son intelligence applicative intrinsèque pour ne les appliquer que lorsqu’ils apportent un gain de performances, optimisant ainsi leur utilisation.
Par exemple, contrairement à une idée reçue, la technologie de compression n’est pas nécessairement avantageuse pour tous les utilisateurs de l’application. Les utilisateurs disposant d’une faible bande passante peuvent assurément tirer un bénéfice considérable de paquets plus petits, puisque le débit réel constitue le goulot d’étranglement. Même les connexions qui doivent parcourir de longues distances peuvent en bénéficier, car des paquets plus petits nécessitent moins d’allers-retours pour transporter les données, ce qui réduit l’incidence de la latence du réseau. En revanche, les performances des connexions à courte distance (au sein d’un même continent, par exemple) disposant d’une bande passante élevée peuvent se dégrader lorsque la compression est appliquée. Le débit n’étant pas nécessairement le goulot d’étranglement, la surcharge liée à la compression et à la décompression ajoute une latence que l’augmentation du débit ne compense pas en matière de performances. Autrement dit, si elle n’est pas correctement gérée, la technologie de compression peut s’avérer être une solution pire que le problème initial. Toutefois, en appliquant intelligemment la compression uniquement lorsqu’elle améliore les performances globales, un ADC optimise l’utilisation et le coût de cette technologie, libérant ainsi davantage de cycles processeur pour les fonctions qui en tireront le meilleur parti.
La direction que prend le monde
La transformation numérique étant un impératif stratégique majeur, de nombreuses entreprises ont entamé leur migration vers le cloud. Face au nombre croissant d’applications qui émergent et transforment le monde qui nous entoure, les organisations qui migrent vers le cloud devraient bénéficier de nombreux avantages, tels qu’une plus grande agilité, des coûts d’exploitation mieux adaptés, une évolutivité à la demande et la possibilité de se concentrer davantage sur leur cœur de métier.
Le « cloud » n’est pas une entité unique et informe regroupant des ressources mutualisées de calcul, de stockage et de réseau ; il se compose plutôt d’un ensemble complexe de fournisseurs, d’infrastructures, de technologies et d’environnements, souvent déployés sur plusieurs nœuds à travers le monde. C’est pourquoi de nombreuses entreprises ont déployé des applications dans plusieurs clouds différents — publics, privés, voire dans une combinaison de tous ces environnements. C’est le multicloud : la nouvelle réalité.
Malgré l’évolution rapide de cet environnement, plusieurs facteurs ralentissent l’adoption du cloud. Le premier défi réside dans la prolifération des environnements multicloud : les applications existantes ont été migrées selon une approche de type « lift and shift », tandis que les applications « nées dans le cloud » ont été déployées sans planification ni gestion. En outre, pour répondre à leurs besoins à court terme, les entreprises ont tendance à recourir à des plateformes cloud disparates, à des architectures différentes, à des services applicatifs variés et à de multiples ensembles d’outils. Il en résulte une complexité architecturale à l’échelle de l’entreprise, qui rend le transfert des applications d’un environnement à un autre beaucoup plus difficile, sans parler des coûts engendrés.
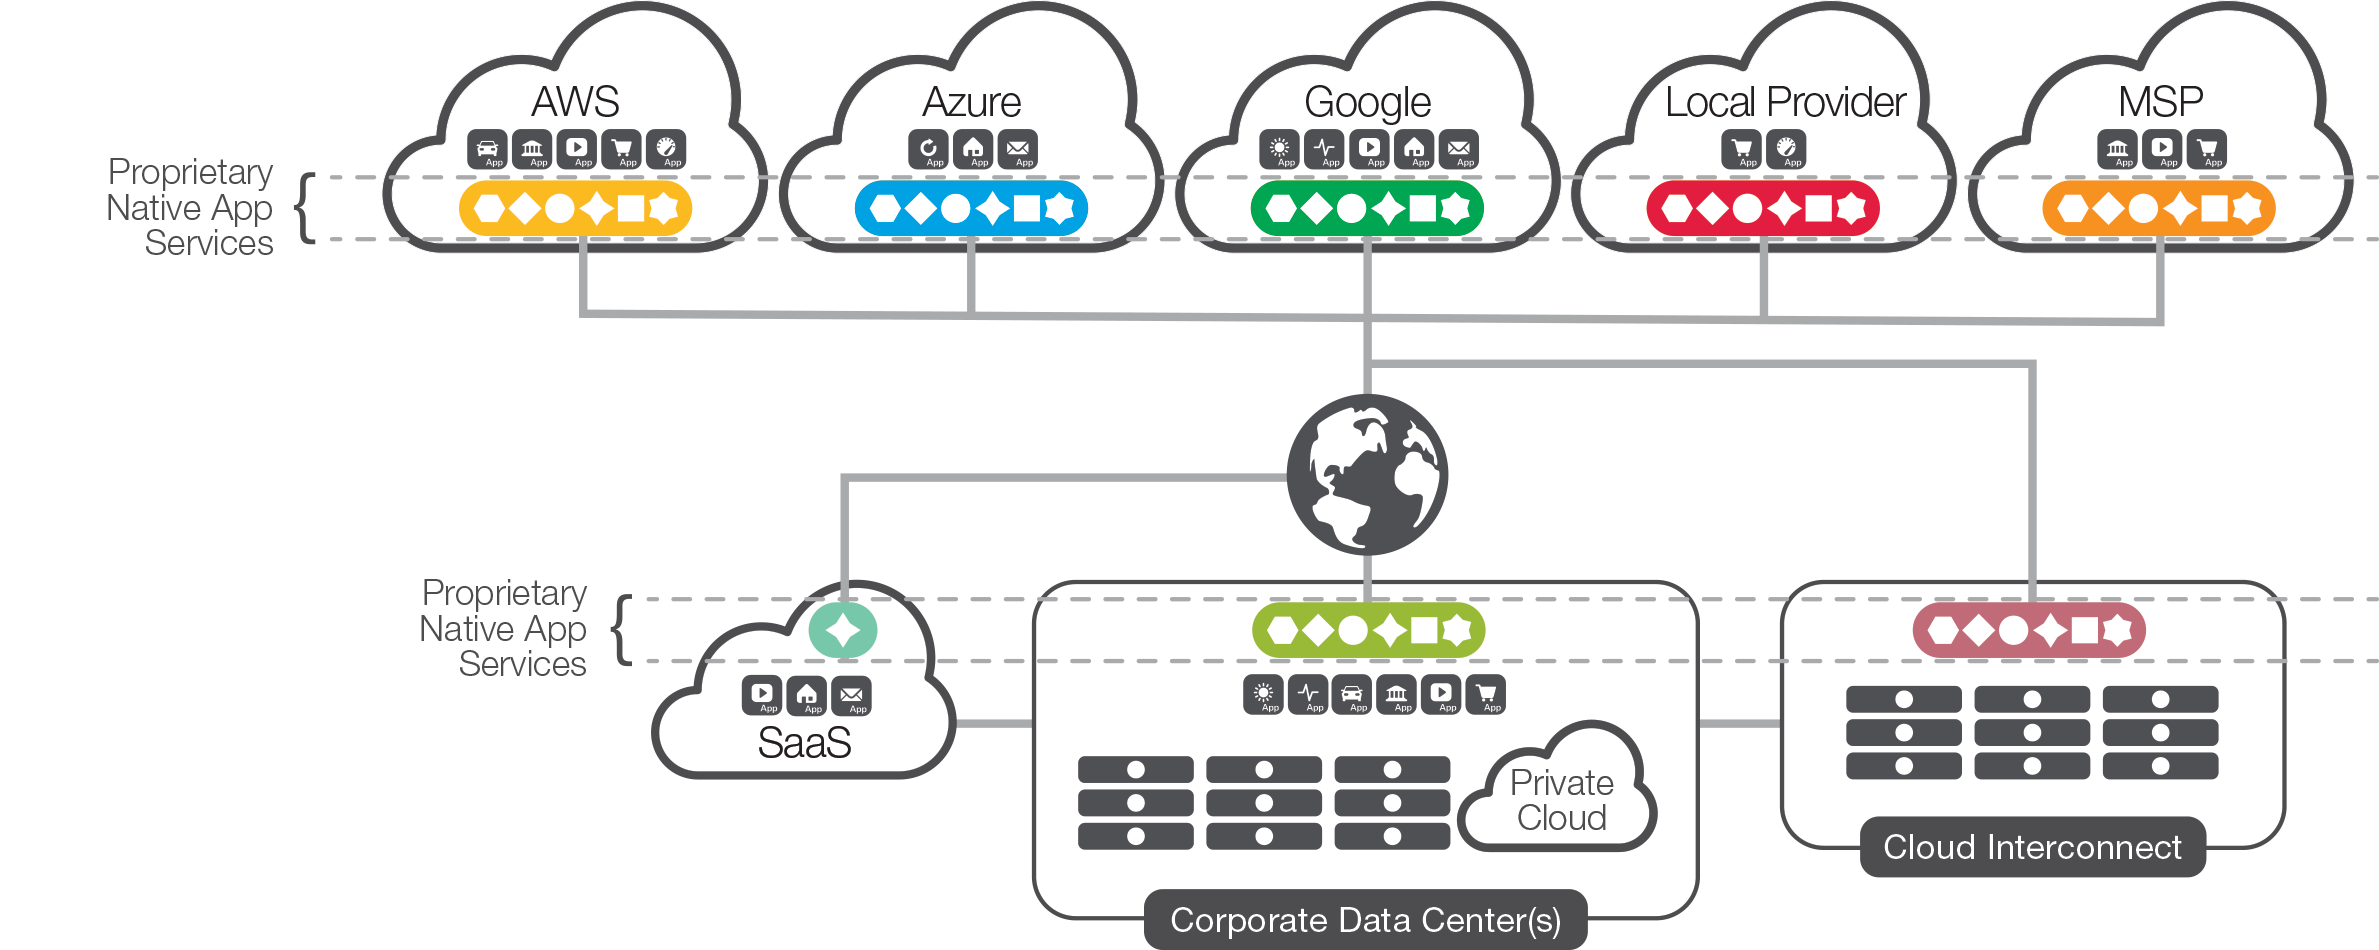
Malgré ces défis, les nouveaux déploiements dans les clouds publics et privés, ainsi qu’entre ces environnements, augmenteront inévitablement au cours des prochaines années. Le multicloud approche à grands pas, et il est temps pour les entreprises de déployer des services applicatifs intelligents et des contrôleurs de mise à disposition d’applications (ADC) qui ne se limitent pas à la prise en charge d’un nombre restreint d’applications ni à un fonctionnement exclusivement matériel ou dans un seul cloud.
Résumé
Les contrôleurs de mise à disposition d’applications (ADC) constituent l’évolution naturelle des répartiteurs de charge d’autrefois, qui occupaient une place stratégique au sein du réseau. Bien que les ADC doivent beaucoup à ces dispositifs aujourd’hui révolus, ils forment une catégorie résolument nouvelle, assurant non seulement la disponibilité, mais aussi les performances et la sécurité. Comme leur nom l’indique, ils prennent en charge tous les aspects nécessaires pour assurer une mise à disposition optimale des applications.
Grâce à des fonctionnalités avancées telles que l’intelligence applicative, le déchargement SSL et les interfaces programmatiques, les ADC modernes peuvent aider les organisations à développer leurs activités et à atteindre les utilisateurs partout et à tout moment. Face à l’évolution constante des besoins du monde technologique, les ADC sont également mieux à même de s’adapter aux technologies les plus récentes dans les environnements multicloud et conteneurisés.
En définitive, nous pouvons affirmer sans risque que les ADC seront non seulement le principal canal et point d’intégration permettant de fournir les applications de manière plus rapide, plus intelligente et plus sécurisée, mais qu’ils continueront également à évoluer et à s’adapter à un monde privilégiant le cloud.
PUBLIÉ LE 10 SEPTEMBRE 2017