La tecnología avanza rápidamente. O quizá solo lo parezca porque no dejan de surgir nuevas tendencias, enfoques y arquitecturas por todas partes. Este mes, las arquitecturas «sin servidor» han irrumpido de repente en los feeds de Twitter y en la mente de todo el mundo. Al menos, si te mueves en el ámbito de DevOps.
Para quienes os ocupáis de la infraestructura, la arquitectura de redes y las operaciones, y aún no os habéis visto inundados por esta nueva arquitectura, se trata de una evolución lógica que va de las arquitecturas monolíticas a los microservicios y, de ahí, a las arquitecturas sin servidor. Supone una mayor descomposición de las aplicaciones: del uso empresarial al servicio y, de este, a la función.
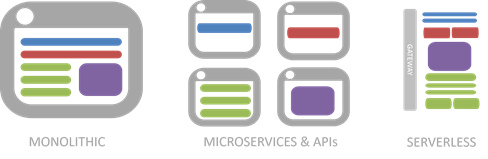
Literalmente, se trata de funciones. Funciones basadas en eventos y de granularidad fina.
Y cada una se centra en un ámbito de la lógica de la aplicación aún más reducido que el de un microservicio. Mientras que un microservicio podría contener toda la lógica de la aplicación necesaria para implementar un «servicio de perfil», la arquitectura sin servidor la descompone aún más en funciones individuales: una para iniciar sesión, otra para cerrarla, otra para cambiar la contraseña y otra para restablecerla. Básicamente, es como crear un servicio pequeño y específico para cada acción que se pueda realizar dentro de una aplicación.
La razón por la que esto se denomina «sin servidor» es que, básicamente, se trata de una forma muy evolucionada de PaaS. Lo cual le viene bien a PaaS, porque, como mercado, nunca ha llegado a convertirse en el gigante que aspiraba a ser. Se limita a estar ahí, recibiendo elogios de los fanáticos que lo adoran, pero, en general, se le ha prestado poca atención y crece a un ritmo que ni de lejos resulta tan prometedor como el de la nube privada o pública, y mucho menos como el de SaaS. En una arquitectura sin servidor, el proveedor de servicios en la nube se encarga de todo salvo del código necesario para ejecutar una acción cuando un usuario pulsa un botón, marca una casilla o hace clic en un enlace. Esa es la parte de los «eventos» en «orientada a eventos»: cuando el usuario pulsa un botón ejecutar función_en_la_nube. Por lo general, esa función forma parte de una API más amplia que, a su vez, gestiona otro servicio en la nube.
Lo importante aquí es que la persona que escribe la función no aprovisiona, configura ni inicia una máquina virtual o un contenedor. No tiene que preocuparse por detalles operativos como el escalado. Simplemente escribe algo de código y, con solo pulsar un botón, ¡voilà! Funcionalidad instantánea.
Esto es llevar la nube hasta sus últimas consecuencias, ya que la pila de la que ahora son responsables los desarrolladores se reduce a una sola capa: la capa de aplicación. Nada más importa, como diría Metallica. La plataforma subyacente se encarga de todos los detalles operativos. Es NoOps, al menos desde la perspectiva del desarrollador.
Porque sabes que, bajo la plataforma, hay servidores, servicios, infraestructura y una red que hacen posible esta capacidad mágica. Simplemente, no es algo de lo que el desarrollador tenga que preocuparse. Pero tú, como profesional de operaciones de infraestructura o de red, sí.
Por eso es poco probable que las empresas se suban a este carro a corto plazo. Lograr algo así requiere un entorno de computación en la nube plenamente operativo que incorpore no solo capacidades de aprovisionamiento de máquinas virtuales o contenedores, sino también el autoautoescalado. En otras palabras, escalado sin parámetros ni intervención de los desarrolladores. Simplemente debería ocurrir, qué caramba, y punto. No es autoservicio, es un servicio automatizado. No se trata solo de escalado, sino también de autoaprovisionamiento. Y de supervisión, generación de informes y prácticamente todo lo relacionado con las operaciones actuales. Por eso lo vemos principalmente en entornos de proveedores de nube consolidados; solo ellos cuentan con la infraestructura, la automatización y la orquestación subyacentes necesarias para sustentar un modelo operativo que apenas requiere intervención.
Así que, por ahora, la mayor parte de la atención en torno a la informática sin servidor se centra en explorarla y averiguar cómo trabajar con las soluciones actuales disponibles en la nube: Amazon Lambda, Google Cloud Functions, Microsoft Azure Functions e IBM OpenWhisk. No es que no haya ofertas para facilitar las implementaciones locales, como Serverless e Iron.io. Pero la informática sin servidor aún está en una fase muy (muy) temprana.
Aun así, probablemente empezarás a oír hablar cada vez más de la informática sin servidor. Por ahora, no es más que el arranque de los motores de una nueva arquitectura. Es poco probable que afecte a la mayoría de las organizaciones a corto plazo (durante los próximos 12-15 meses), pero conviene entender en qué consiste antes de que haga su parada en boxes en las instalaciones locales.
The NewStack ofrece una excelente visión general si quieres obtener más información sobre la tecnología sin servidor y sus ventajas y retos actuales.
Sobre el autor

Lori MacVittie es ingeniera distinguida y evangelista jefe en la Oficina del CTO de F5, y cuenta con una amplia experiencia en entrega de aplicaciones, estrategia de automatización e infraestructura. Es conocida por convertir la complejidad en claridad, ya sea definiendo mecanismos de protección para agentes de IA, analizando arquitecturas multinube frágiles o explorando los límites de los sistemas escalables. Aporta más de treinta años de experiencia en el sector en desarrollo de aplicaciones, arquitectura de TI y operaciones de redes y sistemas. Antes de incorporarse a F5, fue una galardonada editora de tecnología. MacVittie posee un máster en Informática y es una autora prolífica cuyas publicaciones abarcan la seguridad, la nube y la arquitectura empresarial. También es una apasionada de los juegos de mesa y los videojuegos, y expresa sin complejos sus firmes opiniones sobre el queso.
Más artículos de Lori Mac VittieArtículos relacionados del blog

Cree servicios públicos seguros, resilientes y preparados para la IA con F5 y AWS
Descubre cómo las organizaciones del sector público pueden modernizar de forma segura sus aplicaciones y soluciones de IA, al tiempo que gestionan los sistemas heredados, el cumplimiento normativo y el riesgo operativo.

Protección de los sistemas de IA: por qué la seguridad debe avanzar al ritmo de la innovación
Desde acelerar avances revolucionarios en medicina y educación hasta transformar la vida cotidiana, la IA está cambiando nuestra forma de vivir y trabajar. Pero también ofrece grandes oportunidades a los ciberdelincuentes.
Avanzar hacia la optimización digital tras la transformación
Descubre estrategias de optimización digital para garantizar políticas de seguridad coherentes, impulsar la madurez de la transformación digital y superar los retos de la transformación.
Proyecto de código abierto destacado: mayor observabilidad con F5 Cloud Logger iApp
En el punto de mira del código abierto: cómo aumentar la observabilidad. Lee el blog de F5 para descubrir cómo exportar fácilmente la telemetría de BIG-IP a plataformas modernas de análisis en la nube.
El estado de la entrega de aplicaciones en 2018: la transformación digital impulsa la automatización y la multinube pese a las preocupaciones de seguridad
Descubre las principales conclusiones del cuarto informe anual de F5 sobre el estado de la entrega de aplicaciones.
Estado de la entrega de aplicaciones en 2017: automatización, API y DevOps
Descubre el informe sobre el estado de la entrega de aplicaciones de 2017. Lee el blog retrospectivo de F5 sobre los inicios del auge de las redes declarativas y los flujos de DevOps.