Las interrupciones del servicio son costosas. Que se deban en última instancia a un ataque o a un fallo de software o hardware no es tan relevante. El coste por minuto de inactividad está aumentando debido a la creciente dependencia de las API y las aplicaciones web en la economía digital moderna.
Para algunas empresas, esos costes son desorbitados. Se estima que los 40 minutos de inactividad de Amazon en 2013le costaron 2,64 millones de dólares. Eso equivale a 1100 dólares por segundo para quienes no quieran hacer las cuentas. Si le parece aterrador, piense en Google, cuyos 5 minutos de inactividad ese mismo año le costaron 109 000 dólares por minuto (o 1816,67 dólares por segundo), lo que supone un total descomunal de 545 000 dólares. Por 5 minutos. Técnicamente, si esa fue toda la inactividad que sufrió, se trata de los tan ansiados «cinco nueves» que el departamento de TI tiene la misión de alcanzar.
¿Con qué frecuencia se producen interrupciones del servicio? Por lo visto, con demasiada frecuencia. Si nunca lo has visto, echa un vistazo al mapa en tiempo real de interrupciones de Pingdom. Se ha creado a partir de los datos recopilados de sus más de 700.000 usuarios de todo el mundo. Este mapa, tan fascinante como inquietante, muestra las interrupciones que se han producido en todo el planeta durante la última hora. Los destellos brillantes que representan las interrupciones son un buen detalle: dejan muy claro el impacto que tienen en los usuarios.
Es decir, uno no deseado.
La economía digital agrava este problema. A principios de este año, una interrupción de S3 en Amazon dejó fuera de servicio a un gran número de aplicaciones y sitios web de clientes. Pero, antes de atribuir este problema a los proveedores de nube pública, basta con echar un vistazo al sitio builtwith.com para descartar rápidamente esa idea. El porcentaje de sitios que utilizan CDN y API puede resultar alarmantemente alto si se tiene en cuenta la dependencia que esto genera respecto al tiempo de actividad de terceros. Es difícil encontrar un sitio que no dependa de al menos una API o un servicio externo, lo que aumenta la posibilidad de que se produzca una interrupción, ya que, si ese servicio externo deja de funcionar, tu sitio también.
Básicamente, el sector de TI se decantó por los «cinco nueves» porque es imposible alcanzar una disponibilidad del 100 %. Hoy en día, cuando los costes por segundo se están disparando debido al traslado de la economía al ámbito digital, la clave es minimizar el tiempo de inactividad. En otras palabras, establecer objetivos que exijan un tiempo medio de resolución (MTTR) bajo es igual de importante —o incluso más— que intentar eliminar el tiempo de inactividad.
Una de las métricas clave de las «organizaciones de alto rendimiento» en el informe de Puppet Labs Informe sobre el estado de DevOps de 2016 es el MTTR, definido como el tiempo que se tarda en restablecer el servicio cuando se produce una incidencia (por ejemplo, una interrupción no planificada o una degradación del servicio). Las organizaciones con mayor rendimiento (según la evaluación del informe) tardan menos de una hora mientras que las organizaciones de rendimiento medio y bajo tardan «menos de un día». «En otras palabras», señala el informe, «el MTTR de las organizaciones de alto rendimiento era 24 veces más rápido que el de las de bajo rendimiento».
Como habrá observado, la pregunta no era «si» se produciría una incidencia en el servicio, sino «cuándo» se produciría. Se da por hecho que habrá una incidencia y, por tanto, la clave está en reducir al mínimo el tiempo necesario para resolverla. Una encuesta realizada por IHS en 2016 reveló que «de media, los encuestados sufren 5 interrupciones al mes y acumulan 27 horas mensuales de inactividad», lo que supone un coste de 1 $ para una organización mediana promedio y de hasta 60 millones de dólares para las organizaciones de mayor tamaño.
Si suponemos que la ley de Murphy sigue imponiéndose a las de Moore y Conway, la solución consiste en intentar minimizar el MTTR para reducir el tiempo (y los costes) asociados a los inevitables periodos de inactividad.
Eso significa que la visibilidad es fundamental y, por tanto, también la monitorización. Mucha, muchísima monitorización. Pero no solo del sitio web, la aplicación web o la API: debemos monitorizar toda la pila tecnológica. Desde la red hasta los servicios de la aplicación y la propia aplicación. No todo el mundo lo hace y, cuando lo hace, parece hacerlo de forma poco sistemática.
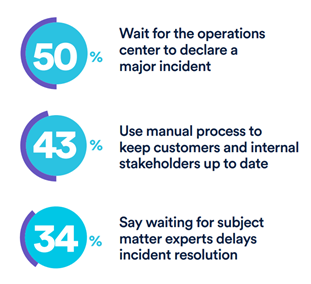
Pensemos en la encuesta de 2017 xMatters|Atlassian sobre la madurez de DevOpsen la que el 50 % de los encuestados declaró que «espera a que el equipo de operaciones declare un incidente grave» antes de responder. Resulta alarmante que un tercio de las empresas «se entere de las interrupciones del servicio a través de sus clientes».
En una economía digital, cada segundo cuenta. No solo porque cuesta dinero, sino también porque repercute negativamente en los ingresos futuros, además. La pérdida de valor de marca y de la confianza de los clientes se traduce en menos compras, menos usuarios y, con el tiempo, en un crecimiento estancado. Ese no es el rumbo que deberían tomar las organizaciones.
La monitorización es el primer paso para detectar los problemas que provocan interrupciones del servicio. Sin embargo, la monitorización por sí sola no ayuda a reducir el MTTR; la comunicación, sí. Avisar cuanto antes a las partes interesadas pertinentes y proporcionarles la información necesaria para diagnosticar el problema permitirá resolverlo más rápidamente. Esto significa que compartir —uno de los cuatro pilares fundamentales de DevOps— es clave para mejorar el MTTR. Aunque su empresa todavía no haya adoptado otros aspectos de DevOps, debería plantearse convertir el intercambio de información en una iniciativa prioritaria. Ya sea a través de ChatOps o mediante correo electrónico, una aplicación móvil o una página wiki que se actualice dinámicamente, es imprescindible que la información obtenida mediante la monitorización se comparta ampliamente en toda la organización.
Un fallo puntual en un conmutador o servidor puede parecer inofensivo, pero, si no se soluciona, podría acabar dejando fuera de servicio la mitad de los servicios de los que depende una aplicación crítica. En el estudio «State of the Network» de 2017 realizado por Viavi, el 65 % de los administradores de redes y sistemas señala que «determinar si el problema se debe a la red, al sistema o a las aplicaciones» es su principal dificultad a la hora de solucionar problemas en las aplicaciones. Una forma de abordar este reto es mejorar la visibilidad y supervisar toda la pila, garantizando que los responsables de identificar la causa raíz dispongan de toda la información posible sobre el estado y el funcionamiento de todos los componentes de la ruta de datos.
La visibilidad es clave para el futuro de las TI. Sin ella, no podemos alcanzar el nivel de automatización necesario para solucionar las interrupciones antes de que se produzcan. Sin visibilidad, no podemos reducir de forma significativa el tiempo medio de reparación (MTTR). Sin ella, sencillamente no podemos mantener el crecimiento de la empresa a un ritmo sostenible.
La visibilidad, al igual que la seguridad, debe ocupar un lugar prioritario en el conjunto de estrategias que impulsan el avance de TI. Porque las interrupciones se producen, y es la visibilidad la que permite a las organizaciones recuperarse de forma rápida y eficiente, minimizando en lo posible el daño a su marca y a sus resultados.
Sobre el autor

Lori MacVittie es ingeniera distinguida y evangelista jefe en la Oficina del CTO de F5, y cuenta con una amplia experiencia en entrega de aplicaciones, estrategia de automatización e infraestructura. Es conocida por convertir la complejidad en claridad, ya sea definiendo mecanismos de protección para agentes de IA, analizando arquitecturas multinube frágiles o explorando los límites de los sistemas escalables. Aporta más de treinta años de experiencia en el sector en desarrollo de aplicaciones, arquitectura de TI y operaciones de redes y sistemas. Antes de incorporarse a F5, fue una galardonada editora de tecnología. MacVittie posee un máster en Informática y es una autora prolífica cuyas publicaciones abarcan la seguridad, la nube y la arquitectura empresarial. También es una apasionada de los juegos de mesa y los videojuegos, y expresa sin complejos sus firmes opiniones sobre el queso.
Más artículos de Lori Mac VittieArtículos relacionados del blog

Cree servicios públicos seguros, resilientes y preparados para la IA con F5 y AWS
Descubre cómo las organizaciones del sector público pueden modernizar de forma segura sus aplicaciones y soluciones de IA, al tiempo que gestionan los sistemas heredados, el cumplimiento normativo y el riesgo operativo.

Protección de los sistemas de IA: por qué la seguridad debe avanzar al ritmo de la innovación
Desde acelerar avances revolucionarios en medicina y educación hasta transformar la vida cotidiana, la IA está cambiando nuestra forma de vivir y trabajar. Pero también ofrece grandes oportunidades a los ciberdelincuentes.
Avanzar hacia la optimización digital tras la transformación
Descubre estrategias de optimización digital para garantizar políticas de seguridad coherentes, impulsar la madurez de la transformación digital y superar los retos de la transformación.
Proyecto de código abierto destacado: mayor observabilidad con F5 Cloud Logger iApp
En el punto de mira del código abierto: cómo aumentar la observabilidad. Lee el blog de F5 para descubrir cómo exportar fácilmente la telemetría de BIG-IP a plataformas modernas de análisis en la nube.
El estado de la entrega de aplicaciones en 2018: la transformación digital impulsa la automatización y la multinube pese a las preocupaciones de seguridad
Descubre las principales conclusiones del cuarto informe anual de F5 sobre el estado de la entrega de aplicaciones.
Estado de la entrega de aplicaciones en 2017: automatización, API y DevOps
Descubre el informe sobre el estado de la entrega de aplicaciones de 2017. Lee el blog retrospectivo de F5 sobre los inicios del auge de las redes declarativas y los flujos de DevOps.