
Este artículo es el segundo de una serie en la que abordamos diversos aspectos de lo que supuso crear y gestionar nuestro servicio SaaS:
- Plano de control para una PaaS de Kubernetes distribuida
- Malla de servicios global para aplicaciones distribuidas
- Seguridad de la plataforma para infraestructuras, aplicaciones y datos distribuidos
- Seguridad de las aplicaciones y de la red de los clústeres distribuidos
- Observabilidad en toda una plataforma distribuida globalmente
- Operaciones y SRE de una plataforma distribuida globalmente
- Framework de servicios en Golang para microservicios distribuidos
En una entrada anterior del blog, explicamos el contexto de las necesidades que nos llevaron a crear una nueva plataforma. Con esta plataforma, permitimos a nuestros clientes desarrollar un conjunto complejo y diverso de aplicaciones, como fabricación inteligente, análisis forense de vídeo para la seguridad pública, negociación algorítmica y redes 5G de telecomunicaciones.
El primer artículo de esta serie trató sobre un plano de control distribuido para ofrecer múltiples clústeres de aplicaciones multiinquilino basados en Kubernetes en la nube pública, en nuestros PoP de red privada y en ubicaciones periféricas.
Este artículo aborda los retos que plantea conectar y proteger estos clústeres de aplicaciones distribuidos desde tres perspectivas: de aplicación a aplicación, de usuario o máquina a aplicación y de aplicación a la Internet pública. Presentaremos una ruta de datos L3-L7+ totalmente nueva e integrada, un plano de control distribuido globalmente y nuestra red global de alto rendimiento. Estos tres elementos se combinan para ofrecer un conjunto completo de servicios de red y seguridad en el edge, dentro de cualquier VPC en la nube o en los PoP de nuestra red global. Tras más de un año en producción con más de 35 clientes, hemos empezado a ampliar el despliegue y creemos que este es un buen momento para compartir nuestra experiencia.
TL;DR (Resumen)
- Para ofrecer una conectividad segura, fiable y de alto rendimiento a clústeres de aplicaciones distribuidos, tuvimos que crear una nueva red global. Aunque existen muchos proveedores de servicios que conectan de forma segura a los consumidores con las aplicaciones (Akamai, Cloudflare, etc.) y a los empleados con las aplicaciones (p. ej., Zscaler, Netskope, etc.), no hay ningún proveedor que satisfaga las necesidades de conectividad y seguridad entre aplicaciones.
- Además de una red global para conectar aplicaciones distribuidas, estos clústeres de aplicaciones requieren servicios de red, fiabilidad y seguridad —enrutamiento de API, balanceo de carga, seguridad y enrutamiento de red— con un modelo operativo y de configuración coherente. Estos servicios deben ejecutarse en distintas ubicaciones de proveedores de nube, en ubicaciones perimetrales con recursos limitados y/o en nuestra red global.
- Para prestar estos servicios de red y seguridad, decidimos crear una nueva ruta de datos de red L3-L7+ totalmente integrada, con una configuración, unas políticas y una observabilidad coherentes independientemente de dónde se ejecutara: en nuestra red, en numerosas nubes públicas o en ubicaciones perimetrales. Dado que muchas de estas rutas de datos pueden desplegarse en varios sitios, también tuvimos que crear un plano de control distribuido globalmente para orquestarlas.
- La combinación de una red global, una nueva ruta de datos de red y un plano de control distribuido nos ha proporcionado una «puerta de enlace de aplicaciones distribuida globalmente» que ofrece seguridad de confianza cero, conectividad de aplicaciones y fiabilidad de los clústeres sin conceder acceso a la red a través de esta red global: una «malla de servicios global» que simplifica el trabajo de nuestro equipo de seguridad y cumplimiento normativo.
¿Dónde están los cables? ¿Por qué construimos una red global?
Dado que nuestros clientes están desarrollando aplicaciones bastante complejas y esenciales para sus operaciones —como fabricación inteligente, análisis forense de vídeo para la seguridad pública, negociación algorítmica o la transición de las empresas de telecomunicaciones al 5G—, debemos ofrecer una experiencia siempre disponible, conectada y fiable tanto para las aplicaciones como para sus usuarios finales. Algunas de estas aplicaciones ejecutan canalizaciones de datos entre clústeres dentro de una nube, necesitan realizar copias de seguridad de los datos entre distintos proveedores de servicios en la nube, requieren una entrega fiable de las solicitudes desde una base global de usuarios hasta los backends de las aplicaciones o necesitan conectividad de alto rendimiento entre sus máquinas y los backends alojados en nubes centralizadas.
Para satisfacer estas necesidades, la red física debía cumplir dos requisitos:
R1 — De nube a nube — Conectividad de aplicaciones de alto rendimiento y bajo demanda entre ubicaciones de nube pública o privada de todo el mundo
R2 — De Internet a la nube — Para que los dispositivos y las máquinas ubicados en el extremo de la red pudieran conectarse de forma fiable al backend de la aplicación, necesitábamos proporcionar varias rutas redundantes y finalizar las conexiones lo más cerca posible de estos usuarios, en lugar de redirigir el tráfico a través de Internet hasta los backends.
Podríamos haber cumplido los requisitos R1 y R2 recurriendo a un proveedor de servicios de red como AT&T, pero no habría podido ofrecernos una experiencia de red fluida ni una integración perfecta con nuestros servicios de aplicaciones: configuración mediante API, telemetría en streaming, posibilidad de añadir fácilmente nuestros propios prefijos IP o los de nuestros clientes, servicios de red mediante API, etc. Además, obtener cobertura mundial a través de proveedores de servicios resulta muy difícil o tiene un coste prohibitivo. Podríamos haber recurrido a dos o tres proveedores distintos para resolver todos estos problemas, pero habríamos acabado con un entramado de sistemas diferentes, con comportamientos y modos de fallo distintos, diferentes SLA y sistemas de soporte, y API diferentes o inexistentes.
Así que al final tuvimos que construir nuestra propia red, lo que implicaba que debía tener tres propiedades:
- Resolver R1 implicaba que teníamos que crear una red privada que abarcara varios proveedores de servicios en la nube y distintas ubicaciones de todo el mundo para conectar todas las regiones. La mejor forma de hacerlo es establecer acuerdos de interconexión con proveedores de servicios en la nube en las principales regiones, además de utilizar una combinación de enlaces de conexión directa en los principales centros de coubicación. La interconexión no garantiza los mejores SLA, mientras que los enlaces de conexión directa sí ofrecen garantías de SLA dentro de una región de nube.
- Resolver R2 para las máquinas ubicadas en el extremo de la red implicaba que debíamos admitir varios enlaces activo-activo desde cada ubicación periférica. Estos enlaces podían ser conexiones a Internet de bajo coste (por red móvil, cable o fibra) y/o enlaces dedicados de mayor coste (por fibra o Ethernet). Para lograr un buen rendimiento y una alta fiabilidad, el tráfico debe equilibrarse y terminar lo más cerca posible de la ubicación periférica, en lugar de transportarse a través de una conexión a Internet poco fiable. En la jerga del sector, esta función también se denomina SD-WAN.
- Resolver R2 para usuarios de Internet y aplicaciones en el extremo de la red implicaba que debíamos terminar el tráfico TLS en el extremo, y que esto también debía hacerse lo más cerca posible del usuario. Para ello, tuvimos que crear ubicaciones en el extremo de la red con una alta densidad de interconexiones con operadores móviles y proveedores de contenidos, así como canalizar el tráfico a través de varios proveedores de tránsito para garantizar un enrutamiento óptimo.
Para cumplir estas tres propiedades, tuvimos que hacer muchas cosas. Sin embargo, destacaremos cinco grandes áreas:
- PoP de red globales con nuestros equipos de red — finalmente tuvimos que crear varios PoP de red en los principales mercados metropolitanos. Empezamos en varias ciudades europeas —París, Londres, Ámsterdam y Luxemburgo— y con un PoP en Nueva York, Estados Unidos, durante las primeras etapas del desarrollo de nuestra plataforma. Después, nos expandimos a Seattle, San José, Ashburn, Fráncfort, Singapur y Tokio, lo que nos proporcionó cobertura global y proximidad a los principales proveedores de servicios en la nube. Elegimos a Equinix como socio global y complementamos su oferta con Interxion, Telehouse/KDDI y Westin en aquellos lugares donde Equinix no era la opción más adecuada. Como creemos en la automatización, finalmente elegimos a Juniper Networks para los equipos de conmutación y enrutamiento, y a Adva para la interconexión metropolitana mediante fibra con enlaces de 400G y 100G.
- Red troncal privada — Para conectar todos estos PoP con un alto rendimiento y fiabilidad, decidimos no crear una red superpuesta sobre varios proveedores de tránsito, sino construir una red troncal privada global mediante una combinación de múltiples enlaces de 100G de proveedores como Zayo, Centurylink, EuNetworks, etc. Aunque muchos proveedores de CDN (p. ej., Cloudflare y Fastly) y de seguridad (p. ej., Zscaler) dependen por completo de conexiones de tránsito y peering, ya que gestionan tráfico descendente, creemos que existen buenas razones para utilizar una combinación de red troncal privada y tránsito, puesto que gestionamos tráfico este-oeste entre aplicaciones. Esto no es algo exclusivo de nosotros: todos los grandes proveedores de servicios en la nube cuentan con una red troncal privada global que conecta sus ubicaciones en la nube.
- Proveedores de peering y tránsito de Internet — Para aumentar la diversidad y lograr el mejor rendimiento al conectar con usuarios y proveedores de contenido o SaaS, la solución ideal es establecer conexiones de peering directas con el mayor número posible de operadores y proveedores de contenido. Establecemos conexiones de peering en varios puntos de intercambio, tal como se indica en PeeringDB (ASN-35280 en PeeringDB). No todo el tráfico puede gestionarse mediante las conexiones de peering, y es ahí donde entran en juego las conexiones de tránsito. Los enlaces de tránsito y los puertos de peering deben supervisarse con sumo cuidado para mantener la calidad; finalmente, seleccionamos a los mejores proveedores de nivel 1, como NTT, CenturyLink y Telia, para que nos presten servicio en distintas ubicaciones de todo el mundo.
- Peering e interconexiones con proveedores de nube — Recientemente hemos empezado a establecer conexiones de peering directas con proveedores de nube, pero estos no garantizan ningún SLA para dichas conexiones. Por ejemplo, mediante nuestra conexión de peering en Seattle (en las instalaciones de Westin), podemos acceder directamente a los tres principales proveedores de nube. Aunque estas conexiones son mejores que recurrir únicamente a proveedores de tránsito, hemos empezado a ampliar nuestra red con conexiones directas a estos proveedores de nube (denominadas AWS Direct Connect, Azure ExpressRoute y GCP Dedicated Interconnect), ya que incluyen SLA y funciones adicionales. Si bien estos enlaces son caros y solo permiten acceder a subredes VPC/VNET internas, ofrecen la mejor conectividad.
- Puertas de enlace de software — En las ubicaciones en la nube o en el extremo que no están conectadas directamente a nuestros PoP, instalamos nuestras puertas de enlace de software. Abordaremos las funcionalidades avanzadas que ofrecen estas puertas de enlace en una sección posterior de este blog, pero una de las funciones relacionadas con la capa de transporte es que estas puertas de enlace crean automáticamente túneles VPN seguros (IPsec o SSL) hacia varios PoP de red para proporcionar redundancia y equilibrar el tráfico entre ellos. Además, en una implementación en la nube, estas puertas de enlace establecen una conexión saliente con nuestro PoP más cercano a través de las puertas de enlace NAT de los proveedores de servicios en la nube y proporcionan un punto de acceso a nuestra red privada global, sin necesidad de atravesar redes públicas ni de conectar clústeres de aplicaciones entre distintas ubicaciones en la nube mediante direcciones IP públicas.
En una fase muy temprana de nuestro desarrollo, nos dimos cuenta de que crear y operar una red global requiere tiempo y conocimientos, y de que necesitábamos incorporar esa experiencia. Tras meses de conversaciones con los fundadores de Acorus Networks (un proveedor de seguridad con sede en París, Francia), acabamos fusionando Acorus con Volterra. Esto nos ayudó a resolver el problema del despliegue de nuestra infraestructura y red globales. Acorus había creado desde cero una excelente red y un equipo de operaciones que había automatizado por completo la configuración de la red física mediante Ansible y desarrollado API externas de telemetría y configuración que nuestro equipo de software podía utilizar.
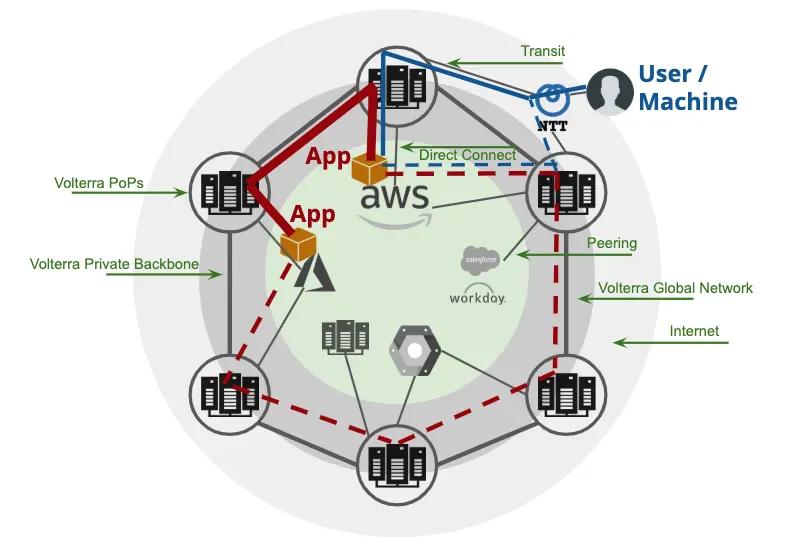
Ahora que contábamos con un equipo centrado en desarrollar una red privada global de gran fiabilidad y rendimiento, podíamos resolver fácilmente los problemas relacionados tanto con el tráfico entre aplicaciones como con el tráfico de usuarios o máquinas hacia aplicaciones en ubicaciones perimetrales o en la nube, tal como se muestra en la Figura 1. Además, la infraestructura informática y de almacenamiento de nuestros PoP de red también nos permitía incorporar a nuestra red la terminación de API, la seguridad de las aplicaciones y la descarga de cargas de trabajo (desde el perímetro o la nube). Esto nos permitirá seguir ampliando nuestras capacidades durante mucho tiempo y expandir fácilmente la cobertura de nuestra red y nuestro catálogo de servicios en función de la demanda.
Servicios de red para aplicaciones: ¿multinube, nube privada o edge?
Una vez que dispusimos de una red global operativa, tuvimos que empezar a añadir clústeres de aplicaciones y nuestras cargas de trabajo. Estas cargas de trabajo necesitan su propio conjunto de servicios de conectividad y seguridad a nivel de aplicación.
Como explicamos en nuestro blog anterior, nuestro objetivo con la plataforma era mejorar la productividad y reducir la complejidad para nuestros equipos encargados de gestionar cargas de trabajo que se ejecutan en múltiples entornos (la nube, el edge y los puntos de presencia de nuestra red).
Todos los proveedores de servicios en la nube requieren configurar, gestionar y supervisar numerosos recursos en la nube para garantizar una conectividad segura con los clústeres de aplicaciones. Por ejemplo, en Google Cloud, para configurar un servicio de red integral para un clúster de aplicaciones, tendremos que gestionar numerosos conjuntos de servicios diferentes:
Servicios de red de área amplia (WAN)
Servicios de redes de aplicaciones
- Balanceadores de carga de aplicaciones, Balanceadores de carga de red (API públicas)
- Balanceadores de carga de aplicaciones, Balanceadores de carga de red (Internos)
- Malla de servicios (De aplicación a aplicación)
Servicios de enrutamiento y aislamiento de red
- Red de nube privada virtual (red VPC)
- Subredes, Rangos de IP, Rutas
- Puertas de enlace NAT, Reglas de firewall
Bien, aunque habría supuesto un gran reto, podríamos haber decidido abordarlo creando una capa de configuración y operaciones que unificara la gestión entre los distintos proveedores de nube. Sin embargo, sabíamos que eso no habría resuelto nuestros problemas, ya que los servicios de los proveedores de nube no satisfacían todas nuestras necesidades (por ejemplo, los CSP no ofrecen la posibilidad de proteger aplicaciones y API), no son los mejores de su categoría y cambian continuamente.
Además, ¿qué ocurre con nuestros PoP de red y emplazamientos perimetrales? Tendríamos que obtener capacidades similares de proveedores de hardware o software e integrarlas todas, por ejemplo, Cisco/Juniper para enrutamiento+NAT+VPN, F5 para balanceo de carga y cortafuegos, etc. En los emplazamientos perimetrales, el problema se agrava, ya que ni los proveedores de servicios en la nube ni los grandes proveedores de redes podían resolver los problemas de los servicios de red en un entorno con recursos limitados. Otra posible opción para el perímetro habría sido trasladar toda la conectividad de las aplicaciones, la seguridad y los servicios de red a nuestra red global, pero estaba claro que no funcionaría, ya que el tráfico entre aplicaciones dentro del mismo emplazamiento perimetral también necesitaba algunos de estos servicios.
Tras muchas conversaciones y tras analizar el panorama, nos dimos cuenta de que integrar numerosos proveedores de servicios y fabricantes —configuración, telemetría, supervisión y alertas— y mantenernos al día de sus hojas de ruta y de los cambios en sus API iba en contra de nuestro objetivo de simplicidad y rapidez.
Otro problema que teníamos que resolver en toda la plataforma era la multitenencia. Esto resultaba más sencillo en el caso de los servicios WAN y el enrutamiento de red, pero suponía un reto para los servicios de red de aplicaciones, ya que la mayoría de los balanceadores de carga del mercado ofrecen una compatibilidad nula o muy limitada con la multitenencia.
Una nueva ruta de datos de red L3-L7+
Como resultado, decidimos afrontar este reto y crear una ruta de datos de red de alto rendimiento que no solo proporcionara servicios de enrutamiento de red, sino también servicios de aplicaciones, seguridad y redes de área extensa. Esto nos permitiría unificar la cartera de servicios en todo nuestro entorno de nube híbrida y distribuida, y depender únicamente de un conjunto mínimo de servicios nativos de las nubes públicas.
Dado que el equipo contaba con una amplia experiencia en redes y que ya habíamos abordado problemas similares anteriormente con Contrail/Juniper, consideramos que la mejor forma de resolver este problema era partir de cero y crear una solución de red completamente nueva que integrase servicios de L3 a L7+ en una única ruta de datos, capaz de ejecutarse en cualquier nube o entorno perimetral y gestionarse de forma centralizada desde nuestra plataforma.
Elegimos los mejores proyectos como punto de partida para diseñar esta nueva ruta de datos: OpenContrail vRouter (para L3-L4), que ya llevábamos seis años desarrollando, y Envoy para L7, dado el enorme respaldo de su comunidad. Dicho esto, tuvimos que realizar varios cambios e incorporaciones para crear una nueva ruta de datos unificada L3-L7+: multitenencia para Envoy, dpdk para Envoy, una pila TCP dpdk en el espacio de usuario, políticas de red, VPN SSL/IPSec, http connect, proxy inverso dinámico, proxy directo transparente, puerta de enlace de API, políticas de aplicaciones programables, ACL rápidas para la protección contra ataques DDoS, integración de identidades PKI, motor Chrome v8, seguridad de aplicaciones y redes, etc.
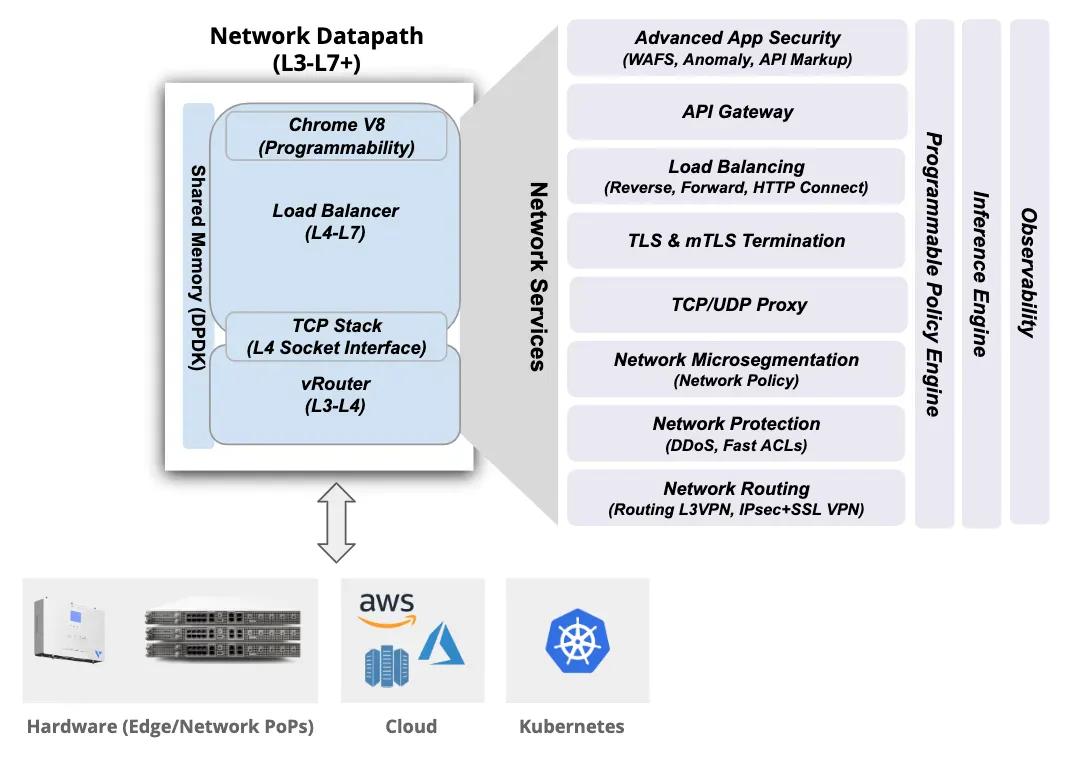
Esta ruta de datos (como se muestra en la Figura 2) se implementa como puerta de enlace de entrada/salida para nuestros clústeres de aplicaciones, como puerta de enlace de software en el extremo, para proporcionar funciones de malla de servicios dentro de un clúster o entre varios clústeres, o para prestar servicios de red desde nuestros PoP globales.
Para satisfacer nuestra necesidad de que la plataforma fuera multiinquilino (abordada en la entrada anterior del blog), también necesitábamos dotar a esta ruta de datos de red de una compatibilidad total con múltiples inquilinos. Esto fue relativamente sencillo para la capa de enrutamiento, ya que vRouter ya admitía VRF, pero tuvimos que modificar Envoy para que fuera multiinquilino. Como no utilizábamos la pila TCP del kernel, modificamos la interfaz de sockets TCP de Envoy y añadimos compatibilidad con VRF.
Esta ruta de datos también debía proporcionar seguridad para las API, cortafuegos de aplicaciones y seguridad de red. Para ello, utilizamos una combinación de técnicas algorítmicas e inferencia automática, un tema que abordaremos en una próxima entrada del blog.
Obtuvimos muchas ventajas al crear esta ruta de datos de red:
Capacidades completas de L3 a L7+ con configuración, control y observabilidad uniformes
La compatibilidad con el escalado horizontal dentro de un único clúster nos permite abarcar desde dispositivos perimetrales de tamaño muy reducido y menor rendimiento hasta capacidades de 100 Gbps o más en nuestra red o en ubicaciones de nube pública.
Añada rápidamente nuevas funcionalidades a la ruta de datos de la red sin depender de ningún proveedor de red ni de servicios en la nube
Una solución común con características similares de rendimiento y respuesta ante fallos en cualquier entorno, algo muy importante para nuestros equipos de operaciones.
Ahora que podíamos desplegar varios clústeres de aplicaciones con esta nueva ruta de datos de red, era fundamental crear un plano de control distribuido globalmente para configurarlos, controlarlos y supervisarlos.
Plano de control diseñado específicamente para una red distribuida
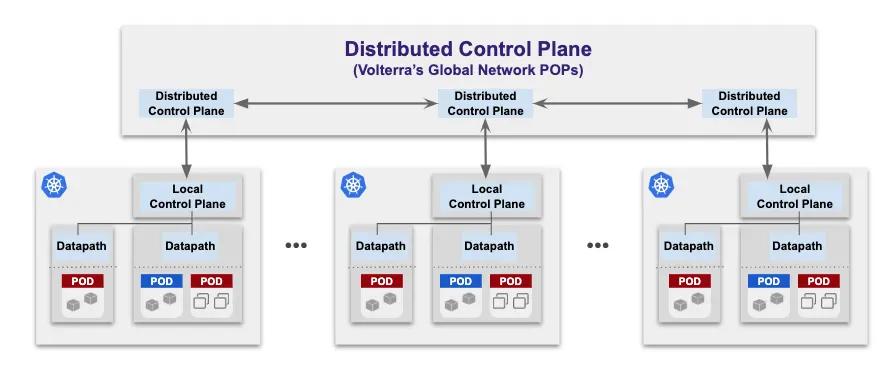
Nuestro equipo de plataforma tuvo que abordar múltiples problemas al crear un plano de control distribuido para gestionar un gran número de nodos distribuidos de procesamiento del plano de datos. Como desarrollamos un nuevo plano de datos, no había ningún plano de control listo para usar que pudiéramos aprovechar, por lo que tuvimos que crear el nuestro: un plano de control local para gestionar varios planos de datos que se ejecutan en un único clúster (en la nube, en el edge o en un PoP de red). Estos nodos del plano de datos necesitaban un plano de control local para gestionar los cambios de configuración y las actualizaciones de rutas, realizar comprobaciones de estado y el descubrimiento de servicios, establecer conexiones de peering con otros dispositivos de red mediante un protocolo como BGP, agregar métricas y registros de acceso, etc. Plano de control distribuido para gestionar varios planos de control locales: en nuestros PoP de la red global se ejecuta un plano de control distribuido (Figura 3), que se encarga de gestionar la configuración de los planos de control locales, distribuir el estado operativo entre cada uno de ellos y recopilar datos de cada nodo. Para distribuir el estado operativo, decidimos utilizar BGP, ya que ofrece consistencia eventual y es robusto. Como habíamos desarrollado una implementación de BGP multihilo y altamente escalable como parte de OpenContrail, la aprovechamos y añadimos extensiones para el balanceo de carga, la distribución de comprobaciones de estado, los endpoints http/api, la propagación de políticas, etc.
Además, existe un plano de gestión centralizado que se ejecuta en dos regiones de nube —AWS y Azure— y que se utiliza junto con el plano de control distribuido para ofrecer un entorno multiinquilino, como se muestra en la Figura 4. Nuestro equipo de SRE puede crear varios inquilinos, cada uno de ellos completamente aislado de los demás en toda nuestra red global. Solo pueden comunicarse entre sí a través de la «red pública». Dentro de un inquilino, los servicios de distintos espacios de nombres pueden comunicarse entre sí según las reglas de enrutamiento HTTP, de API y de red, así como las reglas de seguridad.
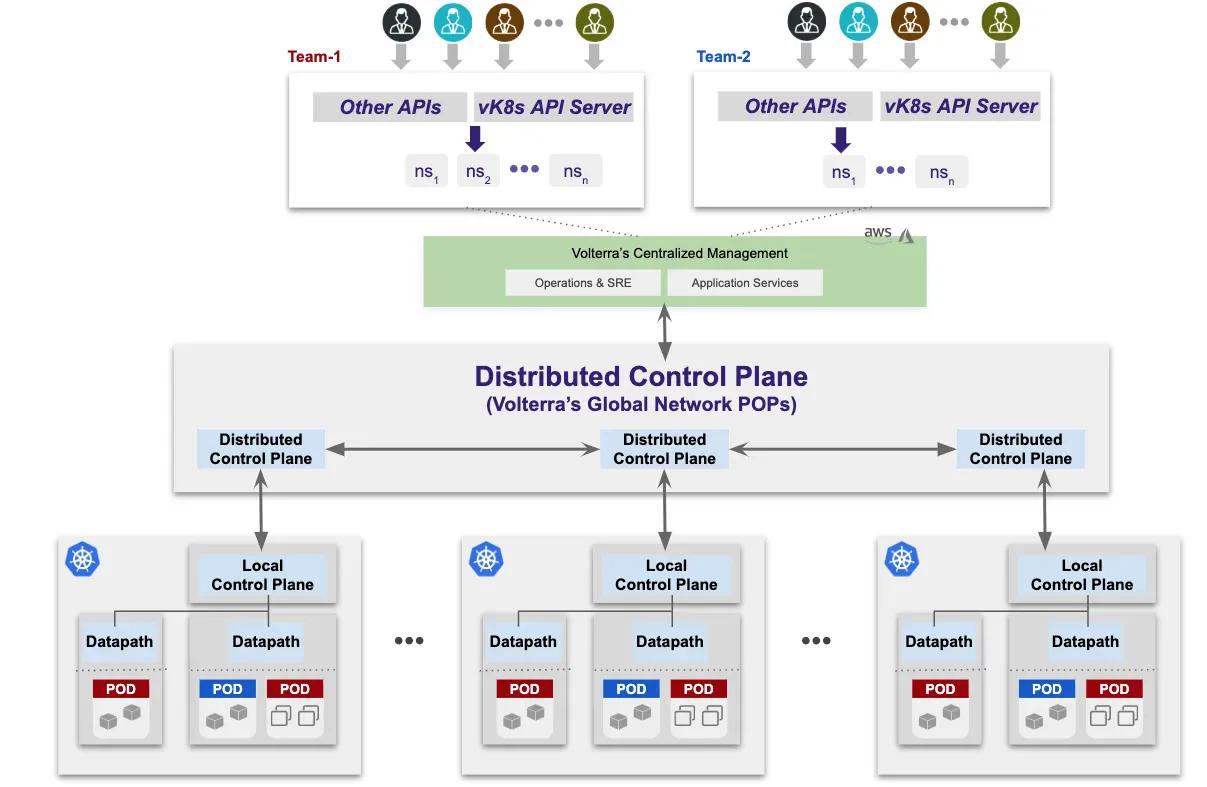
Los planos de control se ejecutan como cargas de trabajo de Kubernetes en un tenant independiente y un espacio de nombres aislado que están bajo el control exclusivo de nuestros equipos de SRE. Por tanto, ningún desarrollador ni cliente puede interrumpir este servicio. Además, dado que el plano de control está distribuido, una interrupción de un plano de control en una ubicación no afecta al servicio en su conjunto.
¿Puerta de enlace de aplicaciones distribuida globalmente?
Una vez que determinamos las necesidades de nuestra red global y definimos los requisitos de los servicios de red L3-L7+ para los clústeres de aplicaciones (una nueva ruta de datos y un plano de control distribuido), nuestro equipo de producto planteó más requisitos que hicieron nuestro trabajo aún más emocionante. Básicamente, querían que proporcionáramos una malla de servicios global entre clústeres con las siguientes características:
- Proporcionar conectividad entre aplicaciones (enrutamiento, control y observabilidad) en toda la red global, pero no conectividad entre redes (al menos, no de forma predeterminada). El motivo era sencillo: conectar redes genera todo tipo de vulnerabilidades de seguridad que solo pueden resolverse mediante la creación de complejas reglas de cortafuegos, lo que dificulta la gestión de cambios.
- Mejorar los balanceadores de carga perimetrales en los PoP de la red teniendo en cuenta el estado y la fiabilidad de los endpoints — Actualmente, en los balanceadores de carga perimetrales (p. ej., AWS Global Accelerator o Akamai Global Load Balancer), la decisión de enrutamiento desde la ubicación perimetral hasta el backend se basa en el estado del servidor de origen (en la mayoría de los casos, el servidor de origen es otro balanceador de carga y no el endpoint que presta el servicio). Nuestro equipo quería que cada uno de nuestros balanceadores de carga perimetrales pudiera gestionar el tráfico en función del estado de todos los endpoints de todos los clústeres, y no solo del estado de los balanceadores de carga de origen.
- Mejorar la selección del sitio perimetral (PoP de red) como parte de la toma de decisiones de GSLB. Actualmente, anycast o GSLB dirigen al usuario/cliente al sitio perimetral más cercano para el tráfico de entrada. Sin embargo, por diversos motivos (la carga en la red troncal o en los proveedores de tránsito), podría ser preferible enviar al usuario a un sitio perimetral de entrada diferente.
Con los requisitos n.º 2 y n.º 3, el objetivo era mejorar el tiempo de respuesta y el rendimiento de la conectividad entre el cliente y el servidor, algo realmente crucial en la comunicación entre aplicaciones o para aplicaciones SaaS a gran escala. Para cumplir los requisitos n.º 2 y n.º 3, estaba claro que el mejor enfoque era crear un proxy distribuido (Figura 5), con un proxy de entrada y otro de salida, y realizar el enrutamiento en función del direccionamiento de las aplicaciones, no del direccionamiento de red. Además, decidimos distribuir el estado de los endpoints de servicio (o servidores) aprovechando el plano de control distribuido y las extensiones de BGP (como se ha descrito anteriormente). Esta implementación del proxy distribuido se muestra en el siguiente diagrama.
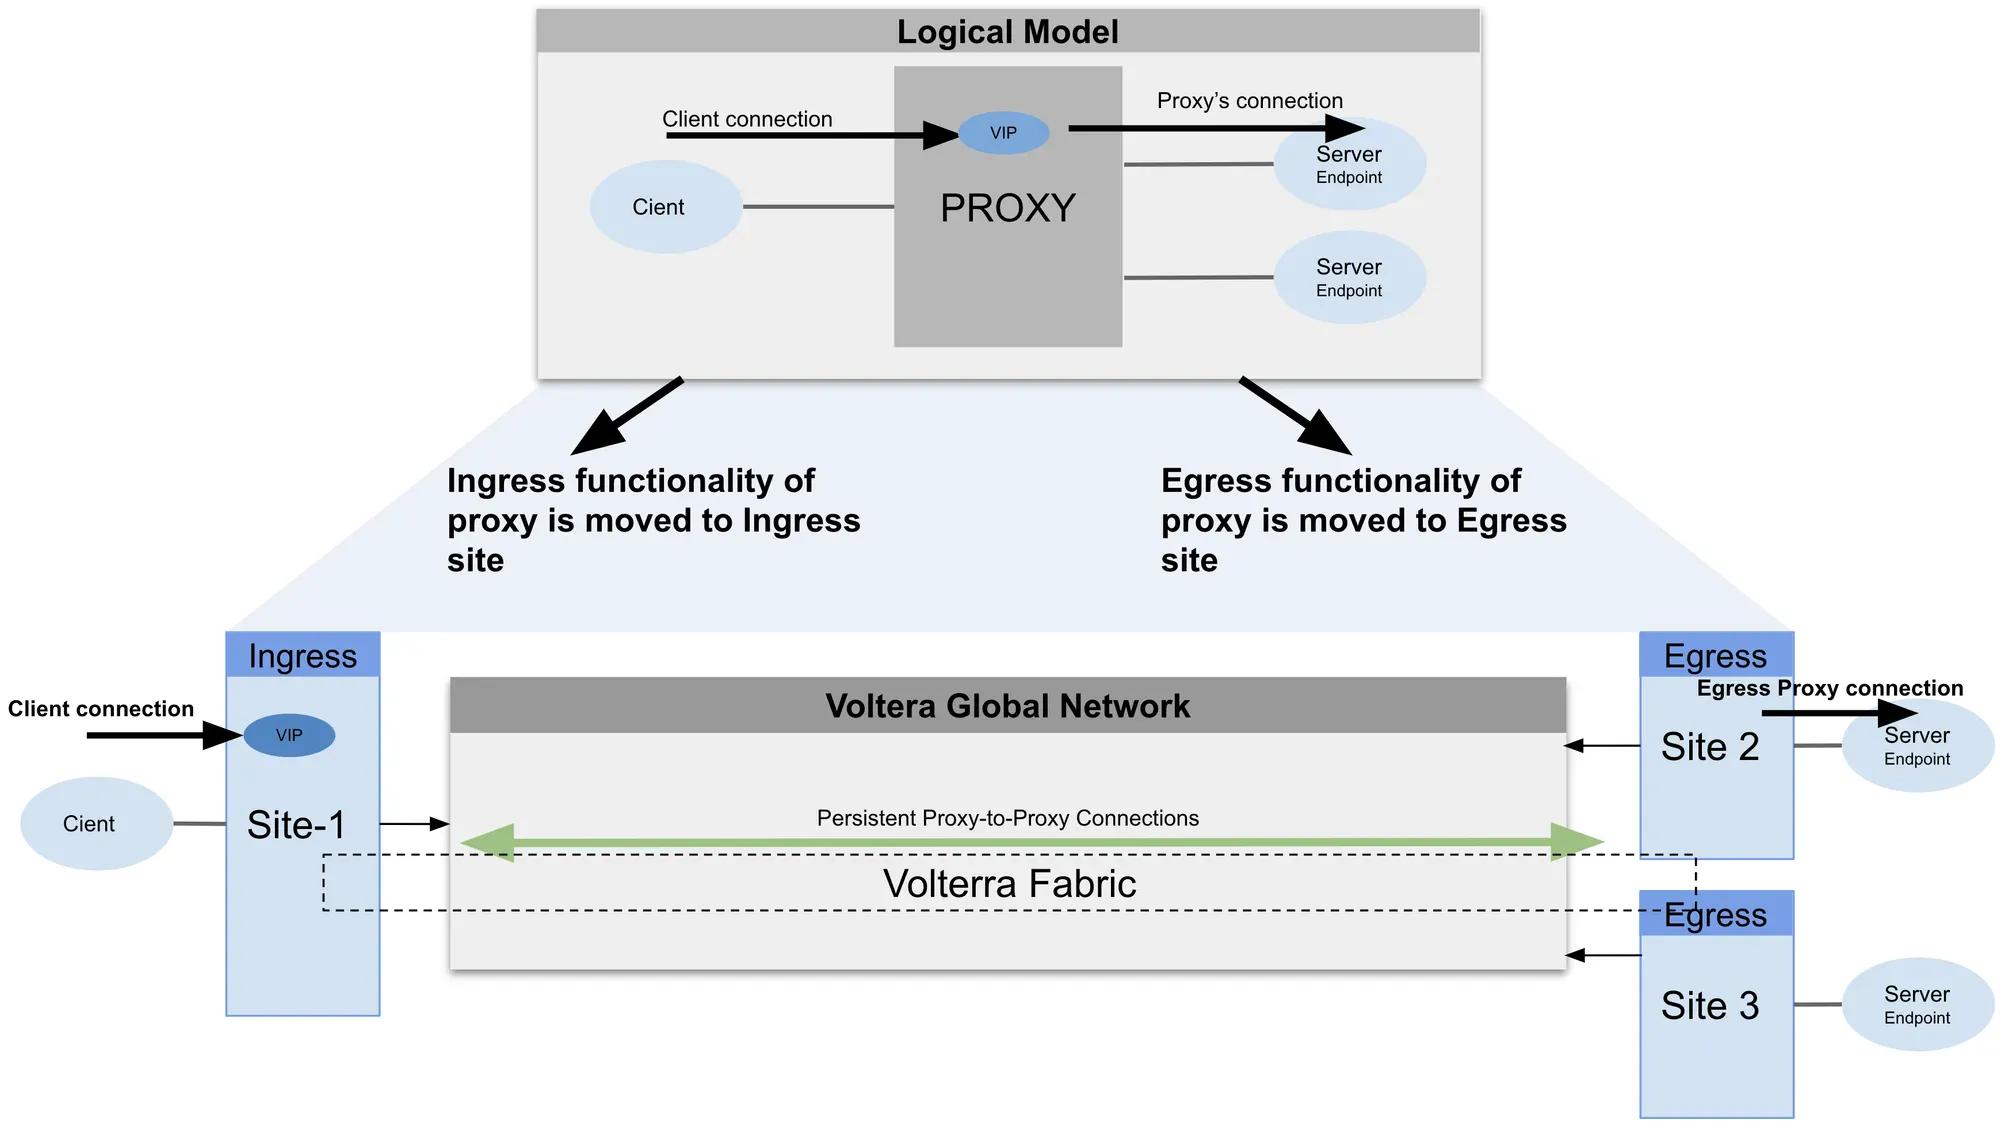
Dado que se ha convertido en un proxy distribuido con una pila de red L3-L7+ completa, lo denominamos puerta de enlace de aplicaciones distribuida globalmente. Todas las funciones disponibles en nuestra ruta de datos de red están ahora disponibles en toda nuestra red global; por ejemplo, el equilibrio de carga y el enrutamiento basados en HTTP o API, la aplicación de políticas en el perímetro, la transformación de API, la terminación TLS más cerca del usuario, etc.
Ventajas que ofrece Distributed Application Gateway
El equipo pudo obtener múltiples beneficios gracias a la implementación de una puerta de enlace de aplicaciones distribuida globalmente. Estos beneficios se produjeron en los ámbitos de las mejoras operativas, la seguridad, el rendimiento y el coste total de propiedad (TCO):
- Seguridad y cumplimiento normativo — La capacidad de proporcionar acceso a las aplicaciones entre distintas ubicaciones sin acceso a la red ha mejorado significativamente la seguridad y el cumplimiento normativo de los clústeres de aplicaciones en ubicaciones perimetrales o en la nube. Esto también ha reducido la necesidad de gestionar configuraciones complejas de cortafuegos, ya que no hay acceso a la red entre las ubicaciones y los clústeres de aplicaciones pueden estar conectados, pero permanecer completamente detrás de NAT en cada ubicación.
- Carga operativa — El uso de un conjunto común de servicios de red en nuestros puntos de presencia (PoP) de red y ubicaciones perimetrales o en la nube ha eliminado la necesidad de que nuestros equipos de SRE o DevOps integren la configuración y la observabilidad de distintos conjuntos de servicios.
- Mejoras de rendimiento y fiabilidad — Dado que enrutamos el tráfico desde nuestro PoP de red al punto de conexión óptimo y disponible, en lugar de hacerlo al balanceador de carga óptimo, la plataforma ofrece un rendimiento muy superior al de cualquier otra solución del mercado para el tráfico entre aplicaciones o entre usuarios y aplicaciones.
- Ahorro en el coste total de propiedad — En las aplicaciones SaaS a gran escala, es habitual disponer de cientos de réplicas del servicio alojadas en varios centros de datos de todo el mundo. Para hacerlo de forma eficaz, el proveedor de SaaS debe desarrollar funcionalidades complejas que, gracias a esta puerta de enlace de aplicaciones distribuida, ahora están disponibles para todos nuestros clientes.
Continuará…
Esta serie de artículos abordará diversos aspectos de lo que supuso para nosotros crear y operar nuestro servicio SaaS distribuido globalmente, con numerosos clústeres de aplicaciones en la nube pública, nuestros puntos de presencia (PoP) de red privada y ubicaciones en el extremo. El siguiente tema es Seguridad de la plataforma y los datos…
Sobre el autor
Artículos relacionados del blog

Cree servicios públicos seguros, resilientes y preparados para la IA con F5 y AWS
Descubre cómo las organizaciones del sector público pueden modernizar de forma segura sus aplicaciones y soluciones de IA, al tiempo que gestionan los sistemas heredados, el cumplimiento normativo y el riesgo operativo.

Protección de los sistemas de IA: por qué la seguridad debe avanzar al ritmo de la innovación
Desde acelerar avances revolucionarios en medicina y educación hasta transformar la vida cotidiana, la IA está cambiando nuestra forma de vivir y trabajar. Pero también ofrece grandes oportunidades a los ciberdelincuentes.
Avanzar hacia la optimización digital tras la transformación
Descubre estrategias de optimización digital para garantizar políticas de seguridad coherentes, impulsar la madurez de la transformación digital y superar los retos de la transformación.
Proyecto de código abierto destacado: mayor observabilidad con F5 Cloud Logger iApp
En el punto de mira del código abierto: cómo aumentar la observabilidad. Lee el blog de F5 para descubrir cómo exportar fácilmente la telemetría de BIG-IP a plataformas modernas de análisis en la nube.
El estado de la entrega de aplicaciones en 2018: la transformación digital impulsa la automatización y la multinube pese a las preocupaciones de seguridad
Descubre las principales conclusiones del cuarto informe anual de F5 sobre el estado de la entrega de aplicaciones.
Estado de la entrega de aplicaciones en 2017: automatización, API y DevOps
Descubre el informe sobre el estado de la entrega de aplicaciones de 2017. Lee el blog retrospectivo de F5 sobre los inicios del auge de las redes declarativas y los flujos de DevOps.