Big data. Cada hora se generan petabytes de datos procedentes de millones de sensores y monitores integrados en dispositivos a lo largo de toda la cadena de valor empresarial. Desde la fabricación hasta la entrega, y desde el punto de venta hasta los consumidores, se generan cantidades de datos sin precedentes.
Esos datos, por sí solos, carecen de significado. Los datos en sí son un conjunto de unos y ceros dispuestos de formas específicas que, al ser interpretados por una aplicación, se convierten en información. La información solo resulta útil cuando se analiza y solo se convierte en valor cuando se actúa a partir de ella.
Las personas no pueden analizar eficazmente los datos que se generan hoy en día, y mucho menos los que se generarán en la próxima hora, día o semana. Sin embargo, cada vez es más necesario tomar decisiones empresariales prácticamente en tiempo real. Para lograrlo, se necesitan capacidad de computación y sistemas entrenados para reconocer las señales entre las ingentes cantidades de ruido que se recopilan a diario.
No se trata de una mera conjetura. En «Aprendizaje automático: el nuevo campo de pruebas para obtener una ventaja competitiva» —una encuesta realizada por MIT Technology Review Custom y Google Cloud—, más del 60 % de los encuestados «ya ha implementado estrategias de aprendizaje automático (ML), y casi un tercio considera que sus iniciativas han alcanzado una fase de madurez». El motivo de su considerable inversión en esta tecnología incipiente es obtener una ventaja competitiva. «Según los encuestados, una de las principales ventajas del aprendizaje automático es la posibilidad de lograr una ventaja competitiva, y el 26 % de quienes ya lo han implementado considera que ha alcanzado ese objetivo».
Se prevé que los beneficios sean extraordinarios.
“Para una empresa típica de la lista Fortune 1000, un aumento de tan solo el 10 % en la accesibilidad de los datos generará más de 65 millones de dólares adicionales de beneficio neto.”
“Los minoristas que aprovechen todo el potencial del big data podrían aumentar sus márgenes operativos hasta en un 60 %.”
Hasta aquí, todo bien. Utilizamos los datos para tomar decisiones que permiten a las empresas liderar y crecer.
El peligro reside en no reconocer que toda dependencia conlleva un riesgo. Si dependo de un coche para ir al supermercado (porque donde vivo no hay transporte público), existe el riesgo de que le ocurra algo a ese coche. Un riesgo considerable. Si mi empresa depende del big data para tomar decisiones (posiblemente en mi lugar, si se toman al pie de la letra las predicciones de los expertos), existe el riesgo de que les ocurra algo a esos datos.
No me refiero ahora a la pérdida evidente de los datos, ni siquiera a su corrupción. Me refiero a una amenaza más insidiosa que surge de la confianza que depositamos en la veracidad de esos datos.
Para poder tomar decisiones basadas en cualquier dato, ya sea en nuestra vida personal o profesional, primero debemos confiar en la exactitud de esos datos.
Big Data sucio
Los datos sucios no son nada nuevo. Confieso que, de vez en cuando, falseo mis datos personales cuando me los solicitan para acceder a un artículo o recurso en Internet. Sin embargo, los nuevos flujos de datos no están necesariamente expuestos a este tipo de alteración inocua, sino a la manipulación deliberada por parte de agentes malintencionados decididos a desviar su empresa de su rumbo.
Como tomamos decisiones basándonos en los datos y solo solemos cuestionarlos cuando aparecen valores atípicos evidentes, somos prácticamente incapaces de percibir la amenaza de una manipulación gradual. Al igual que el ya manido recurso de desviar céntimos de las transacciones bancarias, una alteración sutil de los datos puede pasar inadvertida. Un aumento gradual de la demanda del producto X en un mercado podría interpretarse como el éxito de las iniciativas de marketing o promoción. La macroeconomía suele poder explicar una caída repentina de la demanda del producto Y en otros mercados. Mi capacidad para influir en su negocio es considerable si tengo la paciencia y la determinación necesarias para corromper los datos en los que basa sus decisiones de fabricación o distribución.
¿Hasta qué punto es significativo? La mala calidad de los datos provoca una pérdida de alrededor del 30 % de los ingresos, según Ovum Research. Analytics Week recopiló una fascinante lista de datos sobre el big data que reflejan consecuencias similares derivadas de datos de mala calidad, entre ellas:
“Los datos de mala calidad pueden costar a las empresas entre el 20 % y el 35 % de sus ingresos operativos.”
“Los datos erróneos o de mala calidad cuestan a las empresas estadounidenses 600.000 millones de dólares al año.”
¿Parece poco probable? El web scraping para recopilar información como parte de operaciones de espionaje corporativo es una realidad, y hay equipos dedicados a impedirlo. El uso de API facilita aún más estas prácticas y agrava el problema, a veces en tiempo real. Por tanto, pensar que nadie va a introducir intencionadamente datos erróneos en tu flujo equivale a ignorar deliberadamente que los actores maliciosos suelen ir dos pasos por delante de nosotros.
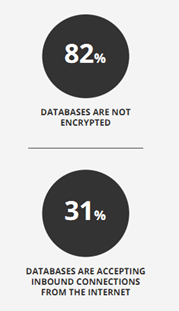
Nuestras prácticas de seguridad —especialmente en la nube, donde se espera que resida gran parte de los macrodatos— agravan esta amenaza. Un libro blanco de TDWI patrocinado por Information Builders ofrece muchos más ejemplos del coste de los datos sucios. Aunque la mayoría se refieren a problemas habituales de datos sucios derivados de la integración de datos a raíz de adquisiciones o a la típica información falseada por los clientes, los modelos de costes resultan muy valiosos para comprender la amenaza que supone para las empresas confiar en datos que pueden estar dañados y saber qué se puede hacer al respecto.
Confiar en las configuraciones predeterminadas ha sido la causa de múltiples brechas de seguridad solo en lo que va de año. ¿Recuerdas el desastre de MongoDB de enero? ¿Aquel en el que las configuraciones predeterminadas dejaron las bases de datos totalmente expuestas a cualquiera en Internet que pudiera estar interesado en ellas? ¿O qué me dices del estudio CSI de RedLock que encontró 285 instancias de consolas de administración de Kubernetes completamente abiertas? No se necesitaban credenciales. El mismo informe reveló que el 31 % de las bases de datos sin cifrar en la nube aceptaban conexiones entrantes desde Internet. Directamente. Es decir, sin nada entre tus datos y yo.
Cuando más de 27 000 bases de datos quedan expuestas y accesibles a través de Internet porque no se ha hecho el más mínimo esfuerzo por protegerlas, es fácil imaginar que los flujos de datos podrían contaminarse con facilidad. Cuando hay organizaciones que, deliberadamente, eliminan los controles de seguridad predeterminados de los servicios de almacenamiento en la nube para dejarlos totalmente expuestos a su detección y corrupción, la posibilidad de que agentes maliciosos introduzcan datos contaminados pasa de ser posible a probable. Las organizaciones que dependen de los datos —es decir, prácticamente todas hoy en día— tienen la responsabilidad de prestar atención no solo a cómo los protegen, sino también a cómo verifican su exactitud.
En el futuro de las empresas basadas en datos, la seguridad implica algo más que protegerse contra la exfiltración: también debe tener en cuenta la amenaza real de la infiltración y cómo combatirla.
Sobre el autor

Lori MacVittie es ingeniera distinguida y evangelista jefe en la Oficina del CTO de F5, y cuenta con una amplia experiencia en entrega de aplicaciones, estrategia de automatización e infraestructura. Es conocida por convertir la complejidad en claridad, ya sea definiendo mecanismos de protección para agentes de IA, analizando arquitecturas multinube frágiles o explorando los límites de los sistemas escalables. Aporta más de treinta años de experiencia en el sector en desarrollo de aplicaciones, arquitectura de TI y operaciones de redes y sistemas. Antes de incorporarse a F5, fue una galardonada editora de tecnología. MacVittie posee un máster en Informática y es una autora prolífica cuyas publicaciones abarcan la seguridad, la nube y la arquitectura empresarial. También es una apasionada de los juegos de mesa y los videojuegos, y expresa sin complejos sus firmes opiniones sobre el queso.
Más artículos de Lori Mac VittieArtículos relacionados del blog

Cree servicios públicos seguros, resilientes y preparados para la IA con F5 y AWS
Descubre cómo las organizaciones del sector público pueden modernizar de forma segura sus aplicaciones y soluciones de IA, al tiempo que gestionan los sistemas heredados, el cumplimiento normativo y el riesgo operativo.

Protección de los sistemas de IA: por qué la seguridad debe avanzar al ritmo de la innovación
Desde acelerar avances revolucionarios en medicina y educación hasta transformar la vida cotidiana, la IA está cambiando nuestra forma de vivir y trabajar. Pero también ofrece grandes oportunidades a los ciberdelincuentes.
Avanzar hacia la optimización digital tras la transformación
Descubre estrategias de optimización digital para garantizar políticas de seguridad coherentes, impulsar la madurez de la transformación digital y superar los retos de la transformación.
Proyecto de código abierto destacado: mayor observabilidad con F5 Cloud Logger iApp
En el punto de mira del código abierto: cómo aumentar la observabilidad. Lee el blog de F5 para descubrir cómo exportar fácilmente la telemetría de BIG-IP a plataformas modernas de análisis en la nube.
El estado de la entrega de aplicaciones en 2018: la transformación digital impulsa la automatización y la multinube pese a las preocupaciones de seguridad
Descubre las principales conclusiones del cuarto informe anual de F5 sobre el estado de la entrega de aplicaciones.
Estado de la entrega de aplicaciones en 2017: automatización, API y DevOps
Descubre el informe sobre el estado de la entrega de aplicaciones de 2017. Lee el blog retrospectivo de F5 sobre los inicios del auge de las redes declarativas y los flujos de DevOps.