Uno de los lemas de DevOps y la nube desde hace ya, en fin, muchos años ha sido «diseñar para fallar». La premisa es que demasiadas empresas sufren costosos periodos de inactividad y pérdidas de ingresos (y productividad) debido a problemas de rendimiento relacionados con la capacidad, por lo que conviene diseñar la aplicación y la infraestructura «para fallar» y así evitar que sucesos tan espantosos vuelvan para atormentarte. Je. ¿Has visto lo que he hecho ahí? Sí, trabajo en remoto, a solas en un despacho. A veces tengo que entretenerme de alguna manera.
Dejando a un lado los juegos de palabras malos, el reciente y extraordinario éxito de Pokémon Go (te habías enterado, ¿verdad?) también se tradujo en una experiencia tremendamente frustrante para muchos. Sobre todo para los padres con hijos entusiasmados hasta la médula que querían salir YA, pero no podían porque la creación de cuentas se suspendió temporalmente y después se limitó estrictamente debido a la abrumadora demanda.
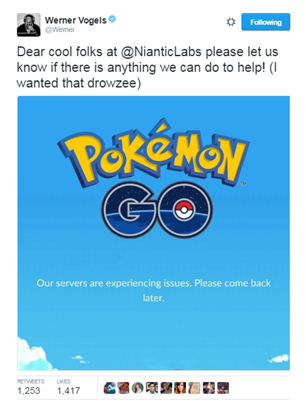
Ahora bien, algunos podrían señalar la oferta del director de tecnología de Amazon, Werner Vogels, para ayudar a la empresa a resolver sus problemas de capacidad como indicio de que, para empezar, no habían «migrado a la nube» y de que ese era el problema de fondo, pero eso presupone que no lo habían hecho, algo que a estas alturas no tengo del todo claro. En serio, según las actualizaciones de Wikipedia sobre el desarrollador de realidad aumentada, este procesa «más de 200 millones de acciones de juego al día mientras los usuarios interactúan con objetos reales y virtuales en el mundo físico». Creo que podemos ser un poco comprensivos con ellos en este caso, o al menos podemos serlo quienes entendemos lo que eso supone en términos de interacciones entre sistemas y transmisión de paquetes. Las actualizaciones apuntaban a «problemas con los servidores», pero, vamos, todos sabemos que «servidor» es la forma técnica de decir «15 componentes distintos repartidos entre la aplicación y la infraestructura de red».
En cualquier caso, la lección de fondo no es que la nube sea necesariamente mejor a la hora de afrontar un éxito inesperado. Puede que lo sea, pero no por el hecho de ser la nube. Es porque la nube no solo está diseñada para fallar sino también para escalar.
No estoy en condiciones de determinar por qué Niantic Labs no pudo hacer frente a la demanda. Quizá se debiera a una falta de capacidad, en cuyo caso la nube habría sido una buena opción, o quizá a que las aplicaciones o la infraestructura no estaban diseñadas para escalar, en cuyo caso la nube podría no haber servido de nada. La cuestión no es criticarles (je) por lo que hicieron o dejaron de hacer. La cuestión es que constituyen un ejemplo perfecto de una realidad: en un mundo dominado por las aplicaciones, las organizaciones deberían preocuparse tanto por diseñar sus sistemas para afrontar los fallos como por prepararlos para el éxito. Y no solo para un éxito gradual, sino para uno instantáneo, de la noche a la mañana, como el de Pokémon Go.
Porque, si ocurre, no querrás que ese fracaso exitoso quede expuesto por todo Internet.
Una fuente habitual de problemas de escalabilidad son las fuentes de datos. Los usuarios veteranos de Twitter recordarán que, en sus inicios, la red social sufrió numerosos problemas de escalabilidad de las bases de datos. PayPal fue una de las primeras empresas en defender abiertamente la fragmentación como estrategia de escalado para afrontar el reto que suponía su enorme número de usuarios, y esta técnica se ha adoptado como una solución general aplicable tanto a bases de datos como a servicios de rendimiento y aplicaciones por igual. El auge de las fuentes de datos NoSQL presenta como una de sus ventajas una mayor escalabilidad que la de las bases de datos relacionales tradicionales.
Otra fuente de problemas de escalabilidad recae exclusivamente en la infraestructura. El escalado automático en la nube depende de la capacidad no solo de añadir automáticamente más recursos informáticos, sino también de aumentar la capacidad del «punto de conexión de la aplicación». En cualquier arquitectura que recurra al escalado para aumentar la capacidad, esto implica utilizar algún tipo de servicio de equilibrio de carga. Cuando se incrementan los recursos informáticos, estos deben registrarse en el servicio de equilibrio de carga. Esto requiere el uso de API y scripts, así como de automatización y orquestación. Estos componentes deben estar implementados antes de que sean necesarios; de lo contrario, se producirán retrasos si la demanda exige aumentar la capacidad.
La inclusión de un servicio de equilibrio de carga en cualquier arquitectura de aplicaciones —en todas ellas— debería ser un requisito. Un servicio de equilibrio de carga no solo permite «diseñar para los fallos», gracias a su compatibilidad inherente con la conmutación por error entre dos instancias de una aplicación, sino que también permite «diseñar para escalar», algo imprescindible para alcanzar el éxito. Pero no piense que basta con colocar un servicio de equilibrio de carga delante de una aplicación (o de un microservicio, si es lo suyo). Es importante que el equipo de operaciones implante la automatización (scripts) y la orquestación (procesos) que permitirán que el escalado automático responda a esa demanda cuando llegue. Hoy en día, el escalado depende de la arquitectura, no de los algoritmos, y es importante tener en cuenta esa arquitectura desde el principio, antes de que la deuda arquitectónica sea tan restrictiva que no quede más remedio que conformarse con lo que se tiene.
Sinceramente, Niantic Labs hizo un buen trabajo diseñando su sistema para resistir fallos. Cuando se producían problemas de capacidad, aparecían mensajes amables en lugar de las páginas predeterminadas con códigos de estado HTTP que suelo encontrarme. Eran divertidos y fáciles de leer y entender para los niños (lo sé porque mi hijo de 8 años nos los leía cada 20 minutos). Lo que no habían previsto fue el éxito, quizá inesperado, que alcanzaron. Esto sirve para recordar a todo el mundo que diseñar un sistema para que pueda escalar es tan importante como diseñarlo para resistir fallos.
Porque, si no lo haces, gana el Team Rocket.
Sobre el autor

Lori MacVittie es ingeniera distinguida y evangelista jefe en la Oficina del CTO de F5, y cuenta con una amplia experiencia en entrega de aplicaciones, estrategia de automatización e infraestructura. Es conocida por convertir la complejidad en claridad, ya sea definiendo mecanismos de protección para agentes de IA, analizando arquitecturas multinube frágiles o explorando los límites de los sistemas escalables. Aporta más de treinta años de experiencia en el sector en desarrollo de aplicaciones, arquitectura de TI y operaciones de redes y sistemas. Antes de incorporarse a F5, fue una galardonada editora de tecnología. MacVittie posee un máster en Informática y es una autora prolífica cuyas publicaciones abarcan la seguridad, la nube y la arquitectura empresarial. También es una apasionada de los juegos de mesa y los videojuegos, y expresa sin complejos sus firmes opiniones sobre el queso.
Más artículos de Lori Mac VittieArtículos relacionados del blog

Cree servicios públicos seguros, resilientes y preparados para la IA con F5 y AWS
Descubre cómo las organizaciones del sector público pueden modernizar de forma segura sus aplicaciones y soluciones de IA, al tiempo que gestionan los sistemas heredados, el cumplimiento normativo y el riesgo operativo.

Protección de los sistemas de IA: por qué la seguridad debe avanzar al ritmo de la innovación
Desde acelerar avances revolucionarios en medicina y educación hasta transformar la vida cotidiana, la IA está cambiando nuestra forma de vivir y trabajar. Pero también ofrece grandes oportunidades a los ciberdelincuentes.
Avanzar hacia la optimización digital tras la transformación
Descubre estrategias de optimización digital para garantizar políticas de seguridad coherentes, impulsar la madurez de la transformación digital y superar los retos de la transformación.
Proyecto de código abierto destacado: mayor observabilidad con F5 Cloud Logger iApp
En el punto de mira del código abierto: cómo aumentar la observabilidad. Lee el blog de F5 para descubrir cómo exportar fácilmente la telemetría de BIG-IP a plataformas modernas de análisis en la nube.
El estado de la entrega de aplicaciones en 2018: la transformación digital impulsa la automatización y la multinube pese a las preocupaciones de seguridad
Descubre las principales conclusiones del cuarto informe anual de F5 sobre el estado de la entrega de aplicaciones.
Estado de la entrega de aplicaciones en 2017: automatización, API y DevOps
Descubre el informe sobre el estado de la entrega de aplicaciones de 2017. Lee el blog retrospectivo de F5 sobre los inicios del auge de las redes declarativas y los flujos de DevOps.