
A principios de este año, se pidió a nuestro equipo que reforzara nuestras herramientas de seguridad y prácticas de desarrollo y pruebas de software existentes para cumplir con PCI-DSS y SOC-2. Una de las áreas clave que tuvimos que reforzar fue el análisis de vulnerabilidades de nuestros microservicios basados en K8s y de un par de servicios monolíticos. Como resultado, nuestro equipo de DevOps tuvo que elegir entre varias herramientas comerciales y soluciones de código abierto para implementar el análisis de vulnerabilidades de nuestro software. Todas estas herramientas hacen cosas muy similares: analizan las dependencias (ya sean bibliotecas del proyecto o paquetes del sistema operativo) y las comparan con bases de datos de vulnerabilidades (como la NVD del NIST, entre otras).
¿Desarrollar o comprar?
Existen varias herramientas de código abierto que se pueden utilizar para crear una solución propia de análisis de vulnerabilidades. También puede optar por un producto comercial que incorpore funciones adicionales al análisis básico y le facilite el trabajo. Algunos ejemplos son:
- Paneles intuitivos para obtener una visión general rápida de las vulnerabilidades de tus proyectos
- Notificaciones (correo electrónico, Slack, etc.)
- Integración con repositorios Git (GitHub, GitLab)
- Integración con otros servicios (registro de Docker, Kubernetes)
- Integración con herramientas de gestión de proyectos (p. ej., Jira)
- Creación automática de solicitudes de fusión para corregir dependencias vulnerables
- Compatibilidad con equipos, proyectos y control de acceso basado en roles (RBAC)
La mayoría de las soluciones comerciales complementan las bases de datos públicas de vulnerabilidades con su propia base de datos para eliminar falsos positivos y negativos y ofrecer resultados más relevantes. Dicho esto, todas estas herramientas comerciales se vuelven realmente caras a medida que aumenta el número de desarrolladores. Por tanto, debes plantearte si te conviene más comprar una solución o crear la tuya propia utilizando herramientas de código abierto existentes.
Al principio, decidimos que una herramienta comercial sería la opción que mejor se adaptaría a nuestras necesidades, dado el poco tiempo del que disponíamos. Sin embargo, tras dedicar tres meses a implantar y probar un producto comercial líder del sector, nos encontramos con numerosos problemas: compatibilidad limitada con Golang, detección de dependencias incorrectas y cierres inesperados, problemas con los contenedores creados desde cero frente a los creados a partir de una imagen base, etc. Como resultado, decidimos descartarlo y desarrollar nuestra propia herramienta utilizando las tecnologías de código abierto disponibles.
En este artículo, voy a ofrecerte una base sólida desde la que empezar si optas por el código abierto. Además, al final encontrarás el enlace a nuestro repositorio de código abierto para que puedas ponerte manos a la obra.
¿Qué analizar?
Básicamente, hay dos cosas que conviene analizar en busca de vulnerabilidades:
- Las dependencias de código de tu proyecto (yarn.lock, Gopkg.lock, etc.)
- Dependencias del sistema operativo (paquetes de Debian, paquetes de Alpine, etc.) en una imagen de Docker
En el futuro, se podrían añadir más funcionalidades, como la comprobación de licencias o el análisis estático de código, pero eso queda fuera del alcance de este artículo.
¿Cuándo realizar el análisis?
En primer lugar, debes asegurarte de que los cambios en el código o en la imagen de Docker no introduzcan ninguna vulnerabilidad nueva, por lo que conviene analizar cada solicitud de fusión antes de fusionarla.
Pero también debes realizar análisis periódicamente, ya que pueden aparecer nuevas vulnerabilidades con el tiempo. Además, los niveles de gravedad pueden cambiar: una vulnerabilidad de gravedad baja que inicialmente ignoraste puede volverse crítica con el tiempo si se descubre un nuevo vector de ataque o exploit. Mientras que las herramientas comerciales recuerdan el último análisis y te avisan si se detecta una nueva vulnerabilidad, en nuestra solución de código abierto simplemente repetimos el análisis sobre la rama principal del proyecto.
Elegir herramientas
Hay muchas herramientas de código abierto disponibles, pero elegimos Trivy porque es fácil de usar, está en desarrollo activo y puede analizar varios proyectos y tipos de sistemas operativos.
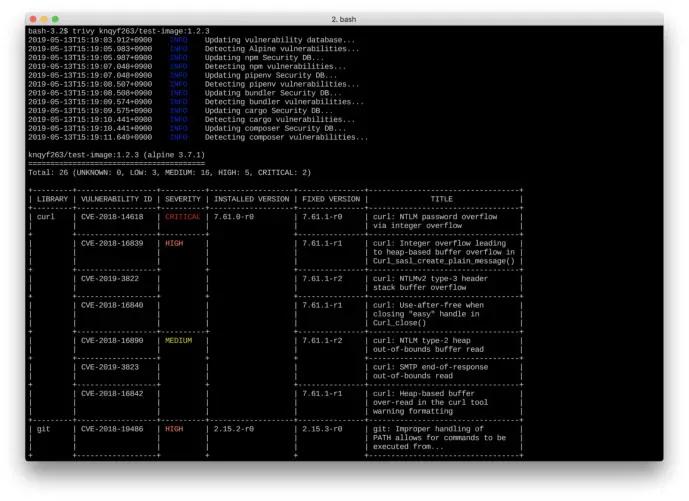
Trivy es un escáner de vulnerabilidades sencillo y completo para contenedores y otros artefactos. Una vulnerabilidad de software es un error, fallo o punto débil presente en el software o en un sistema operativo. Trivy detecta vulnerabilidades en paquetes del sistema operativo (Alpine, RHEL, CentOS, etc.) y en dependencias de aplicaciones (Bundler, Composer, npm, yarn, etc.). Trivy es fácil de usar: basta con instalar el archivo binario para empezar a escanear. Para realizar un análisis, solo hay que especificar un objetivo, como el nombre de la imagen del contenedor.
Se puede instalar fácilmente y ejecutar de forma local sobre la imagen de Docker generada o la raíz del proyecto. También admite varios formatos de salida, como JSON y tablas:
Lamentablemente, hay proyectos que Trivy no puede analizar (por ejemplo, los desarrollados en Go), por lo que tuvimos que recurrir a OWASP Dependency-Check ya que gran parte de nuestro código está escrito en Go.
Dependency-Check es una herramienta de análisis de composición de software (SCA) que intenta detectar vulnerabilidades divulgadas públicamente en las dependencias de un proyecto. Para ello, determina si existe un identificador de enumeración de plataforma común (CPE) para una dependencia determinada. Si lo encuentra, genera un informe con enlaces a las entradas CVE asociadas.
Puede generar páginas HTML con informes, así como resultados en formato JUnit y JSON (entre otros).
Informes y paneles
Ahora nos acercamos a cosas más interesantes 😊
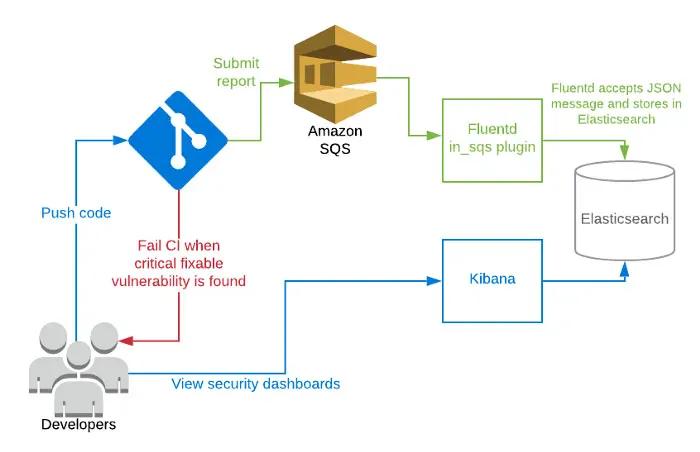
Como ya utilizamos Elasticsearch + Kibana + Fluentd en nuestros equipos de DevOps y SRE, resultaba lógico aprovechar la infraestructura existente para analizar la salida JSON de nuestros análisis de seguridad.
Solo necesitábamos encontrar una forma de enviar datos desde una infraestructura no fiable (ejecutores de CI) a nuestro Elasticsearch seguro. Para ello, decidimos intercalar una cola de mensajes. Fluentd cuenta con el complemento in_sqs para leer mensajes de Amazon SQS y, además, es fácil de usar, por lo que la arquitectura final queda así:
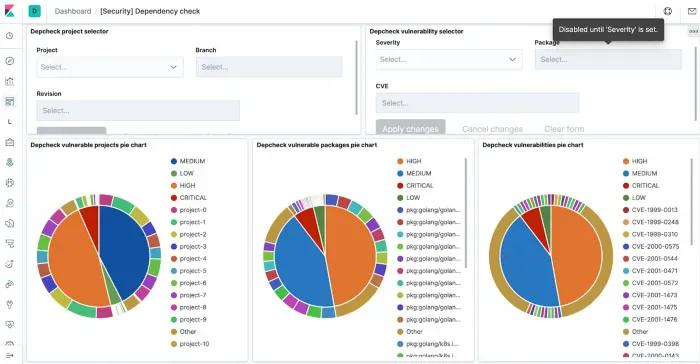
Una vez que los datos llegan a Elasticsearch, es fácil crear algunos paneles con Kibana o usar Discover para consultar las vulnerabilidades con todos los detalles necesarios.
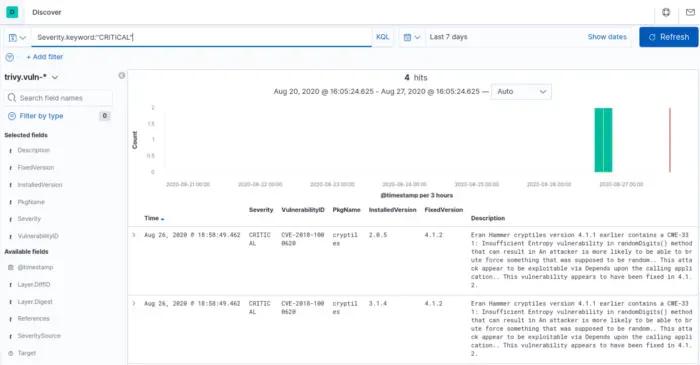
Corrección de vulnerabilidades
Ahora que ya tenemos los análisis y un buen panel de control, ¿cuál es el siguiente paso? No podemos esperar que los desarrolladores consulten estos paneles periódicamente. Por eso, decidimos hacer que la integración continua falle cuando se detecte un problema de gravedad alta o superior para el que haya una corrección disponible. De este modo, la responsabilidad recae en los desarrolladores y los responsables de los proyectos.
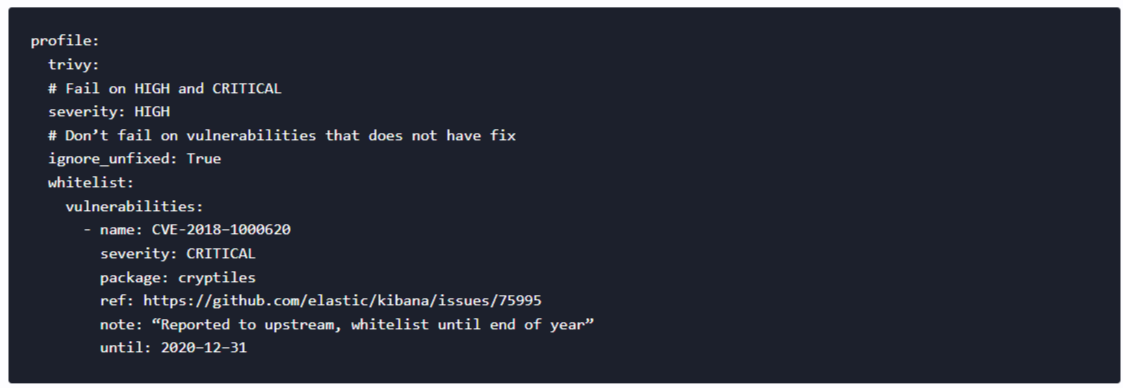
Naturalmente, necesitábamos disponer de una opción para incluir algunas CVE en una lista blanca o modificar este comportamiento predeterminado para cada proyecto. Por ello, creamos un repositorio con perfiles de análisis de seguridad que utiliza nuestra herramienta de análisis, la cual encapsula la ejecución de Trivy y gestiona su comportamiento y sus resultados.
Ahora cualquier desarrollador puede enviar una solicitud de fusión a este repositorio y pedir una excepción. Ejemplo de perfil para el proyecto kibana:
Mejoras futuras
Esta implementación del análisis de seguridad constituye una base sólida que puede ampliarse más allá de nuestros casos de uso iniciales. Por ejemplo:
- Añadir notificaciones de Slack y utilizar perfiles de seguridad para especificar el canal y las opciones de cada proyecto
- Añadir integración con GitLab Issues, Jira o cualquier otro sistema de gestión de incidencias
- Crear un servicio sencillo o un sidecar para analizar las imágenes desplegadas en el clúster de Kubernetes
Haz un fork y úsalo
Puedes encontrar el Dockerfile y las herramientas en nuestro repositorio público de GitLab: https://gitlab.com/volterra.io/security-scanning
Gracias a Jakub Pavlík.
Sobre los autores
Artículos relacionados del blog

Cree servicios públicos seguros, resilientes y preparados para la IA con F5 y AWS
Descubre cómo las organizaciones del sector público pueden modernizar de forma segura sus aplicaciones y soluciones de IA, al tiempo que gestionan los sistemas heredados, el cumplimiento normativo y el riesgo operativo.

Protección de los sistemas de IA: por qué la seguridad debe avanzar al ritmo de la innovación
Desde acelerar avances revolucionarios en medicina y educación hasta transformar la vida cotidiana, la IA está cambiando nuestra forma de vivir y trabajar. Pero también ofrece grandes oportunidades a los ciberdelincuentes.
Avanzar hacia la optimización digital tras la transformación
Descubre estrategias de optimización digital para garantizar políticas de seguridad coherentes, impulsar la madurez de la transformación digital y superar los retos de la transformación.
Proyecto de código abierto destacado: mayor observabilidad con F5 Cloud Logger iApp
En el punto de mira del código abierto: cómo aumentar la observabilidad. Lee el blog de F5 para descubrir cómo exportar fácilmente la telemetría de BIG-IP a plataformas modernas de análisis en la nube.
El estado de la entrega de aplicaciones en 2018: la transformación digital impulsa la automatización y la multinube pese a las preocupaciones de seguridad
Descubre las principales conclusiones del cuarto informe anual de F5 sobre el estado de la entrega de aplicaciones.
Estado de la entrega de aplicaciones en 2017: automatización, API y DevOps
Descubre el informe sobre el estado de la entrega de aplicaciones de 2017. Lee el blog retrospectivo de F5 sobre los inicios del auge de las redes declarativas y los flujos de DevOps.