
Antecedentes
En dos artículos anteriores nos hemos centrado en las consideraciones relativas al diseño basado en datos y, en concreto, en cómo los datos empresariales representan un valor empresarial latente. El mensaje principal ha sido que una arquitectura de datos estructurada constituye la base técnica que permite extraer ese valor inherente. Sin embargo, esos artículos se centraban en presentar los temas pertinentes desde un punto de vista conceptual. Hoy me gustaría mostrar estos conceptos en el contexto de un ejemplo más tangible y cercano: una historia sobre cómo se podría plantear la arquitectura de una aplicación de acuerdo con una mentalidad que prioriza los datos.
Pero antes, ¿por qué debería importarme?
Sin embargo, antes de entrar de lleno en la historia, repasemos por qué los datos son hoy más importantes que en el pasado. Históricamente, muchas empresas han recopilado y almacenado datos principalmente como un fin en sí mismo y por motivos de gobernanza, como las auditorías y el cumplimiento normativo. Por ello, la recopilación y el almacenamiento de datos se han considerado tradicionalmente una especie de «impuesto» sobre las operaciones empresariales, al que se atribuía poco valor operativo directo para el negocio.
Lo que ha cambiado ahora es que se comprende mejor que los datos recopilados pueden analizarse para optimizar los procesos empresariales y mejorar la experiencia del cliente. Por ejemplo, según una encuesta reciente realizada a empresas de comercio minorista digital, estos dos objetivos —mejorar los procesos empresariales y la experiencia del cliente— fueron los principales impulsores de la transformación digital para el 57 % de todas las empresas encuestadas. La observación clave, la esencia de «por qué es importante», es que los flujos de trabajo basados en datos repercuten en la empresa tanto en los ámbitos externos (como la experiencia del cliente) como en los internos, es decir, en los procesos empresariales fundamentales. Por eso, una estrategia de datos meditada y deliberada es esencial para garantizar la calidad y la rentabilidad de los flujos de trabajo empresariales más importantes. Además, cuando los flujos de trabajo se instrumentan para transmitir los datos residuales observados a una infraestructura de recopilación y análisis de datos, pueden analizarse y mejorarse continuamente, lo que da lugar a flujos de trabajo empresariales en constante adaptación y optimización.
Como apunte, la mayor preocupación de estas empresas en torno a la transformación digital era garantizar la ciberseguridad de esos mismos procesos digitales, que, como resulta evidente, es otro ámbito en el que este enfoque basado en la telemetría y el análisis de datos desempeña un papel fundamental, aunque dejaré ese tema para otro artículo.
La aplicación: pedidos y entrega a domicilio en restaurantes
Continuando con nuestro experimento mental, he elegido una situación con la que probablemente muchos podamos identificarnos en el estilo de vida actual, adaptado al coronavirus: una aplicación que ofrece un servicio en línea para pedir comida a restaurantes y recibirla a domicilio. Los platos se piden por internet a un restaurante elegido por el cliente, y el usuario puede optar por recoger el pedido personalmente o solicitar que el servicio se encargue también de la entrega.
En esta historia, asumiremos el papel de propietario de la aplicación. En ese rol, debemos abordar muchas cuestiones diferentes, que dividiremos en dos categorías: en primer lugar, las actividades operativas necesarias y, en segundo lugar, las cuestiones estratégicas de cara al futuro.
El primer grupo —las actividades operativas obligatorias— incluye aspectos como los siguientes:
- Localizar y describir restaurantes, incluida su ubicación y horario de apertura
- Recopilación de datos sobre los platos del menú y sus precios
- Informar a los restaurantes de los pedidos
- Procesamiento de pagos
- Mantener datos sobre la disponibilidad de recursos humanos para recoger y entregar pedidos
- Seguimiento del estado de preparación y entrega de los pedidos
El segundo conjunto de cuestiones está menos relacionado con las operaciones cotidianas, pero no por ello es menos importante. Si se tienen en cuenta desde el principio, estas cuestiones permitirán que la empresa sea ágil, se adapte y mejore continuamente. Algunos ejemplos de este tipo de cuestiones son:
- ¿Cómo se puede prever la demanda? Podría tratarse simplemente de la demanda agregada por franja horaria o día de la semana, o podría desglosarse con mayor detalle, por ejemplo, por restaurante.
- ¿Qué tipo de herramientas, procesos o flujos de trabajo proporcionan información empresarial útil a mis proveedores (restaurantes)?
- ¿Cómo se pueden ajustar dinámicamente los precios, ya sean los de la comida o los de la entrega?
- Suponiendo que mi aplicación esté alojada en la nube pública, ¿cómo puedo optimizar los costes operativos de mi infraestructura?
Este es, por supuesto, un subconjunto de todas las cuestiones que tendríamos que considerar, pero incluso este conjunto más reducido basta para propiciar un buen debate que ponga de relieve la importancia de una arquitectura de datos estructurada como base de una canalización de procesamiento de datos extensible.
Arquitectura de datos o canalización de datos: ¿el huevo o la gallina?
En nuestro papel hipotético de responsables de una aplicación, al plantearnos nuestra estrategia global de datos, podemos empezar por enumerar nuestros flujos de trabajo empresariales e identificar las necesidades de procesamiento de datos de cada uno. Un ejemplo sería el flujo de trabajo que localiza restaurantes cercanos abiertos y, a continuación, muestra las opciones del menú y los precios de los artículos de cada uno; para ello, tendría que filtrar los restaurantes por ubicación y horario de apertura y, después, consultar las opciones del menú de un restaurante concreto, quizá filtrándolas también según la disponibilidad de los repartidores. Podríamos hacer lo mismo con cada flujo de trabajo: procesamiento de pagos, asignación de repartidores a entregas, etc.
O, de forma igualmente razonable, podríamos comenzar nuestras consideraciones por los «átomos» de datos básicos, es decir, los componentes fundamentales de datos que se necesitan. Identificaríamos y enumeraríamos los átomos de datos importantes, prestando especial atención a que tuvieran una representación uniforme y una semántica coherente, junto con cualquier vocabulario de metadatos necesario para respaldar nuestros flujos de trabajo empresariales. Algunos ejemplos de átomos de datos en nuestra aplicación de ejemplo serían: datos de ubicación de restaurantes, clientes y repartidores; productos alimenticios necesarios para menús y facturas; tiempo, utilizado para filtrar y hacer un seguimiento de la calidad de las entregas; e información de pago, asociada a los flujos de trabajo de pagos de clientes y repartidores.
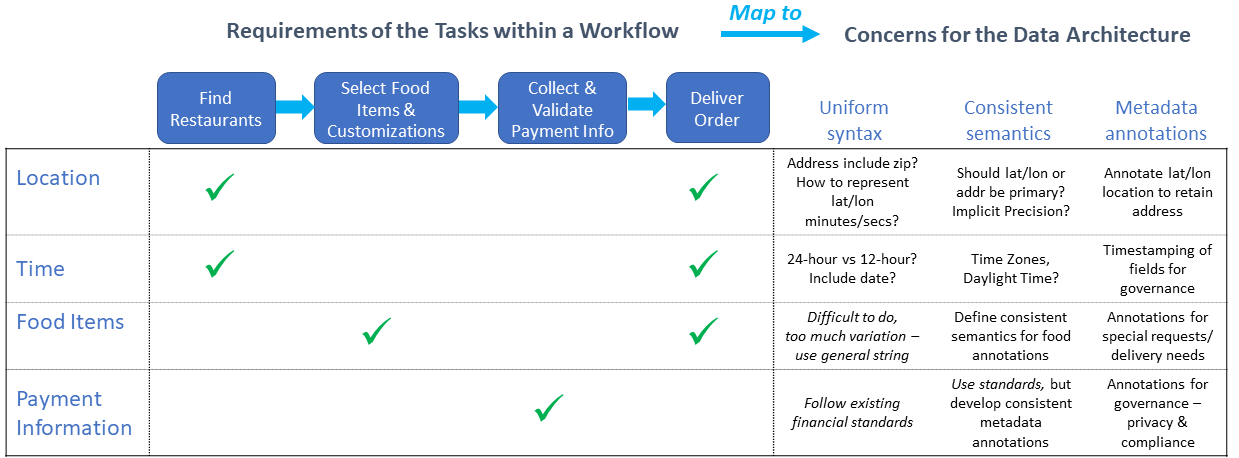
Elegir cuál de estos dos posibles puntos de partida —la canalización de procesamiento de datos de los flujos de trabajo o, alternativamente, los «átomos» de datos— utilizar para nuestra estrategia de datos es el clásico dilema del huevo o la gallina. Ambas perspectivas son útiles y, lo que es más importante, interdependientes. No podemos razonar sobre la canalización de procesamiento de datos sin tener en cuenta los átomos de datos subyacentes, ni podemos desarrollar la arquitectura de datos sin considerar las necesidades de la canalización de procesamiento. Dicho esto, en general recomendaría un enfoque en el que primero se revisen los flujos de trabajo para enumerar los átomos de datos y, a continuación, se aborde el diseño estructurado de la arquitectura de datos antes de acometer el diseño detallado de la canalización de datos. Esto se debe a que los flujos de trabajo son más dinámicos: se añaden y modifican a medida que evoluciona la empresa, mientras que los datos subyacentes tienen más historia e inercia y, por tanto, la arquitectura de datos se beneficia más de una planificación previa.
Aplicación de un enfoque integral de arquitectura y canalización de datos a ejemplos concretos
Volviendo a nuestro ejemplo, supongamos que, como responsable de la aplicación, tenemos una visión bastante desarrollada de los principales flujos de trabajo críticos para el negocio y de los átomos de datos necesarios para sustentarlos. Anteriormente, en este análisis, habíamos identificado algunos de los elementos de datos fundamentales necesarios para nuestros flujos de trabajo: ubicación, hora, productos alimenticios e información de pago. Y, a modo de recapitulación de artículos anteriores, la arquitectura de datos debe permitir alcanzar tres objetivos clave: uniformidad sintáctica, coherencia semántica y un vocabulario de metadatos que permita razonar sobre los datos y gobernarlos. Ahora podemos aplicar estos principios para analizar las consideraciones relativas a la arquitectura de datos de los átomos de datos específicos enumerados en el ejemplo de hoy.
Si nos centramos en el átomo de datos de ubicación, debemos considerar cada uno de los tres objetivos clave de la arquitectura de datos.
- En primer lugar, ¿cuál es la sintaxis uniforme de representación de datos?
En un principio, podría pensarse en representar la ubicación mediante una dirección postal, ya que así es como los restaurantes y los clientes suelen indicar su ubicación. Sin embargo, hay que tener en cuenta las necesidades de ubicación para hacer el seguimiento de los repartidores: suelen estar en movimiento, quizá en una autopista principal o en un lugar que no se describe bien mediante una dirección postal. En su lugar, especificar la latitud y la longitud puede ser una forma más adecuada de representar la ubicación para ese flujo de trabajo, y este formato también serviría para las ubicaciones de restaurantes y clientes. No obstante, dado que los repartidores normalmente deben desplazarse hasta un restaurante o la ubicación de un cliente, debe seguir existiendo una forma de relacionar la ubicación (latitud/longitud) de un repartidor con la ubicación (dirección postal) de un cliente. Por tanto, una opción más meditada podría ser normalizar todos los datos de ubicación como latitud y longitud (la representación «canónica» requerida), pero permitiendo convertir las direcciones postales en latitud/longitud cuando se proporcionen por primera vez (un flujo de trabajo de «ingesta»). - La segunda consideración es la de una semántica coherente.
Suponiendo que la ubicación se normalice como latitud/longitud, esto resulta relativamente sencillo, ya que se trata de un estándar consolidado cuya interpretación no presenta ambigüedades. Sin embargo, otro aspecto de la coherencia semántica es la precisión, es decir, el grado de exactitud implícito de los datos. Dado que los datos de GPS y cartografía tienen una exactitud intrínsecamente limitada, podemos optar por especificar la ubicación con una precisión constante (por ejemplo, redondeando al segundo de arco más cercano, aproximadamente 100 pies) o con una precisión variable, en función de la calidad de la fuente de datos. Si optamos por esta última alternativa para disponer de mayor flexibilidad, debemos indicar —mediante metadatos, que se describen a continuación— la precisión de cada instancia de datos de ubicación. - El tercer objetivo de la arquitectura de datos es ofrecer la capacidad de anotar y enriquecer los elementos de datos recopilados.
En el caso de la ubicación, esto puede incluir la precisión de los datos, como se ha mencionado anteriormente. Además, también puede ser conveniente anotar la ubicación con una dirección postal para facilitar su comprensión y, sobre todo, para poder conservar los datos de direcciones importados. Esto es especialmente importante cuando varias direcciones postales pueden corresponder a la misma latitud/longitud, como ocurre en un complejo de apartamentos. Otro posible enriquecimiento sería añadir una marca de tiempo que indique cuándo se recopiló el campo de datos de ubicación, lo que puede ser relevante para un conductor en movimiento, ya que estos datos quedan obsoletos rápidamente.
Hasta ahora solo hemos hablado de los requisitos relativos a la ubicación y ahora podríamos realizar un ejercicio similar para cada uno de los demás campos de datos. Sin embargo, en lugar de enumerar todos los aspectos que deben tenerse en cuenta para cada uno de los elementos de datos, destacaré algunas observaciones relevantes:
- En cuanto al elemento de datos Tiempo: La representación de un valor temporal es especialmente compleja. Puede variar tanto sintácticamente (p. ej., formato de 24 horas frente al de 12 horas con a. m./p. m.) como semánticamente (p. ej., el concepto de zonas horarias y las diferencias en la aplicación del horario de verano). Por tanto, probablemente será necesario normalizar la representación del tiempo (por ejemplo, convirtiéndola a GMT o, para los usuarios de Unix/Linux, a segundos «desde la época Unix»).
- Producto alimenticio puede presentar instancias muy diversas, cada una con necesidades específicas. Dado que estos átomos de datos suelen tener un formato libre, resulta más útil contar con un vocabulario de metadatos canónico que intentar imponer una sintaxis uniforme. Algunos campos de metadatos corresponderían a propiedades estáticas de cada producto, como «debe mantenerse frío» o «contiene frutos secos», mientras que otros serían necesarios para incluir información específica de cada instancia (cada pedido), como el «nivel de picante» o los «condimentos preferidos». En ambos casos, el objetivo del diseño exige una sintaxis uniforme y una semántica coherente para los campos de metadatos, de modo que puedan compartirse en todo el inventario de productos del menú.
- Otras consideraciones clave son el cumplimiento normativo y la gobernanza de los datos. Uno de los aspectos es la política de conservación de datos, según la cual algunos campos —como la dirección IP de un cliente o el historial de ubicaciones de un repartidor— solo pueden conservarse durante un breve periodo de tiempo. Otra consideración habitual es que algunos campos pueden estar sujetos a restricciones de seguridad o privacidad; un ejemplo es la información de pago. La incorporación de metadatos es una solución para ambos casos. Los metadatos deben utilizarse para anotar una dirección IP o un valor de ubicación con una fecha de caducidad a efectos de conservación de datos. En el caso de la información de pago, los metadatos pueden utilizarse para transmitir requisitos de seguridad, como la necesidad de cifrar los datos en reposo o de especificar restricciones de geolocalización para el almacén de datos persistente.
Aunque este ejemplo apenas ha arañado la superficie, ha puesto de relieve muchas de las cuestiones asociadas a situaciones reales. Sin embargo, en el mundo real, el proceso de reflexión sobre la estrategia de datos no terminaría aquí, sino que sería iterativo y continuo. A medida que los elementos de datos se incorporasen a los canales de procesamiento de datos que materializan los flujos de trabajo empresariales, se realizarían ajustes y mejoras iterativos en la arquitectura de datos. Conforme se mejorasen los flujos de trabajo existentes y se añadiesen otros nuevos, descubriríamos requisitos adicionales de arquitectura de datos para los átomos de datos existentes, así como nuevos átomos de datos.
Reflexiones finales
Aunque este ejemplo se ha simplificado para mayor brevedad, sigue ilustrando los principios clave para relacionar los flujos de trabajo con sus implicaciones en la arquitectura de datos. El proceso siempre comienza teniendo en cuenta las necesidades empresariales: la experiencia del cliente y los procesos empresariales necesarios para satisfacer dichas necesidades. A su vez, los procesos empresariales definen los elementos de un vocabulario empresarial. En el siguiente nivel de detalle, los procesos se corresponden con una canalización de datos que utiliza un vocabulario de datos.
El principio clave es que una arquitectura de datos sólida —que defina la sintaxis, la semántica y las anotaciones— sienta las bases para mejorar de forma eficiente el flujo de datos e incorporar fácilmente nuevos flujos de trabajo. En la capa de abstracción empresarial, esto significa que los procesos de negocio existentes pueden modificarse con facilidad y que los procesos nuevos o emergentes pueden ponerse en marcha rápidamente. Por el contrario, no tomar decisiones meditadas en cualquiera de estos ámbitos —el vocabulario de datos, el marco de la arquitectura de datos o su vinculación con las necesidades empresariales— acabará dando lugar a un sistema quebradizo y frágil, incapaz de adaptarse con agilidad a los nuevos requisitos empresariales.
Sobre el autor
Artículos relacionados del blog

Proteger los endpoints de las API dificulta la seguridad de las API
Descubre las complejidades de la seguridad de las API, los retos a los que se enfrentan las organizaciones, la evolución de los ataques contra endpoints de API y la necesidad de políticas de seguridad adaptadas.
¿Qué es el sesgo de la IA y por qué es importante para TI?
Descubre los fundamentos del aprendizaje de la IA. Aprende cómo pueden surgir sesgos en la IA y qué riesgos plantean para las TI y la transformación digital.
Redefiniendo la ciberseguridad en el extremo de la nube distribuida con IA y telemetría en tiempo real
La transformación digital y la adopción de tecnologías en la nube están provocando cambios en las arquitecturas de las aplicaciones. Estos cambios introducen nuevas superficies de ataque, que son el objetivo de métodos de ataque avanzados, altamente organizados y con motivaciones económicas. Mediante el uso del framework Morpheus de NVIDIA, F5 está investigando técnicas para detectar estas amenazas avanzadas con telemetría en tiempo real y análisis basados en IA.
El papel de la nube en las aplicaciones nativas del edge
No debería sorprender que, al igual que la aparición de la nube dio lugar a las aplicaciones nativas de la nube, el edge esté impulsando un conjunto de aplicaciones nativas del edge. Sin embargo, estas aplicaciones no residirán únicamente en el edge. Al mismo tiempo, están surgiendo nuevos patrones arquitectónicos que aprovechan las aplicaciones alojadas en la nube y en el centro de datos.
La creciente diversidad de ubicaciones y usuarios está impulsando a las empresas hacia el edge
En el contexto del ámbito de las aplicaciones, el término «usuario» siempre se ha referido a la entidad que interactúa con una aplicación. Del mismo modo que los cambios en las arquitecturas de las aplicaciones impulsan cambios en las tecnologías que permiten ofrecerlas y protegerlas, los cambios en la definición de usuario han provocado cambios en los lugares donde se despliegan las aplicaciones.
El edge está impulsando un renacimiento de las infraestructuras
A medida que las organizaciones aumentan la generación de datos y tratan de extraer valor empresarial de ellos, sin duda recurrirán a la analítica y la automatización basadas en la IA y el aprendizaje automático. Precisamente este tipo de cargas de trabajo son las que más se beneficiarían de una infraestructura optimizada y, sin embargo, hoy en día son las que menos probabilidades tienen de poder aprovecharla.