
La enorme complejidad de la distribución de aplicaciones modernas no tiene nada que ver con la de hace una década. Antes confiábamos en estrategias estáticas de balanceo de carga que distribuían flujos de tráfico predecibles entre un puñado de servidores. Hoy nos enfrentamos a entornos multinube dinámicos, microservicios que se ponen en marcha o se detienen sobre la marcha y bases de usuarios que pueden pasar de mil a un millón de la noche a la mañana. El balanceo de carga tradicional basado en reglas no siempre puede seguir el ritmo.
Ahí es donde entra en juego el aprendizaje por refuerzo (RL). Al observar continuamente su entorno y tomar decisiones que maximizan el rendimiento general, un agente de RL tiene el potencial de adaptarse a los cambios en tiempo real mejor que cualquier script preprogramado. Es la diferencia entre seguir una receta al pie de la letra y cocinar por intuición: un enfoque se adapta a condiciones conocidas, mientras que el otro evoluciona dinámicamente según la situación.
Tesis: A medida que las infraestructuras de las aplicaciones se vuelven cada vez más complejas, debemos pasar de un balanceo de carga estático o basado en heurísticas a sistemas adaptativos impulsados por el aprendizaje por refuerzo para mantener la resiliencia, optimizar el rendimiento y preparar nuestras redes para el futuro.
No falta expectación en torno a la IA, pero el aprendizaje por refuerzo es uno de los ámbitos en los que tanto la investigación académica como las pruebas piloto en entornos reales están empezando a mostrar resultados prometedores y tangibles. No hablamos de una posibilidad lejana; las técnicas de aprendizaje por refuerzo ya están dando resultados positivos en entornos de simulación y en determinados entornos de producción.
Introducción al aprendizaje por refuerzo: por qué tiene sentido
Antes de profundizar, aclaremos qué es el aprendizaje por refuerzo (RL) en términos más sencillos. Imaginemos un agente —el «cerebro» del sistema— encargado de recopilar datos, tomar decisiones y adaptar su estrategia a medida que cambian las condiciones. Este agente se sitúa en un entorno dinámico (como un sistema multinube), donde recibe una «recompensa» cuando obtiene resultados satisfactorios, como reducir la latencia o aumentar el rendimiento. Con el tiempo, perfecciona su estrategia para obtener recompensas mayores con más frecuencia.
- Adaptativo y continuo: A diferencia de un algoritmo estático sujeto a un conjunto específico de reglas, el aprendizaje por refuerzo sigue aprendiendo de los nuevos patrones de tráfico.
- Lógica escalable: Los marcos de aprendizaje por refuerzo pueden coordinar miles de variables —como el uso de la CPU, el consumo de memoria o la disponibilidad de los nodos— y optimizarlas simultáneamente.
- Resistente a cambios bruscos: Los cambios repentinos, como un aumento del tráfico de comercio electrónico durante la temporada navideña, pueden corregirse automáticamente sin esperar a que una persona ajuste los umbrales.
Controversia: ¿Es excesivo usar aprendizaje por refuerzo?
Algunos ingenieros han descartado el aprendizaje por refuerzo por considerarlo una solución excesivamente compleja. «¿Por qué arreglar lo que no está roto?» es una pregunta habitual. Pues bien, en F5 hemos observado nuevos escenarios de clientes —como microservicios distribuidos globalmente o implementaciones perimetrales multiinquilino— en los que las reglas estáticas no solo resultan poco óptimas, sino que en ocasiones son peligrosas. Una política que era perfecta el trimestre pasado podría fallar estrepitosamente en nuevas condiciones. La capacidad del aprendizaje por refuerzo para adaptarse en situaciones de incertidumbre puede ser crucial en estos escenarios.
Dentro de F5: un vistazo a experimentos reales
En F5, hemos llevado a cabo experimentos de RL a pequeña escala en entornos de simulación basados en el tráfico real de los clientes. Este es un ejemplo:
- La configuración: Creamos un escenario sintético de «maratón de compras»: imaginemos grandes eventos comerciales que comienzan simultáneamente en distintos continentes. El tráfico aumentaba de forma impredecible, con picos de consultas que consumían mucha memoria a horas intempestivas.
- El agente de aprendizaje por refuerzo: Implementado en un entorno de contenedores, el agente de aprendizaje por refuerzo ajustaba qué microservicios poner en marcha en función de los patrones de uso. Aprendió a dirigir las tareas con un uso intensivo de la CPU a nodos con hardware especializado, mientras trasladaba los procesos menos exigentes a instancias más económicas en la nube.
- Los resultados: En comparación con un enfoque clásico de asignación por turnos con cierto escalado automático, el método basado en aprendizaje por refuerzo redujo los tiempos medios de respuesta entre un 12 % y un 15 %. Además, mantuvo las tasas de error más estables durante los picos extremos de tráfico.
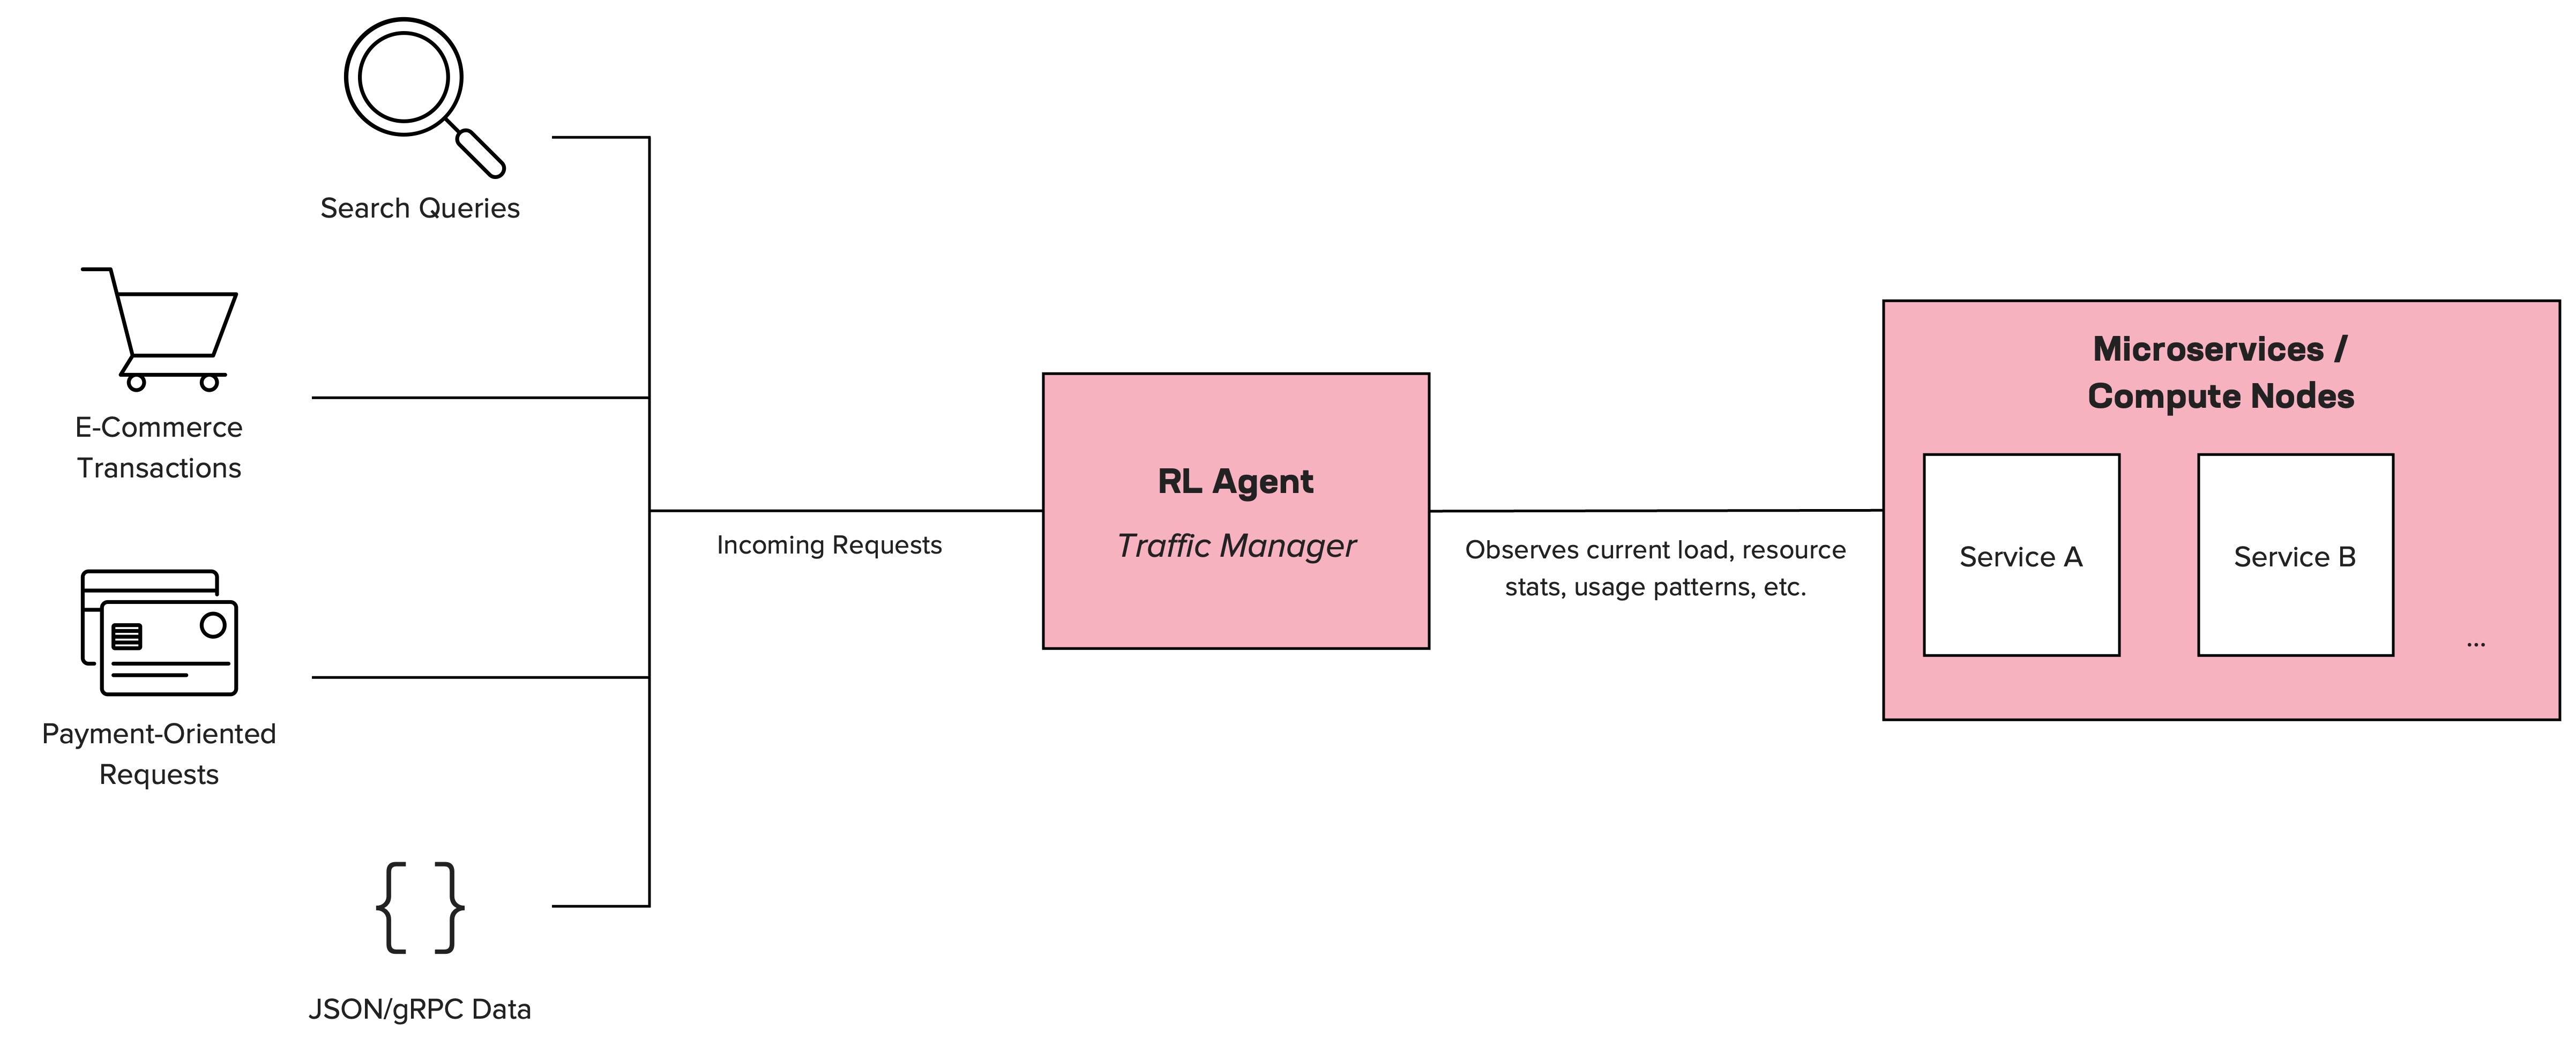
Este diagrama conceptual muestra cómo el agente de aprendizaje por refuerzo sustituye a un equilibrador de carga típico (o funciona junto a él).
- Solicitudes entrantes: Los usuarios o las aplicaciones cliente envían solicitudes.
- Agente de RL: Actúa como el cerebro de la gestión del tráfico. Supervisa métricas en tiempo real (uso de la CPU, memoria y tasas de error) y toma decisiones de enrutamiento o escalado.
- Microservicios / Nodos: El agente de aprendizaje por refuerzo pone en marcha los microservicios adecuados o dirige el tráfico a nodos específicos en función de los resultados del aprendizaje.
Este ejemplo muestra el potencial del aprendizaje por refuerzo para superar al balanceo de carga tradicional en muchos escenarios.
Posibles escollos: no te creas todo lo que dicen todavía
Por supuesto, el aprendizaje por refuerzo (RL) no es una solución milagrosa. Los tiempos de entrenamiento pueden ser largos, y tuvimos que invertir en una supervisión sólida para asegurarnos de que el agente de RL no «manipulara» la señal de recompensa tomando decisiones a corto plazo que perjudicaran el resultado global. Aun así, cuando funciona, el RL puede superar claramente a las heurísticas tradicionales. Estas son otras consideraciones que conviene tener en cuenta:
1. Complejidad frente a fiabilidad
- Problema: El aprendizaje por refuerzo introduce una nueva capa de complejidad en sistemas que ya son complejos. Si no se gestiona con cuidado, un agente puede quedar atrapado en óptimos locales o perseguir objetivos contrapuestos (rendimiento frente a coste frente a latencia).
- Mitigación: Enfoques híbridos en los que el aprendizaje por refuerzo se encarga de las decisiones de alto nivel, mientras que heurísticas de eficacia probada actúan como mecanismos de seguridad.
2. Calidad de los datos y diseño de recompensas
- Problema: El aprendizaje por refuerzo depende de las señales de recompensa. Si las métricas no son adecuadas o se incentiva un comportamiento equivocado, el agente puede aprovechar peculiaridades del entorno que no se traducen en un valor empresarial real.
- Mitigación: Invierta en una supervisión sólida, en el diseño de métricas y en pruebas exhaustivas sin conexión.
3. Consideraciones éticas y normativas
- Problema: Si un agente de aprendizaje por refuerzo discrimina involuntariamente determinadas regiones o patrones de uso para reducir costes, podría traspasar límites éticos o legales.
- Mitigación: Los equipos de implementación deben definir de antemano las acciones permitidas y auditar periódicamente las decisiones basadas en aprendizaje automático.
Tendencias generales de adopción en el sector en 2025
Más allá de nuestros experimentos internos, el aprendizaje por refuerzo está generando un gran interés en el sector. Algunos aspectos destacados:
- Artículos de congresos: Prestigiosos eventos de IA, como NeurIPS ‘24, dedican secciones enteras al aprendizaje por refuerzo distribuido para la optimización de redes.
- Proveedores de servicios en la nube: Los principales proveedores de servicios en la nube ofrecen ahora herramientas especializadas para el escalado automático y el enrutamiento del tráfico basados en aprendizaje por refuerzo, lo que reduce la brecha entre la investigación académica y las herramientas prácticas.
- Implementaciones en el borde: Con la aparición del 5G y las redes en el borde, existe una necesidad urgente de coordinar los recursos entre numerosos centros de datos pequeños. La capacidad de adaptación del aprendizaje por refuerzo resulta idónea para estas arquitecturas dinámicas y distribuidas geográficamente.
Aun así, la adopción empresarial del aprendizaje por refuerzo (RL) para la gestión del tráfico se encuentra todavía en una fase inicial. Muchas empresas siguen mostrándose reticentes debido a la preocupación por su imprevisibilidad o a las dificultades para explicar las decisiones del RL a los equipos de cumplimiento normativo o a los organismos reguladores. Esto pone de relieve la importancia de la IA explicable (XAI)—un área de investigación activa cuyo objetivo es esclarecer cómo llegan los modelos de aprendizaje automático a sus decisiones.
Una visión para 2030
En mi opinión, en los próximos cinco años la gestión del tráfico basada en el aprendizaje por refuerzo (RL) pasará de las pruebas en ámbitos específicos a una adopción más generalizada entre las empresas con visión de futuro. Para 2030, predigo que:
- Orquestación dinámica multicloud: El aprendizaje por refuerzo se convertirá en la norma para orquestar cargas de trabajo en múltiples nubes públicas y privadas, optimizando los costes y el rendimiento de forma mucho más eficiente que los ajustes manuales actuales.
- Mayor integración con la observabilidad de la IA: Las herramientas que registran, visualizan e interpretan de forma fluida las decisiones de los agentes de aprendizaje por refuerzo mitigarán las preocupaciones sobre el cumplimiento normativo y simplificarán la depuración.
- Agentes colaborativos: Veremos a varios agentes de aprendizaje por refuerzo trabajando juntos en un único entorno, cada uno con tareas especializadas, como un equipo de expertos: algunos se encargarán de la asignación de recursos y otros se centrarán en la seguridad o en las restricciones de calidad del servicio.
Aunque algunos escépticos dudan de que el aprendizaje por refuerzo (RL) cumpla estas promesas, considero que ofrece una vía muy prometedora para superar los inevitables retos que traerá consigo el aumento de la complejidad. Según mi experiencia, esta tecnología ya está cobrando impulso, y confío en que seguirá dando forma al futuro de la gestión del tráfico a medida que las empresas busquen soluciones más adaptativas e inteligentes.
Tus próximos pasos
Entonces, ¿ha llegado el momento de deshacerse de sus equilibradores de carga de toda la vida? Todavía no, pero sin duda es hora de empezar a experimentar con enfoques basados en el aprendizaje por refuerzo (RL), si aún no lo ha hecho. Pruébelos en entornos de menor riesgo, mida las mejoras de rendimiento y colabore con equipos multidisciplinares. Así podrá elaborar una hoja de ruta práctica que equilibre el potencial del RL con las limitaciones del mundo real.
Sobre el autor
Artículos relacionados del blog

Proteger los endpoints de las API dificulta la seguridad de las API
Descubre las complejidades de la seguridad de las API, los retos a los que se enfrentan las organizaciones, la evolución de los ataques contra endpoints de API y la necesidad de políticas de seguridad adaptadas.
¿Qué es el sesgo de la IA y por qué es importante para TI?
Descubre los fundamentos del aprendizaje de la IA. Aprende cómo pueden surgir sesgos en la IA y qué riesgos plantean para las TI y la transformación digital.
Redefiniendo la ciberseguridad en el extremo de la nube distribuida con IA y telemetría en tiempo real
La transformación digital y la adopción de tecnologías en la nube están provocando cambios en las arquitecturas de las aplicaciones. Estos cambios introducen nuevas superficies de ataque, que son el objetivo de métodos de ataque avanzados, altamente organizados y con motivaciones económicas. Mediante el uso del framework Morpheus de NVIDIA, F5 está investigando técnicas para detectar estas amenazas avanzadas con telemetría en tiempo real y análisis basados en IA.
El papel de la nube en las aplicaciones nativas del edge
No debería sorprender que, al igual que la aparición de la nube dio lugar a las aplicaciones nativas de la nube, el edge esté impulsando un conjunto de aplicaciones nativas del edge. Sin embargo, estas aplicaciones no residirán únicamente en el edge. Al mismo tiempo, están surgiendo nuevos patrones arquitectónicos que aprovechan las aplicaciones alojadas en la nube y en el centro de datos.
La creciente diversidad de ubicaciones y usuarios está impulsando a las empresas hacia el edge
En el contexto del ámbito de las aplicaciones, el término «usuario» siempre se ha referido a la entidad que interactúa con una aplicación. Del mismo modo que los cambios en las arquitecturas de las aplicaciones impulsan cambios en las tecnologías que permiten ofrecerlas y protegerlas, los cambios en la definición de usuario han provocado cambios en los lugares donde se despliegan las aplicaciones.
El edge está impulsando un renacimiento de las infraestructuras
A medida que las organizaciones aumentan la generación de datos y tratan de extraer valor empresarial de ellos, sin duda recurrirán a la analítica y la automatización basadas en la IA y el aprendizaje automático. Precisamente este tipo de cargas de trabajo son las que más se beneficiarían de una infraestructura optimizada y, sin embargo, hoy en día son las que menos probabilidades tienen de poder aprovecharla.