
¿Qué es la alta disponibilidad?
La alta disponibilidad (HA) se refiere a la capacidad de un sistema para funcionar de forma continua, sin interrupciones ni fallos, normalmente mediante mecanismos de conmutación por error integrados. Los sistemas de alta disponibilidad están diseñados para seguir funcionando incluso cuando se producen acontecimientos inesperados.
Por qué es importante la alta disponibilidad
El principal objetivo de la alta disponibilidad (HA) es evitar el tiempo de inactividad, es decir, el periodo durante el cual un sistema, servicio, aplicación, servicio en la nube o funcionalidad no está disponible o no funciona correctamente. El tiempo de inactividad provoca pérdidas de ingresos, una disminución de la productividad y daños a la reputación de una empresa. Por ello, la alta disponibilidad es importante para:
- Continuidad del negocio: la alta disponibilidad garantiza que los sistemas, las características y las funciones críticas estén siempre operativos según lo previsto. Los sistemas de alta disponibilidad se recuperan rápidamente de los fallos para que las organizaciones puedan seguir prestando servicio a sus clientes con normalidad (preferiblemente sin una interrupción perceptible).
- Experiencia de usuario mejorada: los sistemas rápidos y fiables ayudan a mantener la satisfacción del cliente y a evitar las consecuencias negativas de la pérdida de ingresos, la vulneración de datos y la pérdida de productividad.
- Ventaja competitiva: unos altos niveles de disponibilidad ayudan a las organizaciones a diferenciarse al ofrecer servicios más rápidos y fiables que la competencia. Esto demuestra un compromiso con la calidad general y la satisfacción del cliente.
Tipos de alta disponibilidad
Existen varios tipos de alta disponibilidad (HA), que pueden clasificarse según el nivel de redundancia necesario, el tipo de tolerancia a fallos requerido y la clase de sistema que se protege. Los tipos más comunes de HA incluyen:
- Activo-pasivo: un sistema de respaldo se mantiene en modo pasivo o de espera y solo se activa si falla el sistema principal. Este método de protección ante fallos a veces requiere intervención manual para cambiar al sistema de respaldo.
- Activo-activo: varios sistemas funcionan de forma simultánea y comparten la carga de trabajo. Si uno de ellos falla, los demás asumen automáticamente su carga. Este tipo de alta disponibilidad requiere una configuración y coordinación más complejas entre los sistemas, pero ofrece un mayor rendimiento y escalabilidad que una opción manual.
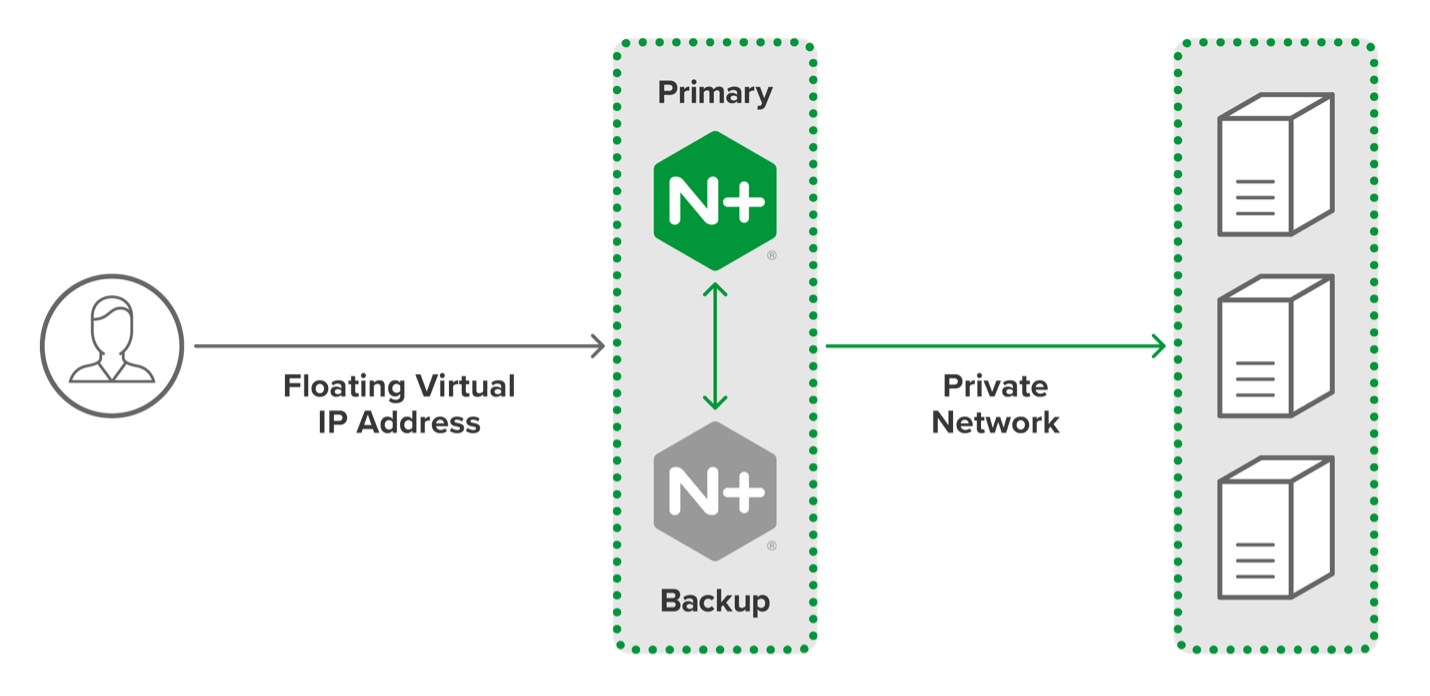
Este diagrama muestra un clúster de alta disponibilidad activo-pasivo formado por dos servidores NGINX Plus. NGINX también admite configuraciones de alta disponibilidad activo-activo y otras configuraciones de alta disponibilidad.
¿Cómo se implementa la alta disponibilidad?
Los mecanismos de redundancia y conmutación por error evitan los puntos únicos de fallo, de modo que el fallo de un componente no afecte al funcionamiento del sistema, la aplicación o la funcionalidad en su conjunto. Entre los mecanismos habituales se incluyen:
- Componentes redundantes: implemente varios servidores, conexiones de red, sistemas de almacenamiento y fuentes de alimentación en el sistema. Si un componente falla, otro toma el relevo sin interrupciones.
- Supervisión y alertas: supervise constantemente el rendimiento y la disponibilidad. Cuando se detecta una interrupción u otro problema, se genera una alerta. Los administradores del sistema pueden identificar y resolver rápidamente cualquier incidencia, lo que reduce el riesgo de tiempo de inactividad.
- Equilibrado de carga: uno o varios servidores especializados interceptan las solicitudes destinadas a un grupo de sistemas (backend) y distribuyen el tráfico entre ellos para lograr un rendimiento óptimo. Si uno de los sistemas backend falla, los equilibradores de carga redirigen automáticamente las solicitudes entrantes a los demás sistemas.
- Mecanismos de conmutación por error: implemente configuraciones activo-pasivo o activo-activo, o clústeres de conmutación por error, para garantizar que, si un sistema falla, otro pueda asumir sus funciones con una interrupción mínima.
- Sistemas de copia de seguridad y recuperación: asegúrese de que los datos y las aplicaciones puedan restaurarse rápidamente en caso de fallo. Los sistemas pueden ser híbridos, estar en distintas ubicaciones, estar basados en la nube o ponerse rápidamente en funcionamiento tras un fallo.
Cómo garantizar una alta disponibilidad
Los servicios y recursos que debe implementar para proporcionar alta disponibilidad dependen del tipo de sistema, del tipo de alta disponibilidad y de los requisitos específicos de su organización. Entre los elementos de apoyo se incluyen:
- Soporte técnico: la primera línea de defensa para las organizaciones que necesitan ayuda con sus sistemas de alta disponibilidad. El personal de soporte especializado puede ayudar a identificar, diagnosticar y resolver problemas. También puede ofrecer orientación sobre las prácticas recomendadas para mantener unos niveles elevados de disponibilidad.
- Mantenimiento y actualizaciones: para seguir funcionando de forma segura, los sistemas de alta disponibilidad deben someterse a un mantenimiento periódico y ejecutar las últimas versiones de software disponibles.
- Planificación de la recuperación ante desastres: fundamental para las organizaciones que necesitan restaurar los sistemas rápidamente. Contar con procedimientos predefinidos y documentados evita que los administradores de sistemas tengan que recordar o idear soluciones durante una emergencia.
- Documentación y formación: ayudan a los administradores de sistemas a comprender cómo gestionar sus sistemas de alta disponibilidad. La documentación puede incluir prácticas recomendadas, tutoriales y sesiones de formación.
Prácticas recomendadas: alta disponibilidad
Seguir las prácticas recomendadas mejora el rendimiento operativo y minimiza los costosos tiempos de inactividad. Estas prácticas recomendadas habituales pueden adaptarse a los sistemas, las ubicaciones y los resultados deseados de una organización.
- Incorpore redundancia: todos los niveles del sistema, desde los componentes de hardware hasta las conexiones de red, están reforzados para que, si falla un componente, el sistema siga funcionando según lo previsto.
- Equilibre la carga del tráfico: al distribuir las solicitudes entrantes entre varios sistemas, permite que los sistemas que siguen operativos asuman la carga cuando uno de ellos falla.
- Supervise el rendimiento y la disponibilidad: la monitorización continua y las alertas reducen el tiempo necesario para identificar y resolver problemas.
- Pruebe y valide con frecuencia los mecanismos de conmutación por error: realice pruebas periódicas para determinar si estos mecanismos siguen siendo capaces de asumir una función de forma fiable en caso de interrupción.
- Procedimientos de copia de seguridad y recuperación: asegúrese de que los datos y las aplicaciones puedan restaurarse rápidamente en caso de fallo.
- Actualice y mantenga los sistemas periódicamente: así, las aplicaciones y los sistemas seguirán funcionando de forma segura.
- Forme al personal: las pruebas periódicas y el refuerzo de los procedimientos deben formar parte de los procedimientos operativos estándar, especialmente para las personas y los equipos responsables de la alta disponibilidad.
- Considere las soluciones en la nube: el almacenamiento en la nube y la recuperación ante desastres permiten que los sistemas sigan funcionando independientemente de dónde se produzca el fallo.
- Supervise la seguridad: implemente medidas que eviten las filtraciones de datos o el acceso a los sistemas por parte de agentes maliciosos o usuarios no autorizados.