IA escalable
Sistemas de IA que siguen funcionando de forma fiable a medida que crecen los conjuntos de datos, los modelos, el número de usuarios y las cargas de trabajo.
La IA escalable se refiere a la capacidad de los sistemas, modelos, canales de datos, infraestructuras y operaciones de IA para mantener el rendimiento, la fiabilidad y la eficiencia de costes a medida que aumentan la demanda y la complejidad. Es lo que diferencia a un proyecto piloto de IA que funciona en un laboratorio de una solución de IA capaz de gestionar cargas de trabajo empresariales reales a gran escala.
¿Qué es la IA escalable?
La IA escalable crea sistemas que pueden ampliarse para gestionar más datos, más usuarios, modelos de mayor tamaño y ubicaciones distribuidas, sin perder rendimiento ni incurrir en costes elevados. La verdadera escalabilidad requiere un crecimiento sincronizado de toda la pila de IA, incluidos los canales de procesamiento de datos, los modelos, los clústeres de GPU, las redes, la inferencia y las operaciones.
Un modelo que funciona durante el desarrollo suele estancarse al escalarlo a producción: las canalizaciones de datos no están preparadas, los endpoints de inferencia tienen dificultades para gestionar solicitudes simultáneas o la red se convierte en el cuello de botella en lugar de la capacidad de cómputo.
La escalabilidad se manifiesta en varias dimensiones fundamentales:
- Escalado de datos: Pasar de conjuntos de datos puntuales a canalizaciones en tiempo real y de alto rendimiento
- Escalado de modelos: Ampliación de un único modelo a múltiples modelos y variantes desplegados en distintas regiones
- Escalado de la infraestructura: Garantizar que la GPU/CPU, el almacenamiento y las redes sigan el ritmo del crecimiento
- Escalado operativo: Maduración de los procesos de lanzamiento, la observabilidad, la ingeniería de tráfico y la gestión de costes
Cuando se implementa de forma eficaz, una IA escalable ofrece un rendimiento fiable y constante a medida que aumentan las cargas de trabajo. Esta transformación permite que la IA pase de ser un conjunto de proyectos piloto a convertirse en una capacidad sólida para toda la empresa. Al establecer una base sólida para la gestión del tráfico, la seguridad y la visibilidad —ámbitos en los que F5 se centra específicamente—, las empresas pueden escalar la IA con rapidez y confianza, sin poner en riesgo la estabilidad del sistema ni acumular deuda operativa oculta.
¿Por qué es importante una IA escalable?
Sin escalabilidad, las iniciativas de IA alcanzan rápidamente su límite. Las organizaciones pueden crear pruebas de concepto (POC), pero escalar para atender miles o millones de solicitudes diarias supone un reto diferente.
Es fundamental abordar la escalabilidad de la IA porque:
- La demanda empresarial supera la capacidad de las arquitecturas iniciales, y la integración de la IA acelera de forma impredecible el crecimiento del tráfico. La mayoría de las implementaciones de IA comienzan con un único modelo, flujo de trabajo y equipo. Tras demostrar su valor, la adopción se extiende a otras unidades, lo que provoca picos de tráfico a medida que nuevas aplicaciones se conectan a puntos de conexión compartidos. Los sistemas diseñados inicialmente para gestionar miles de solicitudes por hora ahora gestionan millones al día. Sin una red escalable, este rápido crecimiento puede saturar la infraestructura.
- Los sistemas de IA pueden fallar de forma sutil a gran escala, lo que provoca picos de latencia, infrautilización de las GPU, sobrecarga de los modelos o bloqueos en las canalizaciones de datos que reducen la fiabilidad. Los fallos de la IA rara vez causan interrupciones importantes; por lo general, se traducen en una degradación del rendimiento. Las GPU suelen permanecer inactivas, las colas de inferencia se acumulan cuando la carga es elevada o se producen picos de latencia durante los periodos de máxima demanda. Un patrón de tráfico mal encaminado o un fragmento de datos lento pueden alterar toda la canalización. Estos problemas sistémicos suelen manifestarse con cargas reales, lo que dificulta su diagnóstico sin una observabilidad adecuada y una gestión inteligente del tráfico.
- Los costes operativos aumentan rápidamente debido a rutas de inferencia ineficientes, una concurrencia sin gestionar y un tráfico mal configurado, lo que puede duplicar o triplicar los gastos en la nube. Los costes de inferencia aumentan por una gestión deficiente del tráfico, solicitudes sin agrupar en lotes, una carga desigual, rutas de GPU en frío o un enrutamiento inadecuado, lo que provoca un escalado innecesario y un sobredimensionamiento de los recursos. Las GPU en la nube son caras; sin una gestión adecuada, los equipos acaban pagando por GPU inactivas o réplicas de más. Muchas empresas descubren que son los problemas de red, y no la complejidad del modelo, los que impulsan los costes y gastos de inferencia.
- El cumplimiento normativo y la gobernanza requieren herramientas empresariales. La IA en producción necesita medidas de protección que no son necesarias en los proyectos piloto. Los primeros proyectos piloto de IA suelen carecer de controles formales, como la seguridad de las API, el seguimiento del linaje de los modelos y la gobernanza de datos. Sin embargo, cuando la IA gestiona datos de clientes, flujos de trabajo regulados o contenido sensible, las organizaciones deben garantizar medidas de protección como la aplicación de políticas, los registros de auditoría, los controles de acceso, el cifrado y la gestión de versiones. Estas medidas son esenciales para implementar la IA en los sectores financiero y sanitario, en las administraciones públicas o en empresas internacionales.
- La ventaja competitiva aumenta a medida que crece la escala. Una inferencia más rápida, un mayor número de iteraciones de los modelos y mejores experiencias de usuario generan una diferenciación duradera. La escalabilidad protege el sistema e impulsa la innovación. Los equipos que reentrenan rápidamente los modelos, implementan actualizaciones u ofrecen inferencias de baja latencia obtienen ventajas competitivas. Los usuarios disfrutan de una mayor capacidad de respuesta, las funcionalidades se lanzan más rápido y los modelos se perfeccionan con mayor frecuencia. Esta agilidad operativa crea una barrera competitiva difícil de superar.
La IA escalable permite a una empresa ampliar sus casos de uso con confianza, ya sea admitiendo un mayor número de usuarios, implementando modelos más complejos o desplegando la IA en distintas regiones y plataformas en la nube.
¿Cómo funciona la IA escalable?
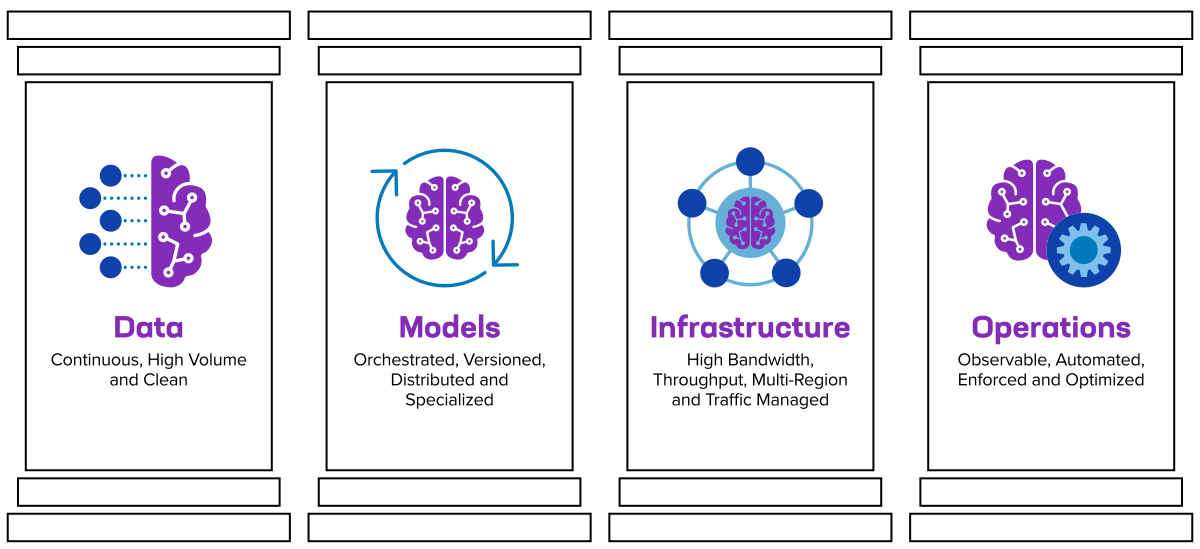
La IA escalable funciona coordinando cuatro pilares de crecimiento: los datos, los modelos, la infraestructura y las operaciones. Los cuatro deben estar alineados. Si uno solo se queda atrás, todo el sistema se ve limitado.
1. Escalado de datos
Los datos suelen ser el primer cuello de botella. Los sistemas de IA necesitan canalizaciones de datos continuas, depuradas y de gran volumen para respaldar el entrenamiento y la inferencia sin sobrecargar las GPU ni interrumpir los flujos de trabajo, incluso a medida que aumenta el volumen de datos.
- Ingesta continua de datos: Los flujos de trabajo de IA deben obtener datos en tiempo real de múltiples fuentes de forma fiable y segura para garantizar que los modelos utilicen datos de entrada actualizados y precisos.
- Canalizaciones de datos de alto rendimiento: Los sistemas deben suministrar los datos con rapidez para mantener las GPU plenamente utilizadas y evitar ciclos de inactividad provocados por flujos de entrada lentos o irregulares.
- Almacenes de características y bases de datos vectoriales: Estos sistemas estandarizan, almacenan y proporcionan características o incrustaciones a gran escala, garantizando la reproducibilidad y una inferencia de baja latencia.
- Controles de calidad y coherencia de los datos: Los datos depurados, validados y con trazabilidad reducen la deriva de los modelos, evitan fallos en los flujos de procesamiento y aumentan la confianza en los resultados de los modelos.
- Sistemas de almacenamiento escalables: El almacenamiento subyacente debe crecer junto con el conjunto de datos, permitiendo el acceso en paralelo, una recuperación rápida y un rendimiento predecible a medida que aumenta el volumen.
2. Modelos de escalado
Las empresas pasan rápidamente de utilizar un único modelo a utilizar cientos de ellos, incluidas versiones destiladas, variantes específicas para determinadas tareas y modelos ajustados. La escalabilidad de los modelos no consiste únicamente en aumentar sus parámetros, sino que también incluye:
- Orquestación multimodelo: La coordinación de varios modelos garantiza que se ejecute el adecuado en el momento oportuno sin sobrecargar el endpoint.
- Versionado, despliegues y reversiones: Gestionar las versiones de los modelos mediante despliegues controlados y reversiones instantáneas evita interrupciones y permite una mejora continua y segura.
- Inferencia distribuida: Ejecutar la inferencia en varios nodos o regiones reduce la latencia y equilibra la carga, evitando cuellos de botella en una única GPU o clúster.
- Especialización de modelos por región o caso de uso: El despliegue de variantes adaptadas a distintos mercados o tareas mejora el rendimiento y la eficiencia al adecuar cada modelo a su contexto óptimo.
3. Escalado de la infraestructura
Las cargas de trabajo de IA requieren recursos informáticos, de almacenamiento y de red de alto rendimiento. A medida que aumenta el uso, las organizaciones deben ampliar la capacidad de las GPU y:
- Redes de gran ancho de banda: Las redes deben ofrecer conexiones de baja latencia y alto rendimiento para que las GPU reciban datos de forma continua, en lugar de quedar inactivas debido a enlaces congestionados.
- Almacenamiento de alto rendimiento: Los sistemas de almacenamiento deben proporcionar acceso continuo y en paralelo a conjuntos de datos masivos para evitar cuellos de botella de E/S durante el entrenamiento y la inferencia.
- Despliegue multirregional: Distribuir la infraestructura entre distintas regiones mejora la resiliencia y reduce la latencia al situar los recursos informáticos y los modelos más cerca de los usuarios y las fuentes de datos
- Direccionamiento del tráfico y equilibrio de carga a velocidad de línea: El enrutamiento inteligente del tráfico a alta velocidad garantiza que las solicitudes de inferencia se distribuyan de manera uniforme, manteniendo los clústeres de GPU plenamente utilizados y evitando puntos de congestión.
La infraestructura debe seguir siendo eficiente porque la capacidad de las GPU es costosa y un enrutamiento ineficiente del tráfico genera desperdicio.
4. Escalado de las operaciones
Ni siquiera el hardware más robusto puede compensar unas operaciones deficientes. La IA empresarial exige:
- Observabilidad de la latencia, el rendimiento y el coste por inferencia: Los equipos necesitan información en tiempo real sobre el comportamiento del modelo y la infraestructura para detectar cuellos de botella, optimizar el rendimiento y evitar fallos silenciosos.
- Respuesta ante incidentes por degradación del modelo: Cuando disminuye la precisión o se dispara la latencia, las organizaciones deben diagnosticar rápidamente las causas raíz y restablecer un servicio estable sin afectar a los usuarios.
- Canalizaciones automatizadas para el despliegue: Una automatización fiable garantiza que las actualizaciones de los modelos pasen de forma segura del entorno de desarrollo al de producción, sin los riesgos asociados a los pasos manuales.
- Aplicación de políticas y gobernanza: Se necesitan controles sólidos para proteger los endpoints de los modelos, aplicar las reglas de acceso y garantizar el cumplimiento normativo en entornos de IA complejos
- Visibilidad y optimización de costes: Supervisar el uso de la GPU, la inferencia y la eficiencia del enrutamiento ayuda a los equipos a controlar los costes y evitar eventos de escalado innecesarios.
¿Cómo aborda F5 las dimensiones fundamentales de una IA escalable?
F5 aborda la IA escalable desde la perspectiva de los principales retos a los que se enfrentan las empresas en materia de ingeniería de tráfico, seguridad y visibilidad. Estas capas suelen convertirse en el cuello de botella a medida que aumentan las cargas de trabajo de IA, incluso en organizaciones que disponen de abundantes GPU y arquitecturas de modelos avanzadas.
F5 ayuda a las empresas a ampliar la IA mediante:
- Maximización del uso de las GPU mediante el enrutamiento inteligente del tráfico: El rendimiento de la inferencia de IA varía según la distribución de las solicitudes. F5 BIG-IP Local Traffic Manager proporciona equilibrio de carga, enrutamiento basado en el modelo y rutas de tráfico optimizadas para reducir la latencia, lo que mantiene los clústeres de GPU a plena capacidad y eficientes, en lugar de dejarlos a la espera debido a flujos de solicitudes lentos o desiguales.
- Eliminación de los cuellos de botella de la red: La inferencia con alta concurrencia puede saturar las pilas de red tradicionales mucho antes de que la capacidad de procesamiento llegue a su límite. F5 BIG-IP Platform y F5 Distributed Cloud App Connect gestionan situaciones de ancho de banda extremo y reducen la congestión, lo que garantiza que el tráfico de inferencia fluya sin problemas hacia todos los puntos de conexión.
- Protección de los endpoints de inferencia y las API de modelos: Los servicios de IA dependen de API que necesitan una verdadera protección de aplicaciones de capa 7, no solo filtrado de paquetes. F5 BIG-IP Advanced WAF, F5 Distributed Cloud Web App and API Protection (WAAP) y F5 BIG-IP SSL Orchestrator ofrecen inspección profunda (incluido el tráfico cifrado), aplicación de políticas, prevención frente a bots y usos abusivos, y protecciones en tiempo de ejecución para proteger los modelos confidenciales y las rutas de inferencia.
- Proporcionar visibilidad en entornos de IA híbridos: El tráfico de IA se produce en diversos entornos, a menudo con patrones poco claros e incoherentes. F5 Distributed Cloud App Stack, junto con la función de transmisión de telemetría de BIG-IP, proporciona a los equipos datos en tiempo real sobre la latencia, el rendimiento, el desempeño de los endpoints de los modelos, la profundidad de las colas y el estado de las API, lo que permite a los operadores optimizar el rendimiento y resolver los problemas antes de que afecten a los usuarios.
- Compatibilidad con canalizaciones de datos modernas, compatibles con S3 y de alto rendimiento: Para las canalizaciones de ingesta y entrenamiento de IA que hacen un uso intensivo de los datos, BIG-IP acelera el tráfico de gran volumen hacia el almacenamiento de objetos compatible con S3. Junto con socios como NetApp StorageGRID, F5 garantiza que las canalizaciones de datos escalen con fluidez para adaptarse a las cargas de trabajo de entrenamiento y recuperación de modelos.
Las capas de gestión del tráfico, seguridad y visibilidad de F5, proporcionadas mediante BIG-IP y Distributed Cloud Services, están diseñadas para garantizar que las cargas de trabajo de IA sigan siendo fiables, eficientes y ofrezcan un alto rendimiento ante el aumento de la demanda.
Por qué la escalabilidad es importante desde las primeras fases del desarrollo
Hoy en día, los sistemas de IA evolucionan más rápido que la infraestructura que los sustenta. Los modelos crecen, los casos de uso amplían su alcance y la concurrencia aumenta a medida que las organizaciones integran la IA en productos, flujos de trabajo y experiencias de cliente. Al mismo tiempo, las expectativas en materia de costes se vuelven más exigentes y los requisitos de gobernanza elevan los estándares de disciplina operativa.
La escalabilidad no consiste únicamente en optimizar; es un requisito fundamental para que la IA sea fiable y reproducible en toda una organización. Sin una base sólida y escalable, cada nueva aplicación de IA corre el riesgo de convertirse en un proyecto a medida, con un rendimiento irregular y costes cada vez mayores.
Las empresas que invierten desde el principio en una infraestructura de IA escalable como base operativa de su IA obtienen:
- Ciclos de iteración más rápidos
- Menores costes operativos
- Rendimiento más uniforme
- Mayor fiabilidad y seguridad
- Una vía sostenible para su adopción en toda la empresa
Arquitectura e infraestructura para una IA escalable
La escalabilidad de la IA depende de una infraestructura capaz de adaptarse a las exigencias de la carga de trabajo. Las empresas suelen considerar cuatro opciones arquitectónicas: nube, infraestructura local, híbrida y perimetral.
- Escalabilidad de la IA basada en la nube: La nube agiliza la experimentación y la ampliación de la capacidad, pero plantea problemas de costes y latencia a gran escala. Entre las limitaciones se incluyen la ingeniería de tráfico, la disponibilidad de GPU y la previsibilidad del rendimiento.
- Escalabilidad de la IA en las instalaciones: Las opciones en las instalaciones ofrecen costes predecibles, una gobernanza de datos estricta y un rendimiento estable, pero requieren una planificación minuciosa de la alimentación eléctrica, la refrigeración y las redes, especialmente en el caso de clústeres de GPU de alta densidad.
- Arquitecturas de IA híbridas: La mayoría de las empresas operan en este ámbito, con el entrenamiento a menudo en la nube, la inferencia en el extremo de la red y el ajuste fino en un clúster de GPU dedicado. La escalabilidad depende de unas redes, un enrutamiento y una seguridad fiables en los distintos entornos.
- IA en el edge y escalabilidad: La inferencia en el edge reduce los costes y la latencia, pero requiere destilación de modelos, estrategias de replicación y una gestión eficaz del tráfico entre los dispositivos del edge y la nube.
Tecnologías clave que permiten escalar la IA:
- Contenedores y orquestación
- Bases de datos vectoriales y almacenes de características
- Frameworks de entrenamiento distribuido
- CI/CD para ML (canalizaciones de MLOps)
- Registros y control de versiones de modelos
- Gestión del tráfico y enrutamiento de capa 7
- Canalizaciones de almacenamiento de objetos compatibles con S3
Las redes son fundamentales para una IA escalable, ya que los clústeres densos de GPU generan un elevado tráfico este-oeste y las tareas de inferencia requieren resiliencia, baja latencia y enrutamiento inteligente. Las capacidades de F5 son esenciales en este contexto.
Mejores prácticas para escalar modelos de IA
El escalado de modelos de IA se basa fundamentalmente en el diseño del servicio, no solo en el ajuste del modelo. Para ofrecer una inferencia fiable y rentable, las organizaciones deben coordinar su arquitectura y sus procesos operativos.
- Diseñe servicios sin estado y escalables horizontalmente: Separe el entorno de ejecución del modelo del estado y asegúrese de que los endpoints puedan escalar automáticamente en función del tráfico.
- Utiliza el procesamiento por lotes, el almacenamiento en caché y divide los datos en fragmentos manejables (sharding): Estas técnicas reducen la carga de las GPU y suavizan los picos de concurrencia. Muchas organizaciones logran reducir considerablemente los costes aplicando estos patrones de forma sistemática.
- Gestione las versiones de los modelos de forma rigurosa: Los despliegues, las pruebas A/B y las reversiones deben ser rápidos y seguros. Una gestión deficiente de las versiones sigue siendo una de las principales causas de incidentes durante la inferencia.
- Supervisa las métricas de primer nivel: La latencia, el rendimiento, el coste por inferencia, el uso de la GPU, las tasas de tiempo de espera agotado y la profundidad de la cola deben supervisarse en tiempo real.
- Aborde cuanto antes la falta de madurez de los datos: Los problemas de calidad de los datos, como los flujos de trabajo aislados, las etiquetas incorrectas y la falta de trazabilidad, se convierten en obstáculos persistentes a medida que aumenta la escala. Invertir en la preparación de los datos suele aportar mayores beneficios que limitarse a ampliar la infraestructura de datos y las GPU.
- Integre un enrutamiento adaptado a los modelos: Los patrones de tráfico de la IA no son uniformes. El enrutamiento según el tipo y el tamaño del modelo, la profundidad de la cola o la región del usuario mejora considerablemente el rendimiento y la eficiencia.
Desafíos de la implementación de una IA escalable
Escalar la IA plantea retos tecnológicos, organizativos y económicos.
- Los cuellos de botella técnicos incluyen infraestructuras fragmentadas, redes con poca capacidad o mal configuradas, sistemas de almacenamiento incapaces de dar soporte a las GPU y endpoints de inferencia sensibles a la latencia que experimentan problemas de carga.
- Las carencias organizativas incluyen equipos de IA e infraestructura aislados entre sí, una madurez insuficiente de MLOps y una falta de responsables y de rendición de cuentas en relación con la IA en producción.
- Restricciones de costes y capacidad incluyen la escasez de GPU, un tráfico de inferencia impredecible, picos en los costes de la nube y un enrutamiento ineficiente que reduce la utilización de las GPU.
- La seguridad y la gobernanza son fundamentales. Los activos sensibles de los modelos deben aislarse, y el tráfico cifrado (que oculta las amenazas) debe examinarse, el acceso a las API debe gestionarse de forma coherente y es esencial contar con visibilidad en tiempo real para detectar desviaciones y usos indebidos de los modelos.
Aquí es donde F5 ofrece una ventaja: elimina los cuellos de botella de la red, protege el tráfico y las API, y proporciona la visibilidad necesaria para que los equipos puedan escalar la IA con confianza, en lugar de depender de soluciones improvisadas.
IA escalable | Preguntas frecuentes
¿Qué es la IA escalable en términos prácticos?
IA que mantiene un rendimiento fiable a medida que aumentan la demanda, los datos y la complejidad de los modelos.
¿En qué se diferencia la escalabilidad de añadir GPU?
Lograr una verdadera escalabilidad depende de un crecimiento sincronizado de los canales de datos, las redes, las operaciones y las arquitecturas de los modelos, y no solo de mejoras aisladas del hardware.
¿Qué factores influyen en la escalabilidad de la IA?
La preparación de los datos, la arquitectura del modelo, la capacidad de red, el uso de la GPU, la gestión de la concurrencia y la gobernanza son elementos clave en los que centrarse.
¿Cómo deberían plantearse las organizaciones la elección entre la nube y las instalaciones locales?
La nube acelera la experimentación, mientras que la infraestructura local mejora la previsibilidad y la gobernanza. Por ello, la mayoría de las empresas suelen adoptar un enfoque híbrido.
¿Qué hace que los proyectos piloto de IA se estanquen antes de pasar a producción a gran escala?
Entre las causas habituales se incluyen la falta de madurez de los datos, una conectividad limitada, el escaso aprovechamiento de las GPU, un enrutamiento ineficiente, unos procesos operativos deficientes y una asignación de responsabilidades poco clara.
¿Cómo afecta la interconexión de redes a la inferencia escalable?
La latencia, el rendimiento y la utilización de la GPU se ven afectados por el enrutamiento, la gestión de la concurrencia y la ingeniería de tráfico.
¿Por dónde deberían empezar los equipos?
Céntrate en la visibilidad. Identifica las limitaciones actuales, como la saturación de la red, los datos y las GPU, y luego desarrolla una hoja de ruta basada en estos cuellos de botella.
Cómo ayuda F5
La IA escalable constituye la base de una IA empresarial eficaz. Requiere canalizaciones de datos integradas, arquitecturas de modelos robustas, una infraestructura de alto rendimiento, redes fiables, una gobernanza sólida y operaciones rigurosas. Las organizaciones que inviertan ahora podrán ampliar las aplicaciones de IA con confianza y de forma rentable, sin comprometer el rendimiento ni la seguridad.
Obtenga más información sobre cómo F5 Application Delivery and Security Platform ayuda a las organizaciones a ampliar sus iniciativas de IA en f5.com/solutions/ai-delivery-and-security.