Ceci est le deuxième article d’une série consacrée aux défis liés à la transformation numérique.
Chaos dans le cloud.
En ce moment même, un ingénieur perspicace doit être en train de faire remarquer que cette expression est redondante. Après tout, le cloud est synonyme de chaos, avec son manque de gouvernance et son approche laxiste de la sécurisation des applications jetées dans ses profondeurs cotonneuses sans calendrier clairement défini.
Arrêtons-nous un instant pour souligner que le chaos associé au cloud est le plus souvent un problème de personnes et de processus plutôt qu’un problème technique.
Cela ne veut pas dire que le cloud ne présente pas de défis techniques — ou du moins architecturaux. Certains sont liés à la complexité des réseaux virtuels. Mais la plupart relèvent de l’architecture. L’un de ces défis architecturaux tient à la nature même du cloud, qui privilégie une approche par application.
À bien y réfléchir, le cloud public et son modèle de déploiement sont considérés comme la forme idéale du cloud (la « forme du cloud », comme pourraient le dire les platoniciens). Cela signifie que le cloud privé devrait lui aussi suivre ses principes et présenter les mêmes caractéristiques.
Cela implique des API et un provisionnement en libre-service, ainsi que des tableaux de bord et des consoles web. Mais cela suppose également une évolution de l’architecture vers un déploiement entièrement axé sur une seule application.
Dans le cloud, les architectures dédiées à chaque application sont la norme. Les services sont déployés et configurés pour prendre en charge une seule application à la fois et créer un chemin de données unique entre l’utilisateur et le terminal, en passant par ces services. Cette approche contraste fortement avec la conception traditionnelle des réseaux de centres de données, dans laquelle de nombreuses infrastructures de services réseau et applicatifs sont mutualisées.
C’est la notion d’« infrastructure partagée » qui devient problématique dans un environnement de développement DevOps et Agile aussi axé sur chaque application que le cloud public.
Les réseaux traditionnels reposant sur une infrastructure partagée créent « un seul et unique chemin entre la porte d’entrée et l’application ». Dans le monde numérique actuel, où tout évolue rapidement, cette approche pose les problèmes suivants :
- Alignement des versions de l’infrastructure. Une application peut nécessiter des fonctionnalités fournies par une mise à niveau ou un correctif, tandis qu’une autre dépend de la version existante. Une infrastructure partagée ne permet généralement pas de faire coexister différentes versions sur un même système et peut donc entraver une application pour en favoriser une autre.
- Conflits de calendriers de déploiement. Lorsque des ressources partagées sont affectées, les entreprises entament une phase de négociation au cours de laquelle les parties prenantes des applications tentent de résoudre les conflits de calendriers de déploiement. Le processus peut être long (et est toujours pénible), et personne n’y gagne lorsqu’une nouvelle application ou une mise à jour est retardée en raison de conflits de calendrier.
- Rayon d’impact. Il va sans dire que si mon application provoque la défaillance d’un système partagé, toutes les applications qui en dépendent tombent également en panne. Le rayon d’impact d’une infrastructure partagée est considérable, ce qui explique en grande partie la réticence à accorder un accès plus large au pipeline de déploiement aux personnes extérieures au service informatique.
- Dépannage. Éplucher des journaux agrégés est une tâche fastidieuse. Des entreprises très prospères se sont développées uniquement grâce à leur capacité à analyser d’immenses volumes de journaux et à ventiler les données en flux propres à chaque application. Le dépannage des systèmes partagés est complexe et chronophage, et il a une incidence négative sur le délai moyen de résolution, un indicateur clé de performance essentiel pour les services informatiques modernes.
Dans le cloud, rien de tout cela ne pose généralement problème. Chaque application suit son propre processus, car les applications sont généralement déployées selon leur propre calendrier, dans leur propre environnement — souvent par des équipes différentes.
Pour préserver notre santé mentale (et notre centre de données), nous devons adopter cette approche sur site, que ce soit dans un cloud privé ou non.
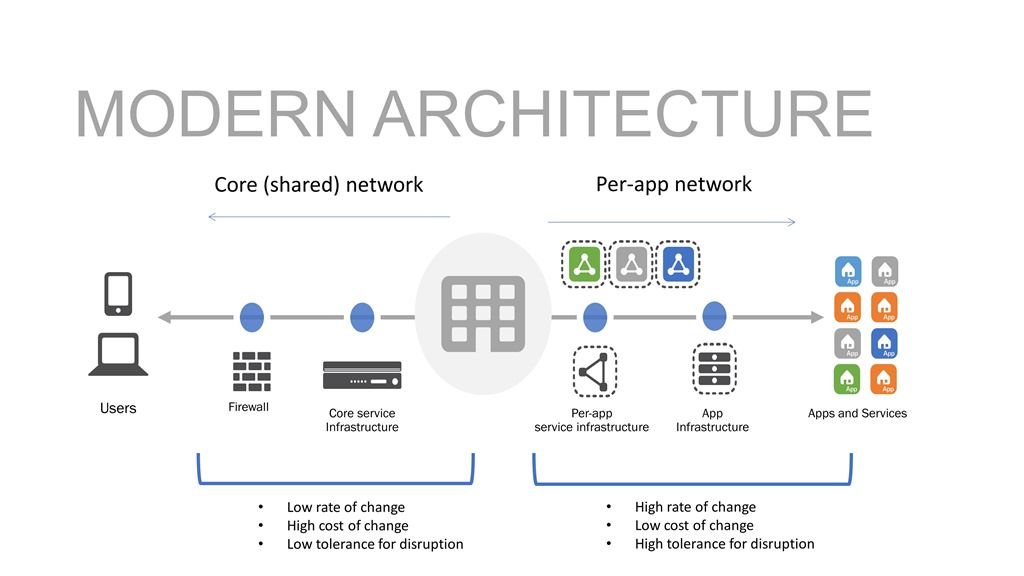
Vous continuerez à disposer de services réseau partagés. Les pare-feu, les systèmes IPS/IDS, la protection contre les attaques DDoS et l’inspection des utilisateurs sont largement indépendants des applications et peuvent (et devraient) être déployés à l’échelle de l’entreprise. Pour tout le reste, il existe des services et une infrastructure propres à chaque application (ou spécifiques à chaque application, si vous préférez). Cette séparation logique préserve la stabilité et la sécurité de l’entreprise tout en permettant un environnement plus volatil, voire instable, au plus près des applications. Elle maintient également un chemin de données pour les applications traditionnelles (anciennes et patrimoniales), qui n’ont pas besoin de la rapidité ni du niveau de prise en charge requis par les applications plus récentes. Le réseau propre à chaque application peut prendre la forme d’un cloud privé, de plusieurs clusters de conteneurs ou d’une combinaison des deux.
L’alliance des deux donnera naissance à un réseau plus stable et résilient, tout en étant flexible et rapide.
Une approche du réseau propre à chaque application présente de nombreux avantages, en plus d’atténuer les problèmes liés à une approche mutualisée associée aux architectures d’applications et aux modèles de déploiement modernes :
- Pipelines et calendriers individuels. Je peux planifier mes propres déploiements lorsqu’ils sont prêts, car ils n’ont d’incidence sur aucune autre application ni infrastructure que les miennes. Cette approche offre la souplesse nécessaire pour prendre en charge les différents calendriers d’un centre de données moderne.
- Périmètre d’impact limité. Si mon déploiement provoque une panne sur mes systèmes dédiés, j’en assume l’entière responsabilité. Cela n’affecte aucune autre application. Cette approche reposant sur un chemin de données dédié à chaque application facilite également le dépannage, car je peux être certain que les journaux et les messages d’erreur de tous les systèmes concernent mon application et moi-même.
- La mise à l’échelle n’est pas limitée par les ressources de la plateforme. Dans un monde extrêmement volatil et dynamique, il est quasiment impossible de savoir quand surviendra le prochain afflux de visiteurs, si un contenu deviendra viral ou si, à Dieu ne plaise, vous subirez une attaque. Quelle qu’en soit la cause, lorsque la demande augmente brusquement pour des applications hébergées sur des systèmes partagés (matériels ou logiciels), la mise à l’échelle est limitée aux ressources disponibles sur la plateforme. Une architecture propre à chaque application atténue cette contrainte et permet aux différents composants d’être mis à l’échelle selon les besoins afin de répondre à la demande.
- Prend en charge un véritable modèle d’infrastructure en tant que code. Les systèmes partagés utilisent des configurations communes, même s’il ne s’agit que d’une configuration de base assortie de politiques propres à chaque application. Ce modèle peut semer le chaos lorsque l’on tente de mettre en œuvre un modèle d’infrastructure en tant que code, en particulier lorsque plusieurs applications essaient d’être mises à jour simultanément. Des modifications peuvent affecter d’autres applications sans avertissement, ou les opérations de validation et de clonage peuvent échouer parce que d’autres utilisateurs verrouillent les ressources au moment où vous en avez besoin. Une architecture propre à chaque application garantit que les artefacts de déploiement n’appartiennent qu’à une seule application et peuvent être correctement gérés par les responsables de celle-ci (qu’il s’agisse des équipes de développement, DevOps, NetOps ou autres).
Même si une architecture par application ne résout pas tous les problèmes liés à la transformation numérique, elle peut largement contribuer à maîtriser le chaos engendré par le cloud. Elle offre davantage de possibilités pour standardiser la sécurité et prendre en charge les environnements multicloud vers lesquels évoluent la plupart des entreprises.
Ne manquez pas le prochain article de cette série, dans lequel nous verrons en détail comment gérer ceux qui font l’impasse sur la sécurité en raison des impératifs de mise sur le marché liés à la transformation numérique.
À propos de l’auteur

Lori MacVittie est ingénieure émérite et évangéliste en chef au sein du bureau du directeur technique de F5. Elle possède une expertise approfondie dans la fourniture d’applications, les stratégies d’automatisation et les infrastructures. Elle est réputée pour sa capacité à rendre la complexité intelligible, qu’elle définisse des garde-fous pour les agents d’IA, analyse des architectures multicloud fragiles ou explore les limites des systèmes évolutifs. Elle cumule plus de trente ans d’expérience dans le secteur, couvrant le développement d’applications, l’architecture informatique ainsi que l’exploitation des réseaux et des systèmes. Avant de rejoindre F5, elle a été rédactrice spécialisée dans les technologies et a reçu plusieurs distinctions. MacVittie est titulaire d’un master en informatique et est une autrice prolifique dont les publications couvrent la sécurité, le cloud et l’architecture d’entreprise. Elle est également une passionnée de jeux de société et de jeux vidéo, et assume pleinement ses avis bien tranchés sur le fromage.
Autres articles de Lori Mac VittieArticles de blog associés

F5 NGINXaaS pour Google Cloud : des applications résilientes et évolutives
Découvrez comment NGINXaaS s’intègre à Google Cloud pour renforcer les performances et la sécurité, et préparer vos applications critiques à un avenir propulsé par l’IA.

L’intégration de F5 Web Application Firewall (WAF) à AWS est disponible dès aujourd’hui
En faisant appel à un partenaire de déploiement AWS WAF tel que F5, vous pouvez renforcer la sécurité de vos applications web grâce à des règles personnalisées qui bloquent les schémas d’attaque courants, comme les injections SQL ou les attaques par scripts intersites (XSS).
Appliquer le principe de Peter Parker à l’inspection TLS
« Un grand pouvoir implique de grandes responsabilités. » Si l’on en trouve des échos chez Voltaire et Churchill, cette citation est surtout connue grâce aux bandes dessinées Spider-Man, où elle est attribuée à l’oncle Ben. Bien entendu, si cette phrase est si répandue dans la culture populaire, c’est notamment parce qu’elle peut s’appliquer à une multitude de situations et de sujets, y compris à l’inspection TLS.
Le NetOps a besoin de défenseurs, pas d’adversaires
Il est important de reconnaître que les équipes NetOps ne sont pas toujours celles qui font obstacle au déploiement de la dernière nouveauté, application ou service. Les freins à la rapidité sont souvent dus au fait que les organisations n’adoptent pas tous les principes du DevOps lorsqu’elles cherchent à transformer leurs opérations informatiques.
Mise à jour des services applicatifs : sécurité, rapidité et visiteurs suspects
Il est de nouveau temps de nous pencher sur les services applicatifs que les entreprises utilisent réellement pour rendre leurs applications plus rapides et plus sûres. On constate notamment une hausse du recours aux services de protection contre les bots, ainsi que la progression lente mais régulière de HTTP/2. Bien qu’il ne s’agisse pas d’une application…
Les templates prennent le contrôle du cloud
Les modèles s’imposent dans le cloud. Lisez le blog de F5 pour découvrir comment l’infrastructure en tant que code et les API déclaratives automatisent la mise à disposition des applications.