Le rôle et l’impact de GraphQL
Par Rajesh Narayanan
Relu et enrichi par : l’équipe OCTO et d’autres contributeurs.
Avis du bureau du CTO de F5
GraphQL s’est imposé comme une approche moderne et efficace du développement d’API, dépassant les limites des API REST traditionnelles. Bien que REST soit largement utilisé depuis les débuts du Web, GraphQL offre une nouvelle perspective et un meilleur contrôle aux développeurs. Avec GraphQL, les développeurs peuvent définir un schéma fortement typé qui permet aux clients de demander précisément les données dont ils ont besoin. En évitant de récupérer trop ou trop peu de données, GraphQL optimise les performances et facilite la création d’applications Web modernes et interactives ayant des besoins complexes en matière d’interrogation et de modélisation des données.
Cependant, nous reconnaissons que GraphQL présente également certains défis. Ce livre blanc apporte un éclairage sur les enjeux de sécurité et la courbe d’apprentissage liés à l’adoption de GraphQL. Nous examinons des études de cas réelles qui décrivent les avantages obtenus par des entreprises de renom ayant mis en œuvre GraphQL avec succès.
En outre, nous présentons notre propre étude de GraphQL et partageons nos expériences et nos découvertes. Nous proposons une brève introduction à GraphQL, le comparons à REST et examinons en détail les défis auxquels il répond. Nous abordons également les questions de sécurité afin d’aider les organisations à prendre des décisions éclairées. Nos recherches révèlent le potentiel transformateur de GraphQL. Nous montrons comment nous avons simplifié l’architecture logicielle d’une suite de gestion des tests, ce qui a permis d’augmenter de plus de 300 % la quantité de données exposées, auparavant dissimulées dans des objets JSON, grâce à GraphQL.
En conclusion, nous recommandons vivement aux entreprises confrontées à des difficultés liées à la mise à l’échelle, à l’optimisation ou à l’exploitation d’une infrastructure d’API REST d’envisager GraphQL comme une solution viable. Nos analyses fournissent des conseils pratiques à celles qui se lancent dans l’adoption de GraphQL, afin de leur permettre d’en exploiter les avantages et de surmonter efficacement les difficultés.
Introduction à GraphQL
POURQUOI GRAPHQL ?
Les limites des API REST stimulent la demande pour une nouvelle approche technologique des API.
L’approche fondée sur REST (Representational State Transfer) a été initialement proposée comme un ensemble de principes architecturaux pour la conception d’API web. REST a évolué au cours des années 2000 et 2010 avec l’émergence du Web 2.0, s’imposant comme un meilleur moyen de mettre en œuvre une architecture orientée services (SOA) que d’autres technologies telles que Common Object Request Broker Architecture (CORBA).
Avec l’essor des appareils mobiles, le nombre de clients a augmenté, tout comme le besoin de données précises. Cependant, les API REST entraînaient souvent la récupération d’un volume de données trop important ou insuffisant, ce qui nuisait à leur efficacité. Cette approche, illustrée par des applications comme Facebook, nécessitait souvent de nombreux appels à l’API REST pour une seule mise à jour, augmentant ainsi le trafic réseau et dégradant les performances et l’expérience utilisateur.
GraphQL a été spécifiquement conçu pour remédier à ces limitations en proposant un schéma fortement typé et un moyen plus efficace d’interroger les données. Il est donc particulièrement adapté aux cas d’usage nécessitant des données précises afin d’optimiser la bande passante réseau. De plus, la capacité de GraphQL à effectuer une introspection du schéma permet d’améliorer la documentation et les outils. Même si une implémentation plus standardisée de REST aurait pu lui faire concurrence, les fonctionnalités et avantages uniques de GraphQL en font un choix particulièrement intéressant pour les architectures d’applications modernes, distribuées et à forte intensité de données.
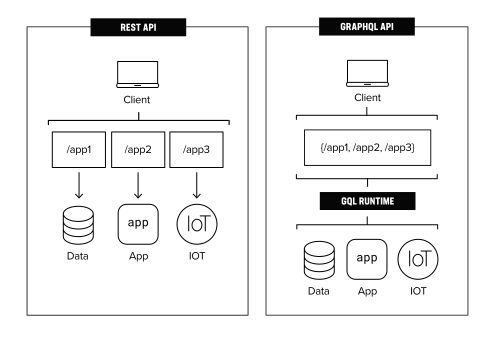
La figure 1 illustre une différence topologique dans la manière dont REST et GraphQL sont mis en œuvre. Comme indiqué dans « API REST ou GraphQL », « la principale différence entre les API GraphQL et REST réside dans le fait que GraphQL est un langage de requête, tandis que REST est un concept architectural destiné aux logiciels en réseau. »
LES MOTIVATIONS DE META POUR GRAPHQL
Meta a créé GraphQL en 2012 (publié en open source en 2015) afin d’améliorer les performances et la flexibilité de ses applications mobiles. Avant GraphQL, les applications mobiles de Meta reposaient sur une combinaison d’API RESTful et de code natif, ce qui compliquait la prise en charge du large éventail d’appareils, de tailles d’écran et de conditions réseau qu’elles devaient gérer.
L’un des principaux défis auxquels ils étaient confrontés tenait au fait que les API RESTful renvoyaient souvent une quantité de données inadaptée : parfois trop importante, parfois insuffisante. Lorsque l’API renvoyait un grand volume de données dont les applications mobiles n’avaient pas besoin, cela ralentissait les temps de chargement et dégradait les performances. À l’inverse, lorsque l’API ne renvoyait pas suffisamment de données, les applications mobiles devaient envoyer plusieurs requêtes à différents points de terminaison afin de récupérer toutes les données nécessaires, ce qui augmentait la latence et la complexité du processus.
Meta a développé GraphQL afin que chaque application puisse demander uniquement les données dont elle avait besoin en une seule requête. Cela a permis d’optimiser le transfert de données entre les applications mobiles et les services backend, réduisant ainsi les temps de chargement et améliorant les performances. De plus, le typage fort et les fonctionnalités d’auto-documentation de GraphQL ont permis aux développeurs de comprendre et d’utiliser plus facilement l’API.
AVANTAGES DE GRAPHQL
GraphQL offre de puissantes fonctionnalités de récupération et de manipulation des données, avec des avantages considérables par rapport aux approches traditionnelles en matière d’API.
Schémas fortement typés
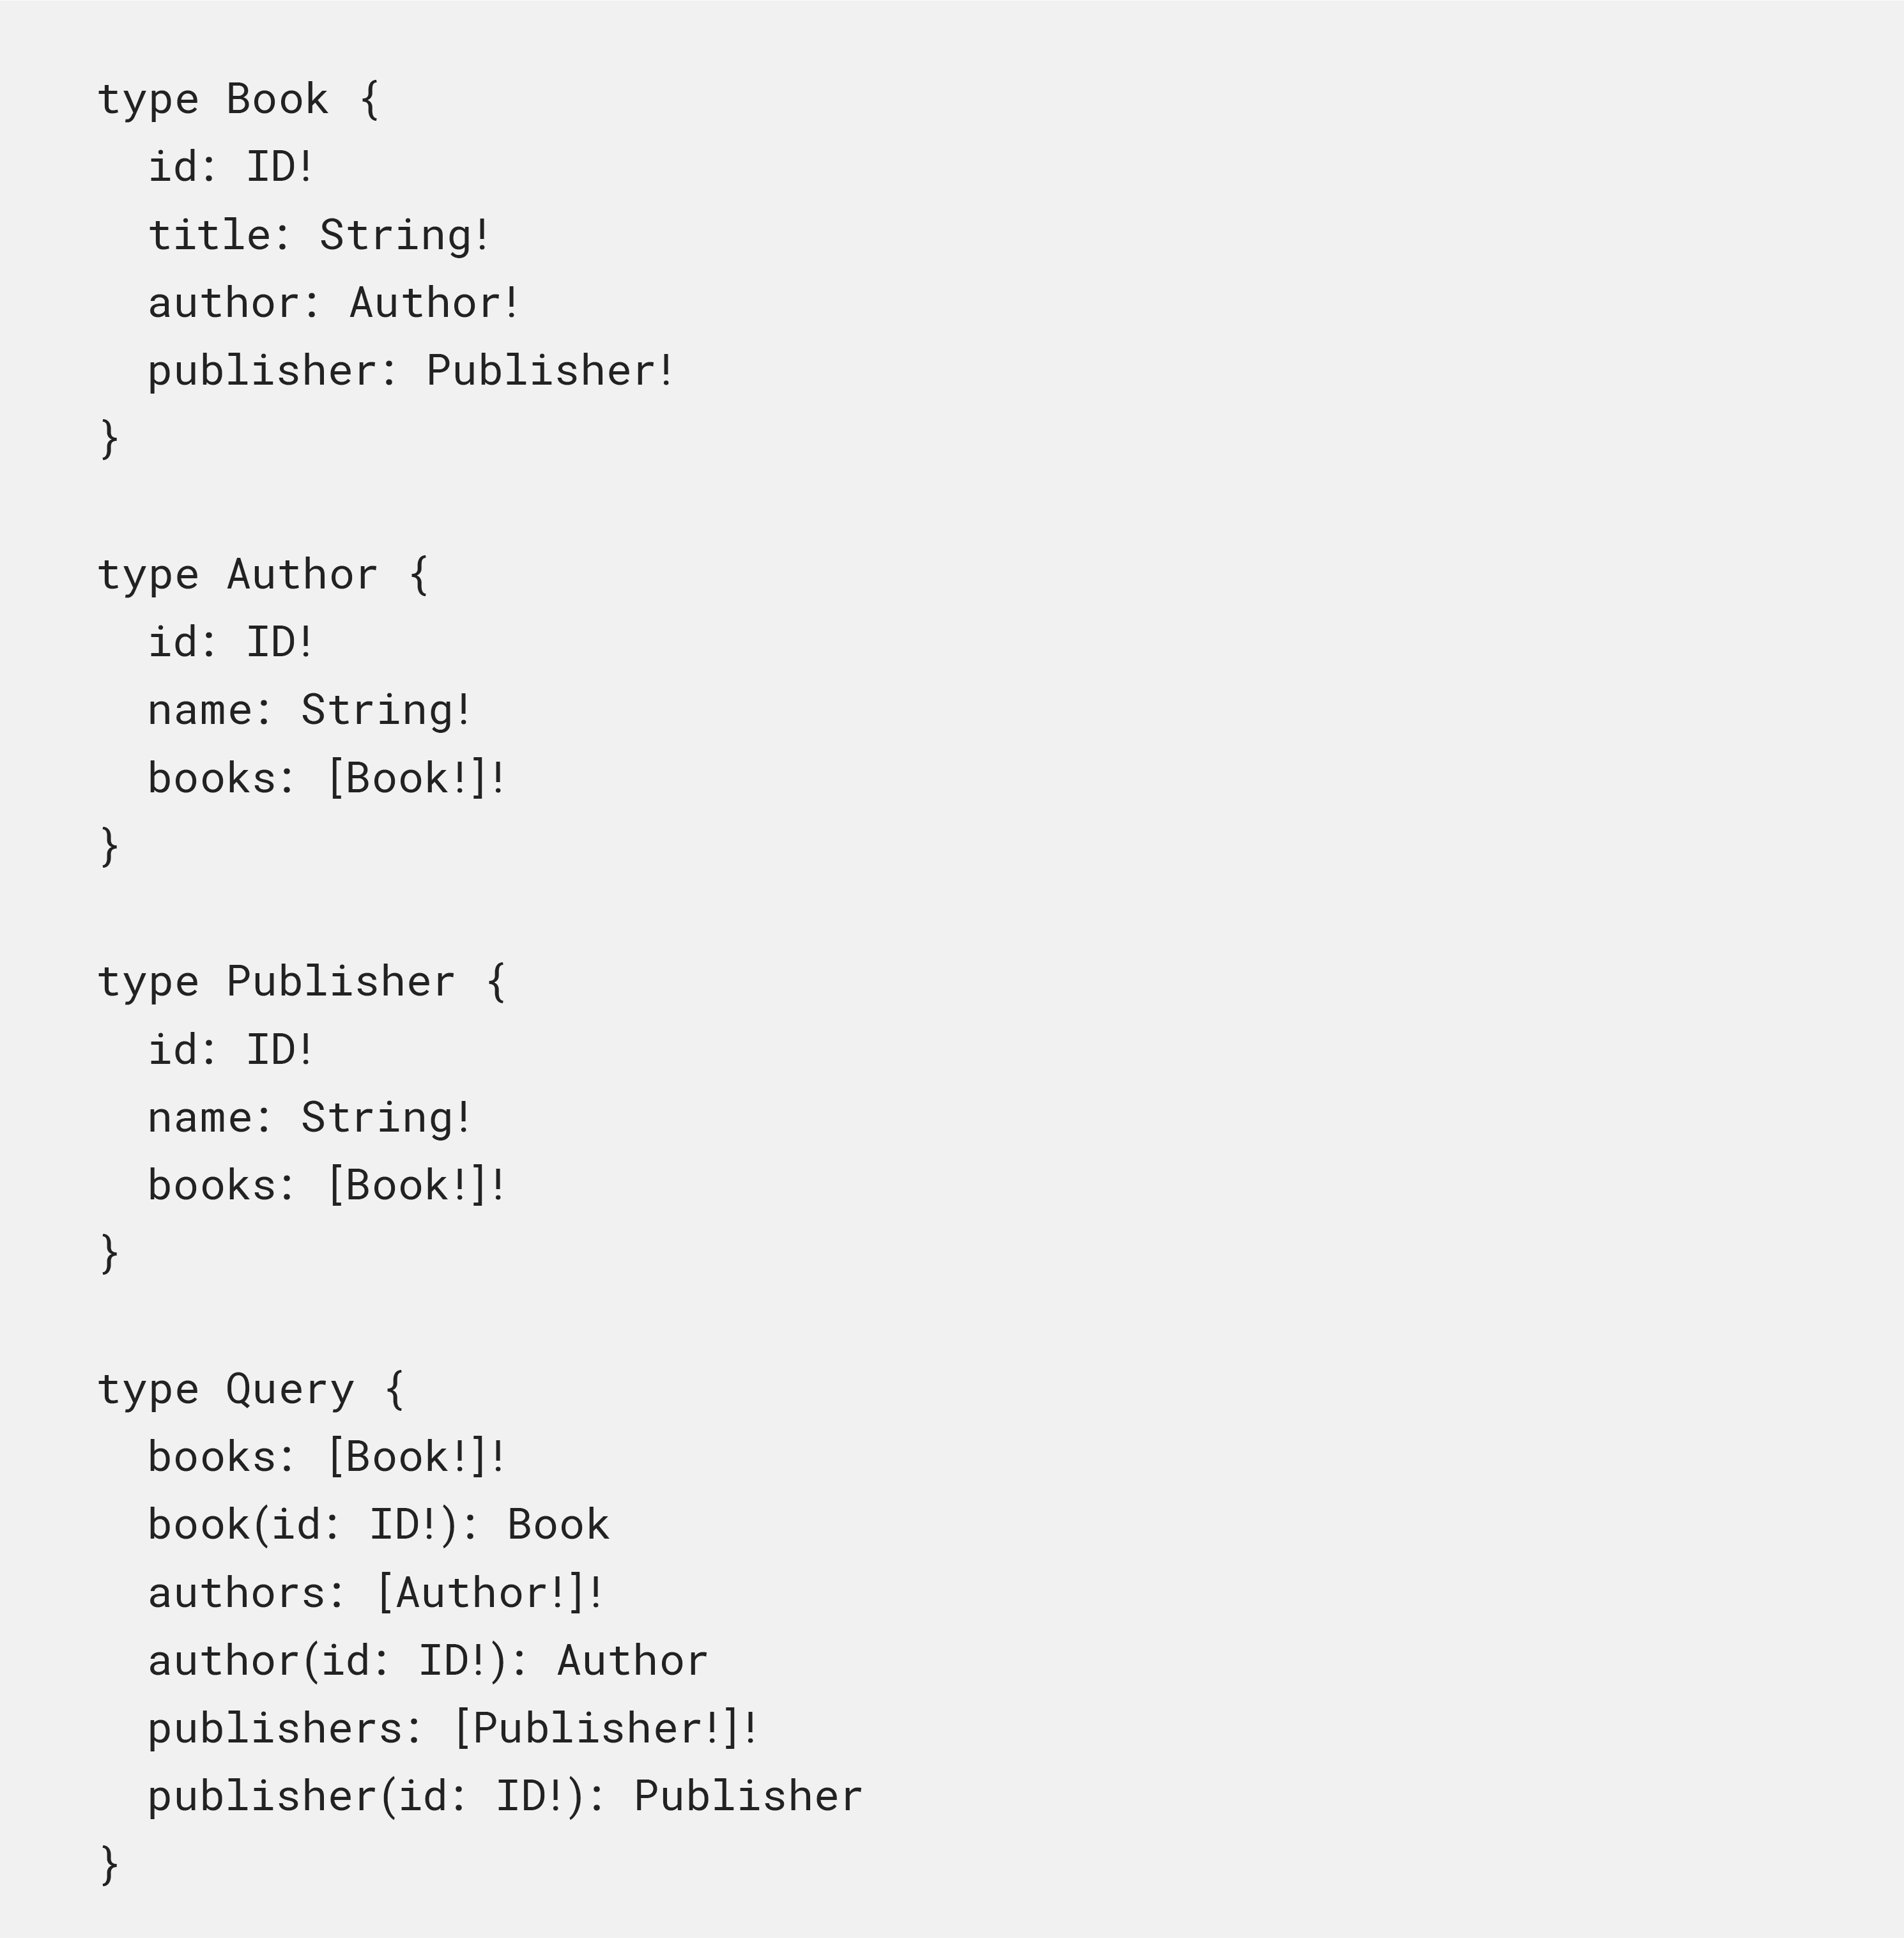
GraphQL dispose d’un schéma fortement typé qui garantit clarté et précision lors de la définition de la structure et des types de données pouvant être interrogés à partir d’une API. Imaginons que nous disposions d’une API pour une bibliothèque contenant des livres, des auteurs et des maisons d’édition.
a) Schéma GraphQL: dans GraphQL, un schéma fortement typé se présenterait comme dans la figure 2 ci-dessous :
Les schémas fortement typés de GraphQL offrent des avantages en matière de sécurité en permettant la validation des entrées, en évitant la récupération excessive ou insuffisante de données, en fournissant une documentation claire et une prise en charge efficace des outils, en facilitant le contrôle des versions et en contribuant à la gestion des autorisations et du contrôle d’accès. Ces fonctionnalités renforcent la sécurité des API en réduisant le risque de vulnérabilités courantes et en garantissant une gestion appropriée des données et des accès.
Dans l’exemple présenté (figure 2), le schéma définit les types de données des livres, des auteurs et des éditeurs, ainsi que les relations qui les unissent. Le schéma est fortement typé, ce qui signifie que chaque champ possède un type de données spécifique et que les clients peuvent facilement effectuer une introspection du schéma afin de découvrir les champs disponibles et leurs types.
b) Schéma REST: dans REST, la définition du schéma serait faiblement typée, comme illustré dans la figure 3 ci-dessous :
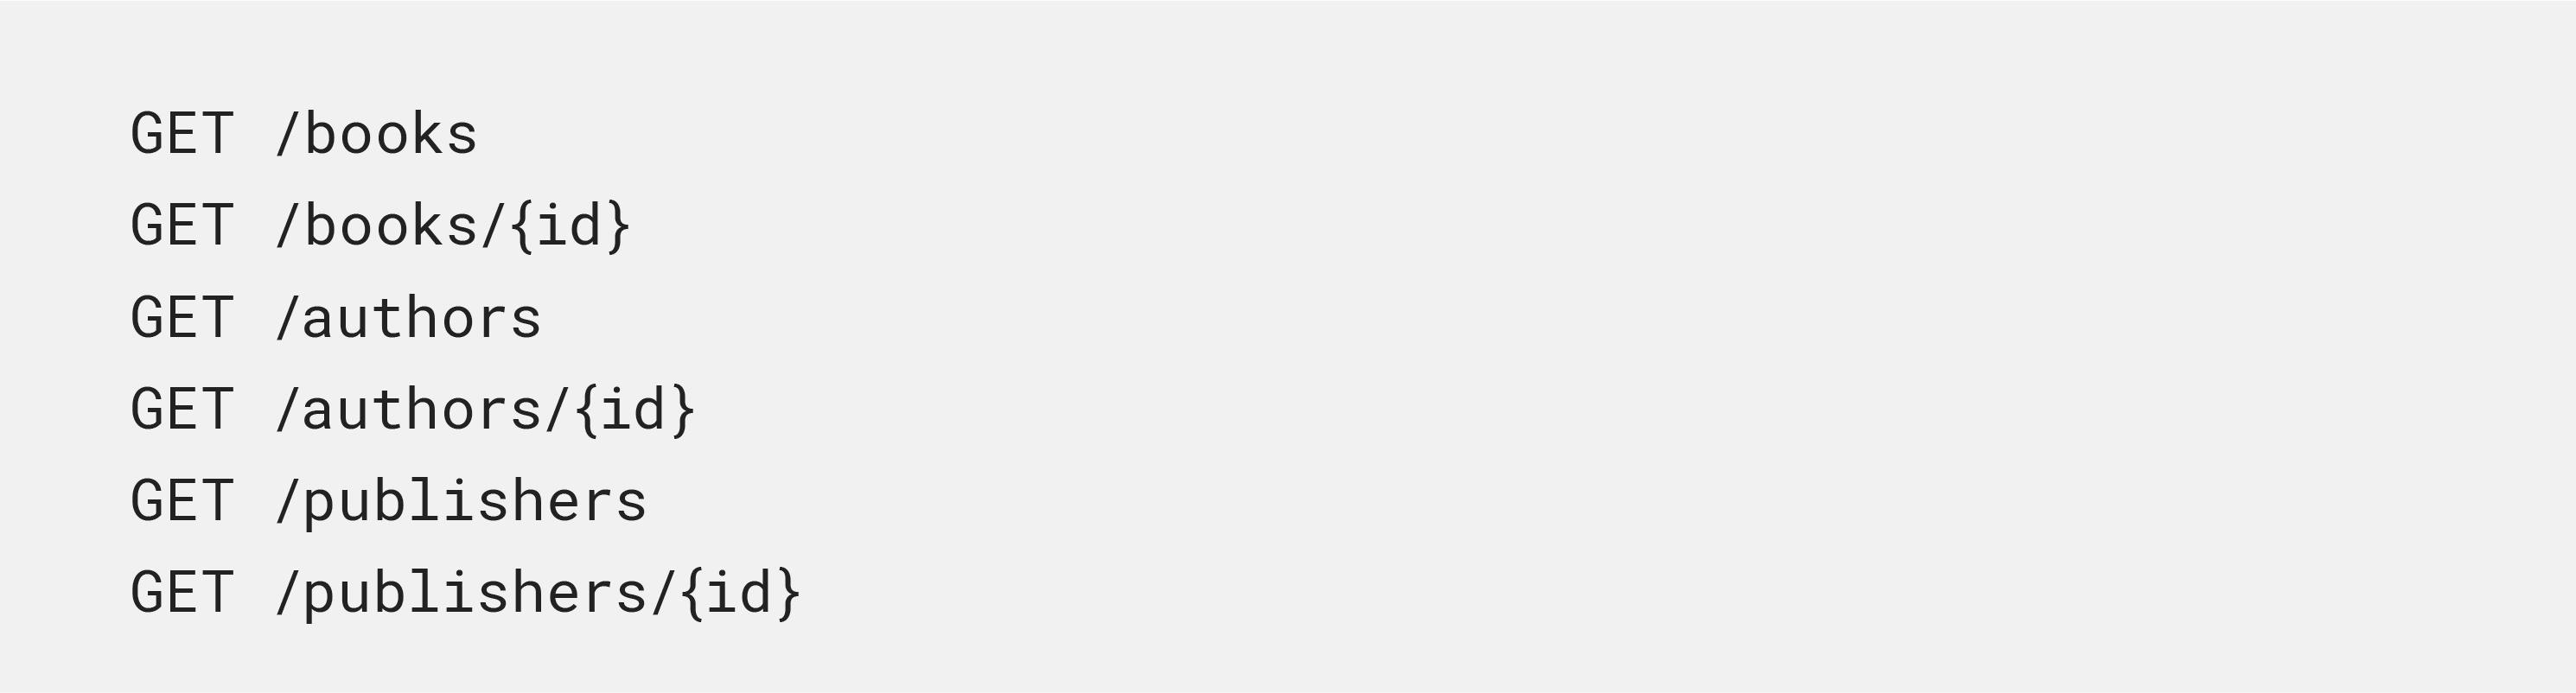
Ces points de terminaison renvoient des objets JSON représentant les livres, les auteurs et les éditeurs, mais le schéma lui-même n’est pas défini explicitement et dépend des compétences et de l’interprétation du développeur. Les clients devront s’appuyer sur la documentation pour comprendre la structure des données.
Au-delà de REST
GraphQL ne se contente plus d’être une meilleure alternative à REST : il pourrait devenir l’approche privilégiée des entreprises souhaitant adopter une meilleure stratégie en matière de données. Outre le fait qu’il remédie aux limites de REST, plusieurs autres raisons expliquent pourquoi GraphQL s’est imposé comme une nouvelle approche de la conception des API. Bien que le tableau (Figure 4) puisse mettre en évidence les avantages de GraphQL par rapport à REST, il est préférable de considérer GraphQL comme une réponse à l’évolution d’Internet et des différentes applications, plutôt que comme une réponse aux problèmes propres à REST.
| CARACTÉRISTIQUES | GRAPHQL | REST |
|---|---|---|
MODÉLISATION FLEXIBLE DES DONNÉES |
GraphQL permet aux développeurs de définir et de faire évoluer facilement les API afin de répondre à l’évolution des besoins. Grâce au langage de requête, les clients peuvent indiquer précisément les données dont ils ont besoin, ce qui rend leur récupération plus flexible et plus efficace. |
Le serveur définit généralement des points de terminaison fixes qui renvoient des structures de données prédéfinies. Les clients ont peu de contrôle sur la forme et la structure de la réponse, ce qui entraîne souvent une récupération excessive ou insuffisante des données. REST n’offre pas le contrôle précis de la récupération et de la composition des données proposé par GraphQL. |
REQUÊTES GROUPÉES |
GraphQL permet de regrouper plusieurs requêtes en une seule, ce qui peut réduire considérablement le nombre d’allers-retours entre le client et le serveur et améliorer les performances. |
REST ne dispose d’aucun mécanisme intégré permettant de regrouper plusieurs requêtes en une seule. Chaque requête REST correspond généralement à une ressource ou à un point de terminaison unique. Certains frameworks ou certaines extensions REST peuvent permettre de regrouper plusieurs requêtes, mais ces solutions ne sont ni natives ni standardisées comme dans GraphQL. |
REQUÊTES ET RÉPONSES TYPÉES |
Les clients peuvent indiquer précisément les données dont ils ont besoin, et les serveurs peuvent répondre uniquement avec les données demandées, ce qui réduit leur récupération excessive ou insuffisante. De plus, GraphQL est fortement typé, ce qui contribue à éviter les erreurs et améliore la prise en charge par les outils. |
Le typage n’est pas imposé nativement dans les requêtes et les réponses. La structure et le format des données sont généralement prédéfinis par le serveur, et les clients doivent interpréter et traiter les données en conséquence. La sécurité du typage peut donc être moindre. |
INTÉGRATION AUX FRAMEWORKS FRONT-END |
GraphQL est conçu pour fonctionner efficacement avec des frameworks front-end tels que React et Vue, ce qui facilite la création d’applications web modernes et interactives. GraphQL dispose de bibliothèques et d’outils dédiés assurant une intégration fluide. |
Bien que REST puisse être utilisé avec des frameworks front-end, son intégration peut nécessiter davantage d’interventions manuelles et d’implémentations personnalisées. Malgré l’existence de bibliothèques tierces, REST ne propose aucune méthode standardisée d’intégration à des frameworks front-end spécifiques tels que React ou Vue. |
INTERROGATION BASÉE SUR LES GRAPHES |
GraphQL permet d’effectuer, en une seule requête, des interrogations complexes couvrant plusieurs ressources et relations, ce qui facilite l’obtention des données nécessaires à la création d’interfaces utilisateur complexes. |
REST suit généralement une approche centrée sur les ressources, dans laquelle chaque point de terminaison représente une ressource ou une entité spécifique. Il ne fournit pas nativement de mécanisme permettant d’interroger, en une seule requête, des données couvrant plusieurs ressources ou relations. |
PERFORMANCES |
La capacité de GraphQL à demander précisément et uniquement les données nécessaires peut rendre leur récupération plus efficace et améliorer les performances. |
Les API REST peuvent entraîner une récupération excessive ou insuffisante des données, car les clients ont peu de contrôle sur la structure de la réponse. Cela peut nuire aux performances, en particulier si l’API renvoie des données excessives ou inutiles. |
PRODUCTIVITÉ DES DÉVELOPPEURS |
Grâce à ses capacités d’introspection, GraphQL s’autodocumente, ce qui réduit le besoin d’une documentation exhaustive et favorise une meilleure compréhension du modèle de données. Le schéma fortement typé et la validation des requêtes facilitent une compréhension commune et permettent de détecter rapidement les erreurs. GraphQL dispose d’un langage de requête intuitif et d’une courbe d’apprentissage plus accessible, ce qui facilite l’intégration des nouveaux arrivants et le transfert de connaissances au sein des équipes de développement. |
En raison de l’absence de contrat standardisé entre le client et le serveur, les connaissances informelles de l’équipe se dégradent. Les API REST reposent généralement sur une documentation informelle ou sur des conventions qui varient selon les implémentations. L’absence de compréhension commune entraîne des incohérences et des lacunes dans les connaissances au sein des équipes. Les développeurs les plus anciens dans l’équipe doivent alors consacrer un temps précieux à former leurs collègues plutôt qu’à résoudre le problème métier. Cette dépendance à l’égard de certaines personnes pour la documentation fragmente les connaissances informelles, ce qui empêche les membres de l’équipe d’acquérir une compréhension globale des fonctionnalités et des structures de données de l’API. |
GESTION DES VERSIONS DE L’API |
En matière de gestion des versions, l’avantage intrinsèque de GraphQL réside dans la possibilité de déclarer comme obsolètes les champs destinés à être supprimés, ce qui laisse aux développeurs côté client le temps de s’adapter. Une gestion des versions similaire à celle des API REST reste possible. |
REST ne permet pas nativement de déclarer des champs comme obsolètes. Il incombe aux développeurs côté client de s’assurer qu’ils utilisent la bonne version de l’API. |
Figure 4 : avantages de GraphQL par rapport à REST
DÉFIS LIÉS À GRAPHQL
Bien que GraphQL offre de nombreux avantages par rapport aux API REST traditionnelles, son utilisation présente également certaines difficultés. Parmi les difficultés courantes figurent :
- Courbe d’apprentissage : Comme la plupart des développeurs connaissent mieux REST, les organisations qui prévoient d’adopter GraphQL devront prévoir du temps pour permettre à leurs équipes d’apprendre à l’utiliser efficacement. GraphQL nécessite une approche différente de la création et de l’utilisation des API, et son adoption pourrait nécessiter des modifications de l’architecture sous-jacente de l’application. Les développeurs devront peut-être se familiariser avec de nouveaux concepts tels que les schémas, les résolveurs et les types, ainsi qu’avec de nouveaux outils et de nouvelles bibliothèques. Avec GraphQL, les clients disposent d’un plus grand contrôle sur les données auxquelles ils peuvent accéder, ce qui peut compliquer la sécurisation des API. Des techniques telles que la validation des entrées, l’authentification et l’autorisation devront peut-être être appliquées différemment qu’avec les API RESTful.
- Mise en cache: la mise en cache peut être plus complexe avec GraphQL, car les clients peuvent demander des données différentes à chaque requête, ce qui complique la mise en cache et la réutilisation des réponses.
- Performances: Bien que GraphQL permette aux clients de demander uniquement les données dont ils ont besoin, il peut également permettre des requêtes plus complexes et gourmandes en ressources. Les API GraphQL peuvent rencontrer des problèmes de performances, notamment lors de l’interrogation de grands jeux de données ou lorsqu’un nombre élevé de requêtes simultanées est effectué. Les développeurs doivent mettre en œuvre des stratégies telles que la limitation de la profondeur des requêtes ou la vérification que les clients sont autorisés à accéder uniquement aux données spécifiques dont ils ont besoin.
- Gestion des erreurs: GraphQL peut complexifier la gestion des erreurs, car celles-ci peuvent être renvoyées dans la réponse plutôt que sous la forme d’un code d’état HTTP distinct.
- Tests: Les tests avec GraphQL présentent des difficultés liées à la complexité des requêtes, à l’absence d’approches de test standardisées, à l’évolution du schéma et à la validation des requêtes lors de l’exécution. Les développeurs doivent consacrer du temps à la recherche de frameworks et d’outils de test adaptés pour relever ces défis. Ils doivent garantir une couverture de test complète en sélectionnant les outils appropriés et en tenant compte de l’évolution du schéma afin de tester efficacement les API GraphQL et d’assurer leur bon fonctionnement et leur stabilité.
- Surveillance : La surveillance des API GraphQL peut s’avérer complexe en raison de la complexité des requêtes, de l’absence de normes en matière de journalisation et de métriques, ainsi que des éventuels problèmes de performances. La nature dynamique des requêtes GraphQL rend plus difficiles la prévision et la surveillance de la structure et du volume des données demandées. L’absence d’outils de surveillance standardisés propres aux API GraphQL complique l’analyse des performances des requêtes GraphQL, le suivi des erreurs et l’évaluation de l’état de santé des API. Les développeurs doivent adopter des outils et des pratiques de surveillance spécialisés, capables de prendre en charge les caractéristiques propres à GraphQL afin de garantir des performances optimales et un fonctionnement fiable.
Modèles d’utilisation de GraphQL
GraphQL est un outil puissant qui peut être utilisé dans un large éventail d’applications, de la création d’API à l’alimentation d’applications mobiles. Sa flexibilité et sa capacité à unifier les sources de données le rendent parfaitement adapté à de nombreux cas d’utilisation.
- Créer des API efficaces: L’une des principales utilisations de GraphQL consiste à créer des API pouvant être utilisées par des applications web et mobiles. GraphQL offre un moyen flexible et puissant de définir les données et d’y accéder, ce qui le rend particulièrement adapté à la création d’API devant prendre en charge un large éventail de clients et de cas d’utilisation.
- Récupération et manipulation des données : GraphQL permet de récupérer et de manipuler des données provenant de diverses sources, notamment des bases de données, des services cloud et d’autres API. En offrant un moyen unifié d’accéder aux données, GraphQL peut contribuer à simplifier le développement et la maintenance d’applications basées sur les données.
- Cas d’usage en temps réel: GraphQL est particulièrement adapté aux cas d’usage en temps réel, car les clients peuvent s’abonner aux mises à jour de données spécifiques et recevoir des notifications lorsque celles-ci sont modifiées. Cette fonctionnalité peut être utilisée dans des applications telles que les chats, la diffusion en direct, les tableaux de bord en temps réel, et bien plus encore.
- Microservices: GraphQL peut être utilisé pour créer une architecture flexible et faiblement couplée, permettant à différents microservices de communiquer entre eux de manière cohérente et clairement définie.
- Du back-end au front-end: GraphQL peut être utilisé pour créer une architecture back-end for front-end (BFF), qui permet à différents clients front-end d’accéder aux données et aux services de manière cohérente et efficace.
- Développement mobile: GraphQL peut être utilisé pour alimenter des applications mobiles en leur permettant d’accéder aux données et aux services de manière cohérente et efficace, quels que soient la plateforme ou l’appareil.
Expériences d’adoption de GraphQL dans l’industrie (études de cas)
Les raisons pour lesquelles nous avons besoin de GraphQL sont évidentes, comme le montrent les déploiements suivants dans le secteur :
NETFLIX
Netflix a résumé son parcours avec GraphQL en 2020 dans une série de deux articles de blog incontournable pour tout spécialiste de GraphQL. L’étude de cas présentée portait sur le système Studio Edge, qui consistait à remanier l’architecture de ses API de studio pour les adapter à GraphQL. L’API Studio de Netflix est utilisée par ses équipes chargées des contenus pour gérer et suivre la production, la postproduction et la distribution des séries télévisées et des films. L’API donne accès à une immense quantité de données, notamment aux métadonnées sur les titres, aux informations sur les talents, et bien plus encore.
À l’origine, l’API Studio reposait sur une architecture RESTful traditionnelle, avec des points de terminaison renvoyant des données au format JSON. Cependant, à mesure que l’API se développait et que le nombre de clients y accédant augmentait, la nécessité d’une solution plus efficace est devenue évidente.
Netflix a commencé à étudier GraphQL comme solution potentielle pour l’API Studio. L’entreprise a d’abord créé un graphe soigneusement conçu pour cette API. Elle a identifié plusieurs avantages majeurs, notamment la réduction de l’utilisation du réseau, la simplification de l’accès aux données et l’amélioration des performances en permettant aux clients de demander uniquement les données dont ils ont besoin.
Netflix a également dû relever des défis spécifiques lors de l’adoption de GraphQL pour l’API Studio, notamment en ce qui concerne la gestion de la complexité du schéma et la garantie que les clients ne puissent accéder qu’aux données qu’ils étaient autorisés à consulter.
Pour relever ces défis, Netflix a développé une solution personnalisée appelée « Netflix GraphQL Federation », qui s’appuie sur la spécification Apollo Federation pour diviser le schéma de l’API Studio en éléments plus petits et plus faciles à gérer. Netflix a également mis en place un système de gestion des autorisations et du contrôle d’accès, qui lui permet de restreindre l’accès des clients à certaines parties du schéma.
Dans leur blog, ils ont également présenté l’évolution de l’architecture de leur API, passée d’un monolithe à une passerelle fédérée. La figure 5 est une adaptation de l’illustration publiée dans leur article.
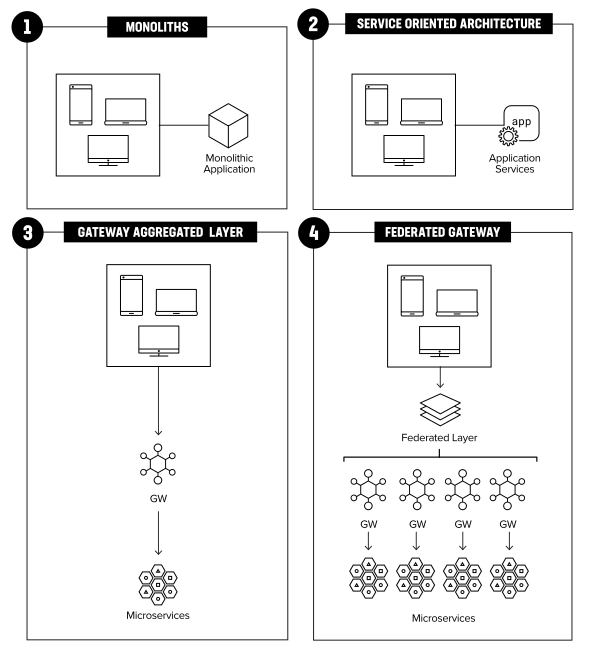
Nous pensons qu’il existe une autre approche, peut-être répandue dans le secteur, mais qui n’a pas encore été formalisée.
Il serait possible de combiner la couche d’agrégation des passerelles et la passerelle fédérée de la figure 5, comme illustré ci-dessous :
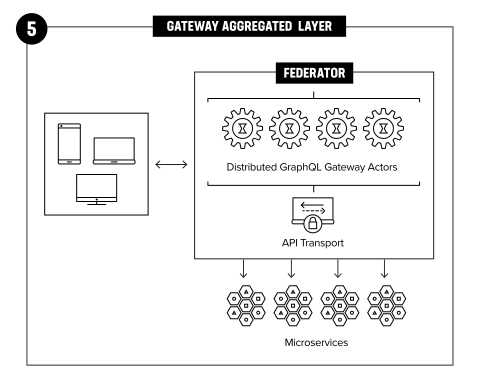
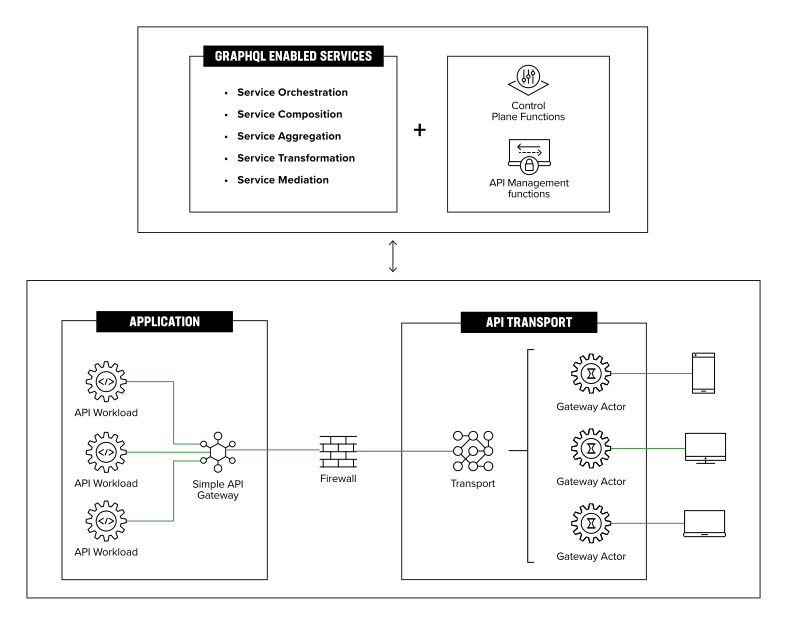
Chaque icône d’engrenage représente essentiellement une instance GraphQL éphémère et fédérée (également appelée acteur de passerelle), qui peut être instanciée en temps réel (voire pour chaque transaction) en périphérie, c’est-à-dire topologiquement à proximité des clients, et se connecter aux microservices via un transport d’API sécurisé. Cette combinaison remplace en substance la couche d’agrégation de passerelle, ou couche fédérée, par des acteurs de passerelle distribués qui réunissent le meilleur des deux fonctionnalités. Nous appelons cela l’architecture d’acteurs de passerelle GraphQL distribués, comme illustré à la figure 7.
AUTRES PIONNIERS
PayPal
PayPal a entamé son parcours avec GraphQL en 2018, lorsqu’il l’a intégré à son application de paiement. Comme Meta, PayPal reprochait principalement à REST que ses principes de conception ne soient pas optimisés pour les applications web et mobiles ni pour leurs utilisateurs. Les applications clientes multipliaient les allers-retours entre le client et le serveur, et la récupération des données prenait environ 700 ms. Cela ralentissait l’affichage, frustrait les utilisateurs et réduisait les taux de conversion. Pour son application de paiement, PayPal a constaté que les développeurs d’interfaces utilisateur (UI) consacraient moins d’un tiers de leur temps à la création de l’interface, le reste étant consacré à déterminer comment récupérer et traiter les données.
Les autres technologies envisagées par l’équipe d’ingénierie de PayPal étaient les API d’orchestration et Bulk REST. La création d’une API d’orchestration entraînerait une récupération excessive de données et un couplage des clients au serveur. PayPal a conclu qu’au fil du temps, cette approche pouvait rendre l’API lourde, peu élégante et l’amener à remplir plusieurs fonctions. Leur expérimentation de Bulk REST s’est également révélée infructueuse. Si elle évitait à l’équipe d’ingénierie d’avoir à ajuster les API d’orchestration, elle exigeait en revanche que les clients connaissent parfaitement le fonctionnement des API.
La première expérience de PayPal avec GraphQL pour développer un nouveau produit a été la création d’un SDK mobile permettant d’intégrer PayPal Checkout dans des applications. Après une semaine d’évaluation de GraphQL, l’équipe d’ingénierie a décidé de l’utiliser pour son nouveau produit. Bien que l’API ne soit pas encore prête, elle a tout de même pu terminer le produit en avance, sans qu’il soit nécessaire de disposer de connaissances spécifiques à PayPal. Les développeurs ont pu créer rapidement une application performante et conviviale, ce qui a convaincu l’équipe d’ingénierie d’adopter pleinement GraphQL dans sa pile technologique.
Starbucks
Starbucks a fait appel à un prestataire externe pour développer son application web progressive (PWA).
L’équipe a été chargée de créer un système de commande capable de prendre en charge efficacement une logique métier complexe. Les clients pouvant personnaliser leurs commandes, l’équipe de développement devait s’assurer que le système puisse gérer plusieurs cas de logique métier spécifique et transmettre les bonnes données au bon endroit, au bon moment.
GraphQL a permis à l’équipe de créer une API performante, avec une mise en cache et un rendu côté serveur afin d’améliorer les fonctionnalités hors ligne. L’équipe a également utilisé React pour intégrer des animations et ainsi créer une expérience utilisateur dynamique et captivante.
GraphQL chez F5
L’objectif du bureau du CTO de F5 était de déterminer comment utiliser GraphQL au sein de l’écosystème F5. Nous menons actuellement deux projets visant à explorer l’utilisation de GraphQL.
AMÉLIORATION DES MODÈLES DE DONNÉES ET DE LA VISIBILITÉ
La suite de gestion des tests (TMS) proposée par F5 permet aux clients de tester les points de terminaison ou les clients de leurs propres systèmes afin de déterminer s’il s’agit d’humains ou de bots.
Il s’agissait d’un projet à usage interne visant à rationaliser le développement et les tests du logiciel TMS. L’objectif principal était d’extraire les données JSON enfermées dans la base de données SQL existante, de les convertir en données de graphe et de mettre en œuvre une API GraphQL permettant de les interroger.
Cette évolution était nécessaire, car la base de données actuelle présente plusieurs difficultés, notamment le « problème des blobs JSON », qui résulte du stockage de métadonnées sous forme d’objets JSON dans une base de données tabulaire. L’analyse et le traitement de ces objets sont intrinsèquement coûteux et inefficaces. En outre, du fait de leur structure en graphe, les blobs JSON contiennent des données précieuses susceptibles d’améliorer davantage les produits et la sécurité de F5. Le passage à une base de données orientée graphe permet d’analyser et de gérer efficacement les blobs JSON au moyen de relations orientées, optimisant ainsi le transfert et l’exploitation des données.
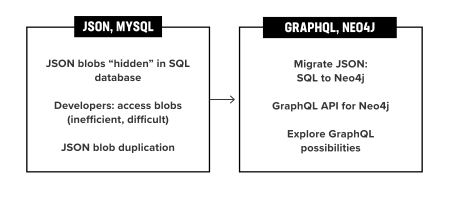
Les résultats sont encourageants. En identifiant les tables de la base de données relationnelle du TMS qui contiennent des blobs JSON, nous avons déterminé que le passage à une GraphDB et l’utilisation de GraphQL pourraient considérablement améliorer notre visibilité sur le système.
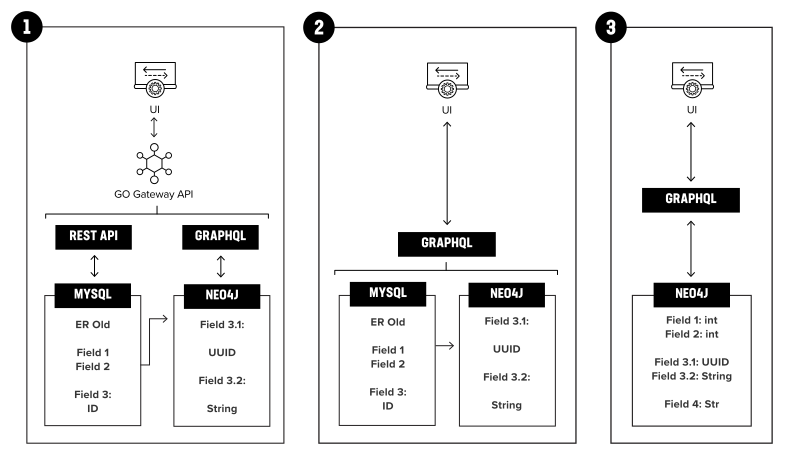
La figure 9 présente les évolutions possibles ou les choix de mise en œuvre pour ce projet. Chaque choix a ses propres implications.
L’option 1 a le moins d’impact sur l’interface utilisateur, car le client n’a pas besoin d’être modifié. Un mode hybride, comme dans les options 1 ou 2, peut être adapté selon la situation, en particulier lorsque le nombre de colonnes contenant des objets JSON est réduit. En outre, le schéma dérivé pour chaque objet JSON serait également peu volumineux.
Mais lors de la planification, nous nous sommes rendu compte que les objets JSON nécessitaient des informations contextuelles stockées dans d’autres colonnes de la base de données SQL. Le schéma stocké dans chaque objet JSON était également assez volumineux. Cela aurait alourdi la maintenance de la base de code. Après mûre réflexion, nous avons donc décidé de repenser l’architecture de l’application afin de prendre en charge GraphQL et Neo4J, comme indiqué dans l’option 3.
INTÉGRATION DE CLOUDGRAPH
CloudGraph est une API GraphQL universelle, gratuite et open source, ainsi qu’un outil de gestion de la posture de sécurité du cloud (CSPM) pour AWS, Azure, GCP et Kubernetes (K8s). L’objectif du projet est d’utiliser CloudGraph pour créer un « plugin CloudGraph » (figure 10) permettant d’y afficher les données de F5 Distributed Cloud (F5XC) et ainsi d’améliorer la visibilité sur les ressources cloud connectées à l’aide de F5 Distributed Cloud.
Notre objectif est de réaliser une intégration avec CloudGraph afin d’acquérir une compréhension approfondie de cette technologie et de développer à l’avenir des intégrations CloudGraph, des analyses et des API GraphQL pour les données F5XC.
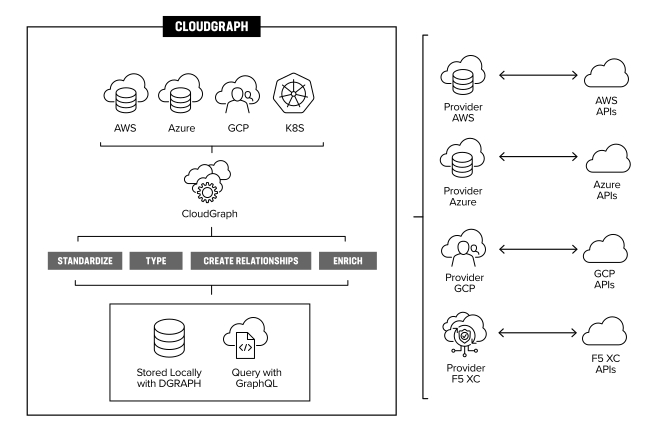
Après avoir intégré le fournisseur F5XC personnalisé à la plateforme CloudGraph et utilisé la fonctionnalité de création de relations de la plateforme, nous bénéficierons d’une meilleure visibilité sur les ressources cloud connectées via F5XC et sur leurs relations avec d’autres clouds. Nous pourrons alors générer des requêtes complexes portant sur les ressources de plusieurs clouds pour un même locataire. Cela nous permettra de fournir aux parties prenantes une vue d’ensemble complète de F5XC et d’envisager une intégration plus poussée de CloudGraph afin d’ajouter des plugins GraphQL et des analyses personnalisées pour les opérations cloud pertinentes pour F5 et ses clients.
Sur la base des initiatives ci-dessus, notre exploration initiale s’est révélée conforme aux expériences décrites dans les études de cas présentées précédemment.
Problèmes de sécurité liés à GraphQL
Les premières perceptions selon lesquelles GraphQL serait supérieur à REST en matière de sécurité ont été démenties, car GraphQL, comme toute autre technologie, comporte ses propres risques s’il n’est pas correctement mis en œuvre. Il est important de reconnaître que GraphQL n’est pas intrinsèquement plus sécurisé que les autres technologies. Une mise en œuvre adéquate et le respect des bonnes pratiques sont essentiels pour garantir la sécurité des API GraphQL. En dissipant ce mythe, nous pouvons aborder GraphQL avec une compréhension réaliste de ses enjeux de sécurité et prendre les mesures appropriées pour atténuer les risques potentiels.
ATTAQUE PAR INTROSPECTION
GraphQL fournit aux développeurs un outil puissant appelé introspection, qui leur permet de demander des informations sur le schéma utilisé par un service GraphQL. Cet outil leur permet de mieux comprendre le service et sa structure. Cependant, l’introspection comporte des risques. Activer l’introspection sur un service GraphQL en production signifie que les informations sensibles contenues dans le schéma peuvent également être consultées. Cela présente un risque important, car des utilisateurs malveillants peuvent exploiter l’introspection pour obtenir des données sensibles et potentiellement causer des dommages. En outre, l’introspection permet à ces utilisateurs d’identifier facilement des opérations potentiellement dangereuses, puisqu’ils peuvent consulter l’intégralité du schéma et déterminer les requêtes à exécuter. Les conséquences d’une telle fuite peuvent être désastreuses, selon la nature du schéma et des données qu’il contient.
Atténuation : une solution pour atténuer les risques liés à l’introspection consiste à la désactiver dans les API de production à l’aide de différents frameworks. En désactivant l’introspection, les développeurs perdent certaines des fonctionnalités pratiques qu’elle offre. Toutefois, pour en retrouver les avantages, ils peuvent enregistrer le schéma GraphQL de l’API de production auprès d’outils tels que GraphOS. Ils conservent ainsi un accès contrôlé au schéma et aux informations qu’il contient.
INJECTION SQL
L’injection SQL est une attaque largement connue et répandue, dont les risques vont de la manipulation des données à la suppression complète de la base de données. Cette attaque simple exploite la concaténation de chaînes de caractères pour permettre à un attaquant d’insérer du code exécutable dans les données saisies, d’accéder sans autorisation à la base de données et d’y apporter des modifications malveillantes. Fait intéressant, ce vecteur d’attaque ne se limite pas aux bases de données SQL : il peut également toucher des bases de données orientées graphe comme Neo4j. Neo4j utilise le langage de requête Cypher, qui ressemble à SQL et en partage les vulnérabilités. Ce type d’attaque, appelé injection Cypher, exploite ces similitudes, mais bénéficie également des solutions existantes, sans qu’il soit nécessaire d’en inventer de nouvelles.
Atténuation: Les contre-mesures consistent notamment à assainir les entrées utilisateur afin de détecter et d’empêcher toute exploitation, ainsi qu’à utiliser la paramétrisation pour dissocier les entrées utilisateur de la création directe des requêtes. Ces mesures réduisent efficacement le risque d’attaques par injection. Il est essentiel de traiter ce problème de sécurité dans les implémentations GraphQL, mais il existe heureusement des solutions bien connues et faciles à mettre en œuvre.
ATTAQUE DE L’API PROXY REST
La superposition d’une API GraphQL à une API REST peut entraîner des vulnérabilités de falsification de requête côté serveur (SSRF). Les attaquants peuvent les exploiter en modifiant les paramètres envoyés à l’API REST par l’intermédiaire du proxy GraphQL. Si aucune des deux API ne valide les paramètres pour des appels spécifiques, les attaquants peuvent prendre le contrôle du système backend. Par exemple, l’ajout de « /delete » à l’identifiant d’un utilisateur dans une requête GraphQL peut entraîner la suppression involontaire de données lorsque cet identifiant est transmis à l’API REST.
Atténuation: Bien que cette vulnérabilité constitue une préoccupation légitime, elle peut être efficacement corrigée en définissant des types dans le schéma GraphQL et en validant rigoureusement les paramètres avant de les envoyer à des API ou services externes. Il est important de noter que cette vulnérabilité, comme d’autres associées à GraphQL, découle de problèmes d’implémentation et non de défauts inhérents à GraphQL lui-même. Ces problèmes surviennent lorsque GraphQL est mal utilisé en raison d’une vision à court terme, alors même que cette technologie est très prometteuse.
ATTAQUES PAR REGROUPEMENT
Les vulnérabilités d’authentification constituent un vecteur d’attaque courant dans divers systèmes, notamment GraphQL. La possibilité offerte par GraphQL d’envoyer plusieurs requêtes ou mutations au sein d’une même requête HTTP l’expose aux attaques par traitement groupé, qui reposent sur des méthodes de force brute.
Le premier type d’attaque consiste à trouver des mots de passe de connexion par force brute. Les attaquants envoient une requête comportant de nombreuses mutations contenant des paires d’identifiants de connexion. Comme GraphQL autorise plusieurs mutations dans une même requête, cette attaque contourne les contrôles de limitation du débit et permet de créer une session en trouvant les mots de passe par force brute.
Le deuxième type d’attaque fonctionne de manière similaire, mais cible une forme courante d’authentification à deux facteurs (2FA) appelée mot de passe à usage unique (OTP). Une seule requête est envoyée avec plusieurs mutations, chacune contenant des identifiants de connexion valides associés à un code OTP différent. Si l’une des mutations contient le bon code OTP, la requête sera authentifiée et une session sera établie.
Atténuation: La correction de ces vulnérabilités nécessite une approche globale, car il n’existe aucune solution infaillible. Les développeurs jouent un rôle crucial en adoptant des pratiques de codage sécurisé et en accordant une attention particulière à la logique métier. Côté serveur web, il est essentiel de mettre en œuvre des mesures telles que la limitation des tentatives de connexion et la validation des saisies utilisateur. En outre, il convient de rechercher tout particulièrement la présence de plusieurs mutations dans les requêtes, car une tentative de connexion légitime ne comporte généralement pas plus d’une mutation.
ATTAQUE PAR DÉNI DE SERVICE
Ces attaques consistent à submerger le service GraphQL avec un trafic excessif, le rendant incapable de traiter les requêtes des utilisateurs légitimes et pouvant entraîner des pannes de serveur. Les attaques par déni de service (DoS) peuvent être menées au moyen de requêtes GraphQL récursives ou par l’envoi de requêtes volumineuses.
Dans le scénario d’une requête récursive, les attaquants exploitent la nature cyclique des définitions du schéma GraphQL. Par exemple, si le schéma comprend les types « auteur » et « livre », un attaquant peut interroger de manière répétée l’auteur et le livre en boucle, submergeant ainsi le serveur d’appels récursifs et perturbant son fonctionnement.
Les attaquants peuvent également envoyer des requêtes demandant une quantité considérable de données à la base de données. Par exemple, une requête peut récupérer de nombreux auteurs ainsi que tous les livres qui leur sont associés. Une demande de données aussi volumineuse peut ralentir considérablement le système, voire le faire planter.
Atténuation : plusieurs solutions permettent d’atténuer ce problème. La première consiste à définir un délai d’expiration pour les requêtes, afin d’empêcher les utilisateurs d’effectuer des demandes dont la durée dépasse une limite donnée. Toutefois, cela peut ne pas suffire à résoudre entièrement le problème, car des dommages peuvent tout de même survenir dans le délai imparti. Une autre solution consiste à limiter la profondeur et la complexité des requêtes. Les requêtes qui dépassent les limites définies en matière de profondeur ou de complexité et qui s’écartent de la définition du schéma peuvent être rejetées. Enfin, la limitation du débit des utilisateurs peut s’avérer efficace. Si un utilisateur envoie un grand nombre de requêtes ou plusieurs requêtes consécutives, son accès au serveur peut être temporairement bloqué jusqu’à ce que celui-ci soit prêt à traiter de nouvelles requêtes.
Modèles de déploiement de GraphQL
Il existe plusieurs modèles de déploiement pour GraphQL, comme illustré, chacun présentant ses propres compromis et considérations. Parmi les modèles les plus courants figurent :
DÉPLOIEMENT MONOLITHIQUE
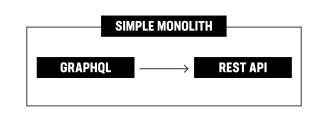
Il s’agit du modèle le plus simple et le plus courant pour déployer une API GraphQL. Dans un déploiement monolithique, le serveur GraphQL, la base de données et tous les autres services nécessaires sont déployés ensemble comme une seule unité. Cette approche permet de démarrer facilement avec GraphQL, mais peut devenir difficile à faire évoluer et à maintenir à mesure que l’application se développe.
MONOLITHES COMPOSÉS
Les monolithes composés désignent une architecture dans laquelle une application monolithique est construite en combinant des monolithes et des microservices, GraphQL faisant office de couche API (figure 12). Dans ce modèle, au lieu de décomposer l’ensemble du système en microservices distincts, l’application est initialement développée sous la forme de monolithes séparés, qui encapsulent toute la logique métier et les couches d’accès aux données.
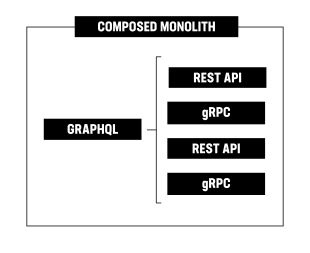
Au sein de cette structure monolithique, GraphQL fait office de couche API, permettant aux clients de demander et de récupérer des données provenant de différents microservices sous-jacents. Ainsi, bien que l’application reste monolithique du point de vue du déploiement, elle utilise GraphQL pour agréger les données issues de divers services et les présenter aux clients de manière flexible et efficace.
Ce modèle offre plusieurs avantages, notamment une simplification du développement et du déploiement, ainsi que la possibilité de tirer parti des puissantes fonctionnalités d’interrogation et de récupération de données de GraphQL. Il permet aux développeurs d’adopter progressivement une architecture de microservices tout en continuant à bénéficier de la flexibilité et de la facilité d’utilisation offertes par GraphQL.
SOUS-GRAPHES FÉDÉRÉS
Dans les modèles de déploiement GraphQL, les graphes fédérés consistent à combiner plusieurs services GraphQL, appelés sous-graphes, au sein d’un schéma GraphQL unique et unifié. Chaque sous-graphe représente un domaine ou un microservice distinct, avec ses propres données et fonctionnalités. Cette architecture s’appuie sur une passerelle centrale qui achemine les requêtes des clients vers le sous-graphe approprié en fonction des champs demandés. En fédérant ces sous-graphes, les développeurs peuvent créer un graphe cohérent dans lequel les clients peuvent interroger et parcourir différents services de manière transparente.
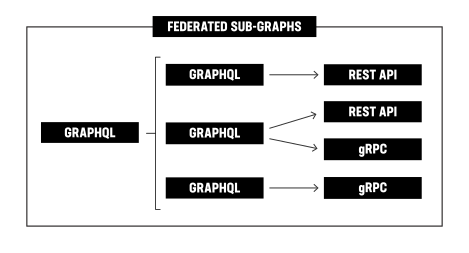
Cette approche favorise la modularité, l’évolutivité et le développement indépendant des services, ce qui améliore les performances et la flexibilité lors de la création d’API GraphQL. Les sous-graphes fédérés (figure 13) offrent un moyen puissant de combiner les données de différents services et de créer une architecture distribuée et évolutive.
GRAPHES HYBRIDES
Les graphes hybrides (figure 14) utilisés dans les modèles de déploiement GraphQL combinent des sous-graphes fédérés et des schémas non fédérés au moyen de techniques d’assemblage. Cette approche permet aux organisations d’intégrer des API GraphQL existantes ou des systèmes hérités à des microservices fédérés, afin d’obtenir une API GraphQL unifiée qui tire parti des avantages des deux approches. En fusionnant les schémas et en résolvant les relations entre les types et les champs, l’architecture de graphe hybride offre flexibilité, modularité et évolutivité.
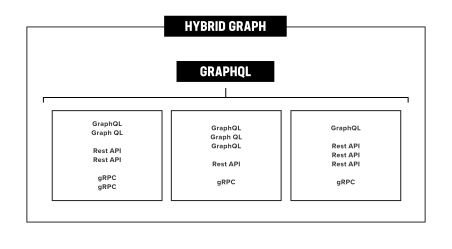
Le modèle de graphe hybride permet aux organisations d’adopter progressivement la fédération tout en tirant parti de leurs ressources existantes. Il permet d’intégrer de manière fluide des sous-graphes fédérés et des schémas non fédérés, afin de répondre à des exigences variées et de favoriser l’interopérabilité. Cette approche permet aux organisations de créer des API GraphQL complètes, capables d’évoluer et de s’adapter à leurs besoins futurs. En combinant les atouts des services fédérés et non fédérés, les graphes hybrides offrent une solution flexible et puissante pour créer des déploiements GraphQL.
Les défis liés aux graphes hybrides dans les déploiements GraphQL comprennent la gestion de la complexité des schémas fusionnés, la prise en compte de l’éventuelle surcharge de performances, la garantie de la cohérence et de l’intégrité des données, la gestion de l’évolution et du versionnage du système, ainsi que la maîtrise des difficultés de supervision et de débogage au sein d’une architecture distribuée. Pour relever ces défis et assurer le bon fonctionnement des déploiements de graphes hybrides, une planification rigoureuse, des optimisations et de solides pratiques de développement sont indispensables.
ROUTAGE SANS SERVEUR
Ce modèle consiste à déployer l’API GraphQL sous la forme d’un ensemble de fonctions sans serveur, telles qu’AWS Lambda ou Google Cloud Functions. Cette approche peut permettre de déployer une API GraphQL de manière économique et évolutive, mais elle peut également entraîner une latence supplémentaire et accroître la complexité de l’architecture.
Le routage serverless présente de nombreux défis. L’un d’eux consiste à connecter de manière fluide des sous-graphes distribués à mesure que l’application se développe. La coordination de plusieurs équipes et déploiements peut devenir complexe, ce qui complique la gestion et la mise à l’échelle efficaces des sous-graphes. Garantir la cohérence et la synchronisation des données entre ces sous-graphes constitue un autre obstacle. La supervision et le débogage dans un environnement serverless distribué peuvent être plus difficiles et nécessitent des mécanismes appropriés de journalisation et de gestion des erreurs. En outre, la gestion du contrôle d’accès et des autorisations entre plusieurs fonctions serverless et sous-graphes pose également des difficultés. Il est essentiel de relever ces défis pour assurer le bon fonctionnement et l’évolutivité d’un déploiement GraphQL basé sur une architecture serverless.
DÉPLOIEMENT EN PÉRIPHÉRIE
Dans un modèle de déploiement en périphérie pour les API GraphQL, l’API est rapprochée des clients grâce à un service CDN. Cette approche offre plusieurs avantages, notamment une latence plus faible pour des réponses plus rapides, une charge réduite sur le serveur d’origine et une protection contre les attaques DDoS.
En répartissant l’infrastructure de l’API sur des serveurs périphériques dans le monde entier, il est possible de gérer le trafic plus efficacement et d’offrir une meilleure expérience utilisateur à l’échelle mondiale. Les capacités de mise en cache et de filtrage du CDN contribuent à améliorer l’évolutivité et à garantir la disponibilité de l’API, même en cas de trafic intense ou d’attaques malveillantes. Les déploiements en périphérie peuvent optimiser les performances et la fiabilité d’une API en tirant parti du réseau de serveurs des CDN.
Conclusion
Les technologies GraphQL ont atteint un niveau de maturité suffisant pour être adoptées par les entreprises traditionnelles. Bien que le Hype Cycle 2022 de Gartner pour les API indique qu’il faudra encore plusieurs années avant qu’elles ne soient largement adoptées, nous avons désormais atteint un tournant décisif où les outils nécessaires sont déjà disponibles. Bien que GraphQL soit encore relativement récent, il a suffisamment évolué pour répondre aux besoins des grandes entreprises bien établies.
La maturité des technologies GraphAPI repose sur le nombre croissant d’entreprises qui adoptent GraphQL et d’autres technologies de bases de données orientées graphe. À mesure que ces technologies sont adoptées par un nombre toujours plus important d’entreprises, les outils et les ressources nécessaires à leur prise en charge deviennent de plus en plus accessibles, ce qui permet à d’autres entreprises de leur emboîter plus facilement le pas. En outre, les avantages des technologies GraphAPI — tels que l’amélioration de l’interrogation des données et la réduction de la complexité — sont de plus en plus largement reconnus, ce qui favorise encore davantage leur adoption par les entreprises.
En tant que secteur, nous devons reconnaître l’importance des technologies GraphAPI telles que GraphQL et leur capacité à dépasser les limites de REST. Les entreprises ne doivent pas négliger l’urgence d’investir dans GraphQL et d’en comprendre le fonctionnement, notamment en matière de modélisation des données, de diversité et d’opacité. S’il est facile de se laisser séduire par les fonctionnalités et le potentiel de GraphQL, nous devons également tenir compte du risque de désillusion après le pic des attentes démesurées. Les fournisseurs doivent accorder la priorité à l’amélioration de leurs produits afin de prendre pleinement en charge GraphQL, tandis que les services informatiques des entreprises — fournisseurs compris — doivent déterminer quelles données gagneraient à être exposées via GraphQL afin d’améliorer la productivité.
Les clients doivent s’attacher en priorité à bien comprendre leurs données et reconnaître qu’une entreprise moyenne fonctionne différemment des hyperscalers qui ont initialement introduit GraphQL. Travaillons ensemble pour adopter GraphQL comme un modèle d’architecture logicielle efficace et faire progresser le secteur vers davantage de productivité et d’innovation.