
Équilibrage de charge : les fondamentaux
Introduction
Sur le marché actuel, dynamique et centré sur les applications, les entreprises sont soumises à une pression croissante pour fournir les informations, les services et les expériences attendus par leurs clients, et ce, de manière rapide, fiable et sécurisée. Les principales fonctions réseau et applicatives, telles que l’équilibrage de charge, le chiffrement, l’accélération et la sécurité, peuvent être assurées par des contrôleurs de mise à disposition d’applications (ADC), des appliances physiques ou virtuelles qui font office de proxys pour les serveurs physiques. Compte tenu de l’essor fulgurant des applications et des exigences imposées aux entreprises par le cycle rigoureux d’intégration continue et de déploiement continu (CI/CD), il n’est pas étonnant que le marché des ADC devrait atteindre 2,9 milliards de dollars par an d’ici 2020.1
Mais avant de nous tourner vers l’avenir, voyons comment nous en sommes arrivés là. L’équilibrage de charge réseau constitue le socle essentiel sur lequel reposent les contrôleurs de mise à disposition d’applications (ADC). Au milieu des années 1990, les premiers équipements matériels d’équilibrage de charge ont commencé à aider les entreprises à faire évoluer leurs applications en répartissant les charges de travail entre les serveurs et les réseaux. Ces premiers dispositifs étaient indépendants des applications et se trouvaient en dehors des serveurs d’applications eux-mêmes, ce qui leur permettait d’équilibrer la charge à l’aide de techniques réseau simples. En pratique, ces dispositifs présentaient une « adresse IP virtuelle » au monde extérieur et, lorsque des utilisateurs tentaient de se connecter, ils transféraient la connexion vers le serveur physique le plus approprié en effectuant une traduction bidirectionnelle d’adresses réseau (NAT).
Cependant, avec l’avènement de la virtualisation et du cloud computing, une nouvelle génération d’ADC d’équilibrage de charge a vu le jour sous la forme d’éditions virtuelles fournies sous forme logicielle et conçues pour fonctionner sur des hyperviseurs. Aujourd’hui, les appliances virtuelles peuvent fournir des services applicatifs avec une gamme de fonctionnalités aussi étendue que celles exécutées sur du matériel dédié. En outre, ces éditions virtuelles éliminent une grande partie de la complexité liée au déplacement des services applicatifs entre des environnements virtuels, cloud et hybrides, ce qui permet aux entreprises de déployer rapidement et facilement des services applicatifs dans des environnements de cloud privé ou public.
La tendance la plus récente à faire son apparition dans les centres de données est la conteneurisation, une méthode de virtualisation des applications qui facilite le déploiement et l’exécution d’applications distribuées. Ce processus isole les applications et les confine dans des espaces mémoire clairement délimités sur un système d’exploitation partagé, ce qui rend le développement et le déploiement d’une application non seulement plus simples, mais aussi plus rapides que la création d’une appliance virtuelle. Grâce aux améliorations considérables en matière de portabilité et de performances, la conteneurisation pourrait offrir aux entreprises une évolutivité et une agilité accrues. À l’avenir, les architectures de conteneurs pourraient également aider les organisations à mieux tirer parti des différents environnements cloud.
Les ADC actuels sont issus des premiers répartiteurs de charge et ont évolué grâce au processus de virtualisation des services. Désormais, avec des éditions virtuelles entièrement logicielles, les ADC peuvent non seulement améliorer la disponibilité, mais aussi aider les entreprises à fournir les applications évolutives, performantes et sécurisées dont elles ont besoin. En définitive, tous ces services applicatifs virtualisés, ces déploiements d’infrastructures partagées et ces fonctionnalités de routage intelligent ne seraient toutefois pas possibles sans les bases solides offertes par la technologie de répartition de charge.
Pour comprendre comment les entreprises peuvent mieux relever les défis complexes d’un marché en constante évolution, explorons les fondements de la fourniture d’applications : les principes de base de l’équilibrage de charge.
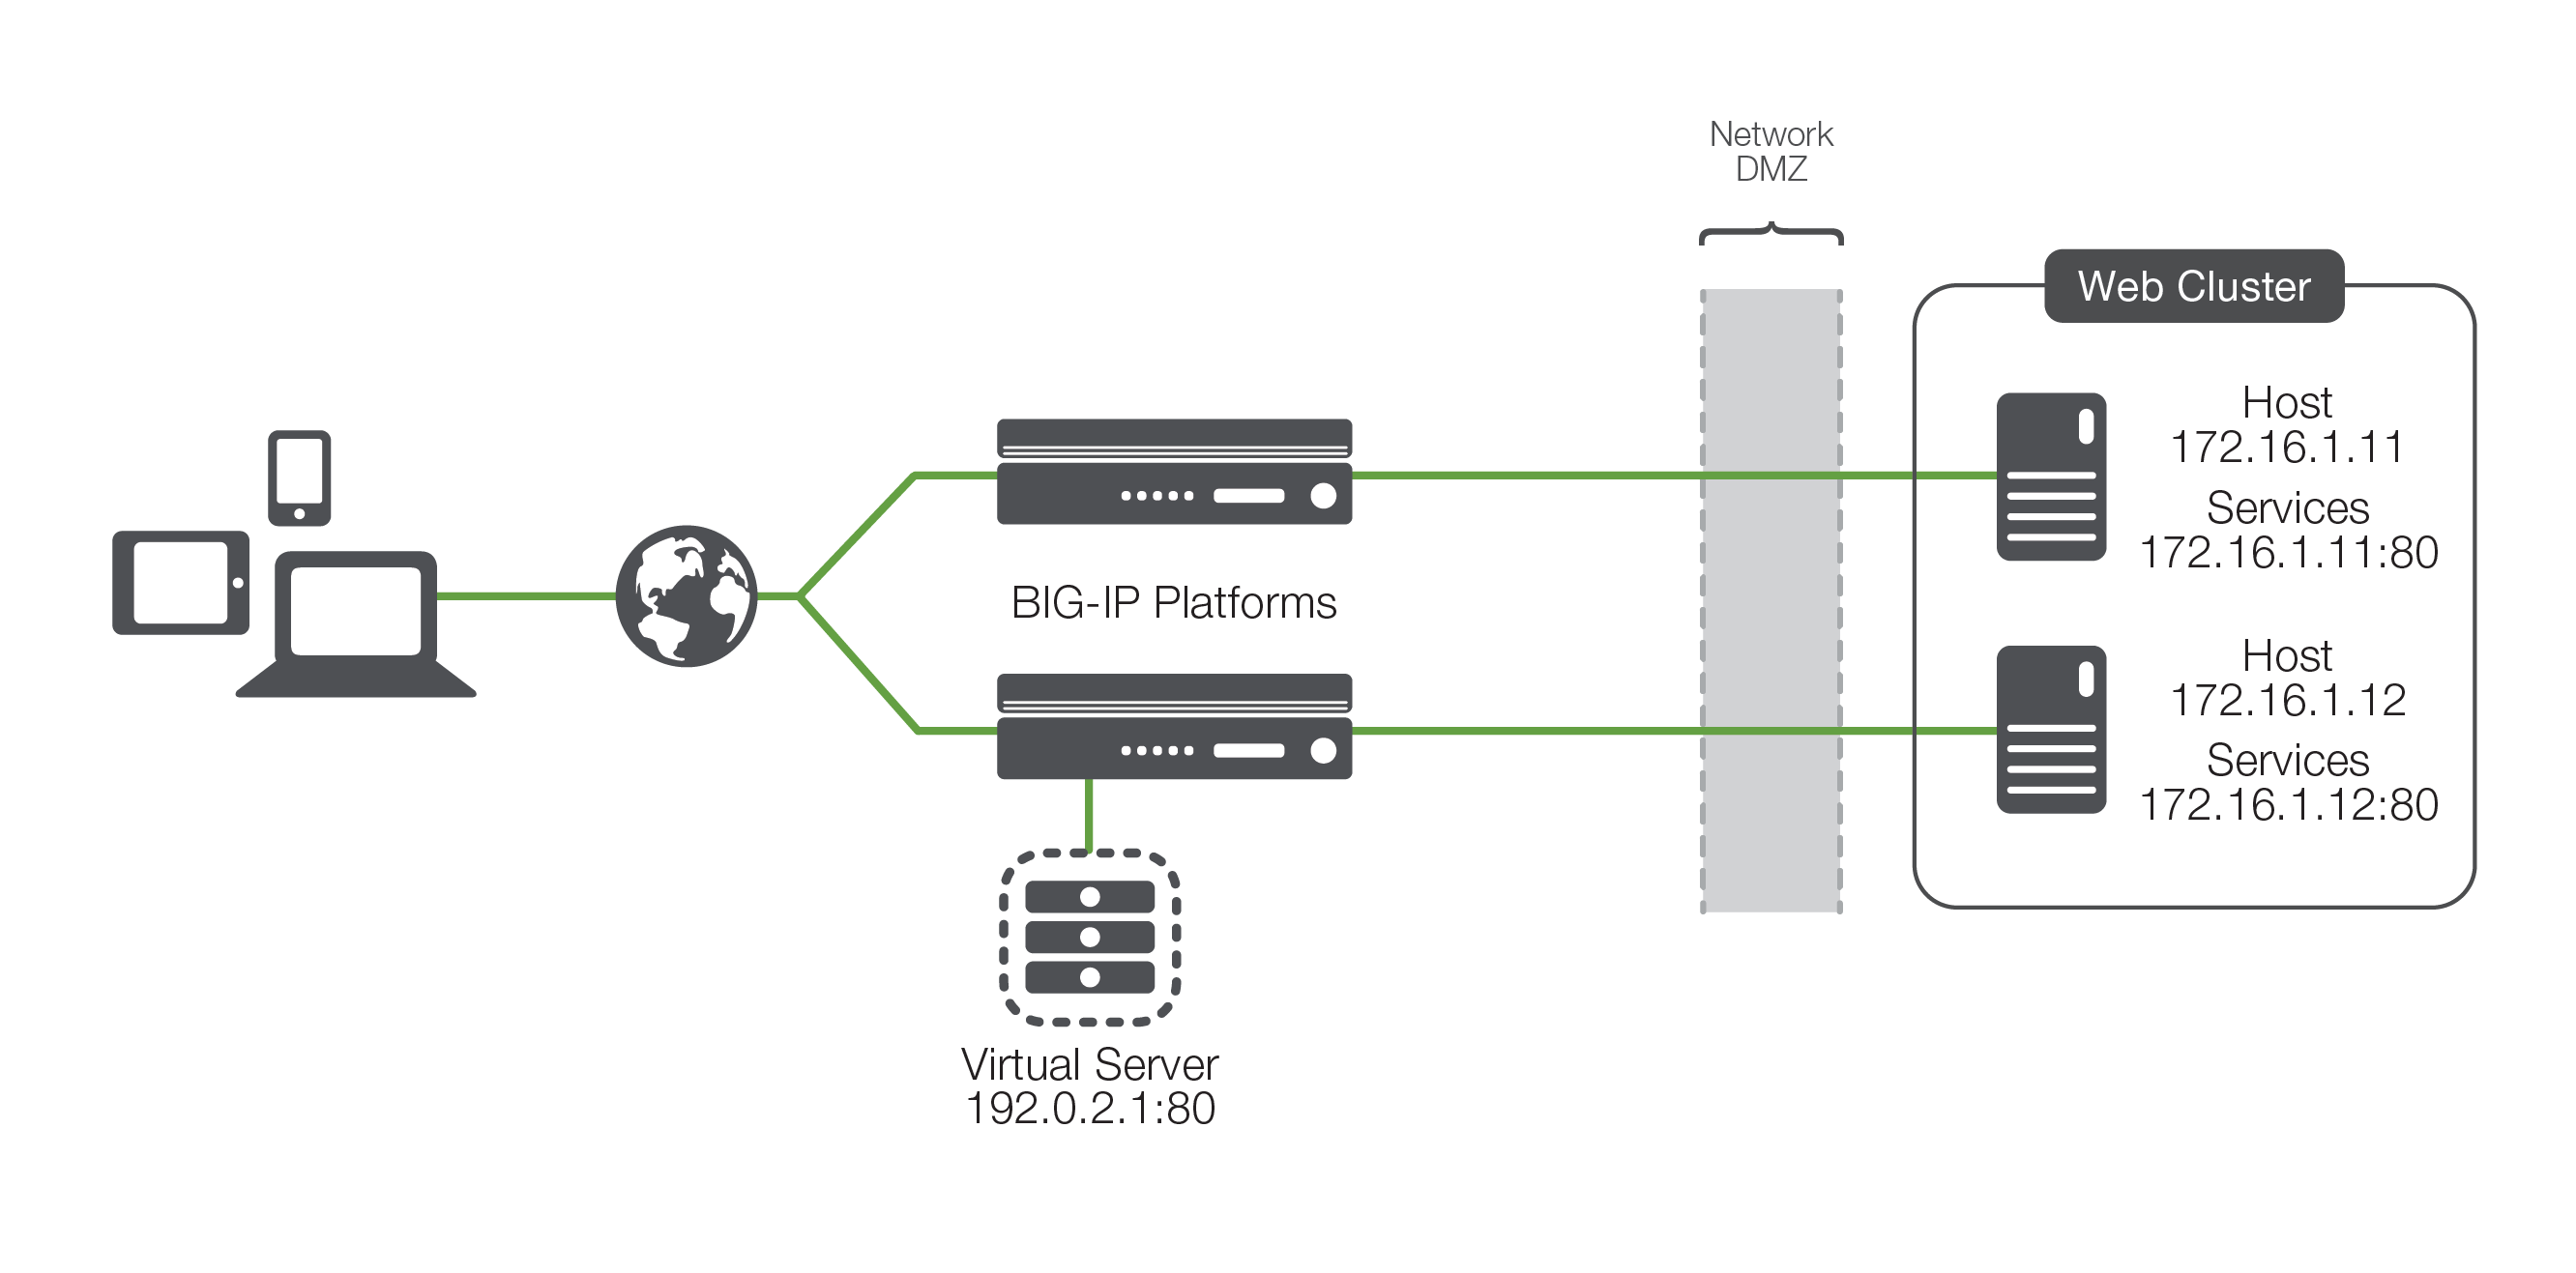
Les bases : terminologie
Avant de commencer, passons en revue la terminologie de base de la répartition de charge. Ce serait plus simple si tout le monde employait le même vocabulaire ; malheureusement, chaque fournisseur de dispositifs de répartition de charge (et, par extension, de contrôleurs de mise à disposition d’applications ou ADC) semble utiliser une terminologie différente. Quelques explications suffiront toutefois à dissiper cette confusion.
Nœud, hôte, membre et serveur
La plupart des contrôleurs de mise à disposition d’applications (ADC) assurant l’équilibrage de charge utilisent les notions de nœud, d’hôte, de membre ou de serveur. Certains emploient les quatre, mais chacune désigne une réalité différente. Tous ces termes visent à exprimer deux concepts fondamentaux. Le premier, généralement appelé « nœud » ou « serveur », désigne le serveur physique ou virtuel lui-même, qui recevra le trafic provenant de l’ADC. Il correspond à l’adresse IP du serveur physique et, en l’absence d’un équilibreur de charge, il s’agirait de l’adresse IP vers laquelle le nom du serveur (par exemple, www.example.com) serait résolu. Dans la suite de ce document, nous désignerons ce concept par le terme « hôte ».
Le second concept est désigné par le terme « membre » (malheureusement également appelé « nœud » par certains fabricants). Un membre est généralement défini de manière un peu plus précise qu’un hôte, car il inclut le port TCP de l’application qui recevra effectivement le trafic. Par exemple, un hôte nommé www.example.com peut être associé à l’adresse 172.16.1.10, qui représente l’hôte, et exécuter une application (un serveur web) sur le port TCP 80, ce qui donne au membre l’adresse 172.16.1.10:80. En termes simples, le membre comprend la définition du port de l’application ainsi que l’adresse IP du serveur physique ou virtuel. Dans la suite de ce document, nous désignerons ce concept par le terme « service ».
Pourquoi une telle complexité ? Parce que la distinction entre un serveur et les services applicatifs qui s’y exécutent permet à l’équilibreur de charge d’interagir individuellement avec les applications plutôt qu’avec le matériel sous-jacent ou l’hyperviseur, que ce soit dans un centre de données ou dans le cloud. Un hôte (172.16.1.10) peut proposer plusieurs services (HTTP, FTP, DNS, etc.). En définissant chaque application de manière unique (172.16.1.10:80, 172.16.1.10:21 et 172.16.1.10:53, par exemple), l’ADC peut appliquer un équilibrage de charge et une surveillance de l’état spécifiques (un concept que nous aborderons plus loin) en fonction des services plutôt que de l’hôte.
N’oubliez pas que la plupart des technologies d’équilibrage de charge utilisent un terme pour désigner l’hôte, ou serveur physique, et un autre pour désigner les services qui y sont disponibles — dans ce cas, simplement « hôte » et « services ».
Pool, cluster et ferme
La répartition de charge permet aux organisations de distribuer le trafic applicatif entrant entre plusieurs destinations back-end, notamment des déploiements dans des clouds publics ou privés. Il est donc nécessaire de disposer d’un concept permettant de regrouper les destinations back-end. Les clusters, comme nous les appellerons (également appelés pools ou fermes), sont des ensembles de services similaires disponibles sur un nombre quelconque d’hôtes. Par exemple, tous les services proposant le site web de l’entreprise seraient regroupés dans un cluster appelé « site web de l’entreprise », tandis que tous les services de commerce électronique seraient regroupés dans un cluster appelé « commerce électronique ».
Serveur virtuel
Un serveur virtuel est un proxy du serveur réel (physique, virtuel ou conteneurisé). Associé à une adresse IP virtuelle, il constitue le point de terminaison de l’application présenté au monde extérieur.
Récapitulatif
Une fois ces termes assimilés, nous maîtrisons les principes de base de la répartition de charge. Le contrôleur de mise à disposition d’applications (ADC) chargé de la répartition de charge présente des serveurs virtuels au monde extérieur. Chaque serveur virtuel pointe vers un cluster de services hébergés sur un ou plusieurs hôtes physiques.
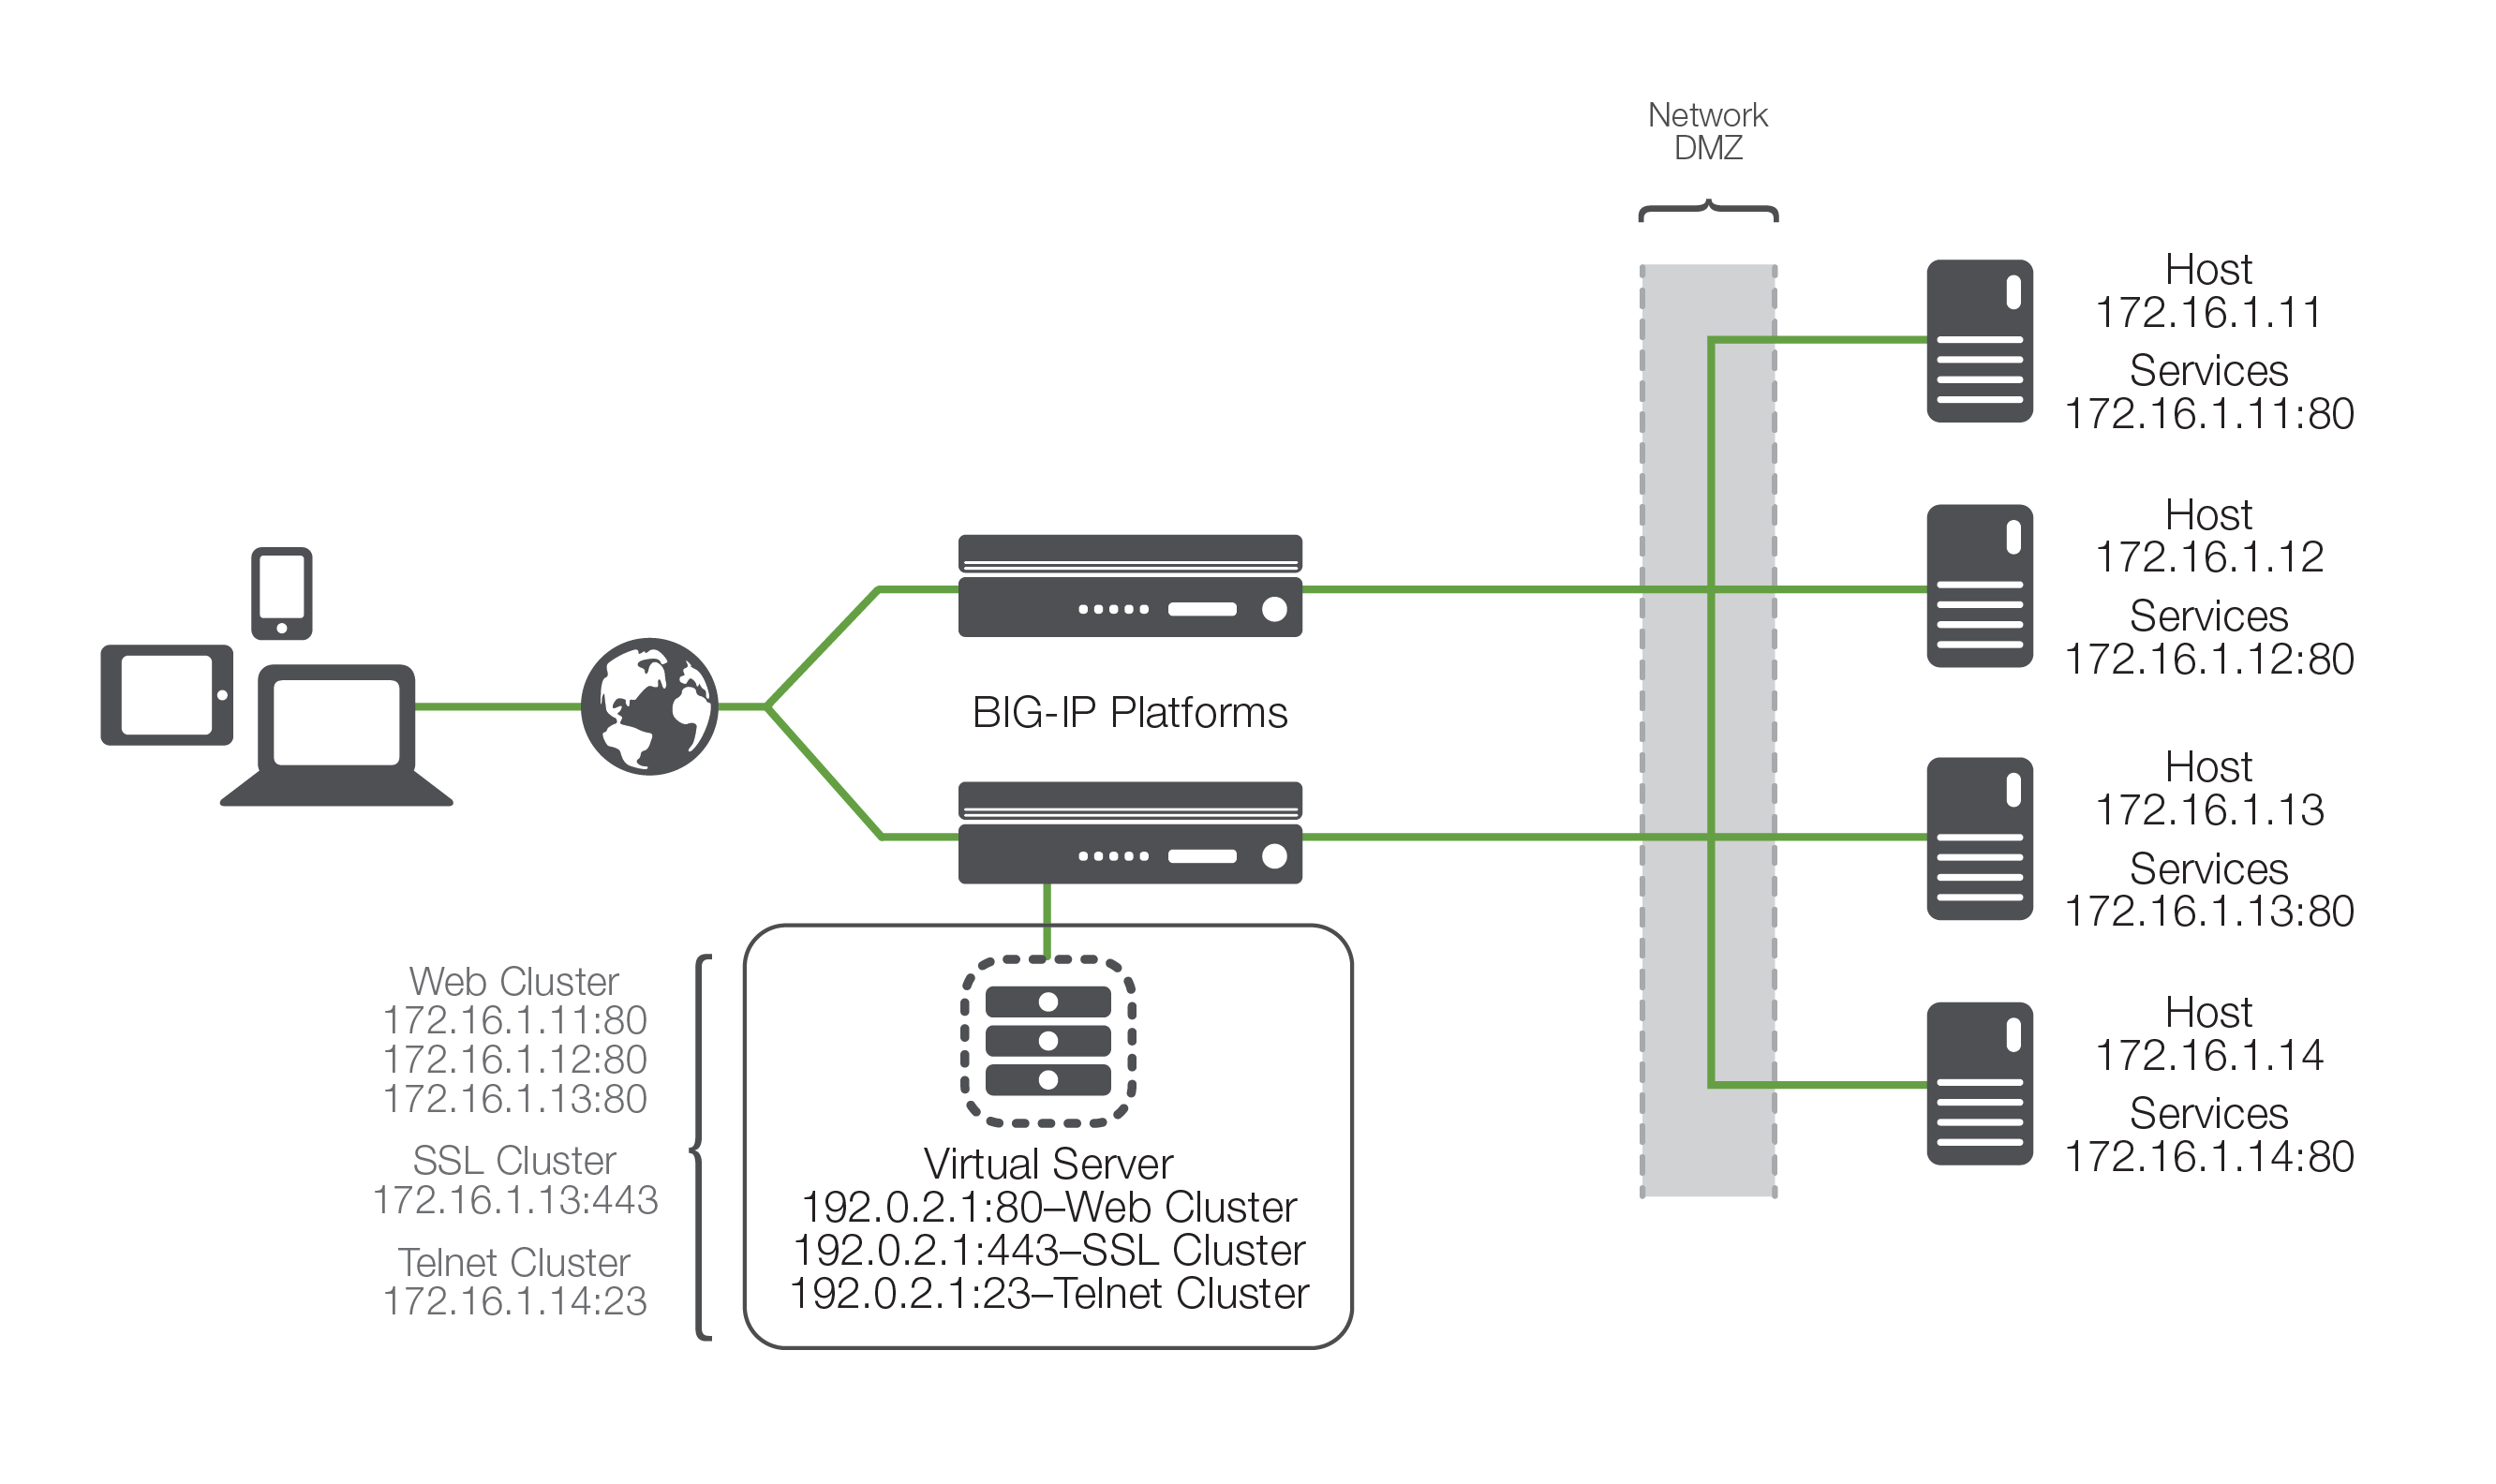
Bien que la figure 2 ne soit pas nécessairement représentative d’un déploiement réel, elle fournit néanmoins la structure fondamentale permettant de poursuivre la discussion sur le processus d’équilibrage de charge et de mise à disposition des applications.
Fonctionnement de l’équilibrage de charge
Maintenant que ce vocabulaire commun est établi, examinons le processus simple par lequel l’application est mise à la disposition du client. Comme illustré, le contrôleur de mise à disposition d’applications (ADC) assurant l’équilibrage de charge est généralement placé en ligne entre le client et les hôtes qui fournissent les services que celui-ci souhaite utiliser. Comme souvent en matière de mise à disposition d’applications, ce positionnement n’est pas une règle, mais plutôt une bonne pratique, quel que soit le type de déploiement. Supposons également que l’ADC soit déjà configuré avec un serveur virtuel pointant vers un cluster composé de deux points de service. Dans ce scénario de déploiement, il est courant que les hôtes disposent d’une route de retour pointant vers l’équilibreur de charge, afin que le trafic de retour soit traité par celui-ci avant de parvenir au client.
La transaction de base pour la fourniture d’applications se déroule comme suit :
- Le client tente de se connecter au service.
- L’ADC accepte la connexion et, après avoir déterminé quel hôte doit la recevoir, modifie l’adresse IP de destination (et éventuellement le port) pour qu’elle corresponde au service de l’hôte sélectionné (à noter que l’adresse IP source du client n’est pas modifiée).
- L’hôte accepte la connexion et répond à la source d’origine, le client, via sa route par défaut, l’ADC.
- L’ADC intercepte le paquet de retour provenant de l’hôte, puis modifie l’adresse IP source (et éventuellement le port) afin qu’elle corresponde à l’adresse IP et au port du serveur virtuel, avant de renvoyer le paquet au client.
- Le client reçoit le paquet de retour, pense qu’il provient du serveur virtuel et poursuit le processus.
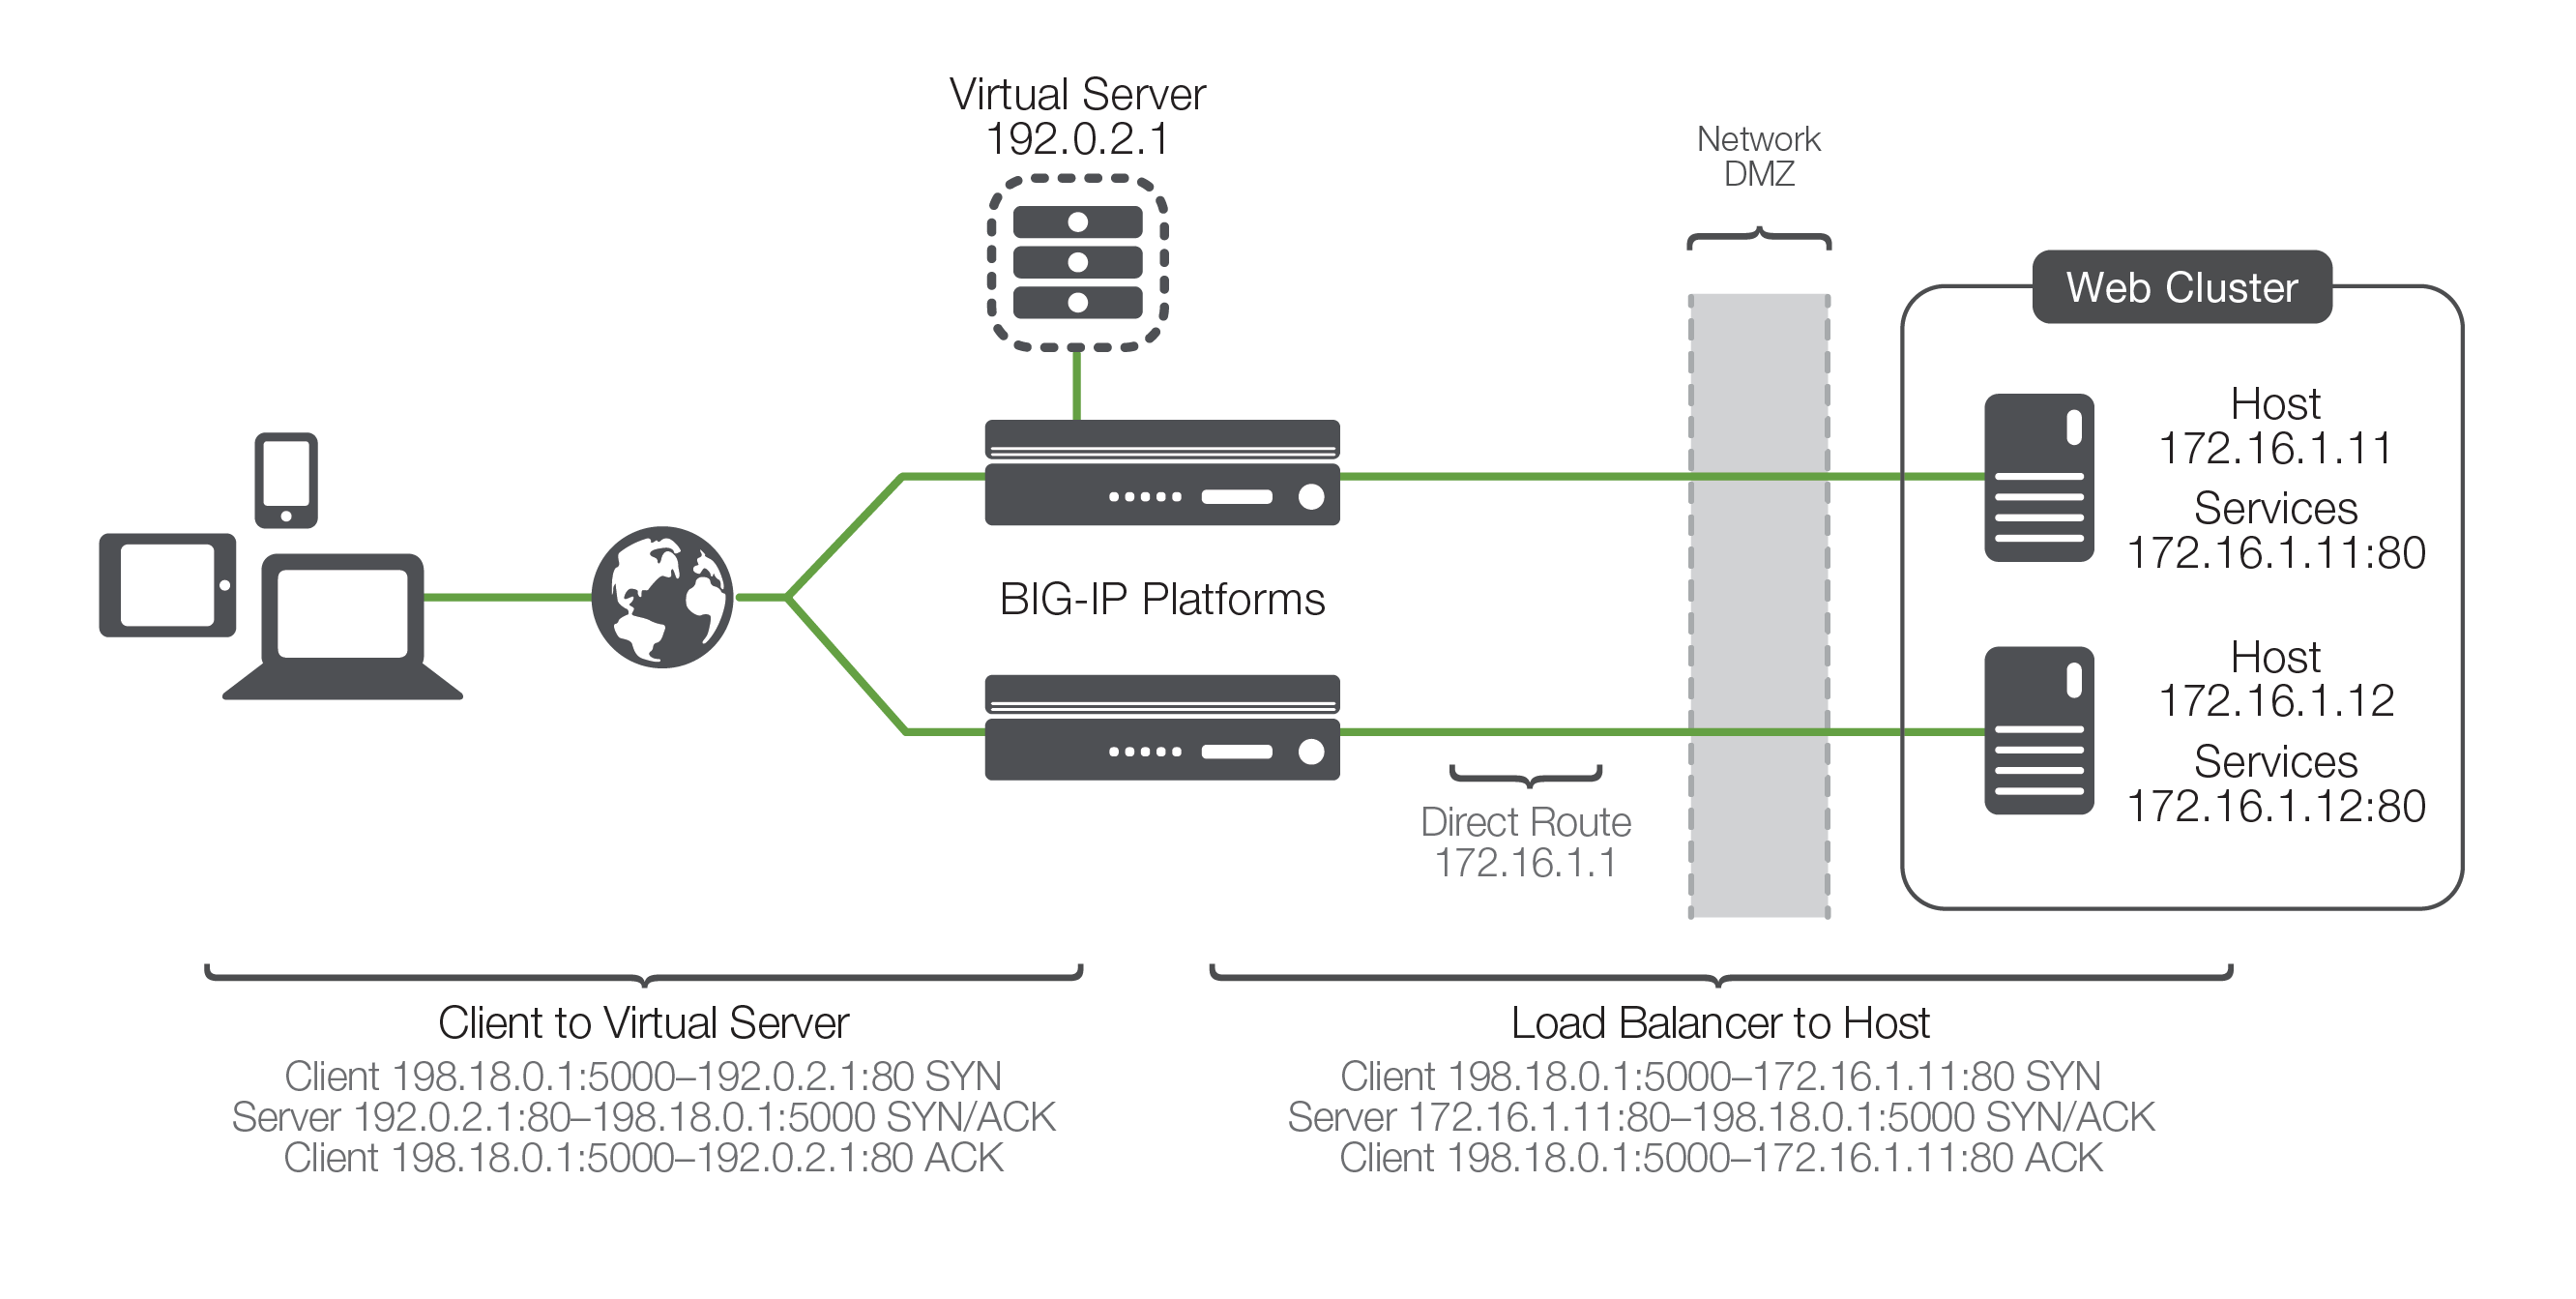
Cet exemple très simple est relativement facile à comprendre, mais il convient de relever quelques éléments clés. Premièrement, du point de vue du client, celui-ci envoie des paquets au serveur virtuel, qui lui répond — rien de plus simple. Deuxièmement, la traduction d’adresses réseau (NAT) intervient. C’est à ce stade que l’ADC remplace l’adresse IP de destination envoyée par le client (celle du serveur virtuel) par l’adresse IP de l’hôte vers lequel il a choisi de répartir la requête. Troisièmement, une partie de ce processus rend la NAT « bidirectionnelle ». L’adresse IP source du paquet de retour provenant de l’hôte sera celle de l’hôte ; si cette adresse n’était pas modifiée et que le paquet était simplement transféré au client, celui-ci recevrait un paquet d’un expéditeur qu’il n’a pas sollicité et le rejetterait tout simplement. Au lieu de cela, l’équilibreur de charge, qui conserve les informations de connexion, réécrit le paquet afin que l’adresse IP source soit celle du serveur virtuel, ce qui résout le problème.
La décision de distribution des applications
À ce stade, deux questions se posent généralement : comment le contrôleur de mise à disposition d’applications (ADC) chargé de l’équilibrage de charge détermine-t-il l’hôte auquel envoyer la connexion ? Et que se passe-t-il si l’hôte sélectionné ne fonctionne pas ?
Commençons par la deuxième question. Que se passe-t-il si l’hôte sélectionné ne fonctionne pas ? La réponse est simple : il ne répond pas à la requête du client, et la tentative de connexion finit par expirer et échouer. Cette situation n’est évidemment pas souhaitable, car elle ne garantit pas une haute disponibilité. C’est pourquoi la plupart des technologies d’équilibrage de charge intègrent un certain niveau de surveillance de l’état de santé afin de déterminer si un hôte est réellement disponible avant de tenter de lui envoyer des connexions.
Il existe plusieurs niveaux de surveillance de l’état de santé, offrant chacun une granularité et un degré de précision croissants. Un moniteur de base se contenterait d’envoyer une requête ping à l’hôte lui-même. Si l’hôte ne répond pas, on peut raisonnablement supposer que les services qui y sont configurés sont probablement indisponibles et doivent être retirés du groupe de services disponibles. Malheureusement, même si l’hôte répond au ping, cela ne signifie pas nécessairement que le service lui-même fonctionne. Par conséquent, la plupart des équipements peuvent effectuer une forme de « ping de service », allant d’une simple connexion TCP à une interaction avec l’application au moyen d’un script ou d’un mécanisme intelligent. Ces moniteurs de santé de niveau supérieur permettent non seulement de vérifier avec davantage de certitude la disponibilité des services eux-mêmes, plutôt que celle de l’hôte, mais aussi au répartiteur de charge de distinguer plusieurs services hébergés sur un même hôte. Le répartiteur de charge comprend ainsi que, même si un service est indisponible, d’autres services du même hôte peuvent parfaitement fonctionner et doivent donc toujours être considérés comme des destinations valides pour le trafic des utilisateurs.
Cela nous ramène à la première question : comment l’ADC détermine-t-il l’hôte auquel envoyer une demande de connexion ? Chaque serveur virtuel dispose d’un cluster de services dédié (répertoriant les hôtes qui proposent ce service), lequel constitue la liste des possibilités. En outre, la surveillance de l’état de santé modifie cette liste afin d’établir celle des hôtes « actuellement disponibles » qui fournissent le service indiqué. C’est dans cette liste actualisée que l’ADC choisit l’hôte qui recevra une nouvelle connexion. Le choix précis de l’hôte dépend de l’algorithme d’équilibrage de charge associé au cluster concerné. Parmi ces algorithmes figurent celui du plus petit nombre de connexions, le ratio dynamique et la méthode simple de répartition à tour de rôle (round robin), dans laquelle l’équilibreur de charge parcourt la liste depuis le début et attribue chaque nouvelle connexion à l’hôte suivant ; lorsqu’il atteint la fin de la liste, il reprend simplement au début. Bien que cette méthode soit simple et très prévisible, elle suppose que toutes les connexions auront une charge et une durée similaires sur l’hôte back-end, ce qui n’est pas toujours le cas. Des algorithmes plus avancés prennent en compte des éléments tels que le nombre de connexions actives, le taux d’utilisation de l’hôte et même les temps de réponse réels du trafic existant vers l’hôte, afin de sélectionner l’hôte le plus approprié parmi les services disponibles du cluster.
Les systèmes de mise à disposition d’applications suffisamment avancés pourront également combiner les informations de surveillance de l’état avec les algorithmes d’équilibrage de charge afin de prendre en compte les dépendances entre les services. Cette fonctionnalité est principalement utile lorsqu’un même hôte exécute plusieurs services qui sont tous nécessaires pour traiter la requête de l’utilisateur. Dans ce cas, il faut éviter d’orienter un utilisateur vers un hôte sur lequel un service est opérationnel, mais pas l’autre. Autrement dit, si un service tombe en panne sur l’hôte, l’autre service de cet hôte doit également être retiré de la liste des services disponibles du cluster. Cette fonctionnalité devient de plus en plus importante à mesure que les services se différencient davantage avec HTML et les scripts.
Répartir la charge ou ne pas la répartir ?
La partie de l’équilibrage de charge qui consiste à sélectionner un service disponible lorsqu’un client lance une requête de transaction ne représente que la moitié de la solution. Une fois la connexion établie, l’ADC doit déterminer si le trafic ultérieur de cet utilisateur doit être équilibré. La gestion du trafic ultérieur après son équilibrage soulève généralement deux problématiques particulières : le maintien de la connexion et la persistance.
Maintien de la connexion
Si l’utilisateur tente d’utiliser une connexion TCP de longue durée (port 21 : FTP, port 23 : Telnet ou autre) qui ne se ferme pas immédiatement, l’équilibreur de charge doit veiller à ce que les différents paquets de données acheminés via cette connexion ne soient pas répartis entre d’autres hôtes de service disponibles. Il s’agit du maintien de la connexion, qui nécessite deux fonctionnalités essentielles. La première consiste à assurer le suivi des connexions ouvertes et du service hôte auquel elles sont associées. La seconde consiste, pour l’équilibreur de charge, à continuer de surveiller la connexion afin que la table des connexions puisse être mise à jour lors de sa fermeture. Il s’agit d’une fonctionnalité relativement standard pour la plupart des contrôleurs de mise à disposition d’applications (ADC).
Persistance
Il est toutefois de plus en plus fréquent qu’un client utilise plusieurs connexions TCP de courte durée (par exemple, sur le port 80 : HTTP) pour accomplir une seule tâche. Dans certains cas, comme la navigation web classique, cela n’a pas d’importance et chaque nouvelle requête peut être envoyée à n’importe quel serveur du service back-end. Cependant, dans de nombreuses situations (XML, commerce électronique, etc.), il est essentiel que plusieurs connexions provenant d’un même utilisateur soient dirigées vers le même serveur du service back-end et ne fassent pas l’objet d’un équilibrage de charge. Ce concept est appelé persistance, ou affinité de serveur.
Il existe plusieurs façons de résoudre ce problème, selon le protocole et les résultats souhaités. Par exemple, dans les transactions HTTP modernes, le serveur peut spécifier une connexion « keep-alive », qui transforme ces multiples connexions de courte durée en une seule connexion de longue durée, pouvant être gérée comme les autres connexions de longue durée. Toutefois, cela n'apporte qu'un soulagement limité, principalement parce qu'avec l'essor des services web et mobiles, le maintien de toutes les connexions ouvertes plus longtemps que nécessaire sollicite fortement les ressources de l'ensemble du système. C'est pourquoi aujourd'hui, dans un souci d'évolutivité et de portabilité, de nombreuses organisations s'orientent vers la création d'applications sans état reposant sur des API. Cela signifie essentiellement que le serveur oublie toutes les informations de session afin de réduire la charge sur les ressources. Dans ce cas, l'état est maintenu par la transmission d'identifiants de session ainsi que par le mécanisme de persistance.
L’une des formes les plus élémentaires de persistance est l’affinité basée sur l’adresse source. Elle consiste simplement à enregistrer l’adresse IP source des requêtes entrantes ainsi que le serveur de service vers lequel elles ont été réparties, puis à acheminer toutes les transactions ultérieures vers ce même serveur. Deux méthodes permettent d’y parvenir : l’utilisation d’identifiants de session SSL et celle de cookies. La persistance SSL assure le suivi des sessions SSL à l’aide de leurs identifiants. Ainsi, même si l’adresse IP du client change, l’équilibreur de charge reconnaît la persistance de la session grâce à son identifiant. La persistance basée sur les cookies permet d’insérer un cookie sur l’ordinateur du client afin d’identifier une session de manière unique, puis de faire référence à ce cookie dans les requêtes pour que la connexion soit dirigée vers le bon serveur.
Aujourd’hui, l’intelligence des contrôleurs de mise à disposition d’applications (ADC) permet aux organisations d’ouvrir les paquets de données et de créer des tables de persistance pour pratiquement toutes les informations qu’ils contiennent. Elles peuvent ainsi utiliser des informations uniques, telles que le nom d’utilisateur, pour maintenir la persistance. Toutefois, les organisations doivent s’assurer que ces informations permettant d’identifier le client sont présentes dans chaque requête, car les paquets qui en sont dépourvus ne bénéficieront pas de la persistance et seront de nouveau répartis par le système d’équilibrage de charge, ce qui entraînera très probablement un dysfonctionnement de l’application.
Conclusion
À l’origine, l’équilibrage de charge visait à répartir les charges de travail sur l’ensemble du réseau et à garantir la disponibilité des applications et des services. Cependant, avec l’évolution de la technologie, les répartiteurs de charge sont devenus des plateformes de mise à disposition d’applications, garantissant une disponibilité élevée et la sécurité des applications critiques de l’organisation. Si l’équilibrage de charge de base reste le fondement de la mise à disposition d’applications, les contrôleurs de mise à disposition d’applications (ADC) modernes offrent des fonctionnalités bien plus avancées.
Les entreprises comprennent que le simple fait de pouvoir accéder à une application ne la rend pas pour autant utilisable — et que des applications inutilisables représentent une perte de temps et d’argent pour l’organisation qui les déploie. C’est là qu’intervient l’ADC moderne, qui permet aux organisations de regrouper des services réseau tels que le déchargement SSL/TLS, la mise en cache, la compression, la régulation du débit, la détection des intrusions, les pare-feu applicatifs et même l’accès à distance au sein d’un point stratégique unique, pouvant être partagé et réutilisé par l’ensemble des services applicatifs et des hôtes afin de créer un réseau virtualisé de distribution d’applications. Les équipes réseau, applicatives et opérationnelles peuvent ainsi mieux répondre aux exigences métier en matière de réduction des délais de livraison et d’amélioration de l’évolutivité, sans jamais compromettre la sécurité.
Pour en savoir plus sur le fonctionnement de la distribution avancée d’applications et sur l’avenir des ADC, consultez L’évolution des contrôleurs de distribution d’applications et Allez au-delà du simple équilibrage de charge.
1 http://www.strategyr.com/MarketResearch/Application_Delivery_Controllers_ADC_Market_Trends.asp
PUBLIÉ LE 10 MAI 2017