Hay una vieja máxima empresarial que todos conocemos y que dice así: el cliente siempre tiene la razón.
En esta economía digital, resulta que ese axioma debe reformularse así: Los datos del cliente siempre tienen la razón.
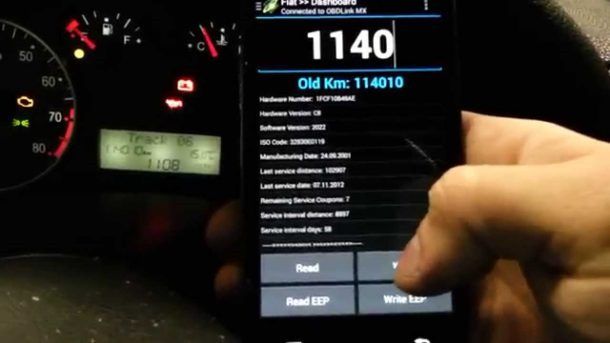
Permíteme ilustrarlo con una pequeña historia.
Hace poco decidí comprarme un coche nuevo y entregar el antiguo como parte del pago. Había tenido el coche viejo durante unos seis años y recorría con él unos cinco mil kilómetros al año. Sé que parece una locura, pero es verdad. Solo salí una vez del estado con él, para ir a Ohio a visitar a mi familia. Nada más. Por lo demás, nunca me alejé más de unos cincuenta kilómetros de casa. Me gusta bromear diciendo que soy esa viejecita que solo coge el coche para ir a misa los domingos.
Así que imagínense mi sorpresa cuando el concesionario me informa de que la lectura del cuentakilómetros es incorrecta —con una diferencia de más de 30.000 millas— basándose en una única línea de datos del informe del historial del vehículo al que había accedido. Una línea que, además, afirmaba que mi coche había pasado por el taller en Dakota del Norte dos años antes.
Esta discrepancia no debe tomarse a la ligera. Las lecturas del cuentakilómetros influyen en el valor de tasación del vehículo y manipularlas es ilegal (puede acarrear multas y penas de prisión). Dado que el cuentakilómetros real mostraba una cifra muy inferior a la que figuraba en el informe, pueden imaginar que el concesionario se quedó un tanto desconcertado. Se enfrentaba a la incómoda decisión de confiar en mí —que insistía en que nunca había llevado el coche a Dakota del Norte— o en los datos que afirmaban lo contrario.
La cuestión se redujo rápidamente a «¿el cliente siempre tiene la razón?» o «¿los datos del cliente siempre tienen la razón?»
Resulta que no es la primera vez que alguien se ve perjudicado por datos inexactos en un informe del historial de un vehículo. La mayoría de los datos todavía se introducen manualmente, por lo que se cometen errores. Sin embargo, para corregirlos, la persona que introdujo los datos debe reconocer que se equivocó. Eso significa que tiene que recordar que cometió un error hace cinco, diez o incluso quince años. Y eso suponiendo que el técnico que introdujo los datos siga disponible para reconocerlo.
Al final, me fui con mi coche nuevo y el concesionario tuvo que encargarse de corregir el informe. Seguro que muchos de vosotros tenéis una historia parecida. Es algo demasiado habitual cuando se opera en una economía digital.
El factor humano (y sus errores)
A medida que seguimos aumentando nuestra dependencia de las máquinas para resolver problemas, extraer información de los datos y tomar decisiones, debemos ser conscientes de que los datos de los que disponemos pueden no ser exactos. En algún punto de la cadena de custodia de esos datos intervino un ser humano. Y una verdad axiomática de la condición humana es que cometemos errores. Basta con que un técnico de mantenimiento de Dakota del Norte pulsara una tecla equivocada hace seis años para que, de repente, te encuentres bajo los focos, sometido a un interrogatorio sobre todos los trayectos en coche que has hecho en tu vida.
Debemos tener cuidado con la confianza que depositamos en los datos que utilizamos para tomar decisiones. No solo debemos preocuparnos por los errores accidentales, sino también por los intencionados. Se lo garantizo: sus datos contienen errores.
El diseño de DNS resulta bastante sorprendente por la forma en que distingue entre fuentes autoritativas y no autoritativas. Si hay alguna discrepancia, sabes que puedes acudir a la única fuente verdadera para averiguar la verdad. Con los datos de los clientes no existe nada parecido. Esto puede ser una señal de alarma, porque los sistemas que utilizamos ahora —y que utilizaremos en un futuro próximo— no siempre pueden saber qué es correcto y qué no. Al fin y al cabo, no hay ningún lugar donde comprobar su veracidad. No existe una autoridad de certificación ni fuentes autoritativas designadas como en DNS. Y, en muchos casos, tampoco hay forma de impugnar los datos.
A medida que seguimos creando perfiles digitales de nuestros clientes a partir de fragmentos de datos, debemos ser conscientes del impacto que esos datos pueden tener, tanto en nosotros, como responsables de la toma de decisiones empresariales, como en los clientes, como seres humanos que tienen que vivir con las consecuencias de cualquier conclusión a la que se llegue basándose en esos datos.
Como proveedores de soluciones de seguridad de aplicaciones, solemos insistir en la protección de los datos y la identidad frente a la exfiltración y el robo. Sin embargo, no solemos darle la vuelta a la cuestión y hablar de la posibilidad muy real de que se produzca corrupción de datos, ya sea de forma accidental o malintencionada.
Deberíamos hacerlo, antes de que se convierta en tendencia en Twitter.
Hemos asistido al auge de los ataques digitales contra personas como represalia en muchas formas. Como los operadores del 911 no pueden obtener ubicaciones y direcciones precisas de los teléfonos móviles, algunas víctimas han sufrido incidentes mortales de swatting. La pornovenganza es una realidad, y la suplantación de nuestros amigos y familiares en las redes sociales ocurre constantemente. Además, hace ya más de tres años que Chris Rock, director ejecutivo de Kustodian, demostró cómo los estafadores podían «matar» artificialmente a alguien para lucrarse o gastar una broma, aprovechando las vulnerabilidades de los procesos de registro de defunciones de la mayoría de los países en DEF CON (CS Monitor). Para quienes estuvieran atentos, ese fue uno de los métodos de hackeo utilizados en la película Hackers, de 1995, junto con la cancelación de la tarjeta de crédito de alguien y la publicación de anuncios personales falsos como represalia por alguna ofensa, ya fuera real o percibida.
Es solo cuestión de tiempo que este tipo de comportamiento vengativo se extienda y acabe corrompiendo datos en otros ámbitos.
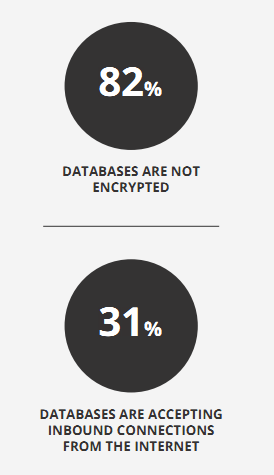
Si crees que llevo un sombrero de papel de aluminio, recuerda el informe CSI de RedLock de 2017 que señalaba que el 31 % de las bases de datos tenían un puerto abierto a Internet. Al alcance de cualquiera. Recuerda el desastre de MongoDB, en el que más de 27 000 bases de datos estaban abiertas al acceso público. La persona equivocada, si encuentra abierta la base de datos adecuada, puede causar estragos en tus datos.
Eso es un problema porque hemos llegado al punto de inflexión en el que los datos suelen considerarse una versión inviolable e infalible de la verdad. Debido a un error en la introducción de datos, esa «verdad» podría haberme llevado a prisión.
Diligencia debida en materia de datos digitales
A medida que seguimos aumentando la cantidad de información sobre nuestras empresas —y nuestras vidas— que se almacena en el ámbito digital, conviene detenernos un momento y recordar que los bits y bytes de nuestros almacenes de datos representan algún aspecto de seres humanos reales. El cuidado con el que tratamos esos datos refleja nuestra actitud hacia esa persona real que es nuestro cliente. Sobre todo, porque no podemos saber qué pequeño dato que introducimos hoy podría interpretarse más adelante de una forma que perjudique al cliente. Al fin y al cabo, la anotación en mi historial del vehículo solo pretendía registrar un cambio de aceite en Dakota del Norte. No hubo mala intención, pero el resultado podría haber sido desastroso para mí.
Ya sea al elaborar políticas de seguridad orientadas a evitar la corrupción de datos, controlar el acceso a aplicaciones y bases de datos o prestar más atención a la introducción manual de datos, debemos recordar que, aunque los datos no mienten —reflejan exactamente lo que introdujo una persona—, quien los introdujo sí podría haber mentido.
Sobre el autor

Lori MacVittie es ingeniera distinguida y evangelista jefe en la Oficina del CTO de F5, y cuenta con una amplia experiencia en entrega de aplicaciones, estrategia de automatización e infraestructura. Es conocida por convertir la complejidad en claridad, ya sea definiendo mecanismos de protección para agentes de IA, analizando arquitecturas multinube frágiles o explorando los límites de los sistemas escalables. Aporta más de treinta años de experiencia en el sector en desarrollo de aplicaciones, arquitectura de TI y operaciones de redes y sistemas. Antes de incorporarse a F5, fue una galardonada editora de tecnología. MacVittie posee un máster en Informática y es una autora prolífica cuyas publicaciones abarcan la seguridad, la nube y la arquitectura empresarial. También es una apasionada de los juegos de mesa y los videojuegos, y expresa sin complejos sus firmes opiniones sobre el queso.
Más artículos de Lori Mac VittieArtículos relacionados del blog

Cree servicios públicos seguros, resilientes y preparados para la IA con F5 y AWS
Descubre cómo las organizaciones del sector público pueden modernizar de forma segura sus aplicaciones y soluciones de IA, al tiempo que gestionan los sistemas heredados, el cumplimiento normativo y el riesgo operativo.

Protección de los sistemas de IA: por qué la seguridad debe avanzar al ritmo de la innovación
Desde acelerar avances revolucionarios en medicina y educación hasta transformar la vida cotidiana, la IA está cambiando nuestra forma de vivir y trabajar. Pero también ofrece grandes oportunidades a los ciberdelincuentes.
Avanzar hacia la optimización digital tras la transformación
Descubre estrategias de optimización digital para garantizar políticas de seguridad coherentes, impulsar la madurez de la transformación digital y superar los retos de la transformación.
Proyecto de código abierto destacado: mayor observabilidad con F5 Cloud Logger iApp
En el punto de mira del código abierto: cómo aumentar la observabilidad. Lee el blog de F5 para descubrir cómo exportar fácilmente la telemetría de BIG-IP a plataformas modernas de análisis en la nube.
El estado de la entrega de aplicaciones en 2018: la transformación digital impulsa la automatización y la multinube pese a las preocupaciones de seguridad
Descubre las principales conclusiones del cuarto informe anual de F5 sobre el estado de la entrega de aplicaciones.
Estado de la entrega de aplicaciones en 2017: automatización, API y DevOps
Descubre el informe sobre el estado de la entrega de aplicaciones de 2017. Lee el blog retrospectivo de F5 sobre los inicios del auge de las redes declarativas y los flujos de DevOps.