Las directrices conocidas como la «aplicación de doce factores» se publicaron por primera vez hace más de diez años. Desde entonces, casi todas las prácticas que prescriben se han convertido en el estándar de facto para desarrollar e implementar aplicaciones web. Y, aunque han seguido siendo aplicables pese a los cambios en la forma de organizar e implementar las aplicaciones, en algunos casos se requiere una interpretación más matizada para comprender cómo se aplican estas prácticas a los patrones de microservicios para desarrollar e implementar aplicaciones.
Este blog se centra en el factor 3, «Guardar la configuración en el entorno», que establece lo siguiente:
- La configuración es todo aquello que varía entre los entornos de despliegue (lo que la aplicación de doce factores denomina «despliegues»).
- La configuración debe estar estrictamente separada del código de la aplicación; de lo contrario, ¿cómo podría variar entre despliegues?
- Los datos de configuración se almacenan en variables de entorno.
Al adoptar los microservicios, puede seguir respetando estas directrices, aunque no siempre de una forma que se corresponda exactamente con una interpretación literal de la aplicación de doce factores. Algunas directrices, como proporcionar los datos de configuración mediante variables de entorno, se trasladan fácilmente. Otras prácticas habituales de los microservicios, aunque respetan los principios fundamentales de la aplicación de doce factores, se asemejan más a extensiones de esta. En este artículo analizaremos tres conceptos fundamentales de la gestión de la configuración para microservicios desde la perspectiva del Factor 3:
- Definir claramente la configuración de tu servicio
- Cómo se proporciona la configuración a un servicio
- Hacer que un servicio esté disponible como configuración
Terminología y conceptos clave de los microservicios
Antes de entrar de lleno en cómo adaptar el Factor 3 a los microservicios, conviene comprender algunos términos y conceptos clave.
- Arquitectura de aplicaciones monolíticas – Un modelo arquitectónico tradicional que separa las funciones de la aplicación en módulos de componentes, pero incluye todos los módulos en una única base de código.
- Arquitectura de aplicaciones basada en microservicios – Un modelo arquitectónico que crea una aplicación grande y compleja a partir de varios componentes pequeños, cada uno de los cuales realiza un conjunto de operaciones bien delimitado (como la autenticación, las notificaciones o el procesamiento de pagos). «Microservicio» también es el nombre que reciben estos pequeños componentes. En la práctica, algunos «microservicios» pueden llegar a ser bastante grandes.
- Servicio – Término general para referirse a una aplicación o un microservicio de un sistema.
- Sistema – En el contexto de este blog, el conjunto completo de microservicios y la infraestructura de soporte que se integran para ofrecer toda la funcionalidad proporcionada por la organización.
- Artefacto – Un objeto creado por un proceso de pruebas y compilación. Puede adoptar muchas formas, como una imagen de Docker que contenga el código de una aplicación.
- Despliegue – Una «instancia» en ejecución de un artefacto, que se ejecuta en un entorno como el de preproducción, integración o producción.
Microservicios frente a monolitos
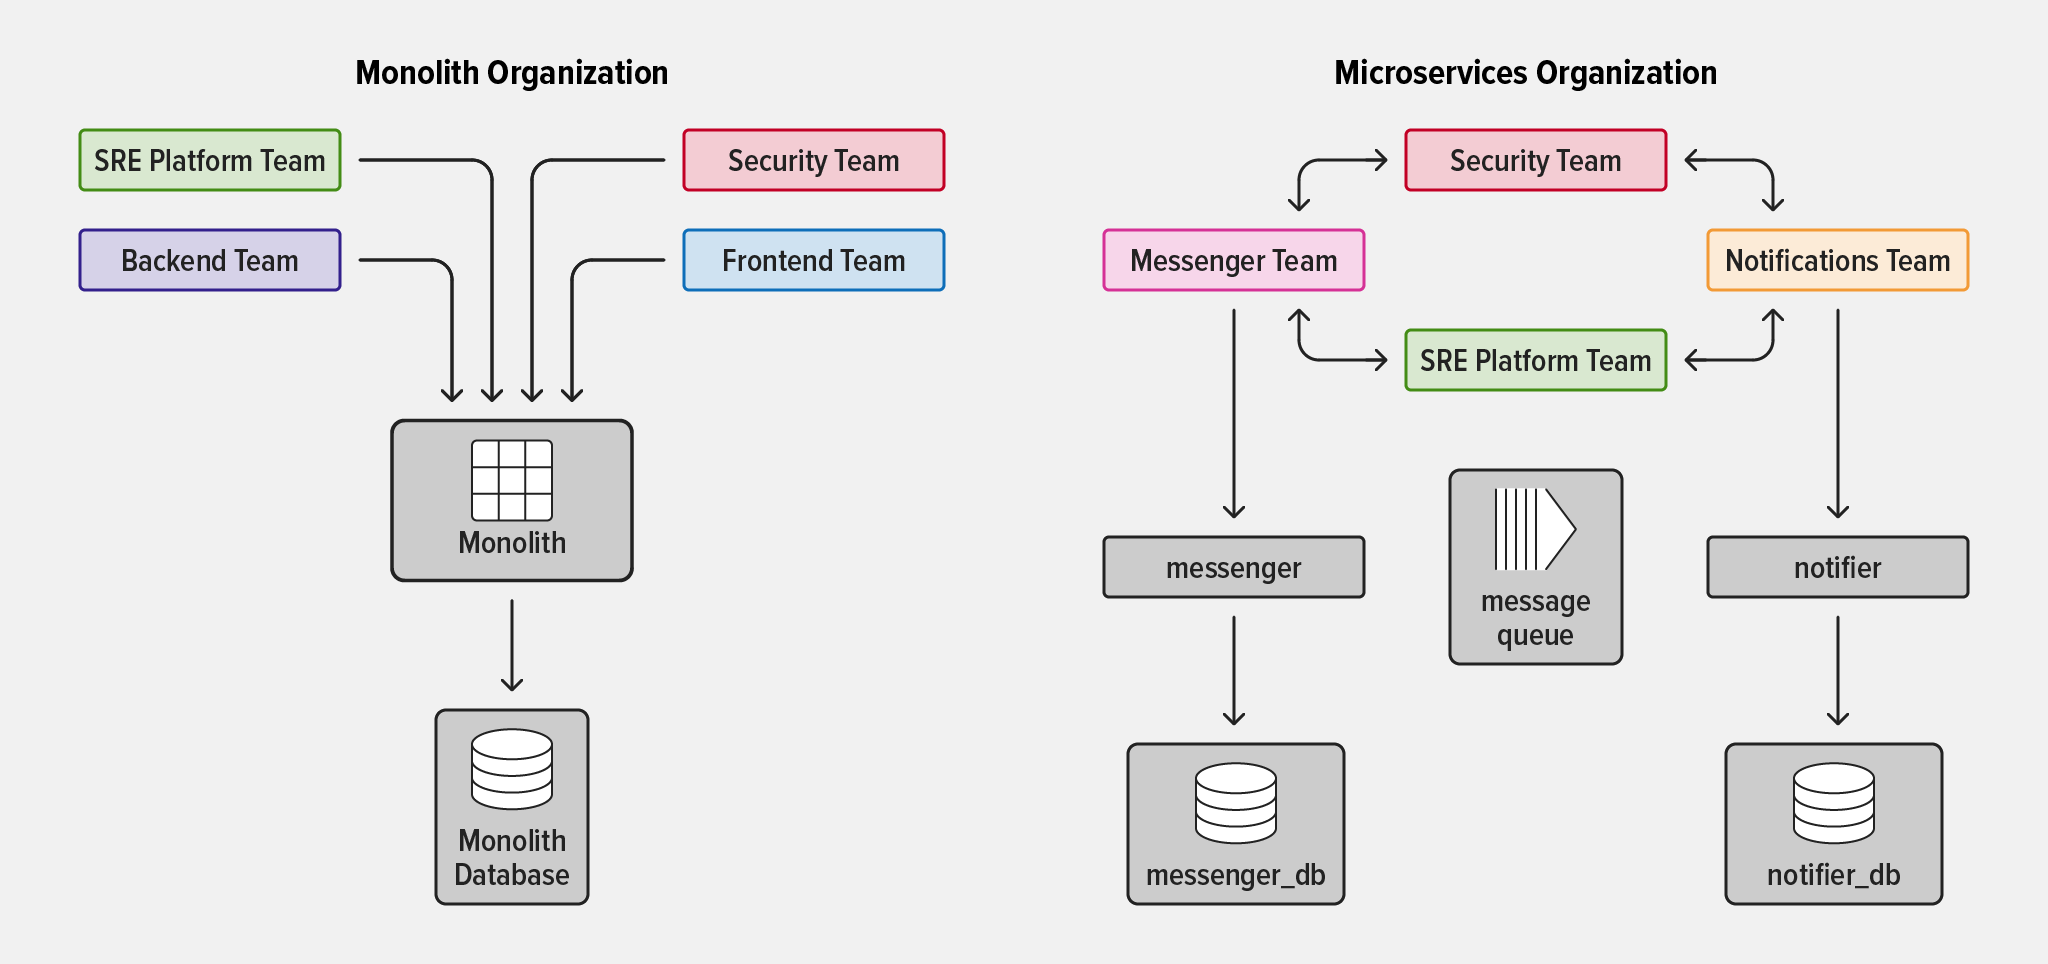
Con una aplicación monolítica, todos los equipos de la organización trabajan en la misma aplicación y en la infraestructura que la sustenta. Aunque, sobre el papel, las aplicaciones monolíticas suelen parecer más sencillas que los microservicios, hay varios motivos habituales por los que las organizaciones deciden migrar a los microservicios:
- Autonomía de los equipos – Puede resultar complicado definir la responsabilidad sobre las funcionalidades y los subsistemas de una aplicación monolítica. A medida que las organizaciones crecen y maduran, la responsabilidad sobre las funcionalidades de la aplicación suele repartirse entre cada vez más equipos. Esto genera dependencias entre ellos, ya que el equipo responsable de una funcionalidad no controla todos los subsistemas relacionados de la aplicación monolítica.
- Reducción del «radio de impacto» – Cuando una aplicación de gran tamaño se desarrolla y se implementa como una única unidad, un error en un subsistema puede afectar al funcionamiento de toda la aplicación.
- Escalar la funcionalidad de forma independiente – Aunque solo un módulo de una aplicación monolítica esté sometido a una carga elevada, la organización debe desplegar numerosas instancias de toda la aplicación para evitar fallos o una degradación del sistema.
Por supuesto, los microservicios plantean sus propios retos —entre ellos, una mayor complejidad, una menor observabilidad y la necesidad de nuevos modelos de seguridad—, pero muchas organizaciones, especialmente las grandes o de rápido crecimiento, consideran que merece la pena afrontarlos para dotar a sus equipos de mayor autonomía y flexibilidad a la hora de crear bases fiables y estables para las experiencias que ofrecen a sus clientes.
Cambios necesarios para las arquitecturas de microservicios
Al refactorizar una aplicación monolítica para convertirla en microservicios, los servicios deben:
- Aceptar los cambios de configuración de forma predecible
- Darse a conocer al sistema en su conjunto de forma predecible
- Estar bien documentado
En una aplicación monolítica, las pequeñas incoherencias en los procesos y la dependencia de supuestos compartidos no son críticas. Sin embargo, cuando hay muchos microservicios independientes, esas incoherencias y esos supuestos pueden generar muchos problemas y caos. Muchos de los cambios que hay que realizar al trabajar con microservicios son necesidades técnicas, pero un número sorprendente de ellos afecta a la forma en que los equipos trabajan internamente e interactúan con otros equipos.
Entre los cambios organizativos más destacados que conlleva una arquitectura de microservicios se incluyen:
- En lugar de trabajar conjuntamente sobre la misma base de código, los equipos pasan a estar totalmente separados y cada uno asume toda la responsabilidad de uno o varios servicios. En la implementación más habitual de los microservicios, los equipos también se reorganizan para ser «multifuncionales», es decir, cuentan con miembros que poseen todas las competencias necesarias para alcanzar los objetivos del equipo con una dependencia mínima de otros equipos.
- Los equipos de plataforma (responsables del buen funcionamiento general del sistema) ahora deben coordinar múltiples servicios gestionados por distintos equipos, en lugar de ocuparse de una única aplicación.
- Los equipos de herramientas deben seguir siendo capaces de proporcionar herramientas y orientación a los distintos equipos responsables de los servicios para ayudarles a alcanzar sus objetivos rápidamente, sin dejar de mantener la estabilidad del sistema.
Definir claramente la configuración de tus servicios
Un aspecto de la arquitectura de microservicios en el que debemos ampliar el Factor 3 es la necesidad de definir claramente cierta información esencial sobre un servicio, incluida su configuración, y de presuponer un contexto compartido mínimo con otros servicios. El Factor 3 no aborda esta cuestión directamente, pero resulta especialmente importante cuando un gran número de microservicios independientes contribuye a la funcionalidad de la aplicación.
Como responsable de un servicio en una arquitectura de microservicios, su equipo gestiona servicios que desempeñan funciones específicas en el conjunto del sistema. Otros equipos cuyos servicios interactúan con los suyos necesitan acceder al repositorio de su servicio para consultar el código y la documentación, así como para realizar contribuciones.
Además, es una realidad desafortunada en el ámbito del desarrollo de software que la composición de los equipos cambie con frecuencia, no solo porque los desarrolladores se incorporan a la empresa o la abandonan, sino también debido a reorganizaciones internas. Asimismo, la responsabilidad de un servicio determinado también suele transferirse de un equipo a otro.
Ante estas realidades, el código base y la documentación deben ser extremadamente claros y coherentes, lo cual se consigue mediante:
- Definir claramente la finalidad de cada opción de configuración
- Definir claramente el formato esperado del valor de configuración
- Definir claramente cómo espera la aplicación que se proporcionen los valores de configuración
- Registrar esta información en un número limitado de archivos
Muchos frameworks de aplicaciones ofrecen una forma de definir la configuración necesaria. Por ejemplo, el paquete NPM convict para aplicaciones Node.js utiliza un «esquema» de configuración completo almacenado en un único archivo. Este actúa como la única fuente de referencia para toda la configuración que una aplicación Node.js necesita para ejecutarse.
Un esquema sólido y fácil de encontrar permite que tanto los miembros de tu equipo como otras personas interactúen con confianza con tu servicio.
Cómo se proporciona la configuración a un servicio
Una vez definidos claramente los valores de configuración que necesita la aplicación, también debe tener en cuenta la importante distinción entre las dos fuentes principales de las que una aplicación de microservicios desplegada obtiene su configuración:
- Scripts de despliegue que definen explícitamente los ajustes de configuración y acompañan al código fuente de la aplicación
- Fuentes externas consultadas durante el despliegue
Los scripts de despliegue son un patrón habitual de organización del código en las arquitecturas de microservicios. Dado que surgieron después de la publicación original de la aplicación de doce factores, constituyen necesariamente una ampliación de esta.
Patrón: configuración de despliegue e infraestructura junto a la aplicación
En los últimos años, se ha vuelto habitual tener una carpeta llamada infrastructure (o alguna variante de ese nombre) en el mismo repositorio que el código de la aplicación. Normalmente contiene:
- Infraestructura como código (Terraform es un ejemplo habitual) que describe la infraestructura de la que depende el servicio, como una base de datos
- Configuración para su sistema de orquestación de contenedores, como los gráficos de Helm y los manifiestos de Kubernetes
- Cualquier otro archivo relacionado con el despliegue de la aplicación
A primera vista, esto podría parecer una infracción del principio del Factor 3, según el cual la configuración debe estar estrictamente separada del código.
De hecho, el hecho de que se encuentre junto a la aplicación implica que una carpeta de infraestructura respeta la regla y, al mismo tiempo, permite introducir valiosas mejoras en los procesos que son fundamentales para los equipos que trabajan en entornos de microservicios.
Entre las ventajas de este patrón se incluyen:
- El equipo responsable del servicio también se encarga de su despliegue y del despliegue de la infraestructura específica del servicio (como las bases de datos).
- El equipo responsable puede asegurarse de que los cambios en cualquiera de estos elementos pasen por su proceso de desarrollo (revisión de código, integración continua).
- El equipo puede cambiar fácilmente la forma en que se despliegan su servicio y la infraestructura de soporte sin depender de equipos externos para que hagan el trabajo por él.
Cabe destacar que las ventajas que ofrece este patrón refuerzan la autonomía de cada equipo, al tiempo que garantizan un mayor rigor en el proceso de despliegue y configuración.
¿Dónde va cada tipo de configuración?
En la práctica, se utilizan los scripts de despliegue almacenados en la carpeta de infraestructura para gestionar tanto la configuración definida explícitamente en los propios scripts como la obtención de la configuración de fuentes externas durante el despliegue, haciendo que el script de despliegue de un servicio:
- Definir directamente determinados valores de configuración
- Defina dónde puede buscar el proceso que ejecuta el script de despliegue los valores de configuración deseados en fuentes externas
Los valores de configuración específicos de un determinado despliegue de su servicio y que estén totalmente bajo el control de su equipo pueden especificarse directamente en los archivos de la carpeta de infraestructura. Un ejemplo podría ser el límite de tiempo durante el que se permite ejecutar una consulta a la base de datos iniciada por la aplicación. Este valor puede cambiarse modificando el archivo de despliegue y volviendo a desplegar la aplicación.
Una de las ventajas de este sistema es que los cambios en este tipo de configuración deben pasar necesariamente por una revisión de código y pruebas automatizadas, lo que reduce la probabilidad de que un valor mal configurado provoque una interrupción del servicio. Tanto los cambios en los valores que pasan por una revisión de código como los valores de las claves de configuración en un momento dado pueden consultarse en el historial de las herramientas de control de versiones.
Los valores necesarios para que la aplicación funcione, pero que no estén bajo el control de su equipo, debe proporcionarlos el entorno en el que se despliega la aplicación. Un ejemplo son el nombre de host y el puerto que utiliza el servicio para conectarse a otro microservicio del que depende.
Dado que ese servicio no pertenece a tu equipo, no puedes dar por sentados valores como el número de puerto. Estos valores pueden cambiar en cualquier momento y, cuando lo hagan, deben registrarse en algún repositorio central de configuración, independientemente de si el cambio se realiza manualmente o mediante algún proceso automático. De este modo, las aplicaciones que dependen de ellos pueden consultarlos.
Podemos resumir estas directrices en dos prácticas recomendadas para la configuración de microservicios.
Qué no hacer al configurar microservicios: depender de valores codificados de forma fija o acordados mutuamente
Puede parecer que lo más sencillo es codificar ciertos valores de forma fija en los scripts de despliegue, como la ubicación de un servicio con el que interactúa el suyo. En la práctica, codificar de forma fija este tipo de configuración es peligroso, especialmente en entornos modernos, donde las ubicaciones de los servicios suelen cambiar con frecuencia. Y resulta especialmente peligroso si el segundo servicio no es de su propiedad.
Puede que pienses que puedes confiar en tu propia diligencia para mantener actualizada en tus scripts la ubicación de un servicio o, peor aún, que puedes confiar en que el equipo responsable te informe cuando esta cambie. La diligencia suele flaquear en momentos de estrés, y depender del rigor humano expone tu sistema al riesgo de fallar sin previo aviso.
Buena práctica de configuración de microservicios: hacer que el servicio pregunte «¿Dónde está mi base de datos?»
Independientemente de si la información sobre la ubicación está codificada de forma fija o no, la aplicación no debe depender de que la infraestructura crítica se encuentre en una ubicación determinada. En su lugar, un servicio recién desplegado debe consultar a una fuente común del sistema con preguntas como «¿dónde está mi base de datos?» y recibir una respuesta precisa sobre la ubicación actual de ese recurso externo. Hacer que cada servicio se registre en el sistema al desplegarse simplifica mucho las cosas.
Hacer que un servicio esté disponible como configuración
Del mismo modo que el sistema debe responder a las preguntas «¿dónde está mi base de datos?» y «¿dónde está el “servicio X” del que dependo?», un servicio debe ponerse a disposición del sistema de forma que otros servicios puedan encontrarlo y comunicarse con él fácilmente sin necesidad de saber cómo está desplegado.
Una práctica de configuración clave en las arquitecturas de microservicios es el descubrimiento de servicios: el registro de información sobre nuevos servicios y la actualización dinámica de dicha información cuando otros servicios acceden a ella. Tras explicar por qué el descubrimiento de servicios es necesario para los microservicios, veamos un ejemplo de cómo implementarlo con NGINX Open Source y Consul.
Es habitual tener varias instancias (implementaciones) de un servicio ejecutándose simultáneamente. Esto no solo permite gestionar tráfico adicional, sino también actualizar un servicio sin tiempo de inactividad mediante el lanzamiento de una nueva implementación. Al actuar como proxy inverso y equilibrador de carga, herramientas como NGINX procesan el tráfico entrante y lo dirigen a la instancia más adecuada. Este es un buen patrón, ya que los servicios que dependen del suyo envían solicitudes únicamente a NGINX y no necesitan saber nada sobre sus implementaciones.
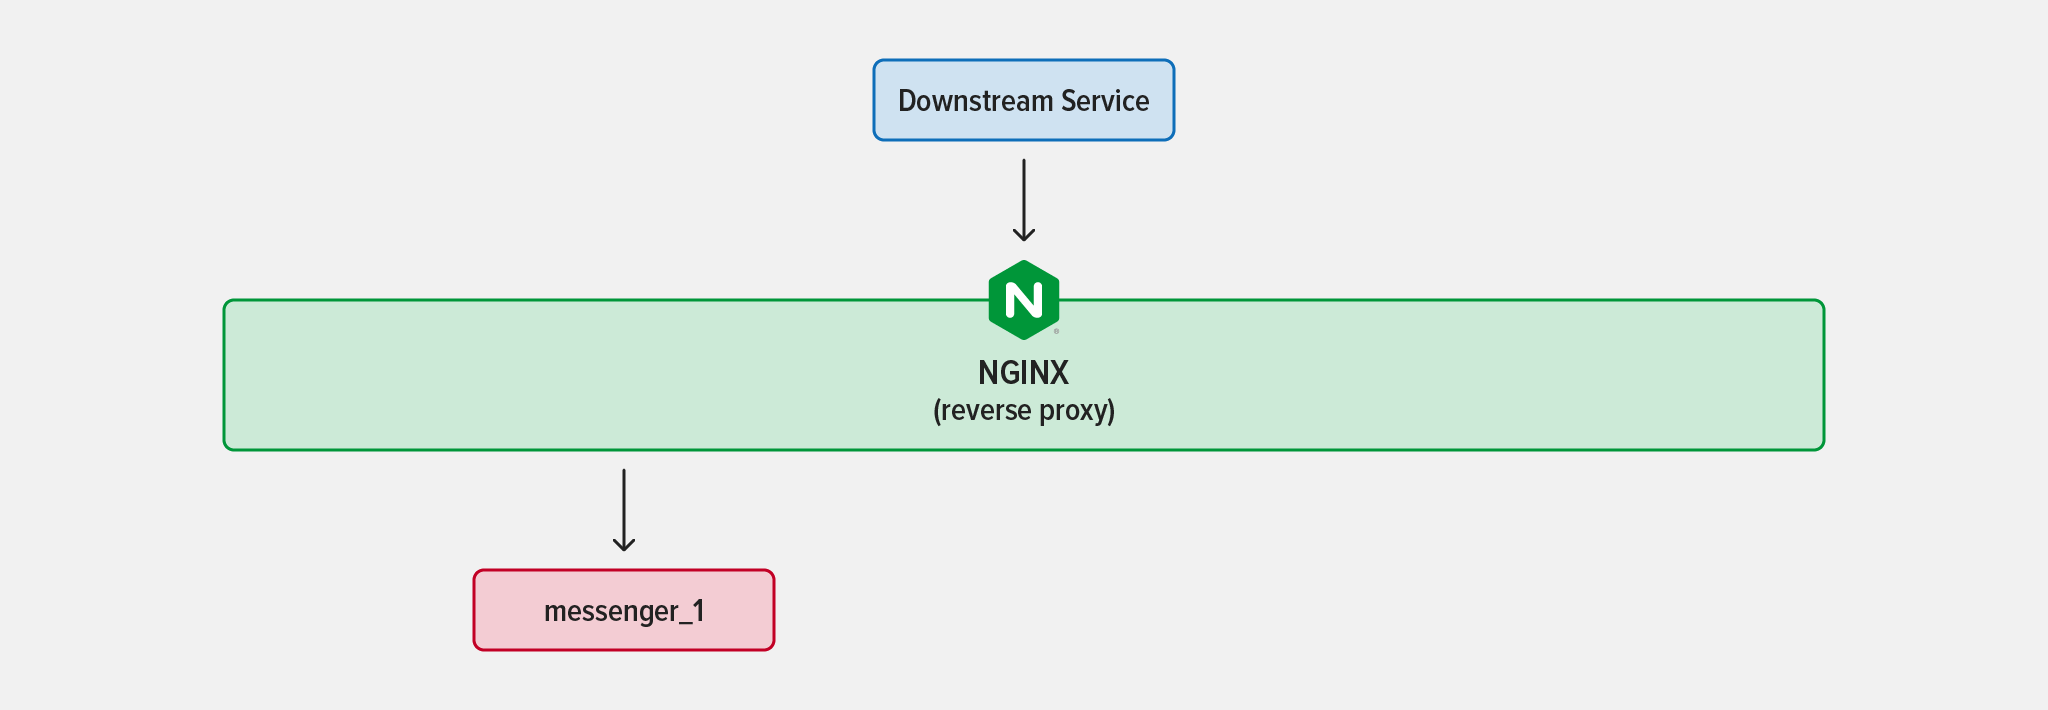
Por ejemplo, supongamos que tienes una única instancia de un servicio llamado messenger ejecutándose detrás de NGINX, que actúa como proxy inverso.
Ahora bien, ¿qué ocurre si tu aplicación se vuelve popular? Eso se considera una buena noticia, pero entonces observas que, debido al aumento del tráfico, la instancia de messenger consume muchos recursos de CPU y tarda más en procesar las solicitudes, mientras que la base de datos parece funcionar perfectamente. Esto indica que quizá puedas resolver el problema desplegando otra instancia del servicio messenger.
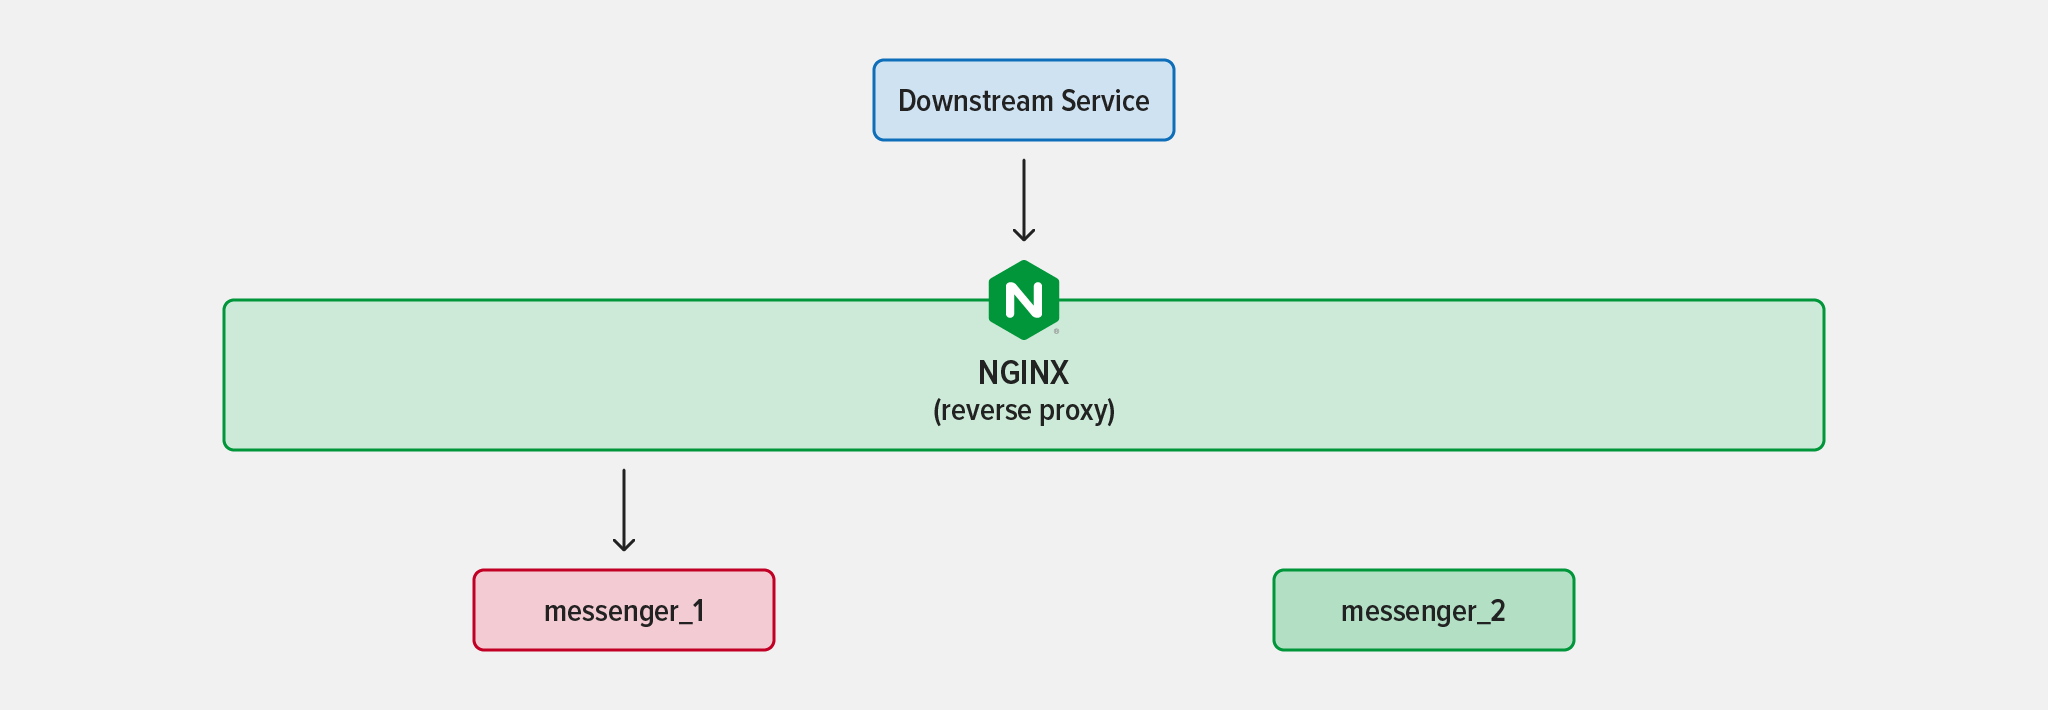
Cuando implementas la segunda instancia del servicio messenger, ¿cómo sabe NGINX que está activa y empieza a enviarle tráfico? Añadir manualmente nuevas instancias a la configuración de NGINX es una opción, pero pronto se vuelve inmanejable a medida que más servicios aumentan y reducen su escala.
Una solución habitual consiste en realizar un seguimiento de los servicios de un sistema mediante un registro de servicios de alta disponibilidad como Consul. Las nuevas instancias de servicio se registran en Consul a medida que se despliegan. Consul supervisa el estado de las instancias realizando comprobaciones de estado periódicas. Cuando una instancia no supera estas comprobaciones, se elimina de la lista de servicios disponibles.
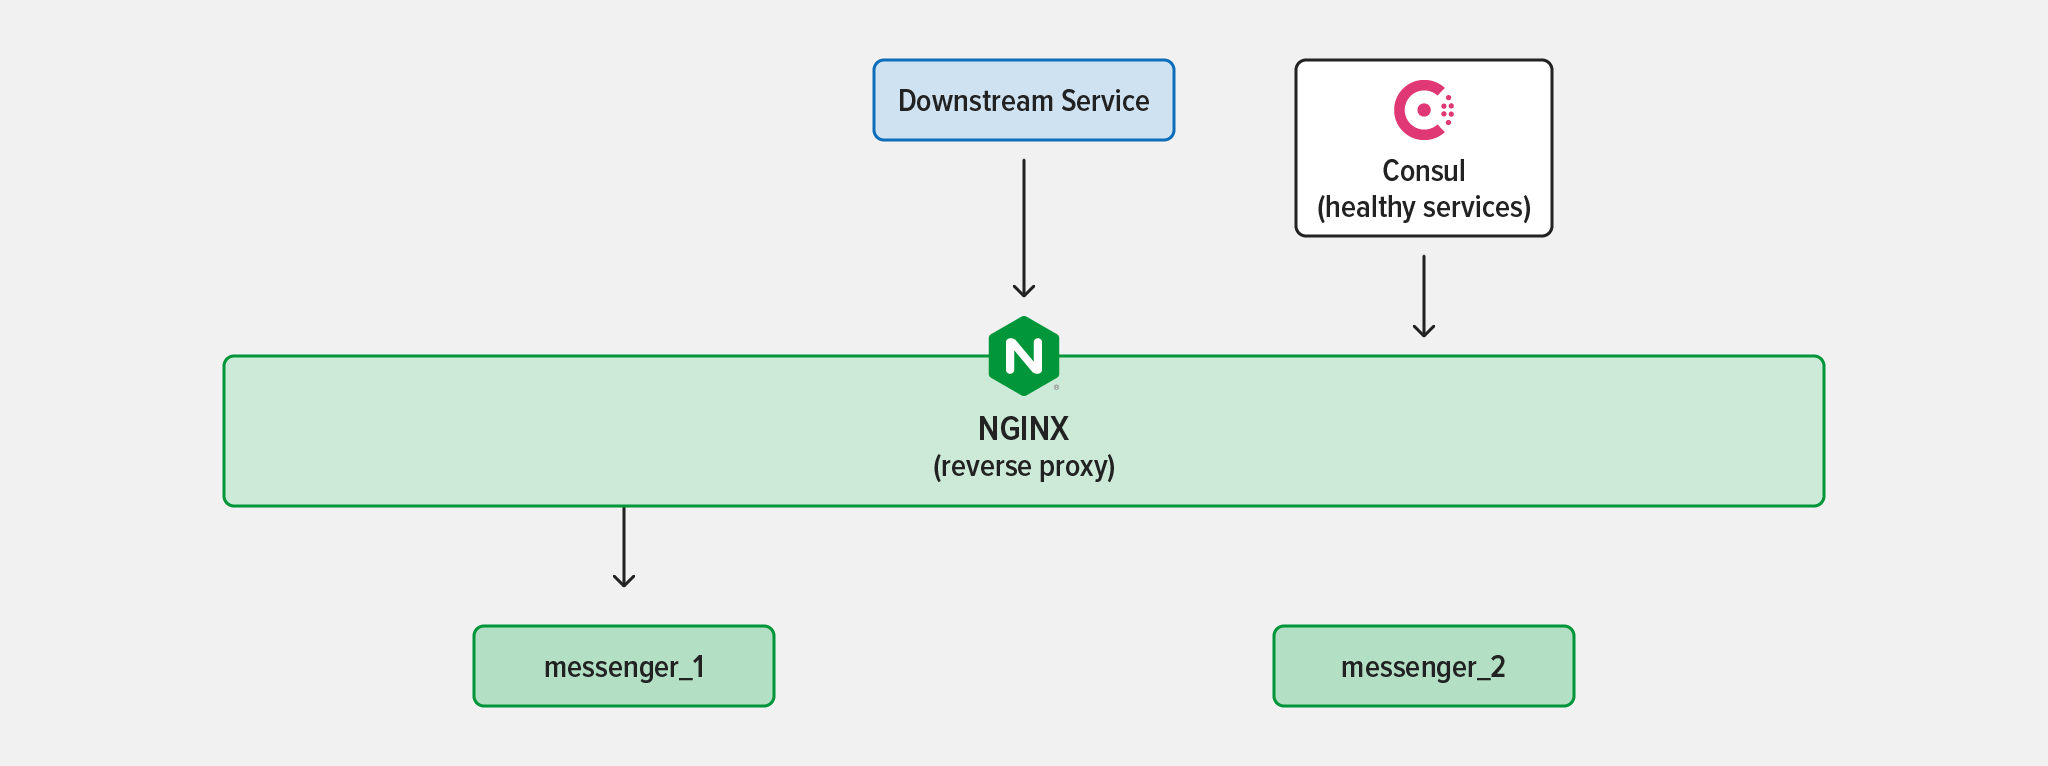
NGINX puede consultar un registro como Consul mediante diversos métodos y ajustar su enrutamiento en consecuencia. Recuerde que, cuando actúa como proxy inverso o equilibrador de carga, NGINX dirige el tráfico a servidores «upstream». Veamos esta sencilla configuración:
# Define an upstream group called "messenger_service"
upstream messenger_service {
    server 172.18.0.7:4000;
    server 172.18.0.8:4000;
}

server {
    listen 80;

    location /api {
        # Proxy HTTP traffic with paths starting with '/api' to the
        # 'upstream' block above. The default load-balancing algorithm,
        # Round-Robin, alternates requests between the two servers
        # in the block.
        proxy_pass http://messenger_service;
        proxy_set_header X-Forwarded-For $remote_addr;
    }
}
De forma predeterminada, NGINX necesita conocer la dirección IP y el puerto exactos de cada instancia de messenger para dirigir el tráfico hacia ella. En este caso, se trata del puerto 4000 tanto en 172.18.0.7 como en 172.18.0.8.
Aquí es donde entran en juego Consul y Consul template. Consul template se ejecuta en el mismo contenedor que NGINX y se comunica con el cliente de Consul, que mantiene el registro de servicios.
Cuando cambia la información del registro, Consul template genera una nueva versión del archivo de configuración de NGINX con las direcciones IP y los puertos correctos, la guarda en el directorio de configuración de NGINX e indica a NGINX que vuelva a cargar su configuración. No se produce ninguna interrupción del servicio cuando NGINX vuelve a cargar su configuración, y la nueva instancia empieza a recibir tráfico en cuanto finaliza la recarga.
Con un proxy inverso como NGINX en este tipo de situaciones, existe un único punto de acceso que registrar en el sistema para que otros servicios puedan conectarse. Su equipo dispone de la flexibilidad necesaria para gestionar instancias individuales del servicio sin tener que preocuparse de que otros servicios pierdan el acceso al servicio en su conjunto.
Ponte manos a la obra con NGINX y la Marcha de los Microservicios
Es cierto que los microservicios aumentan la complejidad, tanto desde el punto de vista técnico de los servicios como desde el punto de vista organizativo de las relaciones con otros equipos. Para aprovechar las ventajas de una arquitectura de microservicios, es importante revisar de forma crítica las prácticas diseñadas para los monolitos y asegurarse de que sigan aportando los mismos beneficios al aplicarlas en un entorno muy diferente. En este blog, analizamos cómo el Factor 3 de la aplicación de doce factores sigue aportando valor en un contexto de microservicios, aunque puede beneficiarse de pequeños cambios en su aplicación concreta.
Para obtener más información sobre cómo aplicar la metodología de aplicaciones de doce factores a las arquitecturas de microservicios, consulta la Unidad 1 de Microservices March 2023 (próximamente en el blog). Regístrate gratis para acceder a un seminario web sobre este tema y a un laboratorio práctico.

Sobre el autor
Artículos relacionados del blog

Únete a F5 NGINX en AppWorld 2024
Descubre las numerosas razones para asistir al evento insignia de F5, que incluirá un emocionante anuncio sobre la cartera de productos NGINX.
Rotación de certificados SSL/TLS sin reinicios en NGINX Open Source
La función de diccionario compartido permite configurar NGINX sin necesidad de reiniciarlo al renovar los certificados SSL/TLS.
Exposición de APIs en Kubernetes
La unidad 2 de Microservices March 2022 se centra en cómo exponer tus API en Kubernetes. Aquí tienes enlaces a los recursos que necesitas: la retransmisión en directo del 14 de marzo, artículos de blog y otros recursos de preparación, y el laboratorio práctico «Protege las API de Kubernetes mediante la limitación de solicitudes».
NGINX Sprint 2.0: visión clara, código renovado y nuevos compromisos con el código abierto
Hoy, en NGINX Sprint 2.0, anunciamos cómo respaldaremos nuestra visión del futuro de las aplicaciones modernas con una mayor presencia en la comunidad de código abierto, incluida la participación en el proyecto comunitario Kubernetes, nuevos proyectos de software de código abierto y la arquitectura de referencia para aplicaciones modernas.
Presentamos NGINX Plus R22
NGINX Plus R22 incorpora nuevas funcionalidades, como la compatibilidad con OCSP para verificar la revocación de certificados en TLS mutuo, el uso de varios proveedores de identidad OIDC en una configuración, el seguimiento en tiempo real de la limitación de solicitudes y conexiones en el panel de NGINX Plus y mejoras en NGINX JavaScript.
Presentamos NGINX Plus R17
NGINX Plus R17 incorpora compatibilidad con la limitación de velocidad en dos fases y con TLS 1.3, la versión más reciente del protocolo Transport Layer Security. La configuración de OpenID Connect es más sencilla y NGINX ModSecurity WAF es el doble de rápido que antes. También se ha actualizado el módulo JavaScript de NGINX.